
C++初识
文章目录
认识C++
1.C++发展史
C++发展史
C++的起源可以追溯到1979年,当时BjarneStroustrup(本贾尼·斯特劳斯特卢普,这个翻译的名字不同的地⽅可能有差异)在⻉尔实验室从事计算机科学和软件⼯程的研究⼯作。⾯对项⽬中复杂的软件开发任务,特别是模拟和操作系统的开发⼯作,他感受到了现有语⾔(如C语⾔)在表达能⼒、可维护性
和可扩展性⽅⾯的不⾜。1983年,BjarneStroustrup在C语⾔的基础上添加了⾯向对象编程的特性,设计出了C++语⾔的雏形,
此时的C++已经有了类、封装、继承等核⼼概念,为后来的⾯向对象编程奠定了基础。这⼀年该语⾔被
正式命名为C++。在随后的⼏年中,C++在学术界和⼯业界的应⽤逐渐增多。⼀些⼤学和研究所开始将C++作为教学和研究的⾸选语⾔,⽽⼀些公司也开始在产品开发中尝试使⽤C++。这⼀时期,C++的标准库和模板等特性
也得到了进⼀步的完善和发展。C++的标准化⼯作于1989年开始,并成⽴了⼀个ANSI和ISO(InternationalStandardsOrganization)国际标准化组织的联合标准化委员会。1994年标准化委员会提出了第⼀个标准化草
案。在该草案中,委员会在保持斯特劳斯特卢普最初定义的所有特征的同时,还增加了部分新特征。在完成C++标准化的第⼀个草案后不久STL(StandardTemplateLibrary)是惠普实验室开发的⼀系列软件的统称。它是由AlexanderStepanov、MengLee和DavidRMusser在惠普实验室⼯作时所开发出来的。在通过了标准化第⼀个草案之后,联合标准化委员会投票并通过了将STL包含到C++标准中的提议。STL对C++的扩展超出C++的最初定义范围。虽然在标准中增加STL是个很重要的决定,但也因此延缓了C++标准化的进程。
1997年11⽉14⽇,联合标准化委员会通过了该标准的最终草案。1998年,C++的ANSI/IS0标准被投⼊
使⽤。
2.C++版本的更新
3.C++的重要性
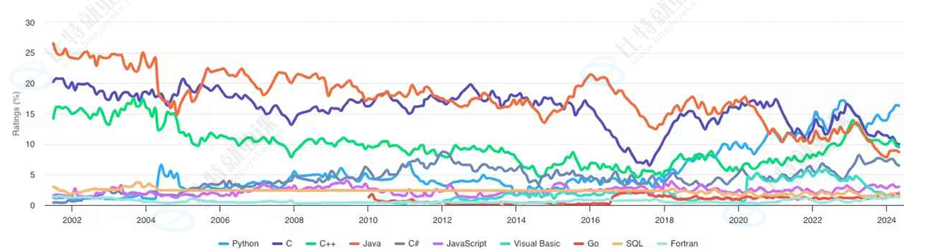
4.C++在工作领域中的作用
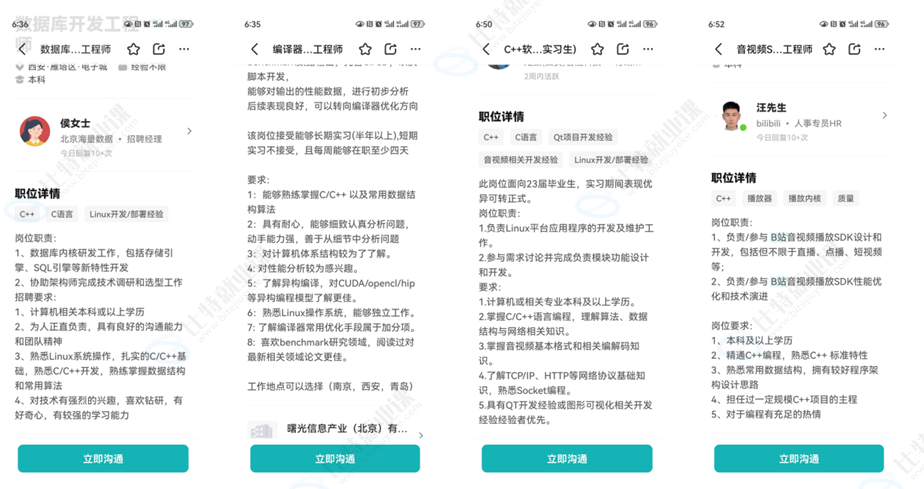
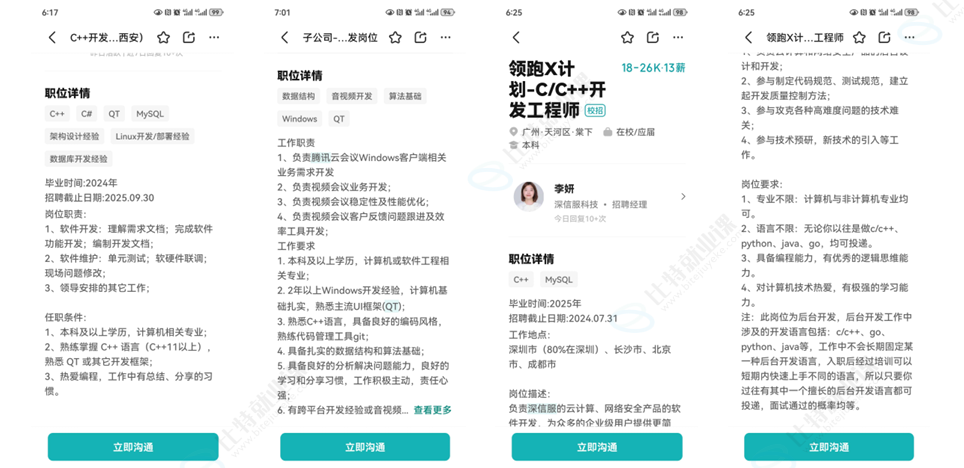
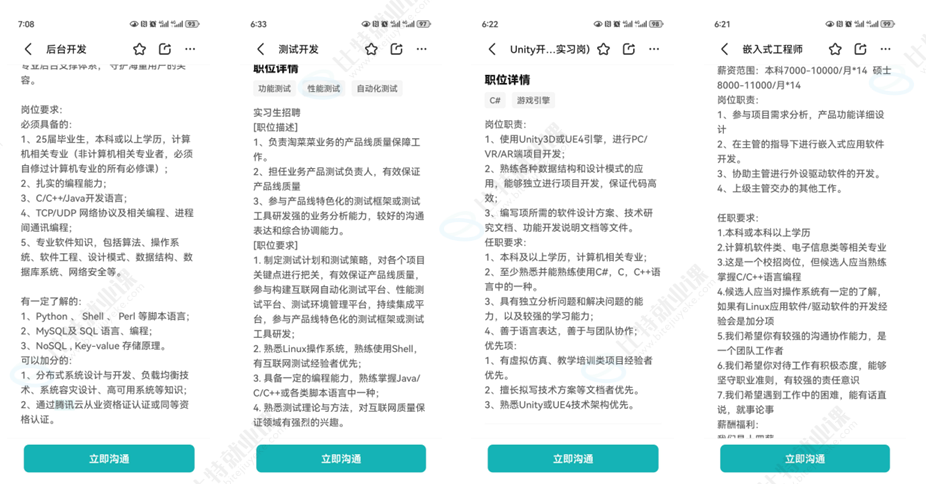
C++的应⽤领域服务器端、游戏(引擎)、机器学习引擎、⾳视频处理、嵌⼊式软件、电信设备、⾦融应⽤、基础库、操作系统、编译器、基础架构、基础⼯具、硬件交互等很多⽅⾯都有。
- ⼤型系统软件开发。如编译器、数据库、操作系统、浏览器等等
- ⾳视频处理。常⻅的⾳视频开源库和⽅案有FFmpeg、WebRTC、Mediasoup、ijkplayer,⾳视频 开发最主要的技术栈就是C++。
3. PC客⼾端开发。⼀般是开发Windows上的桌⾯软件,⽐如WPS之类的,技术栈的话⼀般是C++和 QT,QT是⼀个跨平台的C++图形⽤⼾界⾯(GraphicalUserInterface,GUI)程序。- 服务端开发。各种⼤型应⽤⽹络连接的⾼并发后台服务。这块Java也⽐较多,C++主要⽤于⼀些对 性能要求⽐较⾼的地⽅。如:游戏服务、流媒体服务、量化⾼频交易服务等
- 游戏引擎开发。很多游戏引擎就都是使⽤C++开发的,游戏开发要掌握C++基础和数据结构,学习 图形学知识,掌握游戏引擎和框架,了解引擎实现,引擎源代码可以学习UE4、Cocos2d-x等开源 引擎实现
- 嵌⼊式开发。嵌⼊式把具有计算能⼒的主控板嵌⼊到机器装置或者电⼦装置的内部,通过软件能够 控制这些装置。⽐如:智能⼿环、摄像头、扫地机器⼈、智能⾳响、⻔禁系统、⻋载系统等等,粗
略⼀点,嵌⼊式开发主要分为嵌⼊式应⽤和嵌⼊式驱动开发。- 机器学习引擎。机器学习底层的很多算法都是⽤C++实现的,上层⽤python封装起来。如果你只想 准备数据训练模型,那么学会Python基本上就够了,如果你想做机器学习系统的开发,那么需要学 会C++。
- 测试开发/测试。每个公司研发团队,有研发就有测试,测试主要分为测试开发和功能测试,测试 开发⼀般是使⽤⼀些测试⼯具(selenium、Jmeter等),设计测试⽤例,然后写⼀些脚本进⾏⾃动化测试,性能测试等,有些还需要⾃⾏开发⼀些测试⽤具。功能测试主要是根据产品的功能,设计测 试⽤例,然后⼿动的⽅式进⾏测试
5.C++书记推荐
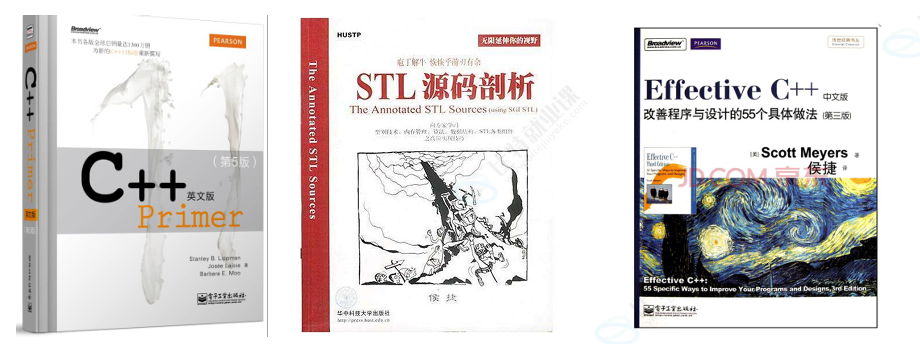
1.C++Primer:主要讲解语法,经典的语法书籍,前后中期都可以看,前期如果⾃学看可能会有点晦涩
难懂,能看懂多少看懂多少,就当预习,学了⽐特课程后,中后期作为语法字典,⾮常好⽤。
2.STL源码剖析:主要从底层实现的⻆度结合STL源码,庖丁解⽜式剖析STL的实现,是侯捷⽼师的经典之作。可以很好的帮助我们学习别⼈⽤语法是如何实现出⾼效简洁的数据结构和算法代码,如何使⽤泛型封装等。让我们不再坐井观天,闭⻔造⻋,本书课程上⼀半以后,中后期可以看。
3.Effctive C++:本书也是侯捷⽼师翻译的,本书有的⼀句评价,把C++程序员分为看过此书的和没看过
此书的。本书主要讲了55个如何正确⾼效使⽤C++的条款,建议中后期可以看⼀遍,⼯作1-2年后再看⼀遍,相信会有不⼀样的收获。
进入C++知识点学习
一、命名空间
1. namespace 的价值和定义
在C/C++中,变量、函数和后⾯要学到的类都是⼤量存在的,这些变量、函数和类的名称将都存在于全局作⽤域中,可能会导致很多冲突。使⽤命名空间的⽬的是对标识符的名称进⾏本地化,以避免命名冲突或名字污染,namespace关键字的出现就是针对这种问题的。
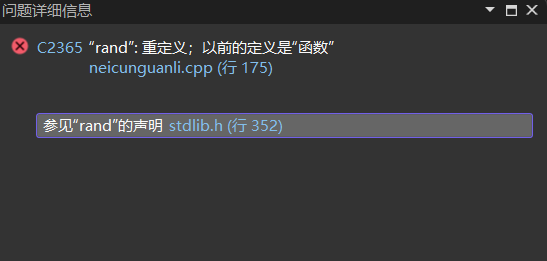
c语⾔项⽬类似下⾯程序这样的命名冲突是普遍存在的问题,C++引⼊namespace就是为了更好的解决这样的问题
#include<stdio.h>
#include<stdlib.h>
int rand = 10;

int main()
{
	printf("%d", rand);
	return 0;
}
- 定义
1.定义命名空间,需要使⽤到namespace关键字,后⾯跟命名空间的名字,然后接⼀对{}即可,{}中即为命名空间的成员。命名空间中可以定义变量/函数/类型等。
2. namespace本质是定义出⼀个域,这个域跟全局域各⾃独⽴,不同的域可以定义同名变量,所以下 ⾯的rand不在冲突了。3.C++中域有函数局部域,全局域,命名空间域,类域;域影响的是编译时语法查找⼀个变量/函数/类型出处(声明或定义)的逻辑,所有有了域隔离,名字冲突就解决了。局部域和全局域除了会影响编译查找逻辑,还会影响变量的⽣命周期,命名空间域和类域不影响变量⽣命周期。
4.namespace只能定义在全局,当然他还可以嵌套定义。
5.项⽬⼯程中多⽂件中定义的同名namespace会认为是⼀namespace,不会冲突。
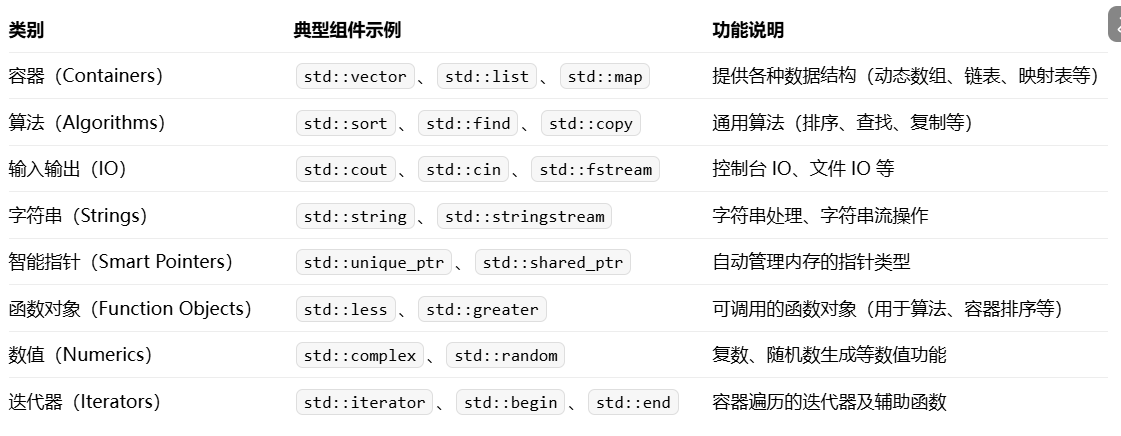
6.C++标准库都放在⼀个叫std(standard)的命名空间中。
//1.正常的命名空间定义
//rand、和Add函数
namespace ljy
{
	int rand = 10;
	int Add(const int&a, const int&b)  //在修饰a和b时要加上类型
	{
		return a + b;
	}
}


//main函数访问
int main()
{
	int a = 1; int b = 2;
	printf("%p\n", rand);  //这里默认访问的是地址
	printf("%d\n", ljy::Add(a, b));
	return 0;
}
注意这里访问rand,最后返回的是rand的地址
命名空间嵌套
#include<stdio.h>
#include<stdlib.h>

namespace Add
{
	namespace ljy
	{
		int rand = 1;
		int Add(const int&a,const int&b)
		{
			return a + b;
		}
	}

	namespace mgk
	{
		int rand = 2;
		int Add(const int& a, const int& b)
		{
			return a + b;
		}
	}
}

//打印
int main()
{
	printf("%d\n", Add::ljy::rand); //这里返回的就应该是%d,因为Add::ljy明确了rand是int
	printf("%d\n", Add::ljy::Add(1, 1));
	printf("%d\n", Add::mgk::rand);
	printf("%d\n", Add::ljy::Add(2,2));
	return 0;
}
这里打印的都是rand 第一个接受的是地址 第二个接受的是int
原因是,第一串代码我们是在标准库中寻找rand,标准库中的rand是一个函数,所以应当接受其地址。而第二个rand我们可以从Add::ljy中明确找到rand是一个int,因此接受并且打印时我们是以int来打印。
2. 命名空间的三种使用方法
第一种就是指定命名空间,大项目中通常采取这种方式
//指定命名空间访问
#include<stdio.h>
namespace ljy
{
	int a = 0;
}
int main()
{
	printf("%d\n",ljy:: a);
	return 0;
}
第二种将命名空间中的某个成员全部展开 using ljy::a
用于项目中某个成员不存在冲突的情况
//将命名空间某个成员全部展开
#include<stdio.h>
using ljy::a;
namespace ljy
{
	int a = 0;
	int b = 1;
}
int main()
{
	printf("%d\n", a); //指定命名空间访问
	printf("%d\n", ljy::b); //这里如果想访问b那么就必须指定ljy命名空间
	return 0;
}
第三中方式展开命名空间的全部成员,项目不推荐,平时练习推荐
//展开命名空间的全部成员
#include<stdio.h>
using namespace ljy;
namespace ljy
{
	int a = 0;
	int b = 1;
}
int main()
{
	printf("%d\n", a);
	printf("%d\n", b);
	return 0;
}
再探namespace——10/11补充
在后续类和对象底层逻辑实现的过程中,你会发现自定义的My_string、 My_vector 都会使用namespace来包含 string vector。
先下结论-> namespace用于以下三种场景
- 目前最频繁使用的场景一
防止项目内不同功能模块的命名冲突
// 网络模块
class Manager { /* 网络管理类 */ };

// 数据处理模块
class Manager { /* 数据管理类 */ };

// 主函数中使用
int main() {
    Manager m; // 编译错误:重定义
}
namespace Network {
    class Manager { /* 网络管理类 */ };
}

namespace Data {
    class Manager { /* 数据管理类 */ };
}

int main() {
    Network::Manager netMgr;
    Data::Manager dataMgr;
}
- 以后经常使用的场景二
防止不同模块 / 库之间的命名冲突
// 库A中的头文件
void func() { /* 库A的func实现 */ }

// 库B中的头文件
void func() { /* 库B的func实现 */ }

// 你的代码中同时包含这两个库
#include "libA.h"
#include "libB.h"

int main() {
    func(); // 编译错误:无法确定调用哪个func
}
// 库A
namespace LibA {
    void func() { /* 库A的func实现 */ }
}

// 库B
namespace LibB {
    void func() { /* 库B的func实现 */ }
}

// 你的代码
int main() {
    LibA::func(); // 明确调用库A的func
    LibB::func(); // 明确调用库B的func
}
- 着重理解的场景三
std库
3. C++输入流和输出流
• iostream 是 Input Output Stream 的缩写,是标准的输⼊、输出流库,定义了标准的输⼊、输 出对象。
• std::cin 是 istream 类的对象,它主要⾯向窄字符(narrow characters (of type char))的标准输⼊流。
std::cout 是 ostream 类的对象,它主要⾯向窄字符的标准输出流。
• std::endl是⼀个函数,流插⼊输出时,相当于插⼊⼀个换⾏字符加刷新缓冲区。
•<<是流插⼊运算符,>>是流提取运算符。(C语⾔还⽤这两个运算符做位运算左移/右移)
•使⽤C++输⼊输出更⽅便,不需要像printf/scanf输⼊输出时那样,需要⼿动指定格式,C++的输⼊输出可以⾃动识别变量类型(本质是通过函数重载实现的,这个以后会讲到),其实最重要的是 C++的流能更好的⽀持⾃定义类型对象的输⼊输出。
•IO流涉及类和对象,运算符重载、继承等很多⾯向对象的知识,这些知识我们还没有讲解,所以这 ⾥我们只能简单认识⼀下C++IO流的⽤法,后⾯我们会有专⻔的⼀个章节来细节IO流库。
•cout/cin/endl等都属于C++标准库,C++标准库都放在⼀个叫std(standard)的命名空间中,所以要通过命名空间的使⽤⽅式去⽤他们。
• ⼀般⽇常练习中我们可以using namespace std,实际项⽬开发中不建议using namespace std。
•这⾥我们没有包含<stdio.h>,也可以使⽤printf和scanf,在包含iostream间接包含了。vs系列编译器是这样的,其他编译器可能会报错。
#define _CRT_SECURE_NO_WARNINGS 1
#include <iostream>
using namespace std;
int main()
{
	int a = 0;
	double b = 0.1;
	char c = 'x';
	cout << a << " " << b << "  " << c << endl;
	std::cout << a << " " << b << "  " << c << std::endl;
	scanf("%d%lf", &a, &b);
	printf("%d %lf\n", a, b);
	// 可以⾃动识别变量的类型

	cin >> a;
	cin >> b >> c;
	cout << a << endl;
	cout << b << "  " << c << endl;
	return 0;
}
#include<iostream>
using namespace std;
int main()
{
	// 在io需求⽐较⾼的地⽅,如部分⼤量输⼊的竞赛题中,加上以下3⾏代码可以提⾼C++IO效率
	ios_base::sync_with_stdio(false);
	cin.tie(nullptr);
	cout.tie(nullptr);
}
二、缺省函数
1.缺省参数是声明或定义函数时为函数的参数指定⼀个缺省值。在调⽤该函数时,如果没有指定实参则采⽤该形参的缺省值,否则使⽤指定的实参,缺省参数分为全缺省和半缺省参数。(有些地⽅把缺省参数也叫默认参数)
2.全缺省就是全部形参给缺省值,半缺省就是部分形参给缺省值。C++规定半缺省参数必须从右往左依次连续缺省,不能间隔跳跃给缺省值。
3.带缺省参数的函数调⽤,C++规定必须从左到右依次给实参,不能跳跃给实参。
4.函数声明和定义分离时,缺省参数不能在函数声明和定义中同时出现,规定必须函数声明给缺省值。
//头文件
#include<iostream>
using namespace std;


//func函数
void Func(int a = 10)
{
	cout << a << endl;
}

int main()
{
	//没有传参fun()
	Func();
    //传参func(10)
	Func(20);
	return 0;
}
//头文件
#include<iostream>
using namespace std;


//全缺省
void Func1(int a = 11, int b = 22, int c = 33)
{
	cout << "a=" << a << endl;
	cout << "b=" << b << endl;
	cout << "c=" << c << endl;

}


//半缺省
void Func2(int a, int b=222, int c = 333)
{
	cout << "a=" << a << endl;
	cout << "b=" << b << endl;
	cout << "c=" << c << endl;
}


int main()
{
	Func1();//11 22 33
	Func1(1);//1 22 33
	Func1(1, 2);//1 2 33
	Func1(1, 2, 3);//1 2 3
	Func2(100);//100 222 333
	Func2(100, 200);//100 200 333
	Func2(100, 200, 300);//100 200 300
}
栈的创建
//头文件
#include<iostream>
#include<assert.h>
using namespace std;

typedef int STDateType;

//Stack结构体——使用typedef
typedef struct Stack
{
	STDateType* a;  //栈里面有3个变量a top capacity
	int top;
	int capacity;
}ST;

//STInit声明
void STInit(ST* ps, int n = 4);

//结构体初始化函数STInit
void STInit(ST*ps,int n)
{
	assert(ps && n > 0);
	ps->a = (STDateType*)malloc(sizeof(STDateType) * n);
	ps->top = 0;
	ps->capacity = n;
    //这里采用的是C语言中的写法,指针写法。后续讲到引用我们可以使用引用
}

int main()
{
	ST s1; //结构题定义
	STInit(&s1);//结构体初始化
    //调用函数
	ST s2;
	STInit(&s2, 1000);
	return 0;
}
三、函数重载
函数重载说白了就是相同的函数名,
1.可以是参数类型不同
2.可以是参数数量不同
3.可以是参数顺序不同
//头文件
#include<iostream>
using namespace std;
//1.参数类型不同  Add函数
int Add(int a, int b)
{
	cout << "int a+int b" << endl;
}
double Add(double a, double b)
{
	cout << "double a+double b" << endl;
}

//2.参数个数不同
void fun1()
{
	cout << "func1()" << endl;
}
void func1(int a)
{
	cout << "func1(int a)" << endl;
}

//3.参数顺序不同
void func2(char a, int b)
{
	cout << "char a ,int b" << endl;
}
void func2(int a, char b)
{
	cout << "int a,char b" << endl;
}

//4.错误样例
void func3()
{
	cout << "error" << endl;
}
void func3(int a = 100)
{
	cout << "error" << endl;
}


int main()
{
	Add(1, 2);
	Add(1.0, 2.0);
	//func1();
	func1(10);
	func2(1, 'a');
	func2('b', 3);
	return 0;
}
四、引用
1.引用的概念和定义
引用就相当于取别名
书写方式
类型& 引用别名=引用对象
#include<iostream>
using std::cout;
using std::endl;

int main()
{
	int a = 0;
	int& b = a;
	int& c = a;
	int& d = b;
	++d;

	cout << &a << endl;
	cout << &b << endl;
	cout << &c << endl;
	cout << &d << endl;

	return 0;
}
看到&a &b &c &d 的结果都是一样的
2.引用的特性
1.引用在定义时必须初始化
2.一个变量可以有多个引用
3.引用一旦引用一个实体,在不能引用其他实体
3.引用的使用
1.引用和类相结合可以减少拷贝次数
2.引用在C++中可以说比C中的指针还方便好用
3.引用和指针唯一不同是引用不可以改变指向
#include<iostream>
using namespace std;

//交换函数 采用引用
void Swap(int& c1, int& c2)
{
	int tmp;
	tmp = c1;
	c1 = c2;
	c2 = tmp;
}

int main()
{
	//交换前::
	int a = 0, b = 1;
	cout << a << " " << b << endl;
	//交换后::
	Swap(a, b);
	cout << a << " " << b << endl;
	return 0;
}
应用到栈上面代码
//头文件
#include<iostream>
#include<assert.h>
using namespace std;

//STDataType 是int型
typedef int STDateType;

//定义结构体 Stack为ST
typedef struct
{
	STDateType* a; int top; int capacity;
}ST;

//STInit函数构建 参数为 rs n=4
void STInit(ST&ps,int n =4) //这里是引用!!
{
	ps.a = (STDateType*)malloc(sizeof(STDateType) * n);
	ps.top = 0;
	ps.capacity = n;
}

//栈顶
void STPush(ST& ps, STDateType x)   //传入接受的参数
{
//——判断是否满了
	if (ps.top == ps.capacity)
	{
		printf("扩容");
		//——满了创建新容量newcapacity
		int newcapacity = ps.capacity == 0 ? 4 : ps.capacity * 2;
		//——接受新地址
		STDateType* tmp = (STDateType*)realloc(ps.a, newcapacity * sizeof(STDateType));
		//——判断是否为空地址
		if (tmp == NULL)
		{
			perror("realloc fail");
			return;
		}
		//更新地址和容量
		ps.a = tmp;
		ps.capacity = newcapacity;
	}
	//栈顶放X
    //栈顶往后平移一个单位
	ps.a[ps.top] = x;   //地址[数字]代表为止
	ps.top++;
}


//获取栈顶函数 STTop
int& STTop(ST& ps)
{
	assert(ps.top > 0);
	return ps.a[ps.top];
}

int main()
{
	// 调⽤全局的
	ST st1;
	STInit(st1);
	STPush(st1, 1);
	STPush(st1, 2);
	cout << STTop(st1) << endl;
	STTop(st1) += 10;
	cout << STTop(st1) << endl;
	return 0;
}
——补充,前后&的区别
int& STTop(ST& ps),前面&和后面&的区别非常大。前面&会保证其返回值不是拷贝后的数值,而是返回的它本身。后面&保证调用的是对栈对象的引用。 两者的区别是一个针对于return的返回值 一个针对于参数本身
更多推荐

 23
 0
- 0


 已为社区贡献4条内容

所有评论(0)