Ubuntu如何使用vLLM运行AI大模型
vLLM(高性能推理引擎)
-
能运行:✅
-
能调优:❌(推理专用)
-
适用场景:服务化、高并发
-
特点:显存效率高,吞吐强
“为大模型推理而生的高性能引擎”
它解决的核心问题
-
推理慢
-
显存浪费
-
并发差
通过:
-
PagedAttention
-
高效 KV Cache 管理
工程定位
-
高并发服务
-
生产环境
如何使用vLLM
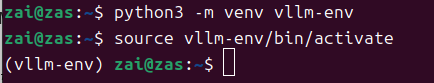
创建 vLLM 专用环境
python3 -m venv vllm-env source vllm-env/bin/activate
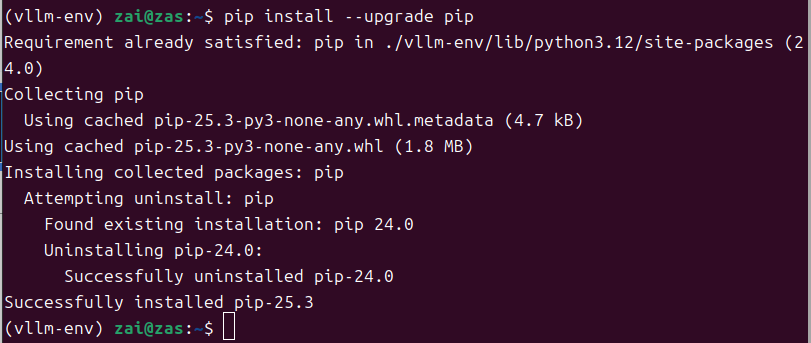
升级 pip
pip install --upgrade pip
确认 CUDA 版本
nvcc --version
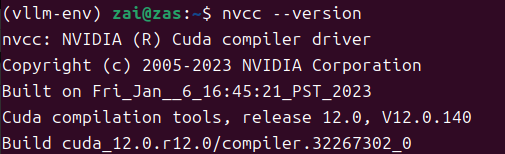
这里和我之前使用Transformers,nvidia-smi命令看到的CUDA版本是不一样的,搜索之后发现:
-
nvidia-smi(NVIDIA System Management Interface):查询的是显卡驱动内置的 CUDA Runtime API 版本(也叫 Driver API),代表你的显卡驱动最高支持到哪个 CUDA 版本。
-
nvcc --version:查询的是CUDA Toolkit(CUDA 工具包)的编译器版本(也叫 Runtime API),是你实际安装在系统中、用于编译 CUDA 程序的工具版本。
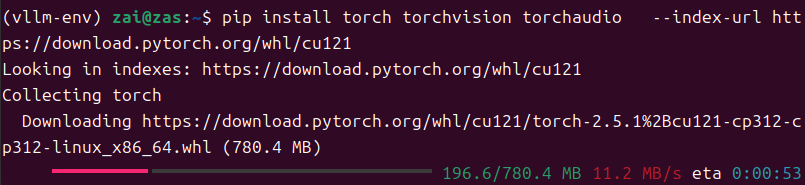
安装官方 CUDA 版 PyTorch(cu121 的 PyTorch 完全兼容 CUDA 12.0 Toolkit 和 13.0 驱动)
pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu121
安装 vLLM(核心)
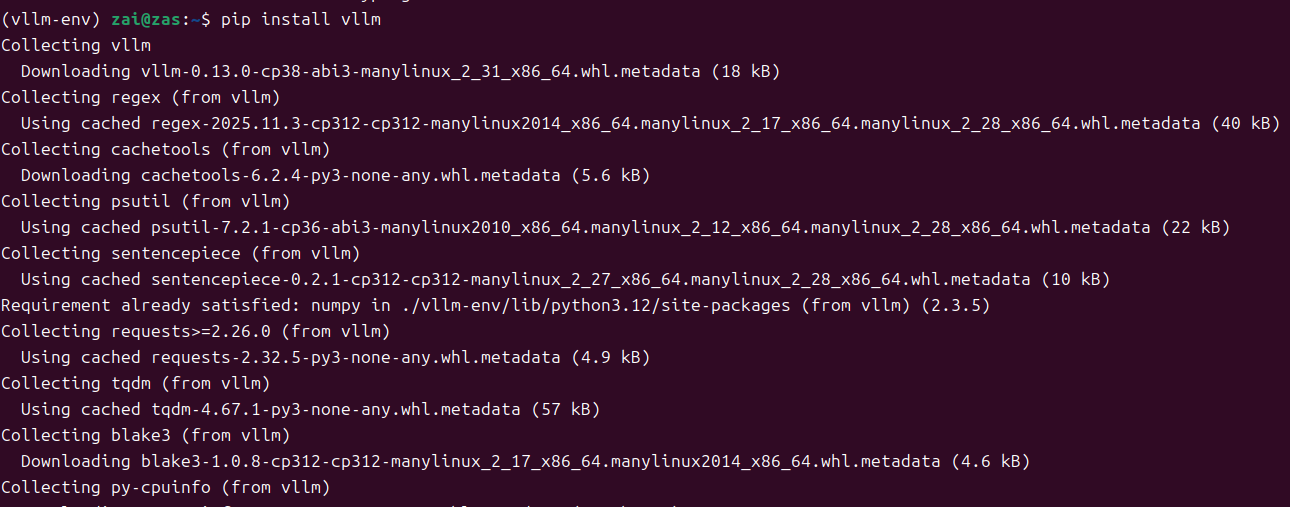
pip install vllm
vLLM 的核心使用方式有两种:Python API 调用(灵活)、命令行服务(快速部署)
方式 1:Python API 调用(推荐,适合开发 / 调试)
这是最灵活的方式,适合集成到自己的代码中,以qwen2.5:14B 模型为例:
新建文件vllm_demo.py,复制以下代码
from vllm import LLM, SamplingParams
import time

# ====================== 1. 核心配置 ======================
# 模型名称/本地路径(支持Hugging Face模型名、本地模型文件夹路径)
MODEL_NAME = "Qwen/Qwen-7B-Chat"  # 可替换为:Llama-2-7b-chat-hf、Baichuan2-7B-Chat等
# GPU相关配置(根据你的显卡显存调整)
GPU_MEM_UTIL = 0.8  # 显存利用率(80%,显存不足可调低至0.6-0.7)
TENSOR_PARALLEL_SIZE = 1  # 多GPU时调整(如2张GPU设为2)

# ====================== 2. 初始化LLM引擎 ======================
print(f"正在加载模型:{MODEL_NAME}...")
start_time = time.time()
# 初始化vLLM引擎(核心步骤,加载模型到GPU)
llm = LLM(
    model=MODEL_NAME,
    gpu_memory_utilization=GPU_MEM_UTIL,
    tensor_parallel_size=TENSOR_PARALLEL_SIZE,
    swap_space=4,  # 显存不足时启用磁盘交换(单位:GB)
    trust_remote_code=True,  # 加载自定义模型(如千问、百川)时必须设为True
    dtype="auto"  # 自动选择精度(显存足够用float16,不足用bfloat16)
)
load_time = time.time() - start_time
print(f"模型加载完成!耗时:{load_time:.2f}秒")

# ====================== 3. 配置生成参数 ======================
sampling_params = SamplingParams(
    temperature=0.7,  # 随机性(0=确定性,1=高随机)
    top_p=0.8,  # 核采样(只选累计概率≥0.8的token)
    max_tokens=500,  # 生成文本的最大长度
    stop=["<|endoftext|>", "</s>"],  # 停止生成的标识
    repetition_penalty=1.1  # 重复惩罚(避免生成重复内容)
)

# ====================== 4. 生成文本 ======================
# 待生成的提示词(支持批量输入)
prompts = [
    "请用简洁的语言介绍vLLM的核心优势",
    "写一个Python函数,实现快速排序算法,并添加注释",
    "解释一下什么是大语言模型的KV缓存,vLLM是如何优化它的"
]

# 批量生成
print("\n开始生成文本...")
start_time = time.time()
outputs = llm.generate(prompts, sampling_params)
generate_time = time.time() - start_time

# ====================== 5. 输出结果 ======================
print(f"\n生成完成!总耗时:{generate_time:.2f}秒,平均每条:{generate_time/len(prompts):.2f}秒")
print("="*80)
for i, output in enumerate(outputs):
    prompt = output.prompt
    generated_text = output.outputs[0].text
    print(f"\n【提示词{i+1}】:{prompt}")
    print(f"【生成结果{i+1}】:{generated_text}\n")
    print("-"*80)
运行脚本代码
python vllm_demo.py
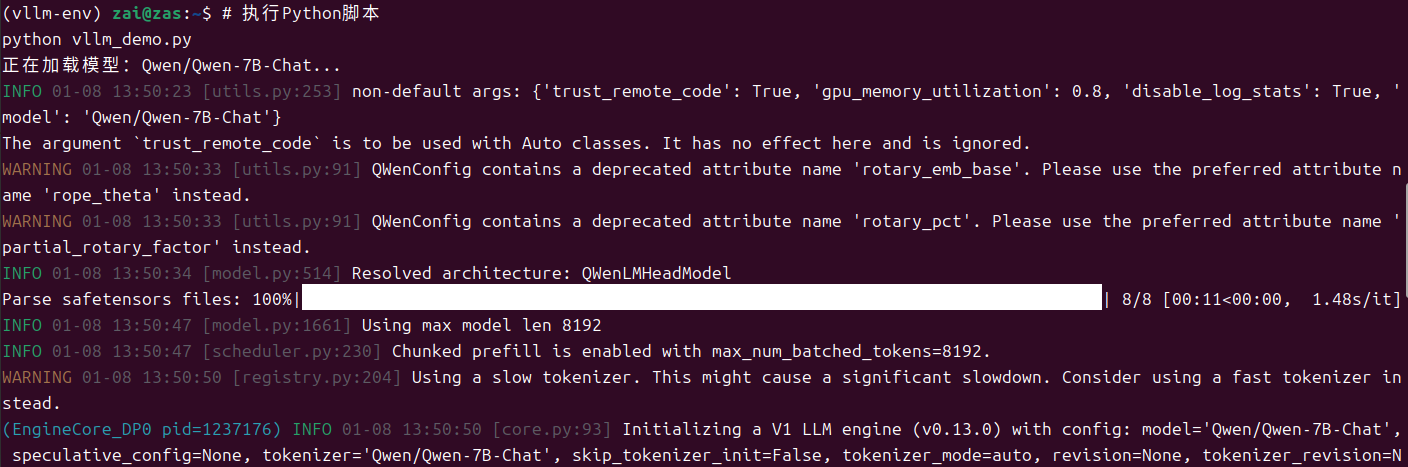
下载成功后运行时出现报错
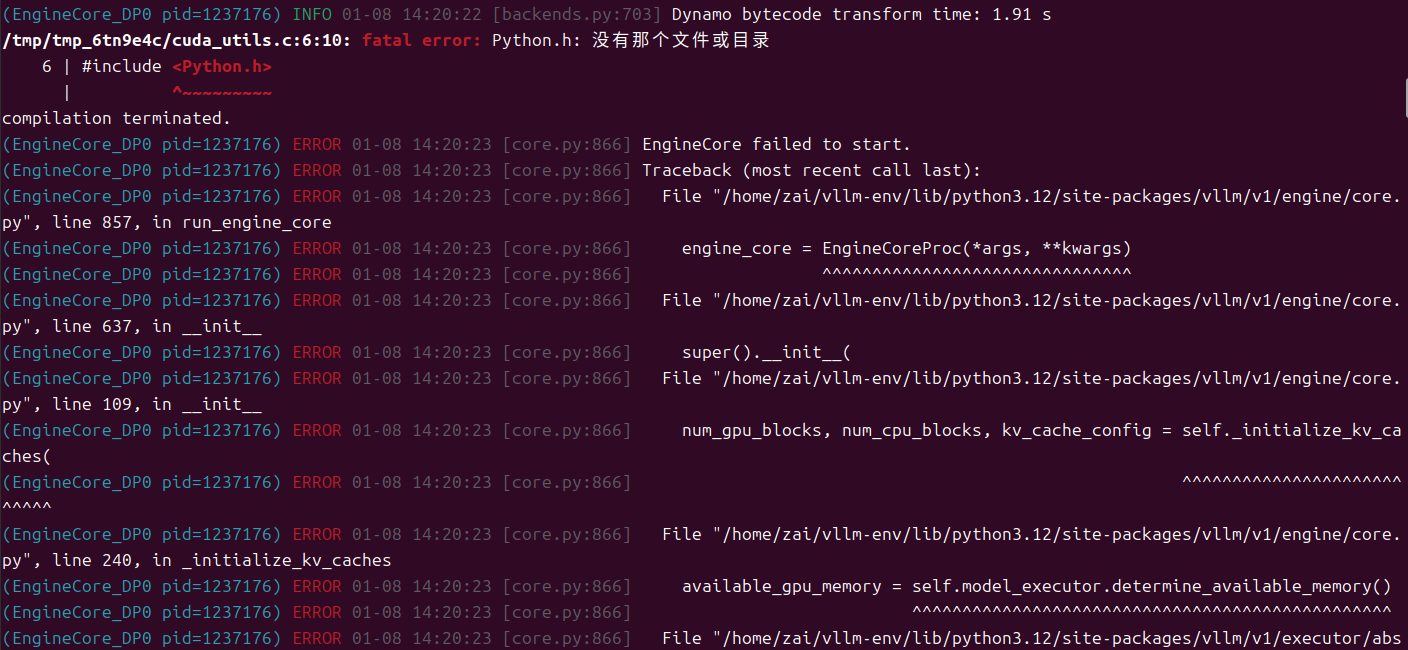
-
服务器只安装了 Python 3.12 的运行时(python3.12),但未安装开发包(python3.12-dev);
-
vLLM 依赖的 triton 库在编译 CUDA 工具类时,需要Python.h头文件,缺失后编译失败;
-
后续的InductorError/CalledProcessError都是这个编译失败的连锁反应,并非模型或显存问题
执行以下命令安装 Python 3.12 的开发包(适配系统):
sudo apt update && sudo apt install -y python3.12-dev gcc
出现报错
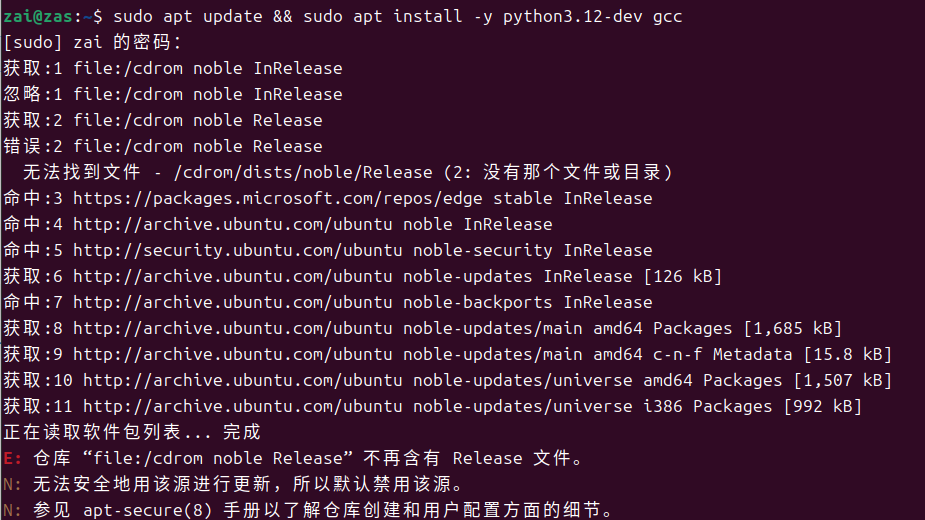
执行sudo apt update时遇到了cdrom源的错误,这是因为系统中残留了光驱(CDROM)的软件源配置,但实际没有挂载光驱,导致更新失败
不过这个错误不影响安装python3.12-dev和gcc—— 我们可以先禁用 CDROM 源,再单独安装所需依赖
执行以下命令编辑 apt 源配置,注释掉 CDROM 相关行:
sudo nano /etc/apt/sources.list
注释这一行配置

CDROM 源报错不影响已有的 Ubuntu 官方源,直接执行安装命令即可:
# 直接安装python3.12-dev和gcc(无需先update)
sudo apt install -y python3.12-dev gcc

# 验证安装成功(能找到Python.h则正常)
find /usr/include -name "Python.h" | grep 3.12
# ✅ 正常输出:/usr/include/python3.12/Python.h

安装完开发包后,回到虚拟环境重装依赖:
# 激活vllm-env虚拟环境
source ~/vllm-env/bin/activate

# 卸载triton和vLLM
pip uninstall triton vllm -y

# 重装vLLM 0.13.0(自动编译适配的扩展)
pip install vllm==0.13.0
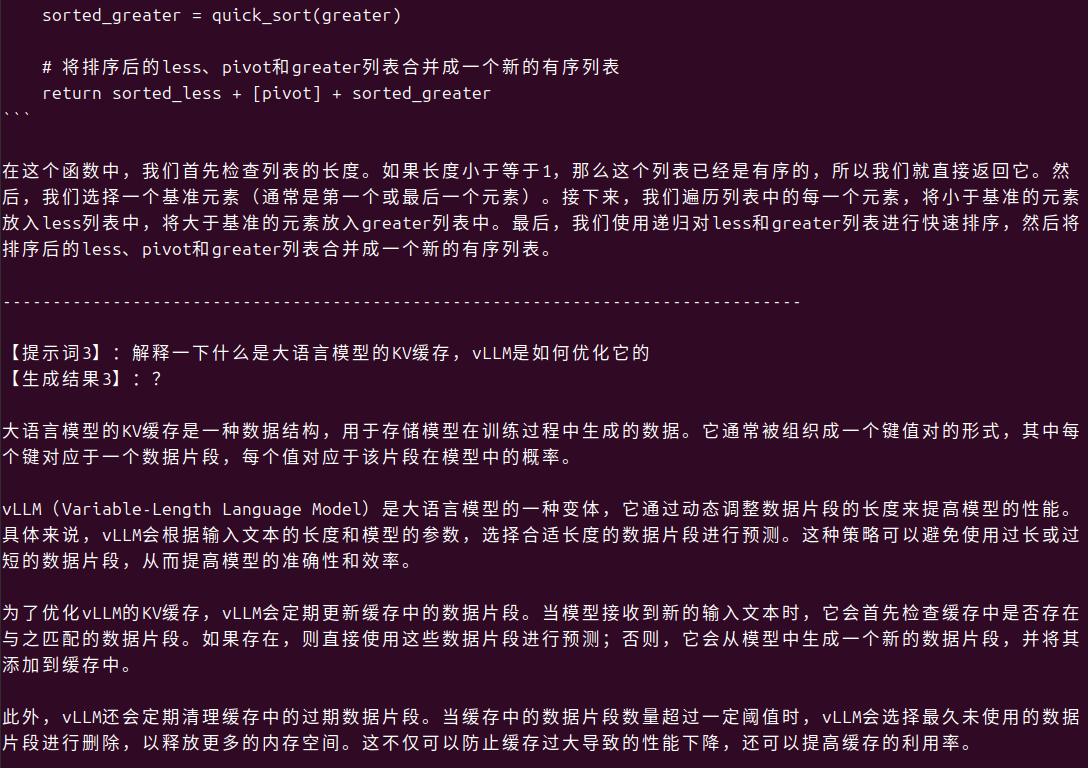
再次运行脚本
python vllm_demo.py
方式 2:命令行启动 API 服务(适合部署)
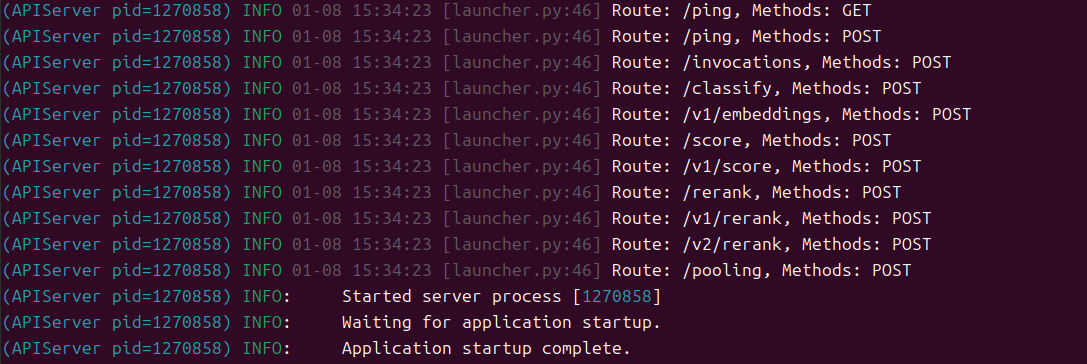
启动 vLLM 服务
# 启动API服务(参数和Python API对应)
python -m vllm.entrypoints.openai.api_server \
  --model Qwen/Qwen-7B-Chat \
  --gpu-memory-utilization 0.8 \
  --tensor-parallel-size 1 \
  --trust-remote-code True \
  --port 8000  # 服务端口
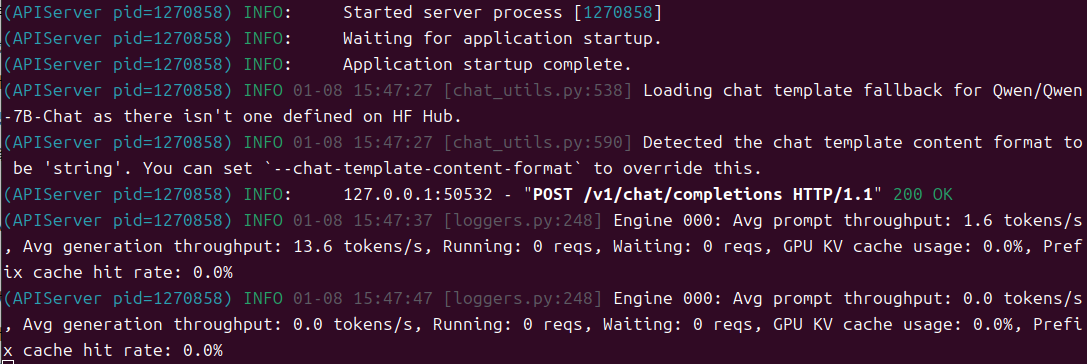
启动成功
新建一个终端窗口,新建文件
nano call_vllm_api.py
复制以下内容
import requests
import json

url = "http://localhost:8000/v1/chat/completions"
headers = {"Content-Type": "application/json"}
data = {
    "model": "Qwen/Qwen-7B-Chat",
    "messages": [
        {"role": "user", "content": "请介绍vLLM的部署优势"}
    ],
    "temperature": 0.7,
    "max_tokens": 500
}

response = requests.post(url, headers=headers, data=json.dumps(data))
result = response.json()
print("生成结果:", result["choices"][0]["message"]["content"])
运行调用代码
python call_vllm_api.py
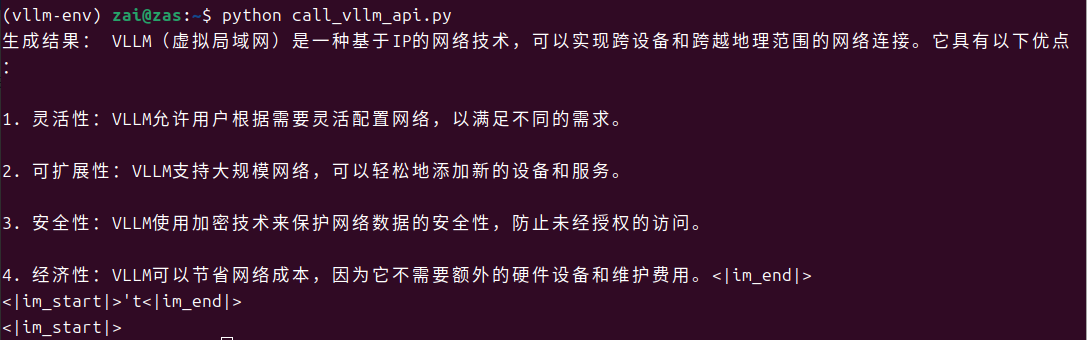
此时能看到运行中的终端窗口有相应的输出
这两种方式的本质区别
方式 1(Python API)= 把 vLLM 当成“库”用(嵌入式)
方式 2(API 服务)= 把 vLLM 当成“模型服务器”用(服务化)
模型本身、推理算法、性能优化是一样的
方式 1:Python API(嵌入式)
想象成:
Python 程序 └── vLLM 引擎 └── GPU 上的模型
特点:
-
模型是 程序的一部分
-
程序退出 → 模型释放
-
更像 Transformers 的“升级版”
方式 2:API 服务(服务化)
想象成:
vLLM 服务进程(常驻) └── GPU 上的模型 ↑ 多个客户端(Web / App / Spring / curl)
特点:
-
模型是 系统级资源
-
一个模型 → 多用户共享
-
支持高并发 / 排队 / KV cache 复用
免费领 150 小时云算力,进群参与显卡、AI PC 幸运抽奖
更多推荐
 13
 0
- 0


 已为社区贡献1条内容

所有评论(0)