
AI开发新范式:Loop Engineering循环工程,让Agent自主运行引爆2026科技圈!
6月7日,OpenClaw创始人Peter Steinberger发了条推文:“你不应该再给编程Agent写提示词了。你应该设计循环来提示你的Agent。”
一周后,520万次浏览。评论区吵成了一锅粥——有人质疑token烧不起,有人讽刺这又是在炒概念,毕竟上一个月大家还在讨论Harness Engineering。
但不管争议多大,一个事实摆在这里:Claude Code的创造者Boris Cherny在红杉资本AI Ascent 2026大会上说,"我不再提示Claude了。我有运行中的循环在提示Claude,并决定接下来做什么。我的工作是写循环。"Google Cloud AI总监Addy Osmani在同一天发长文,正式把这个东西命名为Loop Engineering(循环工程)。
三个人,同一周,说同一件事。不太像巧合。
什么是Loop Engineering?
一句话:把你从"提示Agent的那个人"的位置挪开,改成设计一个系统替你干这件事。
听起来有点抽象?拆开看。
传统编程里,循环做的事很明确——写个for遍历数组,机器就从第一个走到最后一个。每次都是同一套逻辑,处理方式固定。碰到A怎么应对,B怎么应对,全得提前写好,用if和else分清楚。
但现实任务有太多变数,你不可能预见所有情况。没设定过的情况一出现,就出Bug。
Agent Loop不一样。它执行的不再是"指令",而是"目标":
目标 → 行动 → 观察 → 评估 → 修正 → 下一轮行动
每一步都不固定。Agent观察当前状态,判断该干什么,干了再看结果,评估够不够格,不够就改。够了,循环终止。
Loop Engineering就是围绕这个Agent Loop造一整套系统——自动发现任务、分配任务、检查结果、记录状态、决定下一步,直到目标达成。而你,从"每一轮都要手动敲指令的人",变成了"设计这套系统的人"。
四次跃迁:从Prompt到Loop
这不是凭空冒出来的概念。时间线拉长,AI协作范式已经迭代了四轮:
第一轮,Prompt Engineering(2022-2024)。核心问题:我该对模型说什么?人的角色是打字员,ROI就是一次交互的质量。
第二轮,Context Engineering(2025年中)。核心问题:该给模型看什么信息?人变成了上下文策展人,Karpathy和Shopify创始人Tobi Lütke是主要推动者。
第三轮,Harness Engineering(2026年2月)。核心问题:该围绕模型造什么系统?人升级成了系统架构师,HashiCorp创始人Mitchell Hashimoto提出这个概念,关注的是单次运行的可靠性。
第四轮,Loop Engineering(2026年6月)。核心问题:怎么让这个系统自己跑起来?人是循环架构师,ROI变成了无人值守的持续产出。
每次跃迁干的事情都一样:把人的角色往更高抽象层推,把更多执行细节甩给基础设施。说白了,人一步步退场。
但有个澄清很重要:四层是叠加关系,不是替代关系。Prompt不会消失——loop本身就由prompt构成;Context不会消失——loop每个turn还得把对的文件喂给模型;Harness不会消失——loop叠在Harness之上跑。就像操作系统没取代编程语言,Loop也不会取代前面任何一层。
Loop Stack:六个核心组件
Addy Osmani和清华大学《2026循环工程研究报告》把Loop Engineering拆成了六块,叫Loop Stack:
-
- Automations(自动化心跳)——不是跑一次就完事,而是按计划自动执行。Codex的Automations tab里选项目、写提示、设频率,跑出结果进Triage收件箱;Claude Code通过/loop指令、cron任务和GitHub Actions实现。OpenAI内部拿它做日常issue分类、汇总CI失败、写commit简报。
-
- Worktrees(工作树)——解决多Agent并行的文件冲突。每个Agent有自己的工作目录,共享同一个仓库历史,但编辑互不干扰。不过工具只解决了机械冲突,人的审查带宽才是真正的并行瓶颈。
-
- Skills(技能文档)——沉淀项目知识,不用每次从头解释项目。格式是一个文件夹,放SKILL.md写指令和元数据,再加可选脚本和参考文件。解决的是"意图债务"——Agent每次启动都是冷启动,你意图有漏洞它就自信地猜。
-
- Connectors(外部连接器)——打通业务系统、数据库与API,让Agent能访问外部数据源。
-
- Sub-agents(子智能体)——权责分离,交叉验收。生成器负责构建,评估器负责批判和打分。Anthropic的做法很有意思:评估器有独立的上下文窗口和系统提示词,用Playwright真正打开网页测试,而不只是阅读代码diff。借鉴了GAN的思想——生成器和评估器对抗着互相提升。
-
- Memory(持久化记忆)——保障跨会话的任务延续。Agent每次运行都会忘,但文件不会。用仓库持久化存储任务状态,解决上下文丢失问题。
最关键的东西:闸门
Osmani还有个三件套拆法:节奏(Cadence)、闸门(Gate)、反馈(Feedback)。
节奏——Agent什么时候跑、跑多频繁。不是"人叫一声动一下",而是按定时器自主触发。
闸门——Agent怎么知道任务做完了。这是最核心的部分。没有闸门的循环就是烧钱机器。Simon Taylor说得好:“写循环是标题党,写闸门才是真正的工作。”
反馈——Agent做错了怎么自我纠正。不依赖"记得要检查",而是用Hooks这类确定性机制把错误注回Agent上下文。
把人从循环里移出去,换成测试、Hook、定时任务。人的角色从"逐行指挥"变成"设计验收标准+偶尔看看结果"。
清华的报告走得更远,提了九大创新概念,有几个值得拎出来说:
Proof-of-Done——用外部客观证据判定任务完成,不让模型自己说了算。Agent不能自己说"我做完了",得CI通过、测试绿灯、代码审查批准,这些才是真正的完成信号。
评估闸门——独立评估,Agent产出和人类决策隔离。Agent做的东西不是直接上线,而是进收件箱缓冲区,等人拍板。
循环账本——全程记录成本、变更与缺陷,让每次循环的消耗有据可查。
还有四大反模式,清华直接标了"严禁":无限循环、直接开放生产写权限、以运行时长为考核指标、生成者自验收。每一条背后都有真实的踩坑经历。
到底谁在用?
Boris Cherny的工作流听起来像科幻:夜间跑几千个AI Agent,通过Claude App管理,每天从手机上发几十个PR。Claude Code从2026年3月起已经100%由自己编写自己了。
Anthropic内部用的是"生成器-评估器-规划器"三层:规划器把一句话需求拆成高层规格和冲刺阶段,生成器负责构建,评估器负责批判打分。评估器不看代码diff,而是用Playwright打开网页真测。
更接地气的案例是"PR守夜Loop":每20分钟检查当前PR的CI状态,失败了就读日志、判断问题、在独立worktree里修复、跑测试、通过了推送。你睡觉,Agent修Bug。
争议:这玩意谁烧得起?
质疑不是没道理。
每一次Loop迭代就是一次完整的提示词执行。1分钟跑一次,连续8小时,480次API调用。更麻烦的是"字符膨胀"——Agent产出的冗余内容越来越多,烧token的速度比你想的快。
有人问Peter Steinberger,20美元套餐不够用怎么办?他的回答:“你的时间不值钱吗?”
这话听着轻巧,但背后有个逻辑链:Loop Engineering有四个前提条件,缺一个都不成立——任务会重复、验证可自动化、Token预算能承受浪费、Agent已经拥有高级工程师会用的工具。大多数中小团队和个人开发者,至少有两三条目前还够不到。
还有个更深层的问题:认知负债。调试一个跑了47轮的状态机,比修好一个prompt难10倍。你把复杂性从"每一轮手动指挥"转移到了"设计一个自治系统",但复杂性没有消失,它只是换了个地方住。
01
什么是AI大模型应用开发工程师?
如果说AI大模型是蕴藏着巨大能量的“后台超级能力”,那么AI大模型应用开发工程师就是将这种能量转化为实用工具的执行者。
AI大模型应用开发工程师是基于AI大模型,设计开发落地业务的应用工程师。
这个职业的核心价值,在于打破技术与用户之间的壁垒,把普通人难以理解的算法逻辑、模型参数,转化为人人都能轻松操作的产品形态。
无论是日常写作时用到的AI文案生成器、修图软件里的智能美化功能,还是办公场景中的自动记账工具、会议记录用的语音转文字APP,这些看似简单的应用背后,都是应用开发工程师在默默搭建技术与需求之间的桥梁。
他们不追求创造全新的大模型,而是专注于让已有的大模型“听懂”业务需求,“学会”解决具体问题,最终形成可落地、可使用的产品。
CSDN粉丝独家福利
给大家整理了一份AI大模型全套学习资料,这份完整版的 AI 大模型学习资料已经上传CSDN,朋友们如果需要可以扫描下方二维码&点击下方CSDN官方认证链接免费领取 【保证100%免费】
02
AI大模型应用开发工程师的核心职责
需求分析与拆解是工作的起点,也是确保开发不偏离方向的关键。
应用开发工程师需要直接对接业务方,深入理解其核心诉求——不仅要明确“要做什么”,更要厘清“为什么要做”以及“做到什么程度算合格”。
在此基础上,他们会将模糊的业务需求拆解为具体的技术任务,明确每个环节的执行标准,并评估技术实现的可行性,同时定义清晰的核心指标,为后续开发、测试提供依据。
这一步就像建筑前的图纸设计,若出现偏差,后续所有工作都可能白费。
技术选型与适配是衔接需求与开发的核心环节。
工程师需要根据业务场景的特点,选择合适的基础大模型、开发框架和工具——不同的业务对模型的响应速度、精度、成本要求不同,选型的合理性直接影响最终产品的表现。
同时,他们还要对行业相关数据进行预处理,通过提示词工程优化模型输出,或在必要时进行轻量化微调,让基础模型更好地适配具体业务。
此外,设计合理的上下文管理规则确保模型理解连贯需求,建立敏感信息过滤机制保障数据安全,也是这一环节的重要内容。
应用开发与对接则是将方案转化为产品的实操阶段。
工程师会利用选定的开发框架构建应用的核心功能,同时联动各类外部系统——比如将AI模型与企业现有的客户管理系统、数据存储系统打通,确保数据流转顺畅。
在这一过程中,他们还需要配合设计团队打磨前端交互界面,让技术功能以简洁易懂的方式呈现给用户,实现从技术方案到产品形态的转化。
测试与优化是保障产品质量的关键步骤。
工程师会开展全面的功能测试,找出并修复开发过程中出现的漏洞,同时针对模型的响应速度、稳定性等性能指标进行优化。
安全合规性也是测试的重点,需要确保应用符合数据保护、隐私安全等相关规定。
此外,他们还会收集用户反馈,通过调整模型参数、优化提示词等方式持续提升产品体验,让应用更贴合用户实际使用需求。
部署运维与迭代则贯穿产品的整个生命周期。
工程师会通过云服务器或私有服务器将应用部署上线,并实时监控运行状态,及时处理突发故障,确保应用稳定运行。
随着业务需求的变化,他们还需要对应用功能进行迭代更新,同时编写完善的开发文档和使用手册,为后续的维护和交接提供支持。
03
薪资情况与职业价值
市场对这一职业的高度认可,直接体现在薪资待遇上。
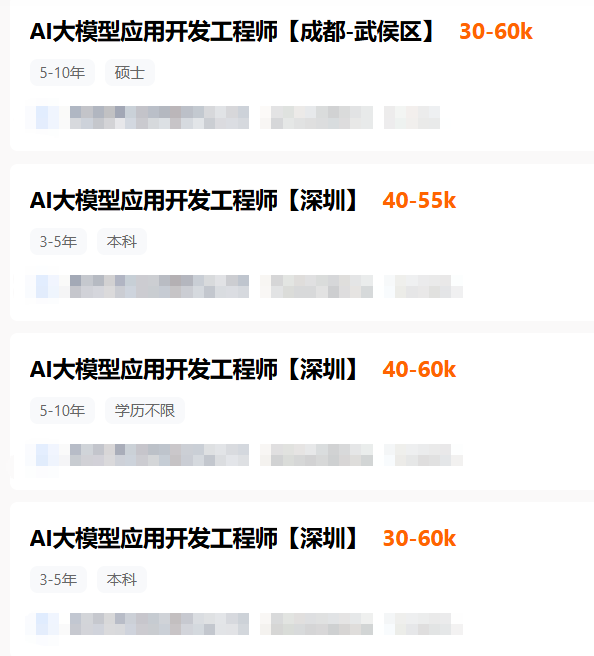
据猎聘最新在招岗位数据显示,AI大模型应用开发工程师的月薪最高可达60k。
在AI技术加速落地的当下,这种“技术+业务”的复合型能力尤为稀缺,让该职业成为当下极具吸引力的就业选择。
AI大模型应用开发工程师是AI技术落地的关键桥梁。
他们用专业能力将抽象的技术转化为具体的产品,让大模型的价值真正渗透到各行各业。
随着AI场景化应用的不断深化,这一职业的重要性将更加凸显,也必将吸引更多人才投身其中,推动AI技术更好地服务于社会发展。
CSDN粉丝独家福利
给大家整理了一份AI大模型全套学习资料,这份完整版的 AI 大模型学习资料已经上传CSDN,朋友们如果需要可以扫描下方二维码&点击下方CSDN官方认证链接免费领取 【保证100%免费】

小龙虾开发者社区是 CSDN 旗下专注 OpenClaw 生态的官方阵地,聚焦技能开发、插件实践与部署教程,为开发者提供可直接落地的方案、工具与交流平台,助力高效构建与落地 AI 应用
更多推荐


 5
 0
- 0


 已为社区贡献25条内容

所有评论(0)