医学RAG系统大揭秘:80k+专家评估揭示真相,收藏这份改进策略避坑指南
耶鲁大学等机构对医学RAG系统进行大规模评估,发现其存在三重失效:仅22%检索内容相关,模型无法有效整合证据,事实准确性和完整性反而下降6%。研究提出证据过滤和查询重构两大改进策略,可显著提升模型性能。该研究对医学AI从业者具有重要指导意义,提醒我们不应盲目应用RAG,而需针对性解决关键问题。
文章摘要
耶鲁大学等顶级机构研究发现,广泛应用于医学领域的检索增强生成(RAG)系统存在重大缺陷:仅22%的检索内容相关,事实准确性和完整性反而下降6%。18位医学专家贡献80,502个标注,系统揭示RAG在医学应用中的关键问题并提出改进策略。
原文PDF - https://t.zsxq.com/FRJjN
正文
引言:医学AI的双重挑战
大型语言模型(LLMs)正在革命性地改变医学领域,从医学问答到疾病诊断,再到治疗规划,应用范围不断扩大。然而,两个核心挑战始终存在:如何跟上快速发展的医学知识以及如何提供可验证的、基于证据的推理。
医学知识更新频繁,临床指南和药物信息经常因新证据出现而修订。对六个主流LLMs的系统评估显示,它们在回答新批准药物相关问题时表现持续低迷。更重要的是,在医学领域,仅提供决策或建议是不够的,医疗专业人员需要可信的证据支撑,特别是在不确定或高风险情况下。
RAG:被寄予厚望的解决方案
检索增强生成(RAG)作为一种有前途的范式应运而生,旨在通过在推理时融入外部证据来帮助模型获取最新信息并提高回应的事实性和可信度。
标准RAG管道包含三个主要阶段:
-
文档准备
:选择领域特定文档,分割成段落,编码为向量表示构建可搜索数据库
-
检索
:给定用户查询,系统检索最相关的top-k段落并附加到输入提示中
-
生成
:LLM整合检索段落和查询生成最终回应
这种架构具有显著优势:LLMs无需重新训练即可访问最新信息,用户可以提供领域特定和权威的知识来源。
研究设计:史上最大规模专家评估
尽管RAG在医学领域应用日益广泛,但很少有研究系统性地检验其实际表现。大多数现有研究将RAG框架视为黑箱,只评估最终任务性能,而不分析检索质量或证据使用等中间步骤。
本研究进行了迄今为止医学RAG领域最全面的专家评估。18位医学专业人员贡献了总计80,502个专家标注,评估了GPT-4o和Llama-3.1-8B在200个真实世界患者查询和USMLE风格查询上的800个模型输出。
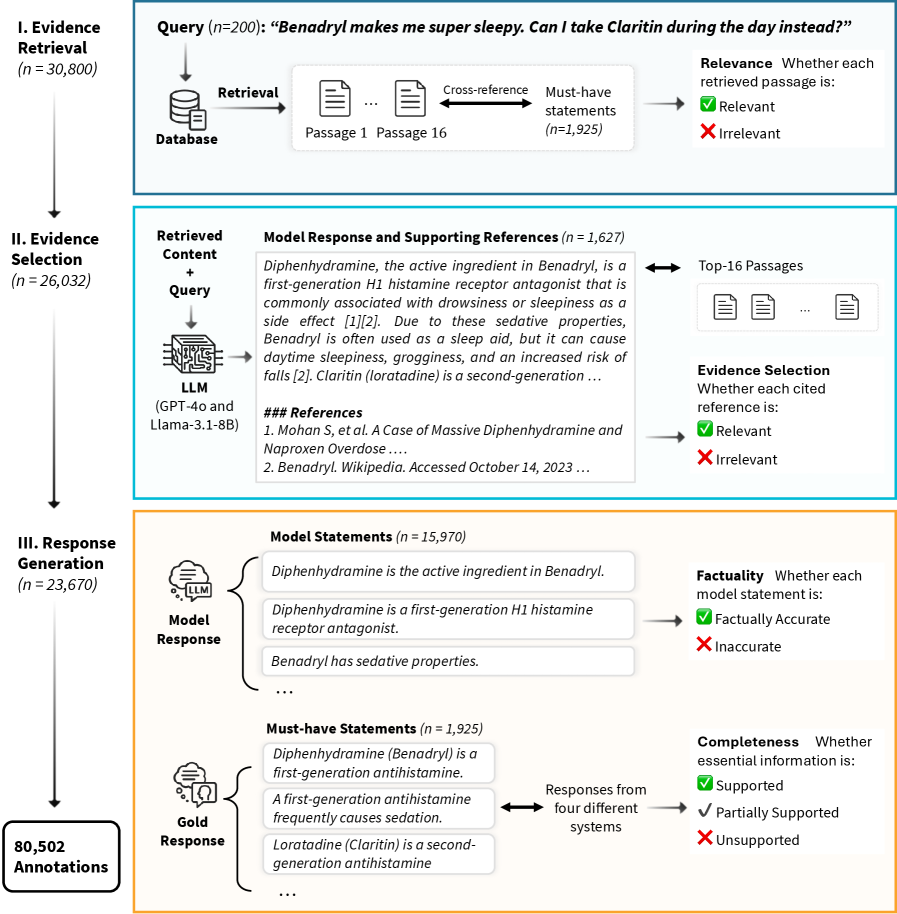 图1:研究设计和评估框架。精细化框架将RAG管道分解为三个组件,实现对每个阶段的系统评估
评估框架系统性地将RAG管道分解为三个组件:
I. 证据检索:评估检索段落的相关性和覆盖率,确定其是否提供足够信息来逻辑推断正确答案的关键要素
II. 证据选择:评估LLMs是否有效地将检索段落纳入回应中,测量回应中引用的检索文档比例
III. 回应生成:在头对头评估中比较有无RAG的LLM最终输出,关注事实准确性和完整性
核心发现:RAG的三重失效
1. 证据检索:相关性严重不足
研究结果令人震惊:检索性能严重受限,大多数检索段落未能提供相关支持。
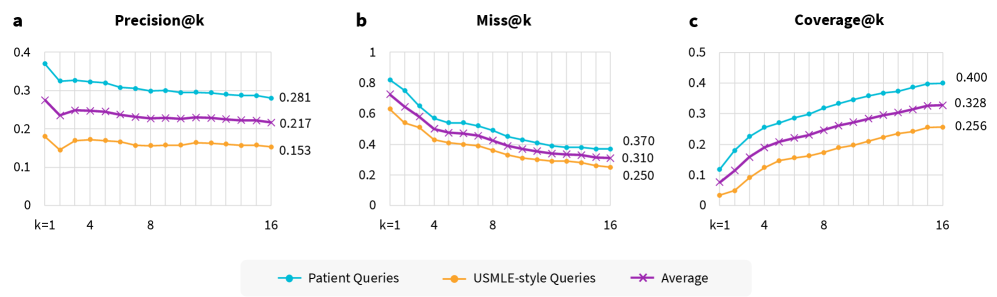 图2:不同评估指标和查询类型下的证据检索性能
关键数据显示:
-
精度极低
:在top-16段落中,仅约22%被判定为相关,USMLE查询更低至15%
-
遗漏率高
:31%的查询在top-16检索结果中没有任何相关段落,USMLE查询高达37%
-
覆盖率不足
:仅33%的必备陈述得到top-16检索段落的支持,USMLE查询仅26%
2. 证据选择:模型判断力缺失
即使检索到相关段落,LLMs往往无法有效整合。两个模型的精度和召回率都很低:GPT-4o精度41%、召回率49%;Llama-3.1精度43%、召回率仅28%。
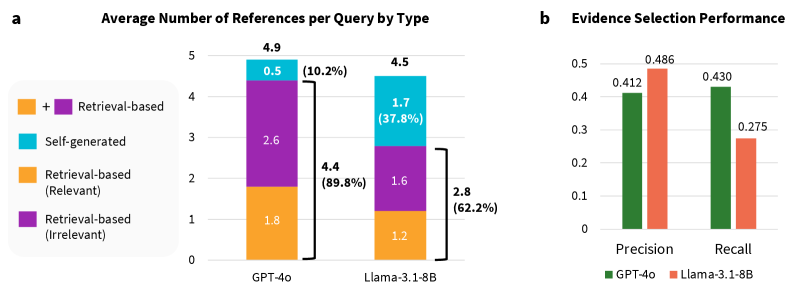 图3:引用类型和证据选择性能分析
更令人担忧的是:
-
误引频繁
:GPT-4o平均每个查询引用2.6个不相关段落,Llama-3.1引用1.6个
-
相关证据利用不足
:GPT-4o平均引用1.8个相关段落,而可用相关段落约3.5个
-
自生成引用问题
:Llama-3.1的自生成引用中77.2%无法验证,存在大量虚构元数据
3. 回应生成:质量反而下降
最关键的发现是,RAG设置下两个模型的事实准确性和完整性都有所下降:
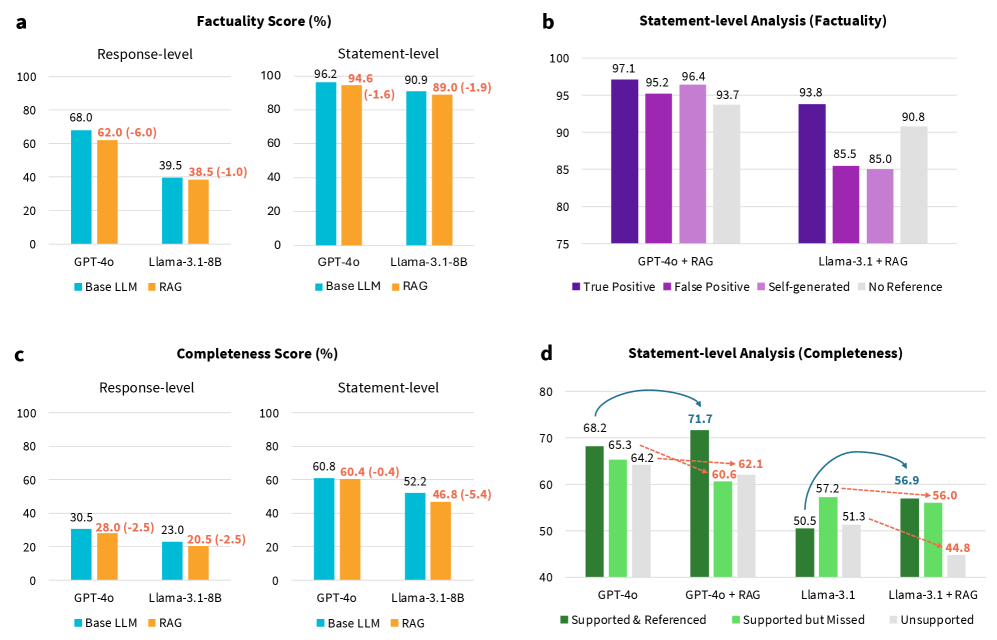 图4:模型回应的事实准确性和完整性
具体表现:
-
事实准确性下降
:GPT-4o回应级别下降6.0%,Llama-3.1下降1.0%
-
完整性降低
:两个模型回应级别都下降2.5%,Llama-3.1陈述级别下降5.4%
-
整体准确率下降
:GPT-4o从71.1%降至70.5%,Llama-3.1从49.4%降至45.8%
深度分析:失效原因
研究进一步分析了不同证据类型对模型性能的影响:
-
相关证据支撑时表现最佳
:GPT-4o达97.1%,Llama-3.1达93.8%
-
不相关证据影响显著
:特别是Llama-3.1降至85.5%,显示对噪声证据更敏感
-
自生成证据风险高
:Llama-3.1降至85.0%,更容易产生幻觉
突破性改进策略
针对发现的问题,研究提出了两个简单而有效的策略:
-
证据过滤
:移除不相关段落,减少噪声干扰
-
查询重构
:重写初始查询以引导检索获取更相关证据
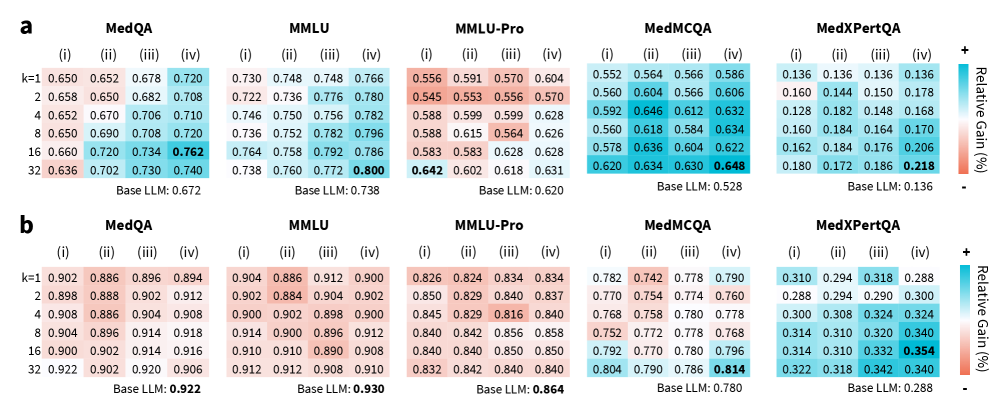 图5:RAG变体和非RAG基线在五个QA数据集上的性能
结合两种策略后,在更具挑战性的数据集上取得显著提升:
-
Llama-3.1
:MedMCQA提升12%,MedXpertQA提升8.2%
-
GPT-4o
:MedMCQA提升3.4%,MedXpertQA提升6.6%
研究意义与启示
这项研究对医学RAG领域具有重要意义:
- 重新审视RAG作用:尽管前景看好,但RAG管道会引入新的失效源,包括检索不相关信息、无法整合相关证据以及降低输出的事实准确性和完整性
- 系统性评估必要性:通过大量专家标注系统评估RAG过程的每个阶段,识别了之前研究中被忽视的关键瓶颈
- 设计思路转变:前进之路不在于将RAG作为默认解决方案,而在于重新思考其系统设计和评估方法
未来展望
研究强调了分阶段感知评估和深思熟虑系统设计对可靠医学LLM应用的重要性。这些发现要求重新审视RAG在医学领域的角色,不应盲目应用,而需要针对性的干预措施来解决识别出的关键问题。
通过证据过滤和查询重构等目标干预措施,可以在具有挑战性的医学任务上大幅提升性能,这表明精心设计的RAG系统仍然具有巨大潜力,关键在于如何正确实施。
结论
这项迄今为止最大规模的医学RAG专家评估揭示了一个令人深思的现实:被广泛采用的RAG系统在医学领域存在严重缺陷,但通过科学的分析和有针对性的改进,仍可以实现显著提升。对于医学AI的从业者和投资者而言,这项研究提供了宝贵的实践指导和战略洞察。
如何学习大模型 AI ?
由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。
但是具体到个人,只能说是:
“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。
我在一线科技企业深耕十二载,见证过太多因技术卡位而跃迁的案例。那些率先拥抱 AI 的同事,早已在效率与薪资上形成代际优势,我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在大模型的学习中的很多困惑。我们整理出这套 AI 大模型突围资料包:
- ✅ 从零到一的 AI 学习路径图
- ✅ 大模型调优实战手册(附医疗/金融等大厂真实案例)
- ✅ 百度/阿里专家闭门录播课
- ✅ 大模型当下最新行业报告
- ✅ 真实大厂面试真题
- ✅ 2025 最新岗位需求图谱
所有资料 ⚡️ ,朋友们如果有需要 《AI大模型入门+进阶学习资源包》,下方扫码获取~
① 全套AI大模型应用开发视频教程
(包含提示工程、RAG、LangChain、Agent、模型微调与部署、DeepSeek等技术点)
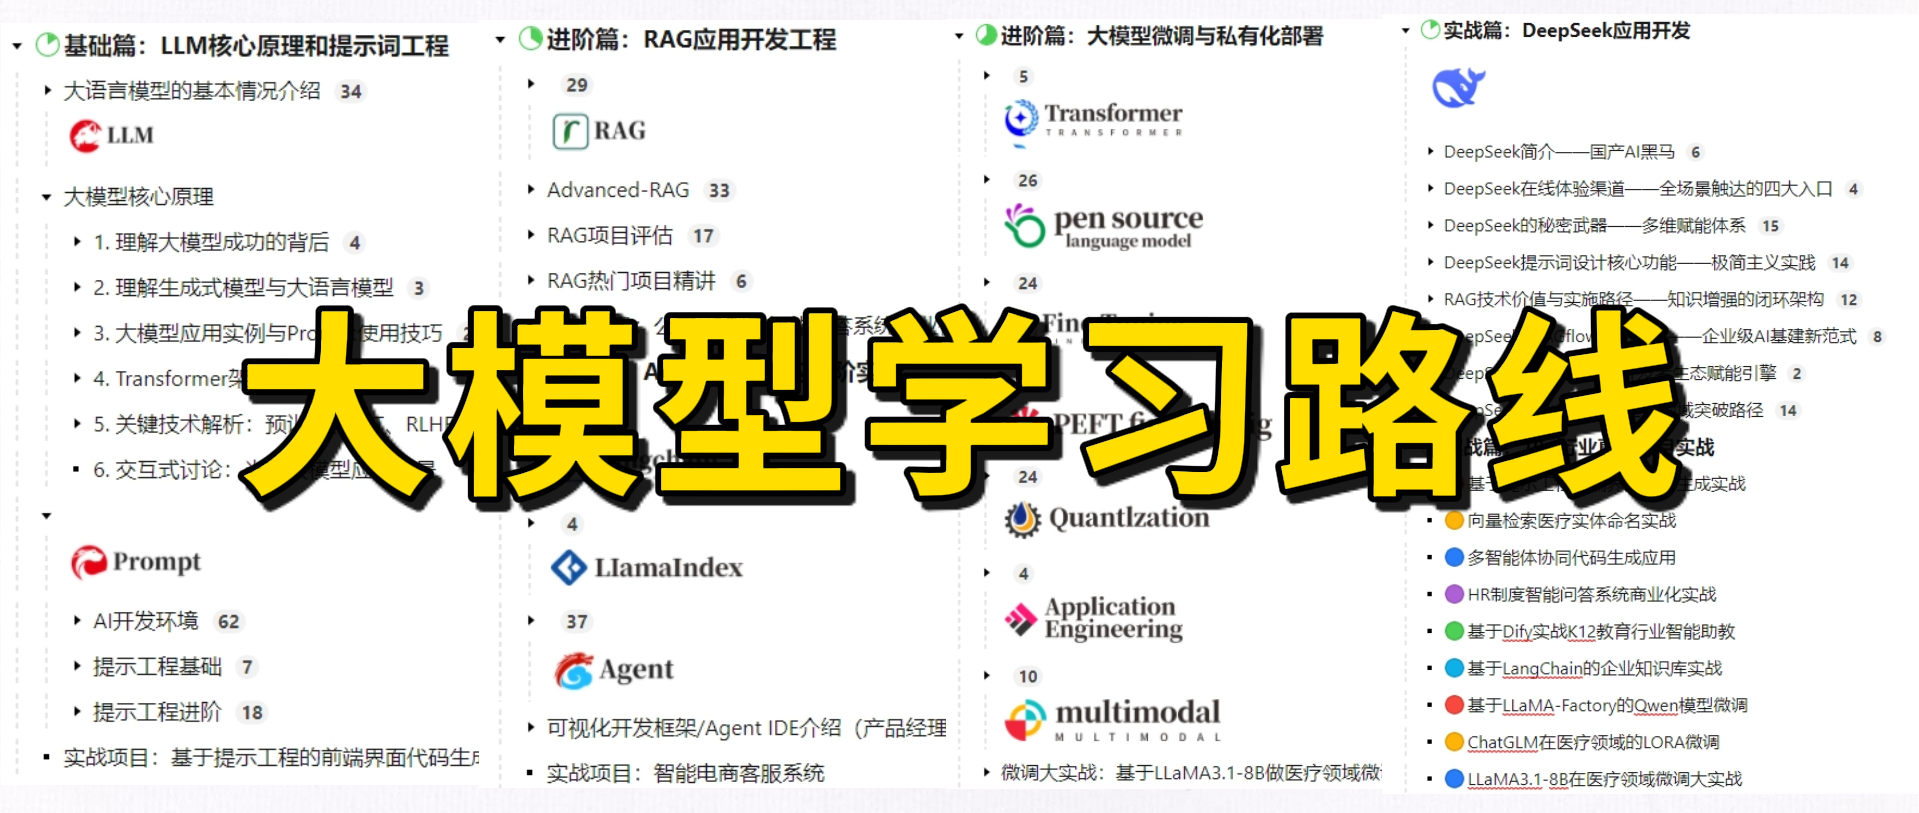
② 大模型系统化学习路线
作为学习AI大模型技术的新手,方向至关重要。 正确的学习路线可以为你节省时间,少走弯路;方向不对,努力白费。这里我给大家准备了一份最科学最系统的学习成长路线图和学习规划,带你从零基础入门到精通!
③ 大模型学习书籍&文档
学习AI大模型离不开书籍文档,我精选了一系列大模型技术的书籍和学习文档(电子版),它们由领域内的顶尖专家撰写,内容全面、深入、详尽,为你学习大模型提供坚实的理论基础。
④ AI大模型最新行业报告
2025最新行业报告,针对不同行业的现状、趋势、问题、机会等进行系统地调研和评估,以了解哪些行业更适合引入大模型的技术和应用,以及在哪些方面可以发挥大模型的优势。
⑤ 大模型项目实战&配套源码
学以致用,在项目实战中检验和巩固你所学到的知识,同时为你找工作就业和职业发展打下坚实的基础。
⑥ 大模型大厂面试真题
面试不仅是技术的较量,更需要充分的准备。在你已经掌握了大模型技术之后,就需要开始准备面试,我精心整理了一份大模型面试题库,涵盖当前面试中可能遇到的各种技术问题,让你在面试中游刃有余。
以上资料如何领取?
为什么大家都在学大模型?
最近科技巨头英特尔宣布裁员2万人,传统岗位不断缩减,但AI相关技术岗疯狂扩招,有3-5年经验,大厂薪资就能给到50K*20薪!
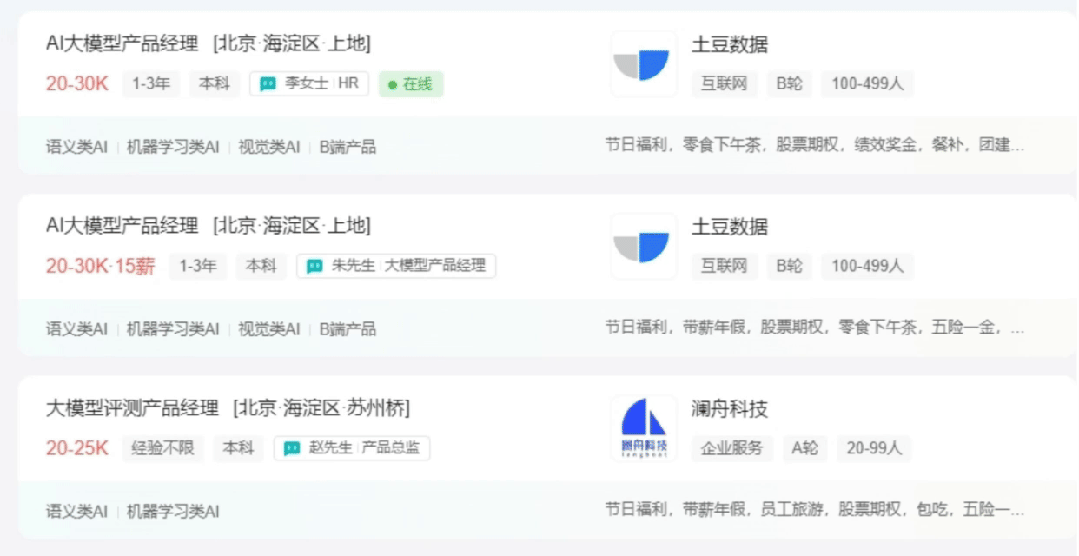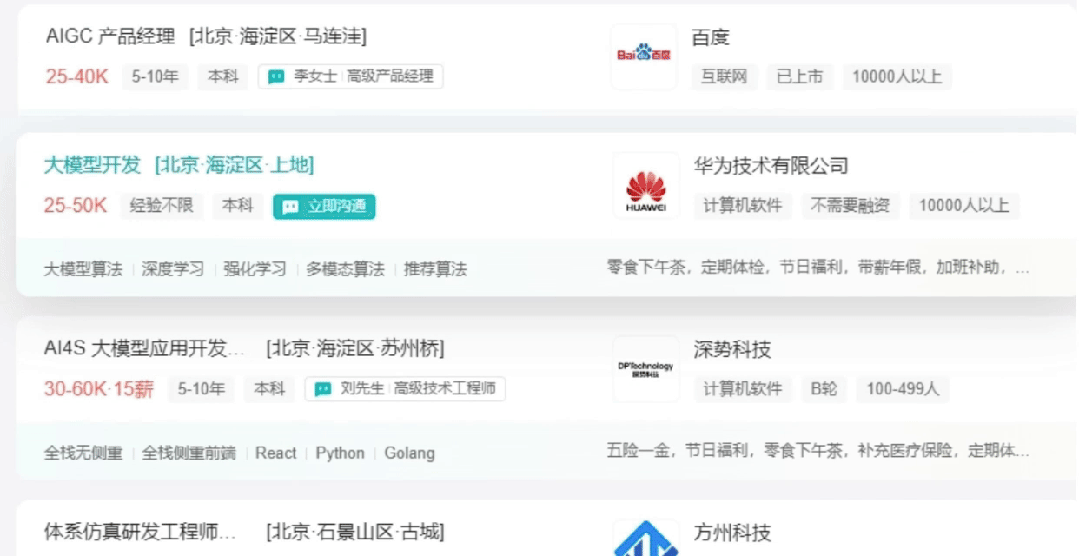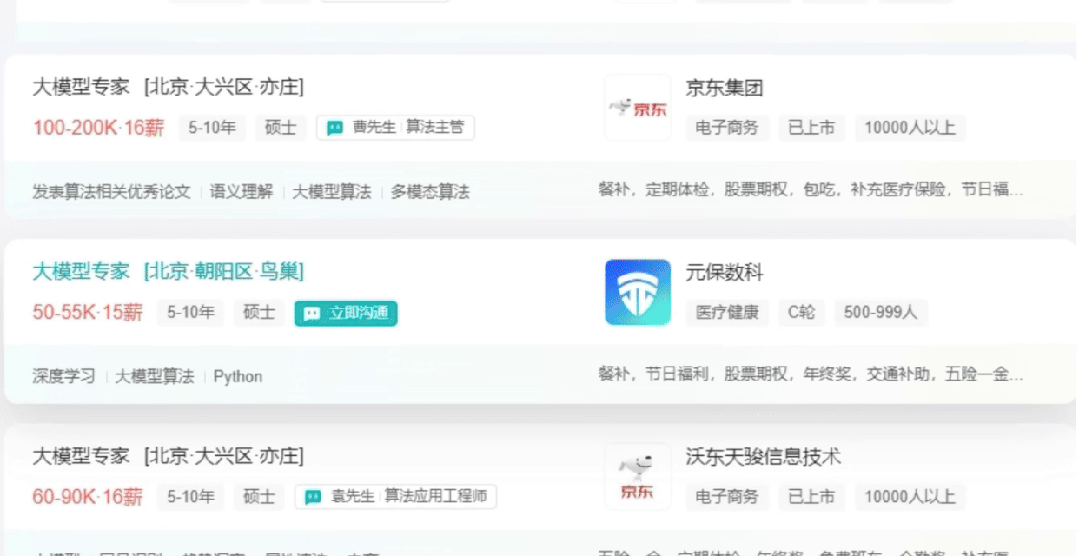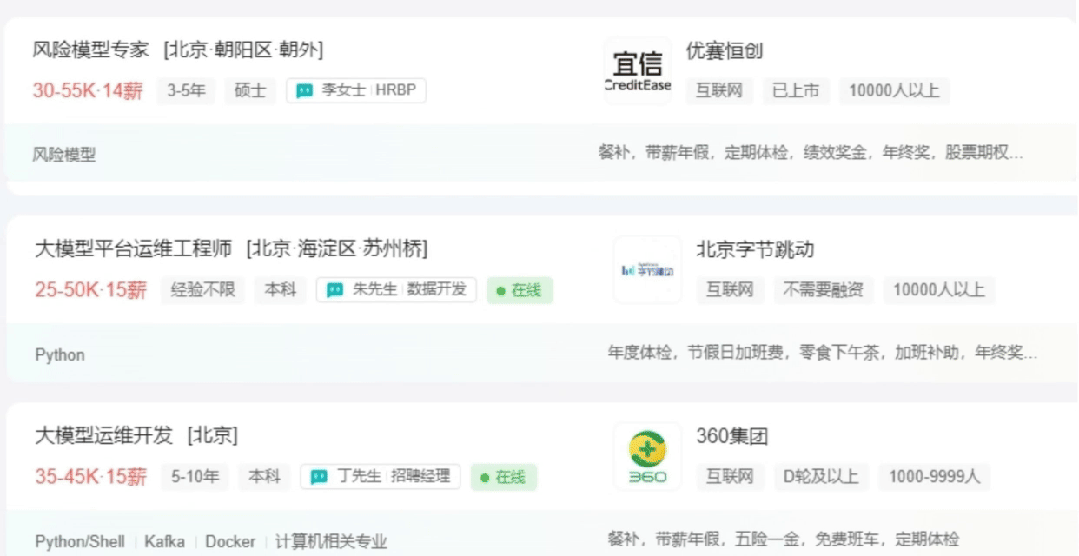
不出1年,“有AI项目经验”将成为投递简历的门槛。
风口之下,与其像“温水煮青蛙”一样坐等被行业淘汰,不如先人一步,掌握AI大模型原理+应用技术+项目实操经验,“顺风”翻盘!
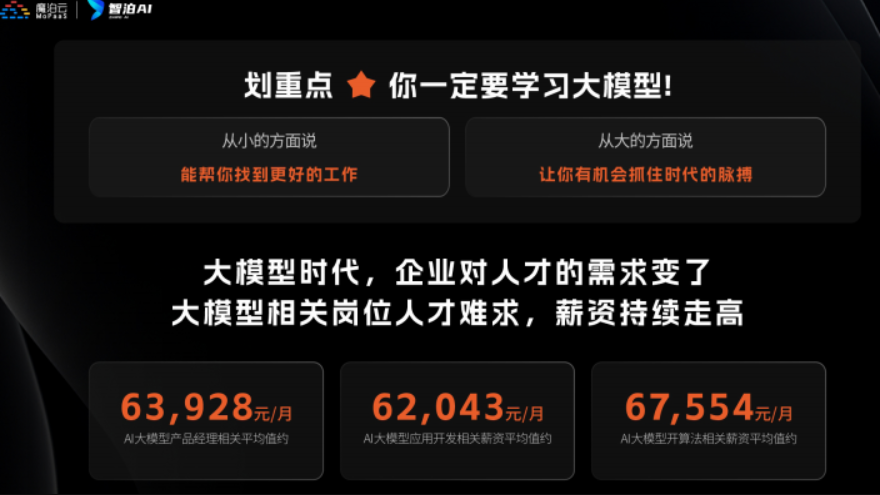
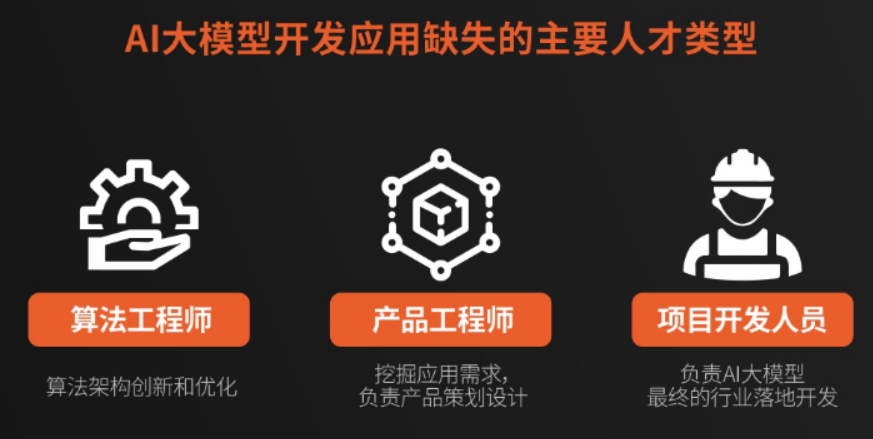
这些资料真的有用吗?
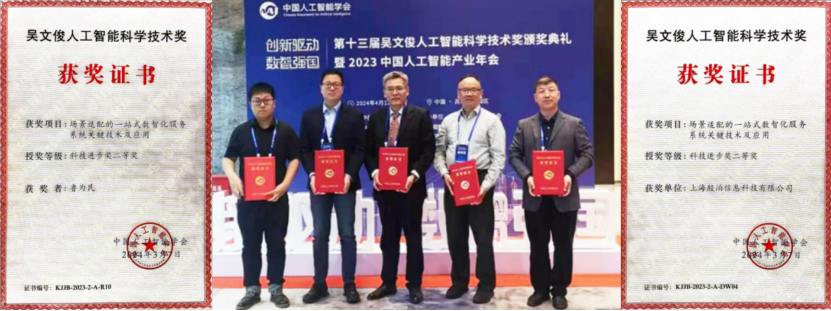
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。
以上全套大模型资料如何领取?
为武汉地区的开发者提供学习、交流和合作的平台。社区聚集了众多技术爱好者和专业人士,涵盖了多个领域,包括人工智能、大数据、云计算、区块链等。社区定期举办技术分享、培训和活动,为开发者提供更多的学习和交流机会。
更多推荐
 19
 0
- 0


 已为社区贡献11条内容

所有评论(0)