


- @yaoyaolin______g


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
根据前、后、左、右、左前、右前、左后、右后八个方向上的远近障碍物信息,将观测数据o ∈ R9×9×6分为九个部分oi p ∈ R3×3×6(i ∈ [1,9])。它映射了当前对其周围环境和动作的观察,并已被用来近似机器人在部分可观察的网格世界中的策略。观测数据的通道数为6个,每个通道的大小为9 × 9。观测数据隐含着机器人之间的协作信息,包括以机器人为中心的远、近障碍物坐标。观察数据包含以机器人本
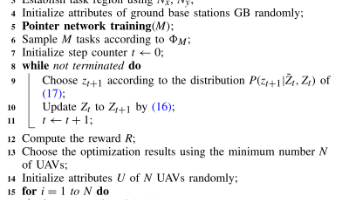
2)在全局任务分配中,通过考虑无人机的载重能力和救援任务的属性,将任务划分问题创新性地视为动态车辆路径问题(VRP),并采用深度强化学习(DRL)方法进行求解,通过静态任务分配和动态排序调整,最大限度地提高无人机的利用率和任务划分效率。4)潜在任务发现数(PTD):主要测试无人机的区域探测能力,记录无人机在其计划航迹上能够发现的未知任务数量,发现的未知任务越多,表明无人机的区域探测能力越强,表明无
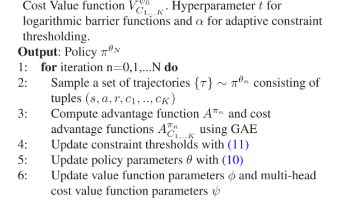
这使得问题总是可行的,因为零-对成本优势函数Aπ Ck进行平均归一化,通过用dk对扩大范围进行参数化,带来与规模归一化类似的效果。2)多头成本值函数:对于每个约束,参数化成本值函数(在我们的情况下,神经网络)需要使用GAE [50]计算成本优势函数。在这种设置中,所有成本值函数共享相同的神经网络主干,并且当引入更多约束时,仅输出层维度增加。首先,自适应约束阈值方法被用来适当地设置基于当前策略的性能
上述方法将复杂问题分解为若干子问题,基于子问题的目标和约束设计奖励函数,然后相应地分解Q函数,不仅允许每个sub-Q函数基于其对应的子问题的奖励函数进行优化,以更准确地评估策略的性能,而且还有助于提高Critic网络的训练效率,从而加速收敛过程。其中,Own_Critic iσ网络用于逼近Qπθiσ函数,Local_Critic σ网络用于逼近Qπθσ函数。其中,<oσ,t,aσ,t,oσ,t+1
为了提高最终解的一致性,对一个包含迄今为止找到的所有非支配解非支配集,在训练阶段,每一集采样一个ω,作为网络的输入。如果某一个子空间中的解比较稀疏,则其中偏好的采样概率会增加,这允许对性能较差的子空间中的权重进行更多次的采样和训练。MOMN将CAN的输出作为输入,首先基于目标对n个智能体的Q向量进行重组,组合对应于某个目标的所有Q值合并馈送到某个MOMN并行轨道中,然后将多个轨迹输出连接为整个网络
