



- @weixin_60223645


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
提供人工智能及强化学习基础网络设计及知识传递服务
地面移动机器人和车辆的运动本质上是二点五维的——它们在一个近似平面上移动,垂直方向的变化有限。把所有传感器信息都变换到以地面为基准的俯视平面上。俯视图(Bird’s-Eye View,BEV)的好处是具体的。这个空间里尺度是恒定的,不像图像里近大远小;物体不会互相遮挡叠置;多个传感器的数据天然对齐在同一张网格上;而且下游的路径规划本来就在这个平面上工作,不需要额外转换。技术上的关键难点是如何把二维
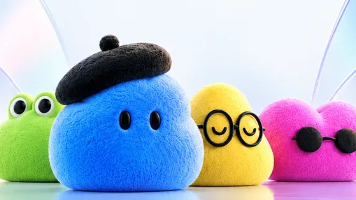
图 1:dots 的官方头图。四个毛茸茸的小团子——戴贝雷帽的蓝色、大眼睛的绿色、戴圆框眼镜的黄色、戴墨镜的粉色——就是 dots 的“脸”。图源:OpenAI。9 月 29 日,OpenAI 在旧金山开了 DevDay 2026。这是openai迄今规模最大的一届,一口气发了二十多项更新:新模型 GPT-6.1 Sol、500 美元的 Pro 套餐、Codex 的一堆新功能……但被讨论最多的,是
如果你第一次听到“训练大模型”,脑海里可能会自动浮现一排显卡、嗡嗡作响的机房、以及一张看起来不太友好的云账单。好消息是:我们今天不训练一个真正能上生产的 ChatGPT,也不挑战算力预算的物理极限。我们要做的是把大模型训练流程缩小成一个可以亲手跑通的“训练沙盘”。
当多个智能体(机器人、无人车或智能体)通过共享信息来协作完成任务时,一个自然的问题是:当共享的信息由于延迟,异步等情况,晚到几步,是否还有好的价值? 车联网领域近期的研究表明:新鲜的协作信息价值巨大;价值随延迟迅速衰减,甚至变成负资产(比不用还差)!;在计算与通信双预算约束下,刷新信息的机制存在可优化的空间;且这种优化规律和机制可以被神经网络学到。
6.10凌晨1点,Claude发布了Fable 5,号称是Claude向大众发布过的能力最强的模型。Fable 5属于Mythos系列,只是为了大众使用,在安全上做了一些限制。
如果你第一次听到“训练大模型”,脑海里可能会自动浮现一排显卡、嗡嗡作响的机房、以及一张看起来不太友好的云账单。好消息是:我们今天不训练一个真正能上生产的 ChatGPT,也不挑战算力预算的物理极限。我们要做的是把大模型训练流程缩小成一个可以亲手跑通的“训练沙盘”。
**从 2024 年底到 2026 年春天,不到一年半的时间,科研,尤其是对于独立研究工作者,这件事已经跟过去完全不是一回事了。****如果要在整个科研史上画一条分界线,2024 年底可能算一条。那之前,AI 是"辅助":是 Copilot 帮着补全一行代码,是 ChatGPT 帮着润色一段英文。那之后,AI 开始变成"主角":它写代码,复现论文,跑实验,一次性读完整个代码仓库,然后指出里面某个算
6.10凌晨1点,Claude发布了Fable 5,号称是Claude向大众发布过的能力最强的模型。Fable 5属于Mythos系列,只是为了大众使用,在安全上做了一些限制。
6.10凌晨1点,Claude发布了Fable 5,号称是Claude向大众发布过的能力最强的模型。Fable 5属于Mythos系列,只是为了大众使用,在安全上做了一些限制。
如果你第一次听到“训练大模型”,脑海里可能会自动浮现一排显卡、嗡嗡作响的机房、以及一张看起来不太友好的云账单。好消息是:我们今天不训练一个真正能上生产的 ChatGPT,也不挑战算力预算的物理极限。我们要做的是把大模型训练流程缩小成一个可以亲手跑通的“训练沙盘”。