- @weixin_51674085


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
是一个 py 库 transformers 的 js 版本,支持浏览器和 node/deno 环境,最近更新了。,比 WASM 版本的性能提高了 30 倍(作者跑出来 60 倍的性能提升)。下面是两个基于 V3 的例子,可以试试看。,支持了 WebGPU,我用我电脑跑。

是字节跳动开源的一个利用 T2V(Text-to-Video)模型对视频进行超分辨率的方法。无论是 AI 生成的视频还是现实中的视频,S T A R 都能进行高清修复。预训练模型(基于 I2VGen-XL 和 CogVideoX-5B)及推理代码现已发布。

阿里通义团队正式推出 MLX 格式的 Qwen3 大模型,包含 4-bit、6-bit、8-bit 和 BF16 四个量化版本,专门针对 Apple 的 MLX 框架进行了深度优化。Topaz Labs[3] 最新推出的 Astra 是一款基于 AI 的视频超分辨率模型,能够将 AI 生成的视频智能放大至 4K 分辨率,同时显著提升画质和细节表现。新增了--sref random功能,提供更多的变

火山引擎正式发布豆包视频生成模型 PixelDance 和 Seaweed,两款大模型均基于 DiT 架构,主要面向企业市场。字节跳动正式宣告进军 AI 视频生成领域,目前除了发布的演示外,没啥特别多的信息,不过可以关注字节的“即梦 AI” 公众号,发“内测”俩字来获取申请表单链接。我看好多人说比肩Sora,确实和Sora一样都用不上,要我说不如开源模型 Cog 来的实在,起码能用上。

是由字节豆包团队推出的图像编辑工具,它能够根据任何文本提示修改现有图像,并保持一致性。该工具支持多种功能,如局部替换、几何变换、重新打光、风格更改、表情编辑、文字替换、姿势修改以及局部擦除等。从演示视频和官方提供的演示来看,效果非常强大,你们可以。不过,我看了下代码实现,发现它调用了字节的 API,但目前这个 API 还没有公开申请的地方,期待后续的开放。
由 XLabs-AI 训练的 Flux LoRA 大集合,包括福瑞、MJv6、动漫、迪士尼、风景、艺术共 6 个 LoRA 模型。
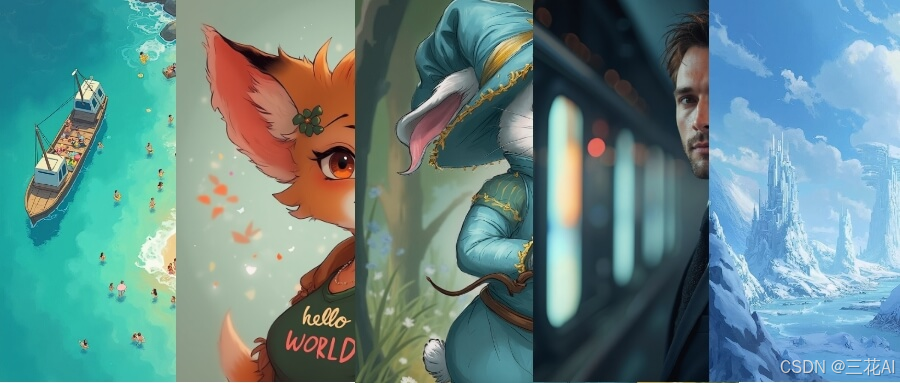
是一个 Sora 的开源替代, 昨天正式发布了。该项目与另一个 Sora 开源替代。现在可以在 HF 上。
NVIDIA 推出的 Describe Anything Model (DAM)[3] 是一款多模态大语言模型,它能够为图像或视频中的特定区域生成详细描述,支持通过点击、框选、涂鸦或遮罩等多种交互方式指定目标区域。OmniAvatar[1] 是阿里开源的一款基于 Wan 2.1 的音频驱动数字人模型。从目前已有的开源数字人模型来看,OmniAvatar 的表现算是相当出色了。EasyEdit[2]
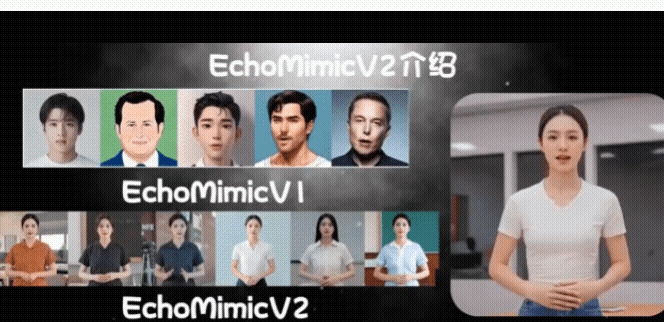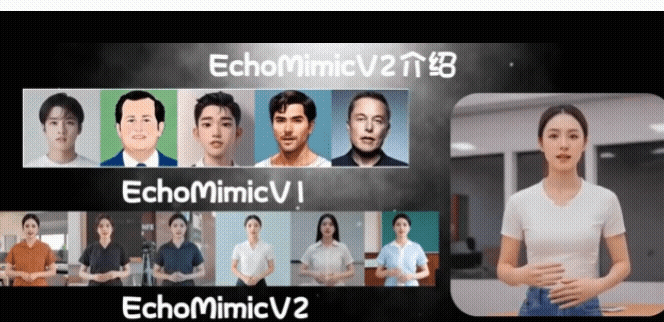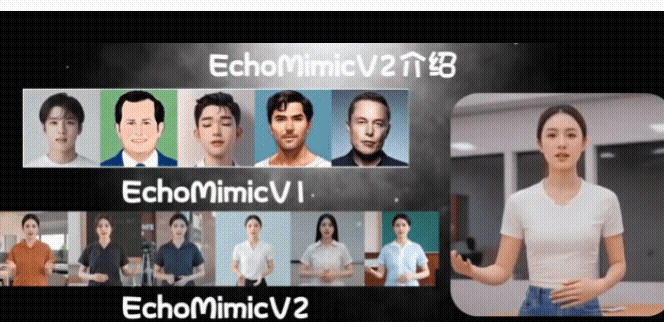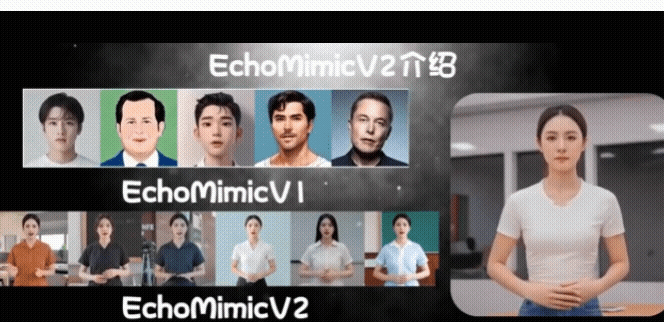
功能从数字人头扩展到了数字人。只需输入一张图片、一段手势视频和一段音频,即可生成数字人。支持中英文驱动,画面稳定性非常好。群里之前有佬友在寻找开源数字人方案,这不就来了吗?主要用于生成数字人头。
发布 Avatar 3.0 主要改进了脚本理解能力、面部表情和语音语调,还新增了唱歌能力。