- @weixin_44673517


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
TTL 缓存是智能体常用组件,清理方式直接影响性能。本文通过纯 Python 标准库实现线性扫描和堆删除两种 TTL 缓存,在 1000 条记录场景下实测:线性扫描 Cleanup 耗时 0.03ms,堆删除仅 0.002ms,清理速度提升 14 倍,查询速度相同。附带可运行代码和踩坑经验。
我测了 500 个 JSON 样本,上下文留 500 token 余量时只有 0.8% 解析失败;留 200 token 时失败率跳到 13%;留 100 token 时超过三成解析失败。大模型的 JSON 解析能力在上下文逼近限制时会突然崩塌,安全余量到底该留多少?
工具调用策略实测:缓存+重试让成功率从65%升至93%,调用上限3是拐点
很多人会将数据智能体与 “AI 聊天机器人”“自动 SQL 生成工具” 混淆,但实际上,数据智能体是具备端到端数据处理能力的独立系统,而非单一工具。其企业级定义可概括为:“数据智能体是基于大模型(LLM)技术,能自主理解业务需求、规划数据处理步骤、调用数据工具(如 SQL、Pandas、BI 平台)、处理异常(如数据缺失、查询错误)、生成结构化洞察(含结论与可视化)的闭环系统,核心目标是降低企业数
NumPy;Pandas;Matplotlib;;。
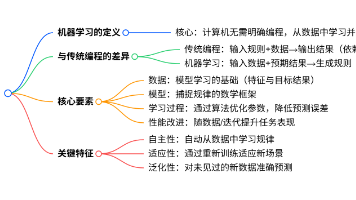
让计算机在没有明确编程的情况下,通过数据学习并改进任务性能的能力。其核心在于通过数据训练模型,使模型自动发现规律,而非依赖人工编写的固定规则来完成任务。
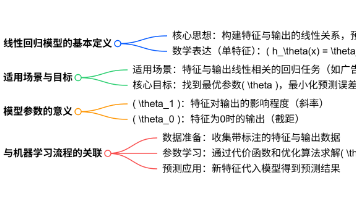
核心思想:通过构建输入特征与目标输出之间的线性关系,实现对连续值的预测。例如,基于房屋面积(输入特征)预测房价(目标输出),假设两者呈线性关联。数学公式: 对于单特征场景,模型表达式为 \(h_\theta(x) = \theta_0 + \theta_1 x\),其中:\(h_\theta(x)\) 为预测值,x 为输入特征,\(\theta_0\) 为偏置项(截距),\(\theta_1\)
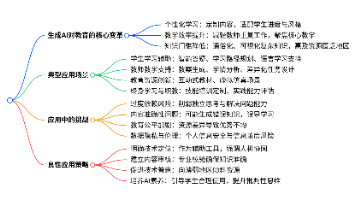
本视频是吴恩达 2025 年 LLM 大模型教程的第 45 集,主题为 “生成 AI 与教育”,探讨生成式人工智能在教育领域的应用场景、带来的变革以及面临的挑战,分析技术如何赋能教与学的全流程。
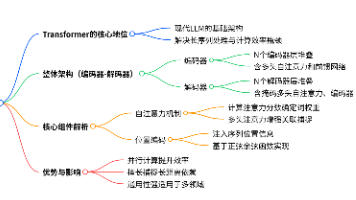
Transformer 是 2017 年提出的基于自注意力机制的深度学习模型架构,彻底改变了自然语言处理领域的技术格局,是现代 LLM(如 GPT、BERT)的核心基础。其核心优势在于,解决了此前 RNN 类模型在长序列处理和计算效率上的瓶颈。
大语言模型(LLM)的高效训练聚焦于在。