


- @weixin_42587745


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
一、问题由来在很多机器学习任务中,特征并不总是连续值,而有可能是分类值。离散特征的编码分为两种情况: 1、离散特征的取值之间没有大小的意义,比如color:[red,blue],那么就使用one-hot编码 2、离散特征的取值有大小的意义,比如size:[X,XL,XXL],那么就使用数值的映射{X:1,XL:2,XXL:3}使用pandas可以很方便的对离散型特征进行on...
本来代码写的是from tensorflow import set_random_seedset_random_seed(2)这样写就会报上面的错误把代码改成下面的就解决了import tensorflowtensorflow.random.set_seed(2)
内容主要包括:商业整数求解器、开元整数求解器、求解器的对比情况、其他求解器等内容。参考链接:【学界】运筹学数学规划|离散优化求解器大搜罗 (qq.com)

一维插值 插值不同于拟合。插值函数经过样本点,拟合函数一般基于最小二乘法尽量靠近所有样本点穿过。常见插值方法有拉格朗日插值法、分段插值法、样条插值法。 拉格朗日插值多项式:当节点数n较大时,拉格朗日插值多项式的次数较高,可能出现不一致的收敛情况,而且计算复杂。随着样点增加,高次插值会带来误差的震动现象称为龙格现象。 分段插值:虽然收敛,但光...
http://121.199.45.168:8007/2/#23-nlp
统计学中的变量指的是研究对象的特征,我们有时也称为属性,例如人的身高、性别等。 每个变量都有变量的值和变量的类型。我们按照变量的类型对变量进行划分。 统计学中的变量(variables)大致可以分为数值变量(numrical)和分类变量(categorical)。 数值型变量是值可以取一些列的数,这些值对于 加法、减法、求平均值等操作是有意义的。而分类变量对于上述的操作是没有意...
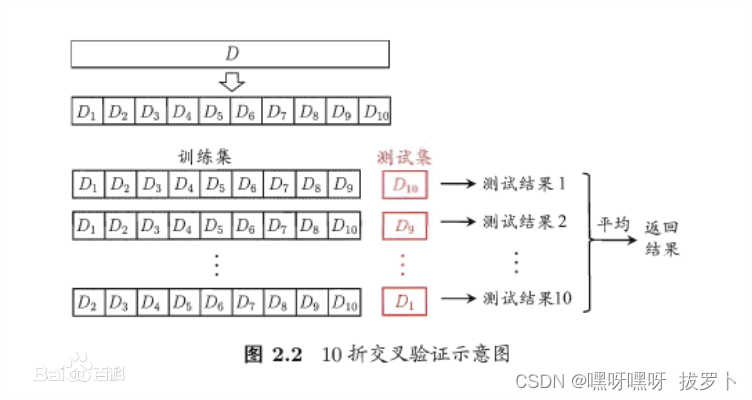
求解神经网络做十字交叉验证k=10,这种方法到底是得到十个模型还是一个模型
ALS推荐算法介绍Spark MLib支持的ALS推荐算法是机器学习的协同过滤算法。根据用户的评分来推断每个用户的喜好,并进行推荐。评分显式评分:用户直接对产品的评分隐式评分:根据用户选择的产品记录,但不知道评分等级稀疏矩阵(Sparse Matrix)问题当用户与产品评分成千上万时,矩阵会很大,而且很多会是空白的,使用计算机处理这样的矩阵会很浪费内存,且花费很多时间。即就是一个矩阵分解的过程,参
求解神经网络做十字交叉验证k=10,这种方法到底是得到十个模型还是一个模型