

写文章


- @u010764629


简介
该用户还未填写简介
擅长的技术栈
未填写擅长的技术栈
可提供的服务
暂无可提供的服务
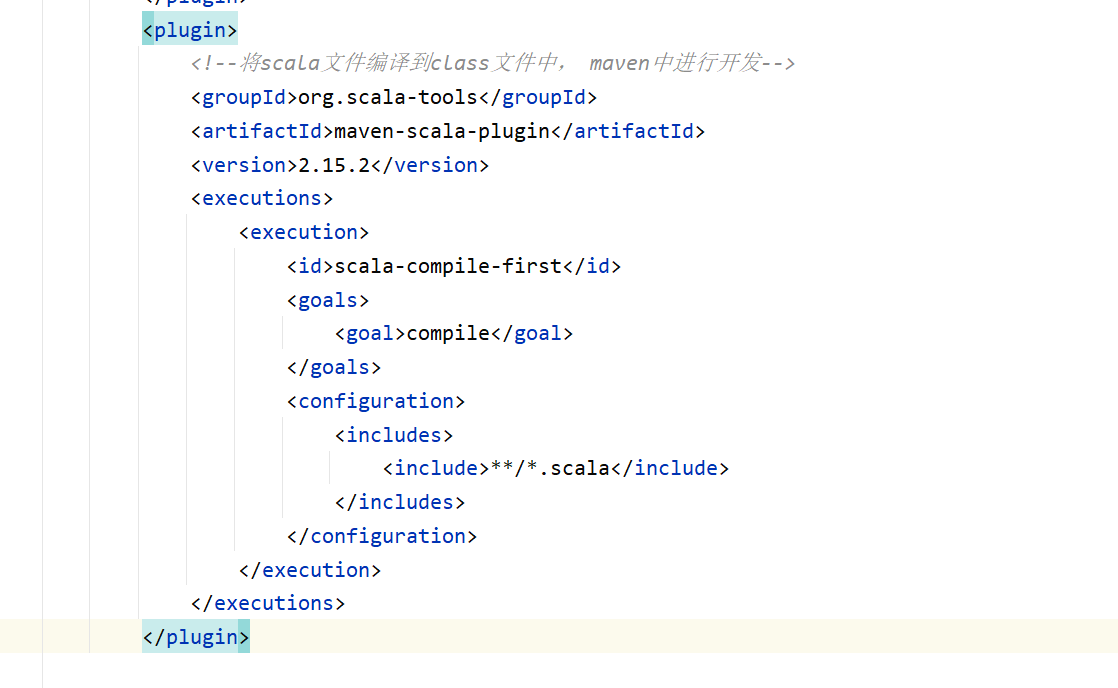
IDEA 内用mvn编译scala文件;scala插件scala-maven-plugin
IDEA 内用mvn编译scala文件;scala插件scala-maven-plugin
hive 的UDF和java的静态代码块的完美结果
一 、 首先说下业务需求背景,因业务需求需要转换经纬度坐标,完全转换为utm 50N的格式。由于中国跨越了多个带区,在把utm 50N的格式的坐标转为wgs84经纬度的时候在西藏和新疆地区出现偏差,精确度下降。这个udf函数就是为了把全国的utm转换为wgs84经纬度的之后都是争取的或者说误差很小很小。二、hive UDF的局限的地方是无法提前初始化开发这想要的对象,尤其是大的对象;如何是一个..
spark输出自己想要的文件名称
在hadoop中输出文件名称的生产是由OutputFormat里面的generateFileNameForKeyValue方法生产的。知道这个之后,我们就可以写一个仔细需要的方法去继承父类重写文件生成的规则了;源码中是获取reduce的编码号生成part*的带有数字的文件名称;这里定制了一个用key作为输出文件名称,用这个是千万不能key是几千万上亿的不重复字符;这个只适合数量小,key也不多情况
到底了