


- @qyqyeve


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
中国电信发布了 Xing4.0-29B-A4B,一个的智能体向模型。它的三个数字组合在一起才构成完整信息:原生上下文(可扩至)、、SuperCLUE 智能体能力排在第 3,与前两名 Qwen 的差距不到 1 分。训练用的是昇腾和国产框架,权重已上线 HuggingFace、魔搭和 Gitee。
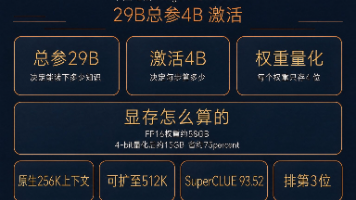
中国电信发布了 Xing4.0-29B-A4B,一个的智能体向模型。它的三个数字组合在一起才构成完整信息:原生上下文(可扩至)、、SuperCLUE 智能体能力排在第 3,与前两名 Qwen 的差距不到 1 分。训练用的是昇腾和国产框架,权重已上线 HuggingFace、魔搭和 Gitee。
codex/.opencode/.cursor/的自我定位是"agent harness 性能优化系统"。它把 Skills、记忆、安全,以及所谓"研究优先"的开发流程打包成一套可安装的层,跨 Claude Code、Codex、Opencode、Cursor 等不同 harness 使用。它的 v2.0.0 版本(2026 年 6 月)自称"agent harness 操作系统",带来了控制面底
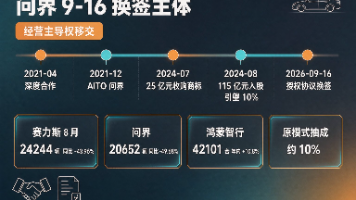
这次调整最硬的背景是销量。口径8 月数据同比赛力斯新能源汽车销量24244 辆-43.96%其中赛力斯汽车(问界)20652 辆-49.68%鸿蒙智行整体交付42101 台年内累计+10.8%,全系累计破152 万台一句话:问界在下滑,但"界"字辈的其他品牌在涨。这组数字放在一起就能看出动机。华为的渠道与合作资源是有限的,问界这条线已经跑通了(品牌、产能、渠道、用户认知都成型了),继续由华为全流程
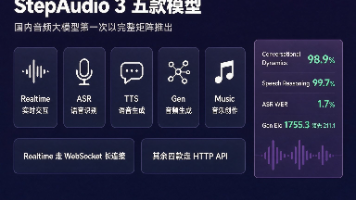
(实时语音交互)、(语音识别)、(语音生成)、(完整音频生成)、(音乐创作),全部上线开放平台。国内音频模型以单点突破为主,一次性放出五款、覆盖"听说理解交互创作"完整链路的,这是第一次。但参数和榜单不是这篇文章的重点,我想写的是。
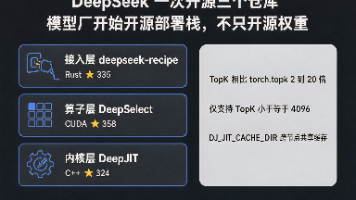
DeepSelect 是这三个仓库里技术含量最高的一个。它实现的是DSA(DeepSeek Sparse Attention,稀疏注意力)里的 TopK kernel,以及采样时用到的 TopK——DSA 从 V3.2 一路用到 V4、V4.1。相比原生torch.topk,官方给出的加速比是2~20 倍。为什么 TopK 在这里是命门?稀疏注意力的思路是不对全部 KV 做注意力,而是先给候选块打
GitHub Trending 上这几天冒出来一个新项目 openclaude,介绍只有一句:「runs anywhere. uses anything.」——跑在任何地方,用任何模型。这个定位和之前的 OpenClaw 高度重合,以至于很多人第一反应是「又来一个 OpenClaw 平替」。作为天天和 Claude Code、各种开源 Agent 打交道的人,我对这类项目一直保持关注。
本文从零开始讲解HomeLab硬件选型,围绕虚拟服务器、NAS存储和网络设备三大核心模块展开。CPU需支持虚拟化指令集,内存建议32GB起步;存储推荐SSD+机械盘组合,ZFS文件系统需预留充足内存;网络方面双网口软路由与VLAN隔离是进阶关键。文章还涵盖UPS、散热等隐藏配置,并提供2500-3500元预算的完整参考方案,帮助新手避开硬件选型陷阱。
小米开源的CocktailASR-1模型为客服质检带来突破性解决方案。该模型采用目标说话人语音识别技术,通过声纹注册精准提取坐席话术,实现从"大海捞针"到精准追踪的转变。文章详细解析了参考音频获取、静音分隔符设计、16kHz采样率处理等工程实践,以及负样本拒识机制与现有平台的对接方案,为呼叫中心、金融保险等行业的语音质检升级提供可落地的实施路径。
本文介绍小米开源的CocktailASR-1目标说话人语音识别技术,解决课堂录音嘈杂场景下的精准转录难题。通过参考音频锁定教师声纹,实现端到端过滤背景噪音、学生讨论等干扰,并支持负样本拒识与思维链推理,大幅提升课堂文稿纯净度与可用性。