

写文章


- @qq_45760884


简介
该用户还未填写简介
擅长的技术栈
未填写擅长的技术栈
可提供的服务
暂无可提供的服务
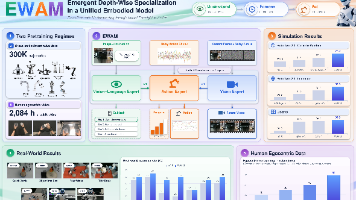
EWAM:没有逐层监督,统一具身模型自己学会了“先看懂、再想象、后动手“
EWAM 是一个以动作为中心的统一具身模型。我们让动作 token 在每一层都能同时读取语义、当前画面、预测的未来画面和动作自身的信息,没有给任何逐层监督。训练后,模型自发形成了一个按深度展开的分工:浅层主要读视觉-语言特征(理解),中层转向预测的未来帧(预演),深层以动作自注意力为主(动作形成)。因果干预实验表明,动作生成确实依赖这个分工。
到底了