


- @qq_41204464


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
Qwen3-VL模型使用指南 摘要: 本文详细介绍了Qwen3-VL多模态模型的使用方法,包括基于HuggingFace Transformers和vLLM两种推理框架的实现方案。文章包含以下核心内容: 模型基础信息: 开源地址:HuggingFace和GitHub 支持视觉语言任务(图像+文本→文本) Transformers框架使用: 模型加载与处理器配置 多模态输入处理(图像+对话模板) 生
目录1.在阿里云购买云主机2.下载、安装MosQuitto服务器3.解压,安装4.配置mosquitto 环境变量5. 测试服务器6.配置mosquitto服务端的IP (关键)1.在阿里云购买云主机可以参考:https://blog.csdn.net/qq_41204464/article/details/93199907选择Windows 的系统镜像...
opencv 运动检测 二帧差法 1. 帧差法基本原理 帧间差分法是一种通过对视频图像序列的连续两帧图像做差分运算获取运动目标轮廓的方法。当监控场景中出现异常目标运动时,相邻两帧图像之间会出现较为明显的差别,两帧相减,求得图像对应位置像素值差的绝对值,判断其是否大于某一阈值,进而分析视频或图像序列的物体运动特性。...
opencv 静态图像 人脸检测首先看一下源代码:#include "opencv2\opencv.hpp"#include <iostream>using namespace std;using namespace cv;int main(){string xmlPath = "haarcascade_...
本文针对HuggingFace下载文件或模型权重时遇到的访问问题和下载速度慢的问题,提供了几种解决方案。首先,通过修改HuggingFace镜像源为国内镜像(如https://hf-mirror.com)来提升访问速度和稳定性。其次,介绍了多种加速下载的方法,包括使用官方CLI工具、hfd多线程下载器等,并比较了它们的优缺点。其中,hfd多线程下载器因其高速和稳定性被推荐为首选。此外,还详细说明了

树莓派 二维码(QR)识别 c语言篇 先看一下运行结果: 识别图片二维码,源程序:#include "zbar.h"#include "cv.h"#include "highgui.h"#include <iostream>using namesp...
Evo-Depth提出一种轻量级视觉-语言-动作模型,通过多视角RGB图像提取隐式深度特征(IDEM),结合FiLM调制模块(SEM)将空间线索注入视觉语言表征,再由Flow Matching动作专家生成连续动作。无需额外传感器,仅0.9B参数,在多个仿真与真实机器人任务中实现高成功率(90%)、低显存占用(3.2GB)与高速推理(12.3Hz),有效提升抓取、对齐等空间敏感任务的可靠性。
在RoboDojo双臂操作中,GPT 6 Astra作为具身策略的“审查者”而非直接控制器,与适配任务的pi0.5协同,仅在失败或意图错位时局部修正动作。该混合策略成功率提升至48%(Direct为26%),token用量减少44.8%,且仅14.4%步数依赖Astra。但在语义抓放为主的RoboLab中,Direct因学生策略适配性差而略胜。结果表明:模型收益取决于学生策略与任务的匹配度,核心在

TurboVLA 通过直接 $V+L\rightarrow A$ 路径实现低时延机器人控制,摒弃传统大模型中介。采用 DINOv3 与 BERT 编码视觉与语言,六层双向 cross-attention 实现精准跨模态对齐,结合状态 token 输入 ACT 风格 decoder 并行输出连续动作。在 LIBERO 与 RoboTwin 2.0 上分别达 97.6% 和 88.06% 成功率,参数
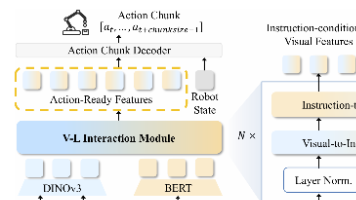
本文复现 TurboVLA 在 LIBERO 单套件上的全流程,仅用 RTX 4090 显卡、10,000 步训练即达 100% 成功率(50/50)。通过精简数据(仅 libero_object)、优化配置与踩坑总结(共9个关键问题),实现最小可行方案。模型采用无 LLM 的 V+L→A 直接映射架构,参数量仅 0.2B,推理延迟 31.2ms,显存 <1GB。核心策略包括:DINOv3 全量微
