


- @leijmdas


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
domain目录遵循DDD分层架构,核心承载业务逻辑。通过mod.rs的serde_i64_string解决前端精度丢失问题;rudb模块以SeaORM实体为DTO,结合Deref委托实现DAO、Page、Facade的零代码继承;ruservice扩展配置、缓存与Web客户端能力。全链路采用“四件套”模式(实现+Init+Test+mod),配合#[ctor]自动注入,实现数据库表到HTTP接口
✅个性化强:根据用户历史行为自动调整参数✅记忆效率高:减少无效复习,提升长期保留率✅支持多平台:Anki、Python、Notion、Java 等均有实现✅开源可定制:如 Py-FSRS、FSRS4Anki 等项目提供完整 API如你有具体使用场景(如想在 Anki 中配置 FSRS、或用 Python 自定义调度器),我可以提供详细操作指南。
2. 主键冲突:手动插入指定 ID 后,序列不会自动更新,需执行 SELECT setval('seq', MAX(id)) FROM table。id BIGSERIAL PRIMARY KEY,-- 自动创建 users_id_seq。-- 缓存数量,提升性能。-- BIGSERIAL = BIGINT + 自动创建序列(推荐,防止溢出)CACHE 1000-- 缓存 1000 个值。STAR
Apache JMeter 是业界最主流的开源性能测试工具,基于 Java 开发,最初用于 Web 应用测试,现已扩展支持数据库、FTP、消息队列、微服务等多种协议。
能否回传结果集✅ `RETURNS TABLE / SETOF`❌(只能 OUT 参数)``CALL proc(args);`psql -U postgres -d yourdb -f proc.sql` 即可一键验证。下面把“函数”和“过程”都给你一次讲透,并附完整可直接 `psql -f` 运行的脚本。- 要查询 → `FUNCTION` + `RETURNS`/`TABLE`-- 找不到会返
• 避免因节点变化导致的问题:在某些情况下,如使用Docker部署Elasticsearch时,节点的IP地址可能会发生变化。• 减少初始连接开销:自动嗅探会尝试连接集群中的所有节点以获取其信息,这在集群节点较多时会增加初始连接的开销。禁用后,客户端只连接指定的节点,减少了连接时间。• 避免不必要的错误:在某些情况下,即使集群状态是正常的,健康检查也可能会因为网络或其他原因失败,导致错误信息。•
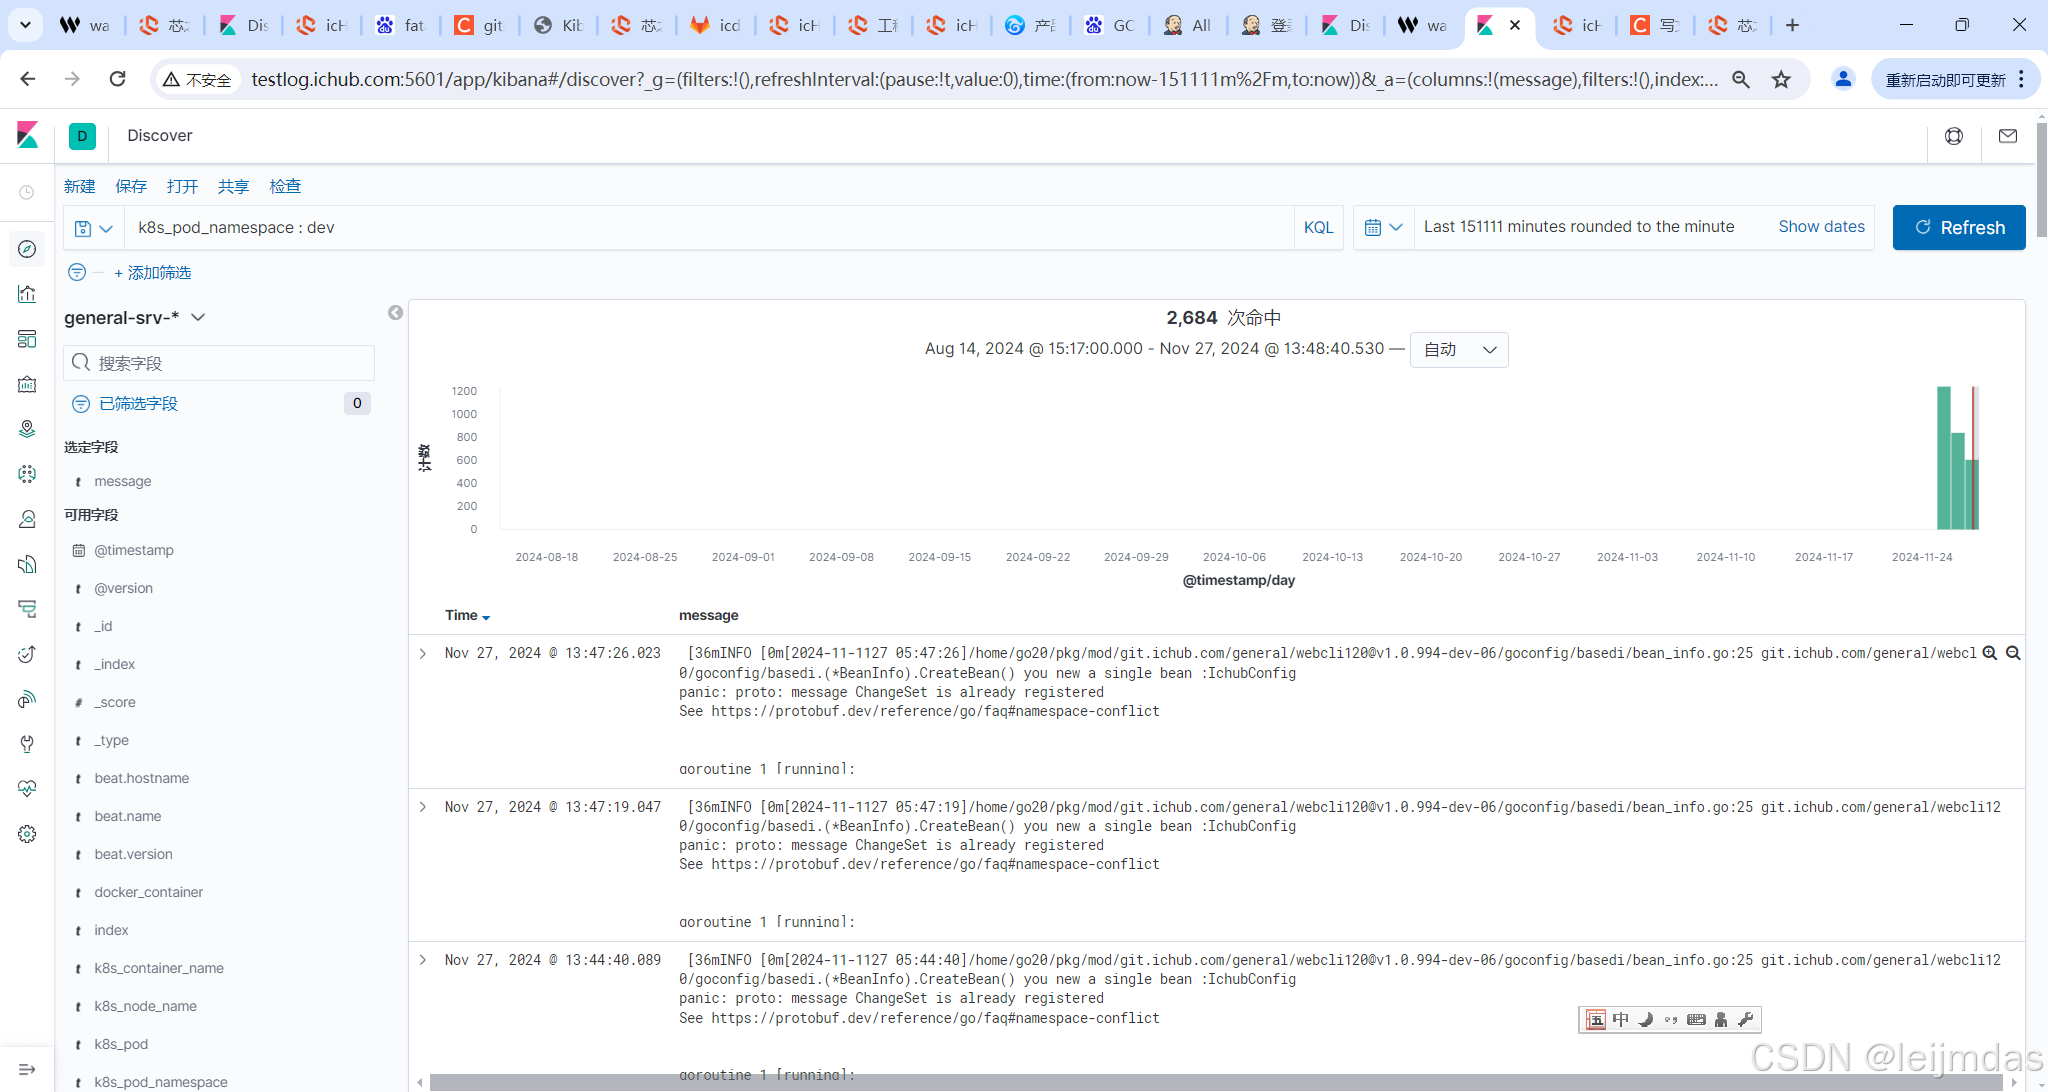
google.golang.org/grpc v1.25.0不用加,google.golang.org/grpc v1.26.0需要加。RPC升级问题GOLANG_PROTOBUF_REGISTRATION_CONFLICT=warn,编译运行环境都要加环境变量。一个坑,运行时也要加环境变量。
q["query"], _ = elastic.NewMatchQuery("short_name", "古泳").Source() //Query(tic.NewMatchAllQuery()) //var src, _ = elastic.NewMatchQuery("name", "市场部门").Source()

• 执行Scroll查询:使用`EsClient.Scroll()`方法来初始化scroll查询,设置索引、类型、查询条件、排序字段(注意必须是字段+.keyword,否则会报错)、scroll时间(如"5m"表示5分钟)、每次查询的大小(如5000条)。• 构建查询:使用`elastic.NewBoolQuery()`构建布尔查询,然后通过`Must`方法添加查询条件,例如时间范围查询`elas
被多位开发者评价为"比Jenkins好用太多"、"不用怎么折腾的Jenkins":如果想自建,Gitea Actions提供类似体验。:已被Harness收购,复杂嵌套流水线支持较弱。:图形化配置界面,无需写复杂的Groovy脚本。:企业级团队,希望快速迁移Jenkins流水线。:用YAML文件定义流水线,学习成本低。:GitLab本身较重,免费版功能受限。:专注构建、部署、监控,不搞复杂功能。: