- @gaussrieman123


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
首先要确定手机是否支持Vulkan,可以下载一个aida64,在设备中如果能找到vulkan设备,说明支持,否则不支持。严格按照官方介绍的步骤一步步执行,就能获得官方推荐的可执行的例子,有很多,可以都试一试。那怎么在自己的工程中使用vulkan呢?按道理说,Android官方支持vulkan,使用起来应该要比非官方支持的opencl方便的多,实际上也的确如此。不过由于vulkan是一个分层...
本文提出了一种四层解耦的智能业务系统架构,将语义驱动理念转化为可落地的工程实践。该架构由数据层(存储任务数据和日志)、用户操作层(转化外部动作为指令)、任务节点层(执行业务逻辑)和任务推荐层(动态推理下一步任务)组成,形成从操作到智能的闭环。系统以"任务"为语义原子,通过结构化状态上下文实现灵活的任务编排,并具备自我进化能力。相比传统流程系统,该架构在灵活性、智能性和可追溯性方

本文针对复杂业务流程中智能推荐系统面临的全局状态空间爆炸、规则维护困难等问题,提出以任务为中心的架构设计。通过聚焦任务节点及其局部上下文,结合规则引擎和语义匹配技术,构建了灵活高效的推荐系统。文章详细阐述了架构设计理念、关键模块实现及技术挑战应对方案,包括任务库设计、局部上下文抽取、规则与语义匹配融合等方法。该架构有效降低了系统复杂度,提升了推荐准确性和维护效率,为复杂业务场景下的智能推荐系统建设

ncnn vulkanncnn在1月20号提交了对Vulkan的支持,而且更新了benchmark对Vulkan的测试,我们本来尝试在ncnn中添加Opencl,看到支持Vulkan非常高兴,迫不及待想试试。花了接近一天时间来完成benchmark,记录一下。系统: ubuntu 18.04查看显卡信息,安装显卡驱动参考这篇文章,作者写的非常详细,查询显卡和安装驱动。我的显卡是1050ti...
什么是并行优化?并行优化是代码优化的基本方法,从大到小一共可以分成三级:异步框架;任务并行;数据并行。在实际工作中,一般是先设计异步框架,包括异步处理任务以及异步任务的异构化等;第二步一般是做数据并行优化(SIMD),利用CPU的向量指令来对多条数据并行处理;这两步是代码优化的重心,一般做完这两步,系统性能会有明显的提升。今天要讨论的是第三步,for循环的并行优化。与前两者不同的是,for循环..
什么是并行优化?并行优化是代码优化的基本方法,从大到小一共可以分成三级:异步框架;任务并行;数据并行。在实际工作中,一般是先设计异步框架,包括异步处理任务以及异步任务的异构化等;第二步一般是做数据并行优化(SIMD),利用CPU的向量指令来对多条数据并行处理;这两步是代码优化的重心,一般做完这两步,系统性能会有明显的提升。今天要讨论的是第三步,for循环的并行优化。与前两者不同的是,for循环..
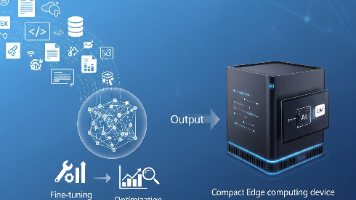
低成本行业大模型落地方案:10万元打造边缘AI 本文提出了一套实践验证的低成本行业大模型解决方案,重点解决中小企业应用AI的高门槛问题。方案采用"减法思维",避免昂贵的预训练和复杂RLHF,转而使用Qwen3-8B基座模型+DPO微调技术,仅需1-2万条结构化数据即可完成定制。通过SFT微调、DPO对齐和4bit量化三个关键步骤,最终模型可压缩至4.5GB,在4万元级国产边缘设
本文探讨了大模型生成速度对用户体验的影响,重点分析了首字延迟(TTFT)和生成速度(Token/s)两大关键指标。文章指出: 用户对响应速度极其敏感,TTFT>3秒会导致70%+的流失率; 不同应用场景需要差异化的速度标准,如实时对话要求TTFT<1s且≥40Token/s; 提供可交互的HTML模拟工具,可直观体验不同速度效果,帮助团队理解优化方向。 核心观点:模型性能不等于用户体验
摘要: 论文《LIMI: Less is More for Agency》提出颠覆性观点:仅用78条高质量专家工作轨迹(约330万tokens)训练的大模型,在自主性任务(Agency)上表现远超使用上万条数据的SOTA模型(AgencyBench得分73.5%,提升53.7%)。关键突破在于**"轨迹"设计**——包含推理、工具调用和环境观察的完整闭环记录(平均42.4k t
AI数据并购浪潮席卷科技界,Meta以148亿美元收购Scale AI标志着模型巨头正从"算力竞赛"转向"数据闭环"争夺。这场并购潮经历了三个阶段:早期行业整合期(2017-2021)、工具与社区期(2022-2024)和当前战略下注期(2024-2025)。深层驱动因素包括:技术迭代需求、商业生态构建、人才获取和供应链安全。并购目标集中在规模化标注平台、数