- @dicky_zhang3


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
在把高并发网关升级到 Java 24 虚拟线程后,很多团队在压测中见证了令人振奋的指标:JVM 堆内存占用极低,哪怕并发调度 50,000 个虚拟线程,堆内存活跃对象也仅占几百兆。然而,在持续进行 3 小时的高压摸高测试后,生产服务器却突然无预警地被操作系统内核杀掉——Linuxdmesg。令人百思不得其解的是,此时 JVM 的监控面板上,堆内存(Heap)使用率甚至还不到 30%,没有任何报警。
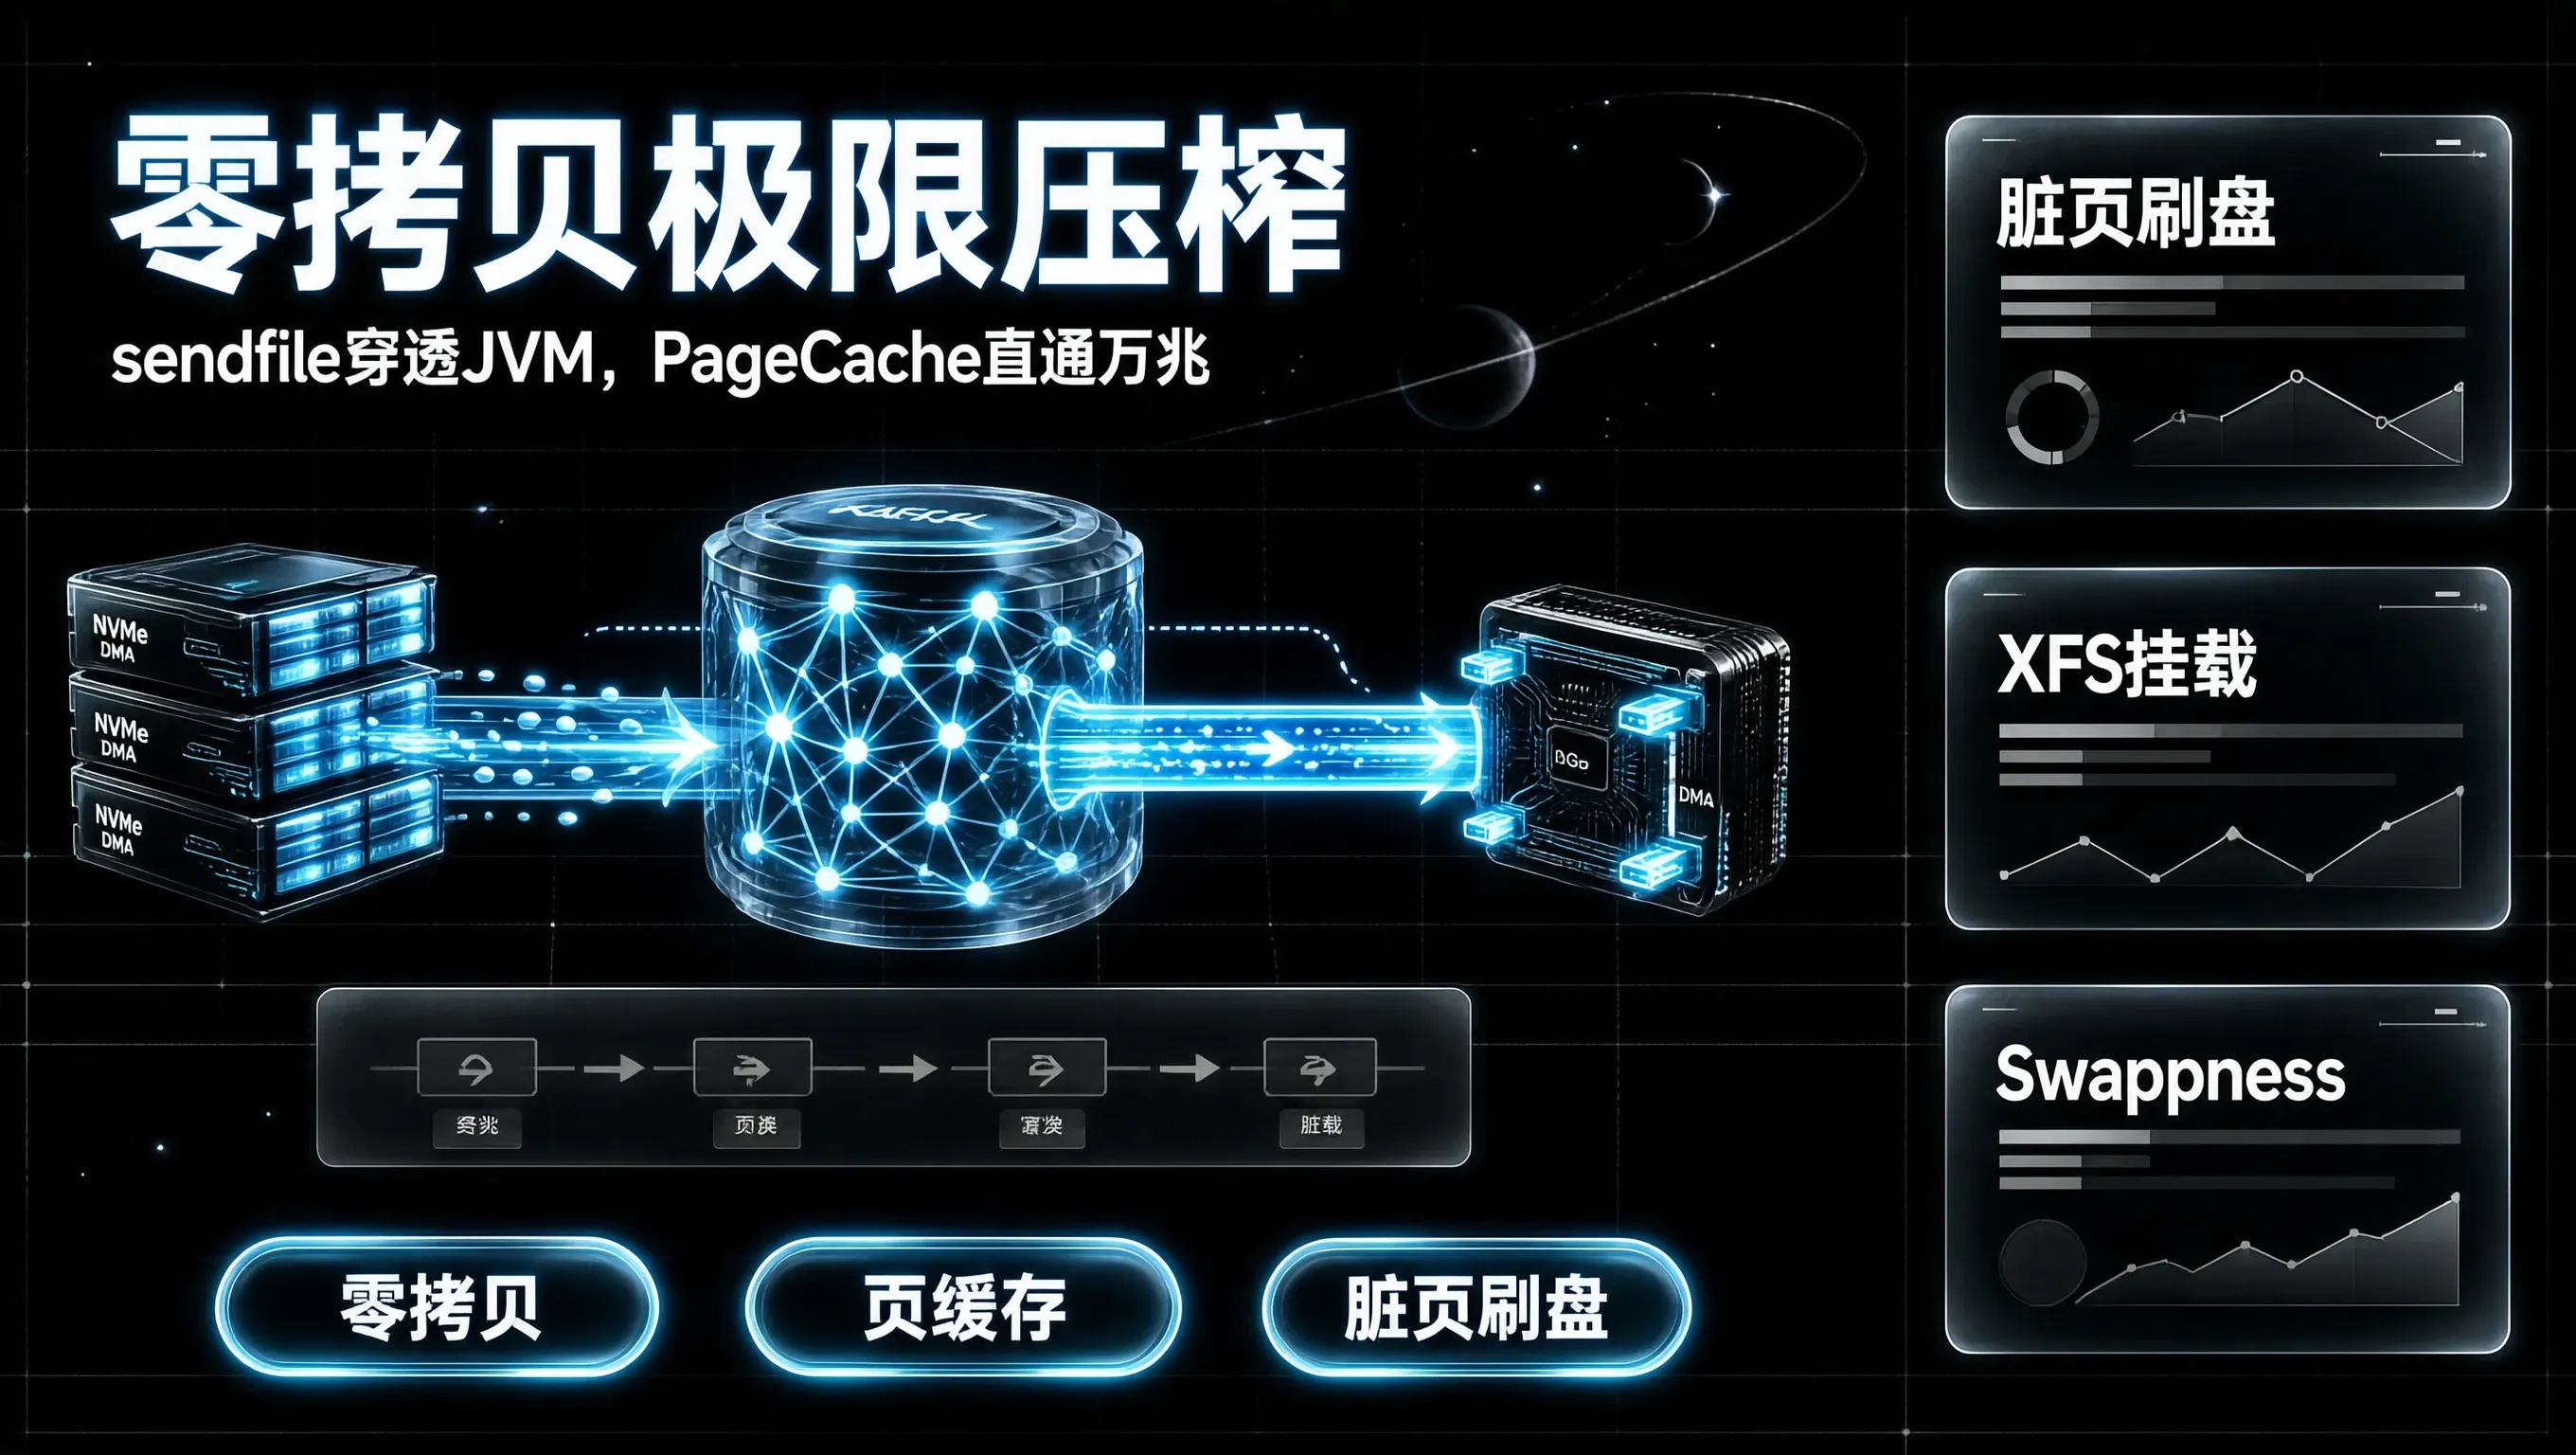
在亿级流量削峰填谷的战场上,Kafka 之所以能够以每秒数百万消息的恐怖速率吞吐海量数据,并不是因为它用 Java 写了多么精巧复杂的内存队列,而在于它极其聪明地做到了“不碰 CPU 和用户态内存”——将繁重的磁盘读写与网络传输工作,全部委托给了操作系统底层的。然而,在很多大促实战中,不少团队发现自建的 Kafka Broker 集群吞吐远远达不到官方标称的水平:磁盘 I/O 利用率早早飙到了 1
摘要生成使用 Qwen2-VL-7B 多模态大模型。输入包括:5~8 张关键帧、ASR 转文本结果、以及标签信息。你是一个视频内容分析专家。以下是视频的关键信息:- 标签:{tags}- 语音文本:{asr_text}- 关键帧:[5~8张图片]请基于以上信息生成一段 100-200 字的中文视频内容摘要,要求:客观描述视频内容,不添加主观评价,包含:视频主题、主要内容环节、关键人物或场景。
转码系统的设计本质上是资源调度问题——如何在有限的 GPU 算力约束下,最小化用户等待时间。优先级队列用 Redis Sorted Set 实现,天然支持高并发入队和原子出队;Worker 能力注册 + 心跳让调度器始终掌握全局负载视图;分清晰度的差异化策略在成本和体验之间取得平衡。未来的方向:探索 Serverless GPU(如 AWS Lambda + GPU)实现弹性扩缩,将长尾任务迁移到
在大促全链路容量评估与推演中,许多架构师常常把 99% 的精力倾注在“后端 Java 微服务的线程池、JVM 垃圾回收与 MySQL 数据库”上。然而,在多次大促开门红真实的洪峰冲击中,故障的根源,深藏在整个流量入口的最前沿阵地——**“接入网关(Ingress / Nginx / Envoy)与 Linux 操作系统的底层网络协议栈拓扑”**之中。
在基于 Kubernetes 构建的大型云原生微服务架构中,是维系全站数千个微服务相互寻址与服务发现(Service Discovery)的“隐形中枢神经”。无论微服务是通过发起 Feign 调用,还是连接,请求发出的第一纳秒,底层操作系统都必须先向 CoreDNS 发送 UDP 数据包以获取目标 Pod 的虚拟 Cluster IP。然而,在多次大促备战的数十万 QPS 全链路高并发压测中,为什
MySQL优化器的成本模型本质上是统计信息加成本常数的函数。Cardinality估算的准确性直接决定索引选择的正确性——而采样机制天然存在偏差风险。理解和这两个魔法数字,能帮助你解释为什么优化器在SSD和HDD上的行为截然不同。优化器Trace是解决"为什么走这个索引"问题的终极工具,它把黑盒决策变成了白盒可追溯的过程。统计信息不准确时的标准处理流程是:ANALYZE TABLE → 检查执行计
场景推荐架构说明读多写少1主N从N建议3-5个高可用MHA/PXC自动故障转移大数据量分库分表 + 主从结合ShardingSphere。
在大促削峰填谷的高并发架构中,Apache Kafka 展现出了令人惊叹的“百万级吞吐”能力。很多人误以为 Kafka 的超强性能是因为它把数据全部常驻在 JVM 堆内存中,或者是因为它采用了某种神奇的纯内存数据库技术。Kafka 之所以能够以超越普通内存操作的速度吞吐数据,靠的是现代操作系统底层的三大基石——以及sendfile。%util在大促容量规划中,必须深入到的底层数学推演中,才能筑牢坚
AI 服务成本优化需要从模型层(选型与量化)、调度层(弹性伸缩与竞价实例)、架构层(级联路由与离线预计算)三个维度协同发力。量化是最具性价比的优化手段,INT4 可将 GPU 成本降低 75%;级联架构将 80% 的简单请求路由到小模型,是架构层降本的核心策略;竞价实例将离线推理的 GPU 单价降低 70%。落地路线上,建议先用量化降低单次推理成本,再引入语义缓存减少重复推理,最后通过级联架构和弹