


- @2501_94579874


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
秋叶ComfyUI整合包V3.7发布,支持Python3.13和Torchcuda13.0,新增视频节点并优化预装插件。该整合包提供一站式AI绘画解决方案,用户需自行下载大模型并安装ComfyUI-Manager插件管理器。基础使用流程包括加载模型、输入提示词、设置图像参数等步骤,通过节点式界面自由定制工作流。整合包兼容最新模型,支持共享SDWebUI模型目录,适合新手快速上手AI绘画创作。
Windows 11精简版X-Lite26H1V3发布,专为老旧设备优化。该系统基于Win11 26H1(Build28000.1575)深度定制,解除TPM/CPU等硬件限制,空载内存仅1.1-1.3GB,安装后C盘占用约10.8GB。相比V2版本,V3完整支持UWP框架、微软商店、WSA/WSL2,适配8GB及以上主流设备。系统移除广告遥测等冗余组件,保留圆角/亚克力等界面特效,默认启用管理员
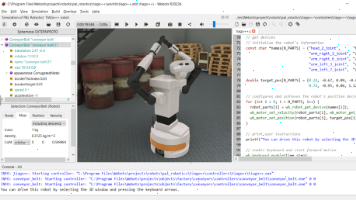
Webots机器人仿真实战指南:从入门到精通 本指南系统介绍了Webots机器人仿真平台的使用方法,包含四大核心实战案例。内容涵盖: 基础篇:安装配置、界面操作、场景搭建与控制器编程 实战篇: E-puck红外避障(Python源码) PID轨迹跟踪控制 A*路径规划算法实现 SLAM建图与自主导航(ROS2集成) 资源支持:提供完整工程文件、安装包及示例代码(百度网盘链接),适合学习研究和项目开
小米开源声音克隆大模型OmniVoice,支持3秒克隆人声和600多种语言。该模型由小米AI实验室开发,采用单阶段扩散语言模型,无需训练即可实现零样本语音克隆。主要功能包括语音克隆、语音设计、情绪控制和发音纠正。相比同类工具,OmniVoice在语言覆盖、中文准确率和生成速度方面表现突出,且完全免费商用。提供整合包和源码两种安装方式,推荐使用NVIDIA显卡以获得最佳性能。使用时需注意参考音频时长
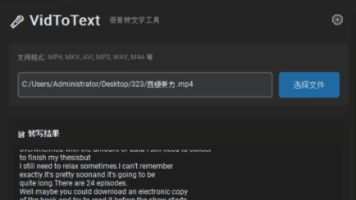
VidToText是一款基于OpenAI Whisper模型的离线音视频转文字工具,支持Windows/Mac系统。其核心优势包括:1)完全离线运行,保障隐私安全;2)永久免费无限制;3)支持多格式输入和SRT字幕导出。软件内置多种AI模型,可适配不同电脑配置,并支持显卡加速。使用时需注意:安装路径不能含中文、首次需联网下载模型、建议人工校对结果。相比在线工具,VidToText特别适合处理敏感内
OOTDiffusion是一款基于潜在扩散模型的开源虚拟试衣系统,发表于AAAI2025。该技术通过深度学习实现服装特征与人体姿态的智能融合,能生成自然真实的试衣效果,解决了传统虚拟试衣效果生硬、效率低下的问题。系统支持电商展示、服装设计验证和个人穿搭预览等场景,提供从特征提取到图像生成的全流程解决方案,单次生成仅需数秒。项目包含完整的预训练模型和运行脚本,用户可通过简单命令快速体验虚拟试衣功能,

本文介绍了ClaudeCode桌面端的本地安装与配置方法。主要内容包括:1)环境要求(Node.js v24+和DeepSeek模型支持);2)资源获取(安装包、运行环境和Skills离线包);3)详细安装步骤(Node.js环境配置、ClaudeCode安装、模型选择和Skills导入);4)功能验证方法;5)常见问题解决方案。该方案可实现文档处理、代码生成等AI功能,所有配置均在本地完成,无需
LTX2.3是Lightricks推出的开源音视频生成模型,支持文生视频、图生视频和音频驱动视频生成,具备原生音画同步、4K/竖屏输出等特点。该模型基于DiffusionTransformer架构,参数量约220亿,可在消费级显卡上本地部署。相比其他开源模型,LTX2.3在多模态输入、竖屏适配和音视频同步方面表现突出,特别适合短视频创作。官方提供一键整合包,支持Windows/Linux系统,最低

小米开源声音克隆大模型OmniVoice,支持3秒克隆人声和600多种语言。该模型由小米AI实验室开发,采用单阶段扩散语言模型,无需训练即可实现零样本语音克隆。主要功能包括语音克隆、语音设计、情绪控制和发音纠正。相比同类工具,OmniVoice在语言覆盖、中文准确率和生成速度方面表现突出,且完全免费商用。提供整合包和源码两种安装方式,推荐使用NVIDIA显卡以获得最佳性能。使用时需注意参考音频时长
OpenHuman是一款基于Rust+Tauri开发的本地AI智能体桌面工具,采用SQLite+FTS5实现数据本地存储,具备记忆持久化、多平台同步、智能模型调度等核心功能。技术架构包含React前端、Rust业务逻辑层和SQLite存储层,相比Electron具有更小的安装包体积(5MB)和更低的内存占用(50MB)。提供四种部署方式:Windows/Mac一键安装、源码编译和Docker容器化
