- @2501_93406832


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
长上下文 Agent、多轮 Coding Agent 很容易遇到一个隐形问题:上下文越跑越乱,无关日志、历史报错、冗余对话、无效工具返回混在一起,最后模型跑偏、幻觉变多、丢失目标,这个现象就是上下文窗口污染。面试经常问:污染是怎么产生的,有哪些净化手段,各自优缺点。

大仓库下 Coding Agent 不能直接把全量代码丢进上下文,这篇拆解它从看懂仓库、粗筛、精定位、迭代验证的完整链路,讲清楚向量检索、AST 符号索引、代码图各自的分工,也是 SWE-Agent、Aider、Cline 这类编码智能体的核心考点。

这个问题是 Agent 面试的经典坑题。很多初学者以为:输入一样,输出就应该固定。但实际跑 Agent 的时候,一模一样的用户提问,两次跑出来调用工具顺序不一样、返回答案不一样,甚至中途直接终止。面试官想看你能不能区分「LLM 本身随机性」和「Agent 链路带来的不确定性」。

在开发 AI Agent 时,很多人认为只要给大模型接入几个工具,就能构建一个完整的智能体。但实际上,模型能够发起工具调用,并不意味着任务就能自动执行、持续推进或可靠完成。Agent Harness 正是围绕模型提供运行支撑的重要机制。本文从一次模型调用开始,结合 Excel 自动处理案例,详细讲解 Agent Harness 的核心职责、Agent Loop 执行循环、上下文管理、任务状态保存、

普通 Agent 写好 Prompt、配置好工具之后,能力就固定死了。而自进化 Agent,可以在和用户交互的过程中持续学习,不断优化任务处理逻辑。很多面试同学会误以为自进化等于微调、SFT 重训模型。实际上工业界大量落地的自进化方案,都不需要改动模型权重。本文拆解自进化完整闭环、四类实现路线、工程安全围栏,面试直接参考。

面试高频场景:面试官问 Agent 如何加载大量 Skill,如果你回答 “全部 SKILL.md 文档拼接到 Prompt”,大概率直接扣分。当 Skill 数量达到几十上百个,全量加载会造成上下文浪费、无关信息干扰、成本飙升。工业界主流方案是Skill 渐进式加载(渐进式披露):只常驻技能元数据目录,真正需要该技能的时候,才读取完整 SKILL.md 说明书。本文结合工程目录样例,通俗讲透原理

很多新手写 Agent 上下文压缩,直接写死一个固定阈值:比如 token 占满 80% 就压缩。上线之后会遇到各种奇怪问题:频繁压缩导致信息丢失、压缩开销大拖慢速度、或者阈值设太高直接 OOM。真正生产级的方案,阈值不是固定数字,是一套动态计算策略。这篇文章把阈值怎么算、为什么要滞回、工程踩坑点一次性讲清楚,面试非常容易问到。

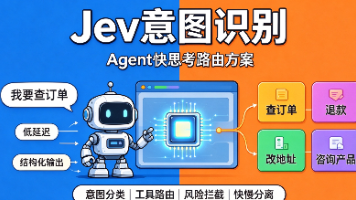
最近 AI 圈刷屏的 Jev 模型,是目前 Agent 工程最火的面试新考点!以前我们做用户意图识别,全都依赖大模型 LLM,不仅慢、贵、还容易幻觉、乱分类。而 Jev 是专门为「判断、选择、打分、真假识别」而生的决策 AI,不聊天、不写文案、不瞎生成,只做精准结构化判断。现在大厂 Agent 架构已经开始更新:大模型负责慢思考规划,Jev 负责快判断意图。本文通俗、有趣、接地气讲透:Jev 是什
“请严格返回 JSON,不要输出其他内容。”这句话很多开发者都写过,但程序照样可能遇到多余说明、字段缺失、类型错误,甚至结构完全正确、内容却不符合业务要求的结果。本文以订单查询助手为例,讲清合法 JSON、符合 Schema 和业务正确三个层次,以及提示词约束、原生结构化输出、工具调用和应用端校验分别承担什么职责。