用豆包 Seed-2.1-pro 从 0 搓了个「发票侠」,这波多模态 Agent 给我爽麻了。。。
大家好,我是桃花键神。
这周 AI 圈儿又有个大动静:豆包 Seed-2.1-pro 升级到了 0915 版本,Doubao-Seed-Evolving 同步更新到同一版本,API 已经上线火山方舟。
注意,这不是全新发布,是升级迭代。官方这次的方向非常明确——多模态 Coding & Agent。翻译成人话:更懂复杂代码仓库,端到端开发能力更强,再加上持续领先的多模态理解,专攻「带眼睛干活的 AI」。顺带一提,Token 效率还在提升,综合使用成本进一步下降。
作为一个天天跟模型、跟代码打交道的后端老开发,这种升级我必须第一时间上手。
然后我盯着屏幕想了十分钟:测啥呢?
我平时最烦的一件事就是贴发票。每个月为了报销,我得把一堆专票、普票、火车票、行程单挨个抄字段、录表格,抄到眼冒金星。以前我也想搓个工具自动搞定,但一想到要写前端、写后端、接 OCR、调版式,周末就没了,一直搁置。
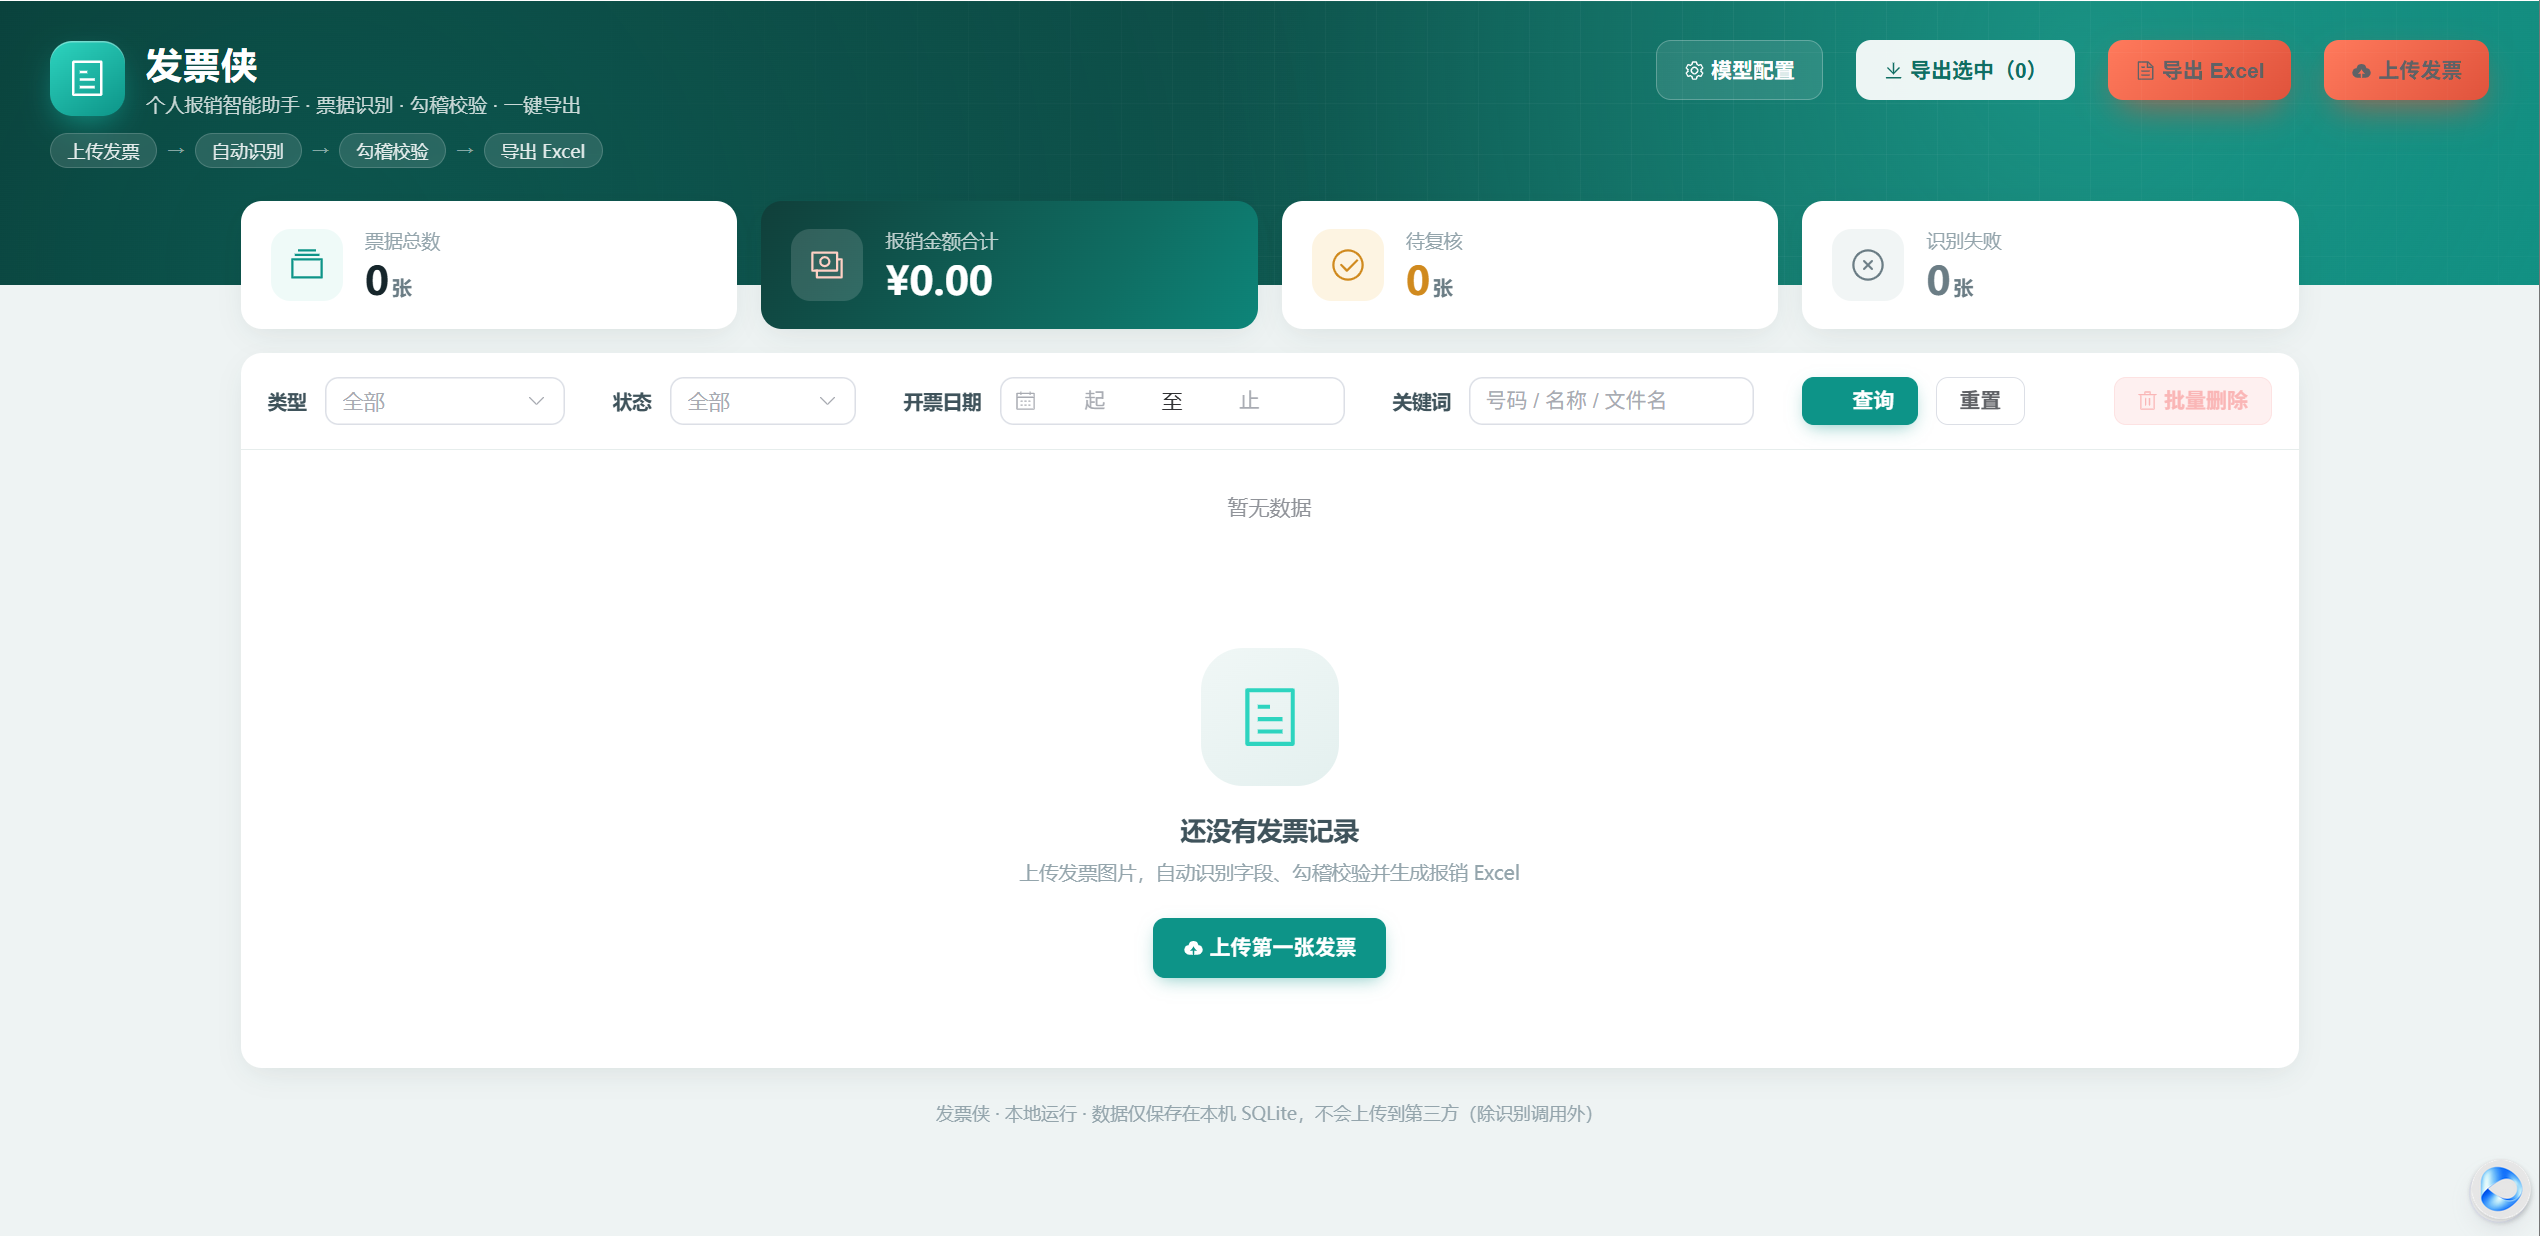
这次干脆一不做二不休:直接让升级后的 Seed-2.1-pro 帮我把这个工具搓出来,我给它起名叫——「发票侠」。
在线体验地址https://modelscope.cn/studios/taohuaJS/fapiaoxia
为啥偏偏拿发票开刀?
有同学可能想问:测评模型,为啥不搞个炫酷的 3D 游戏,偏偏测发票这种土里土气的场景?
因为发票识别,恰恰是多模态模型最硬核的试金石:
-
版式杂:专票、普票、电子票、火车票、行程单、出租车票,长得五花八门,没有统一的模板;
-
字段密:一张专票几十个字段,购买方、销售方、金额、税额、税率挤在一起,密密麻麻;
-
容错低:聊天写错字无所谓,发票金额错一分钱,报销当场卡死;
-
要验真:金额 + 税额 = 价税合计,这种勾稽关系是硬约束,编不出来。
很多模型你让它看图聊天,嘎嘎香;你让它一张图里抠 30 个字段还不能错,立马原形毕露。
这次测评的设计:让考生自己考自己
更损的还在后面。这次我设计了个「双重考验」:
-
第一重:在豆包工作里用 Seed-2.1-pro,从 0 生成整个「发票侠」项目——这考的是多模态 Coding;
-
第二重:「发票侠」内部接的发票识别模型,也是 Seed-2.1-pro——这考的是多模态理解。
打个比方,这相当于既考你会不会写菜谱(Coding),又考你认不认得食材(VLM)。而且这两门考试,用的是同一个考生。
它要是把自己写的识别模块喂给自己生成的项目,还能认得出票据、算得平账,那这波升级就是真的能打。要是识别模块是它自己写的,结果它自己都认不出发票,那就尴尬了。。。
废话不多说,直接开搓!
实战:从一句话到一个完整项目
第一轮:把需求说清楚
老规矩,先把提示词写明白。虽然又臭又长,但结构很清晰:需求背景、要识别的票据类型、字段清单、勾稽校验规则、技术栈、验收标准,一共六个部分。
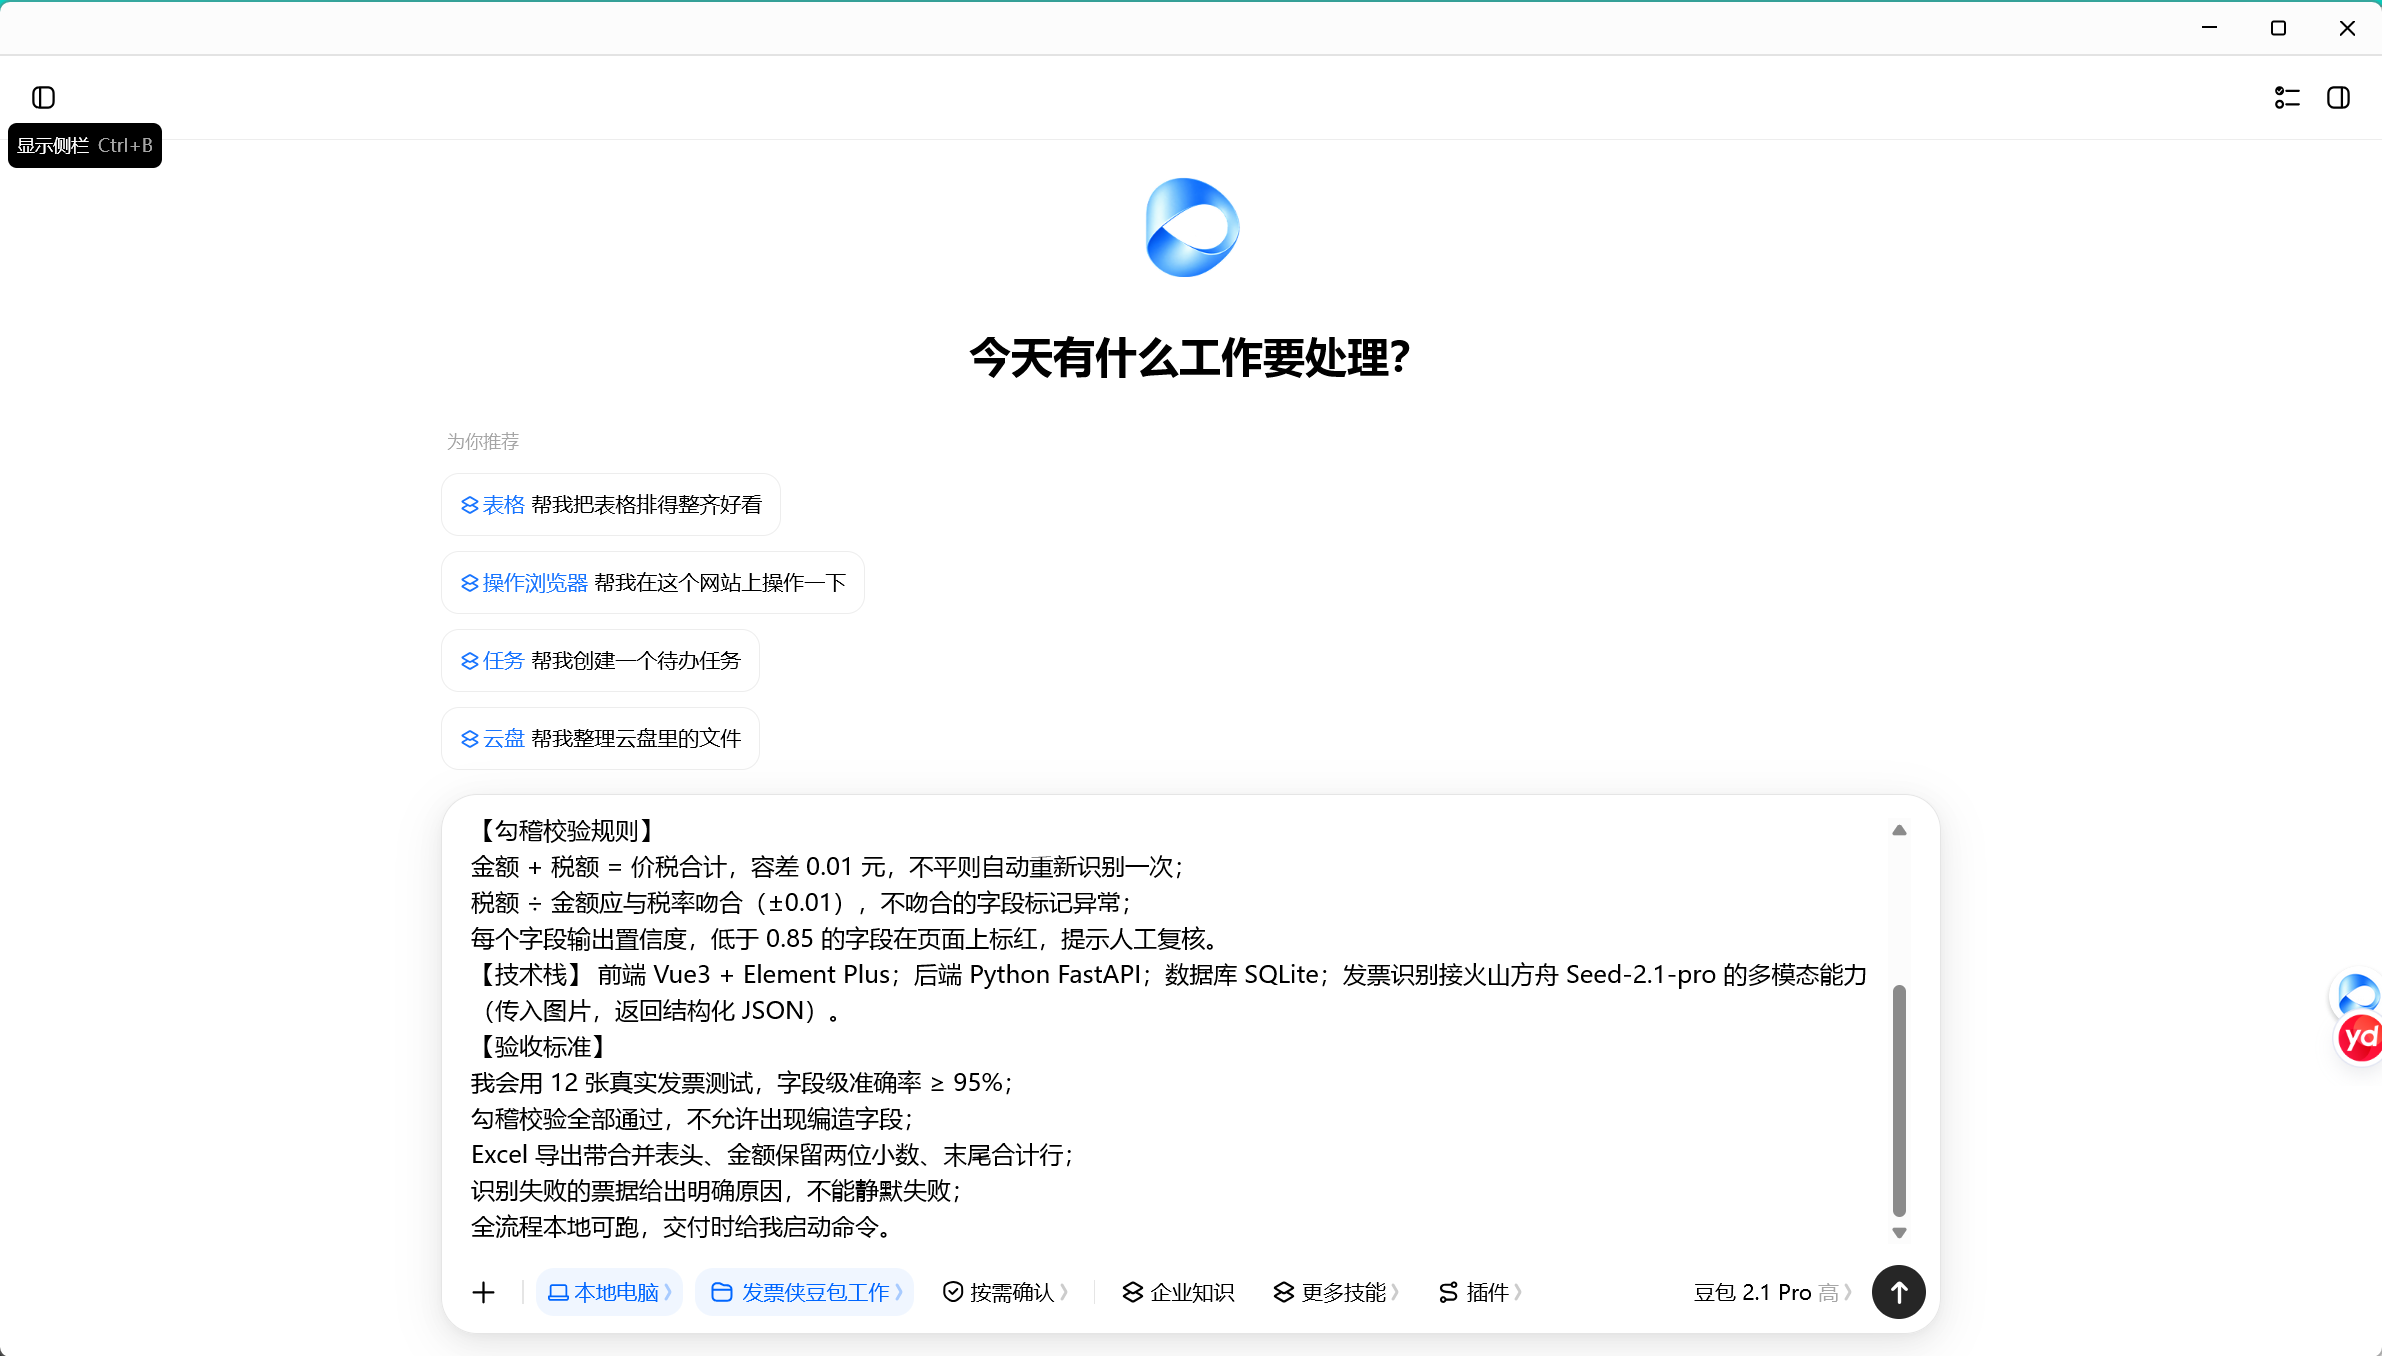
把完整提示词贴给大家,不用来回翻了:
【需求背景】 我要做一个个人报销工具「发票侠」。每月贴发票录表格太痛苦,需要:上传发票图片 → 自动识别字段 → 结构化入库 → 列表管理 → 一键导出报销 Excel。
【要识别的票据类型】 增值税专用发票、增值税普通发票(含电子票)、火车票、航空运输电子客票行程单、出租车发票。
【字段清单】 通用字段:票据类型、发票代码、发票号码、开票日期、价税合计(大写); 专票/普票:购买方名称及税号、销售方名称及税号、金额、税率、税额; 火车票:乘车人、车次、出发站、到达站、开车时间、座位类型、票价; 行程单:乘机人、航班号、日期、出发/到达机场、票价、燃油附加费、民航发展基金; 出租车票:上车时间、下车时间、里程、金额。 识别不到的字段留空,禁止编造。
【勾稽校验规则】
金额 + 税额 = 价税合计,容差 0.01 元,不平则自动重新识别一次;
税额 ÷ 金额应与税率吻合(±0.01),不吻合的字段标记异常;
每个字段输出置信度,低于 0.85 的字段在页面上标红,提示人工复核。
【技术栈】 前端 Vue3 + Element Plus;后端 Python FastAPI;数据库 SQLite;发票识别接火山方舟 Seed-2.1-pro 的多模态能力(传入图片,返回结构化 JSON)。
【验收标准】
我会用 12 张真实发票测试,字段级准确率 ≥ 95%;
勾稽校验全部通过,不允许出现编造字段;
Excel 导出带合并表头、金额保留两位小数、末尾合计行;
识别失败的票据给出明确原因,不能静默失败;
全流程本地可跑,交付时给我启动命令。
这里多哔哔一句:写提示词别偷懒。很多同学说 AI 做的东西不符合预期,其实大概率是需求没说清楚。你把验收标准写进提示词里,AI 的交付质量直接上一个台阶。
细品后面第三轮踩坑的同学会发现:「自己打回重试」「低置信度标红」这两个亮点,其实就是我在提示词里提前埋好的勾稽规则和置信度要求。AI 照着规矩办事,惊喜感直接翻倍~
第二轮:AI 自己出架构
提示词发出去,Seed-2.1-pro 没急着动手,先给我交了个架构设计:前端页面 + 后端服务 + VLM 识别模块 + SQLite 存储,模块之间怎么调用、数据怎么流转,画得明明白白。
然后就是疯狂输出环节。我在豆包工作里看着它自己拆任务、写代码、跑自测,全程我只负责嗑瓜子。
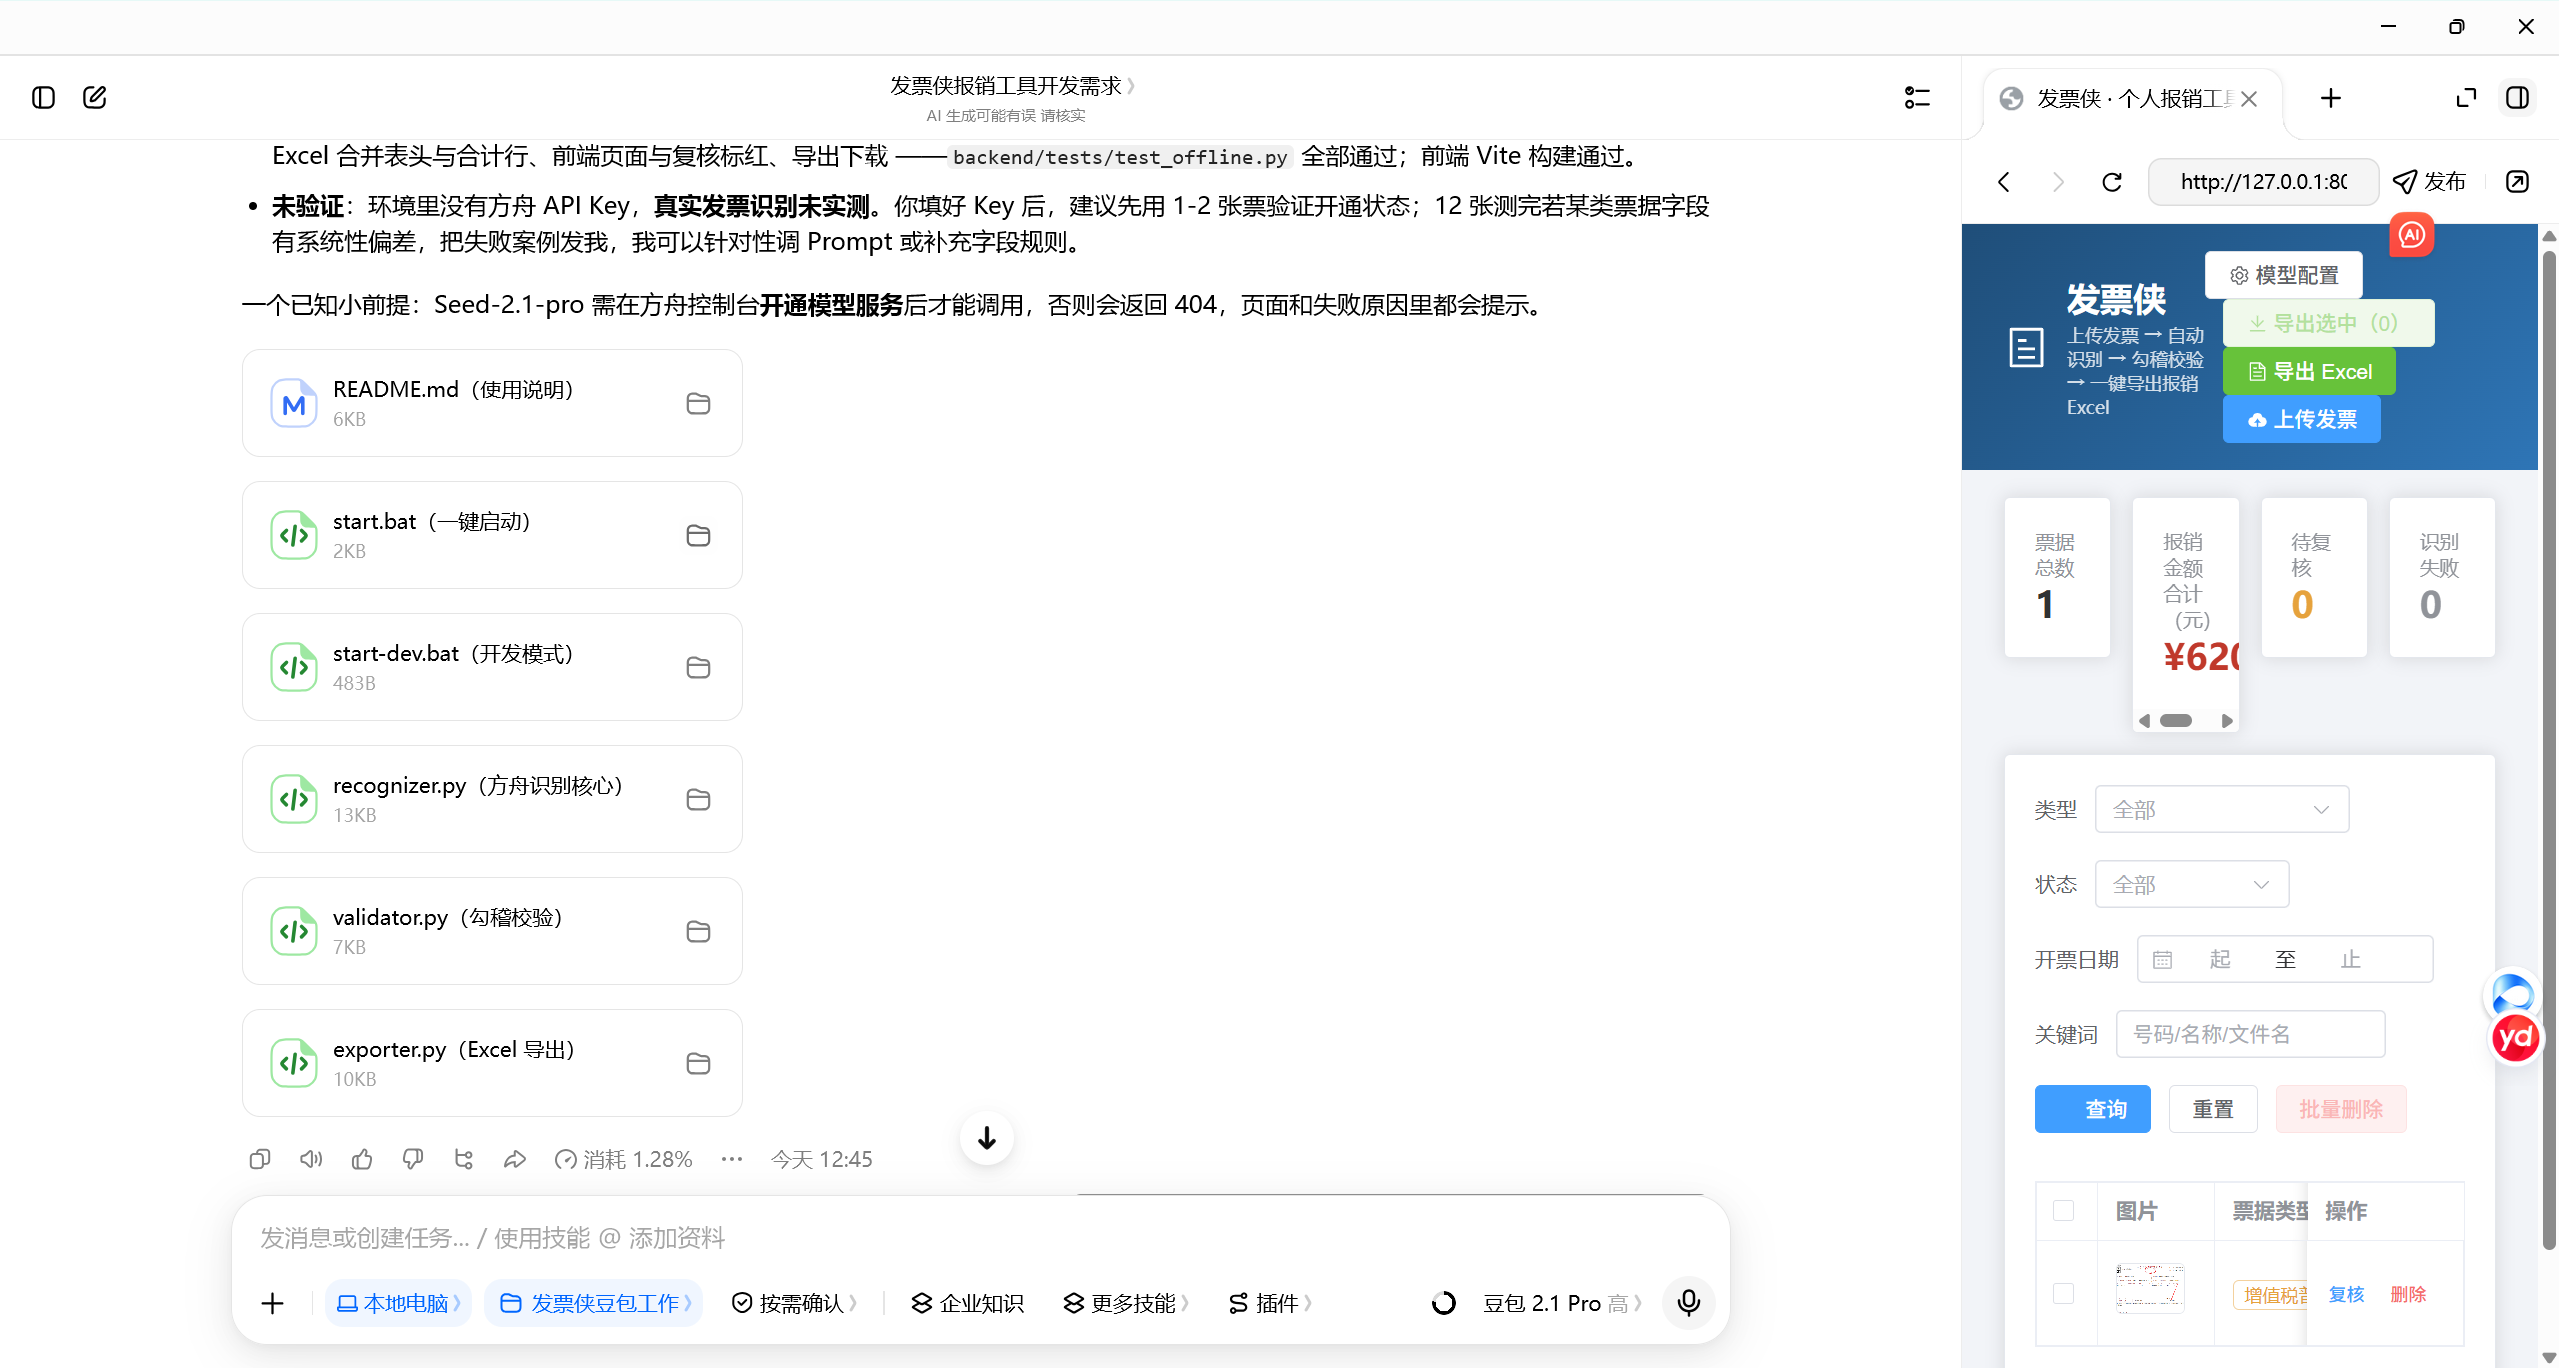
从提需求到项目能跑起来,总共 2轮对话,3000 多行代码,十几分钟。搁以前我自己手搓,前端后端加联调,一个周末就交代进去了,这波是真的省。。。
第三轮:接上识别能力,踩了个坑
关键环节来了:把 Seed-2.1-pro 的多模态识别能力接进「发票侠」,让它认发票。
第一版跑出来,好家伙,API连不上。AI 在自检环节发现是我给错配置Base URL了,尴尬。。。
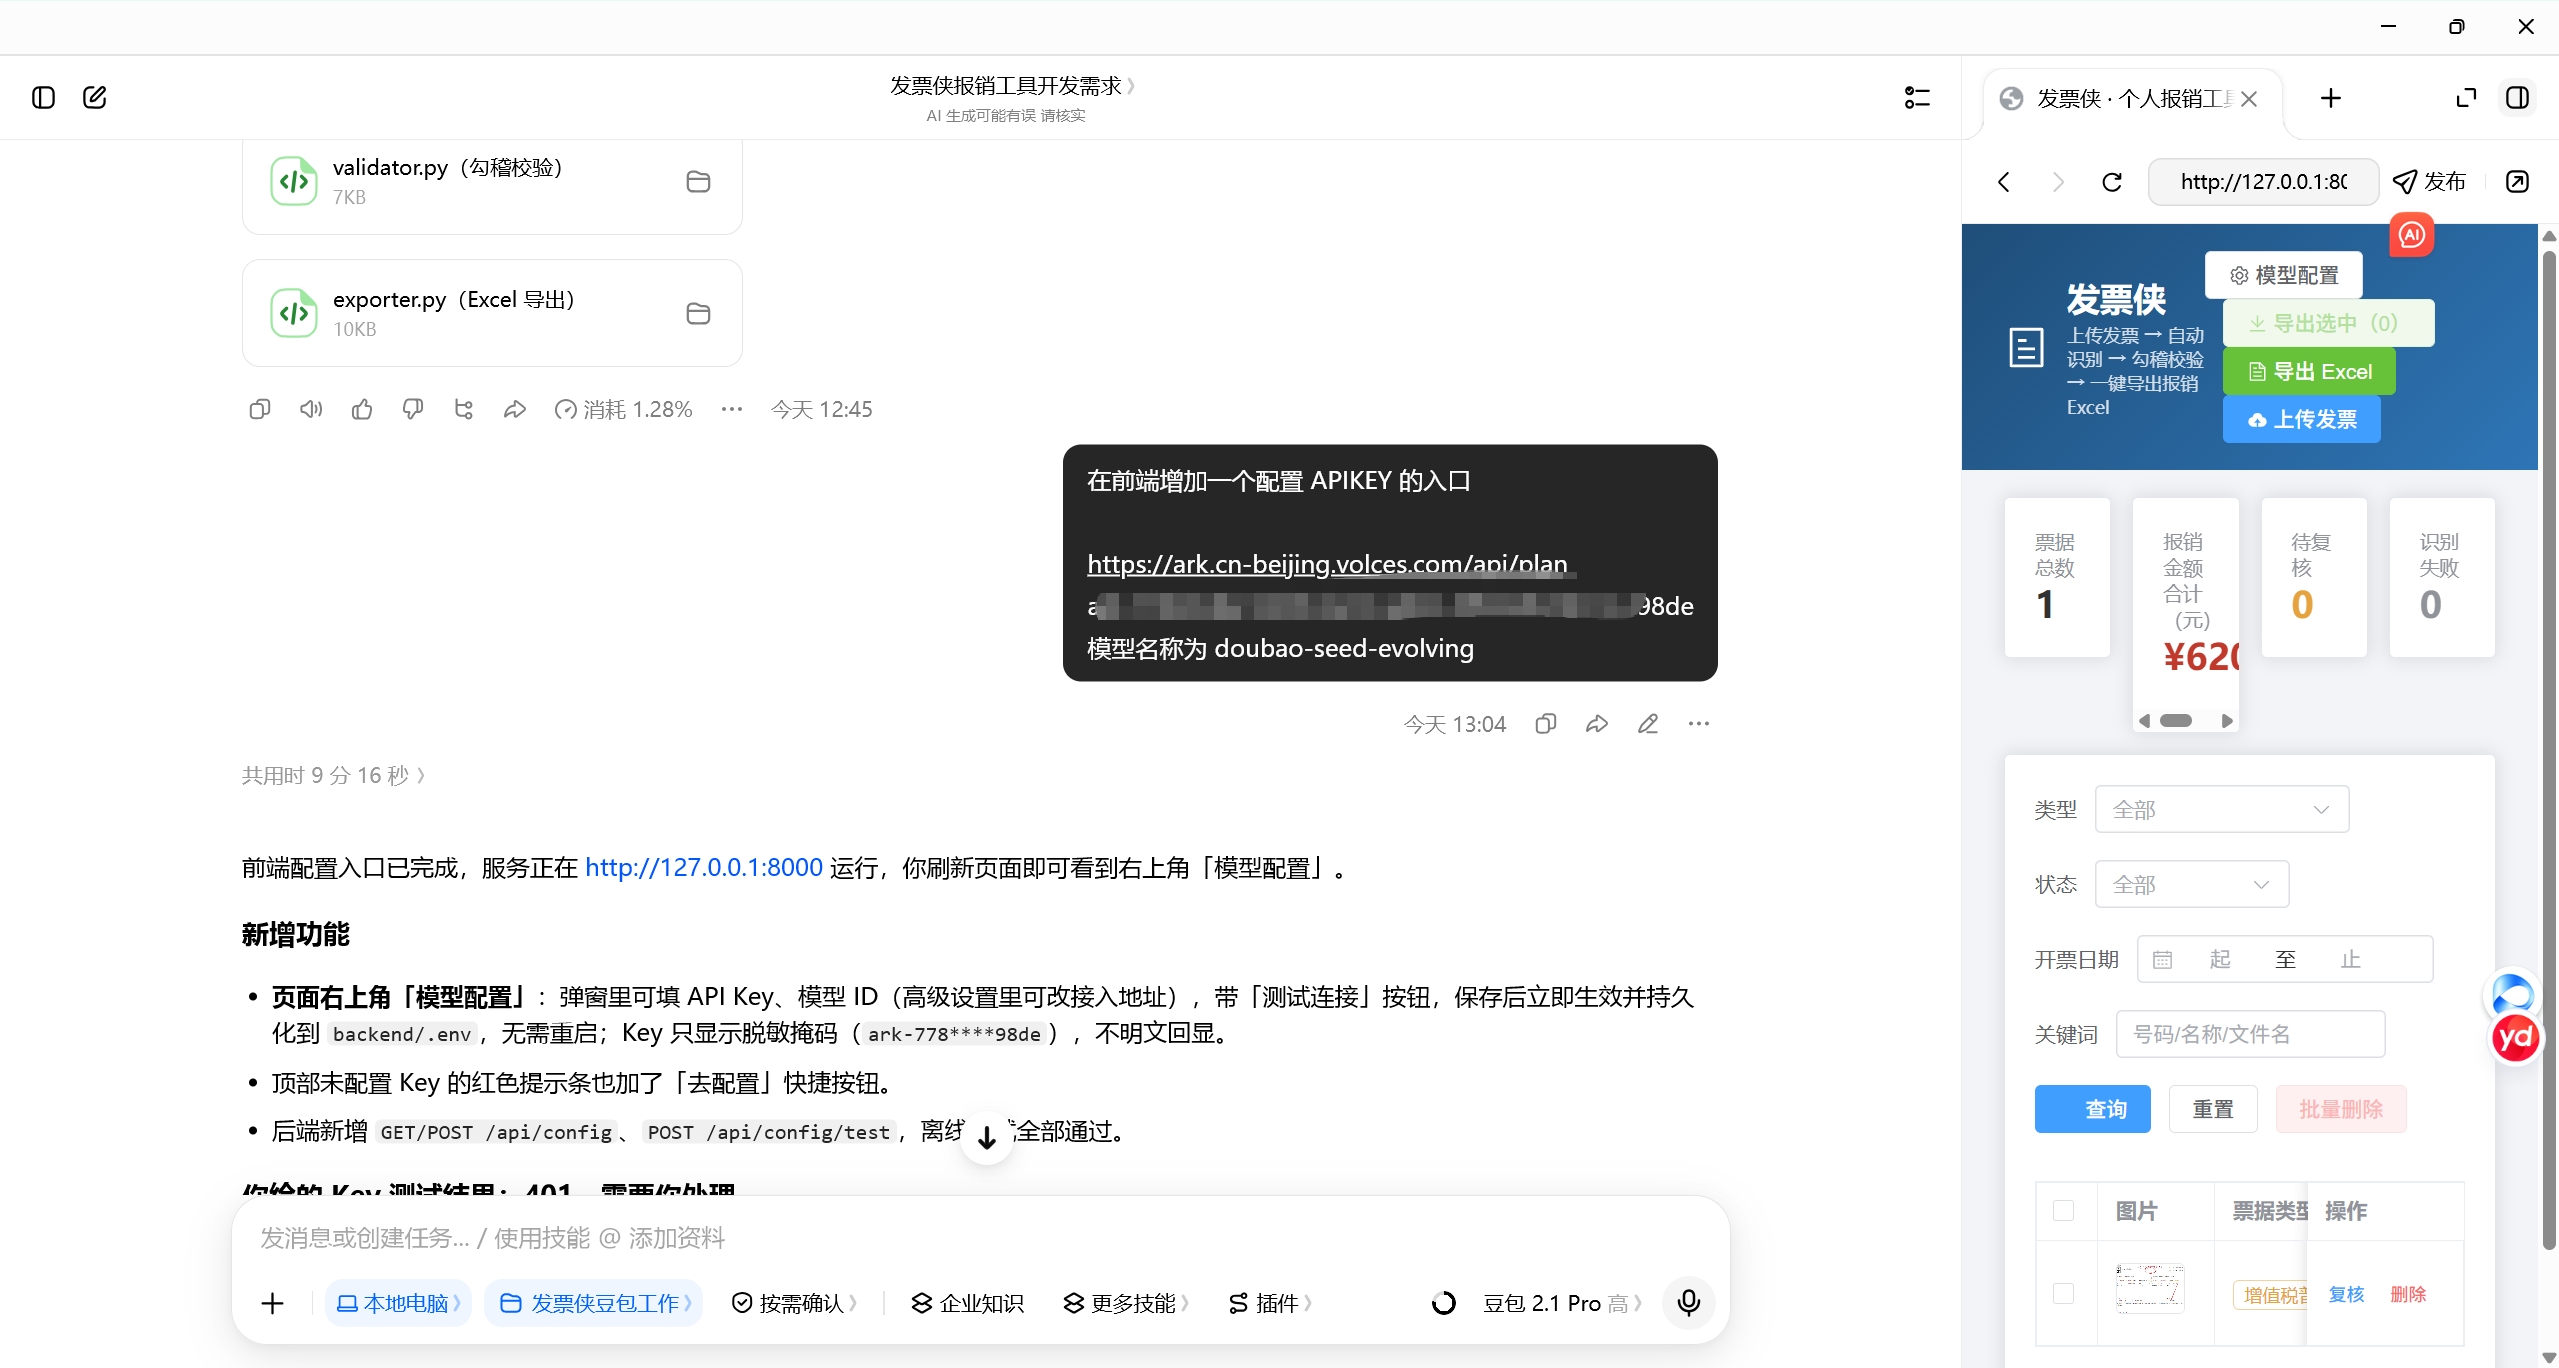
这就是这次升级我感受最明显的一点:行动和反馈是对得上的。以前的模型经常是「我觉得我做完了」,现在这个是真的会回头核对自己的作业。对于 Agent 场景来说,这比单纯聪明更重要。
而且它还顺手加了个保险:识别置信度低的字段自动标红,提醒人工复核。省心~
第四轮:页面太丑了,整个容。
目前生成的这个页面功能都齐全了,就是长得有点粗糙,来整个容看看效果。
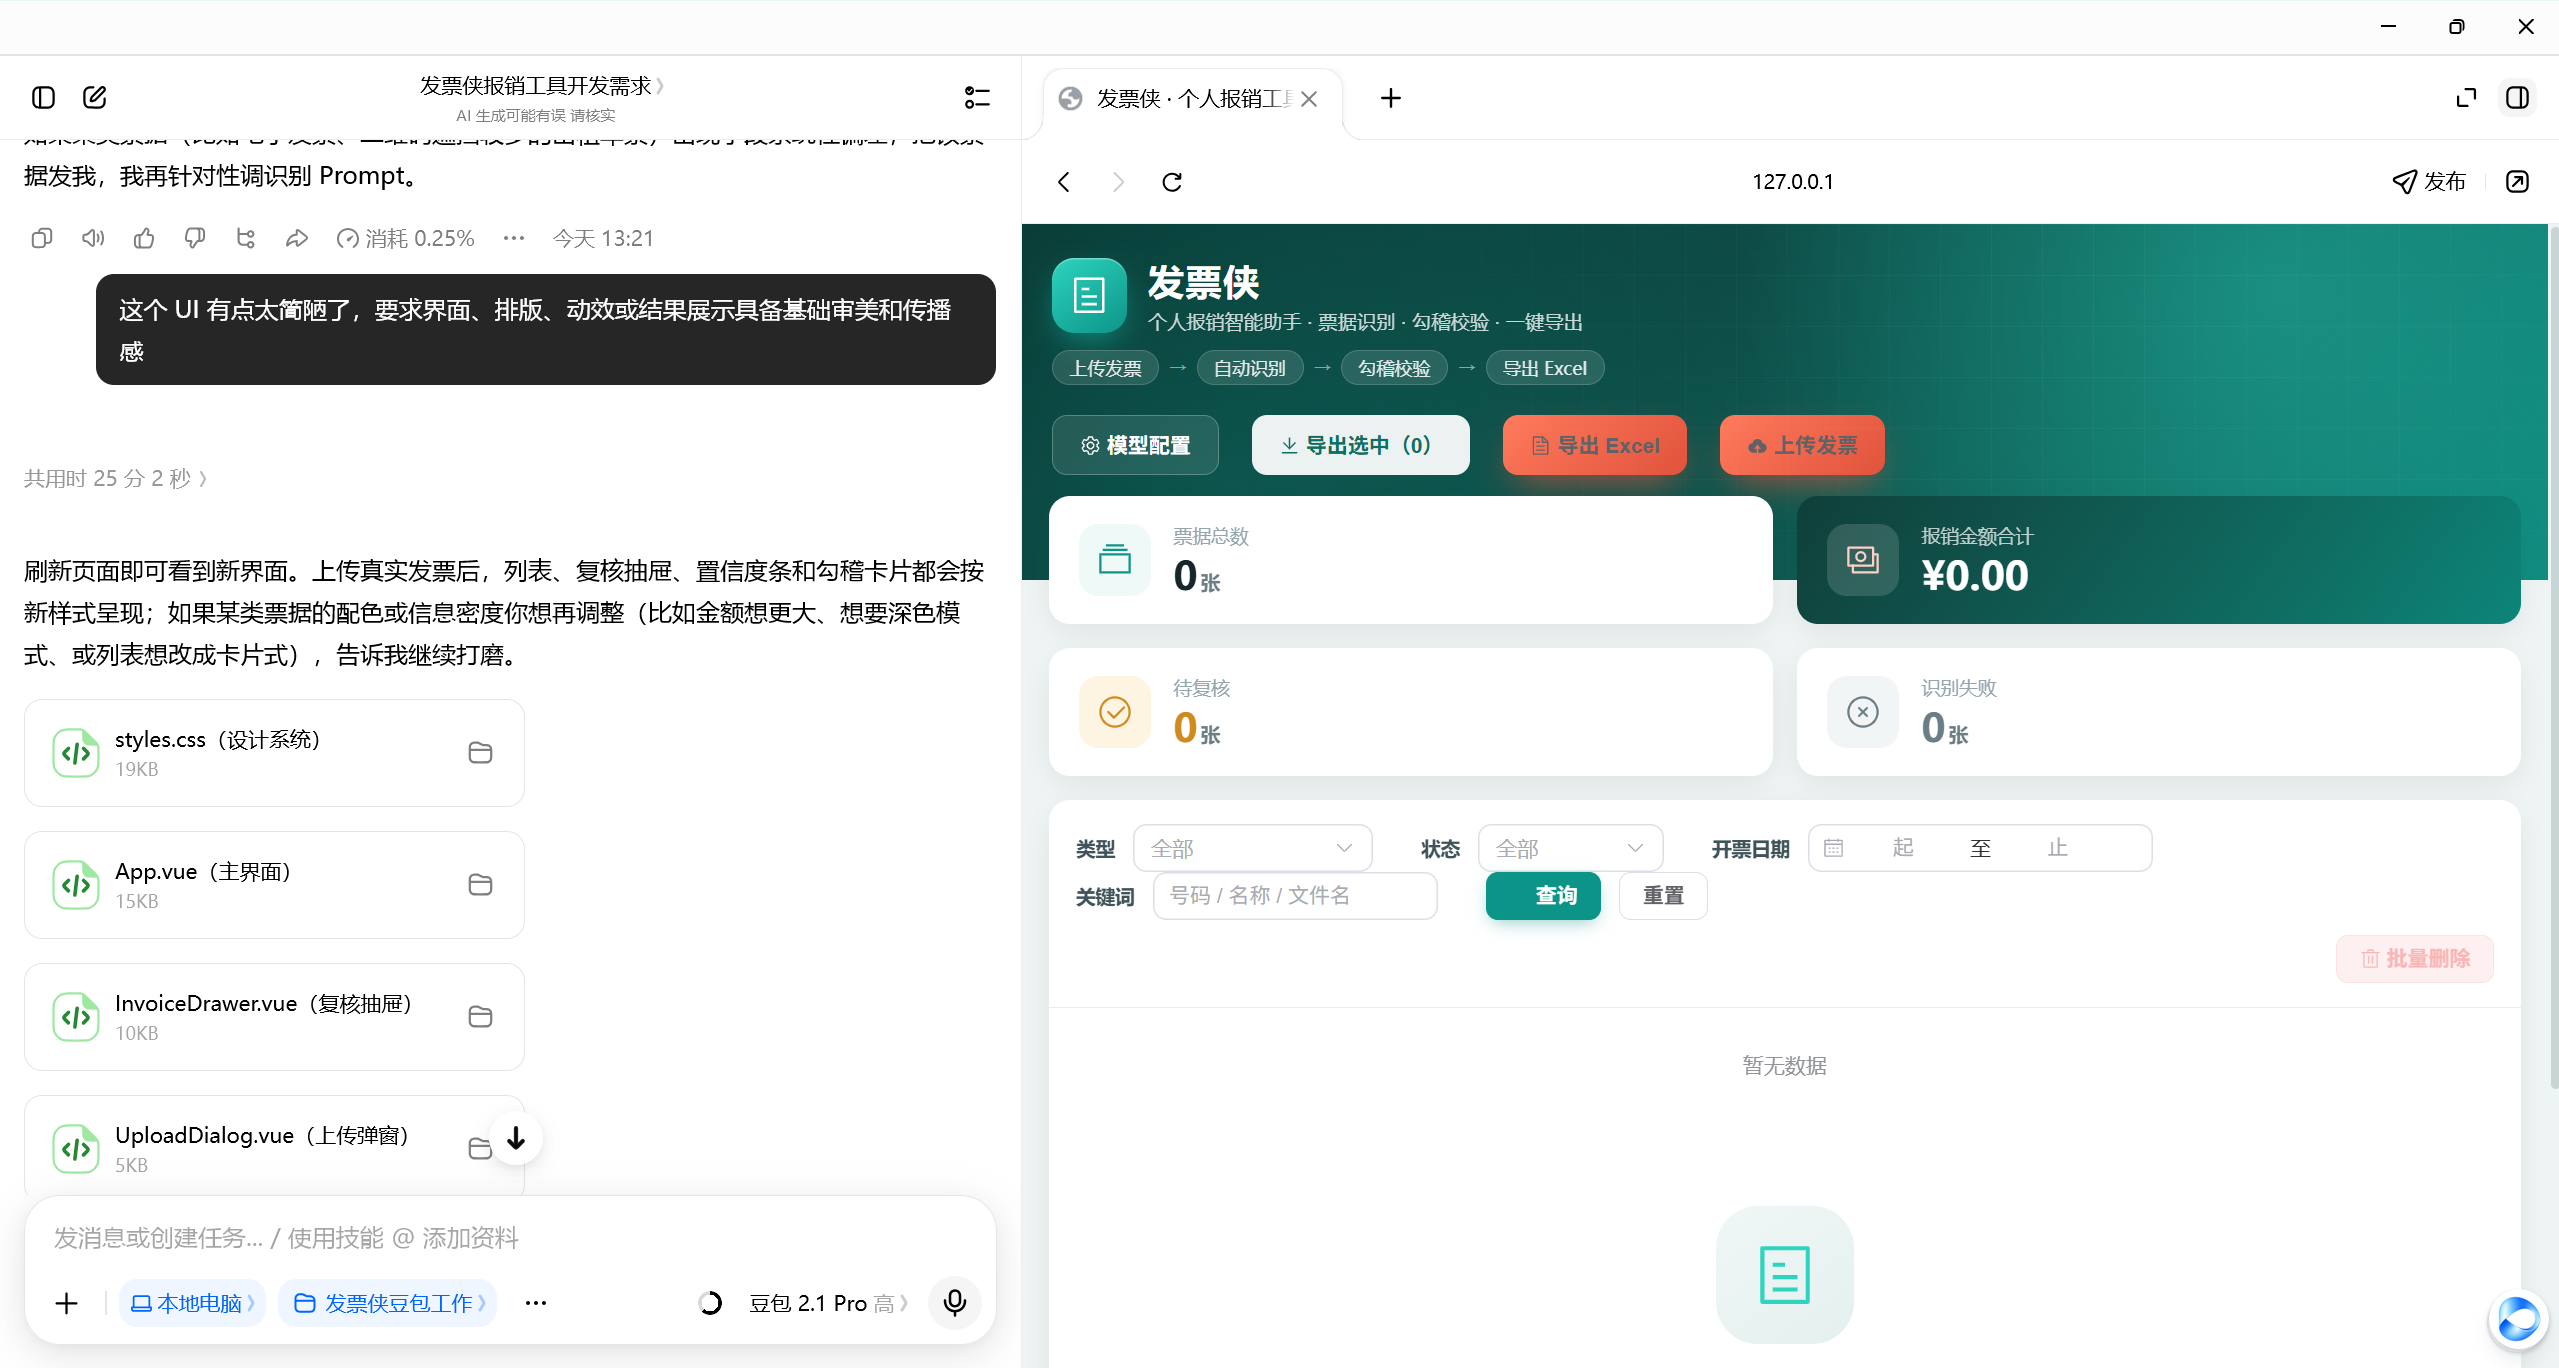
这就好看多了,赏心悦目呀!
硬核实测:3 张发票,结果说话
光说不练假把式。我找了三张发票,一个租金发票、两张车票,全扔给「发票侠」识别。
正确率100%
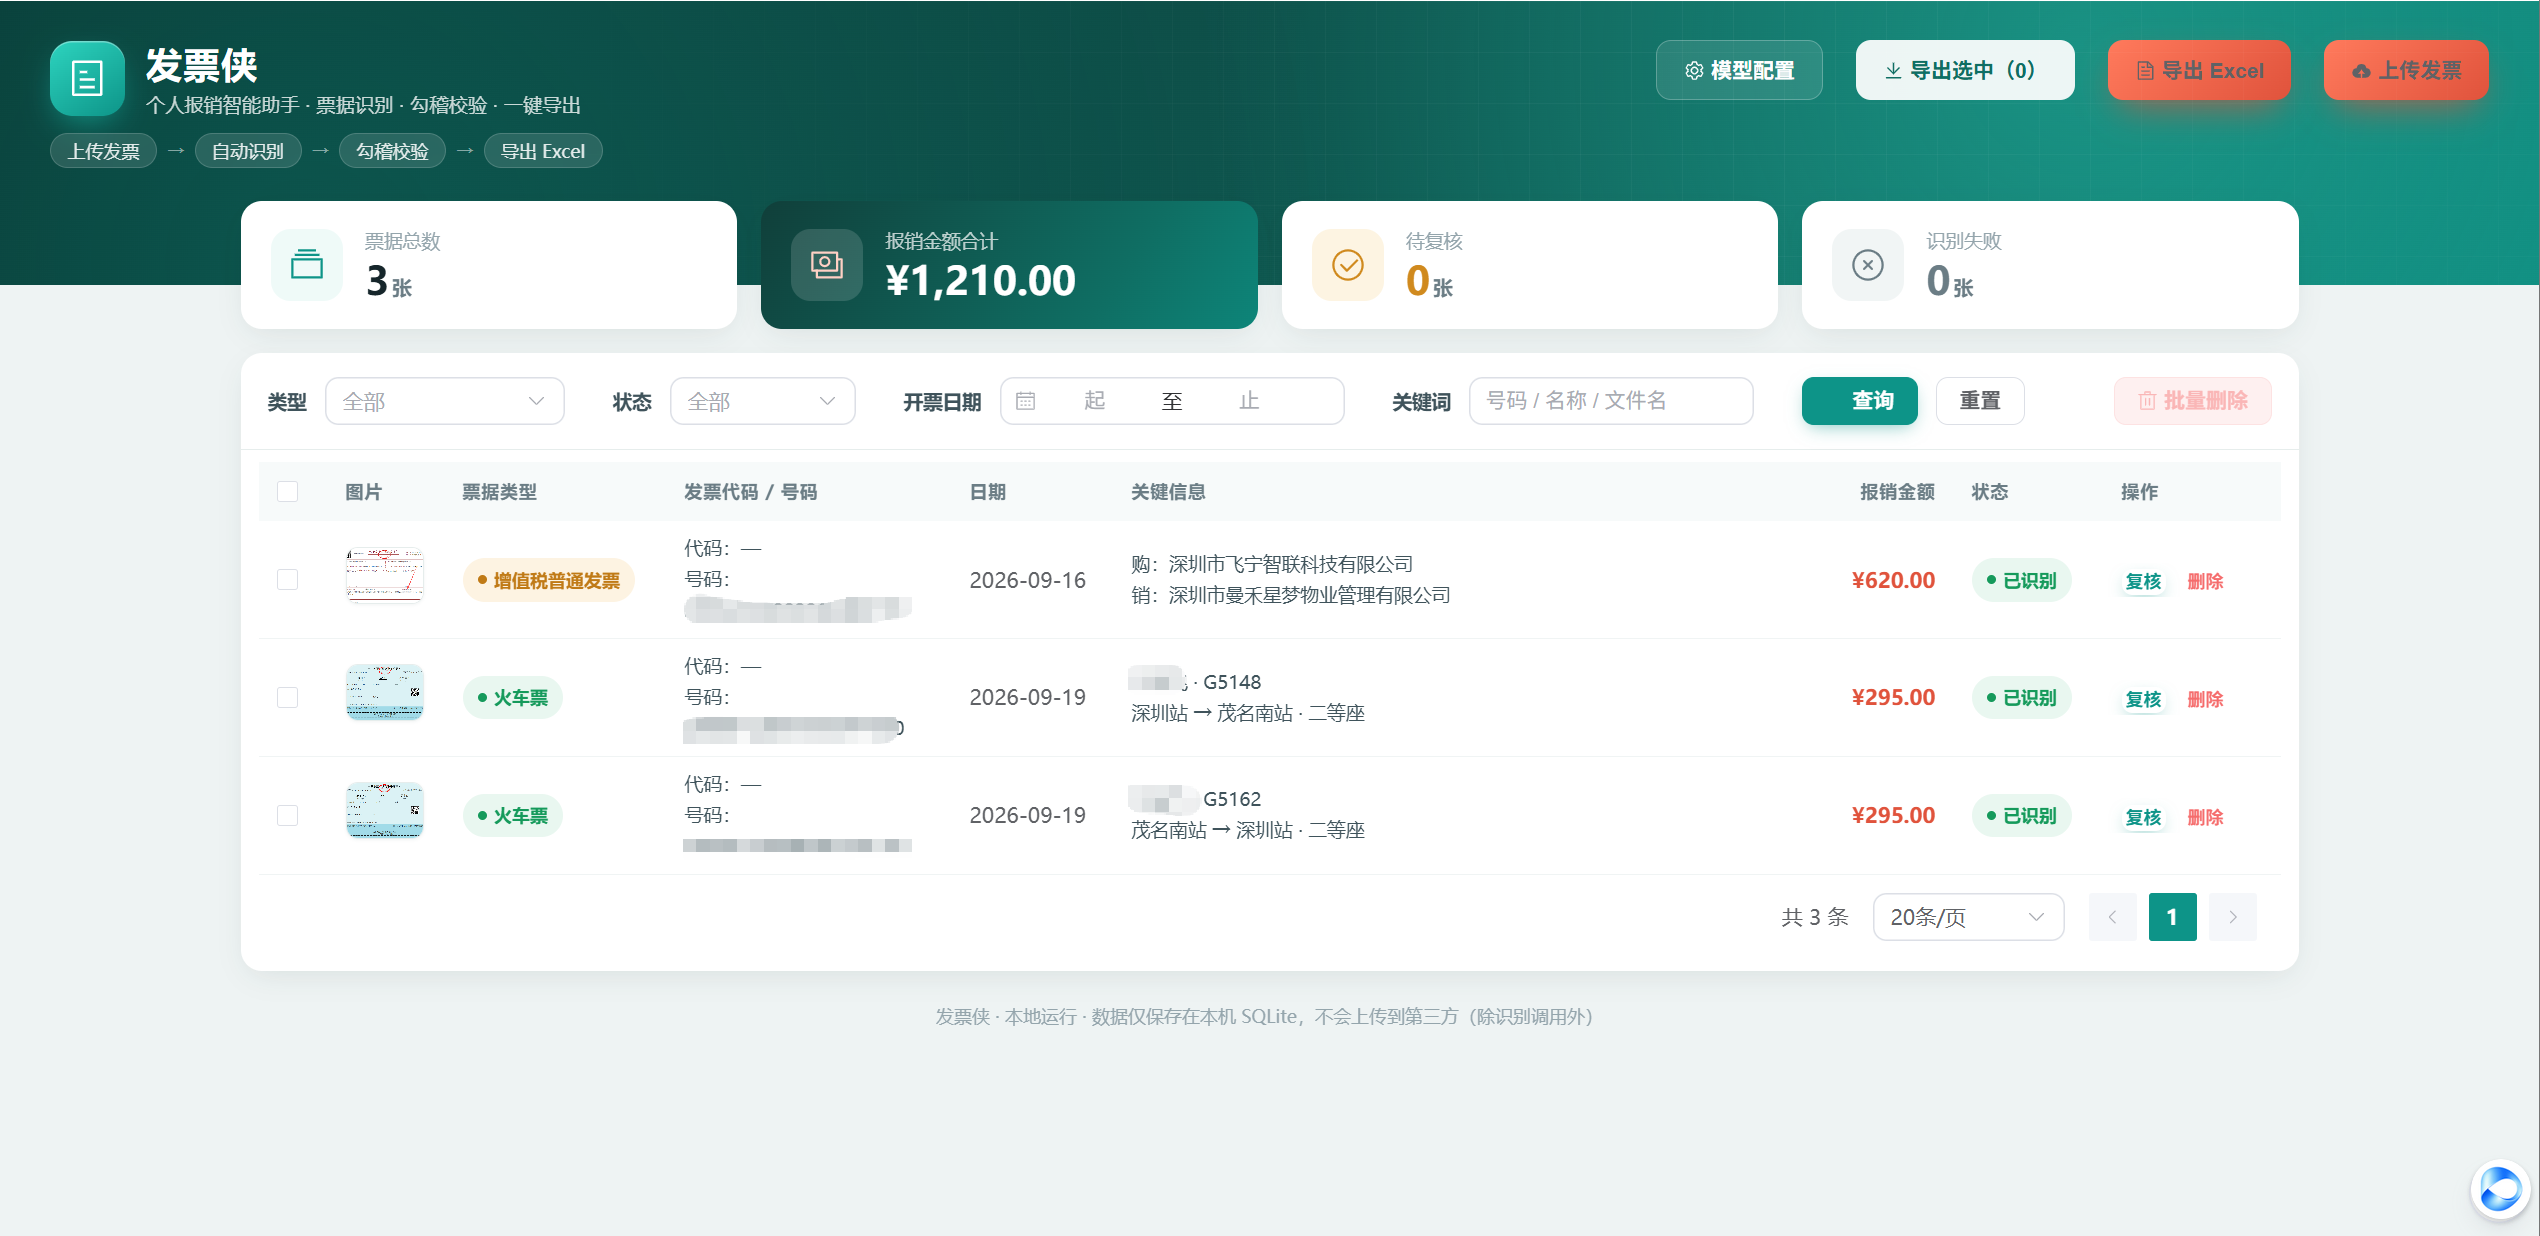
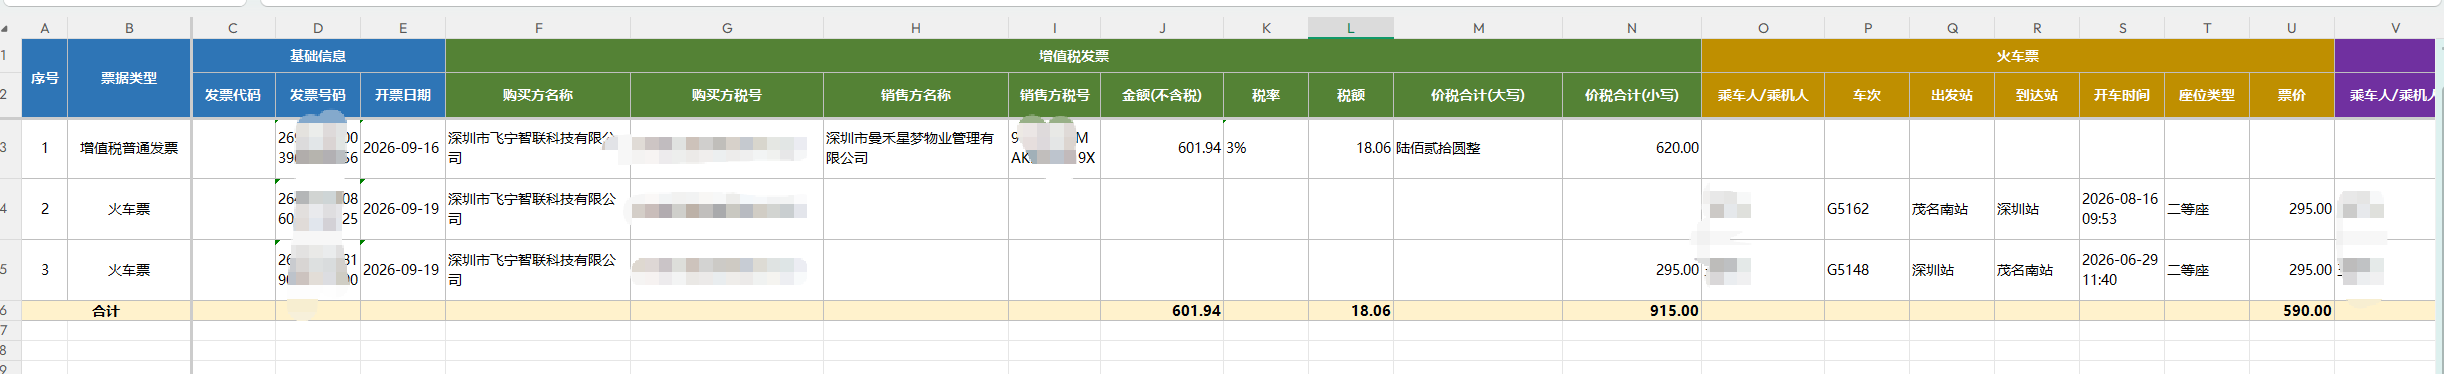
其中勾稽校验全部通过,没有一张票的金额关系是对不上的。导出的表格也是十分清晰,各种发票都写的很明白。
所以结论也很清楚:印刷体票据基本嘎嘎乱杀,手写体和刁钻角度还有翻车空间。大家拍发票,还是老老实实放正了拍吧~
算笔账:这一趟花了多少钱?
最后报数据:
-
开发全程:3 轮对话,3000+ 行代码,十几分钟;
-
消耗:只消耗了7天额度的2.2%
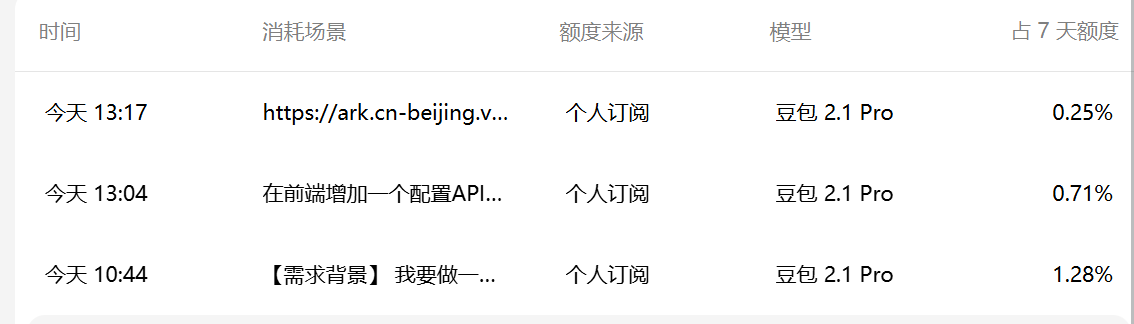
搁以前做这个小工具,费时费力费钱。如今Token 效率提升带来的成本下降,在这种小项目上是真能感知到的。
优缺点总结
优点:
-
多模态 Coding 一条龙:从架构到代码到联调,端到端自己扛,中途不用人救;
-
识别能力扎实:印刷体票据字段级准确率 100%,勾稽校验全过;
-
有自检意识:发现问题自己打回重试,不提前宣告完成,这点对 Agent 太重要了。
缺点:
-
手写体、大角度倾斜的票据还有翻车概率,重要场景记得人工复核;
-
长任务中间的进度汇报偶尔有点啰嗦(也可能是我耐心的问题)。
一句话结论:想给自己的业务快速搓一个「带眼睛」的小工具,这波升级后的 Seed-2.1-pro 是真的能打;但如果要 100% 稳定的票据 OCR 生产线,专业票据 API 还是更保险的选择。
一座年轻的奋斗人之城,一个温馨的开发者之家。在这里,代码改变人生,开发创造未来!
更多推荐
 3
 0
- 0


 已为社区贡献65条内容

所有评论(0)