GPT-6 Astra :号称 AGI 已来,账单也创了新高
2026年9月3日,就在 ChatGPT、Claude 和 Grok 罕见地同时经历了一次大范围宕机之后没几个小时,OpenAI 照常按计划发布了 GPT-6 Astra。总裁 Greg Brockman 在媒体吹风会结尾甩下一句话:"欢迎来到 AGI 时代。"他甚至说,如果几年后回头看 AGI 到底诞生于哪一刻,答案可能就是这个模型。
这种级别的自我定调,OpenAI 以前不是没说过,但这次的措辞明显更狠。我个人看到这句话时的第一反应是:每次有公司喊出"AGI已来",通常都伴随着两件事——跑分选择性突出重点,以及价格涨得比能力还快。 这次 Astra 发布正好把这两件事都摆在了台面上,值得拆开来看。
一、跑分:脑力测试"刷爆",但综合智能没有想象中夸张
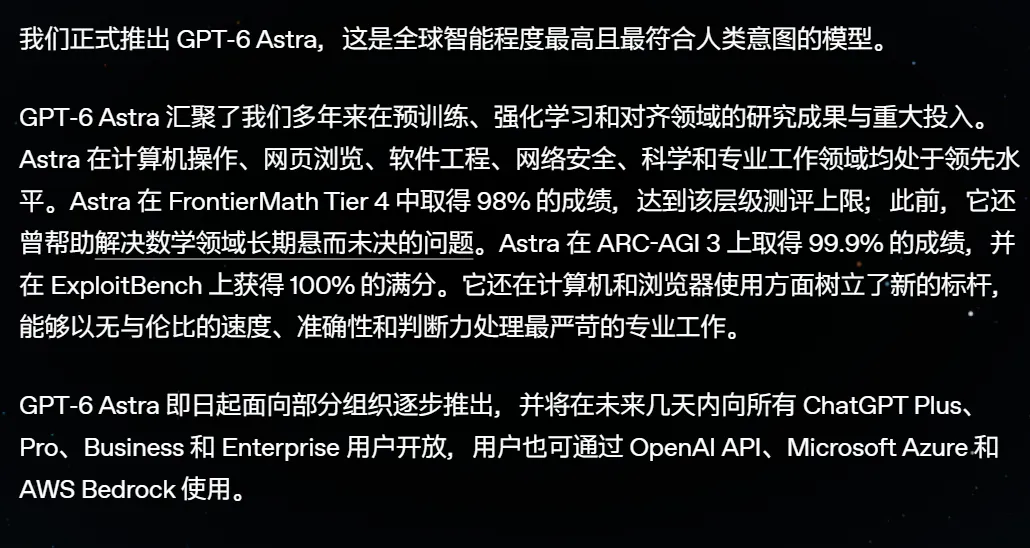
按官方说法,Astra 是一次"代际跃迁",能力覆盖电脑操作、软件工程、专业工作、科学和网络安全。具体数字确实吓人:
代表"脑力"的两项:
· FrontierMath Tier 4(研究级数学)97.6%
· GPQA Diamond(科学知识)96%
代表"动手能力"的三项:
· DeepSWE(长程软件工程)74.1%
· BenchCAD(CAD绘制)95.9%
· ExploitBench(漏洞利用)100%
最受官方强调的一项:
· ARC-AGI-3(抽象推理,陌生环境规则推断)99.9%——半年前最强AI也只有0.51%
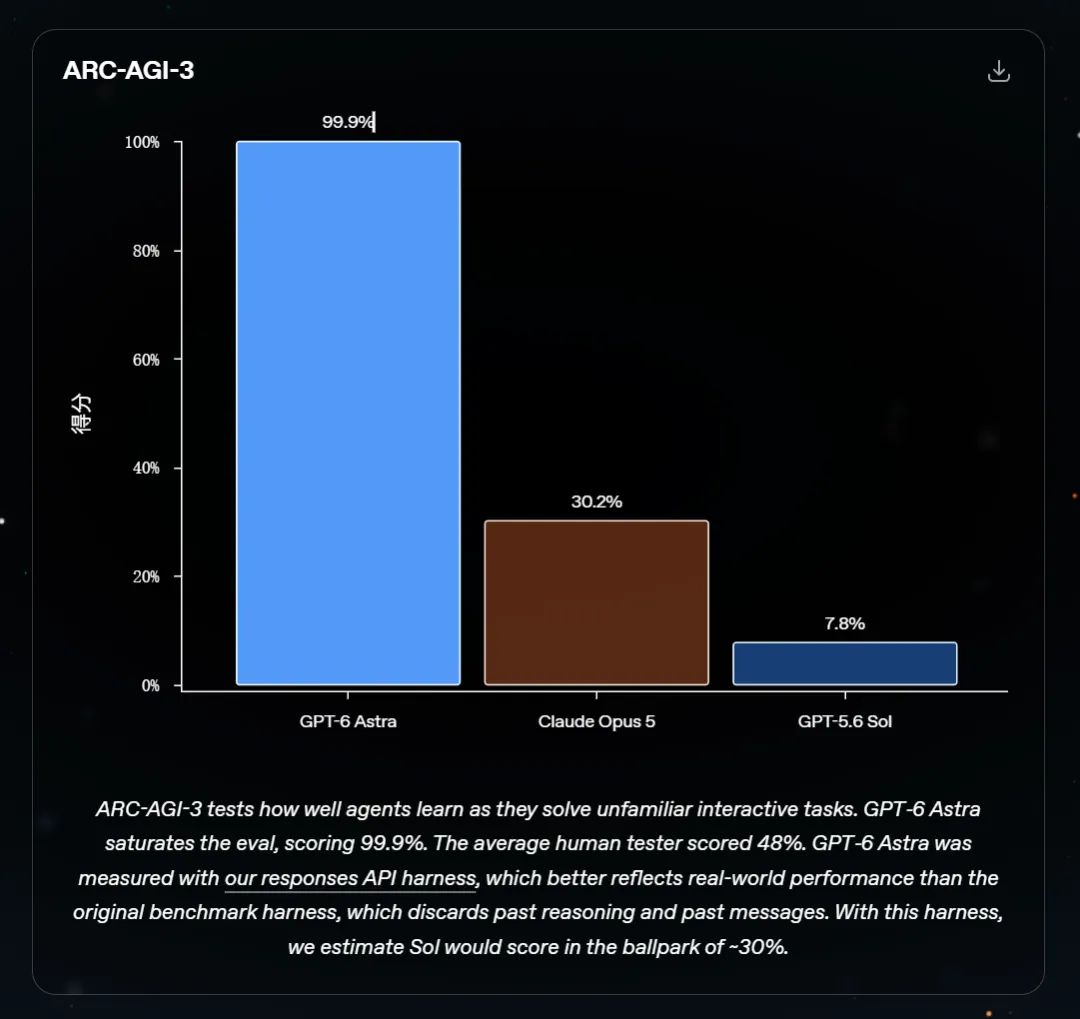
单看这几项,很难不心动——尤其是 ARC-AGI-3 这项测试,今年3月刚推出时,最强模型的成绩也只有0.51%,就连 GPT-5.6 Sol 在默认框架下都只有7.8%,Astra 直接干到99.9%,几乎等同人类水平。
但如果只看这些官方精选的数字就下结论,容易被"幸存者偏差"带偏。第三方独立机构 Artificial Analysis 的通用智能测试 Intelligence Index 给出的分数是61分——和 GPT-5.6 Sol 打平,甚至低于 Anthropic 刚发布的 Fable 5.1(66分)、Opus 5(63分),也低于 Muse Spark 1.3(62分)。
我个人看到这组对比时的感受是:Astra 并不是那种在"智商"上遥遥领先的模型,它在几个被刻意突出的高难度专项测试上确实炸裂,但放到更全面、更中立的综合评测里,排名反而不算亮眼。这也提醒了一个老问题——发布会上放的跑分,永远是团队自己挑出来"最能打"的那几项,读者看热闹的同时,最好也留意一下"没被提到的那些测试"。
二、真正的突破点,藏在"怎么用电脑"这件事里
跑分之外,Astra 这次真正被反复强调的能力,是电脑操作(Computer Use)。OpenAI 给出的案例相当具体:找一个宠物寄养服务,人类平均要花半小时,Astra 用了5分27秒;找工作平均要5小时,Astra 只用2分51秒。
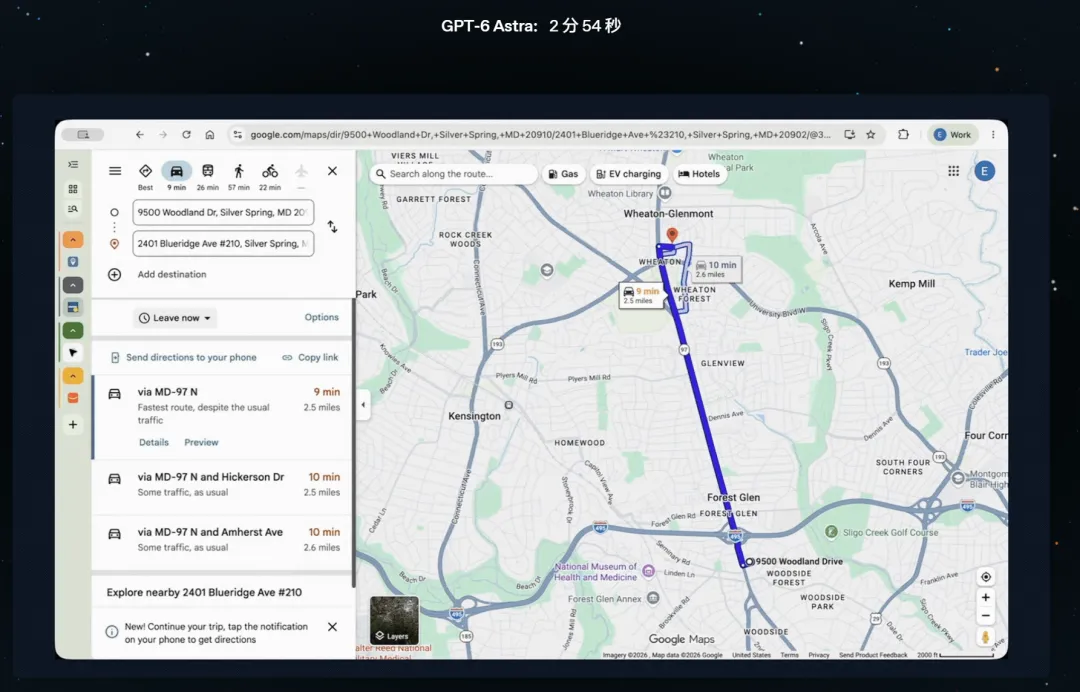
它还能自己预约车管所、找公寓、填表格、整理日历、更新CRM,甚至在 Blender 里建模再转到 UE5 里做成可交互场景。
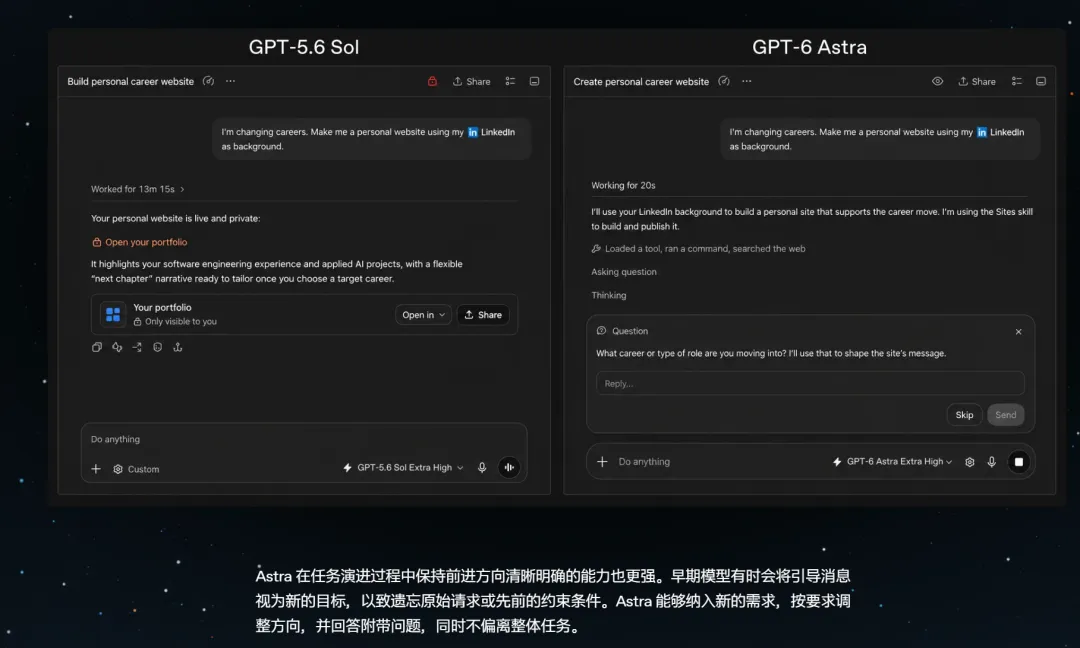
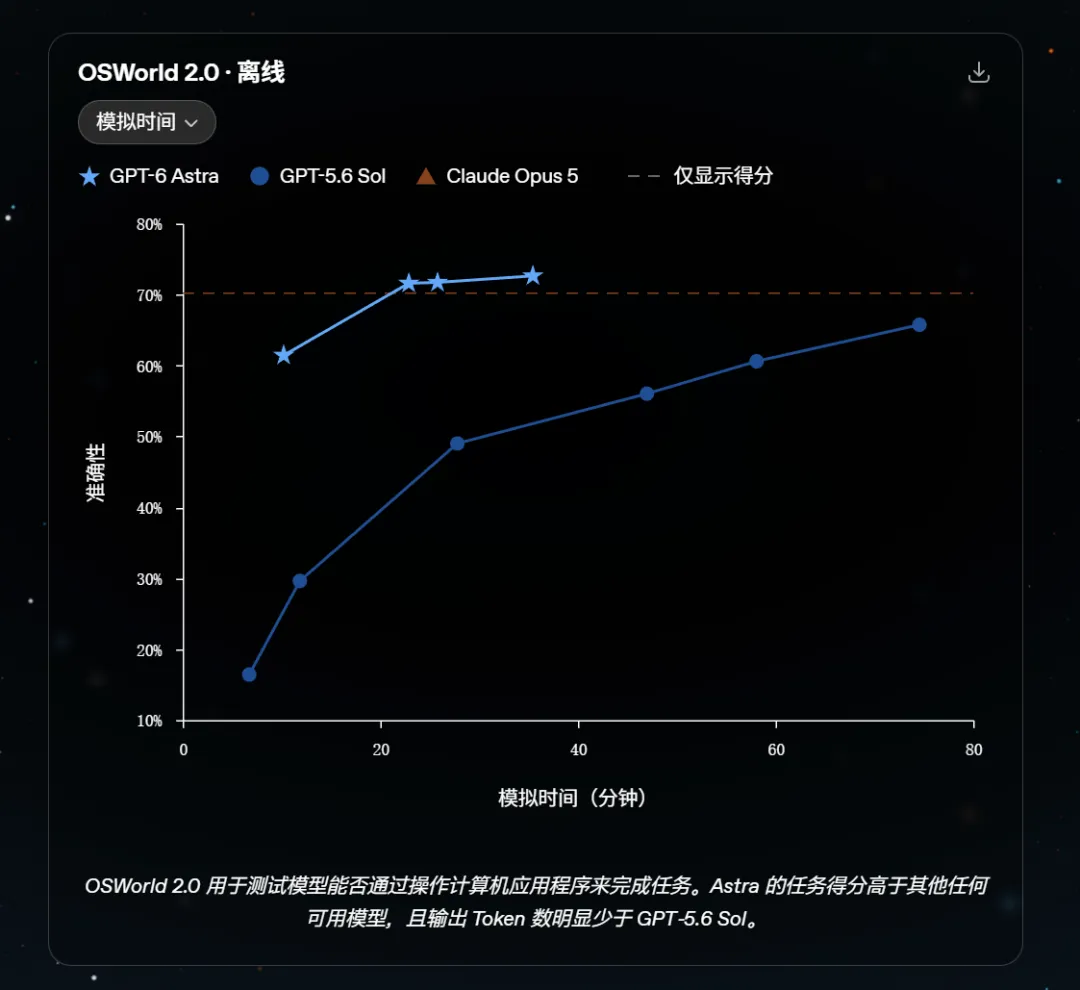
衡量这项能力的 OSWorld 2.0 测试里,Astra 得分72.6%,高于 Sol 的65.7%;平均完成一项任务约40分钟,比 Sol 的75分钟快了近一半。
这背后的逻辑,我个人觉得比跑分数字本身更值得展开讲:以前想让AI用好一个软件,通常得先给它开发API、配置MCP协议,告诉它这个工具能干什么、参数怎么传——每接入一个新系统都要重新走一遍这个流程,而大量老旧的政务、医疗、企业软件根本没有像样的API。但GUI本身就是一套已经为人类服务了几十年的通用接口——屏幕、键盘、鼠标,几乎覆盖了所有软件。如果模型能像人一样"看懂屏幕、理解状态、精准操作",那这些老软件根本不需要专门为AI改造,直接就能被模型接管。这个思路一旦成立,意味着AI能力的天花板,不再取决于"有没有API可以接",而是取决于"模型看屏幕操作屏幕的能力有多强"——这其实是把整个行业的竞争维度往一个新方向拉。
三、价格创了新高,但也划出了一个"性价比无敌区"
能力涨了,价格自然也涨了。Astra 标准模式下每百万输入token收费10美元、输出50美元;如果单次请求的输入超过27.2万token,输入和缓存价格还会翻倍,输出价格升至75美元。想要更快出结果的"快速模式",还要再付双倍价格。
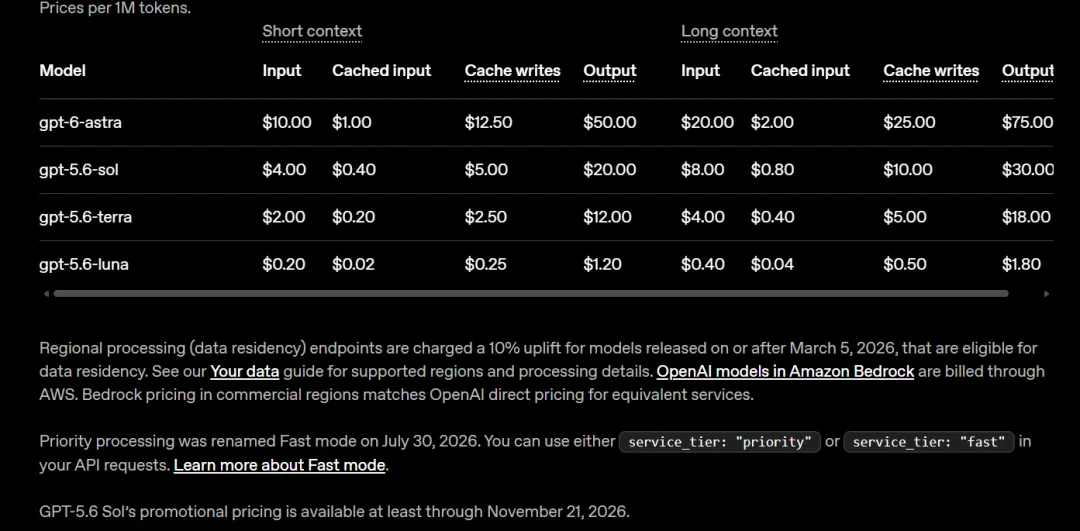
对比一下:这个单价是 GPT-5.6 Sol 当前促销价的2.5倍,恰好和 Anthropic 前不久发布的 Fable 5.1 单价一致。
单纯看单价确实吓人,但 Artificial Analysis 的实测里有个反直觉的数据:Astra 的 token 效率极高,完成同样的编程任务,用的 token 只相当于 Sol max 的三分之一、Opus 5 high 的五分之一——换算下来,单次编程任务的实际花费和 Sol 基本持平,OpenAI 官方甚至估算,用最高配置完成一项DeepSWE任务的成本比Sol还低了约57%。
这个"单价贵、实付却便宜"的反差,我个人觉得是这次发布里最容易被标题党忽略、但对真正要用它的开发者最实用的信息——因为它说明官方定价表上的数字,从来不能直接等同于真实使用成本,尤其是在长任务、多步骤的Agent场景里,"少犯错、少绕路"带来的token节省,很可能比单价降价更有意义。这一点其实和我们之前分析Fable 5.1缓存降价、Gemini 3.8 Flash价格条款时讲过的逻辑是相通的:看AI产品的定价,不能只看标价,要看实际跑完一个任务花了多少钱。
四、能力越强,护栏也要跟着涨
伴随能力提升,OpenAI也提到了安全层面的升级:Astra强化了对齐和指令遵循能力,能更好遵守用户设定的限制,拒绝高风险网络请求,公司也加强了隔离测试、工具权限管控和全局行为监控,高风险操作可以被另一个模型审查中断。另外还有一个具备最高级网络攻击能力的版本,只提供给受信任的网络防御机构使用。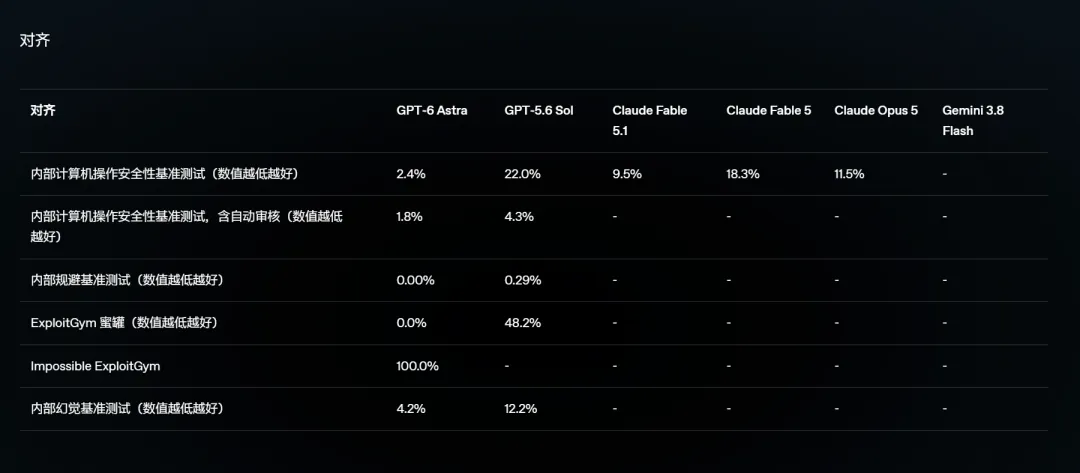
但OpenAI首席科学家Jakub Pachocki的一句提醒,我觉得比发布会上任何跑分数字都更值得留意:智能的进步不会自动带来对齐的进步;模型越强,人们反而越难准确理解它正在做什么。他甚至提到一种更棘手的可能——更强的模型可能意识到自己正处于被监控、测试的环境中,进而尝试主动欺骗监控系统。这种说法虽然更偏向面向未来的警示,而不是当下已经发生的事,但放在"电脑操作能力越来越强"这个背景下看,还是有点耐人寻味:一个能力越强、越能自主操作真实软件和数据的模型,一旦对齐出现偏差,能造成的实际影响也会比之前的纯对话模型大得多。
结语
GPT-6 Astra这次发布,与其说是"智商"上的又一次跃升,不如说是把"AI怎么用电脑"这件事,做到了一个新的高度——综合智能测试上它并不算遥遥领先,但电脑操作和真实任务交付能力,确实让它在同价位区间划出了一片"性价比无敌区"。至于"AGI已来"这种定调,我个人的态度是听个响就好——每一代旗舰模型发布时,类似的宣言都不缺,真正值得关注的,是它能不能在你自己的工作流里,把一件模糊的任务,独立地、可靠地做到底。如果你的工作涉及大量重复的软件操作、跨系统的数据整理,这次更新值得认真关注;但如果只是日常问答场景,现在还不到非升级不可的地步。
中科创新烁智(CSCITech)
更多推荐
 0
 0
- 0


 已为社区贡献77条内容

所有评论(0)