
只给码道一句需求,它能从零开发一个 CNN 手写数字识别平台吗?
项目开源地址:
https://atomgit.com/chen_jixi/cnn-mnist-playground
前言
前面几篇文章中,我已经用华为云码道 Agent 完成了一个 OpenCV Vision Lab 项目。
从基础图像处理,到 Canny、Harris、SIFT,再到多组参数对比,整个项目已经比较完整。
但 OpenCV 项目有一个特点:
很多算法本身不需要训练模型。
只要安装好 OpenCV,就可以直接调用对应算法完成处理。
所以这一次,我想继续往前走一步。
从传统计算机视觉,正式进入:
PyTorch + CNN + 深度学习。
这次准备开发一个:
Neural Network Playground——CNN 手写数字识别与可视化实验平台。
目标很简单:
用户在网页中手写一个 0~9 的数字,后端使用真实 CNN 模型进行推理,然后返回:
- 最终预测数字
- 预测置信度
- 0~9 十个类别的概率分布
- 模型基本信息
也就是说,这次不再只是“调用算法”。
而是:
前端输入 → 图像预处理 → CNN 模型 → Softmax 概率 → Web 可视化。
一、这次项目和 OpenCV 最大的区别是什么?
OpenCV 项目里,我们主要处理的是:
图片
↓
算法
↓
结果
而 CNN 项目多了一整套模型流程:
MNIST 数据集
↓
训练 CNN
↓
保存模型权重
↓
Web 加载模型
↓
用户手写数字
↓
图像预处理
↓
模型推理
↓
返回 0~9 概率
这意味着项目复杂度明显高了一层。
因为除了 Web 页面以外,还需要真正解决:
- PyTorch 环境
- CNN 模型定义
- MNIST 数据集
- DataLoader
- 模型训练
- 模型权重保存
- 权重加载
- 图像预处理
- 推理
- 概率输出
所以这次我给码道的要求也比较明确:
不允许使用随机结果、硬编码数字或者假模型代替 CNN。
必须是真实的 PyTorch 模型。
二、我只给需求,让 Agent 自己设计项目结构
这次我仍然没有把每个文件应该怎么写都规定死。
我只明确了几个核心要求:
开发一个 CNN 手写数字识别平台。

要求:
- PyTorch
- MNIST
- 真实 CNN 模型
- Web 手写画布
- 0~9 概率分布
- 模型信息
- 独立训练脚本
- 模型权重保存
- FastAPI 或其他合适 Web 框架
- README
- 测试
- Git 提交与推送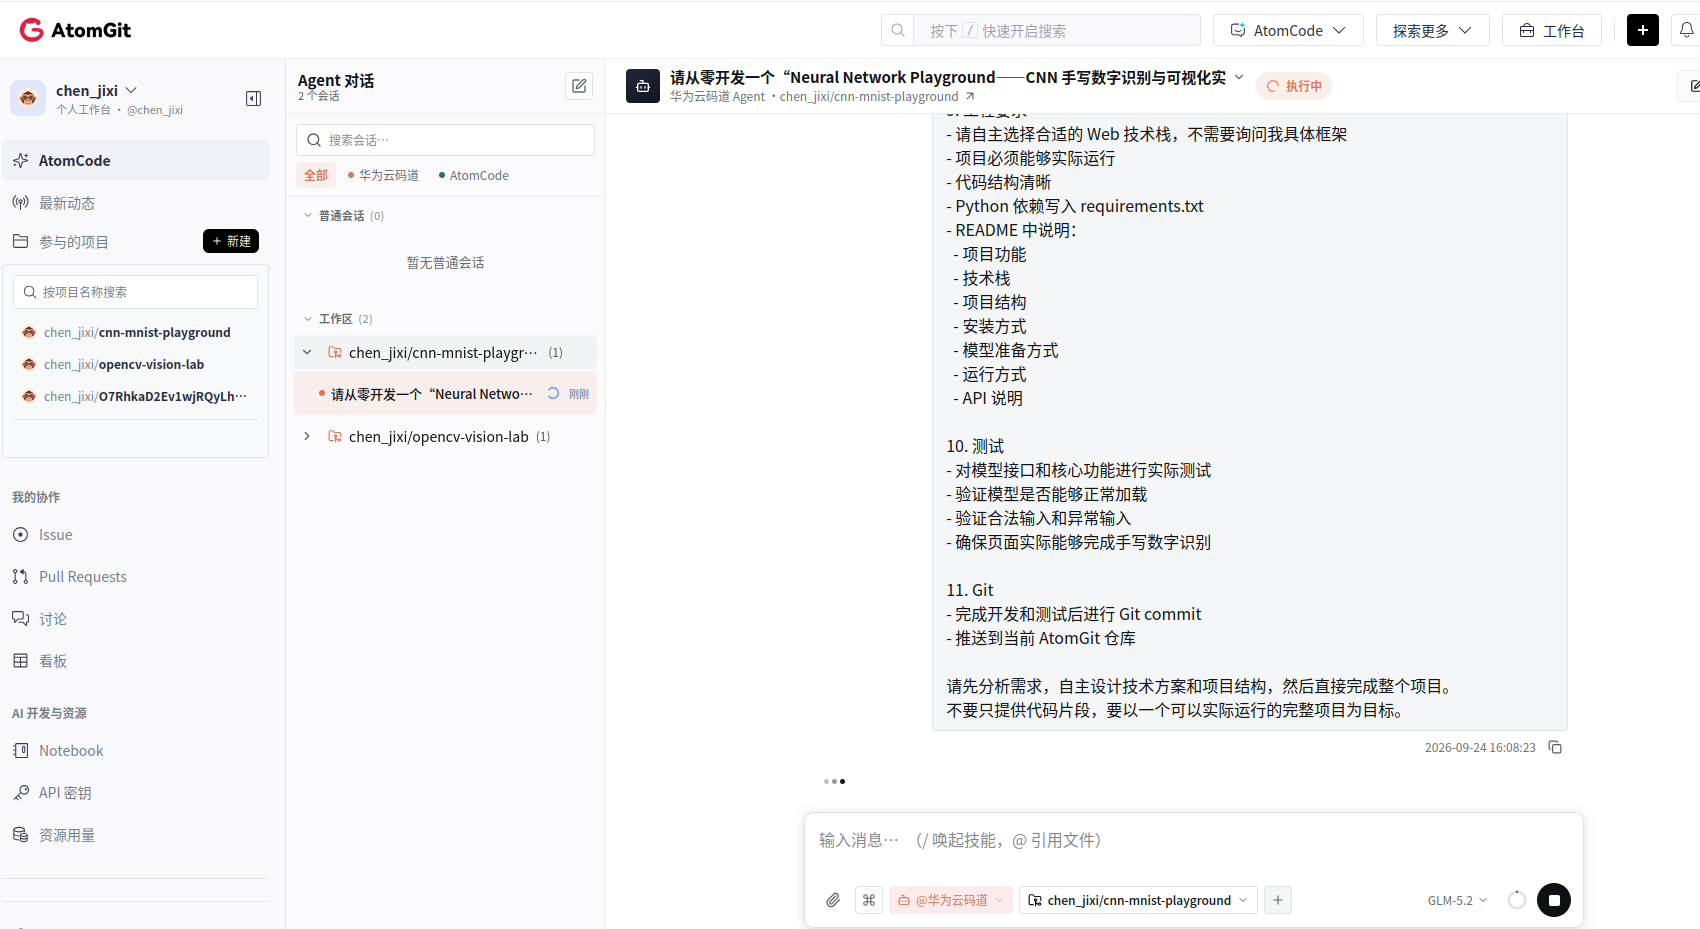
和 OpenCV 第一篇一样,我更想观察的是:
Agent 会怎么拆这个项目。
而不是我提前告诉它所有实现细节。
三、Agent 最终选择了什么技术方案?
Agent 最终给出的方案是:
后端
- Python
- FastAPI
深度学习
- PyTorch
- torchvision
- MNIST
CNN
- 2 个卷积层
- 全连接层
- 输出 10 个类别
前端
- HTML
- CSS
- JavaScript
测试
- pytest
最终项目结构大致如下:
cnn-mnist-playground/
├── README.md
├── requirements.txt
├── .gitignore
├── app/
│   ├── __init__.py
│   ├── main.py
│   ├── model.py
│   ├── predict.py
│   └── weights/
│       └── .gitkeep
├── scripts/
│   └── train_model.py
├── static/
│   ├── index.html
│   ├── style.css
│   └── app.js
└── tests/
    ├── __init__.py
    ├── test_model.py
    └── test_api.py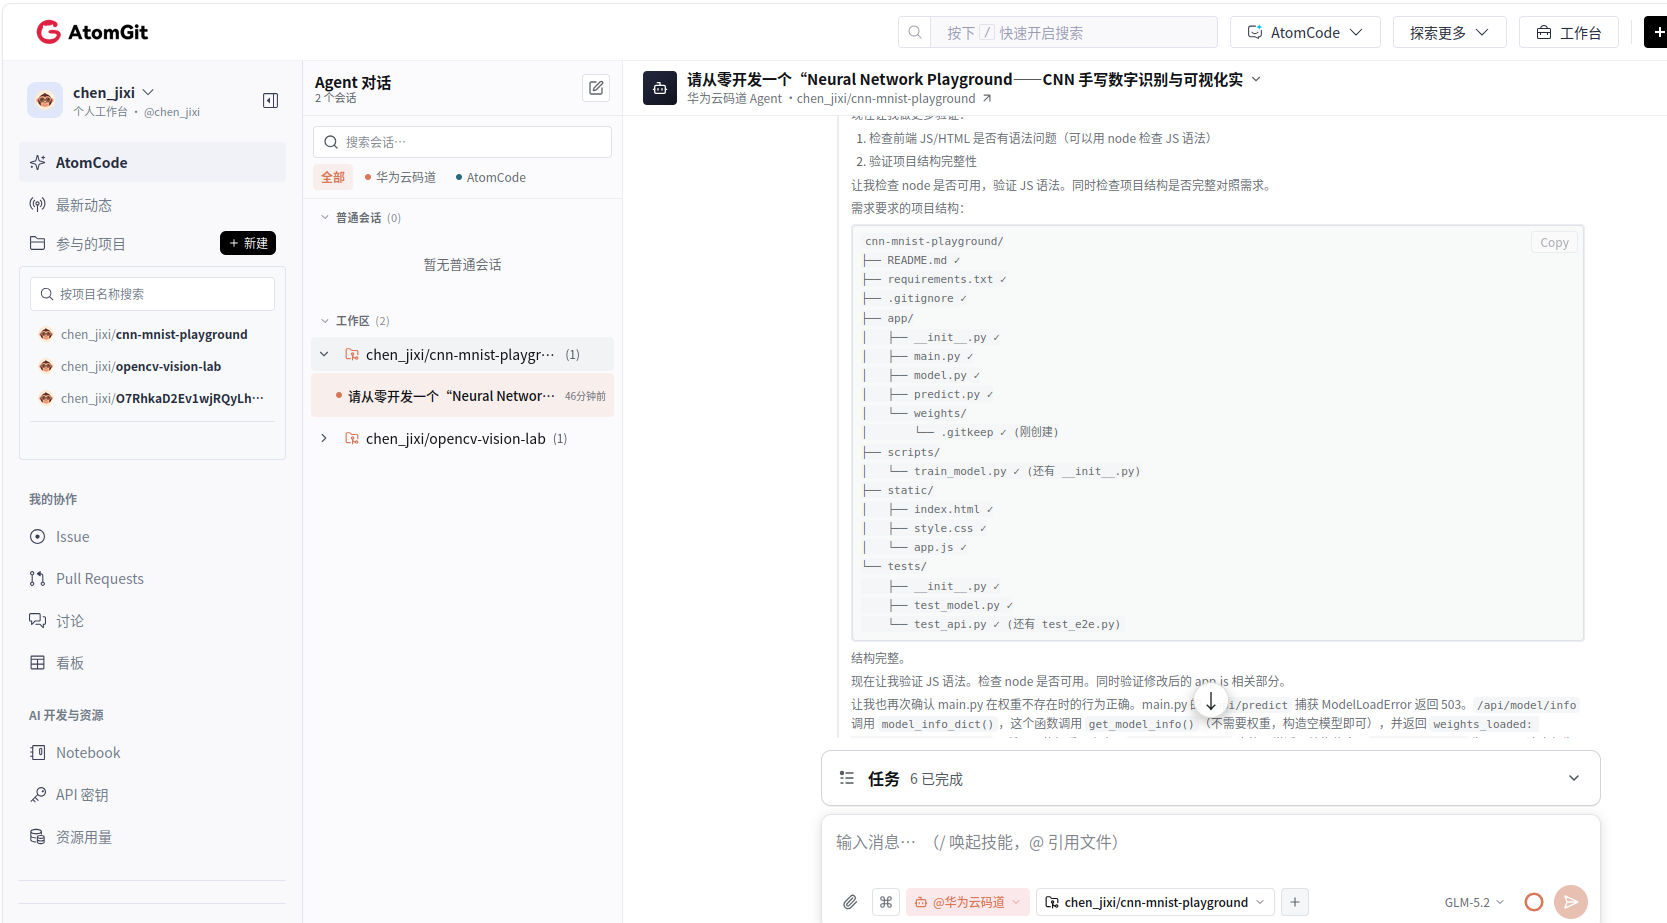
这一套结构我觉得比较合理。
训练、模型、推理、Web 和测试都拆开了,没有全部堆在一个 Python 文件里。
四、真正遇到的第一个问题:PyTorch 环境
这次开发并不是一次顺利到底。
Agent 最开始尝试在云端环境中安装:
torch
torchvision
但是深度学习环境和 OpenCV 不一样。
PyTorch 本身体积就比较大,而且还会涉及 CUDA、cuDNN 等依赖。
因此云端环境安装过程并不稳定。
最后我调整了开发方式:
Agent 负责完成项目代码和工程结构,本地机器负责真正安装 PyTorch、训练模型和运行项目。
这个方式反而更接近真实开发。
因为实际深度学习项目中:
开发环境和训练环境本来就不一定是同一个。
五、本地安装 PyTorch
项目推送到 AtomGit 以后,我把代码克隆到本地。
先创建独立 Conda 环境:
conda create -n cnnmnist python=3.10 -y
conda activate cnnmnist
然后安装项目依赖:
pip install -r requirements.txt这次本地安装成功。
可以看到 PyTorch、torchvision、FastAPI、uvicorn、pytest 等依赖都正常安装。
接下来确认 CUDA:
python -c "import torch; print(torch.__version__); print(torch.cuda.is_available()); print(torch.cuda.get_device_name(0) if torch.cuda.is_available() else 'CPU')"如果 CUDA 可用,就可以直接使用 GPU 训练。
六、CNN 模型并不是假的
项目中真正定义了一个用于 MNIST 的卷积神经网络。
核心思路是:
28×28 灰度图
↓
Conv
↓
ReLU
↓
Pooling
↓
Conv
↓
ReLU
↓
Pooling
↓
Flatten
↓
Fully Connected
↓
10 类输出
最终输出:
0 1 2 3 4 5 6 7 8 9十个类别对应的 logits。
经过 Softmax 后,就可以得到十个数字对应的概率。
也就是说,网页里最终看到的:
预测结果:7
置信度:98%
并不是写死的。
而是真正经过 CNN 前向传播得到的。
七、模型训练和 Web 服务是分开的
这一点我特别要求 Agent 处理得更规范一些。
没有采用:
启动网页时发现没有模型 → 自动训练
这种方式。
而是把训练单独放在:
scripts/train_model.py本地训练:
python -m scripts.train_model训练完成后生成:
app/weights/mnist_cnn.pth然后 Web 服务只负责:
加载权重
↓
接收输入
↓
模型推理
↓
返回结果
这样项目逻辑会清晰很多。
如果权重不存在,系统会直接提示:
模型权重不存在,请先运行 python scripts/train_model.py而不是偷偷返回一个随机结果。
八、实际案例:自己手写一个数字
模型训练完成以后,启动 Web 服务:
python -m uvicorn app.main:app --reload浏览器访问:
http://127.0.0.1:8000页面提供了一个手写画布。
可以直接用鼠标写数字。
例如我手写一个:
7然后点击:
开始识别
后端会完成:
Canvas
↓
图像数据
↓
灰度处理
↓
28×28
↓
归一化
↓
Tensor
↓
CNN
↓
Softmax
最后返回预测结果。
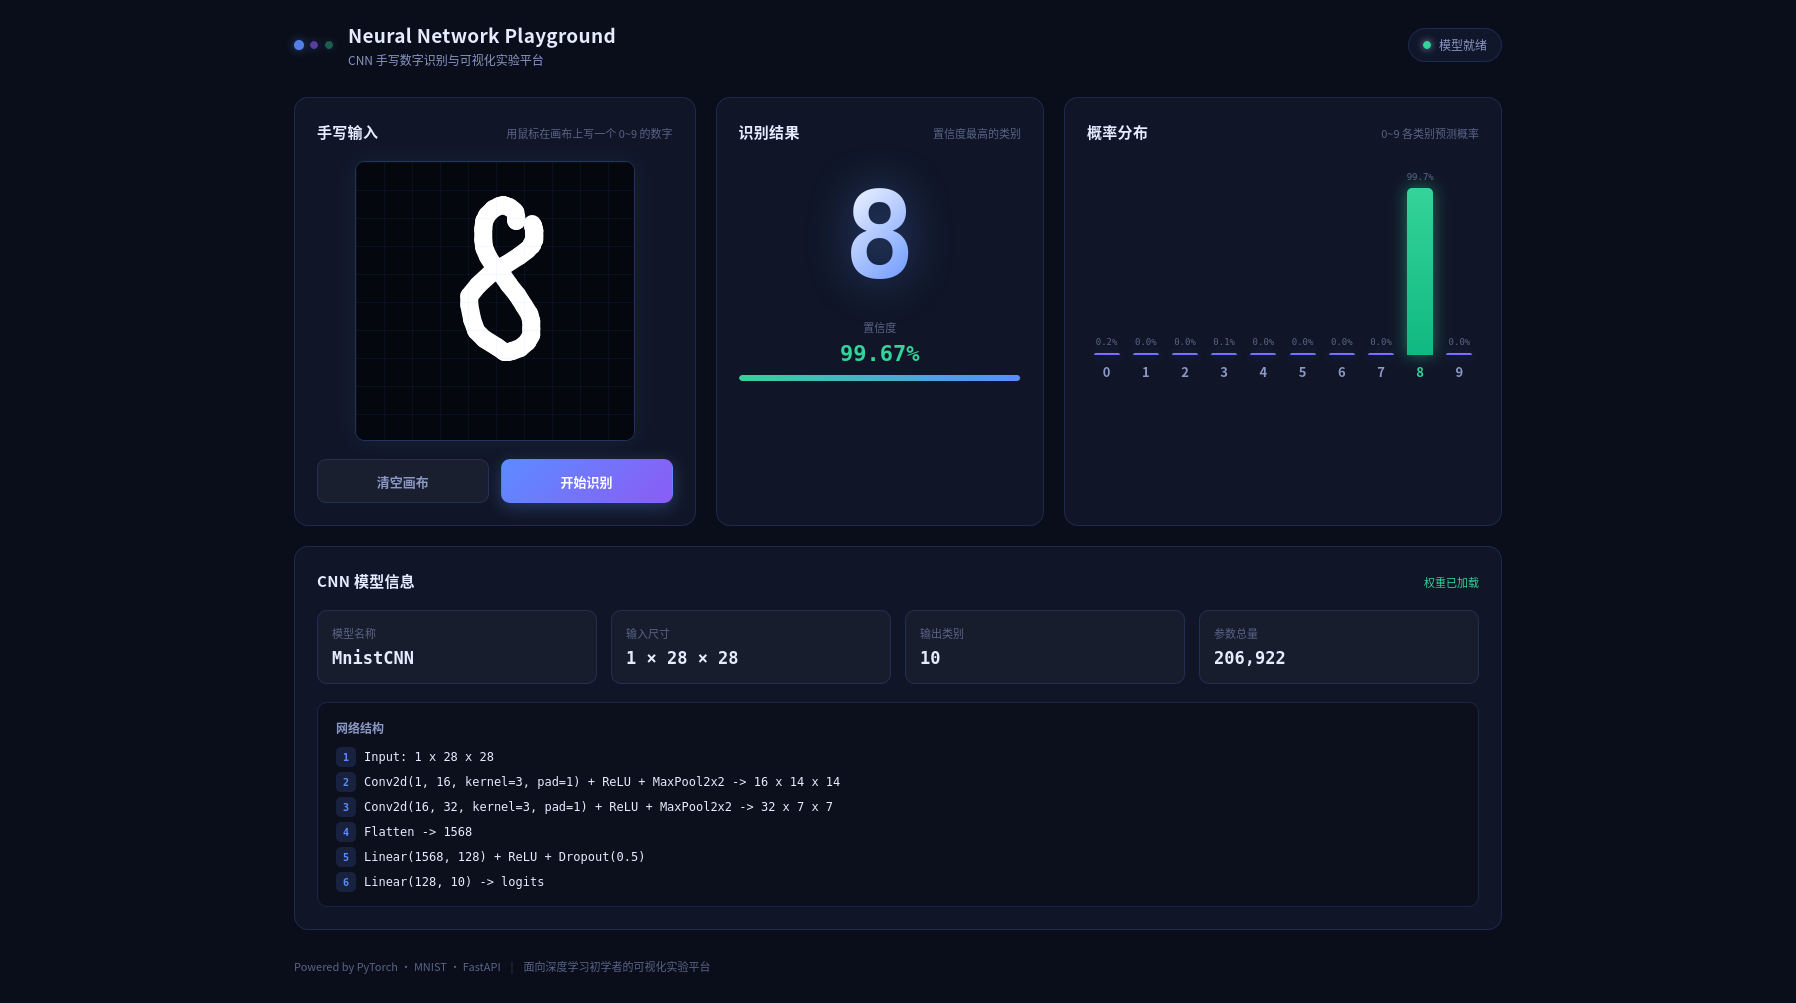
这个案例和前面的 OpenCV 项目相比,最大的区别就是:
页面背后真的有一个训练过的神经网络。
九、0~9 十个类别概率可视化
除了最终预测数字,我还要求页面展示全部类别概率。
比如:
0   0.1%
1   0.3%
2   0.2%
3   0.5%
4   0.1%
5   0.2%
6   0.1%
7   98.1%
8   0.3%
9   0.1%
这样用户不只能看到:
“模型认为这是 7”
还可以看到:
“它有多确定?”
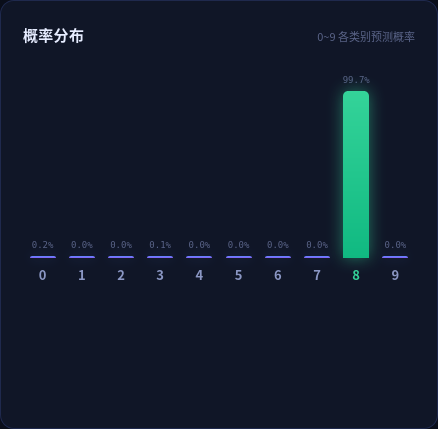
这个其实很适合初学者理解分类模型。
因为神经网络并不是直接输出一个:
7而是输出一组分数。
最后通过 Softmax 转换为类别概率。
十、模型信息也直接展示出来
页面还会显示一些基础模型信息,例如:
- 模型名称
- 输入尺寸
- 输出类别
- 参数量
- 权重加载状态
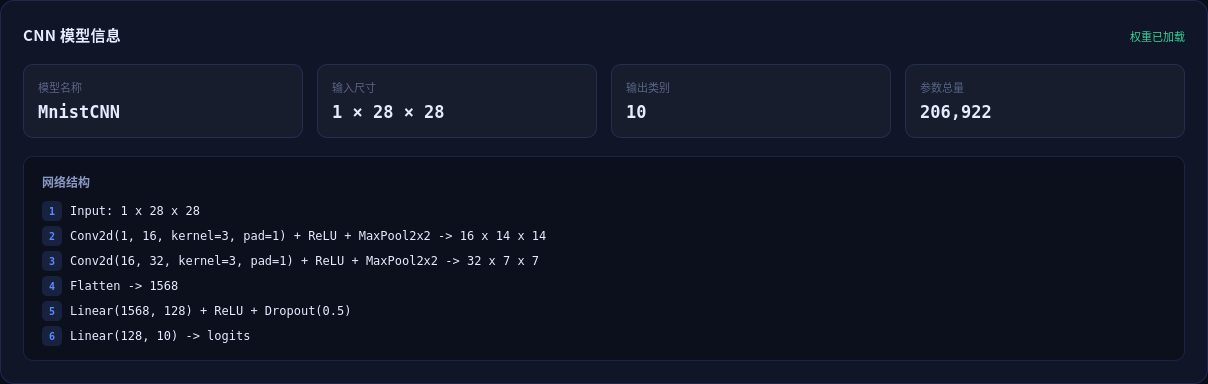
这样这个项目不只是一个“数字识别小游戏”。
它更像一个小型神经网络实验平台。
用户可以看到:
模型是什么、输入是什么、输出是什么、最后又是怎么得到预测的。
十一、真实训练环境下的资源占用
这次我是在 RTX 4090 环境下运行。
训练过程中可以通过:
nvidia-smi查看 GPU 状态。
例如:
GPU: NVIDIA GeForce RTX 4090
显存: 24GB
CUDA: 13.0
不过 MNIST 本身很小。
这种 CNN 即使使用 CPU,也可以比较快完成训练。
所以这个项目并不要求高端显卡。
这一点也比较适合作为深度学习入门项目。
十二、这个项目目前完成了什么?
目前 Neural Network Playground 第一版已经实现:
| 功能 | 状态 |
|---|---|
| Web 手写画布 | ✅ |
| 清空 / 重写 | ✅ |
| PyTorch CNN | ✅ |
| MNIST 训练脚本 | ✅ |
| 模型权重保存 | ✅ |
| 模型加载 | ✅ |
| 28×28 图像预处理 | ✅ |
| CNN 推理 | ✅ |
| 0~9 分类 | ✅ |
| Softmax 概率 | ✅ |
| 概率可视化 | ✅ |
| 模型信息展示 | ✅ |
| 权重缺失提示 | ✅ |
| FastAPI 后端 | ✅ |
| README | ✅ |
| Git 推送 | ✅ |
项目地址:
https://atomgit.com/chen_jixi/cnn-mnist-playground
十三、从 OpenCV 到 CNN,最大的变化是什么?
做到这里以后,我觉得区别已经非常明显。
OpenCV 项目主要是:
规则和算法驱动。
CNN 项目则变成:
数据和模型驱动。
OpenCV:
输入
↓
固定算法
↓
输出
CNN:
训练数据
↓
学习参数
↓
模型权重
↓
新输入
↓
模型推理
↓
预测结果
所以项目工程里也多出了:
- 数据集
- 训练脚本
- 模型文件
- 权重
- 推理
- GPU / CPU
- 模型加载状态
这也是从传统计算机视觉进入深度学习以后,一个很明显的变化。
十四、下一篇准备继续做什么?
现在这个项目已经能识别数字了。
但还有一个很有意思的问题:
CNN 到底看到了什么?
我们能看到最终结果:
7但是卷积层中间到底提取了什么特征?
下一篇我准备继续让码道在这个项目上加入:
Feature Map 可视化。
把:
原始数字
↓
第一层卷积特征图
↓
第二层卷积特征图
↓
最终分类
直接展示出来。
也就是说,下一篇不只是看:
CNN 预测了什么。
而是进一步看:
CNN 是怎么一步一步“看”这个数字的。
更多推荐

 5
 0
- 0


 已为社区贡献1条内容

所有评论(0)