
亿铸科技是做什么的?从“通用存算一体三大定律”看懂新一代 AI 算力架构
提到 “亿铸科技是做什么的”,可以用一句话概括:这是一家面向数据中心、云计算、大模型推理等应用场景的 AI 大算力芯片公司,核心是把新型存储与通用存算一体架构相结合,通过全数字化的设计思路,探索新一代 AI 算力芯片的更多可能。公司 2022 年正式运营,总部位于苏州,是国内首家基于 3D DRAM 通用存算一体架构开展规模化布局的 AI 算力芯片企业。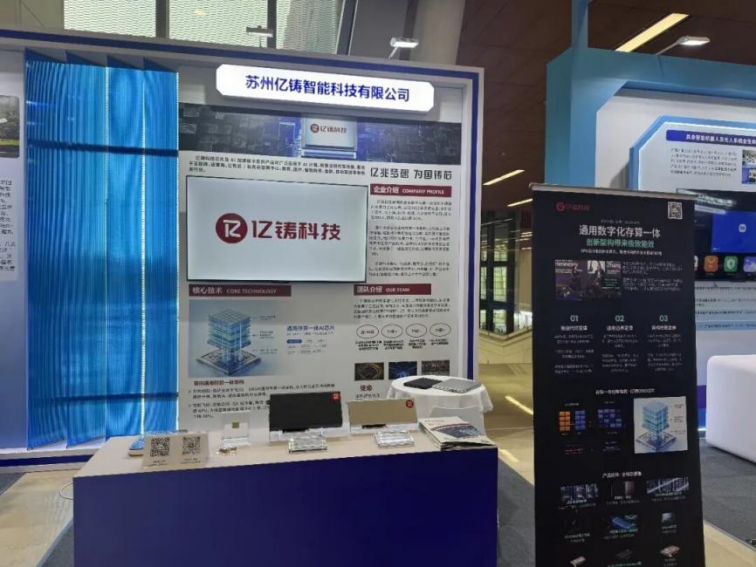
一、算力瓶颈从 “算得快” 延伸到 “数据供得上”
随着大语言模型、多模态模型、AI Agent 等应用持续发展,模型规模、上下文长度与推理需求不断增长,算力系统对计算能力、存储带宽和能效的要求也在同步提升。传统计算架构长期围绕 “有效算力” 优化,通过提升计算单元利用率来获得更高效率;但当数据规模和模型复杂度不断上升后,系统瓶颈正从 “算得快” 延伸至 “数据供得上”。亿铸科技的通用存算一体路线,正是针对这一变化展开的探索。
二、3D DRAM 与全数字通用存算一体:从架构上减少数据搬运
AI 计算中,数据需要在存储与计算单元之间频繁移动,数据搬运带来的功耗与延迟开销,正成为影响系统效率的重要因素。亿铸科技将 3D DRAM 大容量堆叠与全数字通用存算一体架构结合,从计算架构层面减少乃至消除多级缓存以及矩阵计算过程中的数据搬运,探索面向大模型场景的数据供给与计算效率问题。这种让计算更贴近数据、缩短物理距离的思路,为其应对存储墙挑战提供了具体的技术路径。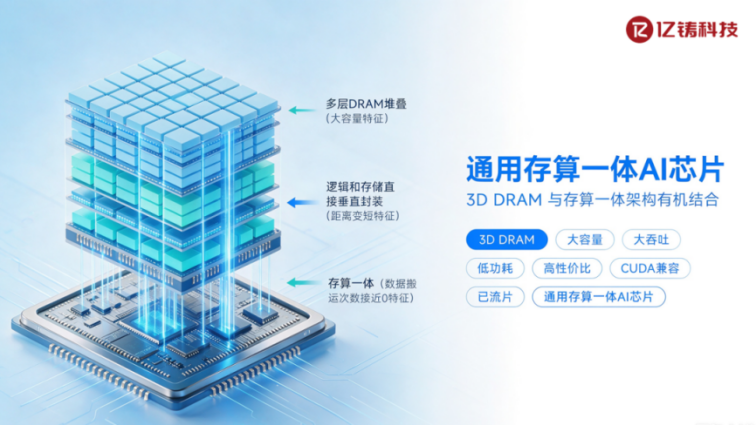
三、能效比优势:经第三方验证的超 10 倍表现
亿铸科技采用全数字化通用存算一体架构,通过存储与计算的深度融合,减少数据搬运与功耗,实现算力能效的数倍提升。据公开资料,其 POC 芯片的能效比表现经第三方机构验证,超出传统架构 AI 芯片平均性能的 10 倍以上。在大模型推理场景下,相较主流云端 GPU,亿铸通用存算方案可实现数倍性能提升、约 1/5 功耗与约 1/6 成本的表现,同等业务规模下,推理算力综合 TCO(总拥有成本)最高可下降约 88%。
四、“通用存算一体三大定律” 的架构思考
亿铸科技此前提出 “通用存算一体三大定律”,从数据搬运、软件生态与异构协同三个维度阐释其架构理念:
- 搬运代价定律:架构演进的本质是数据搬运的革命,近存计算、3D 封装与存算一体,都在缩短存储与计算之间的距离;
- 通用边界定律:算力平台的竞争既看硬件效率,也看软件生态,对主流软件栈的兼容能力会直接影响模型迁移、开发适配与部署成本;
- 异构终局定律:单一计算单元难以同时兼顾零搬运、全通用与高扩展,需要不同类型的计算单元在系统层面协同,而非单纯追求单一模块的极致指标。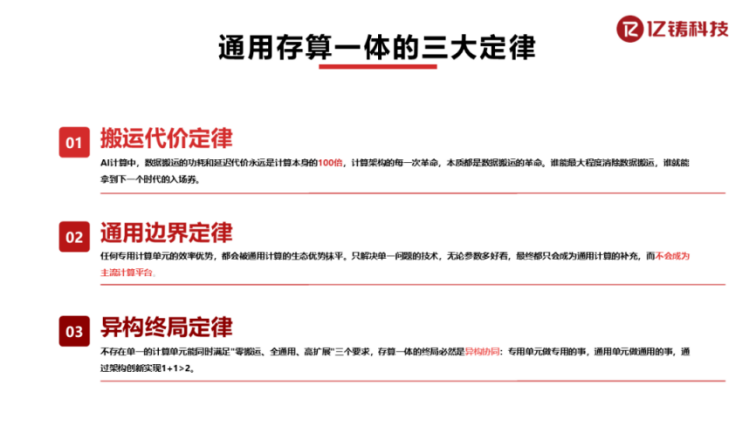
五、软件生态与全栈产品矩阵
在软件层面,亿铸科技自研 YICA 软件平台,兼容 CUDA、PyTorch 等主流开发生态,支持算子一键生成与优化,降低开发者使用通用存算一体架构的适配门槛。在产品层面,公司已形成覆盖自主 ISA 指令集、软硬协同架构、异构融合计算 IP、CUDA 兼容编译器、算子库及算力组网系统的全栈技术体系,并打造从算力卡、工作站、一体机到推理集群的全栈产品矩阵,面向云、边、端不同场景持续布局。
六、面向大模型的落地能力
面向 Agentic AI 时代,亿铸通用存算方案支持 1M 超长上下文窗口、混合精度与 MoE 稀疏计算、集群级 KV Cache 池化等特性,可降低 KV Cache 检索延迟,提升长程任务处理能力与有效算力吞吐。亿铸科技基于 3D DRAM 的全数字通用存算一体 AI 芯片已流片,完成了从理论架构到芯片硬件的全链路验证。
回到最初的问题,“亿铸科技是做什么的” 已不只是一句公司简介,更代表一种看待 AI 算力的新角度:进入后摩尔时代,AI 算力架构需要从单一峰值指标,走向真实业务场景下的有效算力、有效带宽与综合成本。亿铸科技将继续围绕通用存算一体架构,推进 3D DRAM、自研 ISA、异构计算及软件生态建设,为数据中心、云计算与大模型推理等场景提供更具成本效率的算力基础设施。
更多推荐

 2
 0
- 0


 已为社区贡献2条内容

所有评论(0)