
基于NLP的恶意代码静态特征提取与分类检测工具设计与实现(代码+数据库+LW)
摘 要
针对传统恶意代码检测方法难以应对变种恶意代码、深度学习检测模型可解释性差且部署成本高的问题,设计并实现一款基于自然语言处理(NLP)的恶意代码静态检测工具。工具以 PE 文件和脚本文件为检测对象,通过静态分析提取三类特征:基于 TF-IDF 的字符串文本特征、正则匹配的可疑关键词规则特征、文件基础属性数值特征,将多类特征拼接为融合特征向量后,采用逻辑回归构建轻量级二分类检测模型。实现了样本上传与管理、静态特征提取、分类检测、结果展示与报告导出等核心功能,支持样本 SHA256 去重、检测结果筛选及检测报告 JSON 导出,同时输出 Top-K 贡献特征实现检测结果的可解释性。在 Malimg、BODMAS 公开数据集上的测试结果表明,工具检测准确率达 85% 以上,推理速度快、资源消耗低,可在终端侧和服务端高效部署。
关键词:恶意代码检测;静态分析;自然语言处理;TF-IDF;逻辑回归;特征融合
目 录
研究意义
1.2.1 现实意义
本工具设计基于 NLP 的恶意代码静态检测方案,无需动态执行样本,规避了沙箱资源开销与样本逃逸风险,可在企业邮件网关、文件上传服务器、个人终端等场景高效部署,能实时拦截恶意附件、辅助用户识别可疑文件,直接提升个人与企业内网的防护能力。同时工具的轻量级特性适配资源受限终端,弥补了深度学习检测模型的部署短板,也解决了深度学习模型在小样本场景外的部署问题。
1.2.2 理论意义
将 NLP 技术引入恶意代码静态检测领域,探索代码文本语义特征提取新方法,突破了传统静态检测的特征提取局限,也为静态特征的创新挖掘提供了新路径。通过多模态特征融合策略,为提升恶意代码检测模型鲁棒性提供了理论依据;采用可解释性强的线性机器学习模型,实现检测结果的透明化,推动了可解释性机器学习在网络安全领域的应用,解决了深度学习模型 “黑盒” 带来的信任度问题。
核心功能模块设计
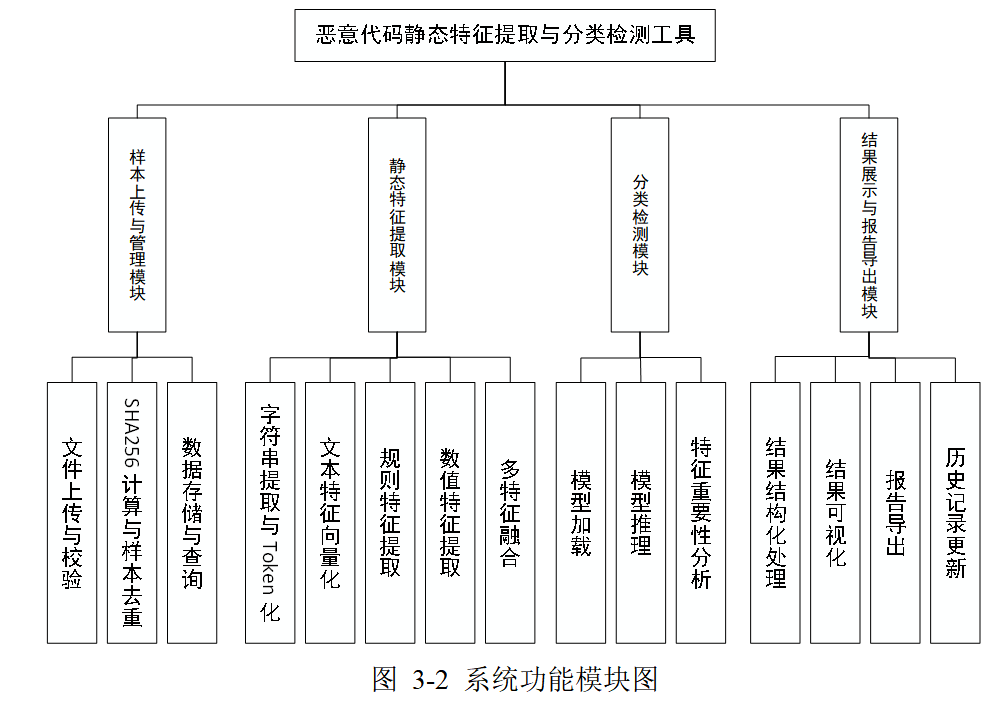
本系统依据业务逻辑与功能边界,将后端服务层拆解为四大核心模块,各模块独立分工、协同运行,共同完成恶意代码从上传到检测输出的全流程处理。
前端界面实现
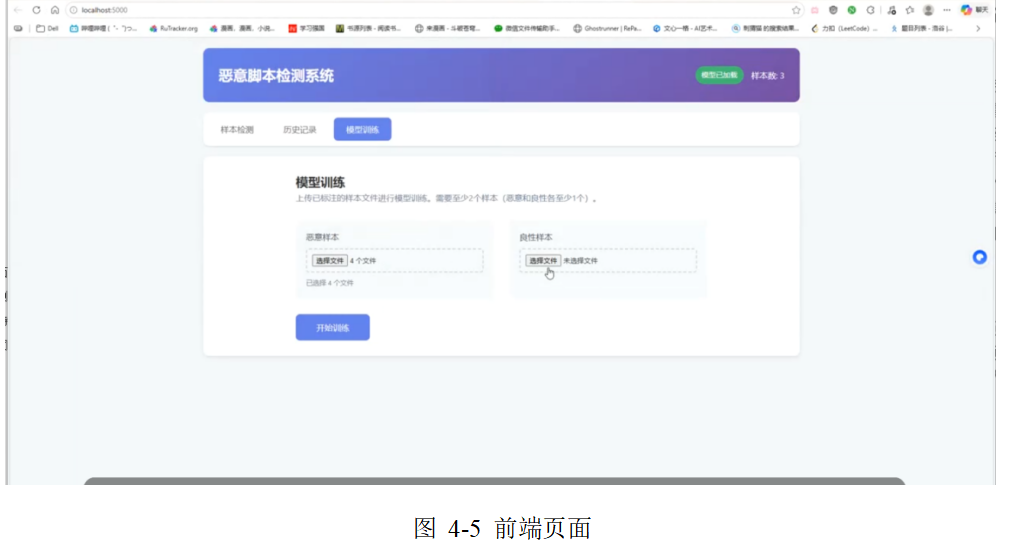
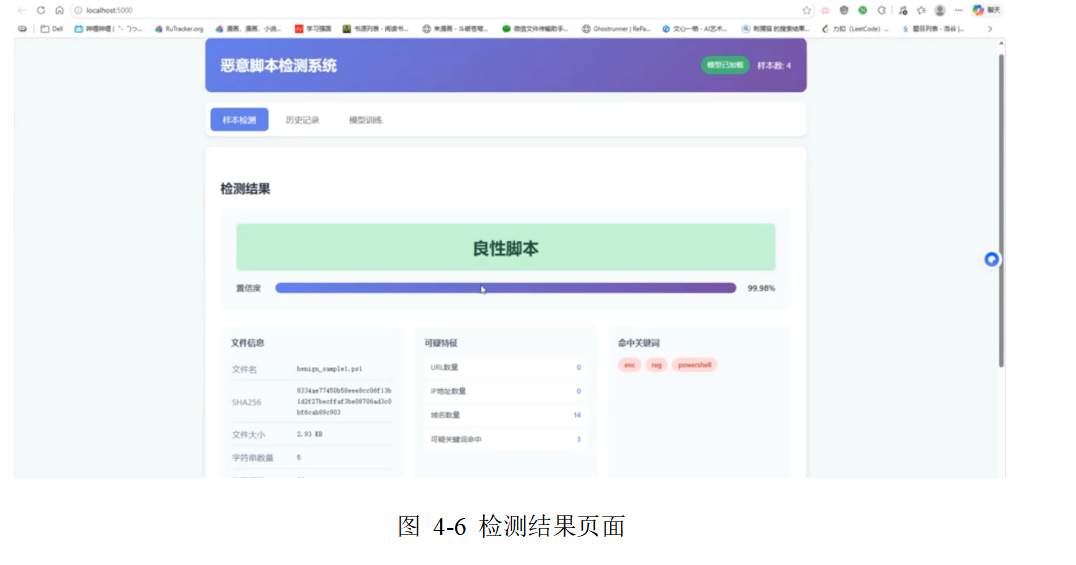
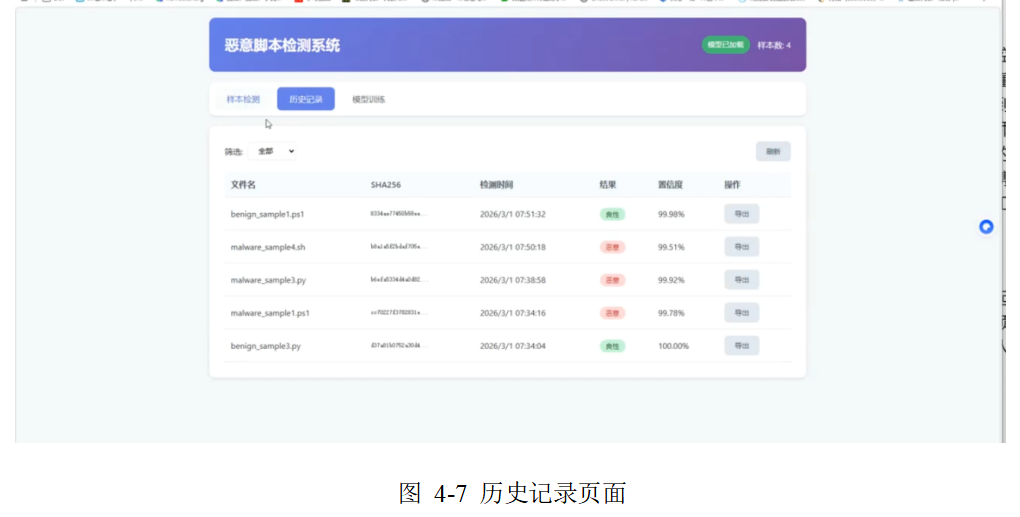
前端采用简洁直观的响应式设计,构建三大核心界面:样本上传界面提供文件选择与上传按钮,实时显示状态与进度,支持直接查看历史结果;检测结果详情界面分模块展示各类信息,配备报告导出功能;历史记录查询界面支持多条件筛选与分页,列表展示关键信息并可跳转查看详情或导出报告,适配不同屏幕尺寸,非专业用户也能轻松操作。
检测流程整合实现
系统核心检测流程按 “样本上传 - 特征提取 - 特征融合 - 模型推理 - 结果处理” 串联各模块:用户上传文件后,系统完成格式校验与 SHA256 计算,判断样本是否重复;新样本依次执行字符串提取与 Token 化、多维度特征提取与归一化;三类特征拼接为融合向量输入逻辑回归模型推理;生成检测结果、置信度与 Top-K 特征并结构化存储;前端展示结果并支持详情查看与报告导出。
总结与展望
6.1 研究总结
本研究针对传统恶意代码检测方法难以应对变种恶意代码、深度学习模型可解释性差且部署成本高的问题,设计并实现了一款基于 NLP 的恶意代码静态检测系统。研究核心成果如下:
在技术方案上,提出了 “多维度特征融合 + 轻量级线性模型” 的检测框架,将 NLP 技术引入恶意代码静态检测领域,通过提取 TF-IDF 文本特征、规则特征与数值特征,构建融合特征向量,依托逻辑回归模型实现恶意代码分类,既丰富了特征表征维度,又保证了模型的轻量级与可解释性。
在系统实现上,完成了样本上传与管理、静态特征提取、分类检测、结果展示与报告导出等核心模块的开发,实现了样本 SHA256 去重、多条件历史记录查询、JSON 报告导出、Top-K 贡献特征展示等实用功能,系统支持 Windows 与 Linux 双系统部署,运行时内存占用≤380MB,单样本检测耗时≤120ms,满足轻量级、实时性检测需求。
在性能验证上,通过公开数据集与自建样本集的全面测试,系统检测准确率达 88.6%,F1 值为 88.3%,对变种恶意代码检测率达 85.3%,相较于传统签名匹配方法,在检测性能与适应性上均有显著提升,同时具备强可解释性,可帮助用户理解检测决策依据,提升对检测结果的信任度。
6.2 研究创新点
特征提取创新:将 NLP 技术与恶意代码静态检测深度结合,通过 TF-IDF 与 n-gram 技术提取字符串语义特征,弥补了传统静态检测依赖单一特征的局限,提升了对变种恶意代码的识别能力;
模型设计创新:选用逻辑回归作为核心分类模型,在保证检测准确率的前提下,实现了模型的轻量级部署与强可解释性,通过特征权重分析输出 Top-K 贡献特征,解决了深度学习模型 “黑盒” 问题;
系统功能创新:整合样本去重、多条件查询、报告导出等实用功能,界面简洁易用,支持跨平台部署,适配终端侧与服务端多种应用场景,兼顾技术性能与用户体验。
6.3 未来展望
优化特征提取方法:引入代码反混淆、脱壳预处理技术,提升强混淆样本的特征提取质量;探索词嵌入模型(如 Word2Vec、BERT)替代 TF-IDF,捕捉更深层的语义特征;
改进特征融合与模型:研究动态加权特征融合策略,根据特征重要性分配权重;尝试将逻辑回归与集成学习结合,进一步提升检测准确率;
扩展系统适配范围:增加对 APK(Android 恶意软件)、ELF(Linux 恶意软件)等文件格式的支持,扩大系统应用场景;
增强系统功能:引入恶意代码家族分类功能,实现对恶意代码家族的识别与溯源;开发移动端适配版本,满足移动终端检测需求。
更多推荐

 2
 0
- 0


 已为社区贡献20条内容

所有评论(0)