
[人工智能]Python02:NumPy.Statistics统计实战指南
NumPy 统计实战指南
一份实用 NumPyy.Statistics 统计指南,覆盖描述统计、聚合、分位数、变异性、协方差、直方图和重采样。
- 对向量、矩阵和批次数据使用明确的 axis 统计。
- 区分位置、离散程度、形状、依赖性和不确定性。
- 有意识地处理 NaN、权重、异常值和样本自由度。
- 使用图形、已知恒等式和可复现实例验证统计摘要。
示例均为独立代码片段,可复制到 Python 3 环境中运行。
1. 数据形状、轴与统计摘要
NumPy 统计函数本质上是数组运算。同一个函数可以根据 axis 汇总整个数组、每一行、每一列或一个批次。在计算统计量前,应定义一行或一个元素代表什么,以及哪个轴保存观测。
|
函数 |
用途 |
重要参数 |
|
mean |
算术平均 |
axis、dtype、where |
|
median |
中位数 |
axis、overwrite_input |
|
sum |
总和或加权累积 |
axis、dtype、keepdims |
|
std |
标准差 |
ddof、axis |
|
var |
方差 |
ddof、axis |
|
min / max |
极值 |
axis、where、initial |
|
average |
加权或非加权平均 |
weights、returned |
import numpy as np
scores = np.array([[80, 90, 70], [65, 75, 85], [95, 88, 92]], dtype=float)
print("overall:", scores.mean())
print("per student:", scores.mean(axis=1))
print("per subject:", scores.mean(axis=0))
print("keepdims:", scores.mean(axis=0, keepdims=True).shape)
Axis 约定
- axis=None 把全部元素归约为一个标量。
- 对于矩阵,axis=0 压缩行并为每列返回结果;axis=1 压缩列并为每行返回结果。
- keepdims=True 保留被压缩的轴,使结果可以与原数组广播。
- 可复用函数和测试中使用 observation_axis 或 feature_axis 等明确名称。
2. 位置、分布与稳健摘要
位置统计描述数据的中心。均值使用所有数据,容易受极端值影响;中位数基于排序,通常对异常值更稳健。直方图或密度式图形很重要,因为两个数据集可能拥有相同均值和标准差,却有完全不同的分布形状。
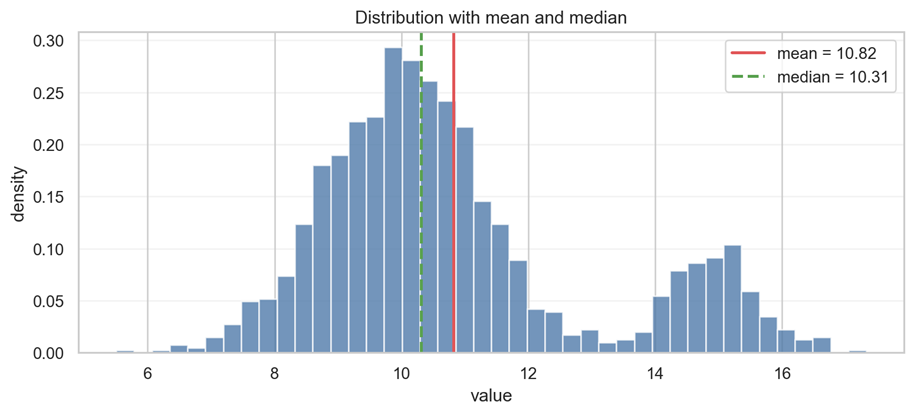
图 1:当分布偏态或多峰时,均值和中位数可能不同。
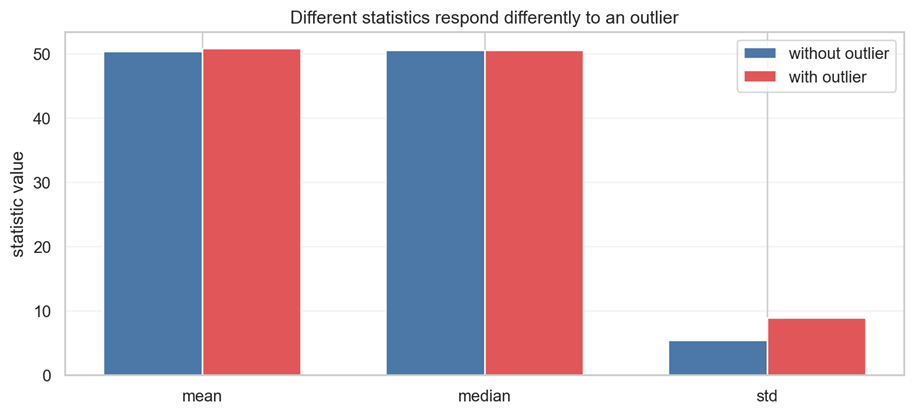
图 2:异常值对均值和标准差的影响可能比对中位数更强。
values = np.array([4, 5, 5, 6, 7, 100], dtype=float)
mean = np.mean(values)
median = np.median(values)
trimmed_like = np.mean(np.sort(values)[1:-1])
print(mean, median, trimmed_like)
|
摘要 |
优点 |
限制 |
|
均值 |
使用全部数据,代数性质方便 |
对异常值和偏态敏感 |
|
中位数 |
稳健的位置摘要 |
不便于直接代数建模 |
|
最小/最大 |
展示支持范围和极值 |
对样本量非常敏感 |
|
极差 |
简单的离散程度 |
只使用两个观测 |
|
几何均值 |
乘法尺度下有意义 |
要求数据为正 |
|
加权平均 |
反映不同观测重要性 |
权重必须有依据 |
稳健性取决于上下文
稳健统计量不一定就是正确统计量。如果极端值是真实且重要的事件,删除或降低其权重可能掩盖过程的重要部分。应报告检测、保留、变换或排除异常值所使用的规则。
3. 方差、标准差与自由度
方差衡量相对于中心的平均平方偏离;标准差把离散程度恢复到原始单位。NumPy 的 ddof 控制除数:ddof=0 使用总体式除数 n,ddof=1 使用常见的样本方差除数 n−1。选择应匹配数组是要描述的完整总体,还是用来估计总体量的样本。
values = np.array([8.0, 9.0, 10.0, 12.0, 11.0])
mean = values.mean()
population_variance = values.var(ddof=0)
sample_variance = values.var(ddof=1)
sample_std = values.std(ddof=1)
standard_error = sample_std / np.sqrt(values.size)
print(mean, population_variance, sample_variance, standard_error)
|
量 |
NumPy 表达式 |
用途 |
|
总体方差 |
x.var(ddof=0) |
描述完整有限集合 |
|
样本方差 |
x.var(ddof=1) |
估计总体方差 |
|
总体标准差 |
x.std(ddof=0) |
完整集合的离散程度 |
|
样本标准差 |
x.std(ddof=1) |
样本离散程度估计 |
|
均值标准误 |
x.std(ddof=1)/sqrt(n) |
假设下的抽样不确定性 |
单位与缩放
- 方差具有平方单位;标准差具有原始单位。
- 给所有值加常数会改变均值,但不会改变标准差。
- 把值乘以 c 会使标准差乘以 |c|,方差乘以 c²。
- 标准差小不代表测量准确,因为测量过程仍可能有系统偏差。
4. 分位数、百分位数、直方图与经验形状
分位数根据排序位置描述数值。第 50 百分位是中位数;四分位距是第 75 百分位减去第 25 百分位。NumPy 支持多种百分位插值方法,因此在要求精确复现的场景中应记录 method。
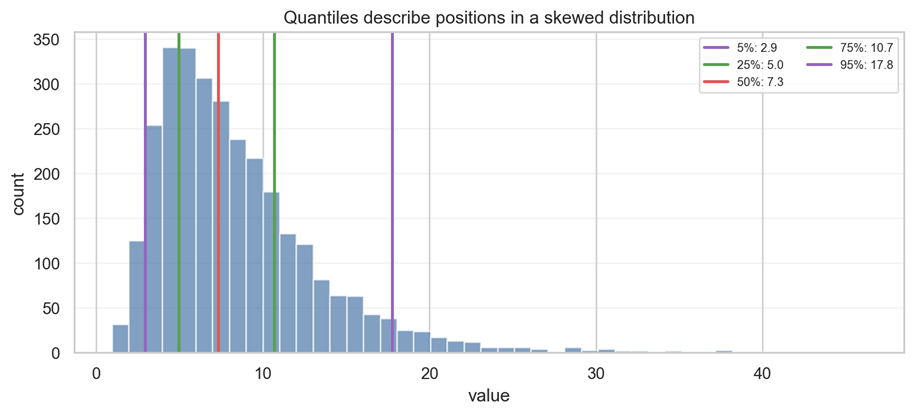
图 3:分位数标记偏态样本分布中的位置。
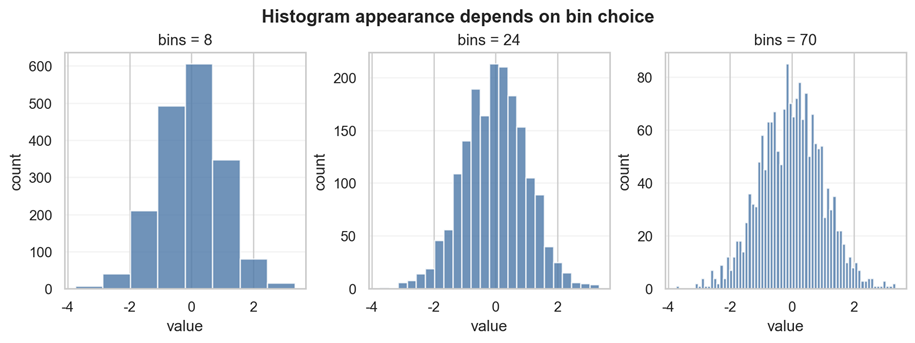
图 4:直方图的外观强烈依赖分箱数量。
values = np.random.default_rng(2026).lognormal(2.0, 0.55, size=3000)
quantiles = np.quantile(values, [0.05, 0.25, 0.5, 0.75, 0.95])
iqr = np.subtract(*np.quantile(values, [0.75, 0.25]))
hist_counts, bin_edges = np.histogram(values, bins="auto", density=False)
print(quantiles, iqr)
print(hist_counts[:5], bin_edges[:5])
|
统计量 |
定义 |
解释 |
|
p05 / p95 |
第 5 / 95 百分位 |
尾部参考位置 |
|
Q1 / Q3 |
第 25 / 75 百分位 |
中间一半的边界 |
|
中位数 |
第 50 百分位 |
排序中心位置 |
|
IQR |
Q3 − Q1 |
稳健的中心离散程度 |
|
直方图 |
分箱中的计数 |
形状依赖分箱边界 |
|
密度直方图 |
面积归一化为 1 |
比较分布形状 |
百分位数方法与表达
对于有限样本,分位数可能位于两个观测之间,不同方法会采用不同插值。一般可以使用默认方法,但报告、监管计算或测试要求精确复现时,应明确记录 method。
5. 协方差、相关性与组间比较
协方差描述原始单位下的共同变化;相关系数把它缩放为无量纲值。NumPy 提供 cov 和 corrcoef,但结果取决于数据方向和自由度选择。应结合图形检查关联,并且不能把关联解释为因果。
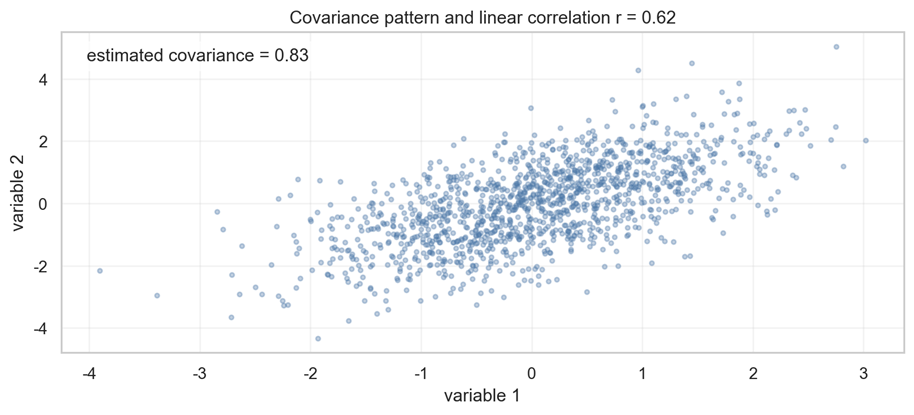
图 5:协方差产生有方向的数据云,相关系数总结线性关联。
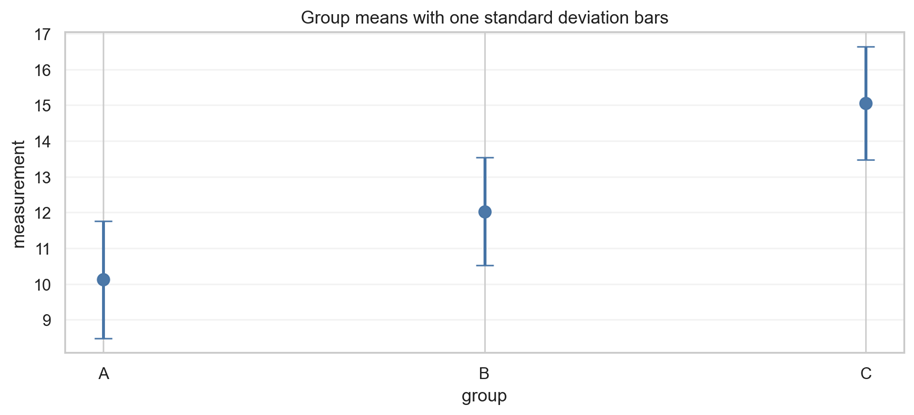
图 6:带标准差线的组均值展示中心和一种离散程度。
rng = np.random.default_rng(2026)
X = rng.multivariate_normal([0, 0], [[1.0, 0.7], [0.7, 1.5]], size=1000)
covariance = np.cov(X, rowvar=False, ddof=1)
correlation = np.corrcoef(X, rowvar=False)
weights = np.array([1.0, 2.0, 1.0, 3.0])
values = np.array([10.0, 12.0, 11.0, 15.0])
weighted_mean = np.average(values, weights=weights)
print(covariance)
print(correlation)
print(weighted_mean)
|
工具 |
输出 |
注意事项 |
|
cov |
协方差矩阵 |
单位和行列方向很重要 |
|
corrcoef |
相关矩阵 |
只总结线性依赖 |
|
average(weights=) |
加权均值 |
权重需要抽样或业务含义 |
|
mean(axis=) |
组均值或特征均值 |
说明观测轴 |
|
std(axis=) |
组离散程度或特征离散程度 |
有意识选择 ddof |
相关性注意事项
- 异常值可能支配协方差和相关系数。
- 非线性关系可能拥有较低的 Pearson 相关。
- 共同趋势或第三个变量可能造成表面关联。
- 配对或重复观测应在计算变化时保留配对关系。
6. 缺失值、掩码与 Bootstrap 风格的不确定性
NaN 需要明确处理策略。普通归约会传播 NaN;nanmean、nanstd、nanmedian 等函数忽略 NaN,但会改变有效样本量。masked array 或 where 参数可以表达有效性规则,避免把缺失值静默当作零。
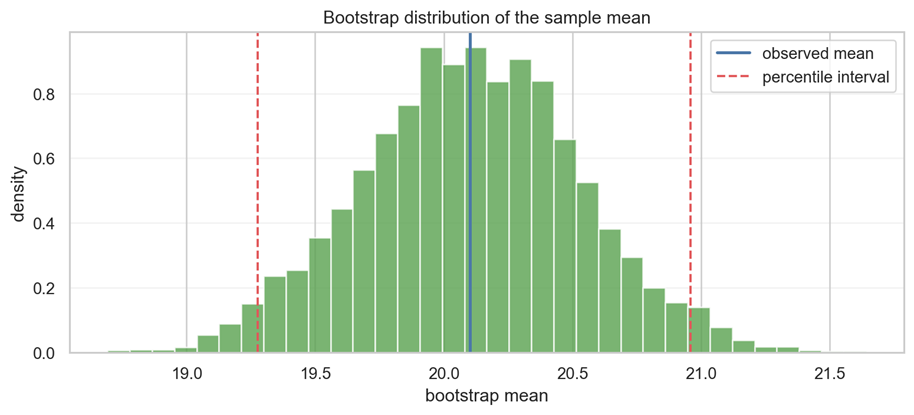
图 7:有放回重采样为均值估计产生经验分布。
values = np.array([10.0, 11.0, np.nan, 13.0, 12.0])
print(np.mean(values))
print(np.nanmean(values))
print(np.nanstd(values, ddof=1))
valid = np.isfinite(values)
print(np.mean(values, where=valid))
rng = np.random.default_rng(2026)
observed = values[valid]
bootstrap_means = np.array([
rng.choice(observed, size=observed.size, replace=True).mean()
for _ in range(5000)
])
print(np.quantile(bootstrap_means, [0.025, 0.975]))
|
情况 |
NumPy 模式 |
需要决定 |
|
NaN 感知均值 |
np.nanmean(x) |
NaN 是随机缺失还是结构性缺失? |
|
有限值掩码 |
where=np.isfinite(x) |
哪些值有效? |
|
掩码数据 |
np.ma.masked_invalid(x) |
有效性是否随数据传播? |
|
Bootstrap 均值 |
choice(..., replace=True) |
重采样单位是什么? |
|
Bootstrap 区间 |
quantile(bootstrap, [...]) |
采用哪种区间方法? |
不确定性不自动等于置信度
Bootstrap 分布描述所选重采样方案下的变异。只有当样本和重采样单位代表目标过程时,才能把它作为有意义的不确定性表达。相关时间序列、聚类观测和极小样本需要专门设计。
7. 可复现统计报告与验证
NumPy 统计摘要应当可审计。记录数据形状、观测轴、dtype、缺失值策略、自由度、权重、分位数方法,以及重采样或模拟使用的随机种子。使用恒等式、独立实现、图形和已知案例验证计算。
|
检查项 |
问题 |
行动 |
|
形状 |
一个观测是什么,哪个轴包含观测? |
断言 shape 和 axis 约定 |
|
dtype |
精度或整数溢出会影响结果吗? |
选择 dtype 并检查尺度 |
|
缺失 |
NaN 或掩码代表什么? |
明确掩码并报告数量 |
|
自由度 |
是总体还是样本估计? |
显式设置 ddof |
|
权重 |
为什么观测有不同权重? |
记录权重定义和归一化 |
|
异常值 |
极端值是错误还是真实事件? |
比较稳健和非稳健摘要 |
|
不确定性 |
估计有多大变异? |
使用标准误或合适重采样 |
|
可复现 |
能否重新生成结果? |
记录代码、版本和参数 |
# 可复现摘要对象
rng = np.random.default_rng(2026)
values = rng.normal(loc=100.0, scale=12.0, size=10_000)
summary = {
"n": int(values.size),
"mean": float(np.mean(values)),
"median": float(np.median(values)),
"std_ddof1": float(np.std(values, ddof=1)),
"q05": float(np.quantile(values, 0.05)),
"q95": float(np.quantile(values, 0.95)),
"finite_count": int(np.isfinite(values).sum()),
}
print(summary)
NumPy 统计最终检查表
- 在计算统计量前定义观测单位、轴、单位和缺失值策略。
- 结合均值、中位数、分位数、离散程度和图形理解分布形状。
- 有意识地设置 ddof、权重、分位数方法和 dtype。
- 把协方差和相关性视为描述性关联,而不是因果关系。
- 报告不确定性、样本量、稳健性选择和可复现细节。
更多推荐

 0
 0
- 0


 已为社区贡献41条内容

所有评论(0)