
[人工智能]Python01:numpy.random.Generator:概念用法与最佳实践
numpy.random.Generator:概念、用法与最佳实践
本文面向工程实践,系统介绍NumPy中推荐使用的随机数接口numpy.random.Generator,包括实例构造方式、常用分布方法以及在可复现性和并行仿真中的最佳实践,适合作为超过4页的技术参考文档,供科学计算和数据分析工作流使用。
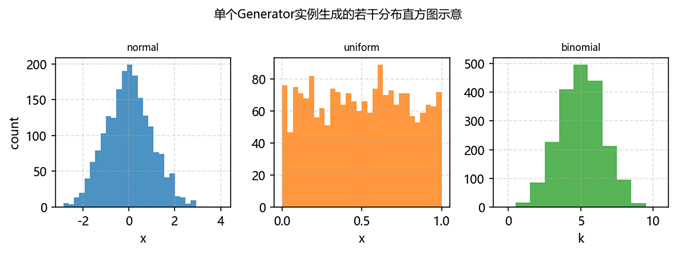
图1:使用同一Generator实例从正态、均匀和二项分布采样得到的样本直方图示意(示意)。
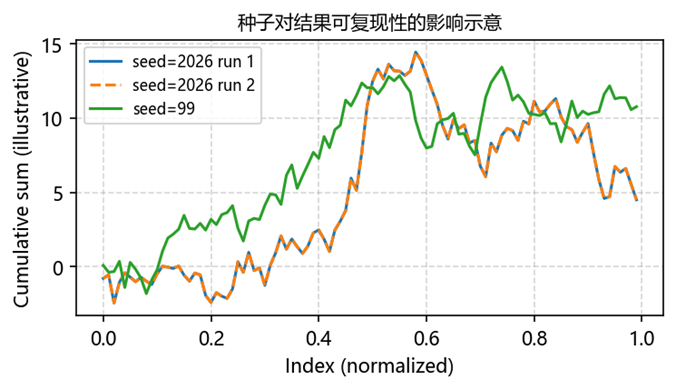
图2:多次构造Generator实例并使用相同和不同种子生成累积和序列的示意,说明相同种子产生相同随机序列(示意)。
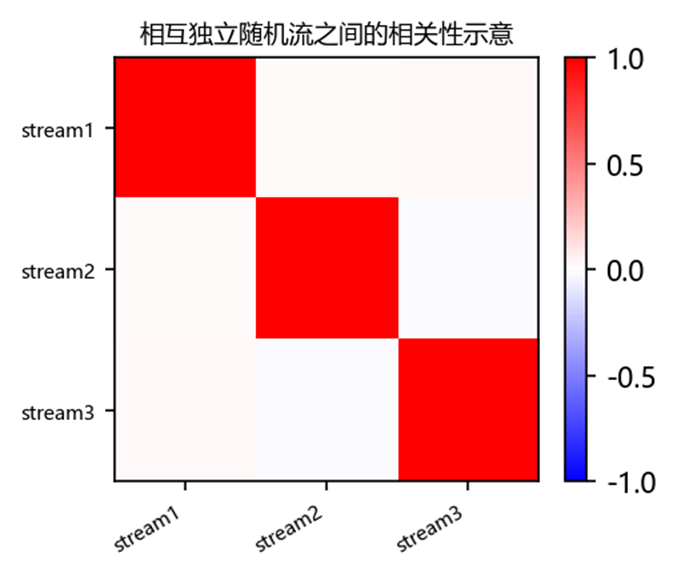
图3:从同一根SeedSequence派生的三个随机流之间相关系数矩阵的示意,表明不同流近似独立(示意)。
|
构造方式 |
代码示例 |
说明 |
适用场景 |
|
默认生成器 |
rng = np.random.default_rng() |
基于操作系统熵和PCG64位生成器创建Generator实例。 |
一般用途,对跨进程完全可复现性要求不高时。 |
|
指定种子 |
rng = np.random.default_rng(1234) |
使用显式种子初始化Generator。 |
需要可复现结果的实验、单元测试和教学示例。 |
|
自定义位生成器 |
from numpy.random import PCG64; rng = np.random.Generator(PCG64(42)) |
允许显式选择底层位生成算法。 |
研究随机数性质或与遗留代码对接时。 |
|
线程私有生成器 |
rng = np.random.default_rng(np.random.SeedSequence().spawn(1)[0]) |
通过SeedSequence派生统计独立的子流。 |
并行仿真中需要相互独立随机流的场景。 |
表1:构造numpy.random.Generator实例的常见方式及典型使用场景。
|
方法 |
分布族 |
常用参数 |
使用示例 |
|
random |
[0, 1) 区间的均匀分布 |
size |
rng.random(100) 生成通用均匀随机数。 |
|
integers |
离散均匀分布 |
low, high, size |
rng.integers(0, 10, size=(3, 4)) 生成整数索引。 |
|
normal |
高斯分布 |
loc, scale, size |
rng.normal(0, 1, 1000) 用于噪声和蒙特卡洛仿真。 |
|
poisson |
泊松分布 |
lam, size |
rng.poisson(5.0, 100) 用于计数过程建模。 |
|
choice |
从数组中采样 |
a, size, replace, p |
rng.choice(states, p=probs) 用于类别选择。 |
表2:Generator常用分布方法及其典型参数和使用示例。
|
主题 |
建议 |
原因 |
备注 |
|
种子管理 |
在顶层实验中使用default_rng并显式指定种子。 |
在使用现代位生成器的同时保证可复现性。 |
在新代码中避免再使用np.random.seed。 |
|
全局状态 |
优先传递Generator实例而非依赖模块级全局状态。 |
提升可测试性,避免隐式依赖。 |
为组件创建各自的rng并通过依赖注入使用。 |
|
并行随机流 |
使用SeedSequence.spawn派生相互独立的随机流。 |
降低并行仿真中随机流相关的风险。 |
记录各子种子有助于调试复现。 |
|
分布选择 |
根据实际现象选择合适的分布。 |
提高仿真建模的合理性。 |
例如计数过程用泊松,聚合效应用高斯。 |
|
测试策略 |
单元测试中固定种子,压力测试中适当变化种子。 |
确保测试可重复的同时覆盖更多边界情况。 |
记录能复现已知问题的特定种子。 |
表3:在项目中使用numpy.random.Generator的若干最佳实践建议。
1. 引入numpy.random.Generator的动机
早期NumPy代码通常使用基于模块级全局状态的随机数接口,如numpy.random.rand和numpy.random.RandomState。虽然简单易用,但这种设计使得种子管理困难,也不利于在复杂工程中实现可复现性和并行随机流管理。
numpy.random.Generator通过将位生成器与分布API解耦,并鼓励显式管理随机状态,解决了上述问题。开发者可以在同一程序内创建多个相互独立的随机流,更方便地进行测试和并行仿真。
2. Generator实例的构造方式
推荐的入口是numpy.random.default_rng。无参数调用时,它从操作系统熵源获取种子并基于PCG64位生成器构造Generator;传入整数种子则得到可复现的随机序列。对于高级用例,可以直接从BitGenerator实例(如PCG64、Philox或SFC64)构造Generator。
在较大的应用中,通常在明确的边界(例如模块级或仿真运行级)创建有限数量的Generator,并将其显式传递给需要随机性的函数或类,避免隐式共享全局状态。
3. 分布方法概览
Generator提供了丰富的分布方法,包括均匀、正态、对数正态、指数、泊松、二项等,以及用于从给定数组中采样的choice等方法。random和integers等方法提供基础组件,而choice则支持按概率权重从任意数组中抽样。
每个分布方法的参数与其数学定义一一对应,例如normal中的loc和scale,poisson中的lam等。理解这些参数有助于将实际物理或统计现象映射为合适的概率模型。
4. 输出形状与广播机制
多数Generator方法都接受size参数,用于指定返回数组的形状。size可以是整数或整数元组,方法会根据需要对分布参数进行广播以生成具有该形状的样本数组。
合理使用size可以实现向量化随机数生成,比在Python循环中逐个采样高效得多。这对于蒙特卡洛仿真、随机优化和合成数据生成等场景尤为重要。
5. 可复现性与种子策略
在调试、科研发表和回归测试中,可复现结果非常重要。通过在构造Generator时使用固定种子(或SeedSequence),并在实验日志中记录这些种子,可以在未来重现相同的随机序列。
同时,完全依赖单一全局种子容易在不同组件之间引入隐式耦合。常见策略是创建一个顶层SeedSequence,然后通过spawn派生多个子SeedSequence,为不同模块或并行worker生成相互独立但可复现的随机流。
6. 并行与分布式仿真中的随机流管理
在并行仿真中,简单地使用连续整数作为种子可能导致随机流之间的相关性强于预期。SeedSequence.spawn提供了一种结构化的方法,从共同的根种子派生多个具有良好统计独立性的子种子。
在分布式计算环境中,可以为每个进程分配一个由spawn得到的SeedSequence构造的Generator,从而避免围绕全局状态的竞争条件,并简化随机数使用的责任划分。
7. 从RandomState迁移到Generator
现有NumPy代码可能仍在使用numpy.random.RandomState及其相关函数。虽然这些接口在一定时间内会继续支持,但新代码推荐使用Generator。迁移通常包括创建一个Generator实例,并将模块级随机调用替换为实例方法调用。
在极少数需要与旧生成器完全比特级兼容的场景下,可以通过选择相同的BitGenerator算法来实现兼容。但对大多数应用而言,切换到现代位生成器可获得更好的统计性质。
8. 使用Generator进行测试与调试
在编写单元测试时,固定种子有助于确保测试结果确定稳定。测试可以使用已知种子构造Generator,并验证重要性质(例如分布矩或算法输出)在版本更新后保持不变。调试罕见故障时,记录导致故障的种子尤为关键。
在健壮性测试中,有必要刻意改变种子,无论是在不同测试运行之间还是在专门的压力测试中,以提高对随机模式多样性下行为的信心。
9. 常见误用与陷阱
在使用随机数时,常见问题包括:多个不相关组件无计划地共享同一个Generator、在同一项目中混用旧API和新API导致语义混乱、误解分布参数含义等。参数和shape的广播机制若未仔细检查维度,也可能引入隐蔽bug。
缓解措施包括:集中管理Generator构造、文档化种子策略、对数组shape添加断言,以及通过小型探索脚本验证采样分布是否符合预期。
10. 在大型工程中的集成实践
在较大工程项目中,可以将随机数视为一项需要统一管理的资源。通过配置文件指定种子或SeedSequence,在组件间通过依赖注入传递Generator,并在日志中记录每次实验使用的随机配置,有助于兼顾可复现性与探索性。
遵循上述实践,团队可以在需要时轻松复现实验结果,同时在开发和研究阶段充分探索随机空间,从而提高系统的可靠性和可维护性。
更多推荐

 3
 0
- 0


 已为社区贡献41条内容

所有评论(0)