
多模态出题,Coding 搭平台:用 Seed-2.1-pro-0915 建起 AI 认证实训系统(317 道题 + 136 个沙箱关)
目录
前言
本文记录「智工认证通——人工智能工程技术人员认证实训平台」的建设过程。Seed-2.1-pro-0915在项目中承担两个角色:一是以多模态理解能力,把 42 份官方资料——41 份含扫描页、公式和架构图的讲义 PDF,加 1 份理论题 Excel——转化为 317 道理论题(其中 232 道 PDF 题逐题带页码溯源);二是以 Coding 能力与我们协同工程化,落地一个含 136 个 Docker 沙箱实操关卡、学员端与讲师端、模考引擎与数据看板,服务于真实考级认证的完整实训平台。
如果你在做教育内容生产、扫描件/图文资料理解,或想用大模型的 Coding 能力快速搭建功能完整的业务系统,这篇文章能给你一套可直接复用的流水线,以及我们踩过的坑。
1 一个真实存在的认证缺口
人工智能工程技术人员(职业编码 2-02-10-09)是人力资源社会保障部与工业和信息化部联合发布的国家新职业,有正式的《人工智能工程技术人员国家职业技术技能标准(2021 版)》。认证分初、中、高三个等级,每级设人工智能芯片、人工智能平台、自然语言及语音处理、计算机视觉、人工智能应用产品集成实现五个方向,本平台面向其中的人工智能平台产品实现方向。需要说明:它并非全国统一统考,而是由各地备案评价机构组织的社会化评价,与市面上各类培训能力证书不是一回事。
考试为百分制,分理论知识(机考或笔试,不少于 90 分钟)与专业能力(实操或项目设计,不少于 120 分钟)两门,两门均达到 60 分才算合格。备考中真正卡人的是专业能力这门:它考的是在真实环境里写代码、调程序、排查问题,而不是背概念。
我们手上就有 42 份资料(41 份 PDF 加 1 份理论题 Excel),但没有配套题库、没有模考系统、也没有可以随时使用的实操环境。看书时"都懂",一做题就露怯;想练实操,光在本地配齐 Python 环境和依赖,就先劝退一批在职考生。市面上的题又多靠人工攒,更新慢、知识域覆盖不全,答案没有出处,做错了都不知道去哪核对。
我们做的「智工认证通」就是冲着这个缺口来的:把学教程、闯关写代码、理论练习与模考、实操仿真考试、数据化备考诊断串成闭环,再用积分、徽章、打卡、排行榜帮在职考生坚持下来。
而建设这样一个平台,首先撞上、又贯穿全程的瓶颈是一个内容问题:题,从哪来? 这篇文章也围绕模型的两种能力讲两件事——它的 317 道理论题,是怎么靠多模态大模型从 41份 PDF 讲义里"读"出来的;而这个含 136 个沙箱实操关、功能完整、真实可用的实训平台本身,又是怎么借助同一颗模型的 Coding 能力一步步搭起来的。
2 平台功能全景:不只是题库,而是完整备考系统
在讲 AI 之前,先交代系统长成什么样,也把全文要用到的数字一次性摊开:
| 维度 | 实际规模 |
|---|---|
| 输入资料 | 42 份官方资料:41 份讲义 PDF(含 6 份没有文本层的扫描件)+ 1 份理论题 Excel |
| 知识覆盖 | 按文件编号天然划分 11 个知识域 |
| 理论题库 | 317 题:单选 163 / 多选 51 / 判断 103;232 道 PDF 题带页码溯源、60 道官方结业题、25 道自编题 |
| 实操关卡 | 136 个代码填空关,学员代码在 Docker 容器里真实执行判分 |
| 工程兜底 | 21 个后端测试文件、190 余个自动化用例,加前端 TypeScript 类型检查与构建门禁 |
它不是一个调用大模型 API 的 demo,而是一个有学员端、讲师端、考试引擎、判题沙箱和数据看板的完整应用。技术栈上,后端是 FastAPI + SQLAlchemy 2(开发用 SQLite、生产用 PostgreSQL),定时任务用 APScheduler,判题走线程池任务队列异步执行("提交拿 id、轮询取结果"协议固定,生产可平滑切换为 Celery + Redis);前端是 Vue 3 / TypeScript / Vite / Element Plus / Pinia / ECharts,鉴权用 JWT 双 Token,学员代码在一次性 Docker 容器里隔离执行。
2.1 学员端:从入门到上考场的完整闭环
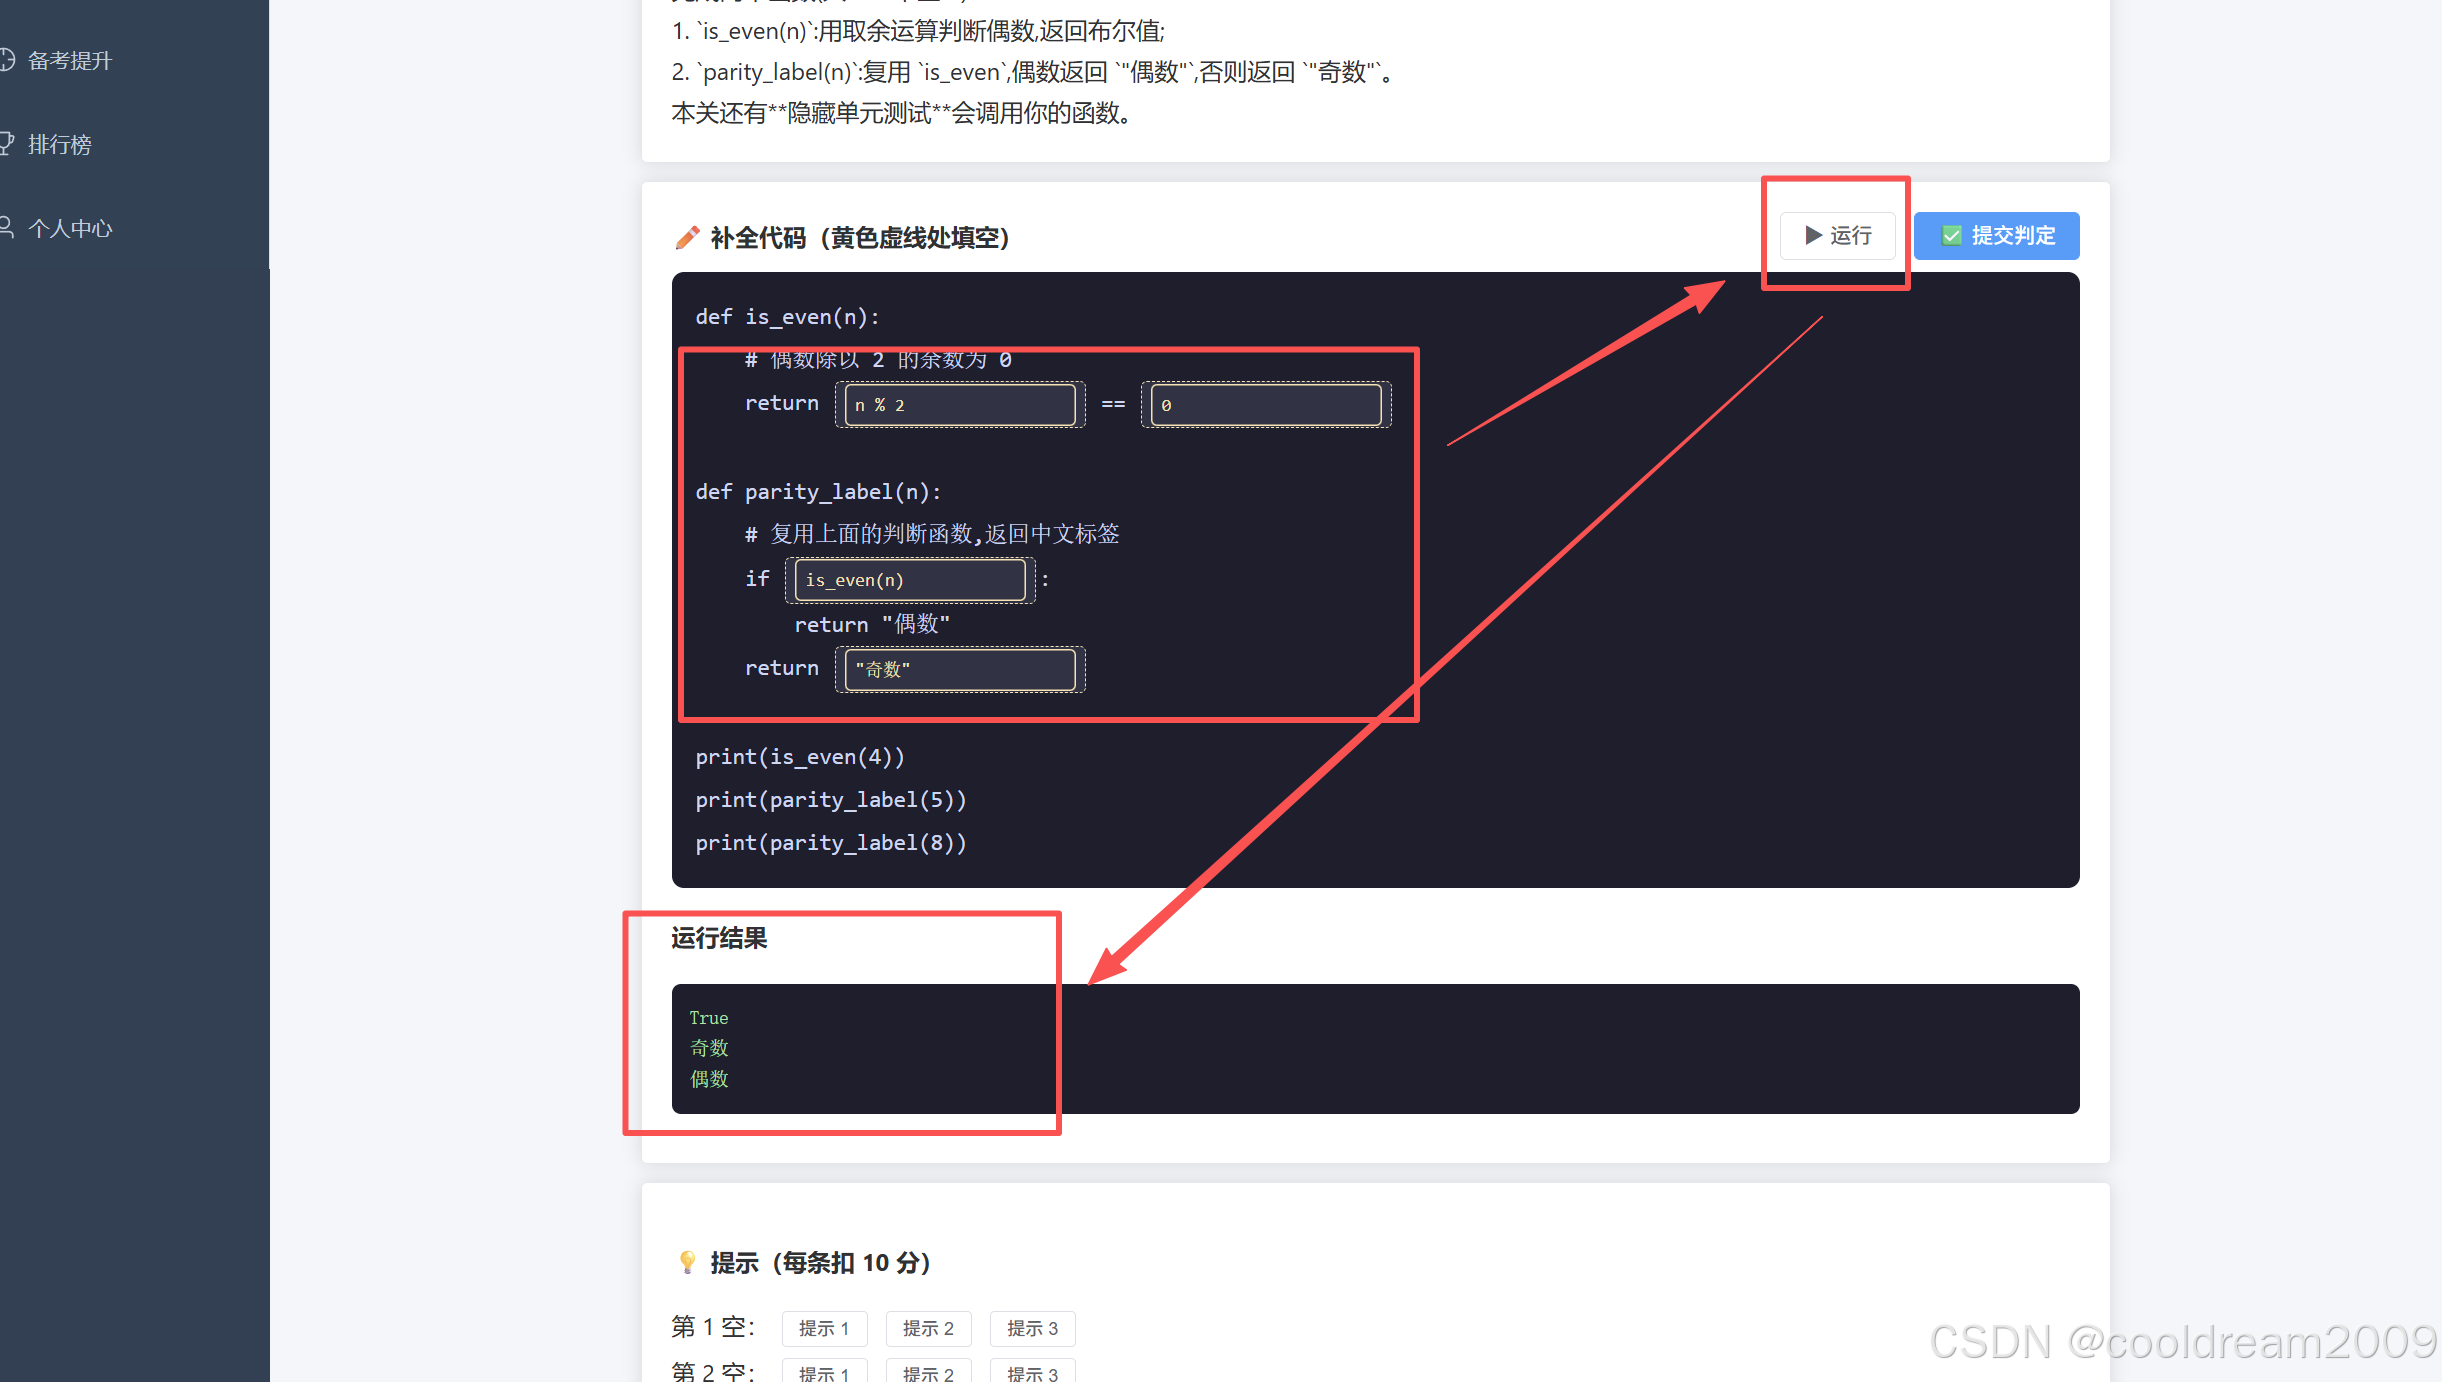
学员登录后首先看到一张闯关地图:课程按章节组织成树,关卡逐关解锁,通关后按表现给星级,卡壳时可以解锁分级提示(看提示会在结算时扣分)。代码关的判定不是选择题式的"像不像",而是真实执行:学员填好空后可以先"运行调试"(不计分),再"提交判定"(计分);后端把代码填入模板,丢进一次性 Docker 容器执行,再按标准输出比对、assert 断言用例和对学员不可见的隐藏用例三层判定对错。
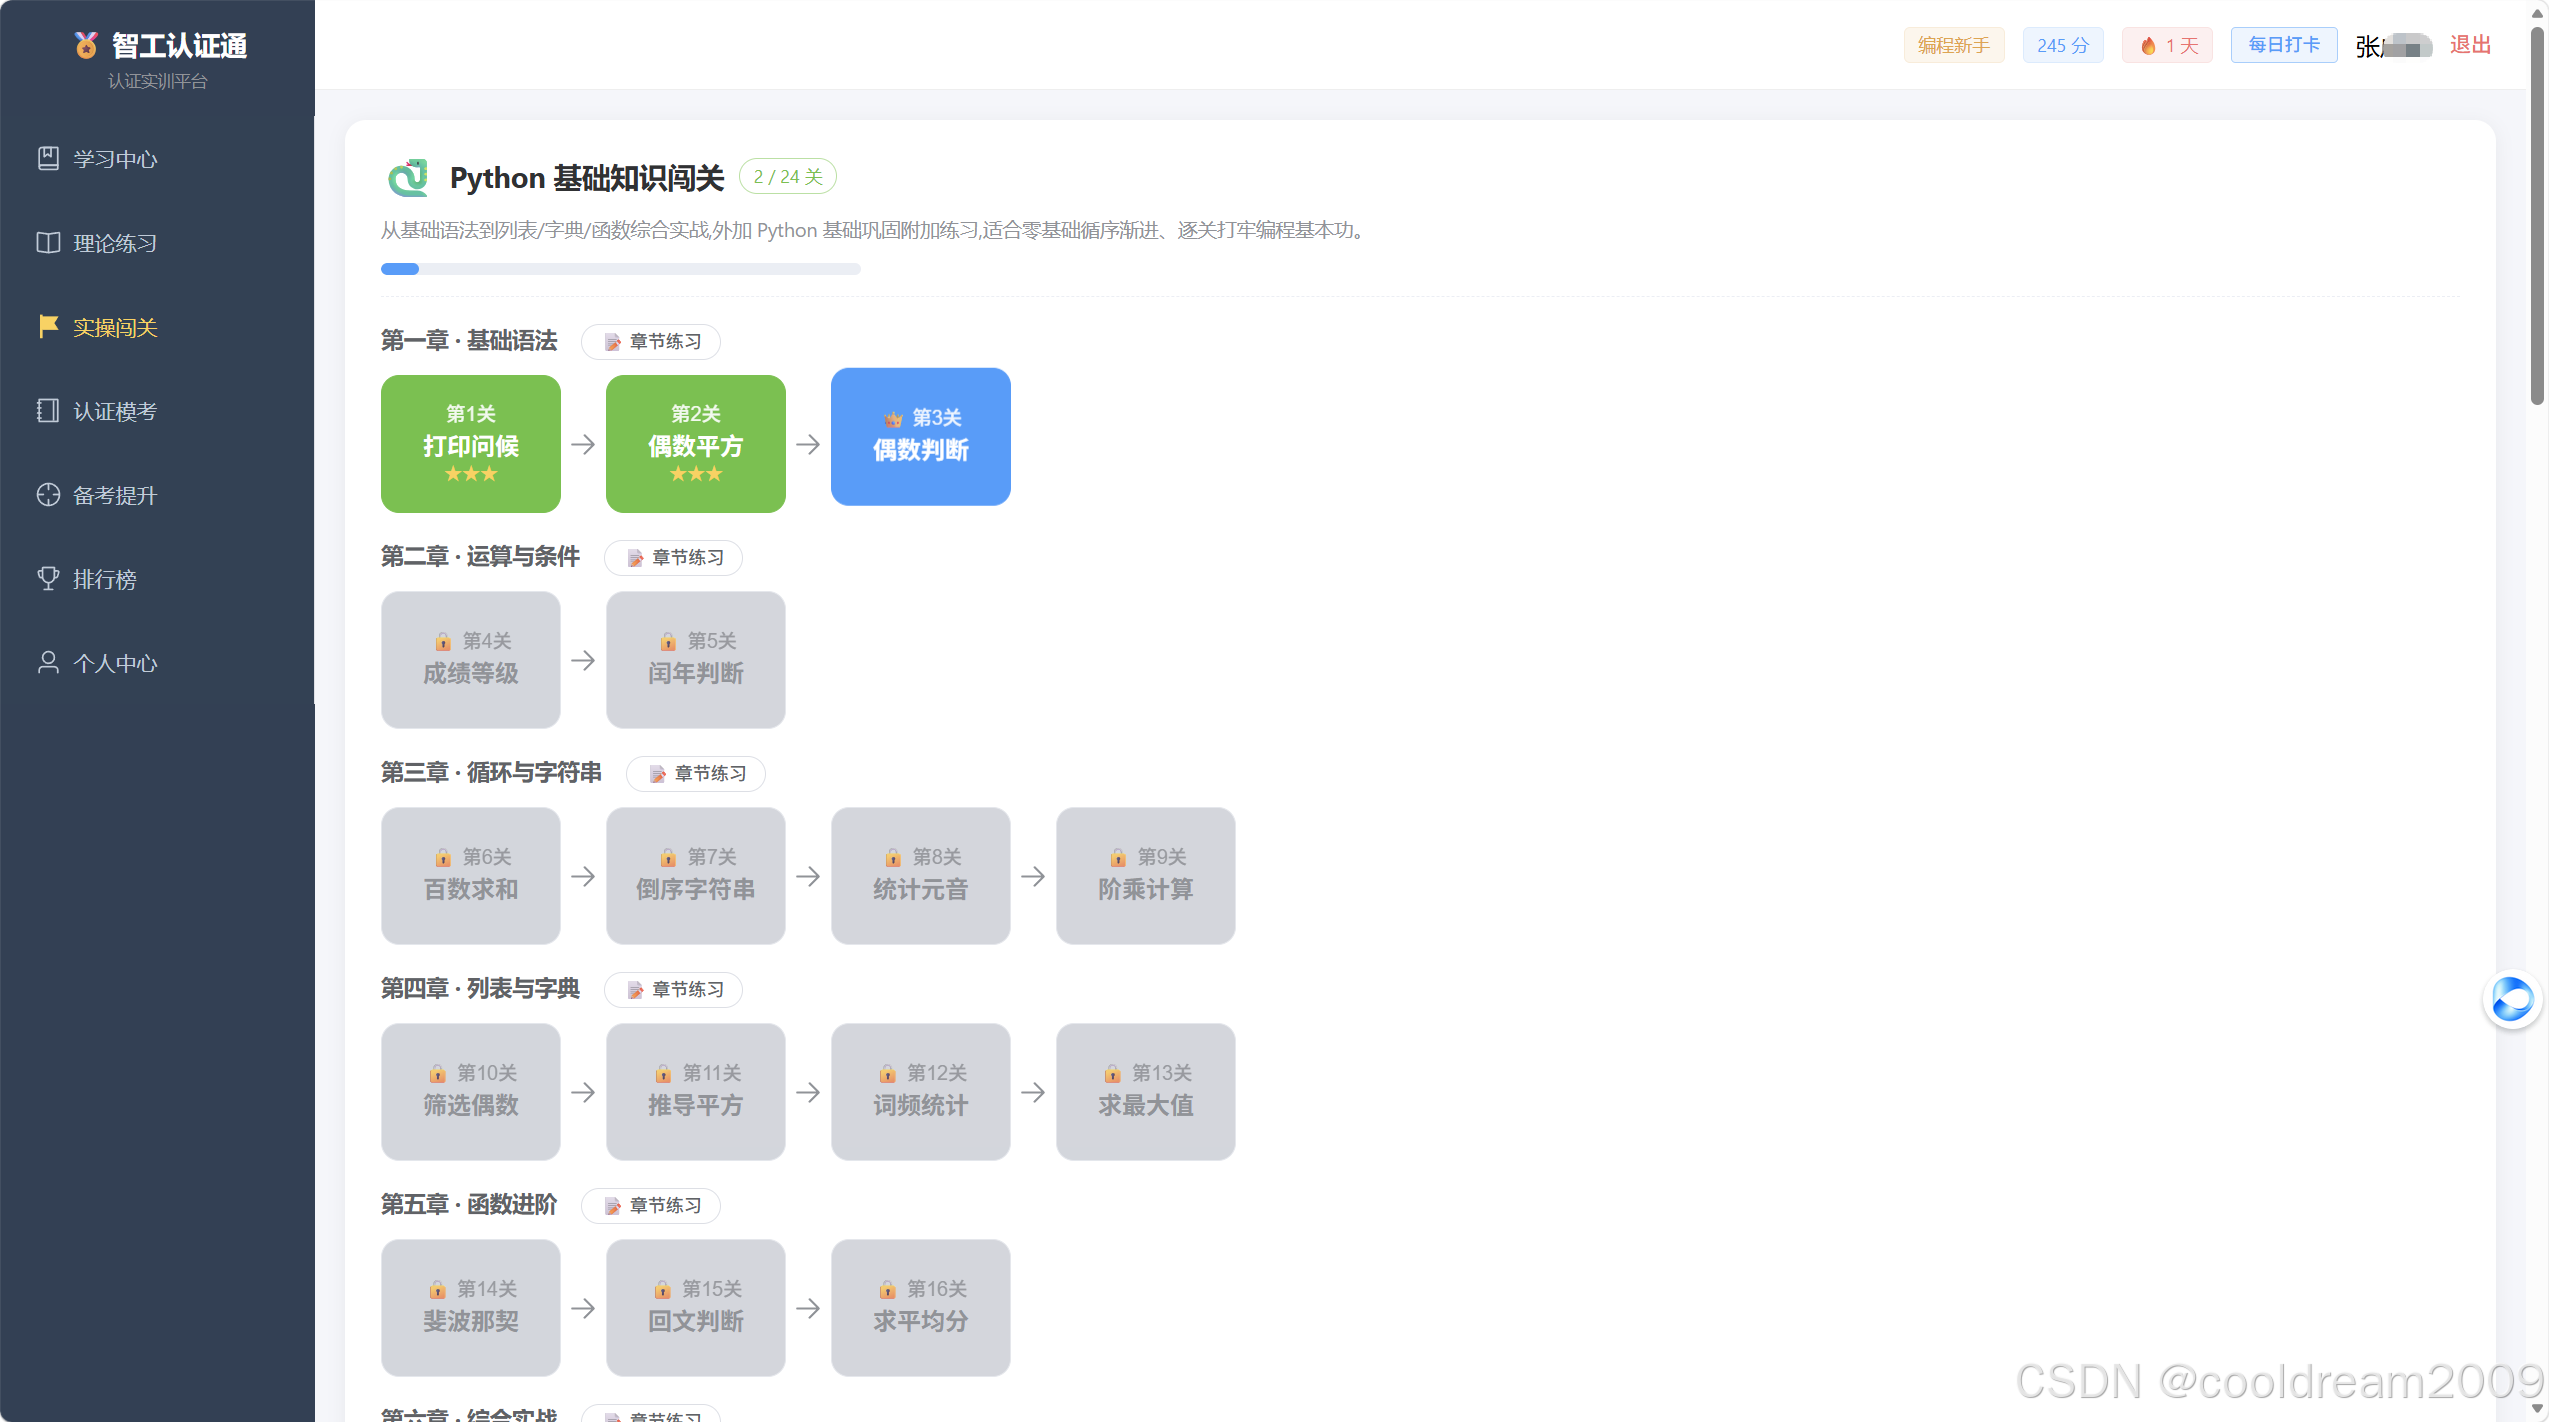
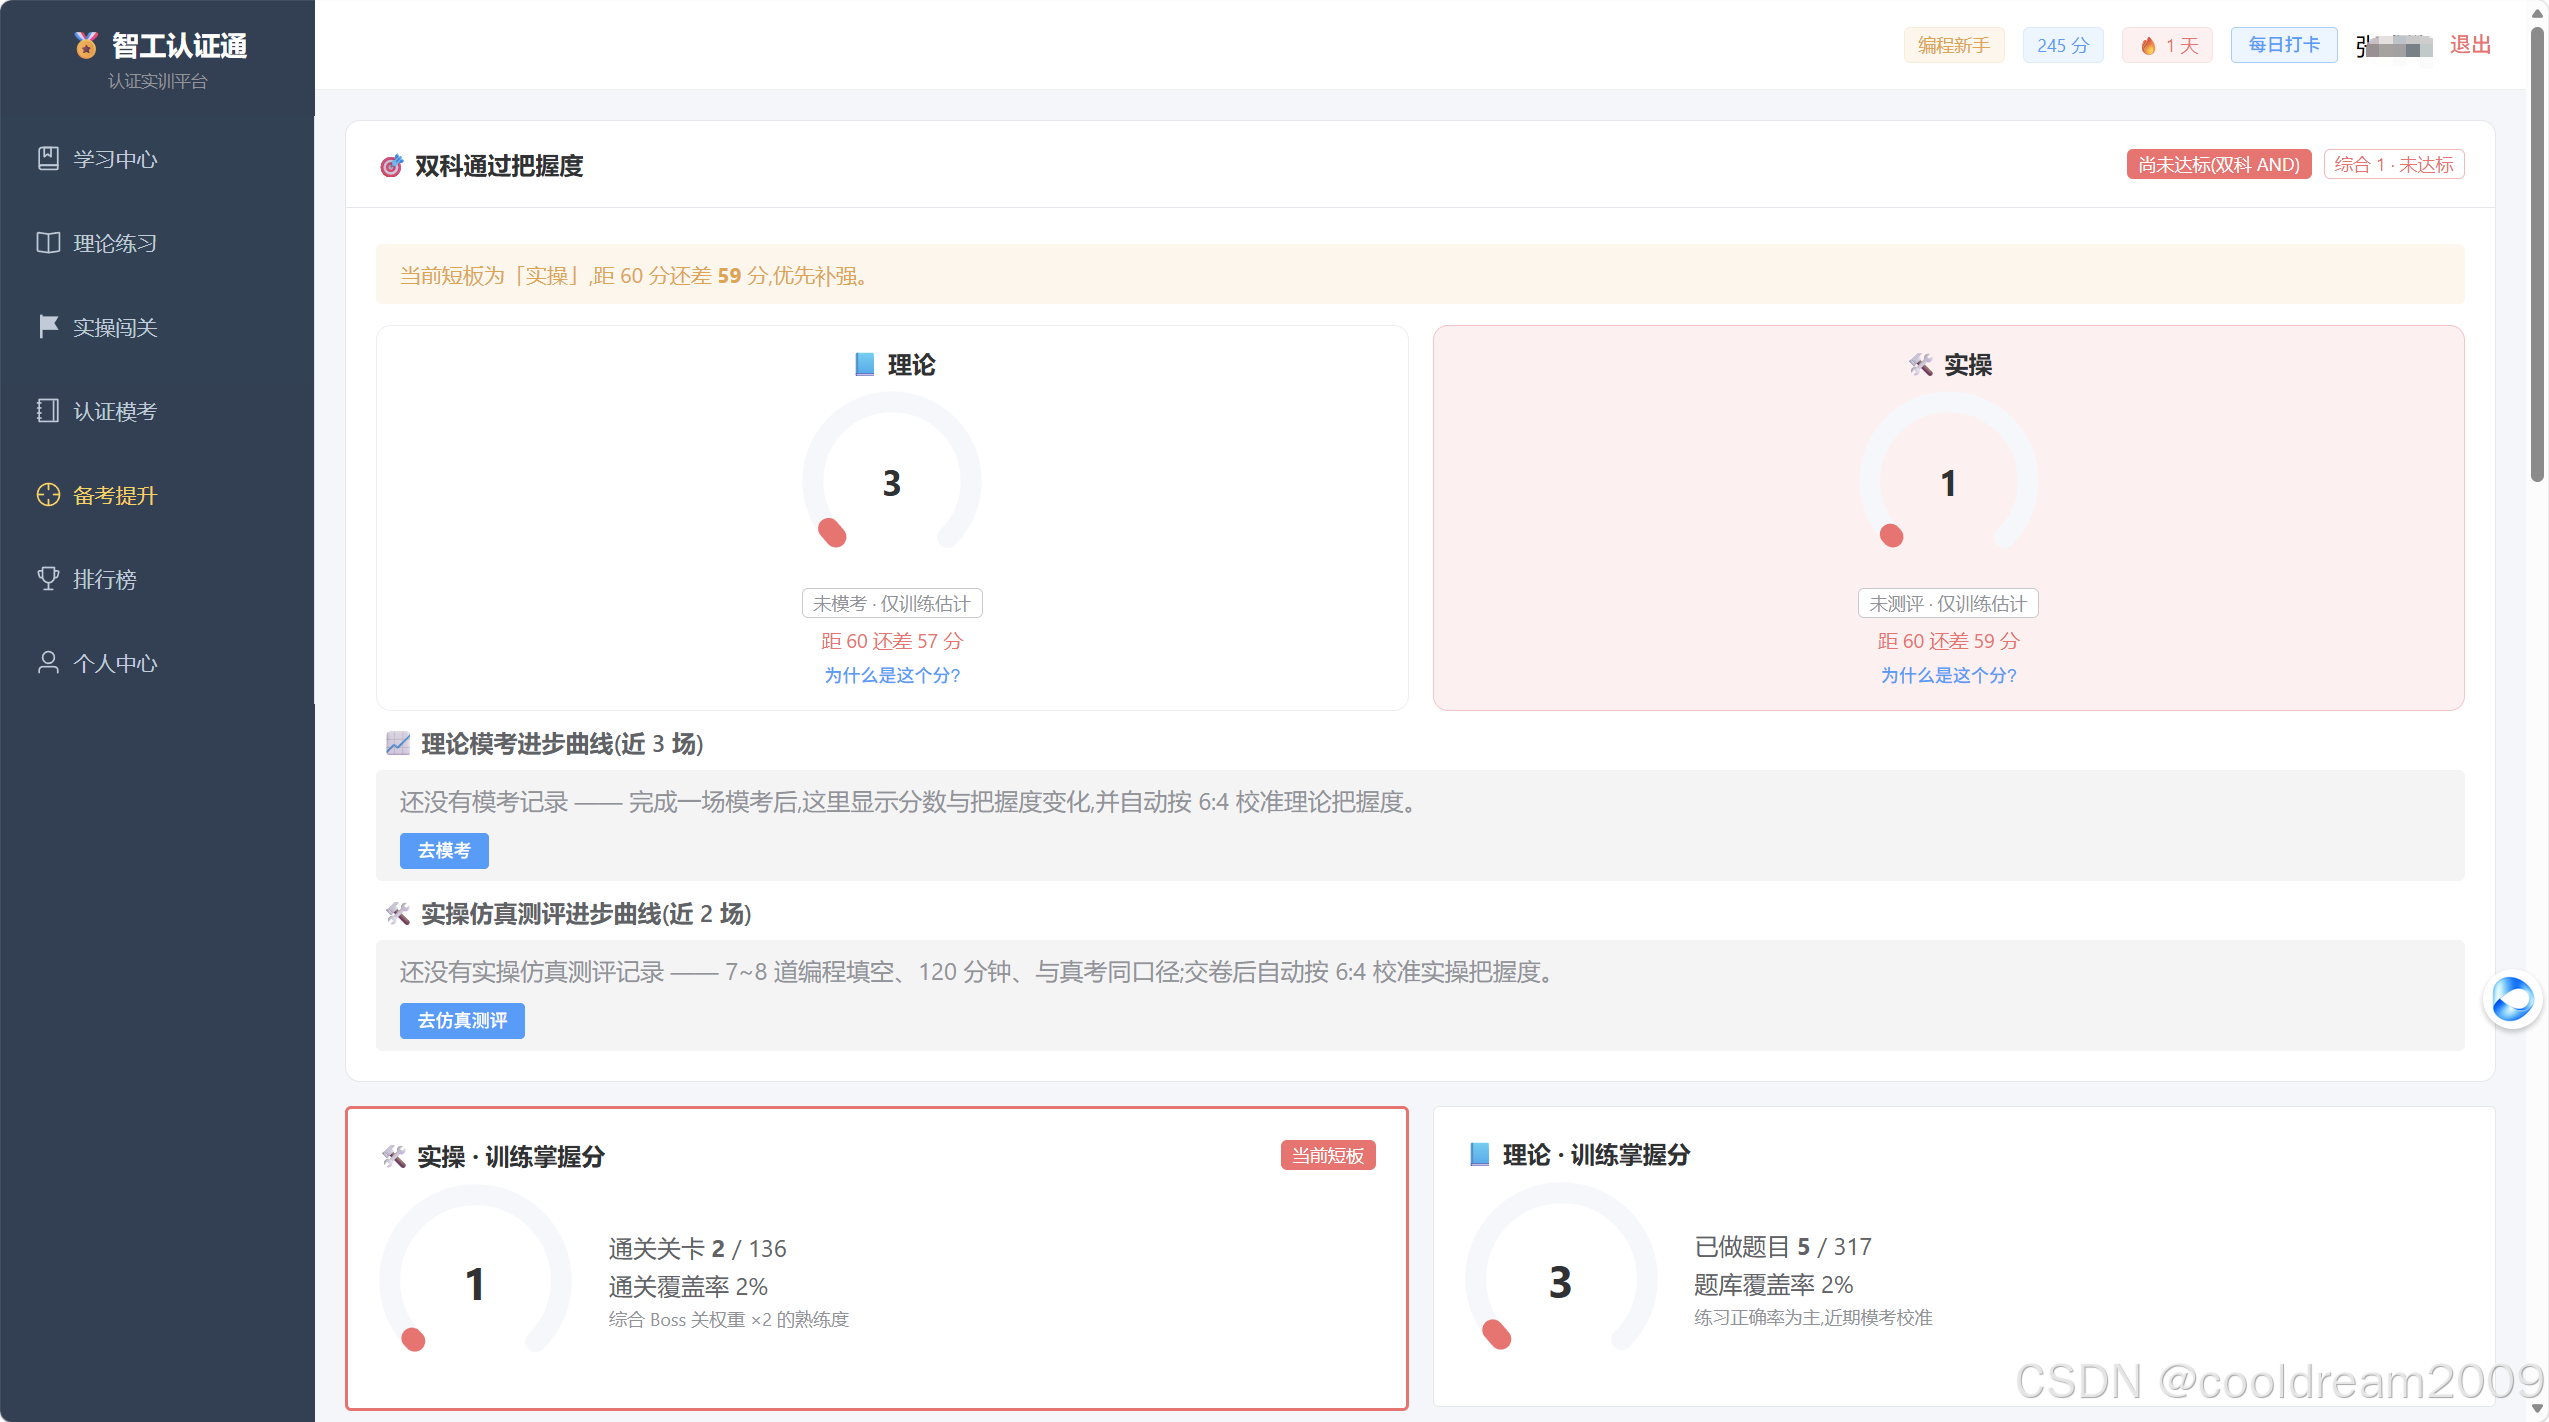
与代码关并行的是理论中心:按章节练习选择题,提交即出解析;做错的题自动进入错题本,按间隔复习(spaced review)的节奏安排重做。理论之外有全真模考:系统按规则限时组卷,到点自动交卷(即使网络抖动,前端也会退避重试),交卷后出分并可逐题回看解析。实操侧有形态对齐真实认证的仿真考试:讲师发布标准卷,学员限时逐题作答、每题沙箱判分,考后生成测评报告。备考仪表盘给出知识点掌握度画像、备考就绪度评估和针对薄弱点的学习路径推荐,解决"我不知道自己还差什么"。学习中心另有图文教程,与关卡、题目互相打通;积分、徽章、打卡、每日/每周任务和四类排行榜(总榜、周榜、通关榜、班级榜,榜单带名次变化)负责解决在职考生"坚持不下来"的问题。
2.2 讲师与管理端:让平台运营得起来
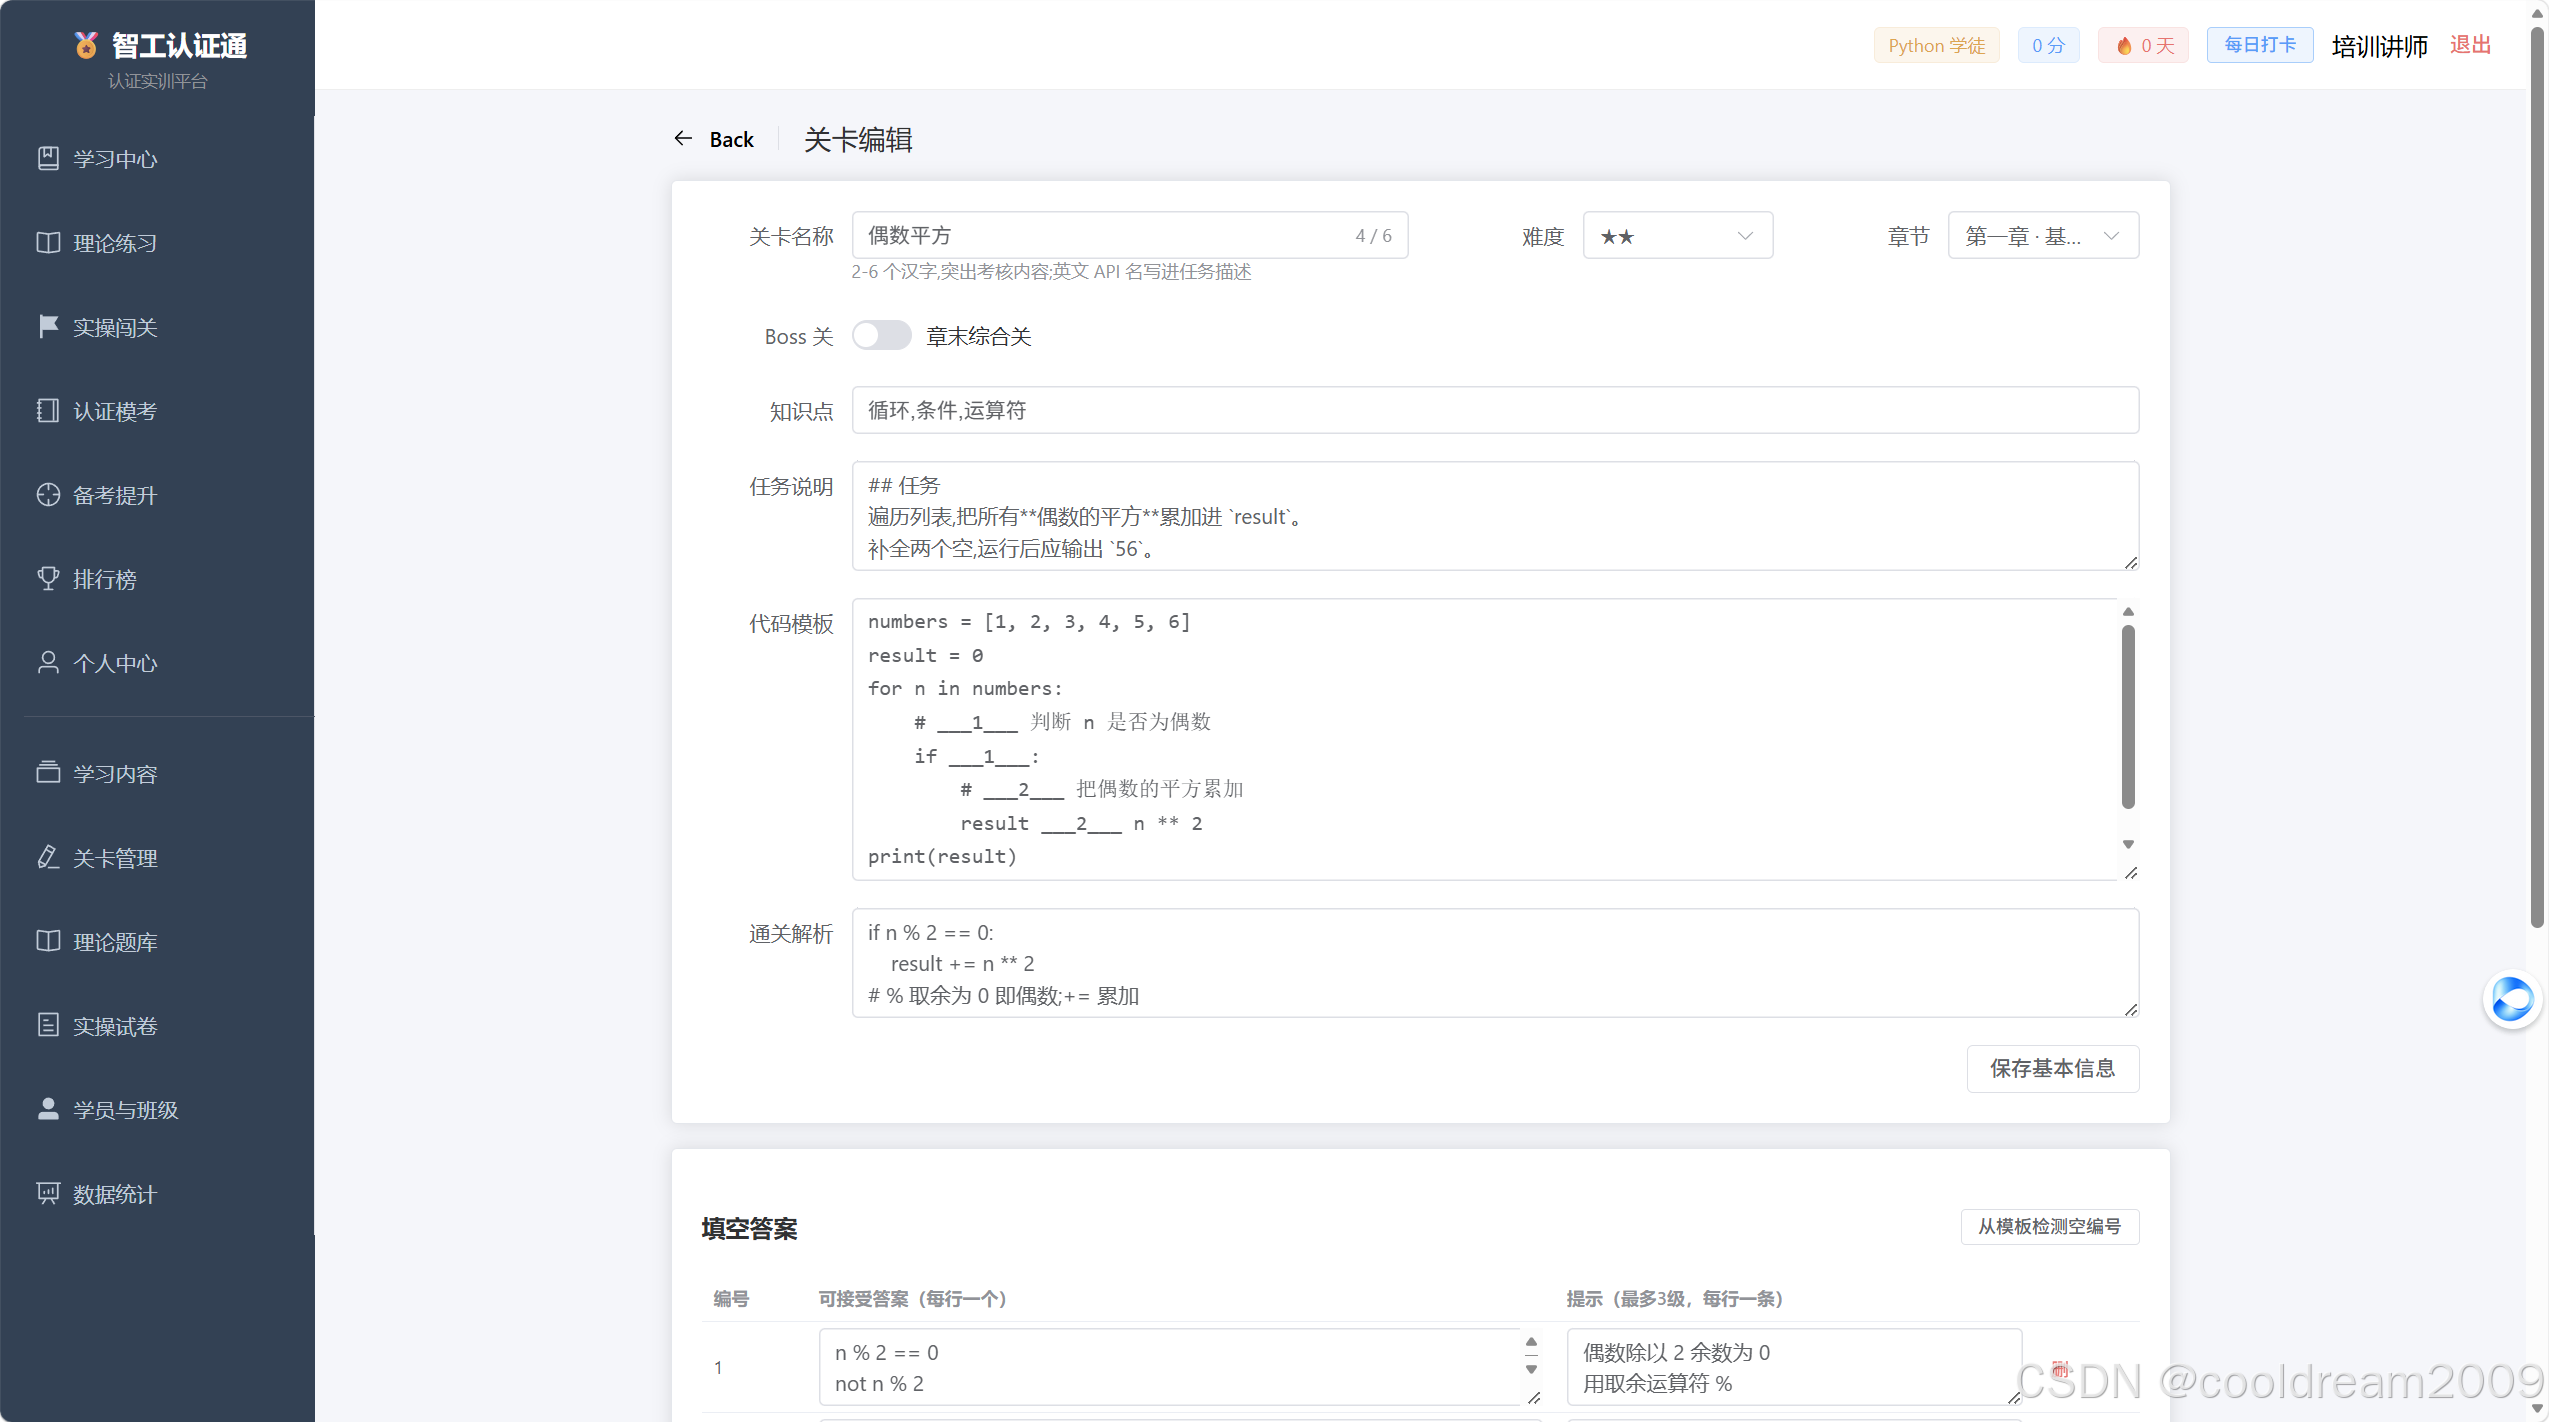
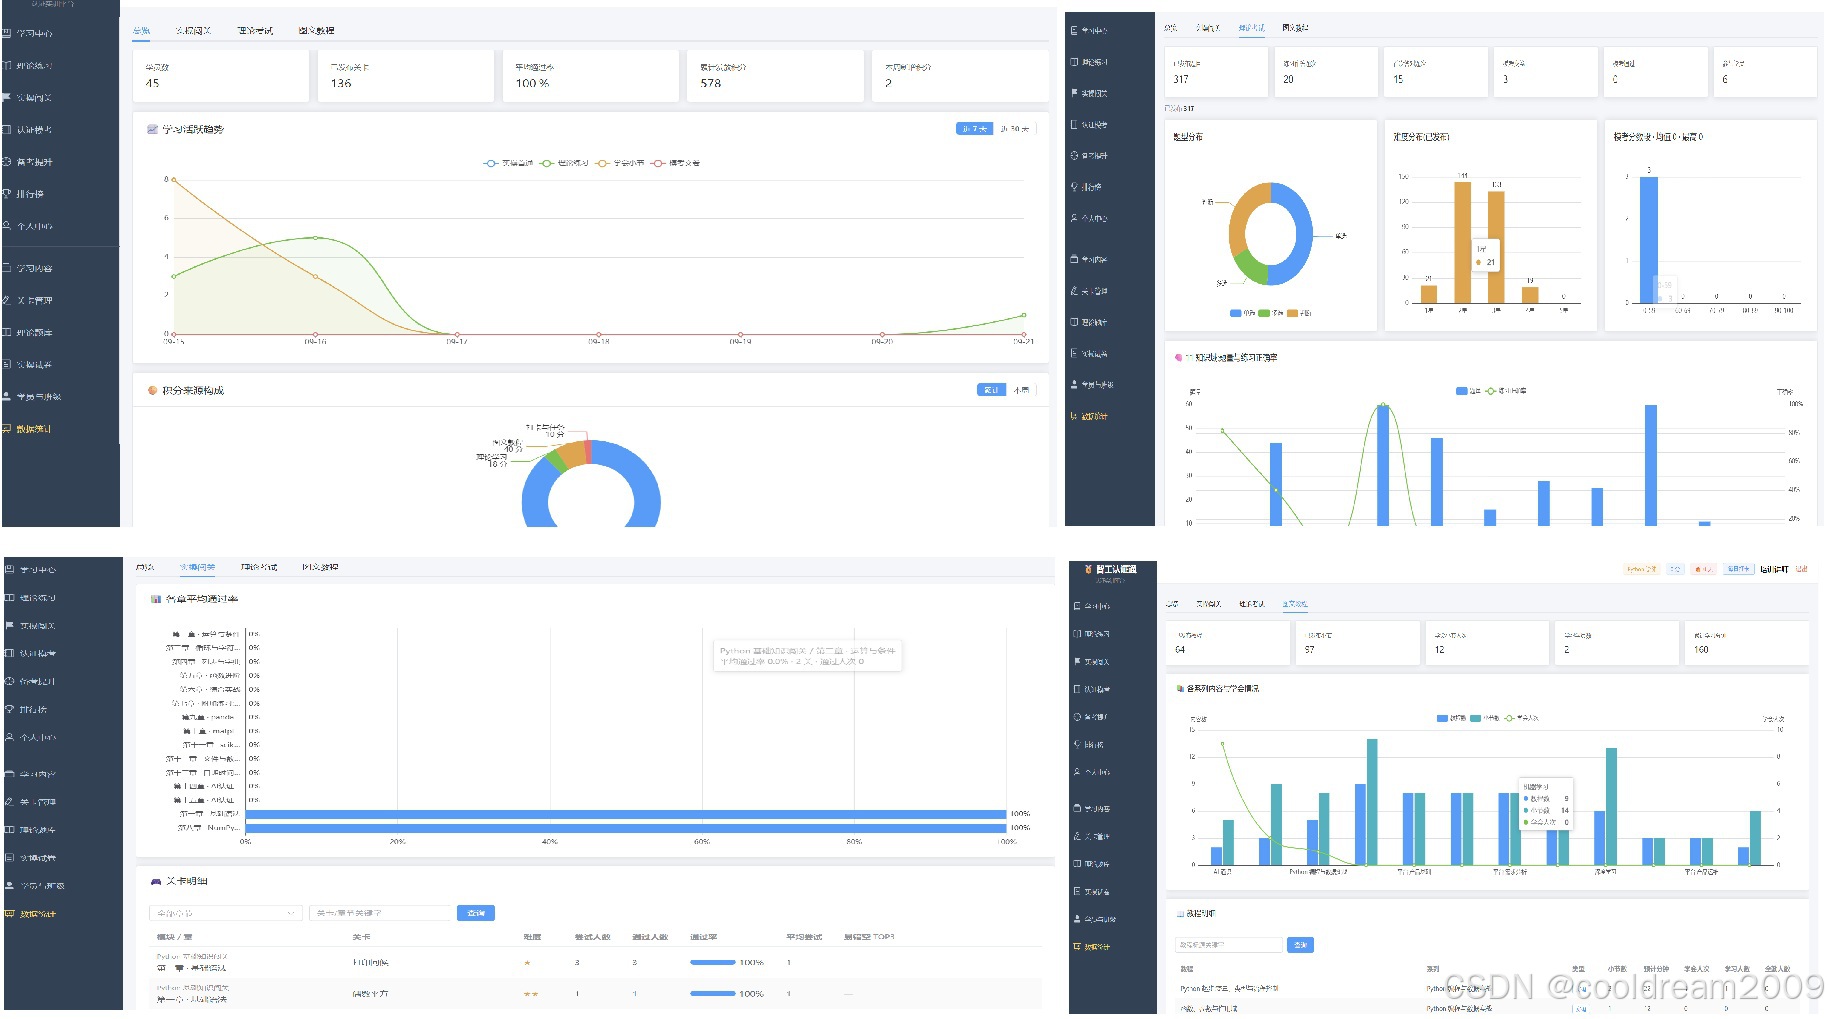
学员端的内容全部由讲师端生产和维护:可视化编辑章节与关卡,包括填空答案、多答案短语、三级分级提示和每个关的测试用例(stdin、期望输出、隐藏用例、断言脚本);题目与关卡支持草稿、发布、下架的完整生命周期,章节可按班级定时解锁。班级运营支持邀请码入班、Excel 批量导入学员(脏数据逐行跳过并回显行号与原因)、手动解锁关卡、课堂加/扣分和重置学员进度(游戏化痕迹清空,实操认证测评档案保留)。讲师端另有一套基于 ECharts 的数据看板,分总览、实操、理论、教程四个板块:活跃趋势与积分构成、各章通过率与 136 关明细、知识域正确率与模考分数段、图文教程学会人次,教学过程因此可观测,而不是凭感觉。
2.3 工程质量:为"完善"兜底
一个要给真实考试用的系统,边角必须硬。学员代码先经静态检查(code_guard)拦截危险调用——这套扫描规则由 19 条已知危险构造(含两条实测绕过 payload)做回归、11 条正常教学代码做白名单防误伤——再进容器隔离执行,超时强制终止;登录连续失败会锁定账号,接口与前端路由都按角色(学员/讲师/超管)双重收口;生产环境有配置安全闸门,例如 CORS 带通配符会直接拒绝启动。所有写接口都有入参体量上限,发分(首通、交卷、打卡、领奖)在并发与重复提交下保证幂等;全站遵循统一响应、分页与审计日志约定。这些不是设想,190 余个后端自动化用例加上前端 vue-tsc 类型检查与构建门禁,每天都在替它们兜底。
但系统再完整,冷启动的瓶颈依然是内容——317 道理论题和 136 个实操关的内容,不可能纯靠手写。下面进入正题。
3 题库冷启动:42 份资料,三种"难读"
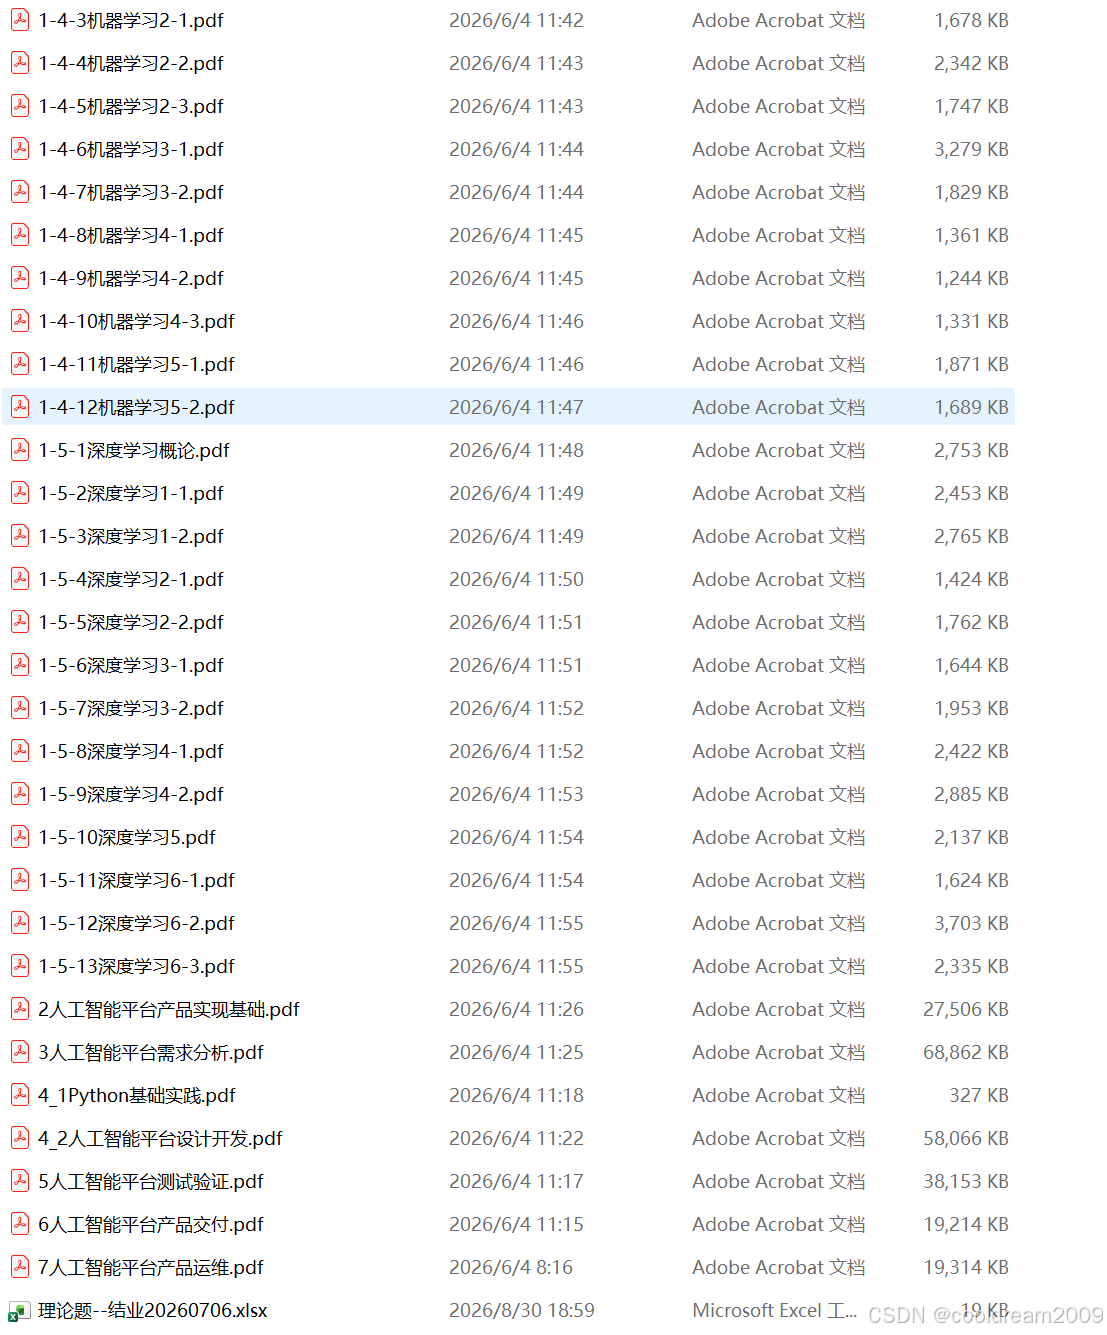
资料盘里是 41 份官方培训讲义 PDF 加 1 份理论题 Excel,共 42 份;PDF 文件名前缀本身就编码了知识域,一条正则就能自动归类、按域配额出题:
DOMAIN_PREFIX = [
    (re.compile(r"^1-1"), "01_伦理与政策"),
    (re.compile(r"^1-2"), "02_基础(软工数据数学)"),
    (re.compile(r"^1-3"), "03_计算平台"),
    (re.compile(r"^1-4"), "04_机器学习"),
    (re.compile(r"^1-5"), "05_深度学习"),
    (re.compile(r"^2"),   "06_产品实现基础"),
    (re.compile(r"^3"),   "07_需求分析"),
    (re.compile(r"^4[_-]"), "08_Python实践与设计开发"),
    (re.compile(r"^5"),   "09_测试验证"),
    (re.compile(r"^6"),   "10_产品交付"),
    (re.compile(r"^7"),   "11_产品运维"),
]
真正的麻烦在 PDF 内部,它们呈现三种形态。其一是文字版,有文本层,pypdf 能直接抽字,但夹杂页眉页脚、版权行噪声,还有英文断词(行尾 - 跨行)和分页截断,需要清洗规整:我们按正则删页眉页脚、合并断词、丢弃无法编码的孤立字符,并过滤近乎空白的短页。其二是纯扫描版:2人工智能平台产品实现基础、3人工智能平台需求分析、4_2人工智能平台设计开发、5人工智能平台测试验证、6人工智能平台产品交付、7人工智能平台产品运维共 6 份 PDF 没有任何文本层,每一页本质上是一张位图,纯文本管线在这 6 份文件上直接断流,抽不出一个字。其三是图文混排:数学导数与梯度公式、CNN 卷积示意图、K8s 架构图、终端截图——即使有文本层,考点本身也是长在图上的,正文文字里并没有完整陈述。
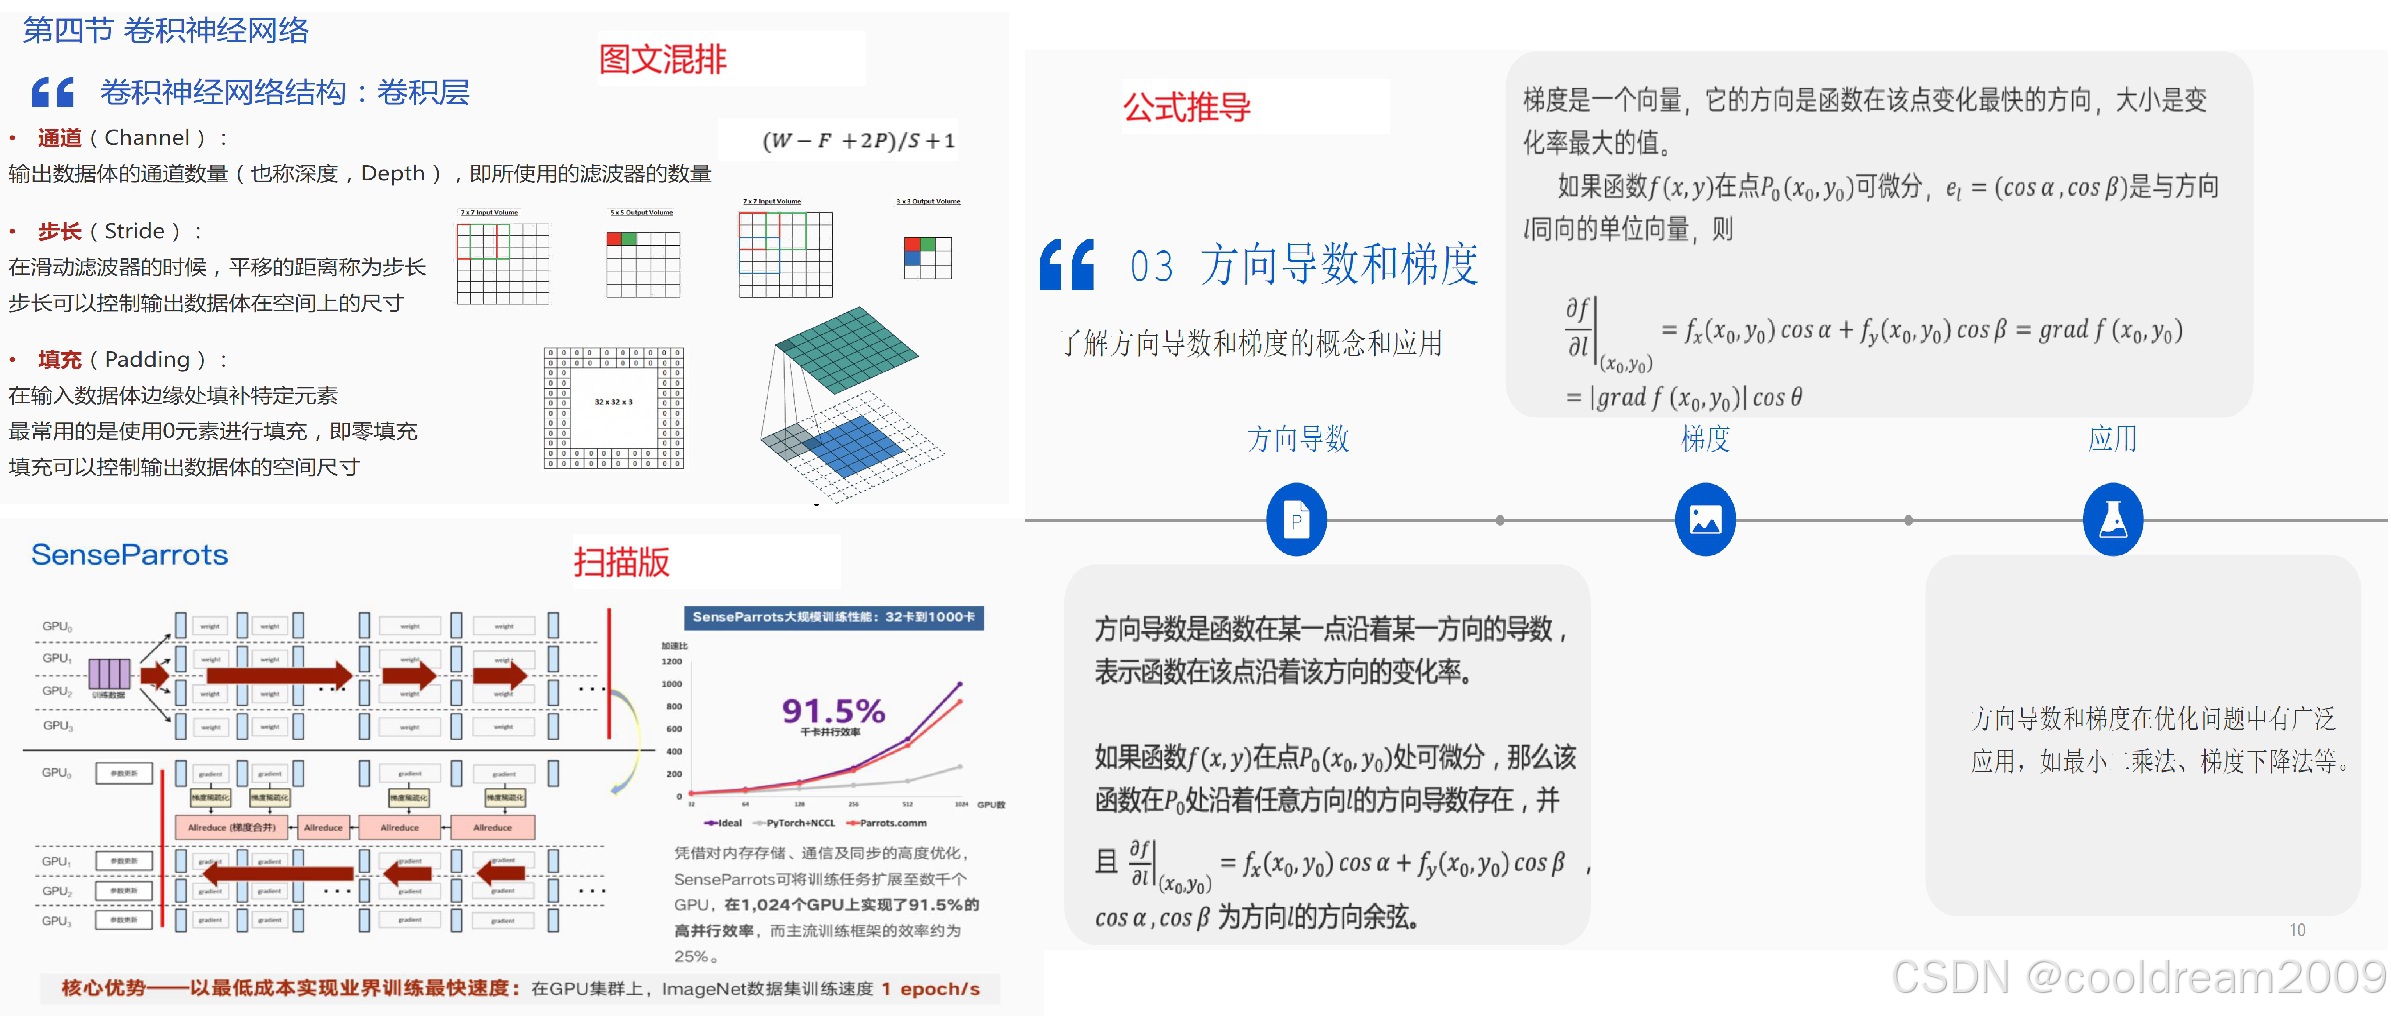
真正入库的两道题很能说明其三类形态。"方向导数和梯度在下列哪类问题中有广泛应用?"答案是优化问题(梯度下降、二乘误差极小化都属此类),考点出自数学基础讲义的公式页;"卷积输出数据体的通道数量(深度)取决于?"答案是滤波器(卷积核)的数量,而步长和填充控制的是空间尺寸——这个区别正是看 CNN 结构示意图才能分清的细节。
4 Seed-2.1-pro-0915:为 Agent 与 Coding 而生的多模态旗舰
4.1 为什么不用 OCR
面对扫描版,容易想到的路径是 OCR。我们评估后的结论是:OCR 解决不了这个场景。它的产物仍是"文字":正文能认,但公式会乱、表格会塌、示意图认出来也只是一堆无意义的图注。更关键的是,出题需要的从来不是"把图变成文字",而是理解这一页在讲什么知识、哪里是考点,然后把它重新组织成一道题干严谨、干扰项合理、答案可核对的合格题目。"识别"与"理解并重组"之间隔着整个出题过程——OCR 把打字的活省了,真正值钱的"读懂加出题"仍然全压在人身上。我们需要的不是一只更快的打字员,而是一位看得懂图、会出题、还会写代码的出题官。
4.2 Seed-2.1-pro-0915 介绍
火山方舟上有两种接入方式,这里按官方口径说清楚:Doubao-Seed-Evolving 是一条动态迭代的模型线路,统一 Model ID、每周至少发布一个版本更新,调用方不改代码就能拿到当时新的模型能力,适合希望始终用到新能力的场景;技术团队会把其中表现稳定的版本固化为日期版本,Seed-2.1-pro-0915 就是 9 月 15 日固化的版本,适合需要版本稳定、不想因模型频繁更新而反复微调适配的场景;当前两者能力表现一致。对我们这种内容生产场景这很实际——建设期批量出题锁定 0915,保证同一批次口径可复现、可审核;后续运营期增补再切 Evolving 线路享受滚动增强。本文按发布口径统一称 Seed-2.1-pro-0915。
Seed-2.1-pro-0915 是面向 Agent、Coding、多模态理解打造的 Seed 系列旗舰模型,围绕代码生成、工具调用、视觉理解、任务规划与长程执行等核心任务持续升级——这五项能力几乎就是为"出题官"角色量身定的:视觉理解负责看懂扫描页、公式与架构图;任务规划负责按 11 个知识域拆解出题任务、控制配额;代码生成负责把题目写成可执行的题数组脚本;工具调用负责串联文本抽取、位图导出、校验与构建脚本;长程执行保证它在几十个文件、数百道题的批次中保持口径一致。它不是一个只会聊天的通用模型,而是一颗能自己跑完一条工作流的"Agent 大脑"。
官方公布的评测可以佐证这次选型。多模态数学视觉推理榜单 MathVision 得分 92.6(启用工具后 94.5),这类"看着公式和图形做推理"的能力,正好对应讲义里大量的公式页与示意图;Coding 方向上,ProgramBench(从零构建系统级工程)50.3 分、NL2Repo-Bench(自然语言需求到仓库级多文件改动)47.0 分;在真实仓库工程任务的开发者众测中,Seed 2.1 Pro 相比 Claude Opus 4.6 获得 59.1% 的胜率——它产出的不是代码片段,而是能端到端交付、能自我验证的工程结果,这与我们"模型写题脚本、脚本被构建执行、代码答案被沙箱验证"的用法完全同构(以上数据均来自官方发布材料,见文末参考资料)。
4.3 在本项目里它承担什么
把整页位图直接交给模型,它看图、理解、总结、出题一气呵成:数学公式在表达什么、卷积示意图里的张量维度如何变化、终端截图里的输出说明了什么,都能进入题面与解析。配套的离线抽取脚本(scripts/theory/extract_pdfs.py)做了务实的双通道分流:文字版 PDF 走 pypdf 抽文本并清洗页眉页脚、合并断词;整页清洗后不足 20 字、判定抽不出文本的扫描版,则直接从 PDF 的 XObject 里取出内嵌整页位图,长边超过 1600 像素的等比压缩、存成质量 72 的 JPEG(如 p001.jpg),作为多模态输入,单页失败不阻断整卷。这个设计有个值得一提的细节:图片通道的产物在起初版本里就标注了"供多模态阅读",也就是说管线早就为"换一个能看图的大脑"预留了接口,Seed-2.1-pro-0915 补上的正是这个大脑。
5 多模态出题工作流:这是 Agent,也是 Coding
5.1 流水线全貌
5.2 为什么说它是 Agent 工作流,而不是"调一次接口"
因为整个过程具备一个 Agent 的关键特征。它有规划:41 份 PDF 先自动归入 11 个知识域,再按各域、各题型的配额拆成子任务,避免模型在好出题的章节扎堆、冷门章节烂尾。它有工具:读文本、读整页位图、跑抽取脚本与构建闸门,每一步都是确定性的程序在配合。它有自检:产出先过统一校验闸门,不合规就带着错误信息回炉重出。它也有人在回路:模型出草案,系统导出一份与后台导入模板同构的复核 Excel,讲师只复核差异、确认页码出处,改完直接导回上架,而不是从零写题。模型负责理解与生成这一段高度耗人的认知劳动,人退到审校和拍板的位置。
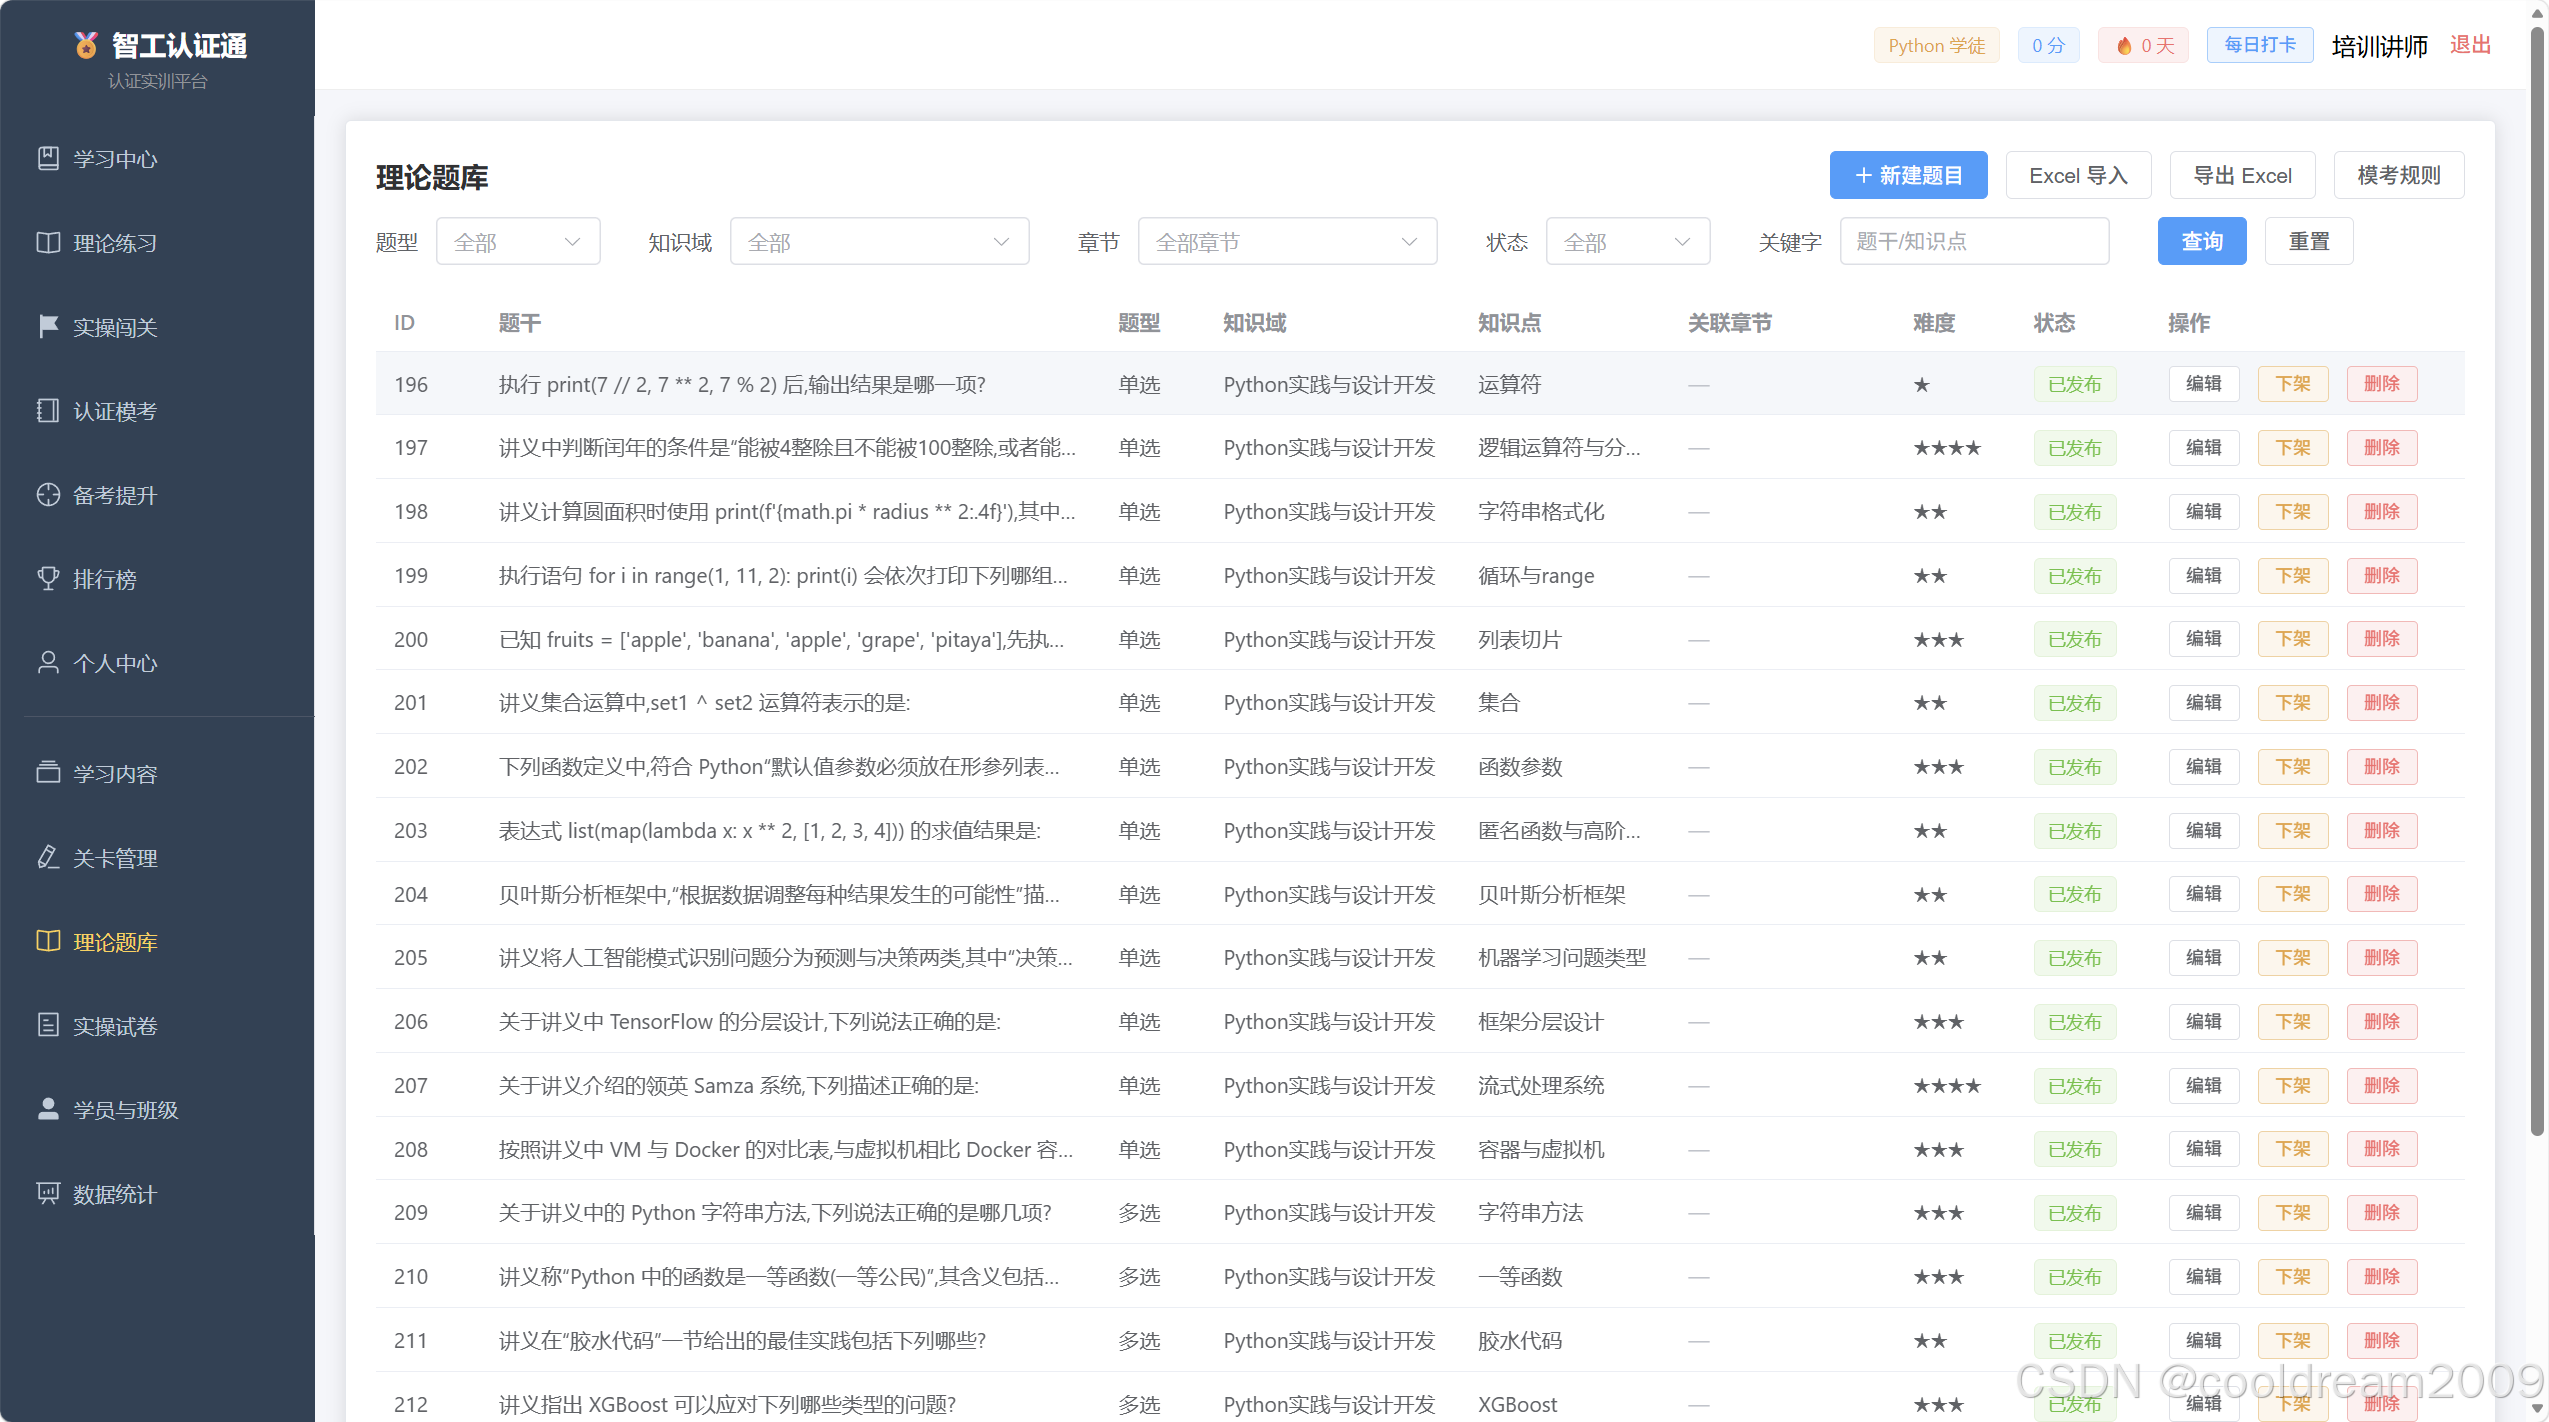
5.3 为什么它也是多模态 Coding
模型的交付物不是一段聊天文本,而是能直接进构建管线被执行的 Python 脚本:按知识域组织(如深度学习域是 gen_05.py,单文件 45 题),脚本末尾带着一组硬性自检断言;官方结业 Excel 独占测试验证域,走另一条导入通道,不经过出题脚本。每道题是一个结构化字段齐全的字典,F1 到 F13 是各讲义文件名的常量:
F8 = "1-5-8深度学习4-1.pdf"   # F1~F13 为深度学习域 13 份讲义的文件名常量

def add(stem, qtype, options, answer, analysis, kp, diff, pdf, page):
    questions.append({
        "stem": stem, "qtype": qtype, "options": options, "answer": answer,
        "analysis": analysis, "domain": "深度学习", "knowledge_point": kp,
        "difficulty": diff, "status": "published",
        "source_pdf": pdf, "source_page": page,   # 页码溯源
    })

add("卷积输出数据体的通道数量(深度)取决于?",
    "single",
    ["输入图片的像素总数", "所使用的滤波器(卷积核)的数量",
     "滑动步长的大小", "零填充的圈数"],
    ["B"],
    "讲义定义通道(深度)即输出数据体的通道数量,也就是所使用的滤波器数量;"
    "步长和填充控制的是空间尺寸。",
    "卷积层", 2, F8, 8)

# 脚本末尾的自检(节选):题型计数、判断题正误比例、13 份来源每份至少 2 题、
# 页码落在该 PDF 真实页数区间、题干归一化后无重复——任一断言失败,脚本直接报错退出。
这些脚本在构建期被真实执行、校验、去重,收尾产出题库种子文件随应用一起发布。模型写的不是"像代码的文本",而是被构建过程真实运行、出了错会直接挂掉的工件——这正是多模态理解与 Coding 能力的合流:眼睛看着图,手里交付的是代码。
6 三道闸门:让"模型出的题"敢给考生用
让非确定性的模型产出面向认证考生的内容,信任不能建立在"模型这次表现不错"上。我们用三道确定性工程闸门兜底。
闸门一:Prompt 即数据契约。 出题要求被约束成固定 schema:题干 stem、题型 qtype(single/multiple/judge)、选项 options、答案 answer(字母数组)、解析 analysis、知识域、知识点、难度(1 到 5)、来源 PDF 与页码。下面是出题提示词的脱敏简化版(真实版本还带有分域配额与 few-shot 样例):
你是人工智能工程技术人员认证培训的命题专家。下面给你讲义的整页位图(或清洗后的文本),请据此出题:
1. 只考查本页明确讲到的知识,不得发明讲义没有的说法;
2. 每题 4 个选项:单选题恰好 1 个正确项,多选题至少 2 个正确项;
3. 干扰项必须来自同一知识域,禁止跨域凑数;
4. 判断题干为完整陈述句,答案只取 A(正确)/ B(错误);
5. 解析必须说明判定依据,并给出来源文件名与页码;
6. 严格输出 JSON 数组,字段为 stem/qtype/options/answer/analysis/
   knowledge_point/difficulty(1-5)/source_pdf/source_page,不要输出 JSON 以外的内容。
模型从起步就被限定在"生产合规数据"而不是"自由发挥"的轨道上。
闸门二:确定性校验加哈希去重。 所有题目无论来自 AI 生成还是 Excel 导入,都过同一个 validate_question:题型是否合法、知识域是否 11 选 1、答案字母是否越界(单选恰好 1 项、多选至少 2 项、判断题只接受 A/B)、选项数量(2 到 8 个)、题干/选项/解析的长度上限,逐条收集错误。构建期还有更严的一层:入银行题目状态必须为 published、来源文件必填、题目所属域必须与文件名前缀一致(防止域标错)、页码必须落在该 PDF 的真实页数区间内(页数由 pypdf 现场读取)、解析必填;题干再做归一化哈希,跨讲义、跨批次的重复题在构建期拦截;末了按域、按题型核对配额,任何一项不过,整批不写出文件。坏题直接拒绝入库,而不是带病上线。原则一句话:模型负责创造,代码负责正确。
闸门三:来源分级与页码溯源。 317 道题按来源分三类标注:232 道由 PDF 讲义生成的题,每题带 source_pdf 加 source_page,解析里写明"《xxx》第 N 页指出……“;60 道官方结业 Excel 题标注原表(Excel 没有解析列,解析由模型对照测试验证讲义逐题补写);25 道人工自编的通用题标注"自编”。考生怀疑答案、讲师复核题目,都点得开原始出处。对一个认证备考产品来说,没有出处的 AI 题是不敢用的;溯源把"信不信任模型"这个无法回答的问题,转化成了"花十秒核对一页讲义"这个可操作的动作。
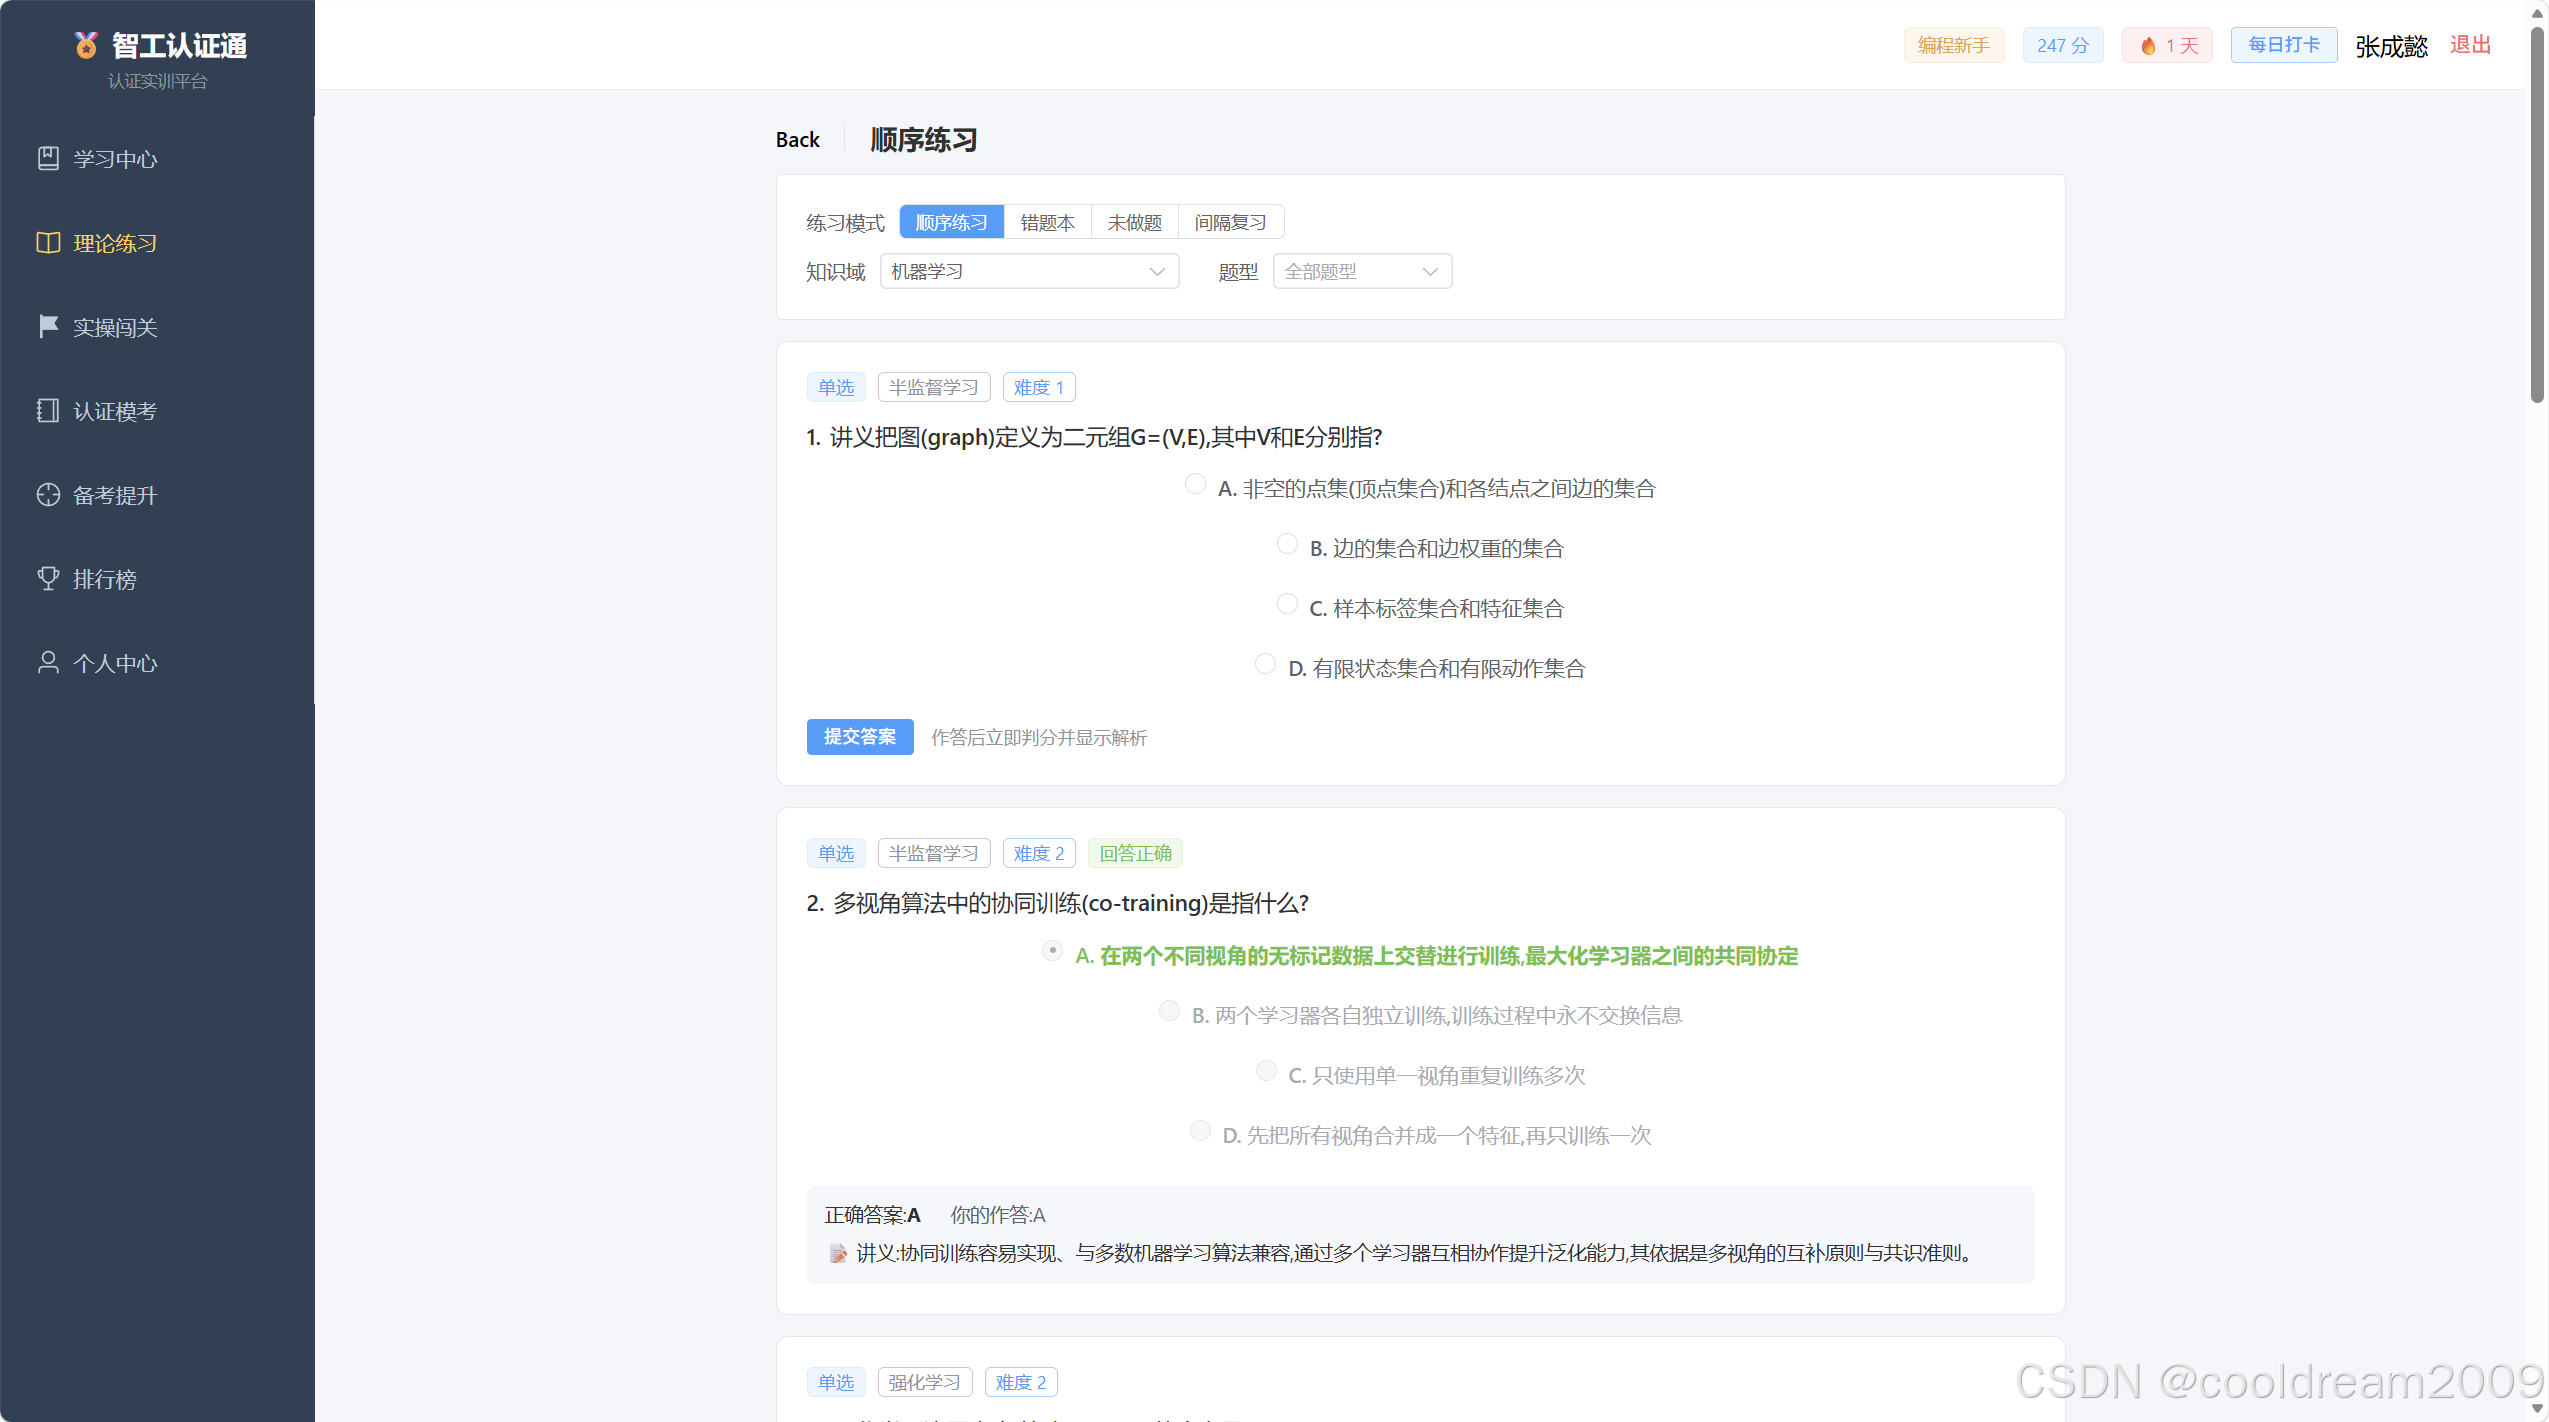
7 实操侧:Coding 能力的双重体现
理论题考"看懂",实操关考"写得出",而后者正是这个认证卡人很紧的环节。多模态与 Coding 在实操侧有两层含义。
一方面是模型的 Coding。讲义里大量知识以代码截图、终端输出、流程图的形式存在,模型理解这些图像后,产出的不只是题干,还包括带占位符的代码模板(___1___ 形式的填空位)、参考答案、多答案短语、三级分级提示,以及 stdin 与期望输出测试用例。下面是 NumPy 章节"创建数组"一关的真实种子结构(精简):
{
  "title": "创建数组",
  "template":
      "import numpy as np\n"
      "# 把 Python 列表转成 ndarray,并指定为浮点类型\n"
      "scores = np.___1___([85, 92, 78, 90, 88], dtype=___2___)\n"
      "print(scores)\nprint(scores.dtype)\nprint(scores.shape)\n",
  "blanks": [
      {"no": 1, "answers": ["array"],
       "hints": ["把列表转成 ndarray 的构造函数", "数组(英文)", "np.array([...])"]},
      {"no": 2, "answers": ["float", "np.float64", "'float64'"],
       "hints": ["Python 内置浮点类型即可", "float(或 np.float64)", "dtype=float"]},
  ],
  "cases": [
      {"type": "stdout", "hidden": False,
       "expected": "[85. 92. 78. 90. 88.]\nfloat64\n(5,)"},
      {"type": "assert", "hidden": True,
       "script": "assert scores.dtype == np.float64\nassert scores.shape == (5,)"},
  ],
}
NumPy、pandas、matplotlib、sklearn 这类"看代码说结果"的关卡尤其依赖这种从截图到可运行代码的转化——学员读到的题面是干净的,但它的源头可能是讲义上一张模糊的代码截屏。
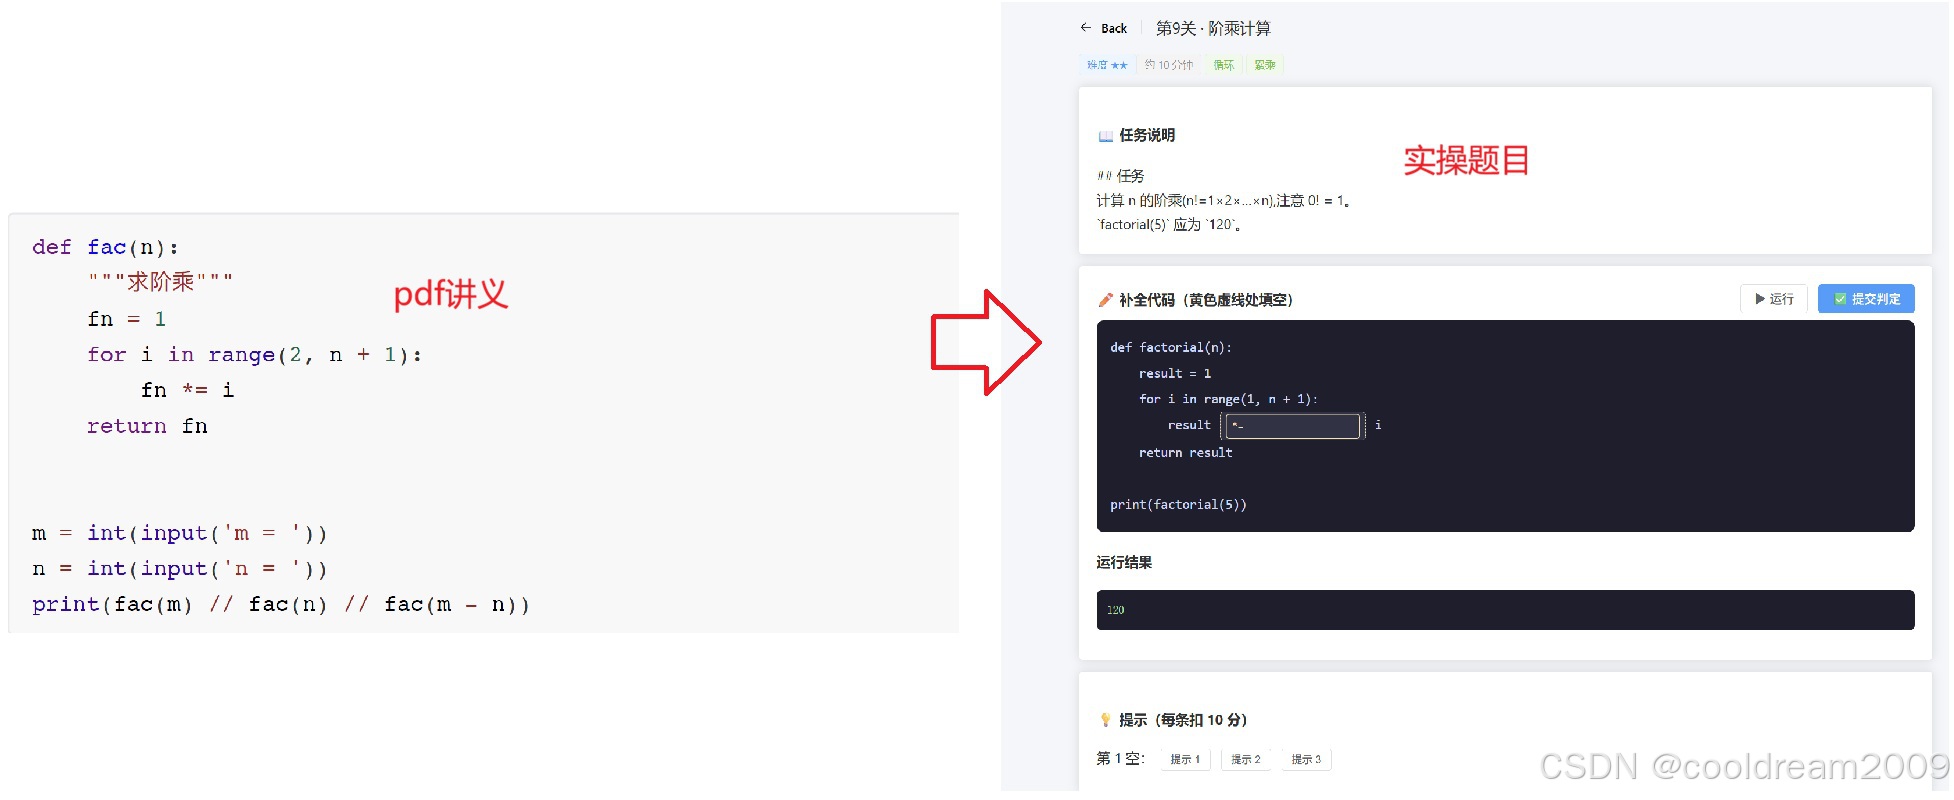
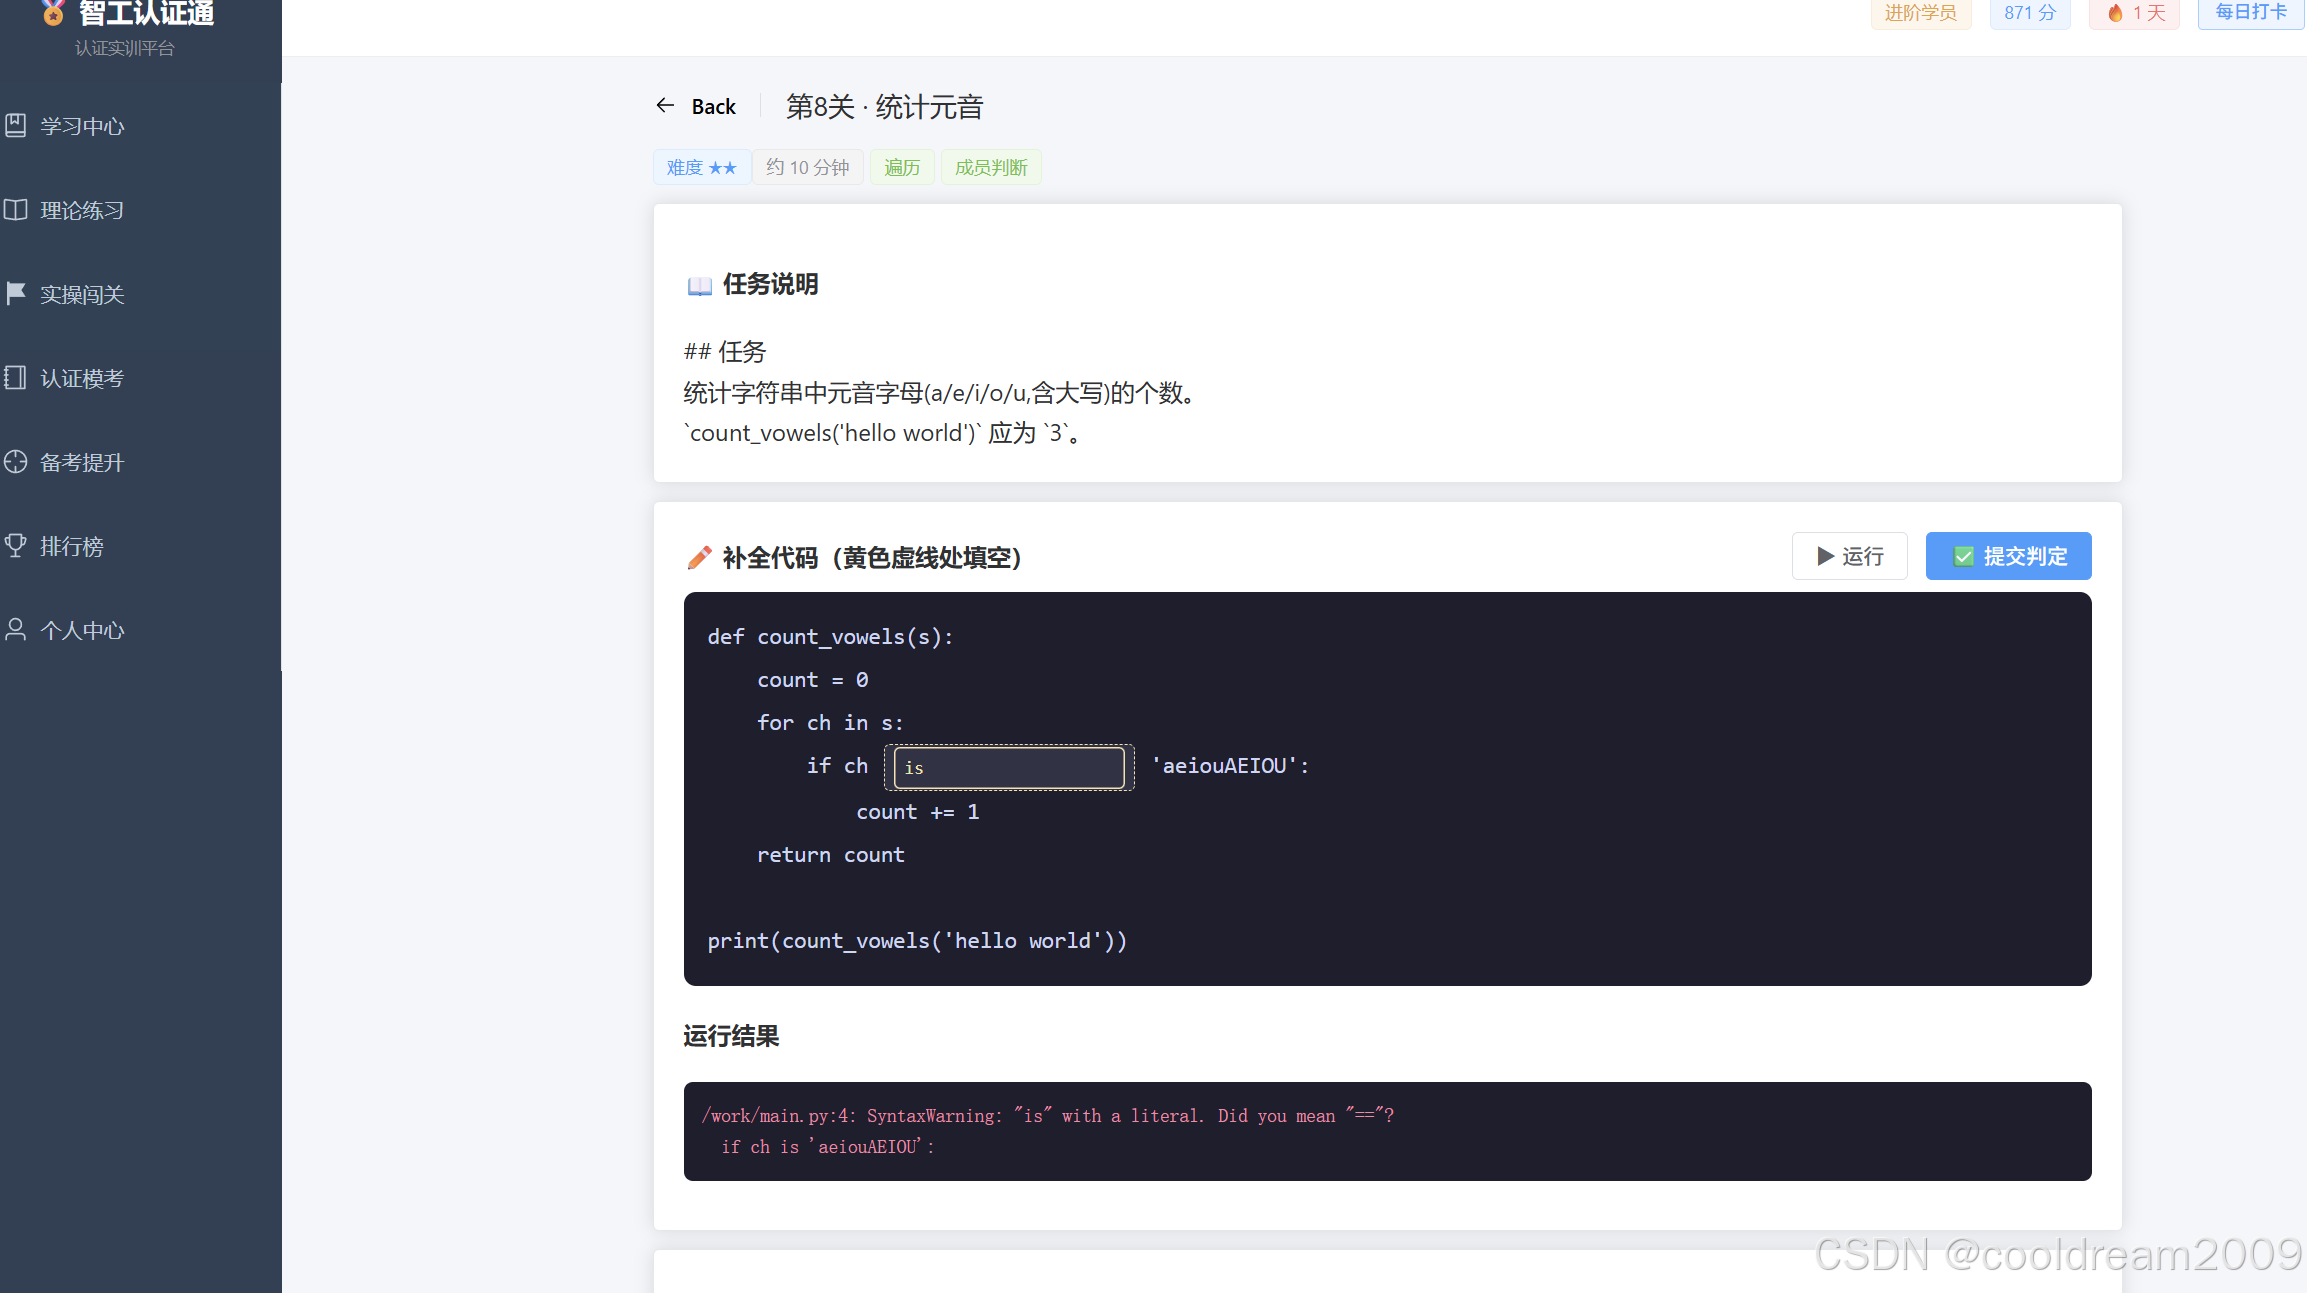
另一方面是平台的 Coding 工程。136 个关卡加上实操认证仿真考试,让学员写的每一行代码都在真实环境里被执行、被判分。这里有一个关键的可信度设计:模型生成的参考答案,必须先在 Docker 沙箱里自跑通过,才允许入库;如果参考答案连自己的测试用例都过不了,这道题直接回炉。学员侧同样在一次性容器里动态判分,标准输出比对、断言用例、隐藏用例三层判定。模型产出是被真实执行环境验证的,而不是"自信地"给出一个跑不通的答案。
沙箱部分还有一个真实教训值得分享。判题 Worker 挂载了宿主机的 docker.sock 来创建判题容器,初版超时清理差点用上 docker container prune——一旦执行,会把宿主机上所有停止的容器一并删掉(远不止判题容器),而且它并不能停掉仍在运行的超时容器。收尾方案是给每个沙箱容器起互不重复的名字(zg-sandbox-<uuid>)、容器带 --rm,超时只 docker kill 这一个具名容器,kill 后自动回收,并在代码注释里明确刻下"严禁 prune"及原因。还要如实说明边界:挂载 docker.sock 本身等价于把宿主机 root 交给容器,当前方案只适用于内网实训这类受控环境;上公有云生产时,应换成 socket 代理(限制可执行的 Docker API)、独立判题机或 DinD(Docker in Docker)隔离。多模态模型能写代码,但"代码在什么权限下运行、出错会不会炸毁宿主",这种工程上的敬畏心只能来自人。
8 能力验证:已经落地的结果
我们没有必要再单独设计一场模型对比实验——已经跑通并上线的题库本身,就是直接的验证。
一条分界性的证据是扫描件:6 份没有任何文本层的扫描版 PDF 中,5 份(产品实现基础、需求分析、设计开发、产品交付、产品运维)由整页位图直读管线共产出 76 道带页码的题,过去必须由人逐页看图录入的输入,现在管线可以无人值守地处理,产物结构与文字版题目完全一致;第 6 份扫描件(测试验证)经评估后没有重复造题——该域直接采用 60 道官方结业 Excel 题,解析由模型对照讲义补写,官方题的权威性比 AI 新出题更可靠。与此同时,公式与示意图考点成功成题:导数性质、梯度在优化中的应用、CNN 通道数与卷积核数量的对应关系,这些题的考点来自页面中的公式和结构图,而不是正文文字。
规模化层面,317 道题全部通过统一字段校验、经去重后入库,按 11 个知识域配额均衡覆盖,没有烂尾章节。题库的来源账算得很清楚:
| 来源 | 题数 | 说明 |
|---|---|---|
| PDF 讲义生成(文字版) | 156 | 35 份文字版讲义中 34 份出题,逐题带页码 |
| PDF 讲义生成(扫描版) | 76 | 5 份扫描件整页位图直读产出,逐题带页码 |
| 官方结业题 Excel | 60 | 全部归入测试验证域,解析由模型补写 |
| 人工自编通用题 | 25 | 替换初版中 8 道过时的文件/法规题,标注"自编" |
| 合计 | 317 | 单选 163 / 多选 51 / 判断 103 |
11 个知识域的实际分布为:伦理与政策 9、基础(软工/数据/数学)44、计算平台 9、机器学习 60、深度学习 46、产品实现基础 16、需求分析 28、Python 实践与设计开发 25、测试验证 60、产品交付 11、产品运维 9。构建闸门在题库从初版 300 题迭代到 317 题的过程中持续兜底:任何字段缺失、页码越界、域标错、配额不符都会让整批构建失败。
能力提升实在的体感,从来不是某一道题多惊艳,而是这样一句话:"扫描件加图表"这种以前只能靠人工的输入,现在整条管线自动跑通,并且每一份产物都可核验、可追溯。
9 对真实考级认证的价值
回到开篇的缺口,这套东西对三方都成立。
对考生而言,练习范围对照官方讲义的 11 个知识域全覆盖,解析带出处能自查;模考限时还原考试节奏;实操无需配置任何本地环境,打开浏览器就能写代码、被真实判分,练的就是考的。学完之后,仪表盘还会告诉你距离通过还差哪些知识点,而不是让你在 317 道题里盲目打转。
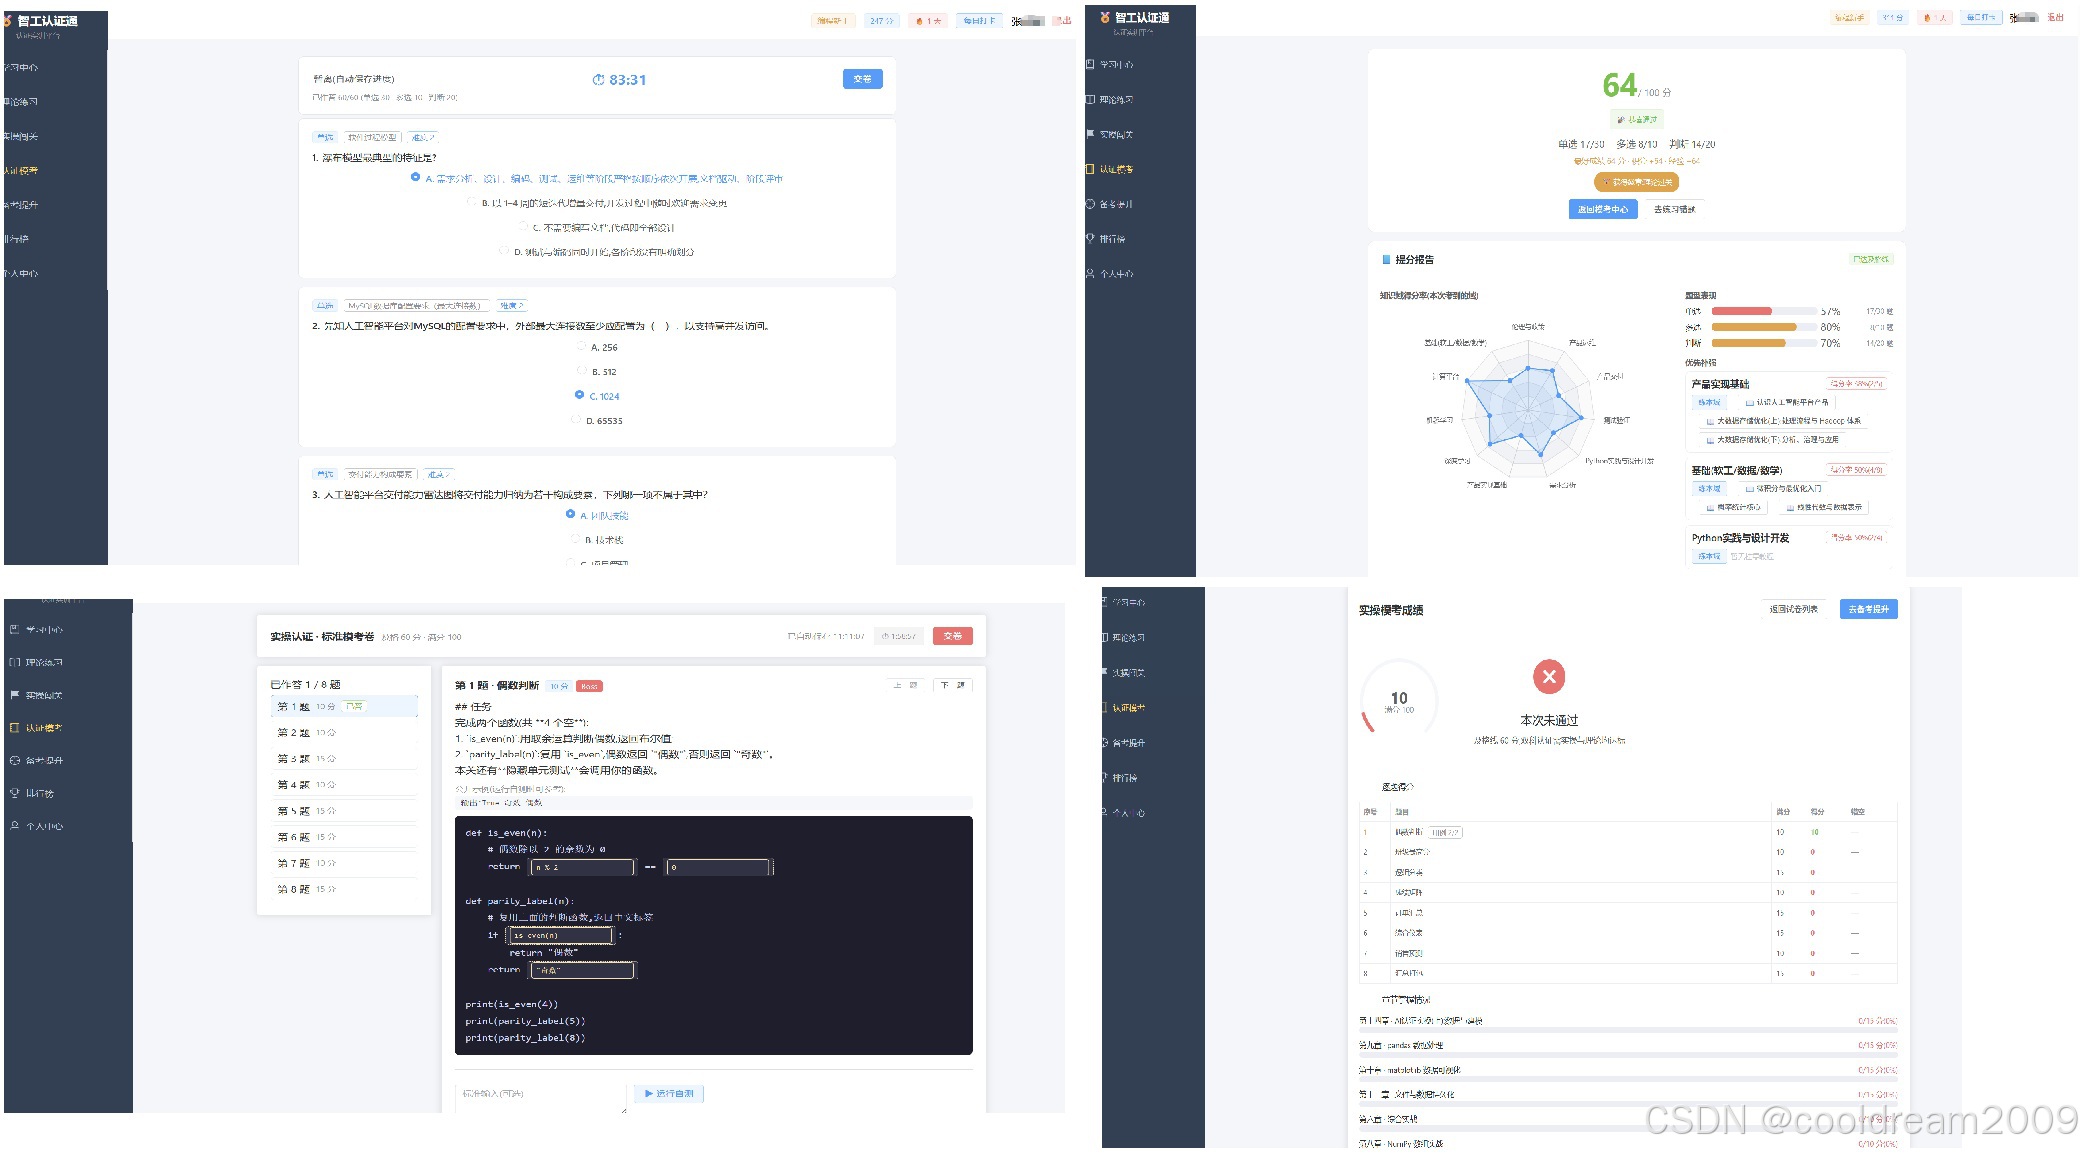
对讲师和培训机构而言,角色从"攒题的人"变成"审校的人":AI 出草案,人审 diff 和出处;讲义更新后,题库可以沿同一管线快速增补。班级、排期解锁、学员导入、数据看板则让教学过程可组织、可观测——谁卡在哪一关、哪个知识域正确率低,看板上一目了然。
对认证本身而言,题目有校验闸门和来源溯源背书,实操有真实运行判分,训练的是写代码的能力而不是背答案的能力——这更接近"能力认证"的初衷,而不是又一个"背题班"。
10 复盘与后续
走完一遍,沉淀下来四条方法论。
- Prompt 即数据契约——先定 schema,再谈生成,模型从起步就在生产合规数据;
- 模型的非确定性,用确定性代码兜底——校验、去重、沙箱执行,三道闸门缺一不可;
- 无溯源,不入库——可核对是内容类 AI 应用建立信任的前提;
- 人在回路——AI 出草案,人做收尾审校,权责始终清楚。
也如实说明当前边界:题库生产是离线 AI 辅助工作流(分域生成脚本加构建闸门),批量铺题不依赖在线密钥,题目固化为种子数据随应用发布,应用运行和判题不调用模型;后端已预留在线出题能力(ai_question_service.py,默认关闭):经环境变量配置 OpenAI 兼容服务(/chat/completions、response_format 约束 JSON),生成的题目仍走同一套 validate_question 校验、以 draft 状态入库待审,后续版本会支持讲师在管理端"选页即时生成、审核台上架",让出题能力从建设期工具变为运营期能力。
多模态的价值,不是"又能多读一种文件格式",而是让 Agent 能进入那些知识由图像承载的真实办公场景:扫描合同、架构图、白板照片、课件截图。Seed-2.1-pro-0915 这一代模型把"看懂"的水位抬了上来,而当强大的视觉理解被一套工程闸门稳稳接住,它就从一个惊艳的 demo,变成了能服务真实认证、对考生分数负责的生产力。
这正是我们走完这一遍后特别想分享的事。
参考资料
1 Seed-Evolving 模型介绍 —— 火山方舟·火山引擎文档
2 模型发布公告(doubao-seed-evolving 动态迭代机制、日期版本说明)—— 火山方舟文档
3 Seed 2.1 官方模型页(MathVision、ProgramBench、NL2Repo-Bench 等评测数据)—— 字节跳动 Seed
4 Seed2.1 Officially Released: Advancing AI Productivity(含开发者众测 59.1% 胜率)—— 字节跳动 Seed 团队
5 豆包 2.1 Pro 模型发布,Coding 与 Agent 能力跨越"质变点"—— 新华网
文中引用的模型评测数据(MathVision、ProgramBench、NL2Repo-Bench、开发者众测胜率等)均来自上述官方发布材料;题库与平台数据(42 份资料、6 份扫描版、5 份扫描版出题 76 道、317 题、136 关、190 余测试用例)均为本项目真实统计,可由
backend/app/data/theory_questions.json与种子脚本复核。
更多推荐

 3
 0
- 0


 已为社区贡献20条内容

所有评论(0)