
【深度学习】分布式训练基础_数据并行与模型并行
文章目录
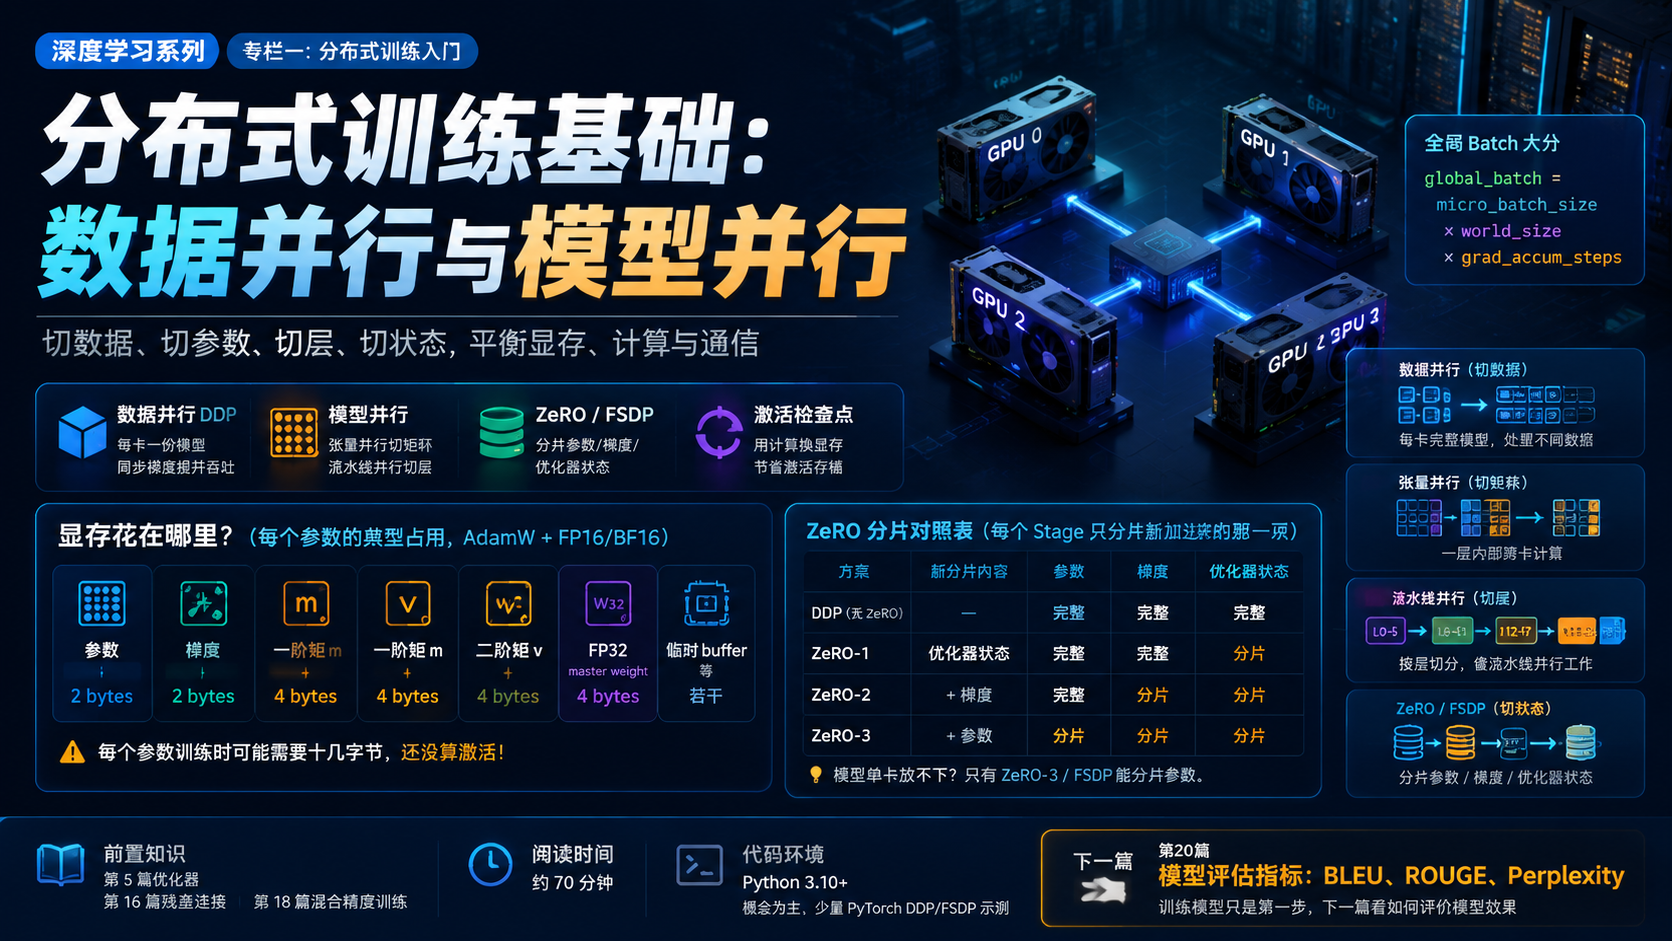
摘要:大模型训练不是把代码从一张 GPU 搬到多张 GPU 那么简单。单卡放不下参数、激活、梯度和优化器状态时,需要分布式训练;单卡算得太慢时,也需要多卡提升吞吐。数据并行让每张卡保存一份模型、处理不同 batch,再同步梯度;模型并行把模型本身切开,包括张量并行、流水线并行;ZeRO/FSDP 则进一步把优化器状态、梯度甚至参数分片。本文从“显存到底花在哪里”讲起,用直觉、表格和伪代码解释 DDP、All-Reduce、Tensor Parallel、Pipeline Parallel、ZeRO、FSDP,以及工程选型时该先考虑什么。
前置知识:优化器,残差连接,混合精度训练
阅读时间:约 70 分钟
代码环境:Python 3.10+,概念为主,少量 PyTorch DDP/FSDP 风格示例
入门导读:先抓住主线
分布式训练要解决两个问题:
- 放不下:模型参数、梯度、优化器状态、激活值超过单卡显存;
- 算太慢:单卡训练吞吐太低,训练周期不可接受。
对应策略可以粗略分成三类:
| 策略 | 核心思想 | 主要解决 |
|---|---|---|
| 数据并行 DDP | 每张卡一份模型,处理不同数据,同步梯度 | 提高吞吐 |
| 模型并行 | 把模型切到多张卡上 | 单卡放不下模型 |
| ZeRO/FSDP | 分片优化器状态、梯度、参数 | 降低冗余显存 |
真实大模型训练通常会组合使用:
数据并行 + 张量并行 + 流水线并行 + ZeRO/FSDP + 混合精度
初学时不要被术语吓到。先理解:到底切的是数据、参数、层,还是优化器状态。
读完先达到这个程度就够了:
- 能解释单卡训练显存由哪些部分组成;
- 能理解 DDP 为什么需要 All-Reduce;
- 能区分数据并行、张量并行、流水线并行;
- 能说明 ZeRO stage 1/2/3 分别切什么;
- 能理解 FSDP 和 ZeRO 的关系;
- 能根据模型大小和集群规模做基本并行策略判断。
带着这 3 个问题读:
- 为什么数据并行不能解决“模型单卡放不下”的问题?
- All-Reduce 同步梯度为什么会成为瓶颈?
- ZeRO/FSDP 为什么能显著降低显存冗余?
一、单卡训练显存花在哪里
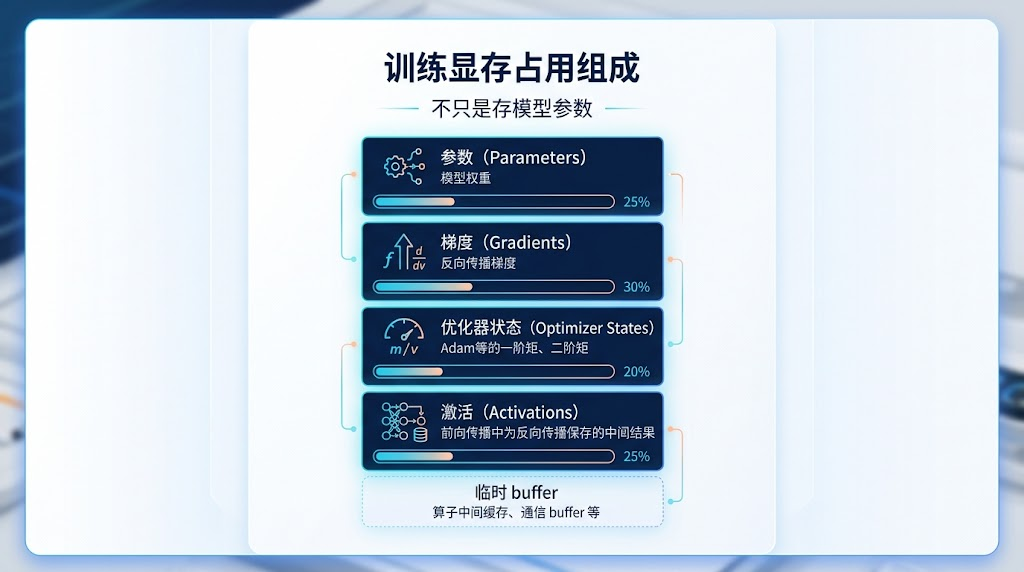
训练时,显存不只是存模型参数。
主要包括:
| 部分 | 含义 |
|---|---|
| 参数 Parameters | 模型权重 |
| 梯度 Gradients | 反向传播得到的参数梯度 |
| 优化器状态 Optimizer States | Adam 的一阶矩、二阶矩等 |
| 激活 Activations | 前向传播中为反向传播保存的中间结果 |
| 临时 buffer | 算子中间缓存、通信 buffer 等 |
 |
以 AdamW 为例,如果参数用 FP16/BF16,但优化器状态用 FP32,那么每个参数可能对应:
参数:2 bytes
梯度:2 bytes
一阶矩 m:4 bytes
二阶矩 v:4 bytes
可能还有 FP32 master weight:4 bytes
粗略算下来,每个参数训练时可能需要十几字节,而不是 2 字节。
用一个简单计算器:
def training_memory_gb(params_billion, bytes_per_param):
    return params_billion * 1e9 * bytes_per_param / (1024 ** 3)

for bpp in [2, 8, 12, 16]:
    print(f"bytes/param={bpp:>2}, 7B training memory≈{training_memory_gb(7, bpp):.1f} GB")
这还没算激活值。长序列、大 batch、深层模型会让激活显存也很大。
所以大模型训练经常单卡放不下。
二、数据并行:每张卡一份模型,处理不同数据
数据并行是最直观的多卡训练方式。
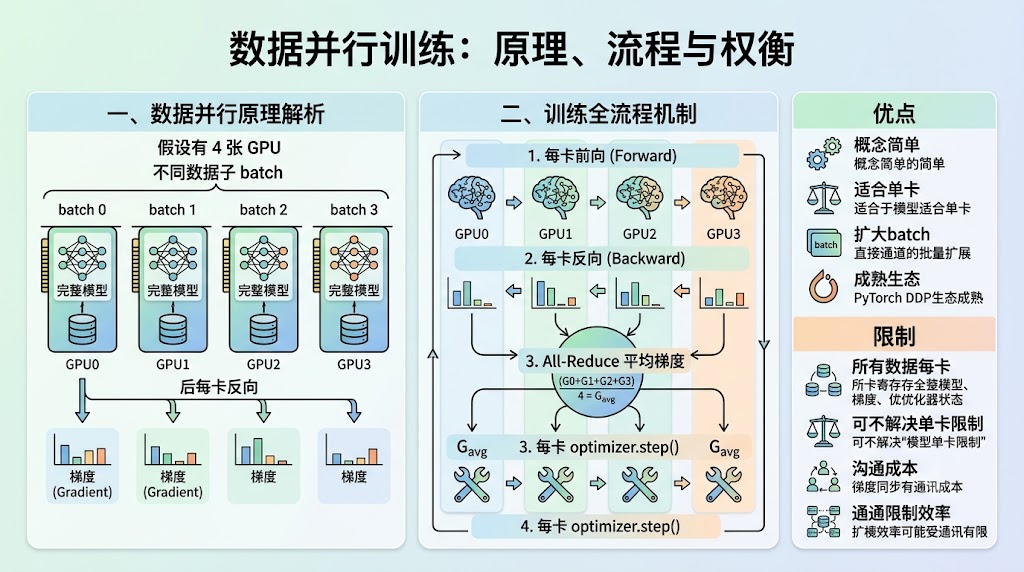
假设有 4 张 GPU:
GPU0: 完整模型 + batch 0
GPU1: 完整模型 + batch 1
GPU2: 完整模型 + batch 2
GPU3: 完整模型 + batch 3
每张卡都有一份完整模型,处理不同数据子 batch。反向传播后,每张卡得到自己的梯度。为了让模型保持一致,需要把梯度求平均,然后每张卡用同样的平均梯度更新参数。
流程:
每卡前向
每卡反向
All-Reduce 平均梯度
每卡 optimizer.step()
数据并行的优点:
- 概念简单;
- 适合模型能放进单卡的情况;
- 扩展 batch 和吞吐比较直接;
- PyTorch DDP 生态成熟。
它的限制也明显:
- 每张卡都保存完整模型、梯度和优化器状态;
- 不能解决“模型本身单卡放不下”;
- 梯度同步有通信成本;
- GPU 数变多后,通信可能限制扩展效率。
三、DDP:PyTorch 常用数据并行
PyTorch 的 DistributedDataParallel,简称 DDP,是常见数据并行实现。
真实运行通常用 torchrun 启动多进程,每张 GPU 一个进程。
概念代码如下:
# train.py,概念示例,真实运行需要 torchrun
import os
import torch
import torch.distributed as dist
import torch.nn as nn
from torch.nn.parallel import DistributedDataParallel as DDP


def setup():
    dist.init_process_group(backend="nccl")
    local_rank = int(os.environ["LOCAL_RANK"])
    torch.cuda.set_device(local_rank)
    return local_rank

local_rank = setup()
model = nn.Linear(128, 10).cuda(local_rank)
model = DDP(model, device_ids=[local_rank])

optimizer = torch.optim.AdamW(model.parameters(), lr=3e-4)
criterion = nn.CrossEntropyLoss()

x = torch.randn(32, 128, device=local_rank)
y = torch.randint(0, 10, (32,), device=local_rank)

loss = criterion(model(x), y)
loss.backward()  # DDP 会在反向传播中同步梯度
optimizer.step()
optimizer.zero_grad(set_to_none=True)
启动方式类似:
torchrun --nproc_per_node=4 train.py
DDP 的核心不是把一个 batch 自动拆开那么简单,而是多进程训练和梯度同步。
四、All-Reduce:同步梯度的核心
数据并行里,每张卡都有自己的梯度。为了保持模型一致,需要计算所有 GPU 梯度的平均值。
这就是 All-Reduce。
如果有 4 张卡,某个参数梯度分别是:
GPU0: g0
GPU1: g1
GPU2: g2
GPU3: g3
All-Reduce 后,每张卡都拿到:
(g0 + g1 + g2 + g3) / 4
简化代码:
import torch
import torch.distributed as dist

# grad 是当前进程上的梯度张量
dist.all_reduce(grad, op=dist.ReduceOp.SUM)
grad /= dist.get_world_size()
通信成本来自梯度张量很大。模型越大,需要同步的数据越多。
DDP 会做 bucket、通信计算重叠等优化:当部分层梯度算好后,就可以开始通信,不必等全部反向结束。
但通信永远不是免费的。多机训练时,网络带宽和延迟会成为关键瓶颈。
五、数据并行和 batch size 的关系
如果每张卡 batch size 是 micro_batch_size,GPU 数是 world_size,梯度累积步数是 grad_accum_steps,全局 batch 是:
global_batch = micro_batch_size × world_size × grad_accum_steps
代码:
def global_batch_size(micro_batch, world_size, grad_accum):
    return micro_batch * world_size * grad_accum

print(global_batch_size(micro_batch=4, world_size=8, grad_accum=16))
全局 batch 变大后,学习率和 warmup 可能也要调整。不是 GPU 数翻倍就一定无脑翻倍 batch。
数据并行扩展时,要同时关注:
- 单卡 batch 是否太小导致利用率低;
- 全局 batch 是否过大影响泛化或收敛;
- 梯度累积是否增加训练时间;
- 学习率是否需要重新调。
六、模型并行:模型本身切开
当模型单卡放不下时,数据并行不够,因为每张卡仍然需要一份完整模型。
模型并行的思路是:把模型切到多张卡上。
常见切法有两种:
| 类型 | 切什么 | 例子 |
|---|---|---|
| 张量并行 | 切一个矩阵或 attention head | 一层内部跨卡计算 |
| 流水线并行 | 按层切模型 | 前几层在 GPU0,后几层在 GPU1 |
它们解决的问题不同,也常组合使用。
七、张量并行:切矩阵
Transformer 里有大量线性层,本质是矩阵乘法。
例如:
Y = X W
如果 W 太大,可以把它按列或按行切到多张 GPU 上。
Column Parallel
把输出维度切开:
W = [W1, W2]
Y1 = X W1
Y2 = X W2
Y = concat(Y1, Y2)
Row Parallel
把输入维度切开:
X = [X1, X2]
W = [W1; W2]
Y = X1 W1 + X2 W2
张量并行的优点:
- 单层大矩阵可以分摊到多卡;
- 适合超大 Transformer;
- 常用于 attention 和 FFN。
缺点:
- 每层内部需要通信;
- 实现复杂;
- 对高速互联要求高;
- GPU 间负载和通信模式要精细设计。
Megatron-LM 等系统大量使用张量并行思想。
八、流水线并行:按层切模型
流水线并行把模型层分到不同 GPU。
例如 4 张卡训练 24 层 Transformer:
GPU0: layer 0-5
GPU1: layer 6-11
GPU2: layer 12-17
GPU3: layer 18-23
前向传播从 GPU0 到 GPU3,反向传播再从 GPU3 回到 GPU0。
如果一次只处理一个 batch,很多 GPU 会空等。为提高利用率,流水线并行会把 batch 切成多个 micro-batch,让不同 GPU 像工厂流水线一样同时工作。
直觉:
时刻 1: GPU0 处理 micro-batch 1
时刻 2: GPU0 处理 micro-batch 2,GPU1 处理 micro-batch 1
时刻 3: GPU0 处理 micro-batch 3,GPU1 处理 micro-batch 2,GPU2 处理 micro-batch 1
流水线并行的优点:
- 适合层数很多、单卡放不下的模型;
- 层级切分直观;
- 可以和张量并行、数据并行组合。
缺点:
- 有 pipeline bubble,GPU 可能空闲;
- micro-batch 调度复杂;
- 层间激活要跨卡传输;
- 切分不均会导致负载不平衡。
九、ZeRO:减少数据并行中的冗余
数据并行的问题是每张卡都保存完整模型、梯度和优化器状态,冗余很大。
ZeRO 的核心思想是:这些状态没必要每张卡都完整保存,可以分片。
ZeRO 常见分为三个阶段。关键要看清楚:每个 stage 只分片新加进来的那一项,前面 stage 已经分片的照旧,没被列出的东西仍然是每张卡各留一份完整的。
| Stage | 新分片内容 | 参数 | 梯度 | 优化器状态 |
|---|---|---|---|---|
| DDP(无 ZeRO) | — | 完整 | 完整 | 完整 |
| ZeRO-1 | 优化器状态 | 完整 | 完整(未分片) | 分片 |
| ZeRO-2 | + 梯度 | 完整 | 分片 | 分片 |
| ZeRO-3 | + 参数 | 分片 | 分片 | 分片 |
也就是说:ZeRO-1 只分片 Adam 的 m/v;梯度和参数每张卡仍然是完整的一份。如果模型本身大到单卡放不下参数,那 ZeRO-1/2 都救不了,只能上 ZeRO-3。
直觉上,假设 4 张 GPU:
普通 DDP:每张卡都有完整 optimizer states + 完整梯度 + 完整参数
ZeRO-1:每张卡只保存 1/4 optimizer states,梯度和参数仍然完整
ZeRO-2:梯度也切成 1/4,参数仍然完整
ZeRO-3:参数也切成 1/4,需要时再 all-gather
ZeRO-3 显存省得最多,但通信和实现复杂度也更高,因为前向/反向时需要按需收集参数。
DeepSpeed ZeRO 是这一方向的代表。
十、FSDP:PyTorch 生态的参数分片
FSDP 全称 Fully Sharded Data Parallel,是 PyTorch 生态里的全分片数据并行方案。
它和 ZeRO-3 思路相近:把参数、梯度、优化器状态分片到不同 GPU,需要计算某一层时再 all-gather 参数,计算完后释放完整参数。
概念流程:
平时:每张卡只保存参数 shard
前向到某层:all-gather 该层完整参数
计算完成:释放完整参数,只保留 shard
反向类似处理梯度
PyTorch 风格示例:
# 概念示例,真实使用需要分布式初始化
from torch.distributed.fsdp import FullyShardedDataParallel as FSDP

model = build_model()
model = FSDP(model)
真实 FSDP 配置会涉及:
- auto wrap policy:哪些模块作为 FSDP 单元;
- mixed precision:参数、梯度、buffer 用什么 dtype;
- activation checkpointing:是否重算激活省显存;
- CPU offload:是否把部分参数/优化器状态放到 CPU 内存;开启后能进一步压缩 GPU 峰值显存(能训更大模型),但代价是每次用到这些状态时都要走 PCIe 把数据搬回 GPU,GPU-CPU 通信量激增,训练步耗时通常会显著变长——只在"显存明显不够、但可以牺牲吞吐"时用;
- state dict 保存和加载策略。
FSDP 不是“包一下就完事”。大模型场景里,wrap 粒度和通信开销会显著影响性能。
十一、激活检查点:用计算换显存
除了参数、梯度和优化器状态,激活值也很吃显存。
反向传播需要用到前向中间结果。如果全部保存,显存压力很大。
Activation Checkpointing 的思路是:前向时不保存某些中间激活,反向时重新计算。
省显存:少存激活
代价:反向时多算一次前向
PyTorch 示例:
import torch
from torch.utils.checkpoint import checkpoint


def run_block(block, x):
    return checkpoint(block, x, use_reentrant=False)
大模型训练经常结合:
混合精度 + FSDP/ZeRO + activation checkpointing
因为只切参数还不够,长序列和大 batch 下激活也可能成为瓶颈。
十二、怎么选择并行策略
可以按问题类型判断。
模型能放进单卡,但训练太慢
优先考虑:
DDP 数据并行
模型每卡一份,扩大 GPU 数提升吞吐。
模型参数和优化器状态放不下
优先考虑:
ZeRO/FSDP
先减少数据并行中的状态冗余。
单层矩阵太大,单卡算不动或放不下
考虑:
张量并行
把 attention/FFN 的大矩阵切开。
层数很多,整个模型太深
考虑:
流水线并行
按层切到多张卡。
激活显存太大
考虑:
activation checkpointing
sequence parallel
减小 micro batch
真实超大模型常见组合:
数据并行维度:扩吞吐
张量并行维度:切层内矩阵
流水线并行维度:切层
ZeRO/FSDP:切状态
十三、通信成本不可忽略
分布式训练不是 GPU 越多越快。通信会吃掉扩展收益。
通信来源包括:
- DDP 梯度 All-Reduce;
- ZeRO/FSDP 参数 all-gather、reduce-scatter;
- 张量并行层内 all-reduce/all-gather;
- 流水线并行层间激活传输;
- checkpoint 保存和加载;
- 多机网络延迟。
如果计算时间是 100ms,通信时间是 80ms,加更多 GPU 可能收益有限。
工程上会关注:
- GPU 间是否有 NVLink;
- 多机是否有高速网络;
- 通信是否能和计算重叠;
- batch 是否足够大;
- 并行切分是否合理;
- 是否出现某张卡负载更重。
分布式训练的核心不是“让所有 GPU 都参与”,而是让计算、显存和通信达到平衡。
十四、常见误区
误区 1:数据并行可以解决所有显存问题。
不行。DDP 每张卡都有完整模型和优化器状态,模型单卡放不下时需要 ZeRO/FSDP 或模型并行。
误区 2:GPU 数翻倍,训练速度就翻倍。
通信、同步、数据加载、batch 配置都会影响扩展效率。
误区 3:ZeRO-3 一定最好。
ZeRO-3 最省显存,但通信和调度成本更高。小模型或卡数少时未必最快。
误区 4:流水线并行只是把层平均分一下。
还要考虑每层计算量、激活大小、micro-batch、bubble 和通信。
误区 5:FSDP 包一层就能高效训练大模型。
FSDP 的 wrap 粒度、mixed precision、checkpointing、state dict 策略都会影响效果。
误区 6:通信问题只在多机出现。
单机多卡也有通信成本,只是 NVLink/PCIe 条件不同。
十五、你应该记住的最小心智模型
分布式训练可以按“切什么”来记:
数据并行:切数据,每张卡完整模型
张量并行:切矩阵,一层内部跨卡
流水线并行:切层,模型深度跨卡
ZeRO/FSDP:切训练状态,减少冗余显存
Activation Checkpointing:切激活存储,用重算换显存
再按问题选策略:
算太慢 -> 数据并行
状态太大 -> ZeRO/FSDP
单层太大 -> 张量并行
层数太多 -> 流水线并行
激活太大 -> checkpointing
这个框架比记工具名字更重要。
总结
分布式训练的本质,是在显存、计算和通信之间做平衡。数据并行让多张卡处理不同数据,通过 All-Reduce 同步梯度,适合模型能放进单卡但需要提升吞吐的场景。模型并行把模型本身切开,张量并行切矩阵,流水线并行切层。ZeRO 和 FSDP 则减少数据并行中的冗余,把优化器状态、梯度和参数分片,从而降低显存压力。
真实大模型训练往往不会只用一种策略,而是组合混合精度、数据并行、张量并行、流水线并行、ZeRO/FSDP 和激活检查点。选择策略时,要先判断瓶颈是参数、优化器状态、激活、计算吞吐还是通信。
第一遍记住一句话:分布式训练不是简单多插几张卡,而是决定数据、参数、层、状态和激活分别怎么切。
大模型视角
后续你看大模型训练框架时,会反复看到 DDP、DeepSpeed ZeRO、FSDP、Megatron Tensor Parallel、Pipeline Parallel、activation checkpointing。这些都是为了让 Transformer 在更大参数、更长序列、更大数据上可训练。没有分布式训练,现代大模型的 Scaling Law 很难真正落地。
本篇作为专栏一的"分布式训练入门"到此为止,只讲了各种并行策略的思想和边界。专栏二在讲预训练时会展开 Megatron/DeepSpeed 的实际训练脚本、参数配比和踩坑;专栏三在讲工程部署时会深入 vLLM/TGI 等推理框架的分布式推理、张量并行与调度。你现在先建立"哪种瓶颈用哪种并行"的判断框架就够了。
下一篇
模型评估指标:BLEU、ROUGE、Perplexity —— 训练模型只是第一步,下一篇看如何评价模型效果,以及传统指标为什么不能完全代表大模型真实能力。
更多推荐

 32
 0
- 0


 已为社区贡献40条内容

所有评论(0)