
人工智能常用工具(十)
第5章 AI工具核心使用方法论(2/4)· 图像类
摘要:本节系统讲解图像类 AI 工具的使用方法论。内容涵盖:文生图提示词的标准结构(主体 + 风格 + 光线 + 构图 + 质量词 + 参数)、Midjourney 关键参数(
--ar、--s、--style raw、--v、--no、--seed)的实测效果、FLUX 与 Stable Diffusion 的提示词要点、图像识别类工具的指令规范,以及文生图常见问题的排查方案。通过 4 个操作示例(Midjourney 完整提示词、权重控制、SD 正反向提示词、发票识别),帮助读者快速上手图像类 AI 工具。
本节聚焦「图像类 AI 工具」:文生图(Midjourney、FLUX、Stable Diffusion、即梦、通义万相、豆包图像)、图像识别/计算机视觉(百度智能云、Google Vision、阿里云视觉智能开放平台)等。
学习目标
学完本节,你能:
- 写出文生图提示词的标准结构(主体 + 风格 + 光照 + 构图 + 质量词 + 参数)。
- 掌握 Midjourney/FLUX 的关键参数(
--ar、--s、--style raw、--v、--no、seed)并理解其效果。 - 为图像识别类工具写出有效指令(上传图 + 具体任务 + 输出格式)。
- 排查文生图常见出问题情况(手部畸形、风格不符、文字乱码、构图失控)。—
正文讲解
1. 图像类工具的能力谱系
| 类型 | 代表工具 | 核心能力 | 典型场景 |
|---|---|---|---|
| 文生图 | Midjourney v7、FLUX.1、Stable Diffusion 3、即梦、通义万相、豆包图像 | 文字描述 → 图片 | 海报、插画、头像、电商主图、概念设计 |
| 图生图 | Midjourney /imagine+图、FLUX img2img、Stable Diffusion、豆包图像 | 以图为参考生成/改图 | 换风格、重绘局部、扩展画布 |
| 图像识别 | 百度智能云、Google Vision、阿里云视觉智能 | 识别人/物/文字/场景 | 发票识别、内容审核、OCR、商品识别 |
| 图像编辑 | Canva AI、Remove.bg、Photoshop 生成式填充 | 抠图、扩图、消除、换背景 | 快速修图、证件照、电商素材 |
选工具口诀:
- 要艺术感/社区灵感 → Midjourney
- 要开源可控/本地部署 → Stable Diffusion / FLUX
- 要中文友好/快速出图 → 即梦、通义万相、豆包图像
- 要识别票据/商品/人脸 → 百度/阿里/腾讯/华为视觉云服务
2. 文生图提示词标准结构
一个稳定的文生图提示词通常按以下顺序组织:
[主体/场景] + [风格/媒介] + [光线/色彩] + [构图/镜头] + [质量词] + [参数]
1. 主体/场景
- 越具体越好。不要说"一个女孩",要说"一位穿白色风衣的亚洲年轻女性,站在东京涩谷街头,下雨天"。
- 用逗号分隔不同元素。
2. 风格/媒介
- 例如:
digital art、oil painting、anime style、cinematic photography、3D render、pixel art、minimalist illustration。
3. 光线/色彩
- 例如:
golden hour lighting、soft natural light、neon lights、cool tone、warm tone、high contrast、pastel colors。
4. 构图/镜头
- 例如:
close-up portrait、wide angle shot、top-down view、bokeh background、rule of thirds、symmetrical composition。
5. 质量词
- 例如:
highly detailed、8k resolution、sharp focus、masterpiece、best quality、ultra-realistic。
6. 参数(以 Midjourney 为例)
--ar 16:9:宽高比--s 250:风格化程度(默认 100,越高越艺术)--style raw:减少默认美化,更写实--v 7:使用最新模型版本--no 文字:负面提示,告诉模型不要什么--seed 12345:固定随机种子,便于复现
3. Midjourney 关键参数实测
实测截图:Midjourney 参数效果示意
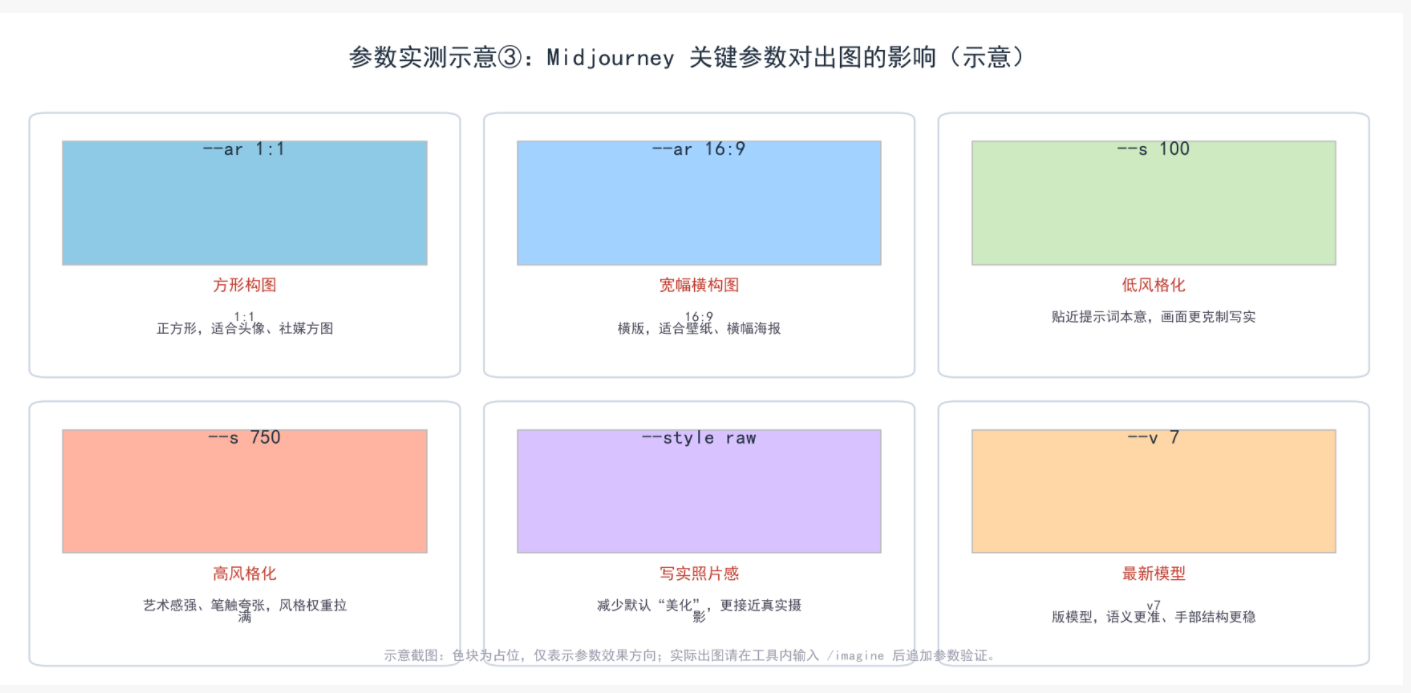
| 参数 | 作用 | 常用取值 | 实测效果 |
|---|---|---|---|
--ar | 画面比例 | 1:1、16:9、9:16、2:3 | 决定构图方向 |
--s | 风格化强度 | 0、100、250、750 | 越高越艺术、越低越贴近字面 |
--style raw | 减少默认美化 | 开关参数 | 更写实、更"raw" |
--v | 模型版本 | 6、6.1、7 | 版本越新,语义/手部/文字越稳 |
--no | 排除元素 | --no 文字,水印,模糊 | 让画面中不出现指定内容 |
--seed | 固定随机种子 | 任意数字 | 同样提示词能复现近似结果 |
示例完整提示词:
A cozy community bookstore at golden hour, warm interior light, wooden shelves, a cat sleeping on the windowsill, soft bokeh background, cinematic photography, highly detailed --ar 16:9 --s 250 --v 7中文可借助翻译器转成英文再输入,因为 Midjourney 对英文语义理解更稳。
4. FLUX / Stable Diffusion 提示词要点
FLUX:
-
自然语言理解更好,可以用接近口语的句子。
-
支持
--ar等参数(在平台前端),也可以直接写反向提示词。 -
提示词示例:
A futuristic Chinese tea house floating in the clouds at sunset, pastel pink and teal color palette, architectural photography, ultra-detailed --ar 3:2 ```**Stable Diffusion(WebUI/ComfyUI)**: -
通常分 正向提示词(Prompt)和 反向提示词(Negative Prompt)。
-
正向:主体 + 风格 + 质量词。
-
反向:
low quality, blurry, deformed hands, extra fingers, watermark, signature。 -
可手动调
CFG Scale(提示词遵循度,通常 7–12)和Steps(步数,通常 20–40)。
| 参数 | 含义 | 建议 |
|---|---|---|
| CFG Scale | 提示词强度 | 7–9 平衡;太高会过曝/失真 |
| Steps | 采样步数 | 20–30 通常够用;太高收益递减 |
| Sampler | 采样器 | Euler a / DPM++ 2M Karras 通用 |
| Seed | 随机种子 | 固定可复现;变动探索新结果 |
5. 图像识别类工具提示规范
图像识别不是"生成",而是"分析"。提示词要明确任务 + 指定输出格式:
请识别这张图片中的以下内容:
1. 所有可见文字(OCR),并保留原有排版;
2. 主要物体及其大致位置;
3. 场景类型(室内/室外/办公/街道);
4. 是否包含人脸或车牌等敏感信息。

输出为 JSON 格式。
如果识别的是发票/表单,可以进一步要求:
请提取发票中的:发票代码、发票号码、开票日期、金额、购买方名称。以表格形式输出。
6. 图像类常见问题与排查
| 问题 | 原因 | 解决方案 |
|---|---|---|
| 手部畸形/多指 | 文生图模型对手部理解弱 | 加 perfect hands, detailed fingers;如果不行,用图生图局部重绘 |
| 文字乱码 | 模型普遍不擅长生成文字 | 尽量避免画面中带字;后期用 Photoshop/Canva 加字 |
| 风格不符 | 提示词风格词不够或冲突 | 统一风格词;删除互相矛盾的描述 |
| 主体被背景淹没 | 构图/权重问题 | 用 :: 权重(Midjourney)或把主体放提示词前面 |
| 出图分辨率低 | 没加高分辨率参数 | 加 --hd 或平台里选高清/2x;后续用 Upscayl 等工具放大 |
| 生成的图有别人的脸/版权风险 | 训练数据问题 | 用于商业前检查;不要直接复刻真人/品牌 |
操作示例(含输入与预期输出)
示例1:Midjourney 完整提示词 + 参数
场景:为咖啡店做一张宣传海报。
输入:
A cozy community bookstore cafe at golden hour, warm ambient light, wooden interior, a barista making latte art, soft bokeh background, cinematic photography, highly detailed --ar 16:9 --s 250 --v 7 --style raw预期输出:一张宽屏、写实、温暖光影的咖啡馆场景图,构图有电影感,适合作为网页 Banner 或朋友圈海报背景。
示例2:用权重控制主体(Midjourney)
输入:
cup of coffee::2 steam rising, cozy window seat, rainy day outside::1 soft focus, warm light --ar 1:1 --s 150预期输出:咖啡杯和蒸汽成为视觉中心(权重 2),窗外雨景作为氛围背景(权重 1),画面主次分明。
示例3:Stable Diffusion 正向 + 反向提示词
正向提示词:
masterpiece, best quality, 1girl, blue hair, cyberpunk city, neon lights, rain, reflective ground, cinematic lighting反向提示词:
lowres, bad anatomy, bad hands, text, error, missing fingers, extra digit, fewer digits, cropped, worst quality, low quality, normal quality, jpeg artifacts, signature, watermark, username, blurry预期输出:一张赛博朋克风格的插画,人物和场景清晰,没有明显肢体畸形和水印。
示例4:图像识别——上传发票提取信息
前置准备:打开百度智能云/阿里云视觉/ChatGPT 多模态 → 上传发票图片。
输入:
请识别这张发票,并提取以下字段,以表格输出:
1. 发票代码
2. 发票号码
3. 开票日期
4. 销售方名称
5. 金额(小写)
6. 购买方名称

如果某个字段看不清,请标注“无法识别”。
预期输出:一个 6 行 2 列的表格,字段与识别结果一一对应,看不清的字段明确标注。
示例5:FLUX 自然语言提示词实战
场景:为一家科技公司设计一张公众号头图。
中文提示词:
一张现代科技感的公众号头图,深蓝色渐变背景,画面中央是一个发光的抽象人工智能芯片,周围环绕着流动的数据光线和粒子,左侧有简洁的几何线条装饰,整体风格简洁大气、高端专业,光线柔和有层次,构图居中对称,高清细节丰富英文翻译(FLUX 输入):
A modern tech-style WeChat official account banner, deep blue gradient background, a glowing abstract AI chip in the center surrounded by flowing data streams and light particles, clean geometric line decorations on the left side, minimalist and premium professional style, soft layered lighting, centered symmetrical composition, highly detailed --ar 3:1参数设置:
--ar 3:1(公众号头图推荐宽幅比例)、--s 200(风格化适中,兼顾写实与设计感)、--no text, watermark(避免生成乱码文字和水印)。预期输出:一张宽幅、深蓝科技风的公众号头图,AI 芯片作为视觉中心,数据光线营造科技氛围,画面简洁无文字,适合直接作为科技公司公众号封面使用。
示例6:通义万相/即梦中文提示词实战
场景:为一家家居品牌设计一张电商主图(商品为北欧风落地灯)。
中文提示词:
一张北欧风落地灯的电商主图,暖白色灯光,浅木色和米色背景,产品居中放置,光线柔和有层次,画面干净简洁,突出商品质感,高清细节丰富,适合电商平台主图使用参数设置:比例选择
1:1(电商主图常用方形)或3:4(竖版信息流),风格强度选择「写实」档(通义万相/即梦前端可选「写实/插画/国风」等风格),关闭「添加文字」选项,避免生成乱码文字。预期输出:一张干净、写实的北欧风落地灯主图,商品居中突出,背景简洁不抢镜,可直接作为电商平台商品主图或详情页首图使用。
同一提示词在 Midjourney 与中文工具上的效果差异:
- Midjourney:需先把中文翻译成英文再输入,对「北欧风」「电商主图」这类中文语境词理解较弱,出图更偏艺术感、光影更浓,但商品细节可能被风格化修饰,写实度需靠
--style raw拉回。- 通义万相/即梦:直接输入中文即可,对「电商主图」「商品质感」等中文商业语境理解更准,出图更贴近电商实拍风格、商品还原度高,但艺术感和光影层次通常不如 Midjourney 丰富。
- 建议:追求艺术感/品牌调性选 Midjourney;追求快速、写实、中文友好选通义万相/即梦,尤其适合电商主图这类对商品还原度要求高的场景。
示例7:图生图——产品照片换风格生成电商主图
场景:手头有一张白色陶瓷马克杯的产品实拍图,想用 Midjourney 的图生图功能,以它为参考生成三种不同风格的电商主图(极简白底、暖色生活场景、赛博朋克背景)。
前置准备:先把产品照片上传到 Midjourney(Discord 中把图片拖入对话框并回车,或使用 Web 端上传),复制图片链接,然后在
/imagine指令中粘贴该链接。输入(以极简白底风格为例):
/imagine [产品图片链接] a white ceramic mug, minimalist e-commerce product photo, pure white background, soft even studio lighting, centered composition, highly detailed, 8k --ar 1:1 --v 7 --style raw三种风格的具体提示词与参数:
- 极简白底:
a white ceramic mug, minimalist e-commerce product photo, pure white background, soft even studio lighting, centered composition, highly detailed --ar 1:1 --v 7 --style raw- 暖色生活场景:
a white ceramic mug on a wooden table, warm cozy lifestyle scene, morning sunlight through window, coffee beans scattered around, shallow depth of field, cinematic photography --ar 1:1 --v 7 --s 200- 赛博朋克背景:
a white ceramic mug, cyberpunk style, neon purple and cyan lights, futuristic city background, reflective surface, high contrast, dramatic lighting --ar 1:1 --v 7 --s 300参数说明:
--ar 1:1(电商主图常用方形比例)、--v 7(最新模型,对商品细节还原更稳)、--style raw(极简白底用,减少美化、更贴近实拍)、--s 200/300(生活场景和赛博朋克适当提高风格化,增强氛围感)。预期输出:三张以同一款马克杯为视觉主体的电商主图——白底版干净写实、适合平台主图;暖色版有生活气息、适合详情页场景图;赛博朋克版视觉冲击强、适合品牌活动或社交媒体推广。同一张产品照片通过图生图即可快速产出多套风格素材,无需重新拍摄。
小结回顾
本节要点:
- 文生图提示词结构 = 主体 + 风格 + 光线 + 构图 + 质量词 + 参数。
- Midjourney 核心参数:
--ar控制比例,--s控制风格化,--style raw写实,--v模型版本,--no排除,--seed复现。 - FLUX 自然语言更友好;Stable Diffusion 需要正向 + 反向提示词,调 CFG/Steps/Seed。
- 图像识别要明确任务 + 输出格式(表格/JSON),并标注无法识别的字段。
- 文生图出问题靠「具体描述 + 质量词 + 局部重绘 + 后期加字」解决。自测小问题:
- Q1:想让 Midjourney 出一张竖版手机壁纸,应该用什么参数?
- Q2:为什么文生图经常出现"手部畸形"?怎么解决?
- Q3:给图像识别工具下指令时,最重要的是哪两点?
参考答案:
- Q1:使用
--ar 9:16参数。手机壁纸是竖版,需要把画面比例设为 9:16(宽高比),Midjourney 就会按竖版构图输出,适合直接作为手机壁纸使用。 - Q2:因为文生图模型对手部的理解较弱,手指数量、姿态容易出错。解决方法是:在提示词中加
perfect hands, detailed fingers等质量词;如果仍不行,可用图生图对局部进行重绘修复。 - Q3:最重要的是「明确任务」和「指定输出格式」。即说清楚要识别什么(如提取发票字段、OCR 文字),并指定输出形式(如表格、JSON),这样模型才能给出结构化、可用的结果。> 下一节:第5章(3/4)编程类工具的核心使用方法与参数实测。
更多推荐

 2
 0
- 0


 已为社区贡献24条内容

所有评论(0)