
(论文速读)基于注意力的深度学习用于轮胎缺陷检测:融合局部和全局特征的工业案例研究
论文题目:Attention-based deep learning for tire defect detection: Fusing local and global features in an industrial case study(基于注意力的深度学习用于轮胎缺陷检测:融合局部和全局特征的工业案例研究)
期刊:Expert Systems With Applications
摘要:在轮胎制造中,轮胎的质量检查至关重要,因为有缺陷的轮胎可能会发生爆炸故障,特别是在比赛等高速驾驶活动期间。解决这一问题需要严格的制作后视觉检查。然而,轮胎纹理和结构的多样性使得缺陷检测成为一项具有挑战性的任务。针对这一挑战,本文提出了一种创新的解决方案,其形式是专门为轮胎缺陷检测设计的混合VIT-CNN模型。首先,我们提出了一个轻量级的基于注意力的初始化模块,它是我们提出的基于注意力的CNN模型的主要组成部分。这种基于注意力的CNN从整个图像中提取局部特征映射,而VIT从图像块中捕获全局特征。使用一个包括83985张无缺陷轮胎和38710张有缺陷轮胎的X射线图像的数据集来训练和测试该模型,这些图像代表了50个设计模式上的15种不同类型的缺陷。结果表明,VIT-CNN模型的召回率为95.48%,准确率为96.1%,F1得分为95.79%,总体准确率为97.33%。统计检验,包括Friedman和Wilcoxon符号等级检验,被用来评估拟议的VIT-CNN模型与单个模型之间是否存在显著差异。从这些测试中获得的结果强调了模型之间存在的显著差异。此外,VIT-CNN模型成功地识别了各种轮胎缺陷和复杂的纹理,使其在真实世界的场景中有效。这项研究增加了轮胎缺陷自动识别,满足了行业对精确和可靠检测的要求,同时通过提供高性能的模型来提高人类安全。
用 ViT-CNN 混合模型检测轮胎缺陷:融合局部与全局特征的工业实践
一、问题背景:为什么轮胎 X 射线检测如此棘手?
全球轮胎行业每年因缺陷轮胎退货造成的损失高达 1 亿美元,而缺陷率约为 7%。为确保产品质量,轮胎出厂前需对 X 射线图像进行逐一人工审查。然而,这一过程主观、低效、耗时,且高度依赖检测员的经验和注意力。
轮胎 X 射线图像的特殊挑战
轮胎内部结构复杂,由天然橡胶、合成橡胶、钢丝、纺织带等多层材料精密叠加而成。这些层状结构在 X 射线图像中以条纹形式呈现,而缺陷往往隐藏在这些复杂纹理之中。该工厂的数据涵盖 15 种缺陷类型、50 种花纹设计,典型缺陷包括:
- 第一层带束偏移(Belt offset)
- 钢丝叠加(Wire overlay)
- 接头开口(Splice opening)
- 异物(Foreign material)
- 带束层等角(Equiangular belts)
- 边缘折叠(Edge fold / Border fold)
- 离散(Dispersion)等
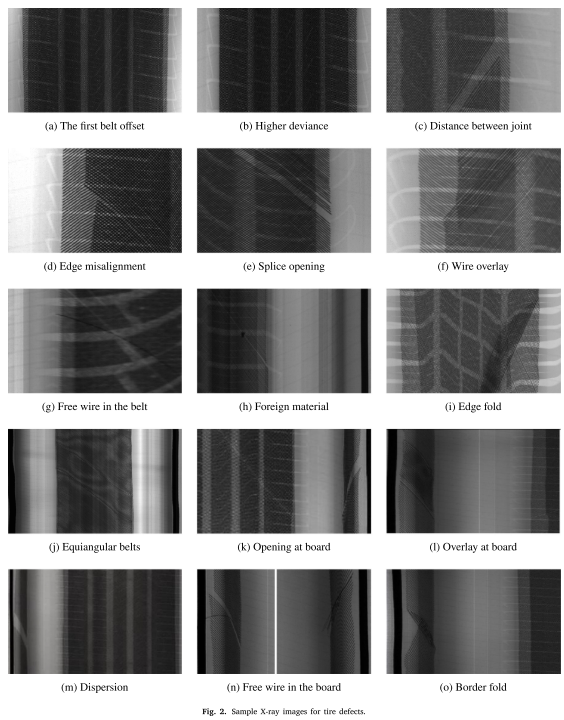
【论文 Fig. 2 — 15 种缺陷类型的 X 射线图像样本(3×5 排列展示)】
论文指出的三类模型各自的缺陷
纯 CNN 的不足:
- 对局部细小缺陷(如小异物、细微花纹不规则)感知能力弱
- 在复杂背景(噪声、不相关轮胎特征)中容易漏检
- 受类别不平衡影响大,偏向高频缺陷类型
- 对不同轮胎设计泛化能力不足
纯 ViT 的不足:
- 参数量巨大(本研究中 ViT 有 85,800,194 个参数),数据量有限时极易过拟合
- 对局部结构信息(如轮胎层间关系、细小缺陷位置)的建模不如 CNN 精细
- 对领域迁移(不同传感器、不同数据采集设备)鲁棒性差
现有混合模型的不足:
- 融合策略设计复杂,两种架构的强弱平衡难以把握
- 多数混合模型仍依赖大规模、高质量数据集
- 训练时间显著增加
二、数据集:来自皮雷利工厂的真实工业数据
采集设备与过程
数据来自土耳其伊兹密特的 Pirelli 汽车轮胎工厂,使用 Alfautomazione Tire-X 3000 X 射线检测设备采集。该设备由一个二极管和一个 U 形接收器组成,检测舱完全用铅封闭以保证辐射屏蔽安全。
工作流程:轮胎进入检测舱后旋转 360 度,X 射线穿透轮胎后由外部接收器捕获,生成完整的环绕式射线图。整个检测过程根据轮胎直径不超过 1 分钟。
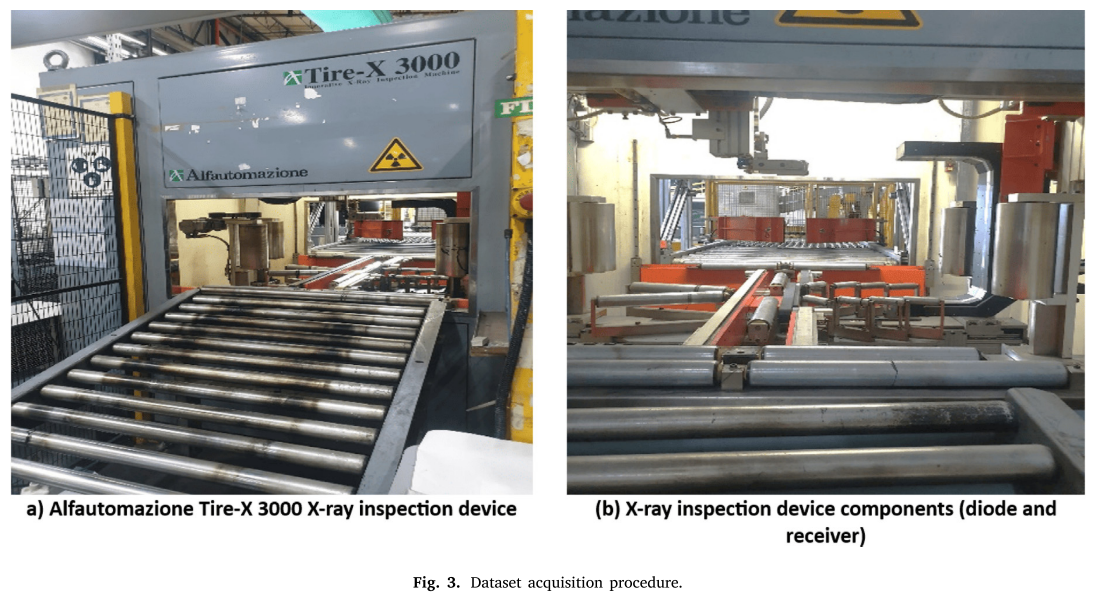
【论文 Fig. 3 — 数据采集设备实物图(Tire-X 3000 全景图及二极管/接收器组件图)】
数据规模与类别不平衡
由于生产中缺陷轮胎本身属于小概率事件,数据收集历时 一年半,最终获得:
- 正常轮胎:83,985 张
- 缺陷轮胎(原始):4,912 张(15 种缺陷类型,50 种花纹设计)
原始正负样本比约为 17:1,类别严重不平衡。
数据增强策略(专为 X 射线轮胎图像定制)
常见增强方法(旋转、翻转、缩放、剪切)对轮胎 X 射线图像来说是有害的——它们会破坏轮胎内部层状结构的物理合理性,生成在真实制造条件下不可能出现的失真样本,导致模型学习到错误特征。
论文仅采用两种保结构的增强方式:
- 亮度调整:模拟 X 射线光源强度自然波动或机器运行时外部变量导致的光照变化
- 垂直位移:复现轮胎进入检测系统时起始位置的轻微差异(这种位置浮动在实际中普遍存在,且不影响轮胎内部结构和缺陷分布)
增强后,缺陷图像数量从 4,912 张增至 38,710 张(训练集 34,794 张,测试集 3,916 张)。所有生成图像均经专家审核确认,保证其忠实还原真实缺陷。
数据划分:
- 缺陷图像:80% 训练,20% 测试
- 正常图像:83,985 张同样按 80/20 划分
- 图像统一归一化并缩放至 224 × 224 × 3
三、方法论:ViT-CNN 混合架构
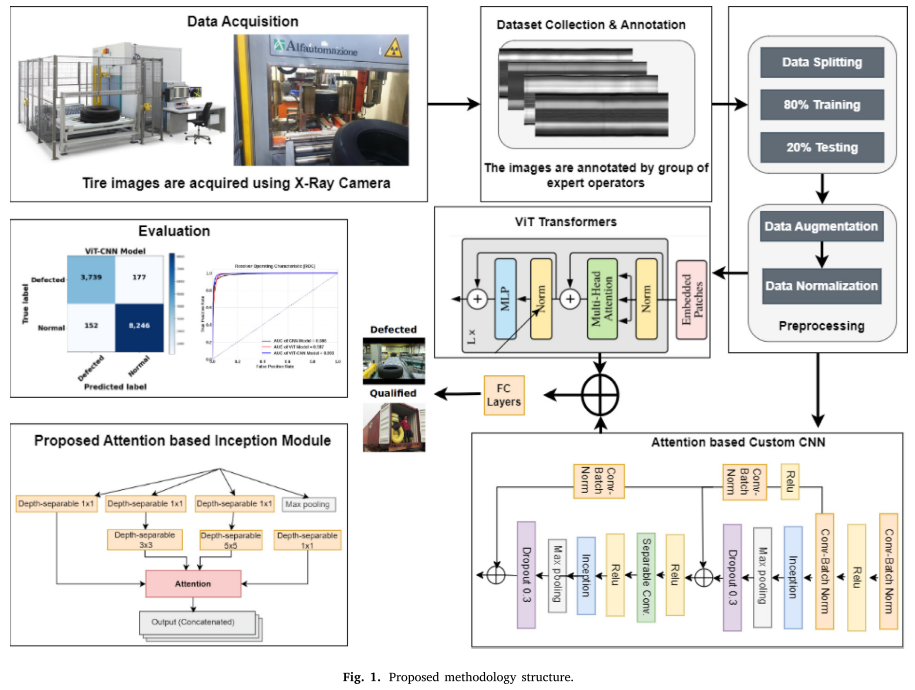
【论文 Fig. 1 — 整体方法框架示意图(从数据采集到评估的完整流程图)】
整体思路是:让 CNN 路负责从整幅图像中提取局部特征映射,让 ViT 路负责从图像 patch 中捕获全局特征,两路特征拼接后完成二分类(有缺陷 / 无缺陷)。
3.1 创新模块一:轻量级注意力 Inception 模块
这是本文最核心的技术贡献,作为 CNN 路的基础构件。
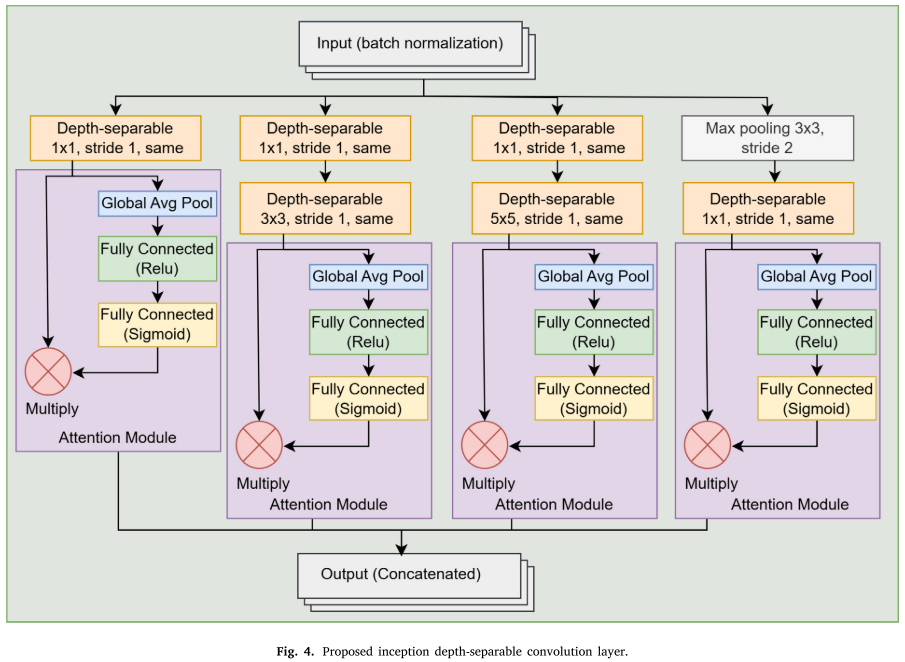
【论文 Fig. 4 — 轻量级注意力 Inception 模块的详细结构图(四路并行分支 + 注意力机制)】
两大核心改动(相较于原始 Inception 模块):
改动一:用深度可分离卷积替换标准卷积
深度可分离卷积将标准卷积分解为逐深度(Depthwise)卷积和逐点(Pointwise)卷积,在几乎不损失性能的前提下大幅降低计算量和参数数量。
改动二:在每路输出后加入通道注意力机制
注意力机制流程如下:
- 全局平均池化(GAP):将每个通道的特征图压缩为单个描述符
- 全连接层(ReLU):作为瓶颈层,压缩通道维度
- 全连接层(Sigmoid):恢复原始维度,输出通道权重图
- 权重相乘:以权重图缩放输入特征图,强调重要通道、抑制噪声通道
四路并行分支,各司其职:
| 分支 | 卷积核 | 捕捉目标 | 典型缺陷 |
|---|---|---|---|
| 第一路 | 1×1 深度可分离卷积 | 细粒度模式 | 微小对齐误差、细微纹理变化 |
| 第二路 | 3×3 深度可分离卷积(前置 1×1 降维) | 中等尺度模式 | 接头叠加、接缝滑移 |
| 第三路 | 5×5 深度可分离卷积 | 大尺度异常 | 带束错位、附着不当 |
| 第四路 | MaxPooling + 注意力 | 局部显著特征 | 嵌入式异物 |
四路输出沿通道轴拼接,形成融合局部与全局、多尺度信息的综合特征表示。
数学形式如下(以第一路为例):
3.2 CNN 路:局部特征提取
基于上述注意力 Inception 模块,论文构建了一个三阶段 CNN(A→B→C Block):
- A Block:两层 Conv-BatchNorm(32 和 64 通道)→ MaxPooling;并行一个 Proposed Inception;经 Conv-BN(224通道),再接 Proposed Inception → MaxPooling → Dropout 0.3 → 分支路,最终输出 28×28×512 特征图
- B Block:重复 8 次(Separable Conv 3×3×512 → ReLU → Proposed Inception → ReLU → Separable Conv → ReLU),维持 28×28×512
- C Block:继续深化后经 Global Average Pooling 输出 512 维特征向量
3.3 ViT 路:全局特征提取
使用标准 Vision Transformer(ViT)结构:
- 图像切分为 patch 序列,线性投影至嵌入维度
- 加入位置编码(Positional Encoding)捕捉空间位置信息
- 经多头自注意力(Multi-Head Self-Attention)+ MLP Block × 12 次
- 全局平均池化输出 384 维特征向量
ViT 中的注意力计算公式:
3.4 特征融合与分类
CNN 路提取 512 维特征,ViT 路提取 384 维特征,拼接为 896 维综合特征向量,经一层含单节点的 Dense 层(Sigmoid 激活)输出 [0,1] 概率值,完成二分类。
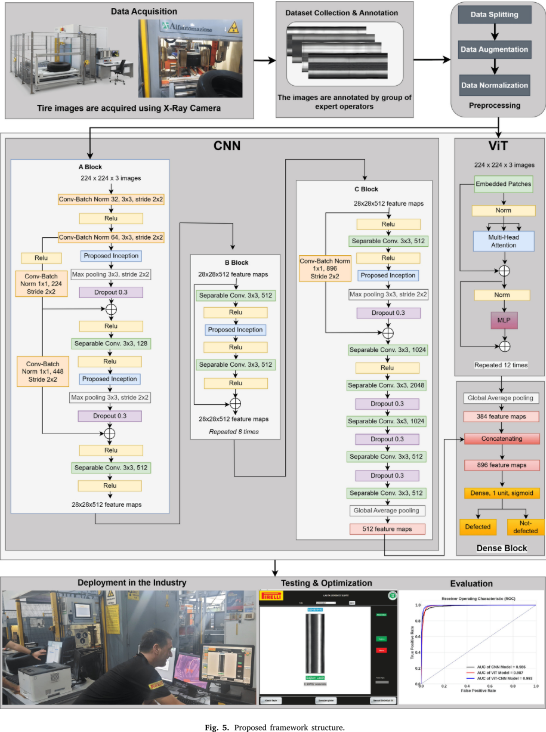
【论文 Fig. 5 — 完整框架结构图(含 CNN 三阶段详细结构、ViT 结构、融合层)】
四、实验结果
4.1 主要分类指标对比
三个模型(纯 CNN、纯 ViT、混合 ViT-CNN)在测试集上的表现:
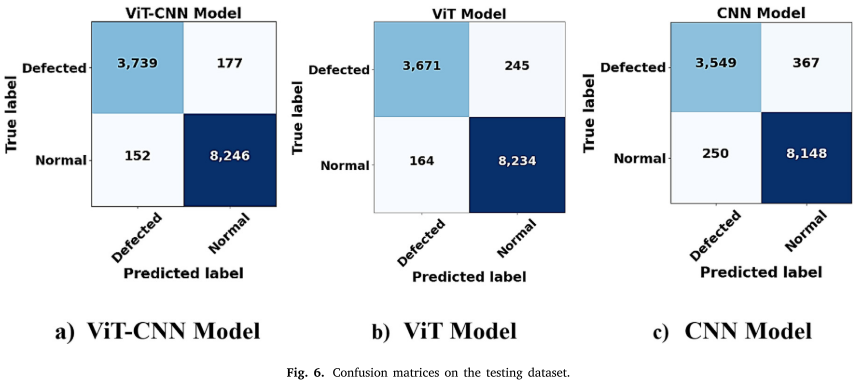
【论文 Fig. 6 — 三个模型的混淆矩阵(并排展示 ViT-CNN / ViT / CNN 三个混淆矩阵)】
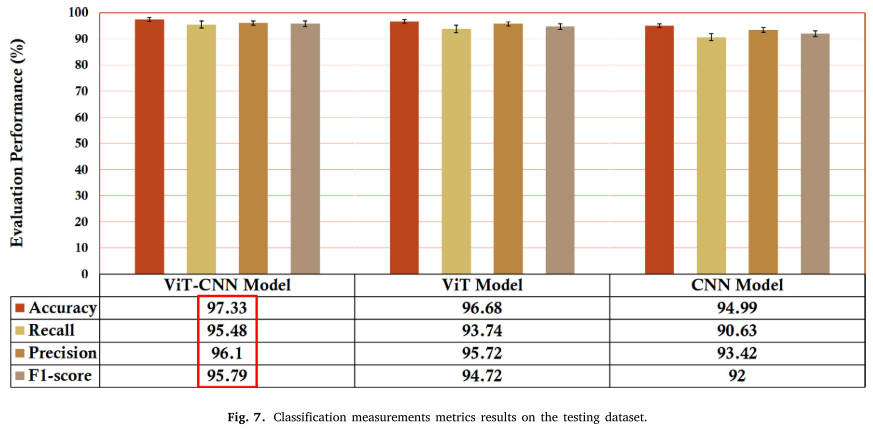
【论文 Fig. 7 — 三个模型的各项评估指标柱状图对比(准确率、召回率、精确率、F1 分数)】
| 模型 | 准确率 | 召回率 | 精确率 | F1 分数 |
|---|---|---|---|---|
| CNN(注意力) | 94.99% | 90.63% | 93.42% | 92.00% |
| ViT | 96.68% | 93.74% | 95.72% | 94.72% |
| ViT-CNN(提出) | 97.33% | 95.48% | 96.10% | 95.79% |
关键观察:
- ViT 在所有指标上均优于纯 CNN,说明 ViT 架构更适合此任务
- 混合 ViT-CNN 在 ViT 基础上进一步提升,尤其是召回率(+1.74 个百分点),说明 CNN 的局部特征提取对漏检缺陷的识别有实质贡献
- 召回率 95.48% 在工业质检场景中意义重大——漏检缺陷轮胎流入市场的风险被大幅降低
4.2 ROC 曲线与 AUC 分数
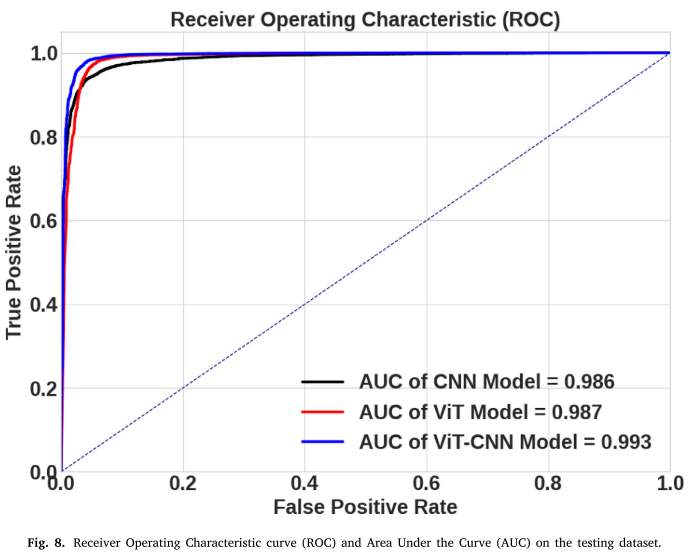
【论文 Fig. 8 — 三个模型的 ROC 曲线(含 AUC 值)】
三个模型的 AUC 值:
- CNN:AUC = 0.986
- ViT:AUC = 0.987
- ViT-CNN:AUC = 0.993
ViT-CNN 的 AUC 达到 0.993,意味着在各种决策阈值下,该模型均能有效区分缺陷与正常轮胎。
4.3 计算复杂度对比
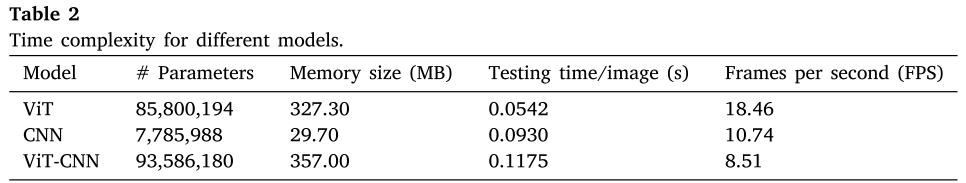
【论文 Table 2 — 三个模型的参数量、内存占用、单图推理时间、FPS 对比】
| 模型 | 参数量 | 内存(MB) | 推理时间/图(s) | FPS |
|---|---|---|---|---|
| ViT | 85,800,194 | 327.30 | 0.0542 | 18.46 |
| CNN | 7,785,988 | 29.70 | 0.0930 | 10.74 |
| ViT-CNN | 93,586,180 | 357.00 | 0.1175 | 8.51 |
ViT-CNN 是三者中参数量最多、推理最慢的,但以 8.51 FPS 的速度处理图像,远超 X 射线设备每次单帧采集的速度,完全满足工业实时检测需求。该模型已被部署到皮雷利工厂的质量控制生产线上。
4.4 统计显著性检验
为严格验证混合模型与单一模型之间的性能差异,论文使用了两种非参数统计检验:
- Friedman 检验(多模型同时比较):
,df = 2,
,三模型存在极显著差异
- Wilcoxon 符号秩检验(两两比较):
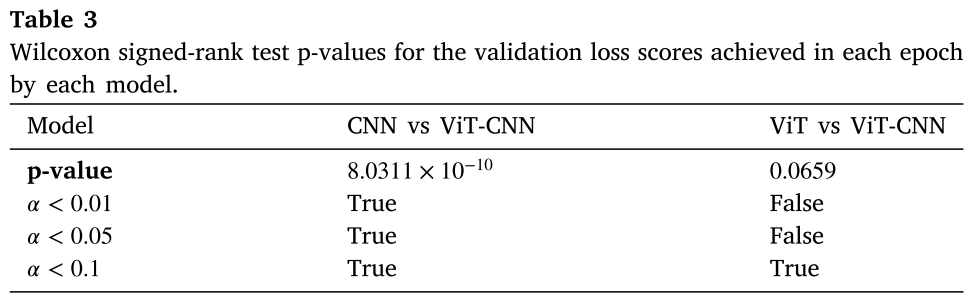
【论文 Table 3 — Wilcoxon 检验的 p 值及各显著性水平结论】
| 比较对 | p 值 | α<0.01 | α<0.05 | α<0.1 |
|---|---|---|---|---|
| CNN vs ViT-CNN | 8.03×10⁻¹⁰ | True | True | True |
| ViT vs ViT-CNN | 0.0659 | False | False | True |
解读:
- CNN 与 ViT-CNN 的差异在 α=0.01 水平上显著,说明两者性能差距是稳健的、非随机的
- ViT 与 ViT-CNN 的差异在 α=0.05 水平上不显著,但在 α=0.1 水平上显著,说明 ViT 是混合模型性能的主要来源,CNN 路提供了边际但有意义的提升
五、可解释性分析:Grad-CAM 热图
在安全攸关的应用中,模型的可解释性与性能同等重要。论文使用 Grad-CAM(梯度加权类激活映射) 技术可视化三个模型的决策依据。
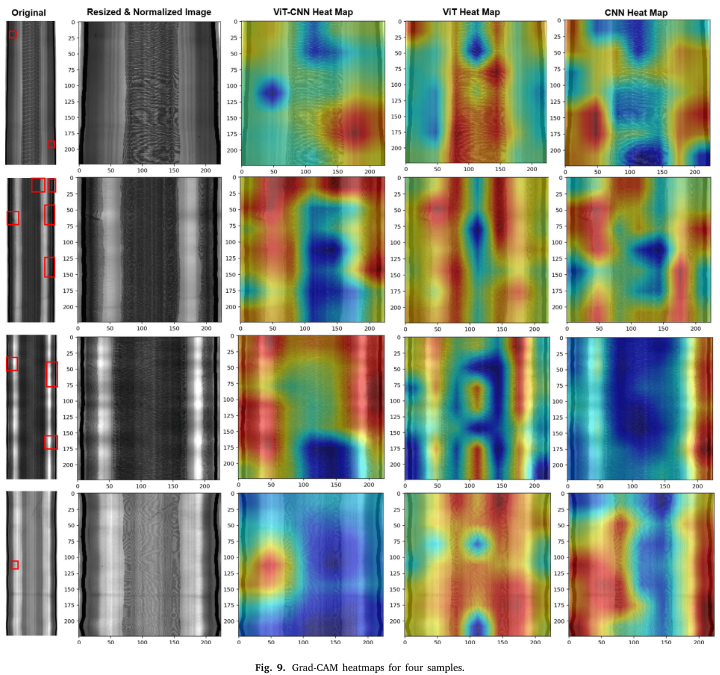
【论文 Fig. 9 — 四个样本的 Grad-CAM 热图(原图 / 归一化图 / ViT-CNN 热图 / ViT 热图 / CNN 热图 五列对比)】
从热图对比中可以观察到:
- ViT-CNN:热激活区域与真实缺陷位置高度吻合,能同时识别异物、接头距离、钢丝叠加、板叠、边缘折叠等多种复杂缺陷
- ViT:能定位到显著缺陷区域,但在外物和等角带束缺陷等复杂模式上精度略低
- CNN:激活区域更大、更模糊,定位精度较差,尤其在接头距离和板叠缺陷上误差明显
ViT-CNN 的混合架构通过整合局部与全局上下文信息,使热图更聚焦于缺陷区域而非背景,这一特性显著提升了模型在工业场景中的可信度和可验证性。
六、失效分析:模型在哪里会出错?
论文诚实地分析了两类主要失效模式:
失效模式一:多缺陷共现反而提升置信度
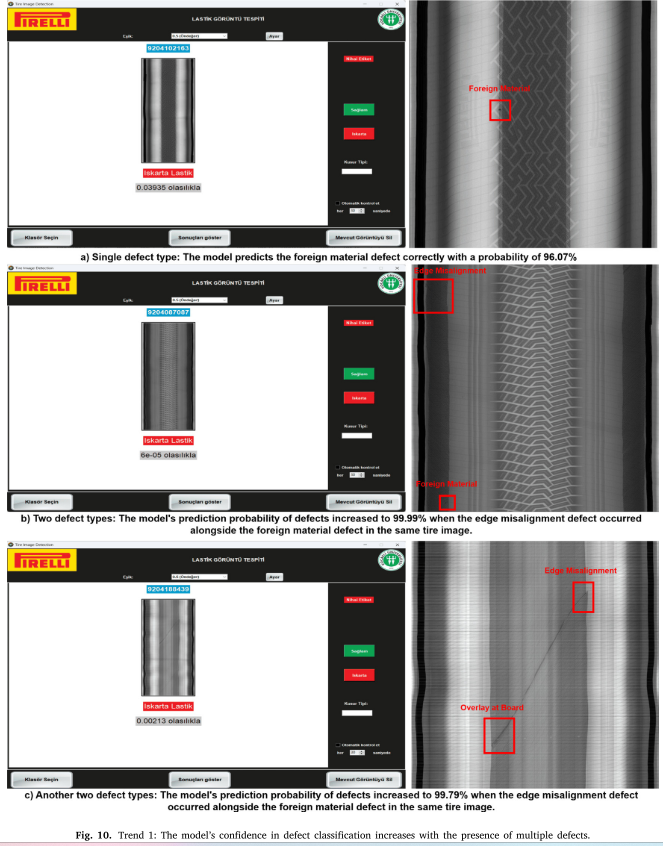
【论文 Fig. 10 — 趋势一展示(单缺陷 → 双缺陷 → 置信度随缺陷数量增加而提高的三种情况)】
实验发现,当图像中同时存在多种缺陷时,模型的分类置信度反而更高:
- 单一异物缺陷:预测概率 0.03935(即 92.13% 置信度认为有缺陷)
- 异物 + 边缘错位:预测概率降至 0.00006(即 99.98% 置信度)
- 另一双缺陷组合:预测概率 0.00213(即 99.79% 置信度)
这说明多种缺陷的信息在聚合后为模型提供了更丰富的区分依据,有助于更稳健的判断。
失效模式二:近边界缺陷被误判为合格品
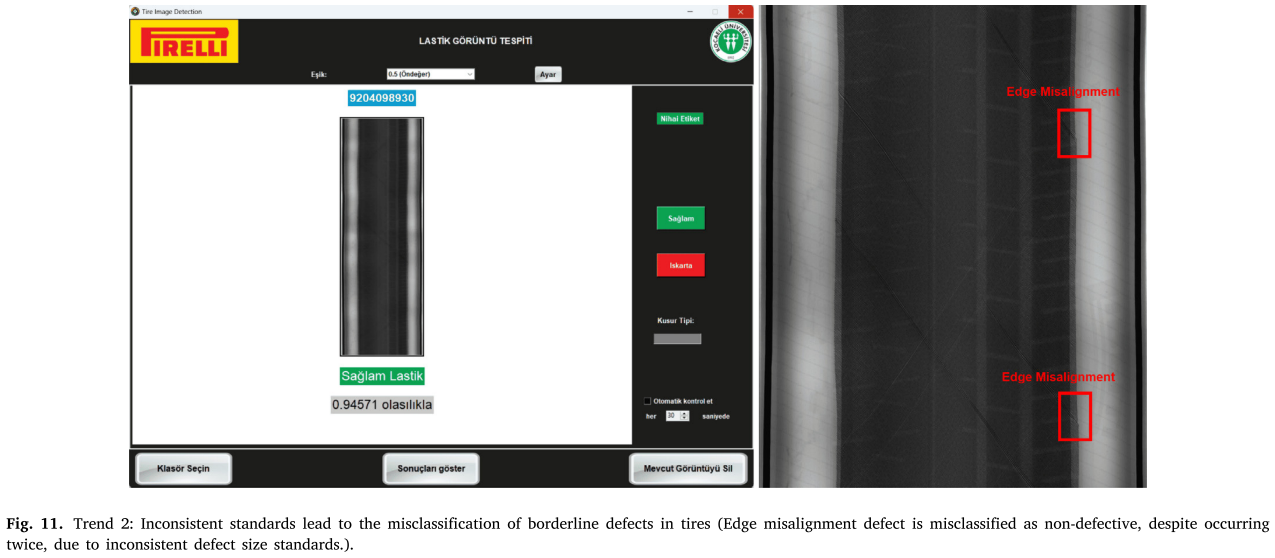
【论文 Fig. 11 — 趋势二:边缘错位缺陷在同一图像中出现两次,但因尺寸接近容差阈值而被误判为合格】
当缺陷尺寸接近容差阈值时,模型常将其误判为正常轮胎。根本原因在于:赛车轮胎和普通轮胎的允许缺陷尺寸标准截然不同,而数据集标注时未区分这一点——本应标为缺陷的赛车轮胎被标为合格品,导致模型学到了偏误规则。
解决方案:在部署到皮雷利工厂的 GUI 系统中,加入了可调节分类阈值的选项。对于高风险应用(如赛车轮胎),操作员可将阈值从默认 0.5 提高至 0.95,确保所有概率低于 0.95 的样本均被判定为缺陷,从而满足更严格的质量标准。
七、与现有工作的横向对比
主数据集(15 种缺陷 × 50 种花纹)对比
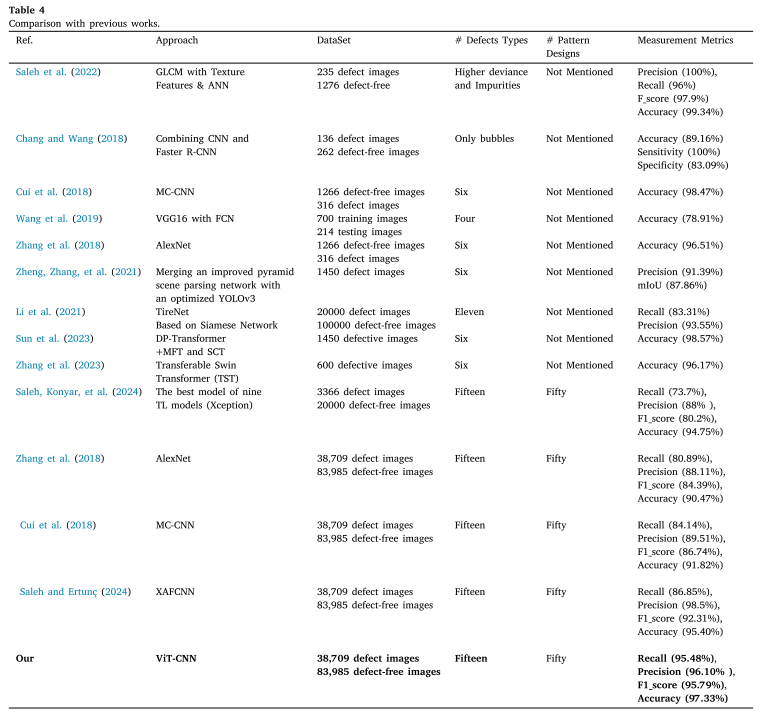
【论文 Table 4 — 与历史工作的全面对比(包含方法、数据集规模、缺陷类型数、花纹设计数、性能指标)】
核心规律:随着缺陷类型数量增加,各先前方法的性能普遍下滑。以 AlexNet 和 MC-CNN 为例,在六种缺陷时准确率分别为 96.51% 和 98.47%;但在同一数据集(15种缺陷 × 50种花纹)上测试时,分别降至 90.47% 和 91.82%。ViT-CNN 则在最复杂的数据集配置下仍达到 97.33% 准确率,展现出卓越的泛化能力。
消融实验(外部数据集 MT — 磁性瓷砖缺陷)
为验证模型的跨域泛化能力,论文在 MT(Magnetic Tile Surface Defects)数据集上进行了测试,该数据集包含 1,344 张图像、6 种缺陷类别,与轮胎缺陷特征有相似性但不完全一致。
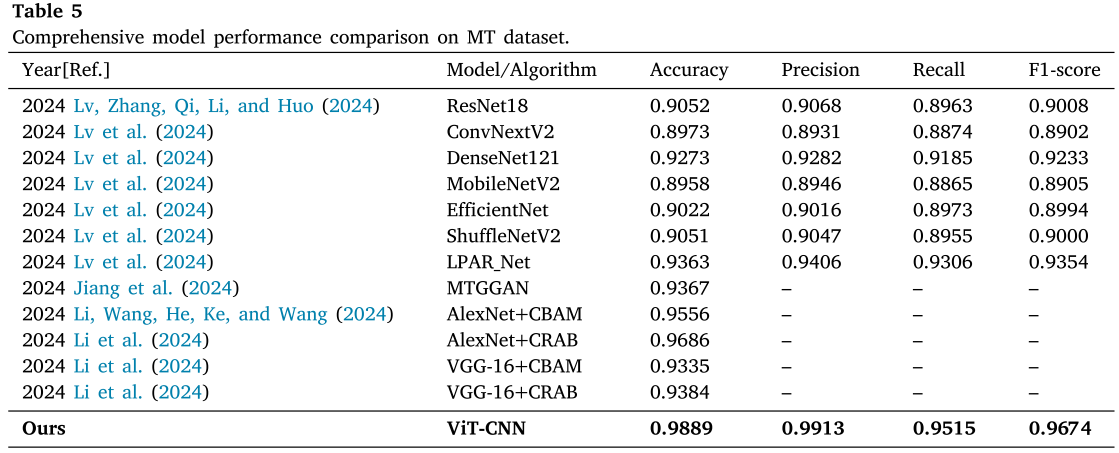
【论文 Table 5 — 在 MT 数据集上与各基线模型的详细对比(Accuracy / Precision / Recall / F1)】
ViT-CNN 在 MT 数据集上取得最高准确率 0.9889,超越 LPAR_Net(0.9363)、MTGGAN(0.9367)、AlexNet+CRAB(0.9686)等所有对比基线,进一步印证了方法的通用性。
八、讨论:亮点总结与局限展望
三大核心亮点
-
轻量级注意力 Inception 模块:四路多尺度并行 + 通道注意力,既保持了计算高效性,又显著提升了对不同尺度缺陷的检测能力,是可独立复用的模块设计
-
ViT-CNN 融合策略的反直觉设计:CNN 路提取局部特征,ViT 路提取全局特征——这与通常认为"CNN 捕捉全局纹理、ViT 关注局部细节"的直觉相反,但实验证明这一分工对该任务更有效
-
工业落地验证:该系统已真实部署在皮雷利工厂生产线上,配备可调节阈值的 GUI 界面,并针对赛车轮胎与普通轮胎的不同标准提供了灵活的应对机制
现存局限与未来方向
- 二分类的局限:当前仅区分"有缺陷 / 无缺陷",未对 15 种具体缺陷类型进行精细分类。扩展为多类分类任务是下一步的重要方向
- 数据集私有性:数据集受保密协议约束无法公开,限制了方法的独立验证
- 计算开销:93.6M 参数、357MB 内存,在边缘计算设备上部署仍需进一步压缩优化
- 标注一致性:赛车轮胎与普通轮胎的缺陷尺寸容差标准不统一,是当前标注噪声的主要来源,需要在未来数据收集阶段加以规范
- 多缺陷定位:当前是图像级二分类,无法精确定位多缺陷的具体位置,结合实例分割是潜在的改进方向
九、总结
这篇来自科贾埃利大学与皮雷利工厂联合开展的工业研究,将混合深度学习架构(ViT + 注意力 CNN)与真实工业部署场景紧密结合。其最大价值在于:
- 技术上:提出了可独立使用的轻量级注意力 Inception 模块,以及一套针对 X 射线图像独特性质量身定制的数据增强策略
- 工程上:在 15 种缺陷类型 × 50 种花纹设计的超复杂场景下实现了 97.33% 的准确率和 95.48% 的召回率,并已部署到真实生产线
- 科学上:通过 Friedman 和 Wilcoxon 统计检验严格验证了模型间的显著性差异,避免了仅凭均值比较的结论不可靠问题
对于工业质检领域的研究者和工程师而言,这项工作展示了如何从"能在数据集上跑通"走向"真正部署到工厂产线"——两者之间的距离,正是这篇论文所填补的。
更多推荐

 0
 0
- 0


 已为社区贡献19条内容

所有评论(0)