
【读点论文】Exposure-slot: Exposure-centric representations learning with Slot-in-Slot Attention
Exposure-slot: Exposure-centric representations learning with Slot-in-Slot Attention for Region-aware Exposure Correction
Abstract
- 图像曝光校正通过解决曝光不足和曝光过度的问题来增强在各种真实条件下捕获的图像,曝光不足和曝光过度会导致关键细节的丢失并妨碍内容识别。虽然已经取得了显著的进步,但是当前的方法通常不能实现用于有效校正的最优特征学习。为了克服这些挑战,我们提出了Exposure-slot,这是一个新的框架,它集成了一个基于prompt的slot-in-slot注意机制来对暴露的特征区域进行聚类,并为每个聚类学习以暴露为中心的特征。通过用分层结构 extending the Slot Attention algorithm ,我们的方法渐进地聚类特征,实现精确和区域感知的校正。特别是,针对槽的暴露特征定制的可学习提示进一步增强了特征质量,动态地适应变化的条件。我们的方法在基准数据集上提供了卓越的性能,在SICE数据集上的PSNR改善超过1.85 dB,在LCDP数据集上超过0.4 dB,超越了当前的最先进水平,从而为多重曝光校正建立了新的基准。源代码可以在以下位置找到:GitHub - kdhRick2222/Exposure-slot: Exposure-slot: Exposure-centric representations learning with Slot-in-Slot Attention for Region-aware Exposure Correction, Computer Vision and Pattern Recognition (CVPR), 2025.。
- 之前的方法如 Retinex 理论、多曝光校正模型(如 MSEC、LCDPNet)以及基于物理特性的特征分离(如频率、对比度等)。而本文的方法可能结合了 Slot Attention 机制,这属于深度学习中的注意力机制,特别是对象中心学习(OCL)的概念。提出了 Slot-in-Slot Attention 结构,这是对标准 Slot Attention 的扩展,采用层次化结构逐步聚类特征,同时引入可学习的提示(prompts)来适应不同的曝光条件。主要模块包括 Slot-Prompt Interaction Module(SPIM)和 Slot-in-Slot Attention Block(SSAB),以及编码器 - 解码器结构。SPIM 结合了 SSAB 和交叉注意力,用于特征 refinement;SSAB 则通过层次化的主槽和子槽注意力来分区曝光区域。此外,还有 Slot Decoder 用于训练时的槽重建,损失函数包括图像增强损失和槽重建损失。Slot Attention 基于对象中心学习,将图像分解为不同的 “槽”,每个槽对应一个对象或区域,这里用于曝光区域的聚类。提示机制可能借鉴了自然语言处理中的提示学习,用于引导模型关注特定的曝光特征。
Introduction
-
图像曝光校正可增强在各种真实条件下拍摄的图像。曝光不足或曝光过度的图像可能会显得过暗或过亮,从而丢失重要的细节并影响准确识别。尽管成像技术有所进步,但强大的自动曝光校正仍然是一个重大挑战。
-
由于图像曝光校正的重要性,它已经成为大量研究的焦点。早期的努力主要是将暴露不足和暴露过度作为独立的问题。然而,最近的发展引入了多重曝光校正模型,能够在统一的框架内处理大范围的曝光水平。例如,MSEC 介绍了一种方法,该方法在以端到端的方式执行多重曝光校正的同时,考虑了颜色和细节增强,并提供了一个具有不同曝光误差的图像数据集,用于训练和评估。
-
此外,LCDPNet 提供了另一个不同场景的数据集,包括过度曝光和曝光不足,并结合了retinex理论来解释图像中的局部颜色分布。最近的方法越来越关注基于特征的物理特征的单独处理,例如曝光、频率、对比度、颜色和细节。FECNet 使用傅立叶变换来促进局部空间特征信息和全局频率信息之间的交互,而ECLNet 使用双边激活机制来独立处理曝光过度和曝光不足的区域。此外,DA 引入了一种解耦和聚合方案,分别增强图像细节和对比度。
-
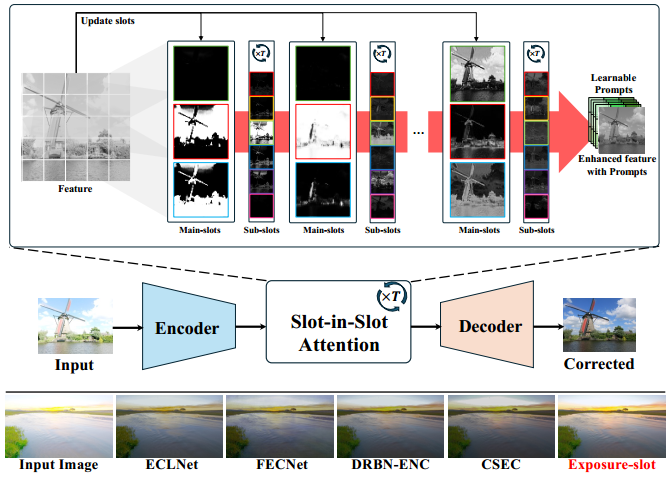
然而,依靠基于这些物理属性来分离图像特征可能无法确保有效曝光校正的最佳特征。例如,在图1的底部,我们设想了这种限制,表明以前的工作经常在天空区域产生不适当的伪像,并努力精确调整日落曝光水平。
-
-
图一。(上图) Slot-in-Slot Attention 机制使用主插槽和子插槽注意的注意图来分层划分暴露感知区域,根据暴露级别使用可学习的提示来执行纠正。(下)曝光槽与现有方法的比较。从左到右:ECLNet ,FECNet ,DRBN-ENC ,CSEC 和我们提出的方法,Exposure-slot.
-
-
为了克服这些挑战,我们提出了一种新的基于提示的槽中槽注意机制,该机制对具有相似暴露水平的区域进行聚类,从而在每个聚类内实现以暴露为中心的特征学习。我们利用槽注意,旨在基于对象表示聚类特征,以识别图像中不同的曝光区域。在我们的方法中,槽代表按暴露水平分组的特征,相应的注意力图充当暴露感知区域图,根据暴露特征指导特征的分组。因此,这些地图会根据曝光级别高亮显示区域,从而对每个区域进行有针对性的曝光校正。
-
为了支持有效的纠正,我们引入了可学习的提示向量,这些向量基于曝光感知区域图进行操作,曝光感知区域图是每个槽的注意力图。这些提示适应由注意力地图定义的每个区域的特征,帮助模型学习有针对性的校正,以改善曝光不足或过度的区域。具体来说,我们引入了时隙-提示交互模块(SPIM),它使用交叉注意将时隙和提示信息结合起来。SPIM的交叉注意组件使用通过 Slot-in-Slot 注意学习到的提示作为条件因素,增强了特征和提示之间的交互。
-
我们的方法建立在标准时隙注意的基础上,采用分层设计,称为时隙中时隙注意,分层次处理时隙。这种机制在多个结构级别上运行:第一级基于不同的曝光特性粗略地划分区域,而后续级用更多的划分来逐步细化这些区域。每个槽捕捉特定于曝光的区域信息,区分具有不同曝光水平的区域,以增强特征分离并提高局部细节的精度。
-
图1的顶部示出了所提出的方法的总体框架。如图1所示,Slot-in-Slot Attention 被应用于编码器和解码器之间的中间特征,为根据曝光特性分层划分的时隙生成注意图。然后,生成的注意力图被用作可学习提示的权重图,从而产生精细的中间特征,这些特征随后被馈入解码器。我们将我们的模型称为 Exposure-Slot,,因为它是第一个在曝光校正中基于曝光水平使用槽注意力进行无监督特征划分的模型,也是第一个应用区域感知提示进行特征增强的模型。我们的主要贡献如下:
- Exposure-slot 是第一种利用 Slot Attention 机制来优化特定于曝光的特征划分的方法。
- 我们引入了 slot-in-slot attention ,这使得复杂的功能划分和学习成为可能。
- 我们应用曝光感知提示来增强每个图像特征的以曝光为中心的特征。
- Exposure-slot在多次曝光基准数据集上取得了最先进的结果,树立了该领域的新标准。
-
Retinex 理论与多曝光校正:传统方法如 RetinexNet、LCDPNet 基于 Retinex 理论,将图像分解为反射光和光照分量,但难以处理复杂场景的局部曝光差异。Retinex 理论与多曝光校正:传统方法如 RetinexNet、LCDPNet 基于 Retinex 理论,将图像分解为反射光和光照分量,但难以处理复杂场景的局部曝光差异。对象中心学习(OCL):借鉴 Slot Attention 在对象分割中的思想,将图像曝光区域视为 “对象”,通过注意力机制聚类相似曝光特征,实现区域感知的校正。
-
层次化槽注意力(Slot-in-Slot Attention):通过主槽(Main-slot)和子槽(Sub-slot)的两层结构,逐步从粗到精划分曝光区域。主槽负责初步分区,子槽细化局部细节,形成层次化的曝光特征表示。
-
可学习提示(Prompts):引入与曝光特性匹配的提示向量,通过交叉注意力与槽特征交互,动态调整不同区域的校正策略,适应复杂光照条件。
-
编码器 - 解码器架构:采用 U 型网络结构,结合跳过连接保留细节,同时通过 Slot Decoder 在训练阶段强制槽特征捕捉曝光信息,提升模型泛化能力。
Related Work
Exposure Correction
-
随着深度神经网络(DNN)的兴起,曝光校正已经出现了一系列基于DNN的利用不同概念的方法。对于曝光不足的图像增强,已经提出了受retinex理论启发的方法。基于Retinex的模型,如CMEC 也纳入了注意力机制,以解决多重曝光校正,而LCDPNet 引入了一种新的局部颜色分布的重点。为了支持多重曝光校正任务,MSEC 和SICE 等专用数据集被开发用于训练和评估。MSEC进一步引入了拉普拉斯金字塔结构来处理不同的暴露水平。ENC 提供了一个曝光归一化模块,通过将不同的曝光特征转换到一个曝光不变的特征空间来细化特征图。CSNorm 还通过选择性归一化亮度敏感通道增强了模型的泛化能力,ERL 提出通过正则化技术进行曝光关系学习,以进行多重曝光校正。
-
最近有几项研究强调基于物理特征的特征分离。ECLNet 使用双边激活机制来调整不同暴露条件下的处理,而FECNet 提出了一个轻量级模型,该模型利用基于傅立叶的方法利用空间频率交互。CLODE 还利用图像曲线调整,并通过使用神经ode的连续曲线图提取来制定亮度变化。最新的进展,CSEC ,通过定义变暗和变亮的特征地图解决了颜色分布的变化。
Slot Attention
-
Slot Attention 【Objectcentric learning with slot attention】是一种用于聚类对应于槽的特征的机制,槽是以对象为中心的学习(OCL)的主要对象。具体而言,这种机制迭代地使用具有关注系数的点积关注来更新Slot,其在关注过程中起到查询的作用。通过多轮循环注意,槽注意在OCL中实现了有效的聚类和特征分离,而不需要注释。
-
如SCOUTER 所见,时隙注意已经有效地应用于图像分类,其使用基于时隙注意的分类器进行可解释的识别。在分割中,槽注意力已被证明对视频分割特别有价值。例如,GSANet 利用槽注意力将视频帧中的中心对象与背景元素分开。
-
在重建和恢复任务中,Slot-VAE 将 Slot Attention 与分层变分自动编码器(VAE)框架相集成,增强了以对象为中心的场景生成。此外,AID 采用时隙注意来捕获光源色度的隐式表示,每个时隙向量捕获特定光源的特征。这使得AID能够为每个光源生成精确的色度和权重图。在本文中,我们利用 Slot Attention 以无监督的方式分割曝光校正。这允许我们的方法训练每个槽来捕获特征相关的曝光表示,并且有效地隐含地聚类特征以进行曝光校正,而不需要注释。
Prompt-Based Learning
- 基于提示的学习方法首先由[Language models are few-shot learners]提出,提出了优化输入提示的概念。这种方法在自然语言处理领域很受欢迎,激发了许多后续研究。CoOp 引入了一种新的方法,将提示上下文视为可学习的参数,超越了局限于固定格式提示的方法,并证明了可学习的提示可以优于手工制作的提示。在CoOp的基础上,开发了几种动态生成合适提示的方法。
- 例如,CODA 生成适合特定输入的提示,而 HyperPrompt 通过使用提示生成器来处理多任务学习。在计算机视觉领域,视觉提示包括添加可训练参数以修改输入,从而实现高效的模型适应。VPT 通过对固定 Transformer 主干应用视觉提示,展示了优于传统微调方法的显著性能提升。此外,提出了与输入图像兼容的视觉提示,特别针对剪辑进行了优化。对于低级视觉任务,PromptIR 和PromptRestorer 等方法利用提示来编码退化特定信息,指导恢复网络适应各种类型和强度的退化。在我们的方法中,我们引入了曝光特定的提示来指导特征分离,并生成针对不同曝光特征而特别定制的区域感知特征。
Proposed Method
Overall Flow
-
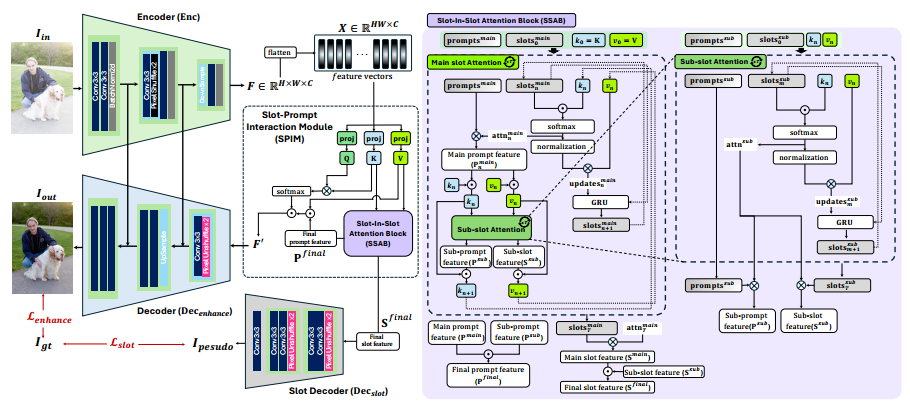
如图2所示,所提出的 Exposure-slot 架构是一个U形残差网络,由通过残差连接和槽提示交互模块(SPIM)连接的编码器-解码器结构组成。
-
-
图二。Exposure-Slot 概述:Exposure-Slot 在U形编码器-解码器网络中运行,槽提示交互模块(SPIM)连接编码器和解码器级。在SPIM,时隙-时隙注意块(SSAB)自适应地划分区域并产生提示特征以增强特征表示。此外,在训练期间使用槽解码器(Decslot)来重建目标的槽特征。这确保了槽注意力图捕捉以暴露为中心的信息,帮助提示学习每个相应槽内的增强的相关信息。
-
-
首先,编码器处理曝光不良的输入图像Iin以产生潜在特征表示 F ∈ R H × W × C F ∈ \R^{H×W×C} F∈RH×W×C,如 F = E n c ( I i n ) F = Enc(I_{in}) F=Enc(Iin)。然后,位于编码器和解码器之间的SPIM使用由时隙中时隙注意机制引导的输入特定的区域感知提示来改进编码器输出F。细化的潜在特征F’随后被传递到图像解码器( D e c e n h a n c e Dec_{enhance} Decenhance ),图像解码器对其进行处理,以产生具有良好增强的曝光的输出图像Iout。
-
class Slot_model(nn.Module): def __init__(self, cfg, use_slot=True): super(Slot_model, self).__init__() # 设备设置 self.device = cfg.device # 均方误差损失函数 self.mse_loss = nn.MSELoss() self.use_slot = use_slot # 特征维度 self.dim = 32 # 下采样层 self.downsample1 = Downsample(self.dim) self.downsample2 = Downsample(self.dim*2) # 上采样层 self.upsample1 = Upsample(self.dim*4) self.upsample2 = Upsample(self.dim*2) # 批量归一化层 self.batchnorm1 = nn.BatchNorm2d(self.dim) self.batchnorm2 = nn.BatchNorm2d(self.dim*2) self.batchnorm3 = nn.BatchNorm2d(self.dim*4) # 激活函数 self.activation = nn.GELU() self.sigmoid = nn.Sigmoid() # 卷积层 self.conv1_1 = nn.Conv2d(3, self.dim, 3, padding=1) self.conv1_2 = nn.Conv2d(self.dim, self.dim, 3, padding=1) self.conv2_2 = nn.Conv2d(self.dim*2, self.dim*2, 3, padding=1) self.conv3_2 = nn.Conv2d(self.dim*4, self.dim*4, 3, padding=1) self.conv4_1 = nn.Conv2d(self.dim*4, self.dim*2, 3, padding=1) self.conv4_2 = nn.Conv2d(self.dim*2, self.dim*2, 3, padding=1) self.conv5_1 = nn.Conv2d(self.dim*2, self.dim, 3, padding=1) self.conv5_2 = nn.Conv2d(self.dim, self.dim, 3, padding=1) self.conv6 = nn.Conv2d(self.dim, 3, 1) # 槽数量 self.slot_num = 3 self.subslot_num = 7 # 槽中槽注意力模块 self.TransformerBlock = IGAB(dim=self.dim*4, num_blocks=1, dim_head=self.dim*4, num_slots=self.slot_num, num_subslots=self.subslot_num, heads=1) # 槽解码器 self.slot_decoder = Slot_Decoder(hid_dim=self.dim*4) self.conv_fusion = nn.Conv2d(self.dim*8, self.dim*4, 3, padding=1) def forward(self, x, gt, inference=False): B, C, H, W = x.shape dH = H%4 dW = W%4 if dH!=0 or dW!=0: # 调整输入图像尺寸 x = F.interpolate(x, (H - dH, W - dW),mode="bilinear") gt = F.interpolate(gt, (H - dH, W - dW),mode="bilinear") x_input = x x_gt = gt # 编码器部分 # 第一层卷积 x = self.activation(self.conv1_1(x)) conv1 = self.batchnorm1(self.conv1_2(x)) # 第一次下采样 conv2 = self.activation(self.downsample1(conv1)) conv2 = self.batchnorm2(self.conv2_2(conv2)) # 第二次下采样 conv3 = self.activation(self.downsample2(conv2)) conv3 = self.batchnorm3(self.conv3_2(conv3)) B3, C3, H3, W3 = conv3.shape # 槽中槽注意力模块 feature_i, attn_maps, slot_features, slots_cossim_list = self.TransformerBlock(conv3) if inference == 1: recon_slot = x_gt else: # 槽解码器 recon_slot = self.slot_decoder(slot_features) # 解码器部分 # 第一次上采样 conv4 = self.upsample1(feature_i) up4 = torch.cat([conv4, conv2], 1) up4 = self.activation(self.conv4_1(up4)) up4 = self.activation(self.conv4_2(up4)) # 第二次上采样 conv5 = self.upsample2(up4) up5 = torch.cat([conv5, conv1], 1) up5 = self.activation(self.conv5_1(up5)) up5 = self.activation(self.conv5_2(up5)) # 输出 output = self.conv6(up5) + x_input if dH!=0 or dW!=0: # 调整输出图像尺寸 output = F.interpolate(output, (H, W),mode="bilinear") recon_slot = F.interpolate(recon_slot, (H, W),mode="bilinear") x_gt = F.interpolate(x_gt, (H, W),mode="bilinear") # 特征损失 feature_loss = self.mse_loss(recon_slot, x_gt) return output, recon_slot, feature_loss -
输入:
x是输入图像,维度为(B, 3, H, W),其中B是批量大小,3是通道数,H和W是图像的高度和宽度。 -
编码器:第一层卷积:
conv1维度为(B, dim, H, W),第一次下采样:conv2维度为(B, dim*2, H/2, W/2),第二次下采样:conv3维度为(B, dim*4, H/4, W/4)。槽中槽注意力模块:输入conv3维度为(B, dim*4, H/4, W/4),输出feature_i、attn_maps、slot_features和slots_cossim_list。解码器第一次上采样:conv4维度为(B, dim*2, H/2, W/2),第二次上采样:conv5维度为(B, dim, H, W)。 -
def main(level=3, dataset='SICE', gpu_num='0'): np.random.seed(999) seed_torch(42) cfg = ConfigBasic() cfg = set_local_config(cfg, level, dataset, gpu_num) cfg.logfile = log_configs(cfg, log_file='train_log.txt') # 数据加载 loader_dict = get_datasets(cfg) # 模型初始化 if level == 2: model = Slot_model_level2(cfg) elif level == 3: model = Slot_model_level3(cfg) else: print("Please check level again.") # 优化器设置 if cfg.adam: optimizer = optim.Adam(model.parameters(), lr=cfg.learning_rate) else: optimizer = optim.SGD(model.parameters(), lr=cfg.learning_rate, momentum=cfg.momentum, weight_decay=cfg.weight_decay) # 学习率调度器设置 if cfg.scheduler == 'cosine': scheduler = optim.lr_scheduler.CosineAnnealingLR(optimizer, cfg.epochs, eta_min=cfg.learning_rate*0.001) elif cfg.scheduler == 'multistep': scheduler = optim.lr_scheduler.MultiStepLR(optimizer, milestones=cfg.lr_decay_epochs, gamma=cfg.lr_decay_rate) if torch.cuda.is_available(): if cfg.n_gpu > 1: model = nn.DataParallel(model) model = model.to(cfg.device) cudnn.benchmark = True # 初始化损失记录 loss_record = dict() for epoch in range(cfg.epochs): print("==> training...") time1 = time.time() # 训练一个 epoch train_loss, loss_record = train(cfg, epoch, loader_dict[train_data], model, optimizer, prev_loss_record=loss_record) if cfg.scheduler: scheduler.step() time2 = time.time() print('epoch {}, loss {:.4f}, total time {:.2f}'.format(epoch, train_loss, time2 - time1)) # 验证 if (epoch+1) % cfg.val_freq == 0: print('==> validation...') val_psnr, val_ssim = validate(loader_dict, model, cfg) save_ckpt(cfg, model, f'ep_{epoch}_val_psnr_{val_psnr:.2f}_val_ssim_{val_ssim:.4f}.pth') if cfg.dataset == 'MSEC': save_ckpt(cfg, model, f'ep_{epoch}.pth') print('[*] Training ends') -
模型根据
level参数选择Slot_model_level2或Slot_model_level3。模型采用编码器 - 解码器结构,中间加入槽中槽注意力模块进行特征划分和学习。
-
Slot-Prompt Interaction Module (SPIM)
-
SPIM被设计为 Slot-in-Slot Attention 块(SSAB)和随后的交叉注意过程的组合。SPIM最初将F投射到查询、键和值表示中,而SSAB接收键和值来估计F的相应提示特征具体而言,SSAB分层地应用槽注意来实现由粗到细的区域分离,这支持有效的曝光校正。则派生的提示特征用作涉及查询、键和值表示的交叉关注步骤中的条件元素。
-
具体地,如图2所示,编码特征 F ∈ R H × W × C F ∈ \R^{H×W×C} F∈RH×W×C 首先被展平成 X ∈ R H W × C X ∈ \R^{HW×C} X∈RHW×C。随后,X 通过线性投影 WQ、WK和WV 被投影成查询 Q ∈ R H W × C Q ∈ \R ^{HW×C} Q∈RHW×C、key K ∈ R H W × C K ∈ \R ^{HW×C} K∈RHW×C 和 value V ∈ R H W × C V ∈ \R^{HW×C} V∈RHW×C,如下:
-
KaTeX parse error: Undefined control sequence: \label at position 2: \̲l̲a̲b̲e̲l̲ ̲{eq:input_linea…
-
在我们的SSAB中,K和V用于生成提示特征 P f i n a l P^{final} Pfinal,该提示特征 P f i n a l P^{final} Pfinal 用作后续交叉注意过程的条件,以生成如下的细化特征图 F ′ ∈ R H × W × C F′∈\R^{H×W×C} F′∈RH×W×C:
-
KaTeX parse error: Undefined control sequence: \label at position 119: …{P}^{final})), \̲l̲a̲b̲e̲l̲ ̲{eq:SPAM_output…
-
其中d表示自适应缩放矩阵乘法的可学习参数。
-
-
连接编码器与解码器,通过槽注意力和提示机制优化特征表示。Slot-in-Slot Attention Block(SSAB):基于 Slot Attention,通过层次化迭代更新主槽和子槽的注意力图,将图像按曝光程度分区。主槽对应 Retinex 理论中的全局光照估计,子槽对应局部反射光调整。交叉注意力机制:提示向量与槽特征通过交叉注意力融合,类似自然语言处理中的提示学习,引导模型关注特定曝光区域的校正需求。
Slot-in-Slot Attention Block (SSAB)
-
在所提出的SPIM内的 Slot-in-Slot Attention Block 中,我们通过集成分层结构的时隙机制来生成细化的特征图,该时隙机制以分层和迭代的方式划分具有不同暴露水平的区域,具有专门针对不同暴露特征定制的学习提示。
-
例如,在2-level slot-in-slot structure 中,第一级使用相对较少数量的槽来划分具有相似曝光特性的区域。在这些结果的基础上,第二层使用更多的槽来更精细地聚集区域。通过反复重复该过程,子时槽逐渐了解不同曝光区域的更精细的细节。值得注意的是,分级结构可以扩展到两个级别之外,从而能够以更高的精度识别以暴露为中心的特征图。接下来,我们引入曝光特定的提示,通过针对不同的区域曝光特征,乘以来自槽注意机制的注意图,来增强图像。由于注意力图识别具有不同曝光水平的区域,因此将它们与特定曝光提示相乘会生成区域感知指导,从而实现平衡的曝光校正。
-
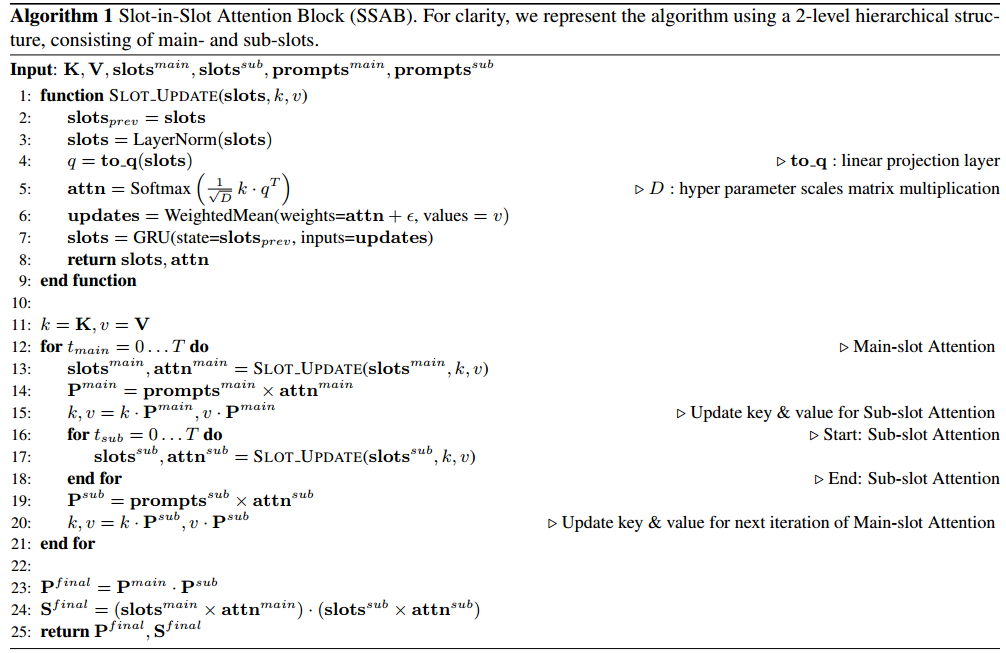
在 算法1中,提供了用于这种2级槽中槽结构的伪代码,通过两个嵌套循环(外部循环和内部循环)来提炼key (k)和值(v)。外部循环更新主槽,然后将主槽与提示相结合以细化k和v。在内部循环中,细化的k和v用于更新子槽,子槽进一步与提示相结合以细化k和v的细节。重复这个过程,直到外部循环完成。值得注意的是,为了更新槽,我们采用了[Objectcentric learning with slot attention]中介绍的槽更新功能。关键区别在于,每次循环迭代都使用更新后的k和v作为输入。
-
Main-slot Attention,在Alg 1中的外圈。我们执行主槽注意来更新主槽(slots-main ),这表示分级槽结构的第一级。值得注意的是, s l o t s m a i n ∈ R K m a i n × D s l o t m a i n slots^{main} ∈ \R ^{K^{main}×D^{main}_{slot}} slotsmain∈RKmain×Dslotmain,其中 K m a i n 和 D s l o t m a i n K^{main} 和D^{main}_{slot} Kmain和Dslotmain分别表示槽的数量和每个槽的维数,可以用可学习的参数初始化。
-
首先,给定来自编码器的K和V,分别分配给K和V,我们使用时隙更新函数更新时隙,如下所示:
-
s l o t s m a i n , a t t n m a i n = S L O T _ U P D A T E ( s l o t s m a i n , k , v ) , ( 3 ) { \mathbf {slots}^{main}, \mathbf {attn}^{main} = \mathbf {SLOT\_UPDATE}(\mathbf {slots}^{main}, k, v), } (3) slotsmain,attnmain=SLOT_UPDATE(slotsmain,k,v),(3)
-
其中 a t t n m a i n attn^{main} attnmain 表示每个 s l o t s m a i n slots^{main} slotsmain 的被关注区域。然后,注意力图attnmain用于产生提示特征Pmain,如下:
-
KaTeX parse error: Undefined control sequence: \label at position 2: \̲l̲a̲b̲e̲l̲ ̲{eq:MainPrompt_…
-
其中, p r o m p t s m a i n ∈ R K m a i n × D s l o t m a i n prompts^{main} ∈ \R ^{K^{main}×D^{main}_{slot}} promptsmain∈RKmain×Dslotmain 表示针对每个暴露特征定制的可学习提示。因此,通过将特定于曝光的提示与包含不同曝光区域信息的注意力图相乘,我们的提示特征Pmain有效地封装了以曝光为中心和区域感知的信息。最后,提示特征Pmain用于更新 key 和 value,如下所示:
-
KaTeX parse error: Undefined control sequence: \label at position 2: \̲l̲a̲b̲e̲l̲ ̲{eq:Mainslot_up…
-
并且得到的k和v被用作后续内环过程的输入,称为Sub-slot Attention。
-
-
Sub-slot Attention ,在Alg 1中的内循环中。我们执行子时槽注意以更新子时槽(slotssub ),它表示分级结构的第二级。特别是 s l o t s s u b ∈ R K s u b × D s l o t s u b slots^{sub} ∈ \R ^{K^{sub}×D^{sub}_{slot}} slotssub∈RKsub×Dslotsub,其中slotssub也使用可学习的参数初始化。这里,Ksub表示子槽的数量,Dsub slot表示它们的维数,Ksub被配置为确保更精细的特征分离。
-
首先,更新的 k 和 v 从主槽注意Eq.5用于通过时隙更新功能更新slotssub。类似于Eq.3,子时槽注意事项更新如下:
-
s l o t s s u b , a t t n s u b = S L O T _ U P D A T E ( s l o t s s u b , k , v ) , ( 6 ) \mathbf {slots}^{sub}, \mathbf {attn}^{sub} = \mathbf {SLOT\_UPDATE}(\mathbf {slots}^{sub}, k, v), (6) slotssub,attnsub=SLOT_UPDATE(slotssub,k,v),(6)
-
其中attnsub表示每个slotssub的关注区域,并且该更新过程重复T次迭代。随后,attnsub用于从子时隙注意中获得子提示特征Psub,如下所示:
-
P s u b = p r o m p t s s u b × a t t n s u b , ( 7 ) \mathbf {P}^{sub} = \mathbf {prompts}^{sub} \times \mathbf {attn}^{sub}, (7) Psub=promptssub×attnsub,(7)
-
其中 p r o m p t s s u b ∈ R K s u b × D s l o t s u b prompts^{sub} ∈ \R ^{K^{sub}×D^{sub}_{slot}} promptssub∈RKsub×Dslotsub 也是可学习的参数,适用于子槽注意中的每个曝光特性。最后,通过将Psub乘以 k 和 v,我们将来自子时隙注意的信息传递给主时隙注意的下一次迭代,如下所示:
-
k , v = k ⋅ P s u b , v ⋅ P s u b . ( 8 ) k, v = k \cdot \mathbf {P}^{sub}, v \cdot \mathbf {P}^{sub}. (8) k,v=k⋅Psub,v⋅Psub.(8)
-
-
总之,主槽注意的结果被集成到子槽注意中,并且来自子槽注意的输出被迭代地反馈到主槽注意循环中。这个互补的更新过程重复T次。在SSAB结束时,最终输出 P f i n a l P^{final} Pfinal 和 S f i n a l S^{final} Sfinal 最终如下获得:
-
P f i n a l = P m a i n ⋅ P s u b , S f i n a l = ( s l o t s m a i n × a t t n m a i n ) ⋅ ( s l o t s s u b × a t t n s u b ) . ( 9 ) \begin {split} \mathbf {P}^{final} &= \mathbf {P}^{main} \cdot \mathbf {P}^{sub}, \\ \mathbf {S}^{final} &= (\mathbf {slots}^{main} \times \mathbf {attn}^{main}) \cdot (\mathbf {slots}^{sub} \times \mathbf {attn}^{sub}). \end {split} (9) PfinalSfinal=Pmain⋅Psub,=(slotsmain×attnmain)⋅(slotssub×attnsub).(9)
-
请注意, P f i n a l P^{final} Pfinal 与Q、K和V集成在一起,如等式2所示。并用于解码最终输出。同时, S f i n a l S^{final} Sfinal 用作独立解码器的输入,以促进时隙训练。
-
-
实现曝光区域的层次化聚类与特征 refinement。主槽注意力(Main-slot Attention):初始分区曝光区域,如区分过曝的天空与欠曝的地面。子槽注意力(Sub-slot Attention):在主槽基础上进一步细化,例如将天空区域中的云层与晴空分开。迭代更新:通过 GRU 迭代优化槽特征,类似传统图像处理中的多尺度分解,但通过深度学习自适应学习权重。
-
槽数量( K m a i n , K s u b K_{main} , K_{sub} Kmain,Ksub), K m a i n = 3 K_{main}=3 Kmain=3(主槽数量), K s u b = 7 K_{sub}=7 Ksub=7(子槽数量)。 K m a i n K_{main} Kmain 决定初始分区的粒度,3 个主槽可大致区分欠曝、正常、过曝区域。 K s u b K_{sub} Ksub 控制子槽的细化程度,7 个子槽可捕捉更复杂的局部曝光差异(如同一区域内的明暗变化),过多会增加计算量,过少则细化不足。
-
class Slot_model(nn.Module): def __init__(self, cfg, use_slot=True): super(Slot_model, self).__init__() # ... 其他初始化代码 self.slot_num = 3 self.subslot_num = 7 self.TransformerBlock = IGAB(dim=self.dim*4, num_blocks=1, dim_head=self.dim*4, num_slots=self.slot_num, num_subslots=self.subslot_num, heads=1) self.slot_decoder = Slot_Decoder(hid_dim=self.dim*4) -
设置了模型的各种参数,如卷积层、归一化层、激活函数等,同时定义了槽的数量(
slot_num、subslot_num等)以及槽注意力模块(TransformerBlock)和槽解码器(slot_decoder)。前向传播部分:实现了模型的前向传播逻辑,包括编码器、槽注意力模块、解码器和损失计算。 -
def forward(self, x, gt, inference=False): # ... 编码器部分代码 feature_i, attn_maps, slot_features, slots_cossim_list = self.TransformerBlock(conv3) if inference == 1: recon_slot = x_gt else: recon_slot = self.slot_decoder(slot_features) # ... 解码器部分代码 feature_loss = self.mse_loss(recon_slot, x_gt) return output, recon_slot, feature_loss -
配置文件config/basic.py文件中定义了ConfigBasic` 类,用于设置训练所需的各种参数,包括数据集、优化器、调度器、训练选项等。
-
class ConfigBasic:
    def __init__(self,):
        self.dataset = None
        self.setting = None
        # ... 其他初始化代码
        self.set_optimizer_parameters()
        self.set_training_opts()
    def set_dataset(self):
        if self.dataset == 'SICE':
            # ... SICE 数据集配置
        elif self.dataset == 'MSEC':
            # ... MSEC 数据集配置
        elif self.dataset == 'LCDP':
            # ... LCDP 数据集配置
        else:
            raise ValueError(f'{self.dataset} is out of range!')
    def set_optimizer_parameters(self):
        # ... 优化器和调度器参数设置
    def set_training_opts(self):
        # ... 训练选项设置
-
Decoder Process
-
来自SPIM的细化特征 F’ 和时隙 S f i n a l S^{final} Sfinal 被用作最终解码过程的输入。具体地,我们的 Exposure-slot 使用增强特征 F’ 来预测通过解码器的增强图像,如下:
-
I o u t = D e c e n h a n c e ( F ′ ) , ( 10 ) I_{out} = \mathbf {Dec}_{enhance}(F'), (10) Iout=Decenhance(F′),(10)
-
其中,Decenhance为图像解码器,Iout为最终曝光增强输出。同时,使用时隙重构解码器将 S f i n a l S^{final} Sfinal 解码成伪校正图像:
-
I p s e u d o = D e c s l o t ( S f i n a l ) , ( 11 ) I_{pseudo} = \mathbf {Dec}_{slot}(\mathbf {S}^{final}), (11) Ipseudo=Decslot(Sfinal),(11)
-
其中Decslot表示槽重构解码器,Ipseudo是得到的伪校正的RGB图像。这种训练策略鼓励每个时间段专注于以暴露为中心的学习,类似于中使用的set预测方法。重要的是要注意,时隙重构解码器仅在训练期间使用,而在推断期间并不需要。
-
-
仅在训练阶段使用,将槽特征重建为伪校正图像,强制槽特征捕捉曝光相关信息,类似自监督学习中的重建损失。通过重建约束,确保槽注意力图准确反映曝光区域,与 Retinex 理论中光照分量的估计目标一致。
Loss functions
-
使用两个损失函数训练曝光槽:图像增强损失 L e n h a n c e L_{enhance} Lenhance 和槽重建损失Lslot。总体训练目标是最小化组合损失,促进精确的图像增强和有效的基于狭缝的重建。
-
图像增强损失。图像增强损失Lenhance使用曝光增强图像Iout和 GT 图像Igt之间的L1距离定义如下:
- L e n h a n c e = ∣ ∣ I o u t − I g t ∣ ∣ 1 . ( 12 ) \mathcal {L}_{enhance} = ||I_{out} - I_{gt}||_1. (12) Lenhance=∣∣Iout−Igt∣∣1.(12)
-
槽重建损失。使用L1距离类似地定义槽重建损失Lslot,但是在由槽重建解码器生成的伪校正图像Ipseudo和 GT 图像 Igt 之间,如下:
- L s l o t = ∣ ∣ I p s e u d o − I g t ∣ ∣ 1 . ( 13 ) \mathcal {L}_{slot} = ||I_{pseudo} - I_{gt}||_1. (13) Lslot=∣∣Ipseudo−Igt∣∣1.(13)
-
最终目标函数 L f i n a l L^{f inal} Lfinal 定义为两个损失的总和:
- L f i n a l = L e n h a n c e + L s l o t . ( 14 ) \mathcal {L}_{final} = \mathcal {L}_{enhance} + \mathcal {L}_{slot}. (14) Lfinal=Lenhance+Lslot.(14)
-
class GELU(nn.Module): def forward(self, x): return F.gelu(x) class BiasFree_LayerNorm(nn.Module): def __init__(self, normalized_shape): super(BiasFree_LayerNorm, self).__init__() if isinstance(normalized_shape, numbers.Integral): normalized_shape = (normalized_shape,) normalized_shape = torch.Size(normalized_shape) assert len(normalized_shape) == 1 self.weight = nn.Parameter(torch.ones(normalized_shape)) self.normalized_shape = normalized_shape def forward(self, x): sigma = x.var(-1, keepdim=True, unbiased=False) return x / torch.sqrt(sigma+1e-5) * self.weight class WithBias_LayerNorm(nn.Module): def __init__(self, normalized_shape): super(WithBias_LayerNorm, self).__init__() if isinstance(normalized_shape, numbers.Integral): normalized_shape = (normalized_shape,) normalized_shape = torch.Size(normalized_shape) assert len(normalized_shape) == 1 self.weight = nn.Parameter(torch.ones(normalized_shape)) self.bias = nn.Parameter(torch.zeros(normalized_shape)) self.normalized_shape = normalized_shape def forward(self, x): mu = x.mean(-1, keepdim=True) sigma = x.var(-1, keepdim=True, unbiased=False) return (x - mu) / torch.sqrt(sigma+1e-5) * self.weight + self.bias class LayerNorm(nn.Module): def __init__(self, dim, LayerNorm_type='WithBias'): super(LayerNorm, self).__init__() if LayerNorm_type =='BiasFree': self.body = BiasFree_LayerNorm(dim) else: self.body = WithBias_LayerNorm(dim) def forward(self, x): h, w = x.shape[-2:] return to_4d(self.body(to_3d(x)), h, w) -
定义了激活函数
GELU和不同类型的层归一化层,用于稳定模型训练。 -
class FeedForward(nn.Module): def __init__(self, dim, mult=4): super().__init__() self.net = nn.Sequential( nn.Conv2d(dim, dim * mult, 1, 1, bias=False), GELU(), nn.Conv2d(dim * mult, dim * mult, 3, 1, 1, bias=False, groups=dim * mult), GELU(), nn.Conv2d(dim * mult, dim, 1, 1, bias=False),) def forward(self, x): out = self.net(x.permute(0, 3, 1, 2)) return out.permute(0, 2, 3, 1) -
前馈网络用于对特征进行非线性变换,增强模型的表达能力。
Experiments
Experimental Setup
-
实施细节。我们使用Adam优化器训练我们的模型,β1 = 0.9,β2 = 0.999,使用256×256的补丁大小和16的批量大小。学习率设置为2×10⁴,训练进行500个周期。此外,参数Kmain和Ksub分别被设置为3和7。
-
数据集和比较方法。我们的训练和基准设置符合现有暴露纠正任务的既定标准。我们在三个多曝光数据集上训练我们的网络:单图像对比度增强(SICE) ,多尺度曝光校正(MSEC) 和LCDP 。
-
我们将我们的曝光槽与现有的最先进的曝光校正方法进行比较,包括LCPDNet 、ERL 、ENC 、DA 、ECLNet 、FECNet 和CSEC 。在PromptIR 中,提示的数量被设置为与每个数据集中暴露值的数量相匹配:2个用于SICE,5个用于MSEC,2个用于LCDP。使用峰值信噪比(PSNR)和结构相似性(SSIM)度量进行评估。
Performance Evaluation
-
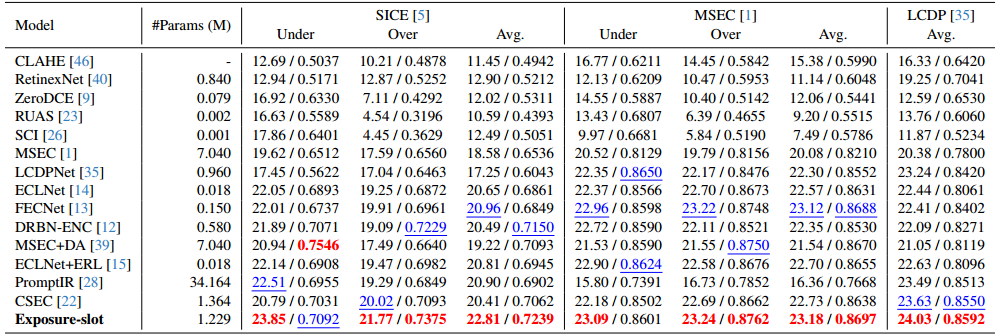
表1显示了我们的方法在三个代表性的多重暴露数据集上的性能:SICE ,MSEC 和LCDP 。在SICE数据集上,我们的方法实现了最高的整体性能,除了曝光不足条件下的一个SSIM值,它排名第二。类似地,对于MSEC数据集,曝光槽持续优于之前在PSNR和SSIM的方法,在所有情况下都取得了最高分,除了SSIM的曝光不足。在LCDP数据集上,我们的方法也表现出优越的性能,超过了CSEC 。与之前最先进的方法相比,我们的方法在PSNR的SICE数据集上显示了1.85 dB的显著增益,在LCDP数据集上与CSEC 相比显示了0.4 dB的显著增益,凸显了其强大的性能优势。
-
-
表1. 根据PSNR↑/SSIM↑,对SICE 、MSEC 和LCDP 的定量结果。最好的分数用红色显示,第二个用蓝色显示。此外,还指定了推理所需的参数数量(#Params)。与之前的SOTA方法相比,Exposure-slot是轻量级的,同时在所有数据集上的平均表现始终优于它。
-
-
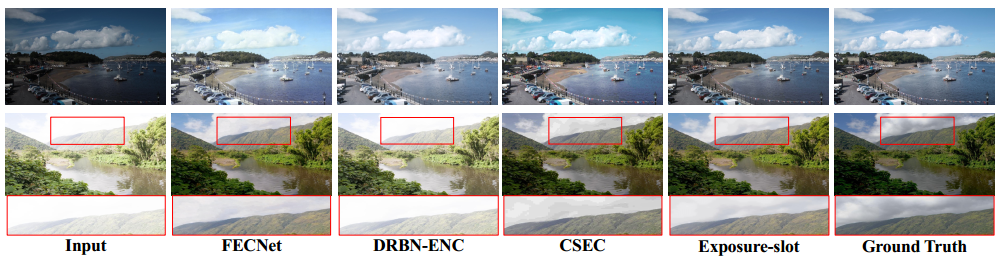
图3显示了在SICE 和MSEC 数据集上的定性比较,展示了我们的模型相对于其他曝光校正方法的性能。在曝光不足的条件下,Exposure-slot实现了出色的色彩保真度和细节恢复,与地面真实情况非常接近,没有过度的亮度或色彩失真,这与其他模型不同。在过度曝光的区域,放大的视图揭示了其他模型,特别是CSEC ,由于过度校正而产生伪像和颜色不一致。相比之下,Exposure-slot保持了稳定的色彩还原和纹理增强,保留了自然的细节和色彩和谐。这些结果突出了曝光槽处理各种曝光条件的能力,在复杂的曝光校正任务中实现了最先进的性能。
-
-
图3。在SICE 和MSEC 数据集上的定性比较(FECNet ,ENC ,CSEC )。曝光不足条件下增强的图像示例(上图)和曝光过度条件下增强的图像示例(下图)。
-
-
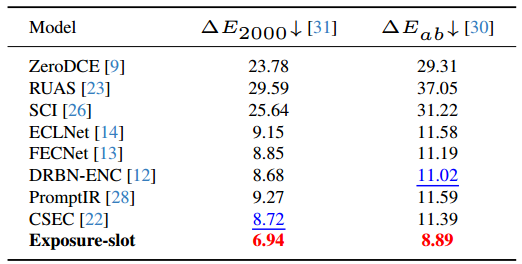
此外,为了评估色彩校正性能,我们在LAB色彩空间中使用E2000 和Eab 指标进行了比较。表2给出了结果,表明我们的方法在颜色校正方面也很出色。与之前的先进方法相比,Exposure-slot在E2000中的性能提高了1.78,在Eab中的性能提高了2.13。
-
-
表二。在SICE 数据集上与色差指标E2000 ↓和Eab ↓的比较。最高分用红色突出显示,次高分用蓝色标记。
-
-
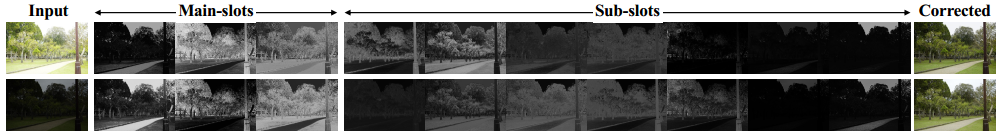
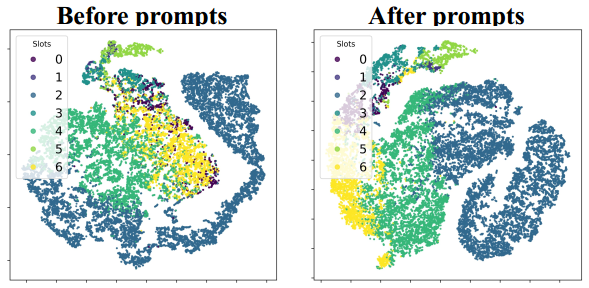
图4显示了SSAB预测的主时隙和子时隙的注意力图。这些结果表明,每个图有效地生成提示区域图,并且曝光槽利用该分割信息来实现同一场景的不同曝光条件下的鲁棒增强。在图5中,方程式中心室晚终的t-SNE显像。证明了我们的提示改进了聚类,并有效地促进了特征分离。值得注意的是,每个槽内改进的特征识别表明,该模型有效地捕获了特定暴露或基于区域的信息。关于注意力地图的进一步可视化和关于t-SNE的更多细节,请参考补充材料。
-
-
图4。slot attention maps (attn) of main- and sub-slot. 的可视化。它演示了如何通过槽注意机制有效地划分和细化以曝光为中心的特征,将输入图像转换为校正的输出。
-
-
图5。提示前后特征的t-SNE结果。来自相同子槽的特征用相同的颜色表示。有了提示,特征显示出更清晰的分离。
-
Ablation Study
-
在本节中,我们进行消融研究,以评估 Exposure-slot 的有效性,以及模型配置和结构水平。
-
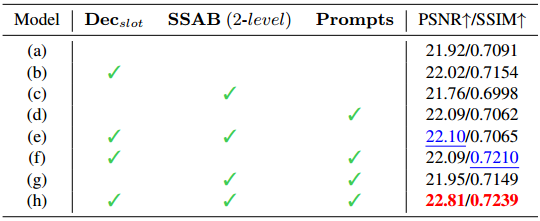
拟议模块的有效性。本节通过消融研究评估SSAB、Decslot和prompts的有效性。表3显示了SICE 数据集上每个消融病例的结果。具体来说,没有SSAB (2级)的配置指的是具有由7个插槽(即仅主插槽)组成的单级SSAB。没有提示的配置直接使用插槽功能最终在等式2中交叉注意。
-
-
表3。提议模块的消融研究。
-
-
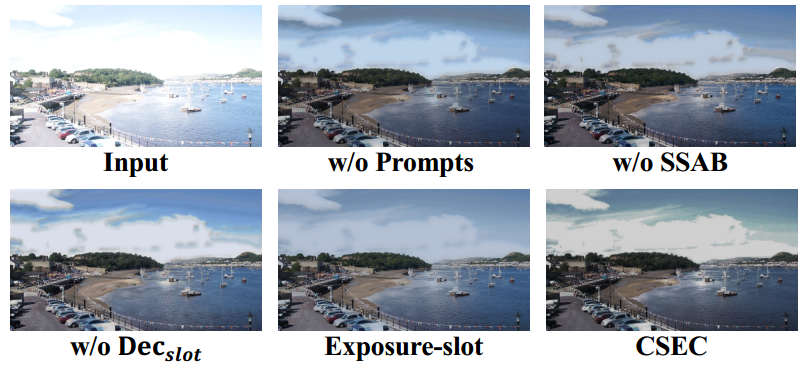
首先,在有和没有Decslot的情况之间的比较显示了当包括Decslot时一致的性能改进。该结果表明,训练深度槽有助于深度槽更准确地识别和表示具有不同曝光特性的区域,从而提高性能。当采用SSAB(型号(e)和(h))与Decslot一起使用时,也显示出显著的性能改进。关于提示,虽然与模型(a)相比,模型(d)显示SSIM略有下降,但所有其他使用提示的情况都显示性能有所提高。值得注意的是,我们的完整模型(h)实现了最高的性能,强调了每个组件在增强模型性能中的重要性。在图6中,我们提供了CSEC 最先进方法的部分消融结果。
-
-
图6。消融研究的可视化。从左上开始,图像对应于表3中的(e)、(f)、(g)和(h),包括之前的SOTA方法CSEC 用于比较。
-
-
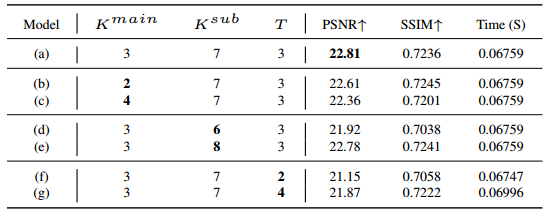
模型配置的调查。表4给出了SSAB内 main-slots(Kmain)、subslots(Ksub)和迭代次数(T)的消融研究,以评估它们对性能的影响。结果包括SICE 数据集上的PSNR和SSIM指标,运行时测量使用英伟达RTX 4090 GPU在单个844×1500 RGB图像上进行。在本分析中,我们通过将每个参数递增或递减1来改变Kmain、Ksub和T。基于PSNR值,Kmain = 3、Ksub = 7和T = 3的配置产生最高性能,因此被我们的方法选用。
-
-
表4。研究SICE 数据集上的槽数(Kmain,Ksub)和迭代次数(T)。
-
-
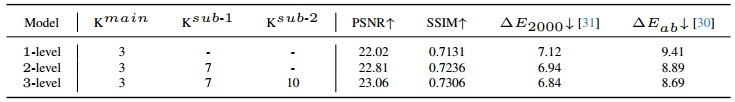
结构层次的有效性。在第3节中,我们使用两级SSAB结构作为默认配置。为了进一步研究SSAB的潜力,我们在SICE 数据集上使用1级和3级SSAB结构进行了实验,如表5所示。在3级配置中,我们将第二子时隙的数量设置为Ksub-2 = 10,从而与2级SSAB相比,PSNR和SSIM分别提高了0.25和0.07。这些结果表明,增加更多的SSAB水平可以提高性能。虽然添加额外的级别可以提高性能,但也会导致时间复杂度呈指数级增长。因此,考虑到这种权衡,我们采用2级SSAB作为默认结构。
-
-
表5。n能级SSAB的消融研究(n = 1,2,3)
-
Conclusion
-
在本文中,我们提出了一种新的曝光校正框架Exposure-slot,它将槽内注意力与可学习的提示相结合,以实现精确的、以曝光为中心的特征学习。通过分级聚类和细化曝光区域,Exposure-slot 有助于精确的区域感知调整,并在多个多重曝光基准上实现最先进的性能。我们的方法证明了在定量和定性指标方面的显著改进,突出了结构化注意机制对于挑战性暴露校正场景的有效性。此外,这项工作推进了曝光校正,并为在其他低级视觉任务中探索基于槽的架构铺平了道路。
-
Exposure-slot 通过融合 Slot Attention 的层次化聚类能力与可学习提示的自适应调整,将传统 Retinex 理论与深度学习的表征学习结合,实现了对复杂曝光场景的精准校正。其模块设计(SPIM、SSAB、Slot Decoder)分别对应曝光区域划分、特征细化与监督学习,参数设置(槽数量、迭代次数)则通过实验优化平衡了精度与效率。
-
对于 Exposure-slot,它的核心是使用 Slot-in-Slot Attention 和可学习提示来聚类曝光区域,分层处理特征。侧重点在区域感知的曝光校正,利用层次化的注意力机制,将图像按曝光程度分区,每个区域用对应的提示调整。算法思想结合了对象中心学习的 Slot Attention,扩展到曝光校正,通过主槽和子槽逐步细化分区。模型设计包括编码器 - 解码器、SPIM 模块、SSAB 块,以及损失函数中的重建损失。
-
IAT,强调轻量级,参数少,处理速度快。它分解 ISP 流程为局部和全局分支,局部用深度卷积,全局用 Transformer 查询控制 ISP 参数如色彩矩阵和伽马。侧重点在高效轻量,结合 ISP 理论和 Transformer,用全局查询调整色彩和伽马,局部调整亮度。模型设计是双分支结构,局部用 PEM 模块,全局用 GPM 生成参数,损失函数包括 L1 和感知损失。
-
CSEC 关注色彩偏移估计和校正,处理同时存在过曝和欠曝的图像。观察到过曝和欠曝区域色彩分布相反,提出 COSE 和 COMO 模块。算法思想是估计色彩偏移并分别校正,用伪正常特征作为参考。模型设计包括 UNet 提取特征,COSE 模块用变形卷积估计偏移,COMO 模块用交叉注意力调制色彩,损失函数包含 L1、余弦相似度、SSIM 和 VGG 损失。
- Exposure-slot 侧重区域分层和提示学习,IAT 侧重轻量和 ISP 参数调整,CSEC 侧重色彩偏移的分别处理。算法思想上,Exposure-slot 用层次化注意力,IAT 结合 ISP 与轻量 Transformer,CSEC 基于色彩分布偏移建模。模型设计上,各有不同模块,如 SSAB、SPIM vs PEM、GPM vs COSE、COMO。
-
Exposure-slot: 基于层次化槽注意力的区域感知曝光校正,区域自适应曝光聚类:通过分层槽注意力机制(Slot-in-Slot Attention)将图像按曝光程度划分为不同区域(如过曝、欠曝、正常区域),实现精细化的局部曝光校正。提示学习与特征优化:引入可学习提示(Prompts),根据各区域的曝光特性动态调整校正策略,提升复杂光照场景下的细节保留能力。
- Slot 更新:基于 GRU 的迭代更新(Algorithm 1),通过注意力图(attn)加权特征值(V),实现槽特征的动态优化。提示交互:主槽提示(P_main)与子槽提示(P_sub)通过注意力图相乘,生成最终提示(P_final),指导解码器调整区域亮度。
-
IAT: 轻量级 Transformer 驱动的 ISP 参数自适应调整,轻量级与高效推理:仅 90K 参数,处理速度 0.004s / 图像,适合移动端部署,同时兼顾低光增强与曝光校正。ISP 流程建模:将相机图像处理管线(ISP)分解为局部像素调整与全局参数(如色彩矩阵、伽马)优化,实现物理层面的光照校正。将 sRGB 图像生成过程拆解为 “原始数据→ISP 处理→目标图像”,通过估计 ISP 参数(如白平衡矩阵、伽马值)实现光照还原。
- 双分支协同优化:局部分支(Pixel-wise Enhancement Module, PEM)通过深度卷积调整像素级亮度(乘性图 M 与加性图 A)。全局分支(Global Prediction Module, GPM)用 Transformer 查询生成 ISP 参数,控制全局色彩与对比度。用深度卷积替代自注意力,减少计算量;引入 Light Normalization 优化低 - level 视觉任务适配性。
- Pixel-wise Enhancement Module (PEM):3×3 深度卷积 + 轻量归一化(LightNorm),保持分辨率的同时降低计算量。Global Prediction Module (GPM):基于 DETR 的查询机制,生成 9 维色彩矩阵和 1 维伽马,初始化身份矩阵确保训练稳定。
-
CSEC: 色彩偏移估计与分离校正的光照增强,针对过曝与欠曝区域色彩分布相反的特性,分别估计其与 “伪正常” 特征的偏移,实现色彩保真的光照校正。无参考区域引导:通过生成伪正常特征图(Pseudo-normal Feature)作为参考,解决无 “正常曝光” 像素的校正难题。
- 色彩分布逆向性:过曝像素偏红、欠曝像素偏绿,需分离校正;伪正常特征图作为中间参考,引导偏移估计。变形卷积的色彩空间扩展:将变形卷积从空间域扩展到色彩域,同时建模空间位置与色彩通道的偏移。跨注意力调制:通过交叉注意力机制融合输入图像与偏移特征,实现全局色彩协调。
- Color Shift Estimation (COSE) 模块:输入伪正常特征与亮 / 暗特征,通过三分支卷积生成空间偏移、色彩偏移与调制标量,实现色彩偏移的精确估计。色彩空间变形卷积公式: y = ∑ ( w n ⋅ x ( p 0 + p n + Δ p n ) + Δ c n ) ⋅ Δ m n y = \sum(w_n \cdot x(p_0+p_n+\Delta p_n) + \Delta c_n) \cdot \Delta m_n y=∑(wn⋅x(p0+pn+Δpn)+Δcn)⋅Δmn,同时调整空间位置与色彩值。Color Modulation (COMO) 模块:采用跨注意力机制,计算输入图像与偏移特征的亲和力矩阵,动态调制校正强度。融合亮 / 暗偏移特征与输入图像,生成最终校正结果。伪正常特征损失(L1)与输出损失(L1 + 余弦相似度 + SSIM+VGG)结合,确保色彩与结构的双重保真。
-
维度 Exposure-slot IAT CSEC 核心侧重点 区域分层曝光聚类与提示学习 轻量级 ISP 参数建模与高效推理 色彩偏移分离估计与无参考校正 算法思想 对象中心学习迁移至曝光区域划分 ISP 流程分解与双分支协同 色彩分布逆向性建模与变形卷积扩展 模型创新点 层次化槽注意力 + 交叉提示交互 轻量级 Transformer+ISP 参数生成 色彩空间变形卷积 + 跨注意力调制 典型模块 SSAB、SPIM PEM、GPM COSE、COMO 参数规模 1.229M 0.09M(90K) 0.30M -
IAT 的全局 ISP 建模解决亮度不均,Exposure-slot 的区域聚类处理局部曝光,CSEC 的色彩偏移校正弥补色偏,三者形成 “全局→局部→色彩” 的完整链条。
-
SlotAttention机制是论文的核心模块之一,它通过迭代更新槽(slots)来学习输入特征的不同部分。使用可学习的均值slots_mu初始化槽。通过多次迭代,计算槽与输入特征之间的注意力分数,并更新槽的表示。使用点积注意力机制计算槽与输入特征之间的注意力分数。使用 GRU 单元更新槽的表示,并通过前馈网络进行非线性变换。计算提示特征和槽特征。-
class SlotAttention(nn.Module): def __init__(self, num_slots, dim, iters = 3, eps = 1e-8, hidden_dim = 128): super().__init__() self.dim = dim self.num_slots = num_slots self.iters = iters self.eps = eps self.scale = dim ** -0.5 self.relu = nn.ReLU(inplace=True) self.slots_mu = nn.Parameter(torch.randn(1, self.num_slots, dim)) self.slots_logsigma = nn.Parameter(torch.zeros(1, 1, dim)) init.xavier_uniform_(self.slots_logsigma) self.prompts = nn.Parameter(torch.rand(1, self.num_slots, dim)) self.to_q = nn.Linear(dim, dim) self.gru = nn.GRUCell(dim, dim) hidden_dim = max(dim, hidden_dim) self.mlp = nn.Sequential( nn.Linear(dim, hidden_dim), nn.ReLU(inplace = True), nn.Linear(hidden_dim, dim) ) self.norm_input = nn.LayerNorm(dim) self.norm_k_inp = nn.LayerNorm(dim) self.norm_v_inp = nn.LayerNorm(dim) self.norm_slots = nn.LayerNorm(dim) self.norm_pre_ff = nn.LayerNorm(dim) def forward(self, inputs, q_inp, k_inp, v_inp): # [B, HW, C] b, n, d, device, dtype = *inputs.shape, inputs.device, inputs.dtype n_s = self.num_slots slots = self.slots_mu.repeat(b, 1, 1) prompts = self.prompts.repeat(b, 1, 1) k, v = self.norm_k_inp(k_inp), self.norm_v_inp(v_inp) for _ in range(self.iters): slots_prev = slots[:, :, :self.dim] slots = self.norm_slots(slots) q = self.to_q(slots) q_slot = q[:, :, :self.dim] q_prompt = q[:, :, self.dim:] dots = torch.einsum('bid,bjd->bij', q_slot, k) * self.scale attn = dots.softmax(dim=1) + self.eps attn_ = attn / attn.sum(dim=-1, keepdim=True) updates = torch.einsum('bjd,bij->bid', v, attn_) slots = self.gru( updates.reshape(-1, d), slots_prev.reshape(-1, d) ) slots = slots.reshape(b, -1, d) slots = slots + self.mlp(self.norm_pre_ff(slots)) prompt_feature = torch.einsum('bnd,bnp->bdp', prompts, attn) # [B, dim, HW]] slot_feature = torch.einsum('bnd,bnp->bdp', slots, attn) # [B, dim, HW]] return slots, attn, prompt_feature.permute(0, 2, 1), slot_feature.permute(0, 2, 1) -
嵌套 SlotAttention 机制,嵌套的
SlotAttention机制通过在每个槽中进一步划分亚槽,实现更精细的特征划分和学习。 -
class subsub_SlotAttention(nn.Module): # ... class sub_SlotAttention(nn.Module): def __init__(self, num_slots, num_subslots, dim, iters = 3, eps = 1e-8, hidden_dim = 128): # ... self.sub2_slot_attention = subsub_SlotAttention(num_slots=self.num_subslots, dim=self.dim) def forward(self, inputs, q_inp, k_inp, v_inp): # ... sub2_slots, sub2_prompts, sub2_slotfeature, sub2_promptfeature, sub2_attn = self.sub2_slot_attention(inputs * prompt_feature_.permute(0, 2, 1), q, k, v) # ... class Slot_in_slot_Attention(nn.Module): def __init__(self, num_slots, num_subslots, num_subsubslots, dim, iters = 3, eps = 1e-8, hidden_dim = 128): # ... self.sub_slot_attention = sub_SlotAttention(num_slots=self.num_subslots, num_subslots=self.num_subsubslots, dim=self.dim) def forward(self, inputs, q_inp, k_inp, v_inp): # ... sub_slots, sub_prompts, sub_slotfeature, sub_promptfeature, sub_attn, sub_slot_cossim = self.sub_slot_attention(inputs * prompt_feature_.permute(0, 2, 1), q, k, v) # ... -
IG_MSA和IGAB模块将多个Slot_in_slot_Attention模块组合在一起,实现多头注意力机制,并通过前馈网络进行特征融合。 -
class IG_MSA(nn.Module): def __init__( self, dim, dim_head=64, num_slots=3, num_subslots=3, num_subsubslots=7, heads=8, ): # ... slot_list = [] for i in range(heads): slot_list.append(Slot_in_slot_Attention(num_slots=self.num_slots, num_subslots = self.num_subslots, num_subsubslots = self.num_subsubslots, dim=self.dim_head)) self.slot_list = nn.Sequential(*slot_list) # ... def forward(self, x_in): # ... for i in range(len(self.slot_list)): slot_attention = self.slot_list[i] slots_, attn_maps_, prompt_map_, slot_map_, slot_cossim_total = slot_attention(x, q_inp[:, :, i*c:(i+1)*c], k_inp[:, :, i*c:(i+1)*c], v_inp[:, :, i*c:(i+1)*c]) # ... # ... class IGAB(nn.Module): def __init__( self, dim, dim_head=64, num_slots1=3, num_slots2=3, num_slots3=7, heads=8, num_blocks=2, ): self.blocks = nn.ModuleList([]) for _ in range(num_blocks): self.blocks.append(nn.ModuleList([ IG_MSA(dim=dim, dim_head=dim_head, num_slots=num_slots1, num_subslots=num_slots2, num_subsubslots=num_slots3, heads=heads), PreNorm(dim, FeedForward(dim=dim)) ])) def forward(self, x): x = x.permute(0, 2, 3, 1) attn_list = [] for (attn, ff) in self.blocks: x_attn, attn_maps, slot_features, slots_cossim_list = attn(x) attn_list.append(attn_maps) x = x_attn + x x = ff(x) + x out = x.permute(0, 3, 1, 2) return out, torch.cat(attn_list, dim=1), slot_features, slots_cossim_list -
Downsample 和 Upsample 模块用于对特征图进行下采样和上采样操作。
-
class Downsample(nn.Module):
    def __init__(self, n_feat):
        super(Downsample, self).__init__()
        self.body = nn.Sequential(nn.Conv2d(n_feat, n_feat//2, kernel_size=3, stride=1, padding=1, bias=False, padding_mode='reflect'), nn.PixelUnshuffle(2))
    def forward(self, x):
        return self.body(x)
class Upsample(nn.Module):
    def __init__(self, n_feat):
        super(Upsample, self).__init__()
        self.body = nn.Sequential(nn.Conv2d(n_feat, n_feat*2, kernel_size=3, stride=1, padding=1, bias=False, padding_mode='reflect'),  nn.PixelShuffle(2))
-
-
SlotAttention机制通过迭代更新槽的表示,将输入特征解耦为不同的槽,每个槽对应输入特征的一个部分。这种解耦能力使得模型能够更好地学习到输入特征的不同方面,提高模型的表达能力。SlotAttention机制使用注意力机制来计算槽与输入特征之间的相关性,使得模型能够自适应地关注输入特征的不同部分。这种自适应注意力能力使得模型能够更好地处理不同的输入情况,提高模型的泛化能力。SlotAttention机制通过多次迭代更新槽的表示,使得模型能够逐步学习到输入特征的更精细的表示。这种迭代更新能力使得模型能够更好地处理复杂的输入情况,提高模型的性能。
更多推荐

 0
 0
- 0


 已为社区贡献4条内容

所有评论(0)