
小白也能看懂的最速神经网络入门(顺便手搓一个神经网络)
小白也能看懂的最速神经网络入门(顺便手搓一个神经网络)
前言
在人工智能、深度学习爆火的今天,很多研究人员投身人工智能应用。这就导致很多想入行的人往往忽略了人工智能、深度学习最本真的底层原理。殊不知我们所用的大模型起源于小小的神经网络。
1、从生物神经网络到人工神经网络
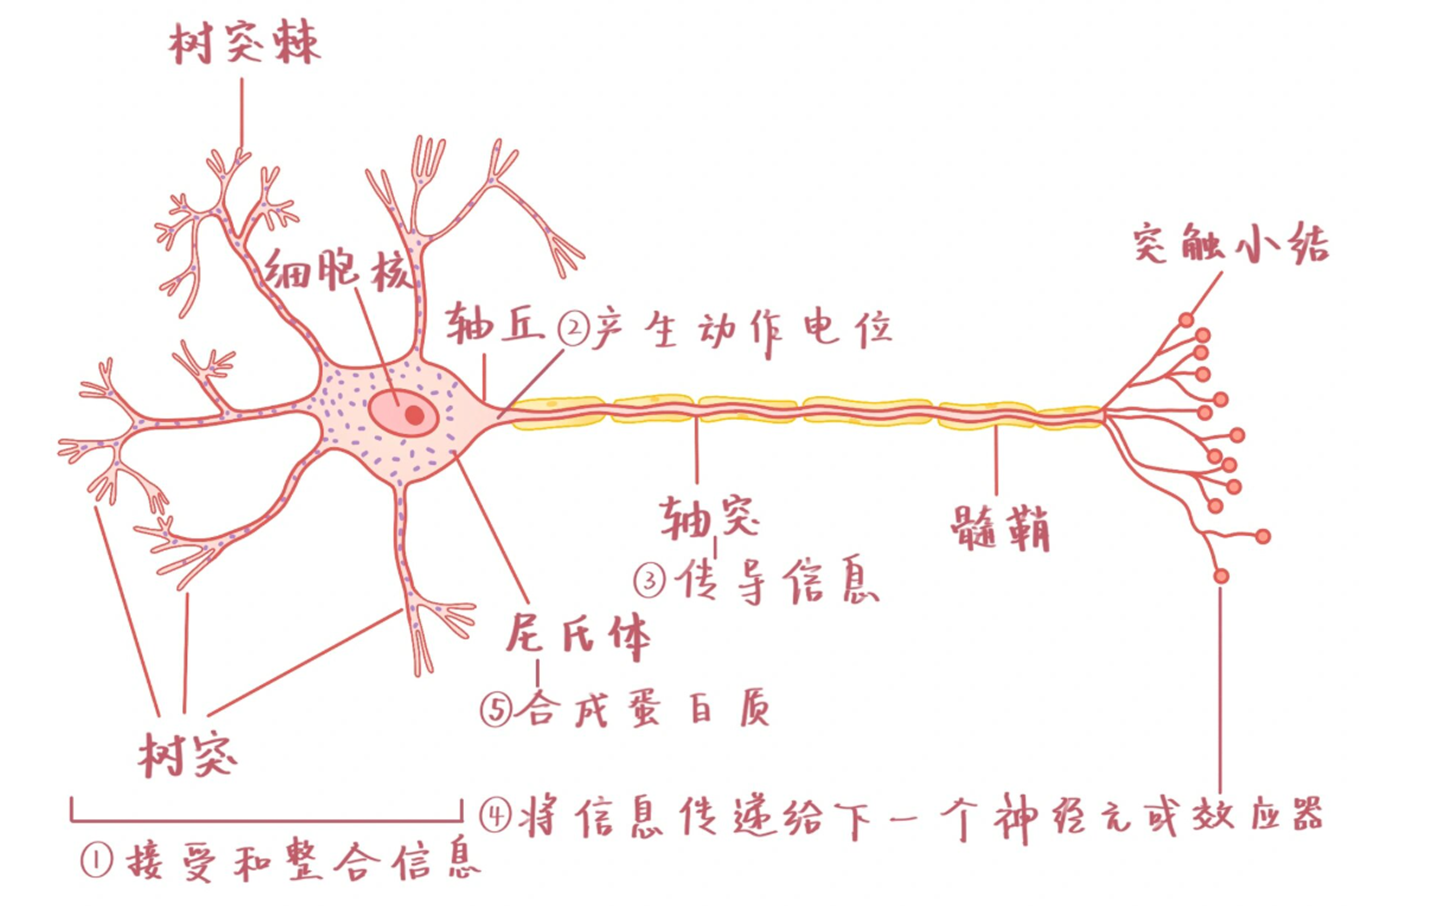
生物神经元(神经细胞)通过树突接收生物电信号,细胞体负责将树突接收的信号进行整合,然后将新的动作电位由轴突传导到突触,而突触又与下一个神经细胞的树突相连接,也就是将信号传递给了下一个神经细胞,下一个神经细胞又重复上述过程。生物神经细胞通过这种方式连接在一起,形成生物神经网络。
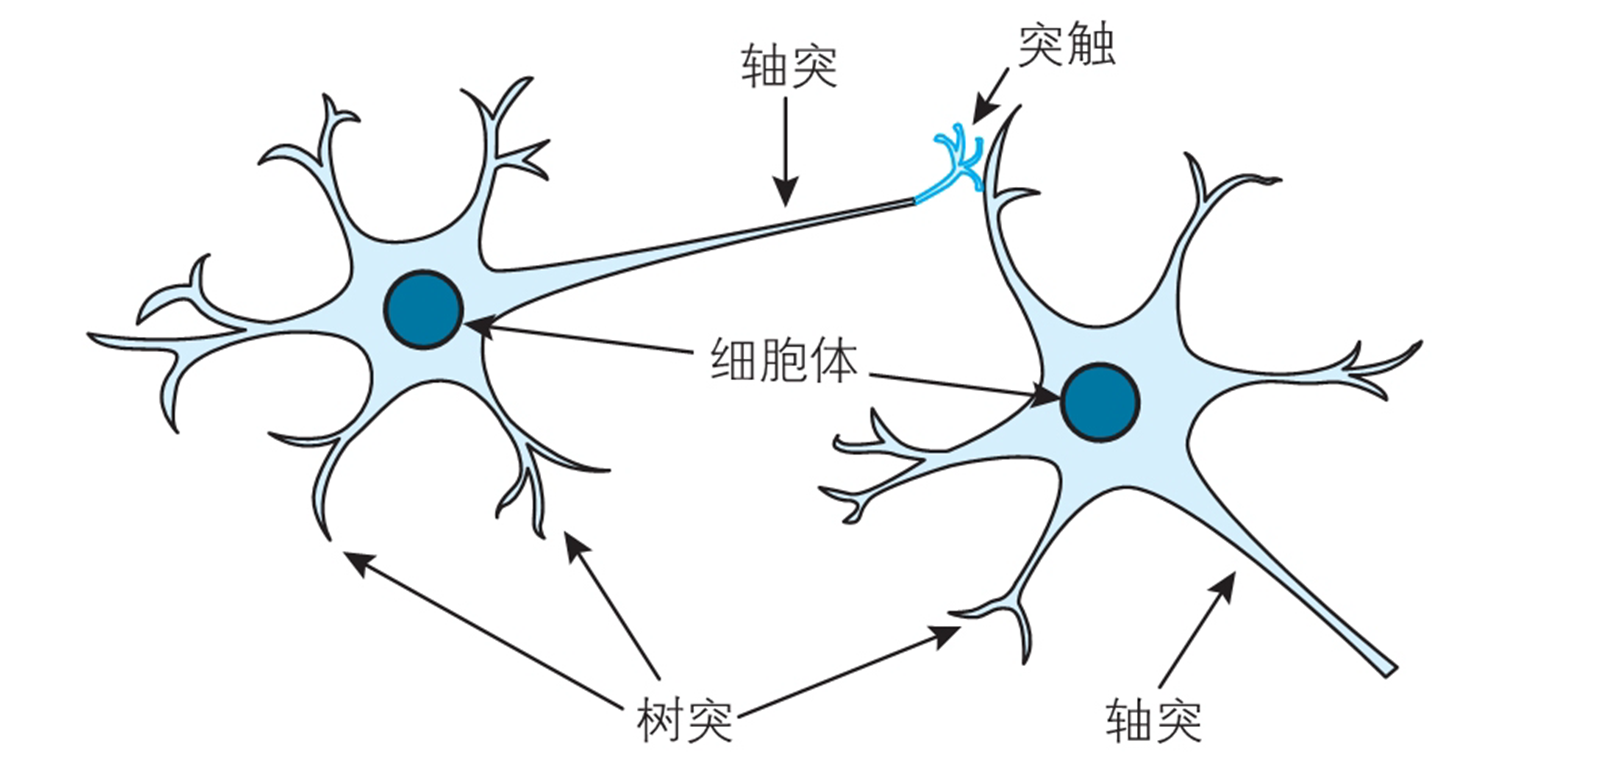
人工神经网络(Artificial Neural Network, ANN,以下简称神经网络)的构思灵感来源于生物神经网络。人工神经网络的基本单元“人工神经元”,粗略模拟了生物神经元“接收输入—加权求和—激活输出”的工作方式。它的起源可追溯到1943年,由心理学家McCulloch和数学家Pitts提出的第一个神经元数学模型,这也是整个领域公认的理论起点。
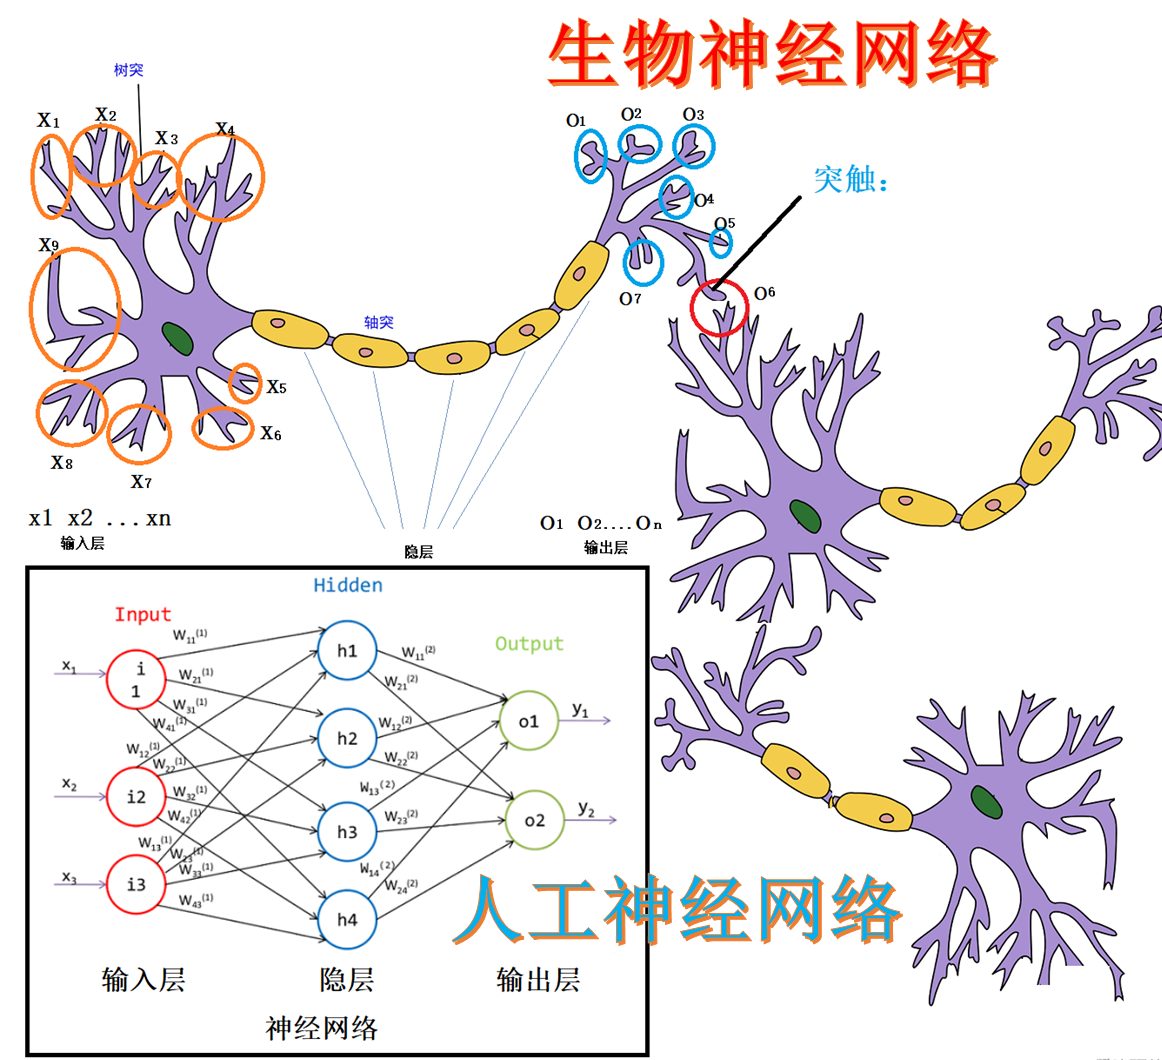
生物神经网络中的生物神经元通过复杂的电化学信号实现信息的接收、整合和传导,人工神经网络只能通过技术手段简化、模仿生物神经网络。通过分析不难发现,生物神经元实际上是典型的IPO(Input, Process, Output)结构,也就是“输入,处理,输出”结构,将若干个IPO结构的对象前后相连(前一个的输出作为后一个的输入)即可形成人工神经网络的逻辑结构。计算机很容易实现IPO结构,例如编程语言中的函数就可以理解为一种神经元。上图人工神经网络中的每一个圆圈就代表一个函数,每个函数接收若干个输入,然后函数体将输入数据进行处理(也就是某种计算,具体可以是加法、乘法或者任意你自定义的计算方式),然后进行输出。只不过这样的神经元是“专用”的,只能完成特定的信号处理方式,不具备通用性。另外,这样的神经元也没有通过调整连接强度来学习的功能。因此,从“逻辑结构”到“功能完善”,人工神经网络还有诸多问题需要解决。
2、逐步实现人工神经网络
前面已经介绍了人工神经网络的基本逻辑结构,但是其中很多功能仍然没有实现。接下来我们就一步步通过Python,从易到难实现现代深度学习常用的人工神经网络,包括全连接网络和卷积神经网络(实际上Transformer、Mamba的基本原理也是一样的)。
2.1 人工神经元的结构和实现
按照之前的理论,神经元就是一个IPO结构,我们不妨将人工神经元的基本结构想象成下面的样子。为了方便描述,之后所说的神经元、神经网络指的都是人工神经元、人工神经网络,生物神经网络在本篇的戏份已经结束了。
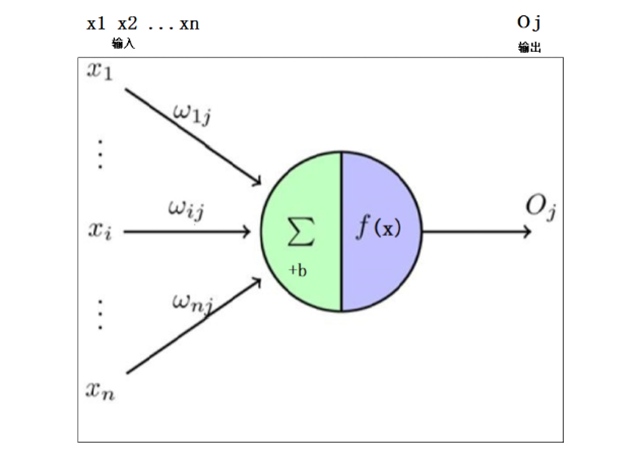
其中,图片左侧的
x
1
,
x
2
,
.
.
.
,
x
n
x_1,x_2,...,x_n
x1,x2,...,xn表示的是神经元的输入,右侧的
O
j
O_j
Oj表示神经元的输出,需要注意的是,这里的
O
j
O_j
Oj表示向量,也就是输出可能是一个数,也可能是很多个数。中间的圆圈表示对数据的处理过程,可以是任意的计算。例如,可以令
O
=
2
x
O=2x
O=2x,或者
O
=
0
O=0
O=0都行,显然,使用上述方式计算输出的神经元分别实现将信号方法2倍或者阻断任意输入的功能。但是,上述计算方式的神经元仍然存在无法调整对输入的处理过程的问题,它们只能是完成固定处理方式的神经元,不具备调节功能。在前人不断的研究过程中,人们发现使用如下式子(1)定义神经元的输入和输出关系,可以实现神经元的调节。
式子(1)
y
=
w
x
+
b
y=wx+b
y=wx+b
其中,
w
w
w和
b
b
b称为神经元的权重(weights)和偏置(bias)。仔细想想,当我们给
w
w
w和
b
b
b赋予不同值的时候,神经元就能够实现对输入x的不同处理方式。
w
w
w和
b
b
b实际上定义了在式子(1)的前提下,不同神经元对输入的处理方式。然而,研究人员很快又发现,式子(1)仅仅是对输入进行了一个线性变换,表达能力有限,因此,就需要给神经元的输出添加一个非线性变换。简单来说,就是将神经元的输出再作为一个非线性函数的自变量,然后获取到这个函数的因变量。举个例子,我们可以将式子(1)的输出y再输入一个二次函数中,例如
f
(
x
)
=
x
2
+
5
x
+
3
f(x)=x^2+5x+3
f(x)=x2+5x+3,那么式子(1)就可以改写为:
a
=
y
2
+
5
y
+
3
a=y^2+5y+3
a=y2+5y+3,其中
y
=
w
x
+
b
y=wx+b
y=wx+b。
在人工神经网络中,激活函数扮演了非常重要的角色,其主要作用是对所有的隐藏层和输出层添加一个非线性的操作,使得神经网络的输出更为复杂、表达能力更强。通常都是这样解释:不使用激活函数的话,神经网络的每层都只是做线性变换,多层输入叠加后也还是线性变换。因为线性模型的表达能力通常不够,所以这时候就体现了激活函数的作用了,激活函数可以引入非线性因素。
激活函数的种类非常多,例如sigmoid,ReLU,PReLU等等。在研究神经元时,我们一般不用太在意激活函数的具体形式,一般要到具体应用场景才关注。
2.1.1 单个输入单个输出的神经元及其前向传播
综上所述,最终人工神经元的计算过程可以用式子(2)、(3)表达。
式子(2)
z
=
w
x
+
b
z=wx+b
z=wx+b
式子(3)
y
=
σ
(
z
)
y=\sigma (z)
y=σ(z)
式子(2)、(3)表述的神经元结构如下图所示。
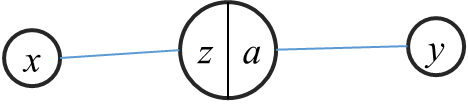
其中x和y都是标量,也就是说这个神经元接收一个数输入,得到一个数的输出。为了方便表达,我们将没有经过激活函数的输出称之为未激活输出,记作
z
z
z,神经元的最终输出也就是激活输出,记为
a
a
a。
y
y
y表示一个网络的最终输出,由于目前讨论的神经元仅有1层,因此上图中,
a
=
y
a=y
a=y。
上述结构实际上很容易使用Python实现。显然,神经元中的
w
,
b
w,b
w,b都是每个神经元的固有属性,并且每个神经元的权重和偏置值可能会不一样,因此,我们可以把神经元看做一个对象,
w
,
b
w,b
w,b是其属性,从输入
x
x
x到输出
y
y
y之间的计算过程可以使用一个成员函数来实现,就如同下方的代码。
#单输入输出的神经元
class SISONu:
    def __init__(self,activation=None):
        self.w=1
        self.b=1
        self.act=activation
	#对输入x的处理过程,这个过程一般称之为前向传播,也就是forward
    def forward(self,x):
        z=x*self.w+self.b
        if self.act is not None:
            z=self.act(z)
        return z

if __name__=="__main__":
    data=2
    n1=SISONu()
    res=n1.forward(data)
    print(res)
w , b w,b w,b在实际使用中是随机初始化的,这里为了方便后续计算,那我们不妨将其随机初始化为“1”(初始化的值会对最终结果有影响,但是影响不大,而且神经网络对数据的处理本身就是带有一定随机性的)。由于神经元n1的激活函数设置为None,也就是不使用激活函数,因此 w x + b wx+b wx+b就是其最终输出,最终上述程序片段输出“3”。
当然,我们也可以给上述神经元设置一个激活函数,例如sigmoid,其公式如下:
σ
(
x
)
=
1
1
+
e
−
x
\sigma(x)=\frac{1}{1+e^{-x}}
σ(x)=1+e−x1
对应的代码可以这样写:
#添加函数
def sigmoid(x):
    return 1/(1+math.exp(-x))
#main中添加如下代码
    n2=SISONu()
    n2.act=sigmoid
    res=n2.forward(data)
    print(res)
2.1.2 单个输入多个输出的神经元
在实际应用中,神经元不可能都是单输入单输出的,而是存在多出入、单输出的情况,这种神经元的结构如下如所示:
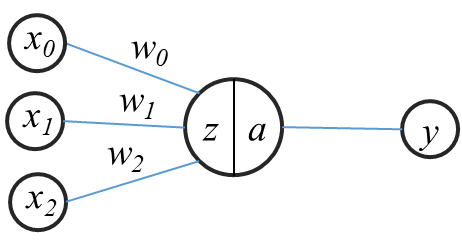
上面的神经元接收三个输入(
x
0
,
x
1
,
x
2
x_0,x_1,x_2
x0,x1,x2),输出一个标量
y
y
y,其输出与输入的关系为:
式子(4):
y
=
σ
(
w
0
x
0
+
w
1
x
1
+
w
2
x
2
+
b
)
y=\sigma(w_0x_0+w_1x_1+w_2x_2+b)
y=σ(w0x0+w1x1+w2x2+b)
σ
(
)
\sigma()
σ()仍然表示激活函数,神经元对数据的处理则是对应的权重相乘求和,然后加上偏置,最后经过激活函数。为了简便表达,我们可以将式子(4)写成向量乘法的形式,
式子(5):
y
=
σ
(
W
X
+
b
)
y=\sigma(WX+b)
y=σ(WX+b)
其中,
W
=
[
w
0
,
w
1
,
w
2
]
W=[w_0,w_1,w_2]
W=[w0,w1,w2],
X
=
[
x
0
,
x
1
,
x
2
]
T
X=[x_0,x_1,x_2]^T
X=[x0,x1,x2]T
同样,我们可以使用类似2.1.1小节中的方法在Python中进行实现。
import numpy as np
class MISONu:
    def __init__(self,input_units=3,activation=None):
        self.w=np.random.random((1,input_units))
        self.b=1
        self.act=activation
        self.input_units=input_units
    def forward(self,x):
        if x.shape!=(self.input_units,1):
            print(f"输入的个数必须与该神经元接受的输入个数一致,当前输入个数{x.shape[0]},而神经元接收的输入个数为{self.input_units}")
            return None
        else:
            z=self.w@x+self.b
            if self.act is not None:
                z=self.act(z)
            return z
def sigmoid(x):
    return 1/(1+math.exp(-x))
if __name__=="__main__":
    n3=MISONu()
    n3.act=sigmoid
    x=np.array([[1],[1],[1]])
    out=n3.forward(x)
    print(out)
在上面的代码中,我们建立了一个多输入单输出(Multi Input Singal Output)神经元类MISONu,并且在构造函数中,我们允许通过参数input_units指定输入的数据的个数,默认值为3。构造函数负责初始化权重
w
w
w和偏置
b
b
b。由于输出是1个,因此偏置仍然是一个标量,这里简单初始化为1;由于具有多个输出,通过式子(5)可以知道,权重是一个有input_units个元素的行向量,输入是具有input_units个元素的列向量。上面的代码使用numpy库进行了相应的初始化。forward函数则是完全按照公式(5)进行计算,其中
@
@
@在numpy中表示矩阵乘法。显然在上面的代码中,此时的权重w是1×3的行向量,输入x是3×1的列向量,wx的结果是一个1×1的向量,也就是标量。
从这里例子我们能注意到,权重矩阵的列数与输入的数据个数相等。例如,如果输入是p个数,那么权重w就有p列。
2.1.3 多个输入多个输出的神经元
在实际应用中,我们还会碰到具有多个输入多个输出的神经元,这样的神经元是我们接触到最多的情况,也是最普遍的情况。多输入多输出的神经元结构如下。
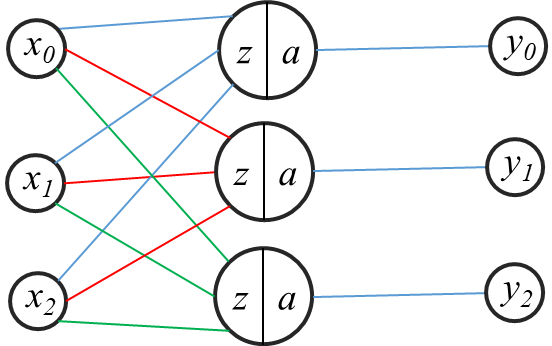
具体的,上面的神经元接收三个输入(
x
0
,
x
1
,
x
2
x_0,x_1,x_2
x0,x1,x2),输出一个具有三个元素的向量(也就是3个输出)
(
y
0
,
y
1
,
y
2
)
(y_0,y_1,y_2)
(y0,y1,y2),其输出与输入的关系为:
式子(6):
y
0
=
σ
(
w
00
x
0
+
w
01
x
1
+
w
02
x
2
+
b
0
)
y_0=\sigma(w_{00}x_0+w_{01}x_1+w_{02}x_2+b_0)
y0=σ(w00x0+w01x1+w02x2+b0)
y
1
=
σ
(
w
10
x
0
+
w
11
x
1
+
w
12
x
2
+
b
1
)
y_1=\sigma(w_{10}x_0+w_{11}x_1+w_{12}x_2+b_1)
y1=σ(w10x0+w11x1+w12x2+b1)
y
2
=
σ
(
w
20
x
0
+
w
21
x
1
+
w
22
x
2
+
b
2
)
y_2=\sigma(w_{20}x_0+w_{21}x_1+w_{22}x_2+b_2)
y2=σ(w20x0+w21x1+w22x2+b2)
σ
(
)
\sigma()
σ()仍然表示激活函数,神经元对数据的处理则是对应的权重相乘求和,然后加上偏置,最后经过激活函数。
式子(6)也可以写成:
(
y
0
y
1
y
2
)
\begin{pmatrix} y_0 \\y_1\\y_2 \end{pmatrix}
y0y1y2
=
=
=
(
w
00
w
01
w
02
w
10
w
11
w
12
w
20
w
21
w
22
)
\begin{pmatrix} w_{00} & w_{01} &w_{02} \\ w_{10} & w_{11} &w_{12}\\ w_{20} & w_{21} &w_{22} \end{pmatrix}
w00w10w20w01w11w21w02w12w22
⋅
·
⋅
(
x
0
x
1
x
2
)
\begin{pmatrix} x_0 \\x_1\\x_2 \end{pmatrix}
x0x1x2
+
+
+
(
b
0
b
1
b
2
)
\begin{pmatrix} b_0 \\b_1\\b_2 \end{pmatrix}
b0b1b2
为了简便表达,我们可以将式子(6)写成矩阵乘法的形式,
式子(7):
Y
=
σ
(
W
X
+
B
)
Y=\sigma(WX+B)
Y=σ(WX+B)
其中,
W
=
(
w
00
w
01
w
02
w
10
w
11
w
12
w
20
w
21
w
22
)
W= \begin{pmatrix} w_{00} & w_{01} &w_{02} \\ w_{10} & w_{11} &w_{12}\\ w_{20} & w_{21} &w_{22} \end{pmatrix}
W=
w00w10w20w01w11w21w02w12w22
,
X
=
(
x
0
x
1
x
2
)
X= \begin{pmatrix} x_0 \\x_1\\x_2 \end{pmatrix}
X=
x0x1x2
,
B
=
(
b
0
b
1
b
2
)
B= \begin{pmatrix} b_0 \\b_1\\b_2 \end{pmatrix}
B=
b0b1b2
,
Y
=
(
y
0
y
1
y
2
)
Y= \begin{pmatrix} y_0 \\y_1\\y_2 \end{pmatrix}
Y=
y0y1y2
同样,我们可以使用类似2.1.2小节中的方法在Python中进行实现。
class MIMONu:
    def __init__(self,input_units,output_units,activation=None):
        self.w=np.random.random((output_units,input_units))
        self.b=np.random.random((output_units,1))
        self.act=activation
        self.in_units=input_units
        self.out_units=output_units
    def forward(self,x):
        if x.shape!=(self.in_units,1):
            print(f"输入的个数必须与该神经元接受的输入个数一致,当前输入个数{x.shape[0]},而神经元接收的输入个数为{self.in_units}")
            return None
        z=self.w@x+self.b
        if self.act is not None:
            z=self.act(z)
        return z
if __name__=="__main__":
    n4=MIMONu(3,5)
    x=np.array([[1],[1],[1]])
    out=n4.forward(x)
    print(out)
    '''
    输出结果:
    [[2.13766633]
    [1.251274  ]
    [0.76830145]
    [1.69888456]
    [2.05161929]]
   '''
上面的代码构造了一个具有3个输入,5个输出的神经元,并且给了一个数据进行前向传播计算,注意,n4神经元没有使用激活函数。如果使用了激活函数,那么在多个输出的情况下,激活函数是对每个元素应用的。观察规律可以发现,权重矩阵
w
w
w的行列数与输入和输出的个数相关,其行数就是输出个数,列数就是输入个数。例如,假设需要一个输入为p个数,输出为q个数的神经元,那么其实现过程实际上就是一个q行p列的矩阵与输入数据组成的列向量(p行1列)做矩阵乘法。矩阵乘法的性质决定了这个性质,因为(q×p)的矩阵乘(p×1)的矩阵结果就是(q×1)的矩阵。 这与式子(7)的描述是一样的。
结论:实际上神经网络没有我们想象的那么难以实现,尽管数学上的逻辑经过了前人几十年的探索,但是在实际使用中,神经网络就是由神经元前后相接组成的(前面的输出是后面的输入),而且在实现上就是一个矩阵乘法。
2.1.4 激活函数
不使用激活函数的话,神经网络的每层都只是做线性变换,多层输入叠加后也还是线性变换。因为线性模型的表达能力通常不够,所以这时候就体现了激活函数的作用了,激活函数可以引入非线性因素。由此可见,激活函数对于神经网络至关重要。前面已经确定了神经元的基本运行逻辑和实现方法,并且见到了最常用的激活函数之一——sigmoid。目前有几十种激活函数,他们的目的都是一样的——对所有的神经元输出添加一个非线性的操作,使得神经网络的输出更为复杂、表达能力更强。但是,不同的激活函数可能对神经网络性能带来不同影响,因此本节我们来认识一些常用激活函数。
-
sigmoid激活函数
sigmoid是最早被用于神经网络的激活函数之一,其公式为: σ ( x ) = 1 1 + e − x \sigma(x)=\frac{1}{1+e^{-x}} σ(x)=1+e−x1,其图像如下:
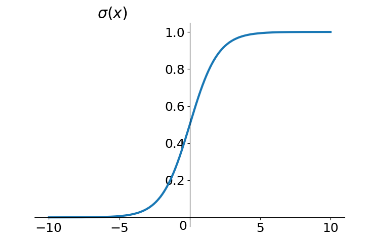
它能够把输入的连续实值变换为0和1之间的输出。如果是非常大的负数,那么输出就是0;如果是非常大的正数,输出就是1。
Sigmoid函数是深度学习 领域开始时使用频率最高的激活函数。他的优点非常明显,首先,他可以将输入规定化到0到1之间,这有助于赋予深度学习模型的输出一个有意义的解释;其次,sigmoid函数的导数非常容易求出,也很容易计算( σ ′ ( x ) = σ ( x ) ( 1 − σ ( x ) ) \sigma'(x)=\sigma(x)(1-\sigma(x)) σ′(x)=σ(x)(1−σ(x)))。
sigmoid的局限性也很明显,在输入很大或者很小的时候,其梯度很小,因此早期使用sigmoid的神经网络容易出现梯度消失问题。
另外,sigmoid的输出恒大于零,因此限制了模型的输出范围,这会导致模型收敛速度变慢。
sigmoid函数的Python实现在上面的代码中已经出现过了,在此不再赘述。 -
tanh激活函数
tanh激活函数的计算公式为: t a n h ( x ) = e x − e − x e x + e − x tanh(x)=\frac{e^x-e^{-x}}{e^x+e^{-x}} tanh(x)=ex+e−xex−e−x,其图像如下。
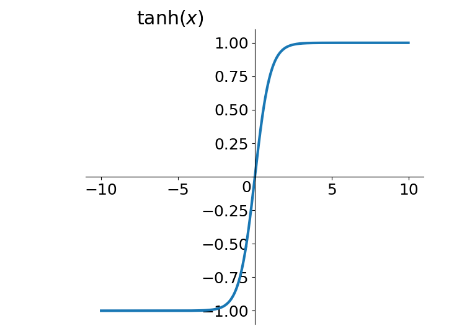
由上图可见,tanh的输出在-1到1之间,解决了sigmoid输出值域不对称的问题。然而,梯度消失的问题和幂运算计算复杂的问题仍然存在。
根据公式,我们可以很容易写出tanh函数的Python实现。
def tanh(x):
    return (math.exp(x)-math.exp(-x))/(math.exp(x)+math.exp(-x))
- ReLU激活函数
ReLU全称是Rectified Linear Unit,翻译过来就是修正线性单元。其公式如下:
σ ( x ) = { m a x ( 0 , x ) x ≥ 0 0 x < 0 \sigma(x)=\begin{cases} max(0,x) & x≥0 \\ 0 & x<0 \end{cases} σ(x)={max(0,x)0x≥0x<0
其图像如下:
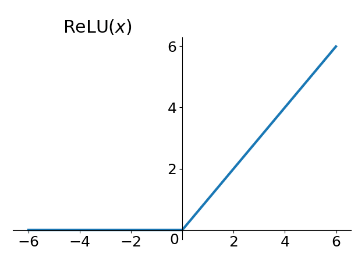
可以看到,ReLU函数十分简单,他仅仅是将负值置零。ReLU函数的优点非常多: - 解决了梯度消失问题 (在正区间)
- ReLU 函数中只存在线性关系,因此它的计算速度比 sigmoid 和 tanh更快。
- 提供相对宽的激活边界 ReLU的单侧抑制提供了网络的稀疏表达能力。
每个激活函数都有自己的优势和缺陷,他们的搭配在各种神经网络中也不是固定的,需要根据特定问题进行调整。
总之,当你不知道用什么激活函数的时候,使用ReLU一般不会有错。
ReLU的实现相当简单,下面提供参考。
def ReLU(x):
    return np.maximum(x,0)
2.2 多层神经元构成的神经网络以及前向传播
之前花了很长篇幅讲解神经元的结构及其前向传播(也就是对数据的处理)实现,而神经网络是由多个神经元前后相连构成的,接下来我们就来看看多层神经元构成的神经网络是如何对数据进行计算的。
我们以一个通用的结构作为例子,如下图所示。
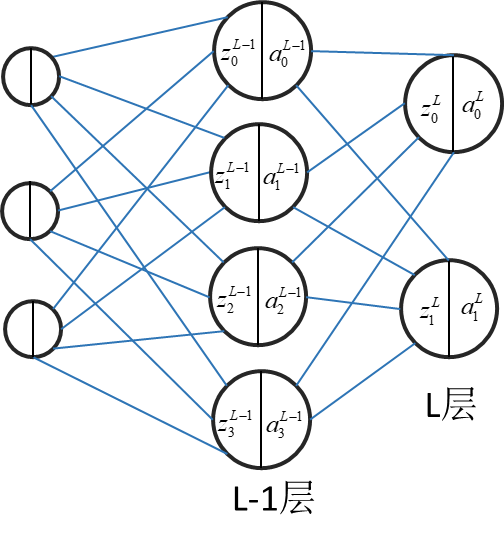
上面的图表示的是一个具有n个输入、2个输出的由L层神经元构成的神经网络。注意,作为一个具有代表性的典型神经挽留过,上图仅仅绘制了最后3层,前面的层包括输入层在内都省略了。网络的最后一层是L层,倒数第二层是L-1层,依次类推。图中的每个神经元中的符号解释如下:
以符号
a
0
L
a_0^L
a0L为例,
a
a
a表示的是神经元的激活输出,其中上标
L
L
L表示神经元所处的层,
L
L
L就是
L
L
L层,下标表示某层的输出向量中的下标,
0
0
0表示该层的第一个输出。因此,
a
0
L
a_0^L
a0L表示
L
L
L层的下标为
0
0
0的激活输出。对应的,
z
0
L
z_0^L
z0L表示的就是激活输出。
没有下标的
a
L
a^L
aL表示
L
L
L层的输出向量,
a
L
=
[
a
0
L
,
a
1
L
]
T
a^L=[a_0^L,a_1^L]^T
aL=[a0L,a1L]T。
我们先从具体的最后一层,也就是L层开始看起。我们将L层视为一个神经元,从图中可以看到,L层的输入个数是4个,输出个数是2个,按照神经网络中神经元前后连接的理论,L层神经元的输入来自于L-1层(也就是前一层)的输出,中间的计算过程就是一个矩阵乘法加一个激活函数。因此,我们可以把L层的计算过程表达如下:
式子(8):
[
z
0
L
z
1
L
]
=
[
w
00
L
w
01
L
w
02
L
w
03
L
w
10
L
w
11
L
w
12
L
w
13
L
]
[
a
0
L
−
1
a
1
L
−
1
a
2
L
−
1
a
3
L
−
1
]
+
[
b
0
L
b
1
L
]
\begin{bmatrix} z_0^L\\z_1^L \end{bmatrix}= \begin{bmatrix} w_{00}^L &w_{01}^L&w_{02}^L&w_{03}^L\\w_{10}^L &w_{11}^L&w_{12}^L&w_{13}^L \end{bmatrix} \begin{bmatrix} a_0^{L-1}\\a_1^{L-1}\\a_2^{L-1}\\a_3^{L-1} \end{bmatrix}+ \begin{bmatrix} b_0^L\\b_1^L \end{bmatrix}
[z0Lz1L]=[w00Lw10Lw01Lw11Lw02Lw12Lw03Lw13L]
a0L−1a1L−1a2L−1a3L−1
+[b0Lb1L]
式子(9):
[
a
0
L
a
1
L
]
=
σ
(
[
z
0
L
z
1
L
]
)
\begin{bmatrix} a_0^L\\a_1^L \end{bmatrix}=\sigma(\begin{bmatrix} z_0^L\\z_1^L \end{bmatrix})
[a0La1L]=σ([z0Lz1L])
式子(8)就是L-1层的输出作为L层的输入,经过矩阵乘法(也就是L层神经元对输入的处理过程)得到非激活输出
z
L
z^L
zL,然后公式(9)表示非激活输出经过激活函数得到激活输出
a
L
a^L
aL。将式子(8)、(9)写成向量形式如下:
z
L
=
w
L
a
L
−
1
+
b
L
a
L
=
σ
(
z
L
)
z^L=w^La^{L-1}+b^L\\ a^L=\sigma(z^L)
zL=wLaL−1+bLaL=σ(zL)
不失一般性,我们可以将上式写成一般形式:
式子(10):
a
l
=
σ
(
w
l
a
l
−
1
+
b
l
)
a^l=\sigma(w^la^{l-1}+b^l)
al=σ(wlal−1+bl)
式子(10)就是现代神经网络前向传播的核心公式,其中
a
l
a^l
al表示
l
l
l层的输出,
l
l
l表示神经网络中的任意一层,
(
l
−
1
)
(l-1)
(l−1)就是
l
l
l层的前一层。式子(10)用一句话来说,就是:神经网络中任一层的输出由其前一层的输出经过本层权重、偏置处理,再经过激活得到。
以上,我们就得到了神经网络的前向传播通用公式。最后,我们来手搓一个多层神经网络结束这个部分。
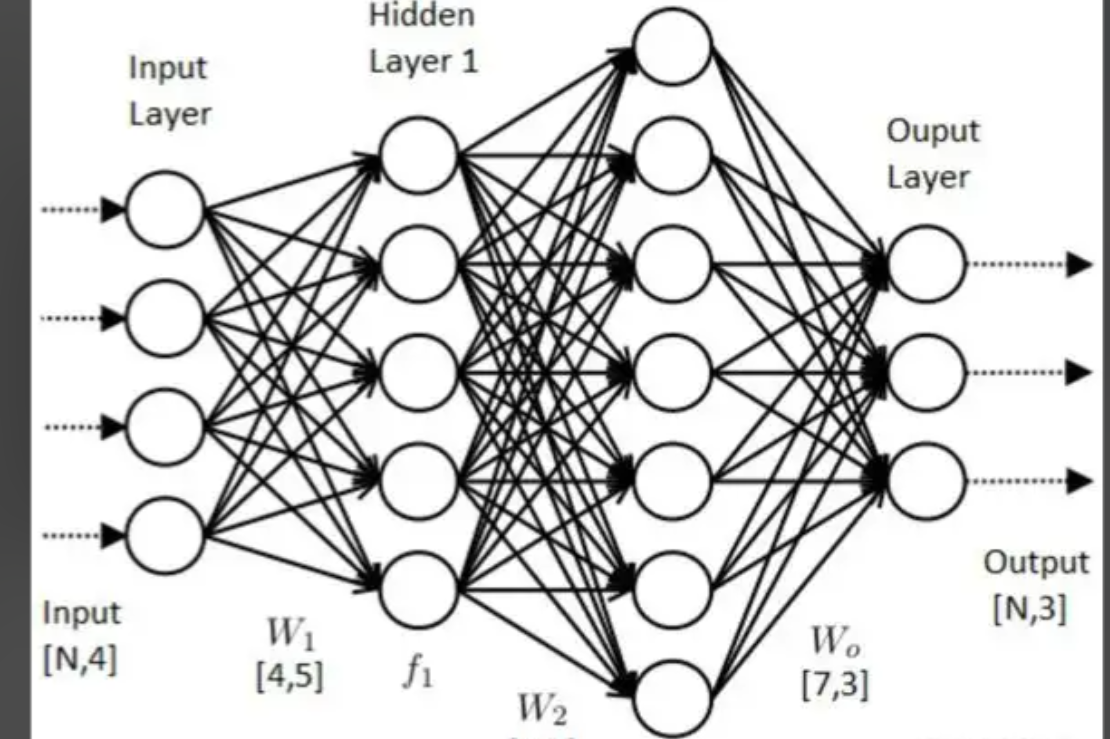
上面的神经网络图是在网上随便找的,该网络接受4个输入,输出个数为3。第一层输入4,输出5;第二层输入5,输出7,第三层(最后一层)输入7,输出3。可以看到,前一层的输出个数和后一层的输入个数一定是一样的,我们使用之前写的MIMONu类来实现以下,这里假设我们全部使用ReLU激活函数。Python代码如下:
if __name__=="__main__":
    #我们创建出各个层,然后将其放到一个list中
    out_nums=[4,5,7,3]    #记录每一层的输出个数,第一个是输入个数
    myNetwork=[]
    for i in range(len(out_nums)-1):
        #根据输入输出构建神经元
        nu=MIMONu(out_nums[i],out_nums[i+1],activation=ReLU)
        myNetwork.append(nu)
    #尝试用一个数据计算一下
    x=np.array([[1],[1],[1],[1]])
    out=x
    for layer in myNetwork:
        out=layer.forward(out)
    print(out)
在实际使用中,通常会将网络的每一层封装进一个类中,方便调用,就像下面这样。
class MyNeuralNetwork:
    def __init__(self,out_nums,act=ReLU):
        self.layers=[]
        for i in range(len(out_nums) - 1):
            # 根据输入输出构建神经元
            nu = MIMONu(out_nums[i], out_nums[i + 1], activation=act)
            self.layers.append(nu)
    def forward(self,x):
        for layer in self.layers:
            x = layer.forward(x)
        return x
这样使用就会很简单:
if __name__=="__main__":
    #我们创建出各个层,然后将其放到一个list中
    out_nums=[4,5,7,3]    #记录每一层的输出个数,第一个是输入个数
    #尝试用一个数据计算一下
    x=np.array([[1],[1],[1],[1]])
    nn=MyNeuralNetwork(out_nums)
    out=nn.forward(x)
    print(out)
2.3 神经网络的反向传播过程
认真看到这里的朋友应该已经发现了,虽然我们弄清楚了神经网络的前向传播过程,但是我们所创造的神经网络没有调节功能。也就是说,目前我们写的神经网络都是在胡乱计算(因为w和b是随机的),核心原因就是我们写的神经网络不会根据任务要求调节w和b。反向传播算法就是让神经网络根据任务要求调节w和b的算法。由于直接说公式过于抽象,我们通过一个具体的例子来学习反向传播算法的作用及其计算过程。
2.3.1 单输入单输出的最简网络的反向传播
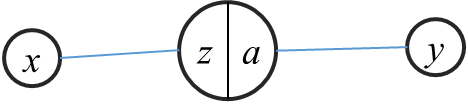
我们以上面的神经网络的反向传播过程作为例子。上面的神经网络是最简单的神经网络,只有1个输入,1个输出,1层,我们姑且叫他SNet(没错,我发明的)。由于任务比较简单,所以不使用非线性激活也能完成,为了简化数学过程,这里的SNet不使用激活函数(或者你可以理解为使用线性激活)。现在,我们要求上述网络完成一些数据的预测任务。
假设我们现在获取到了一些数据,如下图:
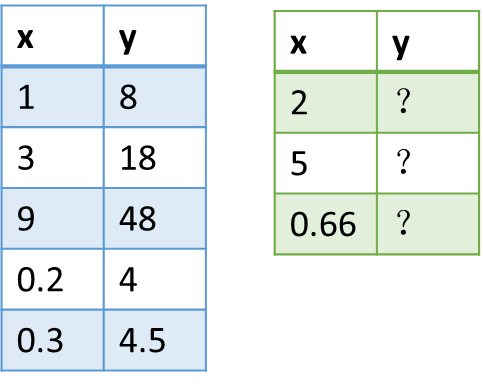
上面的数据符合我们SNet的输入输出要求(实际使用中是根据数据的输入输出要求设计网络,这里为了案例需要构造了一些数据,但是原理是一样的),蓝色部分数据告诉我们,当输入1时,SNet的输出要求是8,输出3时,网络的输出是18,以此类推。然后,现在问题是,我们需要在输入为2、5、0.66时,网络给我们预测输出应该是多少?我知道,上面的数据通过解方程就能够得到结果,但是我们现在用神经网络实现,这样简单的例子是为了方便理解,同时也方便验证。
一般而言,神经网络中的权重和偏置的初始值都是随机的。我们不妨假设W初始值为1,B初始值为1。(当然,你想要设置为其他值也可以,对结果不影响。)显然此时的SNet无法完成我们要求的预测任务,我们要通过反向传播算法来调整w和b,使SNet能够逐渐的“学会”预测给出的数据。
-
前向传播过程
在进行反向传播之前,我们需要先进行一次前向传播,不然我们或者网络自己也不知道预测得到底对不对。所以,我们先用第一行数据来试一试。
∵此时W=1,B=1,而输入数据x=1
∴输出 y p r e d = W x + B = 1 × 1 + 1 = 2 y_{pred}=Wx+B=1×1+1=2 ypred=Wx+B=1×1+1=2
这里 y p r e d y_{pred} ypred表示SNet的输出,也就是预测值,而此时的我们期望的输出值,也叫做标签或者真实值是8。显然,此时 y p r e d ≠ y y_{pred}≠y ypred=y,所以SNet不能满足我们的要求。我们需要某种度量来告诉神经网络,告诉它他的输出与我们的期望差多远,然后对W和B进行调整。可以想象一下,如果是人算错了,我们可以批评他、责备他,告诉他算错了,然后这个人重新调整算法。但是对于神经网络来说,我们没有办法通过像人一样的方式来纠正他,我们需要一些数学上的方法。
首先要解决的就是关于“错了多少”的度量问题。 -
损失函数(Loss function)
之前我们已经知道了SNet算错了,但是它错了多少呢?是错了五六层楼那么多吗?
显然,我们要将误差量化,也就是变成数字来表达误差。这个用于表达误差的东西就是损失函数。损失函数用于衡量目标真实值与模型预测值之间的差值,它是衡量神经网络的准确性的重要算法。针对不同的任务需要不同的损失函数。对于我们常见的回归问题,常用的损失函数是均方差(mean square error),简称MSE。对于分类问题,就是使用交叉熵。
理论上而言,只要能够表示出预测值 y p r e d y_{pred} ypred和真实值 y y y之间差距的函数,都可以作为损失函数,例如绝对误差函数、均方差、欧氏距离等等都可以作为损失函数。
这里,我们可以直接使用绝对误差损失函数,其计算公式如下。
l ( y , y p r e d ) = ∣ y p r e d − y ∣ l(y,y_{pred})=|y_{pred}-y| l(y,ypred)=∣ypred−y∣
显然,当预测值和真实值差的越多,损失函数值就会越大,因此使用这个函数作为损失是没有问题的。当然,也可以用平方误差: l ( y , y p r e d ) = ( y p r e d − y ) 2 l(y,y_{pred})=(y_{pred}-y)^2 l(y,ypred)=(ypred−y)2。为了计算简便,我们统一用绝对误差。 -
计算误差
∵此时W=1,B=1,而输入数据x=1
∴输出 y p r e d = W x + B = 1 × 1 + 1 = 2 y_{pred}=Wx+B=1×1+1=2 ypred=Wx+B=1×1+1=2
∴损失值 l ( y , y p r e d ) = ∣ y p r e d − y ∣ = ∣ 2 − 8 ∣ = 6 l(y,y_{pred})=|y_{pred}-y|=|2-8|=6 l(y,ypred)=∣ypred−y∣=∣2−8∣=6
我们现在知道错了多少了,接下来的问题就是如何利用损失函数调整W和B。 -
梯度下降
大家可以想一下,造成“6”这个误差,到底是谁的错?是数据造成的吗?数据是给定的,这个“6”和数据无关。回看损失值的计算过程,唯二的变数就是W和B,误差就是W和B造成的。换句话说,如果W和B调整到合适的值,误差是有可能到0的,此时 ∣ y p r e d − y ∣ = 0 , y p r e d = y ∣ |y_{pred}-y|=0,y_{pred}=y| ∣ypred−y∣=0,ypred=y∣。这不就是我们想要的吗?所以,我们只要找一个方法,有方向、有目的的调整W和B,问题就解决了。数学上正好就有这样一个方法——梯度下降。
梯度是多元实值函数对应的一个向量值函数;在场论中也可认为是一个将标量场作用为向量场的算子。它代表多元函数的值改变“最快”的方向。用下图的二次函数作为例子,图中红色点所在位置,函数 f ( x ) f(x) f(x)的值不为0,若想要降低 f ( x ) f(x) f(x)的值,那么就要沿着所在点的右边移动一点,这样 f ( x ) f(x) f(x)的值就会减小。确定这个方向的就是梯度。
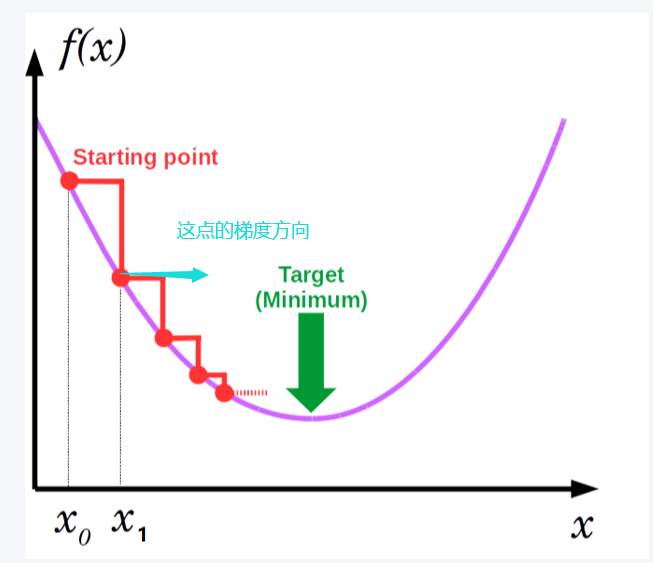
大白话:函数在某个点的导数的值。
再举个例子,例如:
y
=
x
2
+
5
x
+
3
y=x^2+5x+3
y=x2+5x+3,其导数
y
’
=
2
x
+
5
y’=2x+5
y’=2x+5,那么该函数在
x
=
1
x=1
x=1处的梯度
g
r
a
d
=
2
x
+
5
∣
x
=
1
=
7
grad=2x+5|_{x=1}=7
grad=2x+5∣x=1=7。这个“7”就是该函数在x=1处的梯度。大家也可以画一个图看看,
y
=
x
2
+
5
x
+
3
y=x^2+5x+3
y=x2+5x+3沿着
x
=
7
x=7
x=7处向“左走”(梯度反方向),其值会变小。当然,如果是多元函数,那么导数就要改为偏导。
梯度下降法指出,函数沿着梯度方向下降(也就是梯度的反方向)速度最快。
接下来我们继续补完之前的计算过程。
∵此时W=1,B=1,而输入数据x=1
∴输出
y
p
r
e
d
=
W
x
+
B
=
1
×
1
+
1
=
2
y_{pred}=Wx+B=1×1+1=2
ypred=Wx+B=1×1+1=2
∴损失值
l
(
y
,
y
p
r
e
d
)
=
∣
y
p
r
e
d
−
y
∣
=
∣
2
−
8
∣
=
6
l(y,y_{pred})=|y_{pred}-y|=|2-8|=6
l(y,ypred)=∣ypred−y∣=∣2−8∣=6
注意到损失函数
l
(
y
,
y
p
r
e
d
)
l(y,y_{pred})
l(y,ypred)是关于
W
W
W和
B
B
B的函数,那么此时,函数
l
l
l在
W
=
1
,
B
=
1
W=1,B=1
W=1,B=1处的梯度为?
将
y
p
r
e
d
=
W
x
+
B
y_{pred}=Wx+B
ypred=Wx+B带入到损失函数中:
l
(
y
,
y
p
r
e
d
)
=
∣
y
p
r
e
d
−
y
∣
=
∣
W
x
+
B
−
y
∣
l(y,y_{pred})=|y_{pred}-y|=|Wx+B-y|
l(y,ypred)=∣ypred−y∣=∣Wx+B−y∣,现在,我们更容易看出损失函数的自变量是
W
,
B
W,B
W,B了。下面对这个函数求W和B的偏导即可。先求W的导数,对于绝对值函数,要分绝对值内是正数还是负数的情况,所以有:
∂
l
∂
W
=
∂
(
∣
W
x
+
B
−
y
∣
)
∂
W
=
{
x
W
x
+
B
≥
y
−
x
W
x
+
B
<
y
\frac{\partial l}{\partial W}=\frac{\partial (|Wx+B-y|)}{\partial W}= \begin{cases} x & Wx+B≥y \\ -x & Wx+B<y \end{cases}
∂W∂l=∂W∂(∣Wx+B−y∣)={x−xWx+B≥yWx+B<y
∵
W
x
+
B
−
y
=
2
−
8
<
0
Wx+B-y=2-8<0
Wx+B−y=2−8<0
∴
∂
l
∂
W
=
−
x
\frac{\partial l}{\partial W}=-x
∂W∂l=−x,将
x
=
1
x=1
x=1带入,得到损失在
W
=
1
W=1
W=1处的梯度
∂
l
∂
W
∣
x
=
1
=
−
1
\frac{\partial l}{\partial W}|_{x=1}=-1
∂W∂l∣x=1=−1
同理,
∂
l
∂
B
=
−
1
\frac{\partial l}{\partial B}=-1
∂B∂l=−1,得到损失在
B
=
1
B=1
B=1处的梯度
∂
l
∂
B
=
−
1
\frac{\partial l}{\partial B}=-1
∂B∂l=−1。
梯度下降指出:函数值沿梯度反方向减小,因此,我们只需要将W和B向梯度反方向调整即可。
这里需要引入一个新的概念——学习率。梯度仅仅告诉我们朝那个方向走,但是没告诉我们沿着这个方向走多远。因此,我们需要一个值,表示我们要沿着梯度反方向走多远,这个值在机器学习里面就叫做学习率。学习率是机器学习中的超参数,意思就是这个值需要根据经验人为设定,这里我们不妨将其设置为1,即学习率
η
=
1
\eta=1
η=1。根据梯度下降公式,我们来更新W和B的值。过程如下:
W
←
W
−
η
⋅
∇
W
l
B
←
B
−
η
⋅
∇
B
l
W←W-\eta·\nabla_Wl\\ B←B-\eta·\nabla_Bl
W←W−η⋅∇WlB←B−η⋅∇Bl
其中,
∇
a
l
\nabla_al
∇al表示函数
l
l
l对变量
a
a
a的梯度。经过上面的式子更新,
W
=
1
−
1
×
(
−
1
)
=
2
,
B
=
1
−
1
×
(
−
1
)
=
2
W=1-1×(-1)=2,B=1-1×(-1)=2
W=1−1×(−1)=2,B=1−1×(−1)=2 。
那么,现在经过更新后的SNet能完成对上面数据的预测了吗?我们用第二行数据来试试。
∵此时W=2,B=2,而输入数据x=3
∴输出
y
p
r
e
d
=
W
x
+
B
=
2
×
2
+
3
=
8
y_{pred}=Wx+B=2×2+3=8
ypred=Wx+B=2×2+3=8
∴损失值
l
(
y
,
y
p
r
e
d
)
=
∣
y
p
r
e
d
−
y
∣
=
∣
8
−
18
∣
=
12
l(y,y_{pred})=|y_{pred}-y|=|8-18|=12
l(y,ypred)=∣ypred−y∣=∣8−18∣=12
很遗憾,此时
y
p
r
e
d
≠
y
y_{pred}≠y
ypred=y,因此这个网络还需要继续训练。那我们再计算一次梯度,然后继续使用梯度下降更新W和B。
∵
W
x
+
B
−
y
=
8
−
18
<
0
Wx+B-y=8-18<0
Wx+B−y=8−18<0
∴
∂
l
∂
W
=
−
x
\frac{\partial l}{\partial W}=-x
∂W∂l=−x,将
x
=
3
x=3
x=3带入,得到损失在
W
=
2
W=2
W=2处的梯度
∂
l
∂
W
∣
x
=
3
=
−
3
\frac{\partial l}{\partial W}|_{x=3}=-3
∂W∂l∣x=3=−3
同理,
∂
l
∂
B
=
−
1
\frac{\partial l}{\partial B}=-1
∂B∂l=−1,得到损失在
B
=
2
B=2
B=2处的梯度
∂
l
∂
B
=
−
1
\frac{\partial l}{\partial B}=-1
∂B∂l=−1。
W
=
W
−
η
⋅
∇
W
l
=
2
−
1
×
(
−
3
)
=
5
B
=
B
−
η
⋅
∇
B
l
=
2
−
1
×
(
−
1
)
=
3
W=W-\eta·\nabla_Wl=2-1×(-3)=5\\ B=B-\eta·\nabla_Bl=2-1×(-1)=3
W=W−η⋅∇Wl=2−1×(−3)=5B=B−η⋅∇Bl=2−1×(−1)=3
接下来,我们再用第三行数据去测试一下SNet能不能实现这样的数据预测。
∵此时W=5,B=3,而输入数据x=9
∴输出
y
p
r
e
d
=
W
x
+
B
=
5
×
9
+
3
=
48
y_{pred}=Wx+B=5×9+3=48
ypred=Wx+B=5×9+3=48
∴损失值
l
(
y
,
y
p
r
e
d
)
=
∣
y
p
r
e
d
−
y
∣
=
∣
48
−
48
∣
=
0
l(y,y_{pred})=|y_{pred}-y|=|48-48|=0
l(y,ypred)=∣ypred−y∣=∣48−48∣=0
我们发现,此时
y
p
r
e
d
=
y
y_{pred}=y
ypred=y,我们的SNet能够预测这样的数据了!
实际上,不论输入和输出是多复杂,也不论神经网络有多少层,他们都遵循一样的优化规律。因此,只要懂得了SNet怎么训练的,其他的神经网络是一样的道理(只不过要算的项目会多,但是原理一样)。
OK,“talk is cheap, show me the code ”。接下来我们把上述过程的代码贴在下面。
class SNet:
    def __init__(self,w=1,b=1):
        self.w=w
        self.b=b
        self.eta=1 #学习率
    def forward(self,x):
        return self.w*x+self.b
    #反向传播过程,输入需要一个数据x和一个标签y
    def backward(self,x,y):
        #反向传播之前先前向传播
        y_pred=self.forward(x)
        #计算误差
        l=y_pred-y
        #求梯度
        if l<0:
            dw=-x
            db=-1
        elif l>0:
            dw=x
            db=1
        else:   #绝对值函数在=0处没有导数定义,我们给他添加一个定义
            dw=0
            db=0
        #更新w和b
        self.w=self.w-self.eta*dw
        self.b=self.b-self.eta*db
if __name__=="__main__":
    #测试一下,先构造一些数据
    data=[[1,8],[3,18],[9,48],[0.2,4],[0.3,4.5]]
    #构建网络对象
    nn=SNet()
    #假设用前面三个数据用于训练
    for i in range(3):
        x,y=data[i]
        #训练nn
        nn.backward(x,y)
    print("训练完毕")
    #用数据测一测,看看准不准
    y_pred=nn.forward(0.2)
    print(y_pred)
    y_pred=nn.forward(0.4)
    print(y_pred)
这里再普及一下数据集的概念,上图左侧蓝色的部分的数据,我们一般叫做数据集。数据集中用于训练的部分,我们叫“训练集”,例如前两行数据。用来验证模型训练得好不好的数据集叫做“验证集”,例如第三行数据。最后两行数据,可以用于测试我们的网络性能,我们叫他们“测试集”。“验证集”和“测试集”都不能用来训练(也就是不能拿来做梯度下降),就像你们的期考题目中不会出现平时作业上的原题一样(σ`∀´)σ)。
右边绿色的部分,就是实际应用当中的数据了。例如,我们拿到了某个城市历史数据当中空气湿度(也就是x)和降雨量(y)的关系,那么我们可以用SNet结合这些数据训练一个模型。然后,再未来某一天,我们采集到当天的空气湿度数据,就能够预测今天的降雨量。
当然,这里可能预测得没有那么准,毕竟影响降雨量的因素太多了,肯定不止空气湿度一个,为了更加准确,我们可以将风速,风向,云层厚度等等加入到输入数据x中,此时我们的SNet就要改造成一个多输入单输出网络。而如果你除了降雨量之外还希望预测其他的东西(例如温度),那么SNet的输出就要是多个,此时SNet就要改造成一个多输入多输出网络,他们的训练原理和最简单的SNet是一样的。
总结:实际上,对于单层神经网络,使用梯度下降就已经足够了。而对于多层神经网络而言,也是依靠梯度下降进行训练(调整w和b)的,只不过多层神经网络会遇到一些新的问题,这些问题在1986年被David Rumelhart、Geoffrey Hinton 和 Ronald Williams 发表论文明确阐述,引发神经网络研究热潮 。
请注意:反向传播是基于梯度下降的,是梯度下降的优化和扩展。现在说反向传播算法,默认包括了梯度下降
2.3.2 多层神经网络的反向传播
之前看了单层神经网络的优化过程,我们现在把这个过程扩展到多输入、多输出的多层神经网络,看看会出现什么情况。
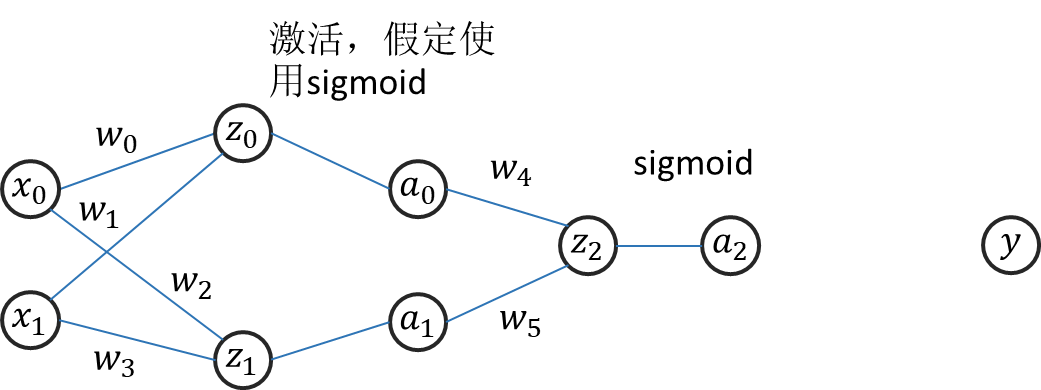
考虑如上神经网络的调整过程。该网络有两个输入,两层,第一层输入2,输出2,;第二层输入2,输出1。
a
2
a_2
a2是最终输出,
y
y
y是真实值,用于计算误差。
反向传播的最终目的就是要求损失函数对于w和b的偏导或者梯度。
此处损失函数使用二范数, C = 1 2 ( y − a 2 ) 2 C=\frac{1}{2}(y-a_2)^2 C=21(y−a2)2,前面的1/2是为了方便计算,平方求导刚好约掉。此处再说明一下,之前的神经元是一个圈,左边是z右边是a,这里为了更加清晰,将z和a分开成两个圈了,计算过程还是一样的。
-
前向传播的计算过程
如同前面的单层网络一样,反向传播之前需要先进行一次前向传播(前向传播的起点是输入),我们通过上面的图,将其中的所有 z , a z,a z,a的表达式都写出来。我们沿着数据的传播方向编写,例如写前向传播过程时,我们从左往右写,过程如下。
先计算 z 0 , z 1 z_0,z_1 z0,z1:
z 0 = w 0 x 0 + w 1 x 1 + b 0 z 1 = w 2 x 1 + w 3 x 1 + b 1 z_0=w_0x_0+w_1x_1+b_0\\ z_1=w_2x_1+w_3x_1+b_1 z0=w0x0+w1x1+b0z1=w2x1+w3x1+b1
再计算 a 0 , a 1 a_0,a_1 a0,a1:
a 0 = σ ( z 0 ) a 1 = σ ( z 1 ) a_0=\sigma(z_0)\\ a_1=\sigma(z_1) a0=σ(z0)a1=σ(z1)
再计算 z 2 , a 2 z2,a2 z2,a2:
z 2 = w 4 a 0 + w 5 a 1 + b 2 a 2 = σ ( z 2 ) z_2=w_4a_0+w_5a_1+b_2\\ a_2=\sigma(z_2) z2=w4a0+w5a1+b2a2=σ(z2) -
反向传播过程
接下来开始上面所述网络的反向传播过程,这里再强调一遍:反向传播的最终目的就是要求损失函数对于w和b的偏导或者梯度。
所以,我们要先计算损失函数,然后再对损失函数求w和b的偏导。
由于网络最终输出是 a 2 a_2 a2,因此损失函数C的表达式是:
C = 1 2 ( y − a 2 ) 2 C=\frac{1}{2}(y-a_2)^2 C=21(y−a2)2
好,接下来让我们愉快的求C对于w和b的偏导!
先来个简单的,求 C C C对 w 5 w_5 w5的偏导。(至于为什么要先求 w 5 w_5 w5的偏导,直观上是为了简便,逻辑上是因为我们前面说了,沿着传播方向来进行计算,反向传播是从损失到w的,也就是从右边到左边,刚好和前向传播反过来。)
∂ C ∂ w 5 = ? ? ? \frac{\partial C}{\partial w_5}=??? ∂w5∂C=???
这里要用到数学上的复合函数求导规则,也就是所谓的链式求导。我们可以看一下损失函数 C C C的表达式,其中是没有关于变量 w 5 w_5 w5的表达的,因此无法直接求。但是我们知道, C C C的表达式中的 a 2 = σ ( z 2 ) a_2=\sigma(z_2) a2=σ(z2),而 z 2 = w 4 a 0 + w 5 a 1 + b 2 z_2=w_4a_0+w_5a_1+b_2 z2=w4a0+w5a1+b2,这里面就有 w 5 w_5 w5的表达式。如果不理解,你可以将 z 2 z_2 z2带入 a 2 a_2 a2,再将 a 2 a_2 a2带入 C C C的表达式,你可以得到一样的结果。因此:
∂ C ∂ w 5 = ∂ C ∂ a 2 ∂ a 2 ∂ z 2 ∂ z 2 ∂ w 5 \frac{\partial C}{\partial w_5}=\frac{\partial C}{\partial a_2}\frac{\partial a_2}{\partial z_2}\frac{\partial z_2}{\partial w_5} ∂w5∂C=∂a2∂C∂z2∂a2∂w5∂z2
通过查看前向传播过程的式子,我们可以得到:
∂ C ∂ a 2 = a 2 − y ∂ a 2 ∂ z 2 = σ ′ ( z 2 ) ∂ z 2 ∂ w 5 = a 1 \frac{\partial C}{\partial a_2}=a_2-y\\ \frac{\partial a_2}{\partial z_2}=\sigma'(z_2)\\ \frac{\partial z_2}{\partial w_5}=a_1 ∂a2∂C=a2−y∂z2∂a2=σ′(z2)∂w5∂z2=a1
所以,最终我们可以得到损失函数对 w 5 w_5 w5的偏导 ∂ C ∂ w 5 = ( a 2 − y ) σ ′ ( z 2 ) a 1 \frac{\partial C}{\partial w_5}=(a_2-y)\sigma'(z_2)a_1 ∂w5∂C=(a2−y)σ′(z2)a1。注意,这里面的每一个值都是在前向传播中已经计算出来了的,将这些值带入,就可以得到梯度。
类似的,我们可以计算出损失对 w 4 w_4 w4的偏导:
∂ C ∂ w 4 = ∂ C ∂ a 2 ∂ a 2 ∂ z 2 ∂ z 2 ∂ w 4 \frac{\partial C}{\partial w_4}=\frac{\partial C}{\partial a_2}\frac{\partial a_2}{\partial z_2}\frac{\partial z_2}{\partial w_4} ∂w4∂C=∂a2∂C∂z2∂a2∂w4∂z2
带入前向传播的值,我们可以得到损失函数在 w 4 w_4 w4的梯度。
下面我们来尝试一下计算对 w 3 w_3 w3的偏导。如果求解过程不清楚复合函数关系,可以翻回去看一下之前的前向传播计算图。要求 w 3 w_3 w3的偏导,可做如下分析:C是 a 2 a_2 a2的函数, a 2 a_2 a2是 z 2 z_2 z2的函数, z 2 z_2 z2是 a 1 a_1 a1的函数, a 1 a_1 a1是 z 1 z_1 z1的函数, z 1 z_1 z1是 w 3 w_3 w3的函数,因此:
∂ C ∂ w 3 = ∂ C ∂ a 2 ∂ a 2 ∂ z 2 ∂ z 2 ∂ a 1 ∂ a 1 ∂ z 1 ∂ z 1 ∂ w 3 \frac{\partial C}{\partial w_3}=\frac{\partial C}{\partial a_2}\frac{\partial a_2}{\partial z_2}\frac{\partial z_2}{\partial a_1}\frac{\partial a_1}{\partial z_1}\frac{\partial z_1}{\partial w_3} ∂w3∂C=∂a2∂C∂z2∂a2∂a1∂z2∂z1∂a1∂w3∂z1
同理,我们也能计算出 C C C对 w 2 , w 1 , w 0 w_2,w_1,w_0 w2,w1,w0的偏导,带入前向传播过程中的值,可以算出梯度。
我们接下来算一下 C C C对偏置的导数,从 b 2 b_2 b2开始。
∂ C ∂ b 2 = ∂ C ∂ a 2 ∂ a 2 ∂ z 2 ∂ z 2 ∂ b 2 ∂ C ∂ b 1 = ∂ C ∂ a 2 ∂ a 2 ∂ z 2 ∂ z 2 ∂ a 1 ∂ a 1 ∂ z 1 ∂ z 1 ∂ b 1 \frac{\partial C}{\partial b_2}=\frac{\partial C}{\partial a_2}\frac{\partial a_2}{\partial z_2}\frac{\partial z_2}{\partial b_2}\\ \frac{\partial C}{\partial b_1}=\frac{\partial C}{\partial a_2}\frac{\partial a_2}{\partial z_2}\frac{\partial z_2}{\partial a_1}\frac{\partial a_1}{\partial z_1}\frac{\partial z_1}{\partial b_1} ∂b2∂C=∂a2∂C∂z2∂a2∂b2∂z2∂b1∂C=∂a2∂C∂z2∂a2∂a1∂z2∂z1∂a1∂b1∂z1
如此一来,问题就全部解决了。因为我们能够算出损失 C C C对任一变量 w , b w,b w,b的偏导,利用之前的梯度下降,就能够对任一神经网络进行训练。但是,上面的算法还会面临一个问题,那就是计算量太大。
上面的例子中,我们的神经网络仅有两层,求网络浅层(靠左边)的权重和偏置的偏导要经过大量的计算。试想一下,如果这个网络有几十层甚至上百层,那这个偏导计算式子会是什么样?**恐怕一黑板都写不完吧?**计算机会陷入计算量爆炸的窘境。所以,上面的算法如何进行优化呢?
仔细观察可以发现,上面求解w和b的梯度的公式中,有些部分的计算是重复了的,前一层的梯度计算会用到后面一层的梯度,如下图所示。
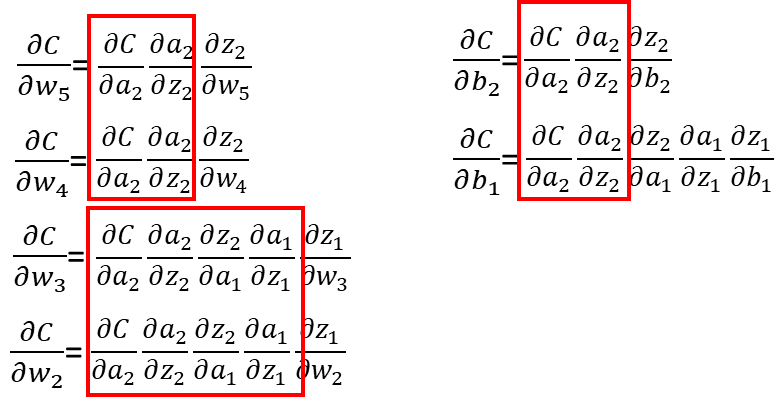
如果我们在计算过程中,将一些偏导的中间过程存储下来,在需要使用这个值的时候直接读取而不是重新计算,那么就可以节约大量的计算(当然,这个过程使是用空间换时间的)。这就是大名鼎鼎的反向传播算法。注意,他不是一种新的神经网络训练方法,而是对梯度下降的一种优化。现代神经网络都是依赖于反向传播算法进行训练的,可以说,没有反向传播算法,就没有如今的AI大繁荣。反向传播算法也是2024年诺贝尔物理学奖的获奖内容。 -
反向传播算法(完整版)
友情提示:下面的内容相对硬核,非专业研究可以跳过。
下面我们来硬核推导一下反向传播算法公式。为了方便理解,我们还是想象这样一个网络。
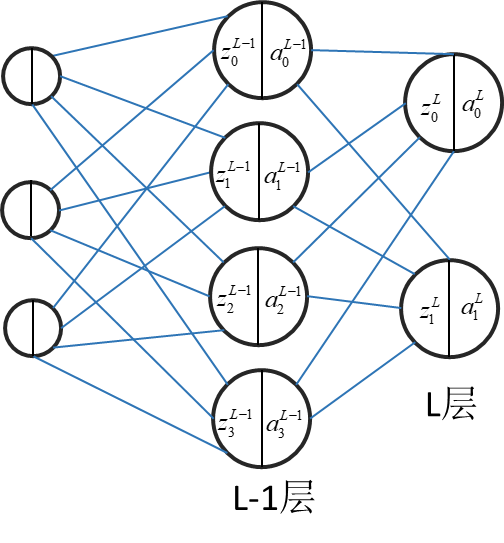
这个网络是一个L层网络(L可以是大于1的任意整数),每层神经元个数可以是任意的。显然,这个模型能够代表所有的全连接网络模型。在之前的讨论中,我们已经知道了前向传播过程,可以使用如下公式表达。
前向传播过程公式:
z l = w l a l − 1 + b l a l = σ ( z l ) C = f ( y , a L ) z^l=w^la^{l-1}+b^l\\ a^l=\sigma(z^l)\\ C=f(y,a^L) zl=wlal−1+blal=σ(zl)C=f(y,aL)
C C C依然表示损失函数,他是标签 y y y和网络最终输出 a L a^L aL的函数,这里使用抽象函数表达,他可以是均方误差,绝对误差等等具体函数。
那么,我们的目的是什么?
再强调一次,反向传播的最终目的就是要求损失函数对于w和b的偏导或者梯度。
那么,来算吧。为了方便,我们引入一个新标记:
δ j l = ∂ C ∂ z j l \delta_j^l=\frac{\partial C}{\partial z_j^l} δjl=∂zjl∂C
上式表示损失函数对于网络中任一 l l l层的第 j j j个未激活输出的偏导。在反向传播中,第一个被求出来的一定是损失函数对于最后一层(也就是L层)的权重和偏置的偏导。因此,我们先来求最后一层的偏置的偏导。
∵已知 δ j l = ∂ C ∂ z j l \delta_j^l=\frac{\partial C}{\partial z_j^l} δjl=∂zjl∂C,
∴得到 δ j L = ∂ C ∂ z j L \delta_j^L=\frac{\partial C}{\partial z_j^L} δjL=∂zjL∂C
而 z L = w L a L − 1 + b L z^L=w^La^{L-1}+b^L zL=wLaL−1+bL (1), a L = σ ( z L ) a^L=\sigma(z^L) aL=σ(zL) (2)
∴ δ j L = ∂ C ∂ z j L = ∂ C ∂ a j L ∂ a j L ∂ z j L \delta_j^L=\frac{\partial C}{\partial z_j^L}=\frac{\partial C}{\partial a_j^L}\frac{\partial a_j^L}{\partial z_j^L} δjL=∂zjL∂C=∂ajL∂C∂zjL∂ajL
将(1)、(2)带入 δ j L \delta_j^L δjL,得到: δ j L = ∂ C ∂ a j L σ ′ ( z j L ) \delta_j^L=\frac{\partial C}{\partial a_j^L} \sigma'(z_j^L) δjL=∂ajL∂Cσ′(zjL)
显然,上面式子对于所有的 j j j都成立,那么上式最终写成向量式为:
δ L = ∇ a C ⊙ σ ′ ( z L ) \delta^L=\nabla_aC\odot\sigma'(z^L) δL=∇aC⊙σ′(zL)
其中, ∇ \nabla ∇是梯度算子, ∇ a C \nabla_aC ∇aC表示C在a处的梯度, ⊙ \odot ⊙是哈的马达运算符,表示逐元素相乘。通过上面的式子,我们求出了网络最后一层未激活输出对于损失函数的偏导。
接下来,我们终于可以求损失函数对于最后一层偏置的偏导了,由于已经算出 δ L = ∇ a C ⊙ σ ′ ( z L ) \delta^L=\nabla_aC\odot\sigma'(z^L) δL=∇aC⊙σ′(zL),所以计算过程很简单。
∂ C ∂ b L = ∂ C ∂ z L ∂ z L ∂ b L \frac{\partial C}{\partial b^L}=\frac{\partial C}{\partial z^L}\frac{\partial z^L}{\partial b^L} ∂bL∂C=∂zL∂C∂bL∂zL
注意到 z L = w L a L − 1 + b L z^L=w^La^{L-1}+b^L zL=wLaL−1+bL,因此 ∂ z L ∂ b L = 1 \frac{\partial z^L}{\partial b^L}=1 ∂bL∂zL=1(除了b,其他都是常量),而 ∂ C ∂ z L = δ L \frac{\partial C}{\partial z^L}=\delta^L ∂zL∂C=δL,所以最终:
反向传播中的第一个公式(BP1):
∂ C ∂ b L = δ L \frac{\partial C}{\partial b^L}=\delta^L ∂bL∂C=δL
不失一般性,反向传播中第二个公式(BP2):
∂ C ∂ b l = δ l \frac{\partial C}{\partial b^l}=\delta^l ∂bl∂C=δl
(BP1)给出了整个网络中,最后一层偏置对损失函数的导数,(BP2)告诉我们网络中任意层的偏置对损失函数的导数。但问题是, δ l \delta^l δl没有通用表达式,除了当 l = L l=L l=L时,无法求出。下面我们要设法获取到 δ l \delta^l δl的表达式,这样任意层偏置对损失函数的导数就能求出了。
我们之前已经求出最后一层 δ L \delta^L δL的值。那么,我们应该能通过 δ L \delta^L δL求出 δ L − 1 \delta^{L-1} δL−1,在求出 δ L − 1 \delta^{L-1} δL−1…根据这样的递推思想,我们不难想到,对于任意一层的 δ l − 1 \delta^{l-1} δl−1有:(至于为什么想到要这样写,是因为我们已经定义了 δ j l = ∂ C ∂ z j l \delta_j^l=\frac{\partial C}{\partial z_j^l} δjl=∂zjl∂C)
δ l − 1 = ∂ C ∂ z l − 1 = ( ∂ C ∂ z l ) ( ∂ z l ∂ a l − 1 ∂ a l − 1 ∂ z l − 1 ) \delta^{l-1}=\frac{\partial C}{\partial z^{l-1}}=(\frac{\partial C}{\partial z^l})(\frac{\partial z^l}{\partial a^{l-1}}\frac{\partial a^{l-1}}{\partial z^{l-1}}) δl−1=∂zl−1∂C=(∂zl∂C)(∂al−1∂zl∂zl−1∂al−1)
其中, ∂ C ∂ z l = δ l \frac{\partial C}{\partial z^l}=\delta^l ∂zl∂C=δl, ∂ a l − 1 ∂ z l − 1 = σ ′ ( z l − 1 ) \frac{\partial a^{l-1}}{\partial z^{l-1}}=\sigma'(z^{l-1}) ∂zl−1∂al−1=σ′(zl−1), ∂ z l ∂ a l − 1 = w l T \frac{\partial z^l}{\partial a^{l-1}}={w^l}^T ∂al−1∂zl=wlT。 w l w^l wl之所以要转置,是因为矩阵变量求导之后行列互换,具体的可以参考矩阵论或者最优化方法的相关内容。最终,我们得到反向传播算法的第三个关键公式(BP3):
δ l − 1 = w l T ⋅ δ l ⋅ σ ′ ( z l − 1 ) \delta^{l-1}={w^l}^T·\delta^l·\sigma'(z^{l-1}) δl−1=wlT⋅δl⋅σ′(zl−1)
好了,现在我们能够求得任意一层偏置对损失函数的导数了。最后,我们来求任意一层权重对损失函数的导数,也就是 ∂ C ∂ w j k l \frac{\partial C}{\partial w_{jk}^l} ∂wjkl∂C。计算的时候,时刻记住 δ l \delta^l δl是一个已知的值,且: δ j l = ∂ C ∂ z j l \delta_j^l=\frac{\partial C}{\partial z_j^l} δjl=∂zjl∂C
∂ C ∂ w j k l = ∂ C ∂ z j l ∂ z j l ∂ w j k l = δ l ⋅ ∂ ( ∑ m = 0 k w j m l ⋅ a m l − 1 + b j l ) ∂ w j k l \frac{\partial C}{\partial w_{jk}^l}=\frac{\partial C}{\partial z_j^l}\frac{\partial z_j^l}{\partial w_{jk}^l}= \delta^l·\frac{\partial (\sum_{m=0}^kw_{jm}^l·a_m^{l-1}+b_j^l )}{\partial w_{jk}^l} ∂wjkl∂C=∂zjl∂C∂wjkl∂zjl=δl⋅∂wjkl∂(∑m=0kwjml⋅aml−1+bjl)
上面公式的求和部分关于 w j k l w_{jk}^l wjkl的偏导部分,仅有 m = k m=k m=k时才不为0,因为对于任意 m ≠ k m≠k m=k的 w j m l w_{jm}^l wjml,对于 w j k l w_{jk}^l wjkl而言都是常数。最终,得到反向传播算法最后一个公式(BP4):
∂ C ∂ w j k l = δ l ⋅ a k l − 1 \frac{\partial C}{\partial w_{jk}^l}=\delta ^l·a_k^{l-1} ∂wjkl∂C=δl⋅akl−1
让我们把这四个式子写在一起:
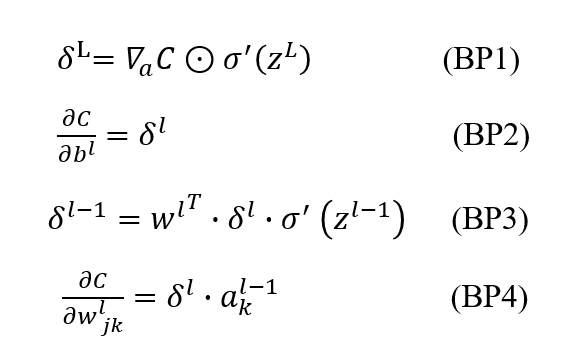
我们再来复盘一下。(BP1)告诉我们如何计算最后一层的误差,注意,将损失,最后一层的激活输出,未激活输出,带入(BP1)是可以算出一个具体的数值的,我们可以将这个数值存储到计算机中,需要用的时候就不用重新算了。
(BP2)告诉我们,神经网络中任意一层偏置对损失函数的导数就是该层的误差。接下来(BP3)马上就告诉我们该如何去计算每一层的误差,而且这个每一层的误差还用于求任意层权重对损失的导数,这就是(BP4)告诉我们的事情。
在(BP3)和(BP4)中, w w w是已知的, z , a z,a z,a在前向传播中是全部计算过的,因此不用重复计算。
现在,你应该对我之前说的话有了更深刻的理解。
如果我们在计算过程中,将一些偏导的中间过程存储下来,在需要使用这个值的时候直接读取而不是重新计算,那么就可以节约大量的计算,这就是反向传播算法。注意,他不是一种新的神经网络训练方法,而是对梯度下降的一种优化。
反向传播算法就是将需要使用到的数据存储起来,避免重复运算,从而提升神经网络训练的速度。
呼~终于写完了,如有任何疑问,建议,欢迎交流。这个系列应该会一直更新,喜欢可以给个收藏和关注。
更多推荐

 14
 0
- 0


 已为社区贡献2条内容

所有评论(0)