
分身有术:一文读懂大模型里的 Sub Agent 机制
Sub Agent 直译是「子智能体」,但你完全可以把它想象成主智能体雇来的临时工或者专科医生。当主智能体遇到一件适合外包的事——比如「把整个代码库摸一遍」「跑一轮对抗性的代码审查」「把这十个互不相干的小修改并行做掉」——它就召唤出一个子智能体来专门干这件事。
前言
你有没有过这种体验:让 AI 帮你改一个复杂的项目,它先翻了几十个文件、跑了一堆测试、又顺手查了三份文档,等真正要动手写代码时,前面那些七零八碎的搜索结果、报错日志、半截思路,已经把对话塞得满满当当。结果就是——它越聊越「上头」,越聊越容易忘记你最初到底想要什么。这在业内有个挺形象的说法,叫「上下文污染」(context pollution),更狠一点的叫「上下文腐烂」(context rot)。
大模型的上下文窗口再大,也是有边界的。把所有杂活都堆在同一个对话里,就像让一个人一边开重要的战略会,一边还要在同一张桌子上拆快递、对账单、回消息——桌子很快就乱成一锅粥。于是,大牛们想到了一个特别朴素、又特别管用的点子:与其让「主脑」事必躬亲,不如让它学会「分身」,把脏活累活外包出去。这,就是我们今天要聊的主角——Sub Agent(子智能体)机制。
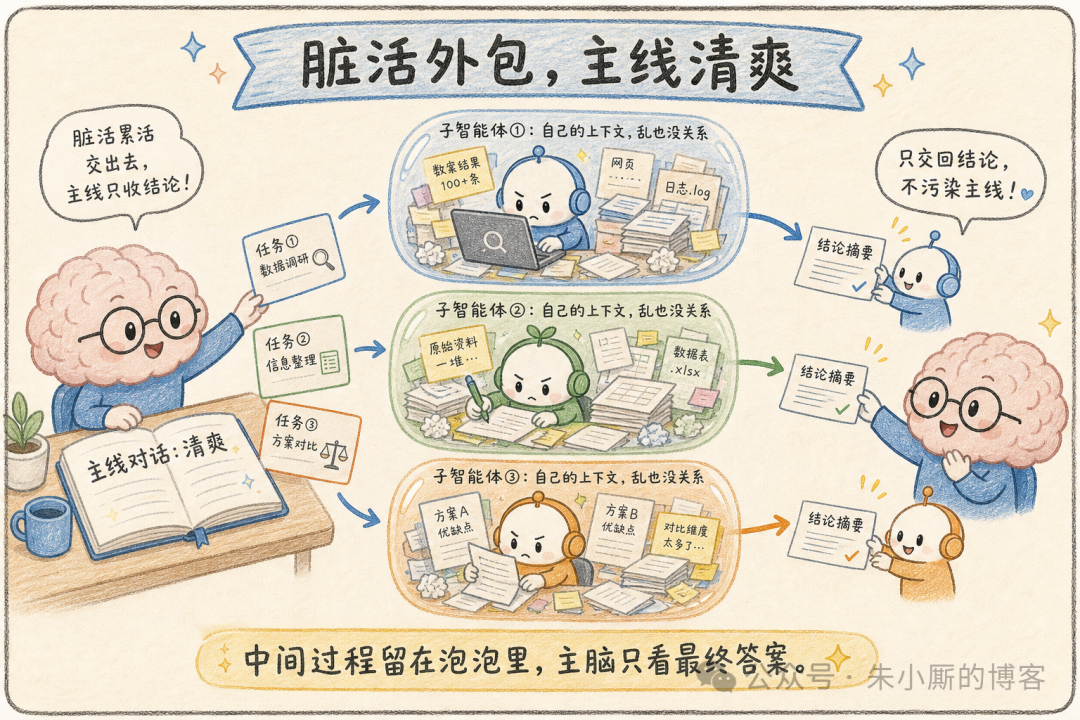
脏活外包,主线清爽:过程留在泡泡里,主脑只看结论
一、到底什么是 Sub Agent
Sub Agent 直译是「子智能体」,但你完全可以把它想象成主智能体雇来的临时工或者专科医生。当主智能体遇到一件适合外包的事——比如「把整个代码库摸一遍」「跑一轮对抗性的代码审查」「把这十个互不相干的小修改并行做掉」——它就召唤出一个子智能体来专门干这件事。这个子智能体是一个完全独立的实例:有自己独立的对话循环、自己的工具集、自己的权限边界,甚至有自己专属的「人设」(系统提示)。它干完活,把结果交回来,主智能体只看到最终产出,看不到它内部那些抓耳挠腮的推理过程。
这套机制最关键的三个特性,拆开来其实特别好懂:
第一,上下文是隔离的。每个子智能体启动时都是一张「干净的白纸」——它看不到主对话此前的聊天记录,也不知道主智能体刚才读过哪些文件。主智能体唯一能塞给它的,就是召唤它时写的那段任务说明。所以一个好用的派活姿势,是把文件路径、报错信息、关键决定都直接写进任务里,别指望子智能体「心有灵犀」。也正因为隔离,子智能体那边再怎么翻江倒海、堆满日志,都不会弄脏主线。
第二,工具和权限是定制的。子智能体可以只拿到它这趟任务真正需要的工具,权限也能单独收紧。让一个「只读探索」的子智能体老老实实只读不写,既安全又省心。
第三,只交回结论。这是整套机制的精髓。子智能体在自己的上下文窗口里把搜索、试错、验证全部消化掉,最后只把一段「总结」吐回给主智能体。噪音留在原地,主线保持清爽——这就是为什么用了子智能体,主对话能「越聊越清醒」而不是「越聊越糊涂」。
顺带提一个有意思的变体:fork(分叉)。普通子智能体是白纸出生,而 fork 出来的子智能体会继承主对话的全部上下文——同样的系统提示、同样的工具、同样的历史记录。它牺牲了「输入隔离」,换来的是「不用重新解释背景」,特别适合那种「要讲清楚来龙去脉太费劲」的支线任务,或者想从同一个起点并行尝试好几种方案的场景。但即便是 fork,它自己的那些工具调用依然不会回灌进主对话,最后还是只把结论带回来。
二、拆开看
从架构上讲,子智能体机制其实是一套「主—从」结构。主智能体是指挥官,子智能体是专业工兵。这套结构往上能长出各种花样:最简单的是「一个主管 + 几个工人」,复杂一点能搭成「协调者—工人」的层级团队,再往上甚至能组织起多智能体的「蜂群」协作。但万变不离其宗,每一个子智能体的生命周期,都遵循一条清清楚楚的流水线。
我们可以把它想象成一个临时工的一天:第一步「派生」——主智能体发现有活儿适合外包,按下召唤开关,一个新的子智能体诞生。第二步「装备」——系统给这个新人配齐三样东西:一个全新空白的上下文(我补充一下:这里说的不严谨,实际上应该是 sub agent在启动的那一刻,它会拿到一份main agent的一份context快照,而且这个快照并不一定是完全继承,而可能是摘要继承。之后 main agent 的 context有变化时, sub agent是感知不到的,相当于起始时继承了一下 main agent的上下文)、一套带权限锁的专属工具箱、一顶写着角色名的「人设帽子」。第三步「干活」——子智能体在自己的小泡泡里埋头苦干,搜索、读文件、跑命令、反复试错,过程要多乱有多乱,反正外面看不见。第四步「交付」——活干完了,它把一张「结论摘要」递回给主智能体。第五步「回收」——泡泡收起,资源清理干净,任务彻底结束。
这套生命周期还藏着两个让它特别强大的「隐藏属性」。一是可并行:既然每个子智能体都是独立小泡泡,那就可以同时开好几个——一个去审计登录流程,一个去梳理出错的测试,一个去追踪数据库调用链,主智能体在中间稳稳地当「拍板的人」,整体效率自然水涨船高。二是可嵌套与可追溯:子智能体在某些实现里还能再召唤自己的子智能体(当然有深度上限,免得无限套娃);同时它的完整工作记录会被单独存档,事后可以回放、可以追溯,这对调试和复盘特别友好。
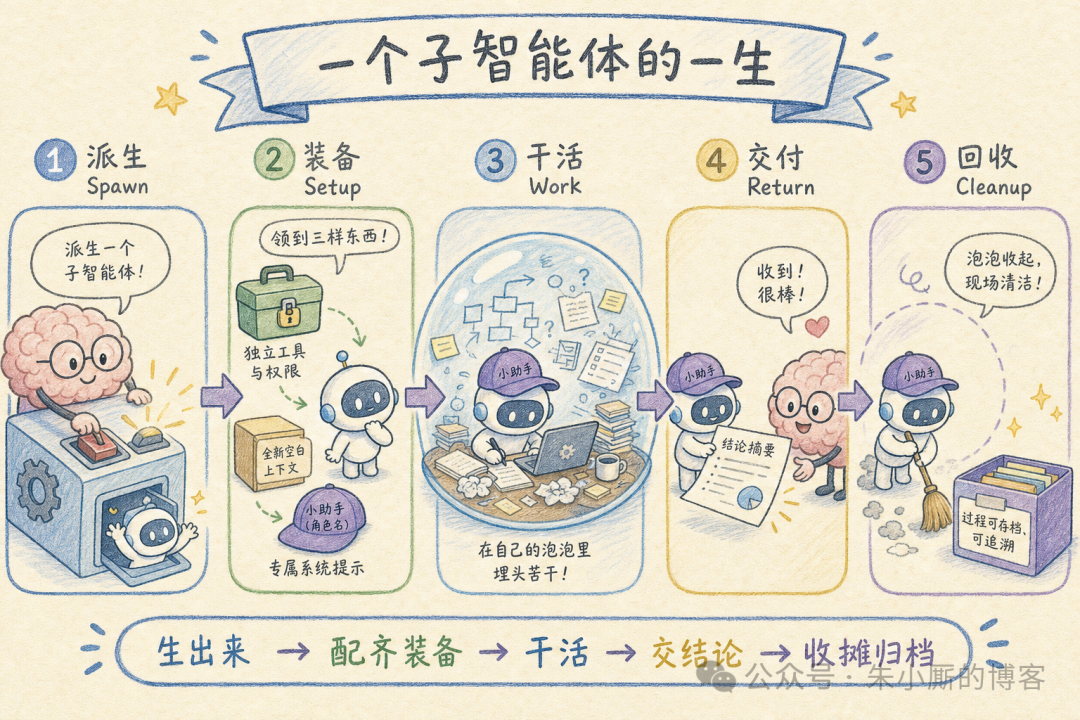
一个子智能体的一生:派生 → 装备 → 干活 → 交付 → 回收
三、什么时候该叫上「分身」
子智能体虽好,可不是「凡事都喊一帮人来」就显得高级。它真正发光的场景,有一个共同特征:这件事能被干净地切成互不打架的小块,而且大多是「读得多、写得少」的活。最典型的四类,一是代码库探索——满世界找定义、理调用关系,这种会产生海量中间结果却又不需要回头反复看的活,扔给子智能体最合适;二是并行调研——同一个问题从几个角度同时挖,谁先挖到算谁的;三是独立审查——专门派一个「唱反调」的子智能体来挑刺、找漏测、做安全检查,因为它视角独立,反而更容易发现主线里被惯性忽略的问题;四是大批量同质任务——比如几十个长得差不多的小工单,一个子智能体处理一行,处理完统一汇总。
反过来说,有两种情况要悠着点。一是写操作密集的并行:好几个子智能体同时改代码,很容易互相踩脚、产生冲突,这种「需要协调」的活就别盲目并行了。二是本来就很轻、很线性的任务:召唤子智能体本身是有开销的,杀鸡用牛刀只会更慢更贵。说白了,子智能体不是「免费的超能力」,它把工程里的「任务拆解与协调」这件事,原封不动地搬到了你写提示词的那一刻——你拆得越干净,分身们带回来的东西就越有用;拆不干净,那就是收获一堆更同步的噪音而已。
四、Claude Code 是怎么玩的
在 Claude Code 里,子智能体是一等公民,而且玩得相当「自动化」。它的入口是一个叫 Agent 的工具:当主模型判断某件事值得委派,它就调用这个工具,背后由一段约四百行、被称作 runAgent() 的生命周期函数接管,从创建、权限过滤、工具解析一直到最后的清理,每个子智能体都走这同一条流水线。最妙的是「自动判断」——你甚至不用预先定义任何角色,Claude 也会在合适的时候自己召唤一个内置的「通用型」(general-purpose)子智能体去做调研或探索。
如果你想要专属的「专科助手」,做法也很轻量:在 .claude/agents/ 目录下放一个 Markdown 文件,开头用一段 YAML 写明这个角色叫什么、擅长干什么、能用哪些工具、有什么权限,正文就是给它的系统提示。当主智能体遇到匹配描述的任务,就会自动把活派给对应的角色。前面提到的 fork 也在这里:当一个具名角色需要太多背景才能开工时,直接 fork 一份带着完整上下文的分身往往更省事,还能复用已经缓存的提示片段、更省钱。
它还有几个值得一提的细节。
会嵌套:从 Claude Code v2.1.172 起,子智能体可以再生子智能体,但有深度上限(大约到第五层就不让再往下生了),防止无限套娃。
可追溯、可恢复:每个子智能体的完整对话会被存成独立的 JSONL 记录文件,事后能凭它的 agentId 回放甚至恢复会话。
有更重的「升级版」:如果你要协调的不是几个、而是几十上百个智能体,官方建议改用 Workflow 工具,把编排逻辑搬到一段脚本里由运行时执行,而不是硬塞进逐回合的对话里。
五、Codex 又是怎么玩的
OpenAI 的 Codex 在 2026 年 3 月 16 日正式向所有开发者开放了子智能体,App 和命令行都能用。它的设计哲学和 Claude Code 有一处很关键的不同:Codex 不会自作主张地分身。它只在你明确开口时才召唤子智能体——你得说出「派两个 agent」「这块并行处理」「一个要点一个 agent」之类的话,它才动手。官方把这点讲得很直白:子智能体不是更省,它们各自要跑模型、用工具,反而比单个 agent 更费 token。所以要不要分身,决定权牢牢攥在你手里。
配置上,Codex 走的是 TOML 路线:在 .codex/agents/ 里定义自定义角色,可以单独指定模型、沙箱模式、MCP 工具、技能配置等,没写的字段就从父会话继承。并发与深度则在 config.toml 的 [agents] 段里管控,两个默认值很值得记住:max_threads 默认 6,也就是最多同时开 6 个 agent 线程;max_depth 默认 1,意思是允许直接的子 agent,但不让它再往下嵌套。官方特意提醒:把 max_depth 调大要谨慎,否则一句宽泛的「都去并行」可能引发层层 fan-out,token、延迟和本地资源消耗都会失控。
Codex 还有两个挺实用的招数。一个是实验性的 spawn_agents_on_csv 工具:你给一张 CSV,它一行派一个工人 agent,等整批跑完,再把结果合并导出成 CSV——批量同质任务的福音。另一个是命令行里的 /agent:你可以随时切进某个正在跑的 agent 线程,看看它在忙什么,或者直接喊话去引导、叫停、关闭它。毕竟「委派」不等于「闭眼信任」,关键决策还是得有人盯着。模型搭配上,官方的务实建议是主线用强一点的模型、轻量子任务交给更小更快的 mini 档,难啃的工程活再上专门的 codex 档。
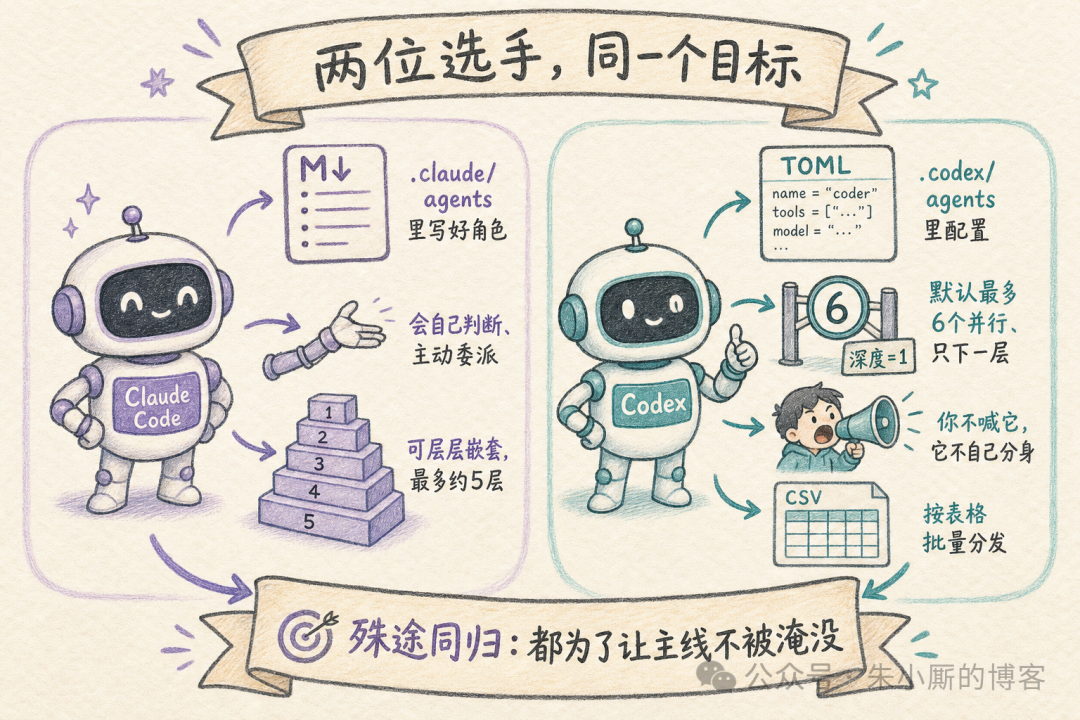
两位选手,同一个目标:Claude Code 自动委派 vs Codex 显式召唤
六、提醒
聊到这儿,得给热情泼一点点冷水。子智能体很迷人,但它解决的是「上下文压力」,不是「工程管理」本身。第一,它更费钱:每个分身都是一次独立的模型与工具消耗,分得越多账单越长,别为了「看起来很并行」而无脑开分身。第二,它不是额外的安全护盾:子智能体继承的是你的沙箱和审批策略,并行写代码还可能制造协调难题,真正安全的做法是只在「确实能并行、且以读为主」的活上用它。第三,它把管理责任搬到了提示词层:会拆活的人能借它把调研并行化、跑得飞快;不会拆的人,只会用更多同时输出,更快地撞上同一堵墙。
结语:从「一个人扛」到「带一支队伍」
说到底,Sub Agent 机制标志着 AI 编程助手的一次思路转变:从「一个超级大脑硬扛所有事」,进化成「一个清醒的指挥官 + 一支召之即来、用完即散的专业小队」。Claude Code 让它聪明地自动发生,Codex 让它老实地听你调遣,路径不同,但都指向同一个朴素的目标——让主线别被淹没,让 AI 在复杂任务里始终记得「我到底要干嘛」。下一次当你的 AI 又开始「越聊越上头」时,也许你该轻轻提醒它一句:这活儿,要不叫个分身?
📌 三十秒收尾:子智能体 = 主脑临时召唤的专业小助手,独立上下文、独立工具、只交回结论;适合「能拆开、读得多」的活,不适合「要协调、写得多」的活;Claude Code 自动委派、靠 Markdown 定义、可嵌套,Codex 必须显式召唤、靠 TOML 配置、默认最多 6 个并行只下一层。本质都是为了——主线清爽,思路不丢。
更多推荐

 11
 0
- 0


 已为社区贡献12条内容

所有评论(0)