
机器学习实验——KNN算法
一、KNN算法的简单了解
KNN算法是机器学习里非常基础又好懂的算法,适用性特别强,不管是做分类任务,还是处理回归问题都能用上。它的核心思路很简单:通过计算不同数据特征值之间的距离,来给新数据做分类。
具体来说,每一个包含n个特征的输入数据,在特征空间里都能对应一个独一无二的点。而KNN算法最终给出的结果,要么是这个点对应的类别标签,要么是一个具体的预测数值。
KNN还有个很特别的地方——它不像传统机器学习算法那样有专门的“学习训练”步骤。它的工作方式,是直接用训练数据把特征空间划分好,这个划分后的结果,就是它最终的模型。实际使用时,我们会有一个带标签的样本数据集,也就是说,我们清楚里面每一个数据对应的类别是什么。
当有一个不带标签的新数据进来时,KNN会把这个新数据的每一个特征,都和样本数据集中的数据一一比对,找出那些特征最像的“邻居”。不过通常不会找遍所有样本,而是只选最像的前k个——这就是KNN里“K”的含义,k一般是不超过20的整数。最后,算法会看这k个最像的邻居里,哪个类别占比最多,就把这个类别作为新数据的分类结果。
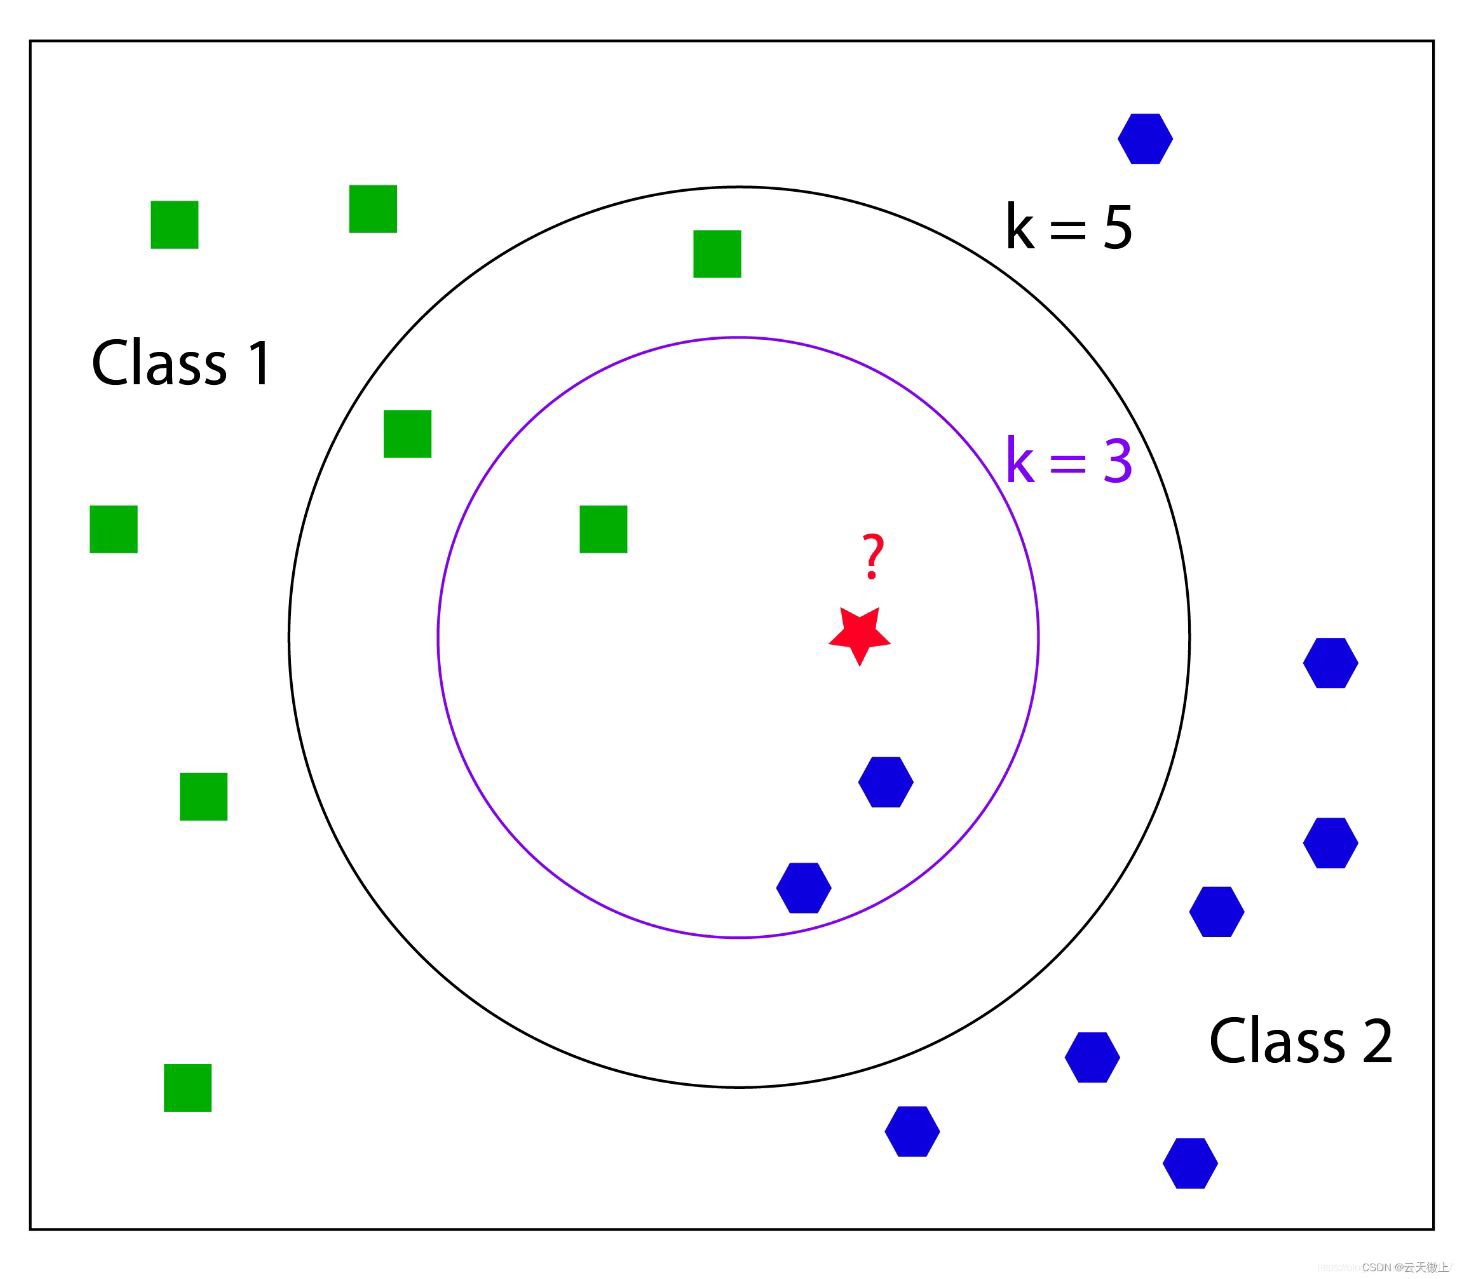
举个例子,就像图里这个红色星星的点,我们要判断它属于哪一类。如果我们把k值设定为3,就会发现离它最近的3个邻居里,有2个都是蓝色六边形。这样的话,我们就可以把这个红色星星归到蓝色六边形所在的class2类别里。
二、问题引出
海伦经常用在线约会网站找合适的约会对象。她之前接触过的人,可以分成三种类型:
1.不喜欢的人
2.比较喜欢的人
3.特别喜欢的人
这些人都有三个明显的特征:
1. 每年坐飞机旅行积累的常客里程数
2. 花在玩视频游戏上的时间占比
3. 每周吃冰淇淋的升数
现在这个约会网站想尽可能给海伦推荐她会喜欢的人,所以需要我们设计一个分类器。这个分类器要能根据用户的上面这三个特征,判断出这个人是否值得推荐给海伦。
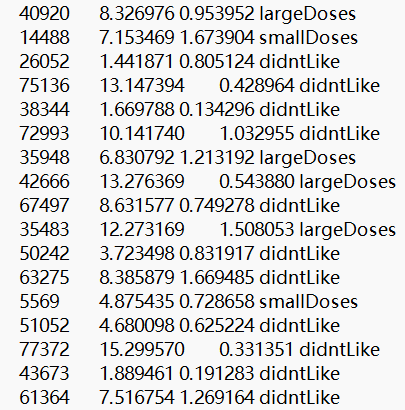
三、数据集格式
如下图
四、算法的流程实现
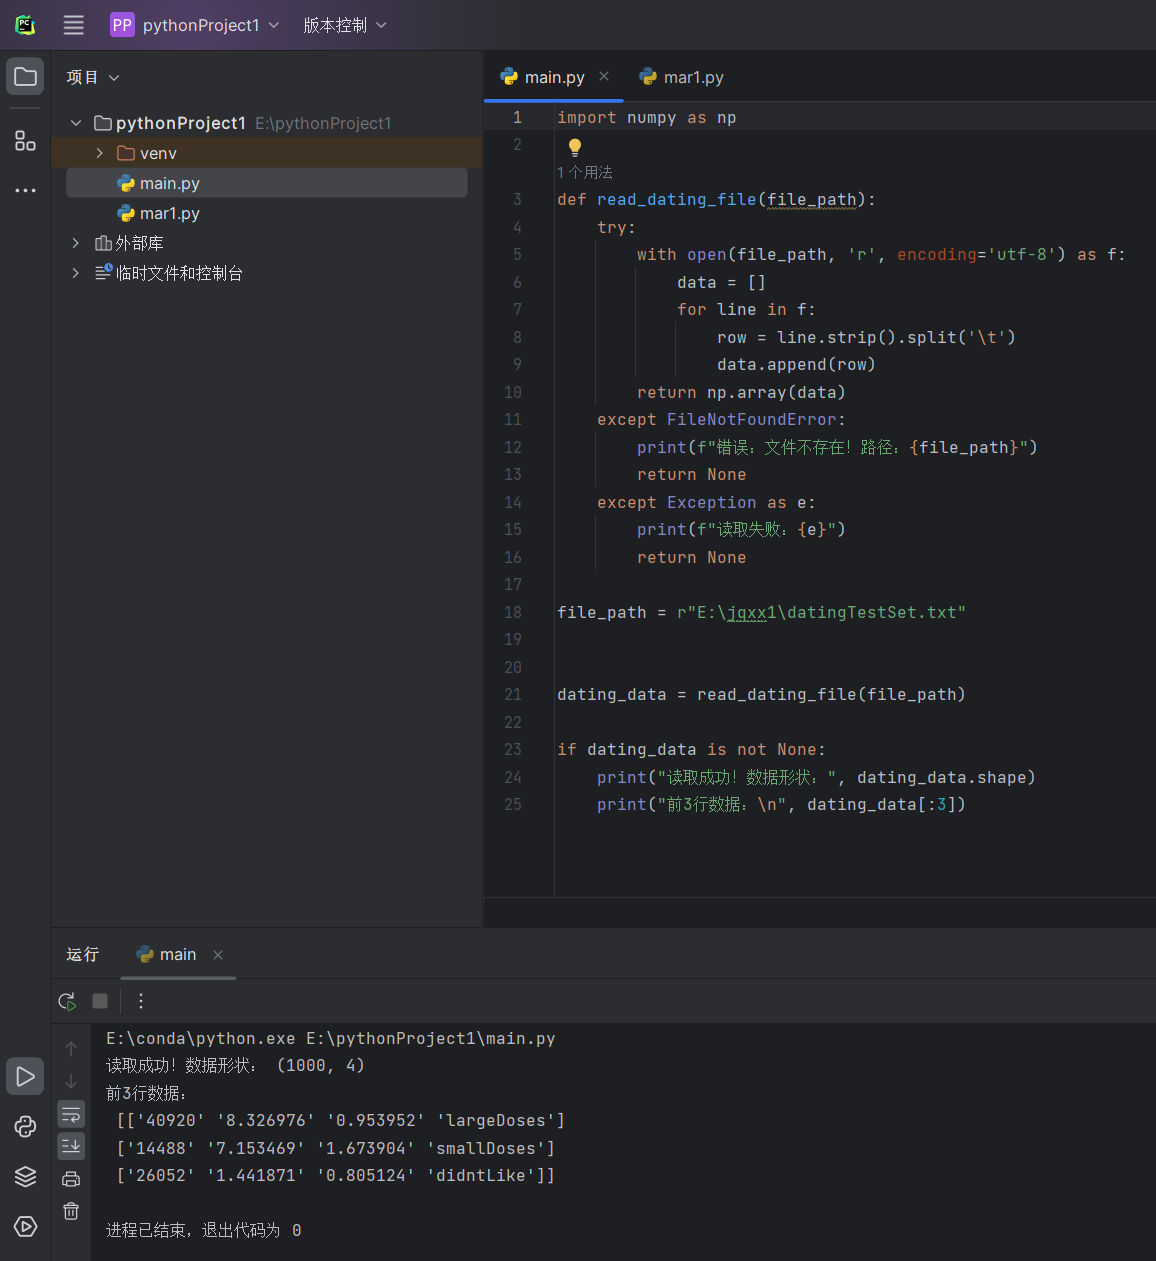
1.导入数据集,首先将文件路径记录,通过函数进行逐行读取。
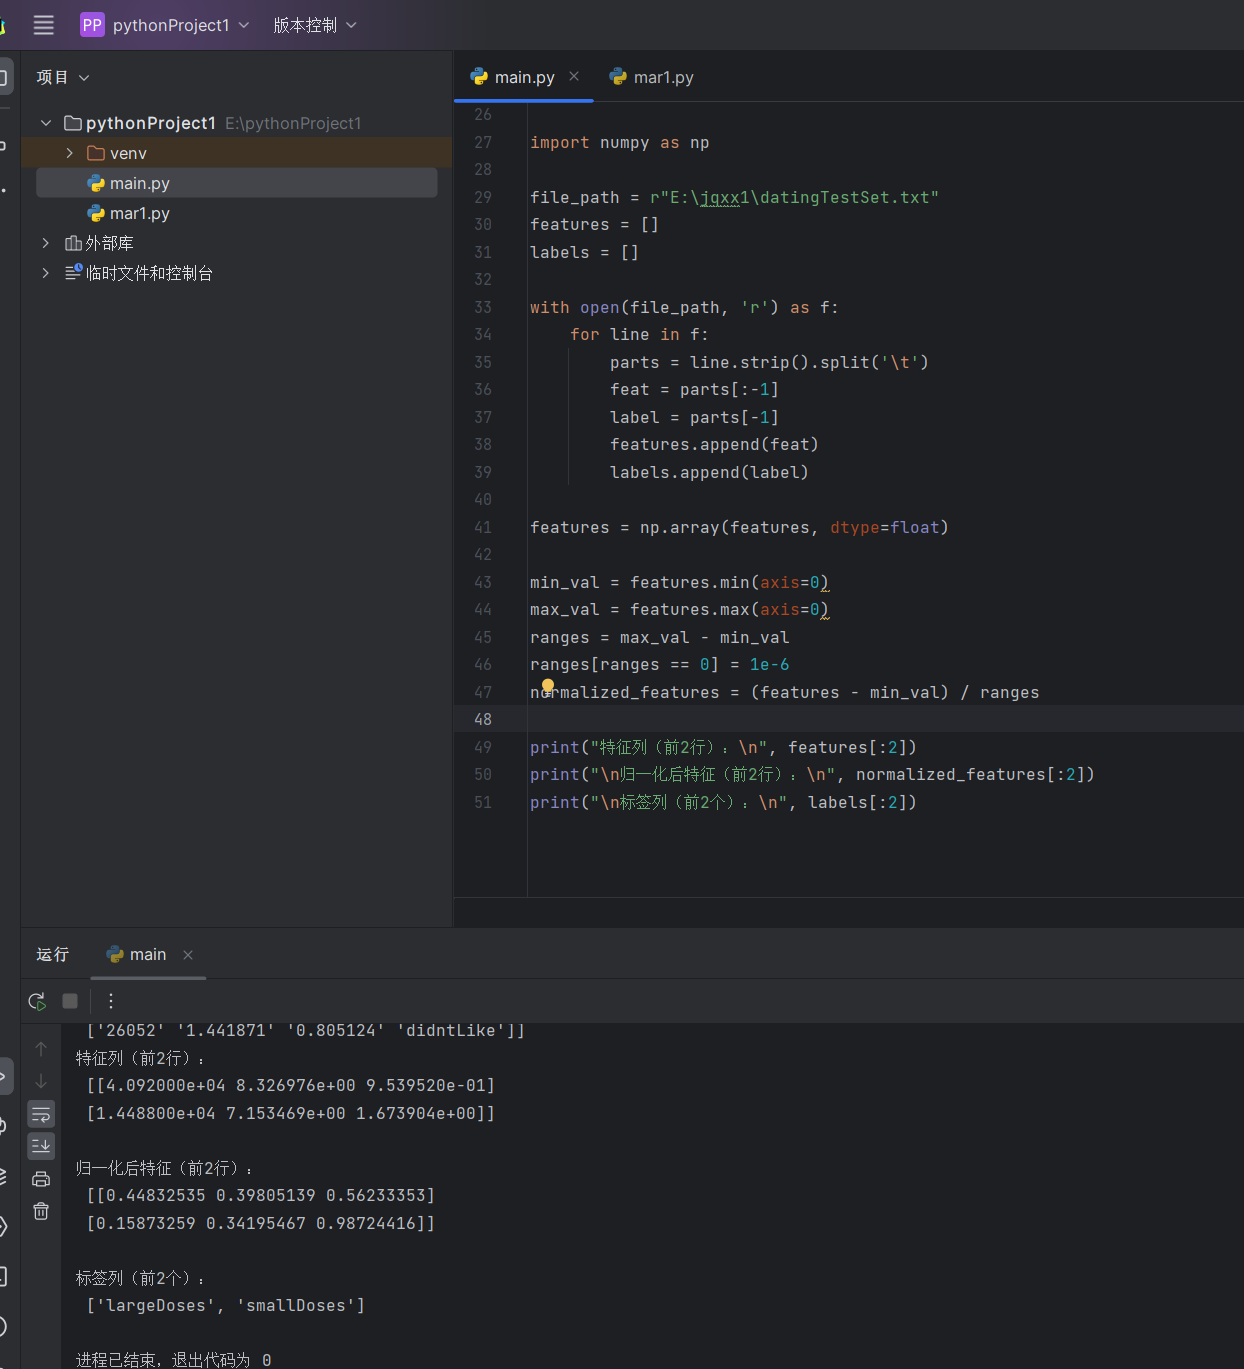
2.对前面读取的数据进行归一化处理
3.用欧式距离计算结果
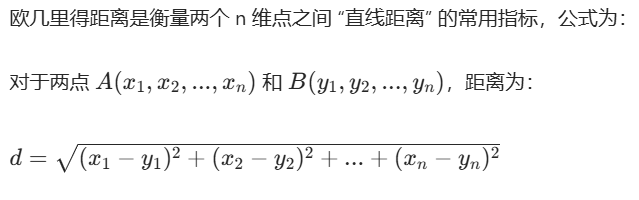
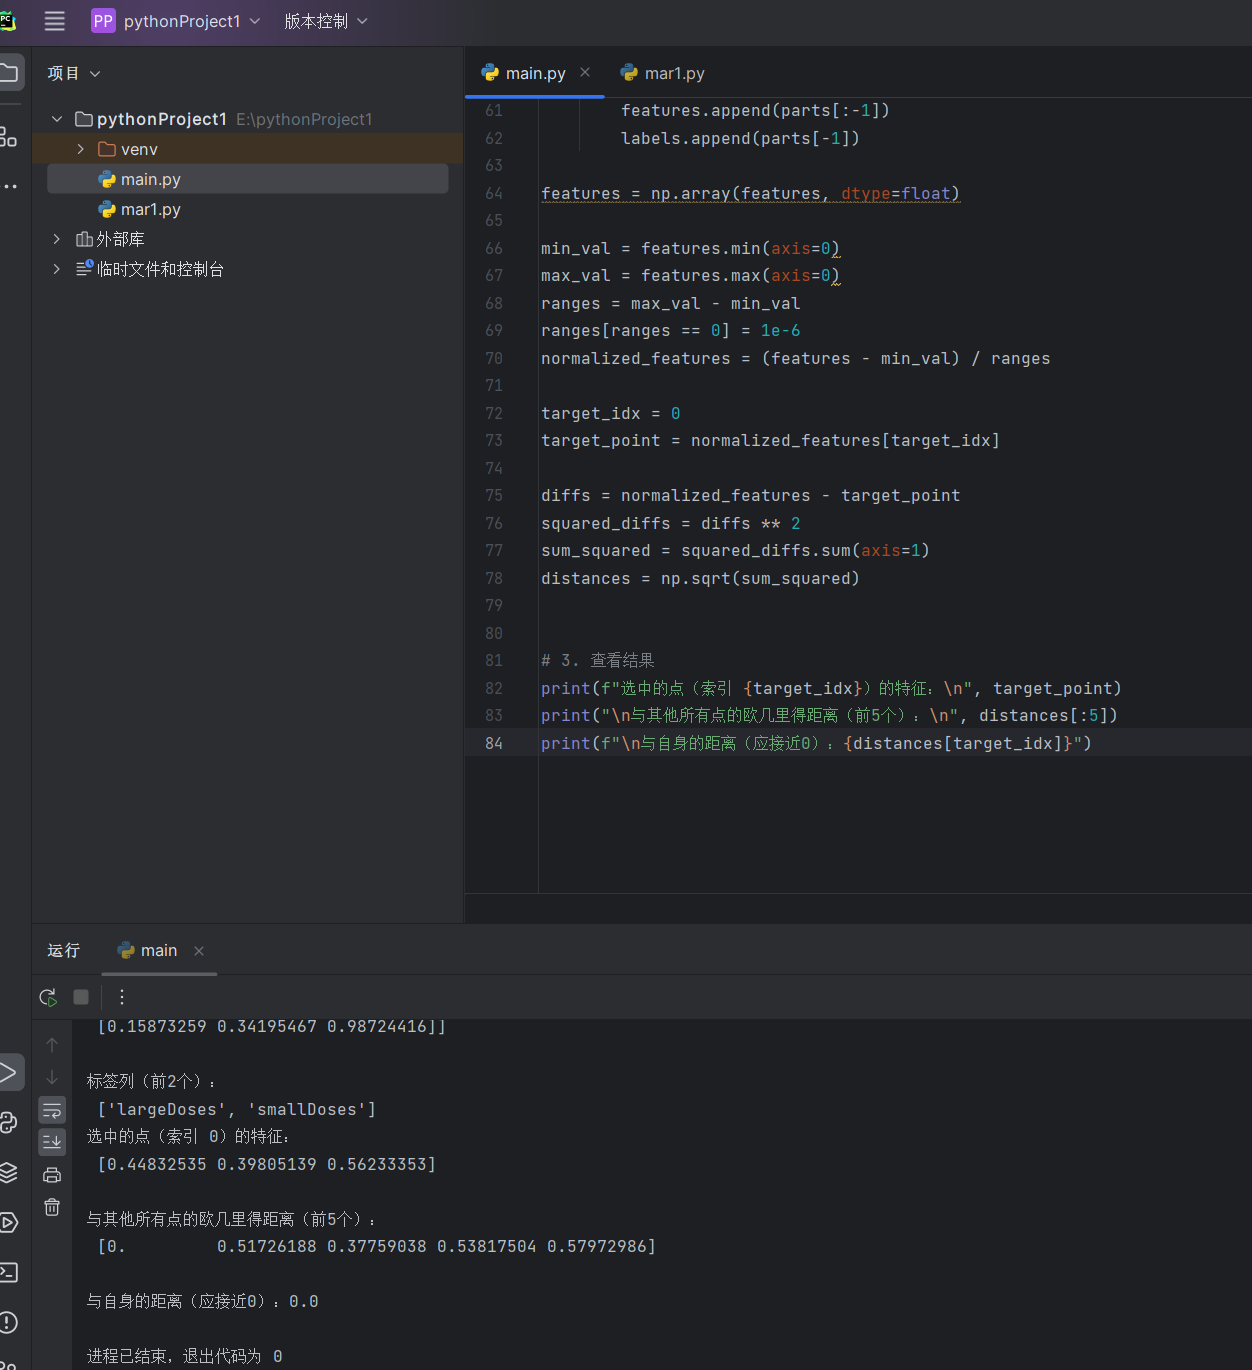
4.获取最近的k个点(以3为例)标签形成分类
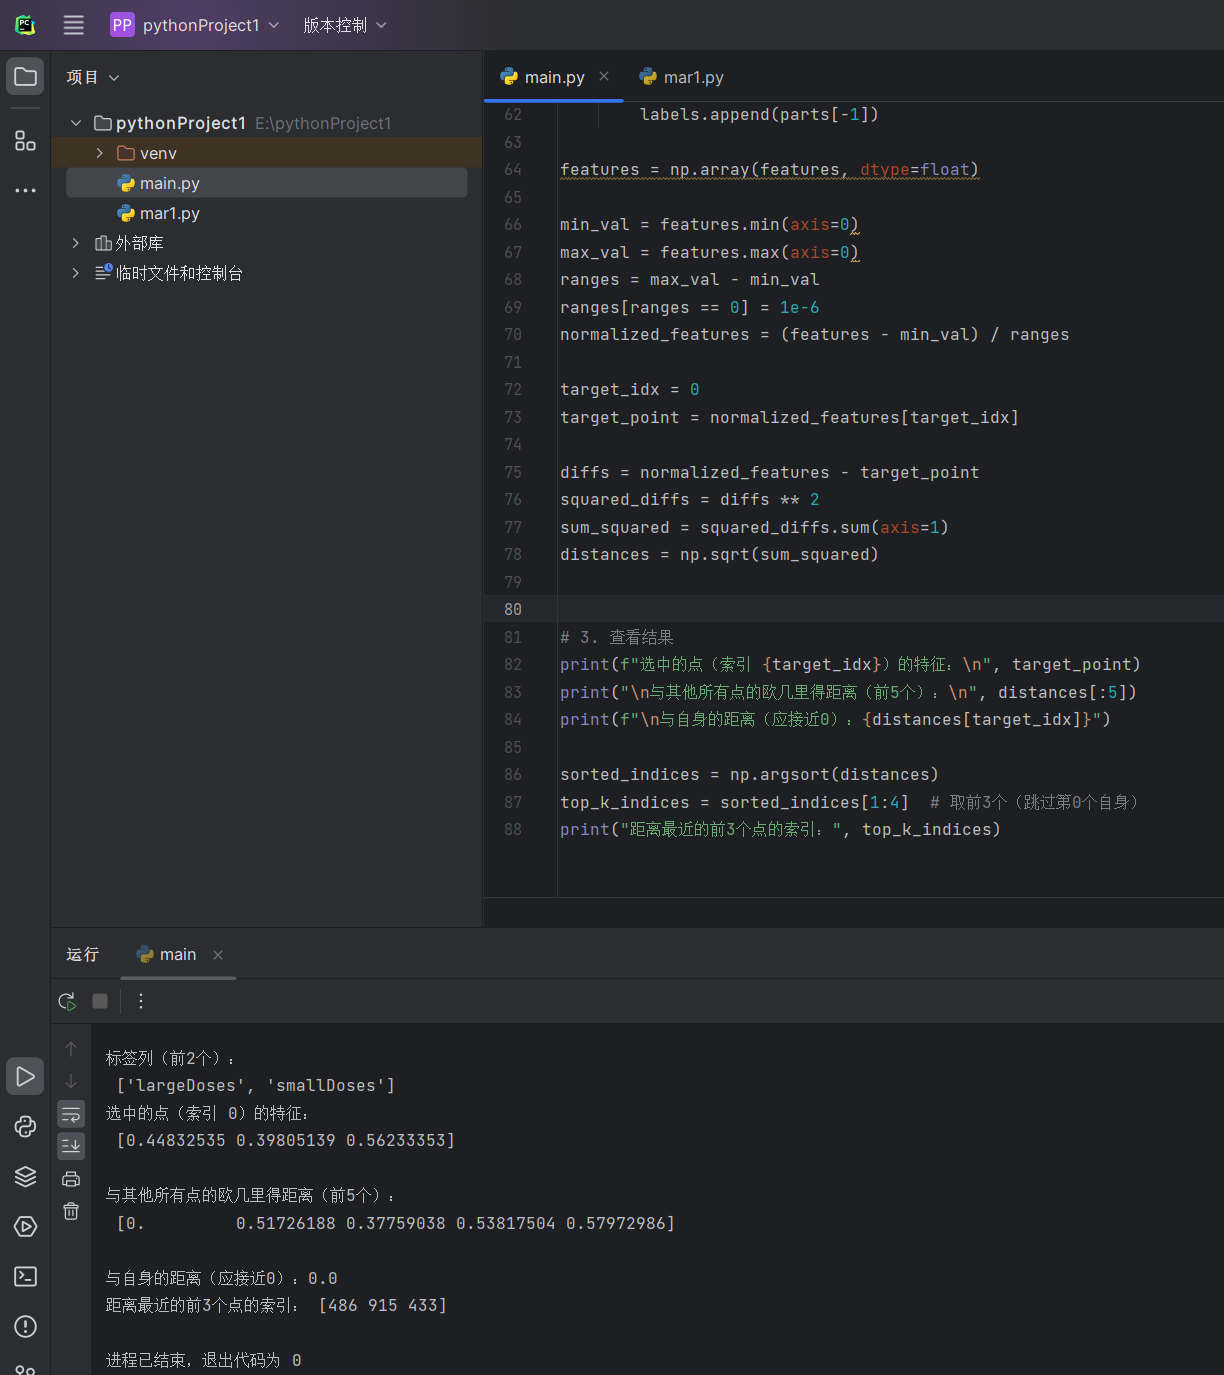
5.输出分类预测结果
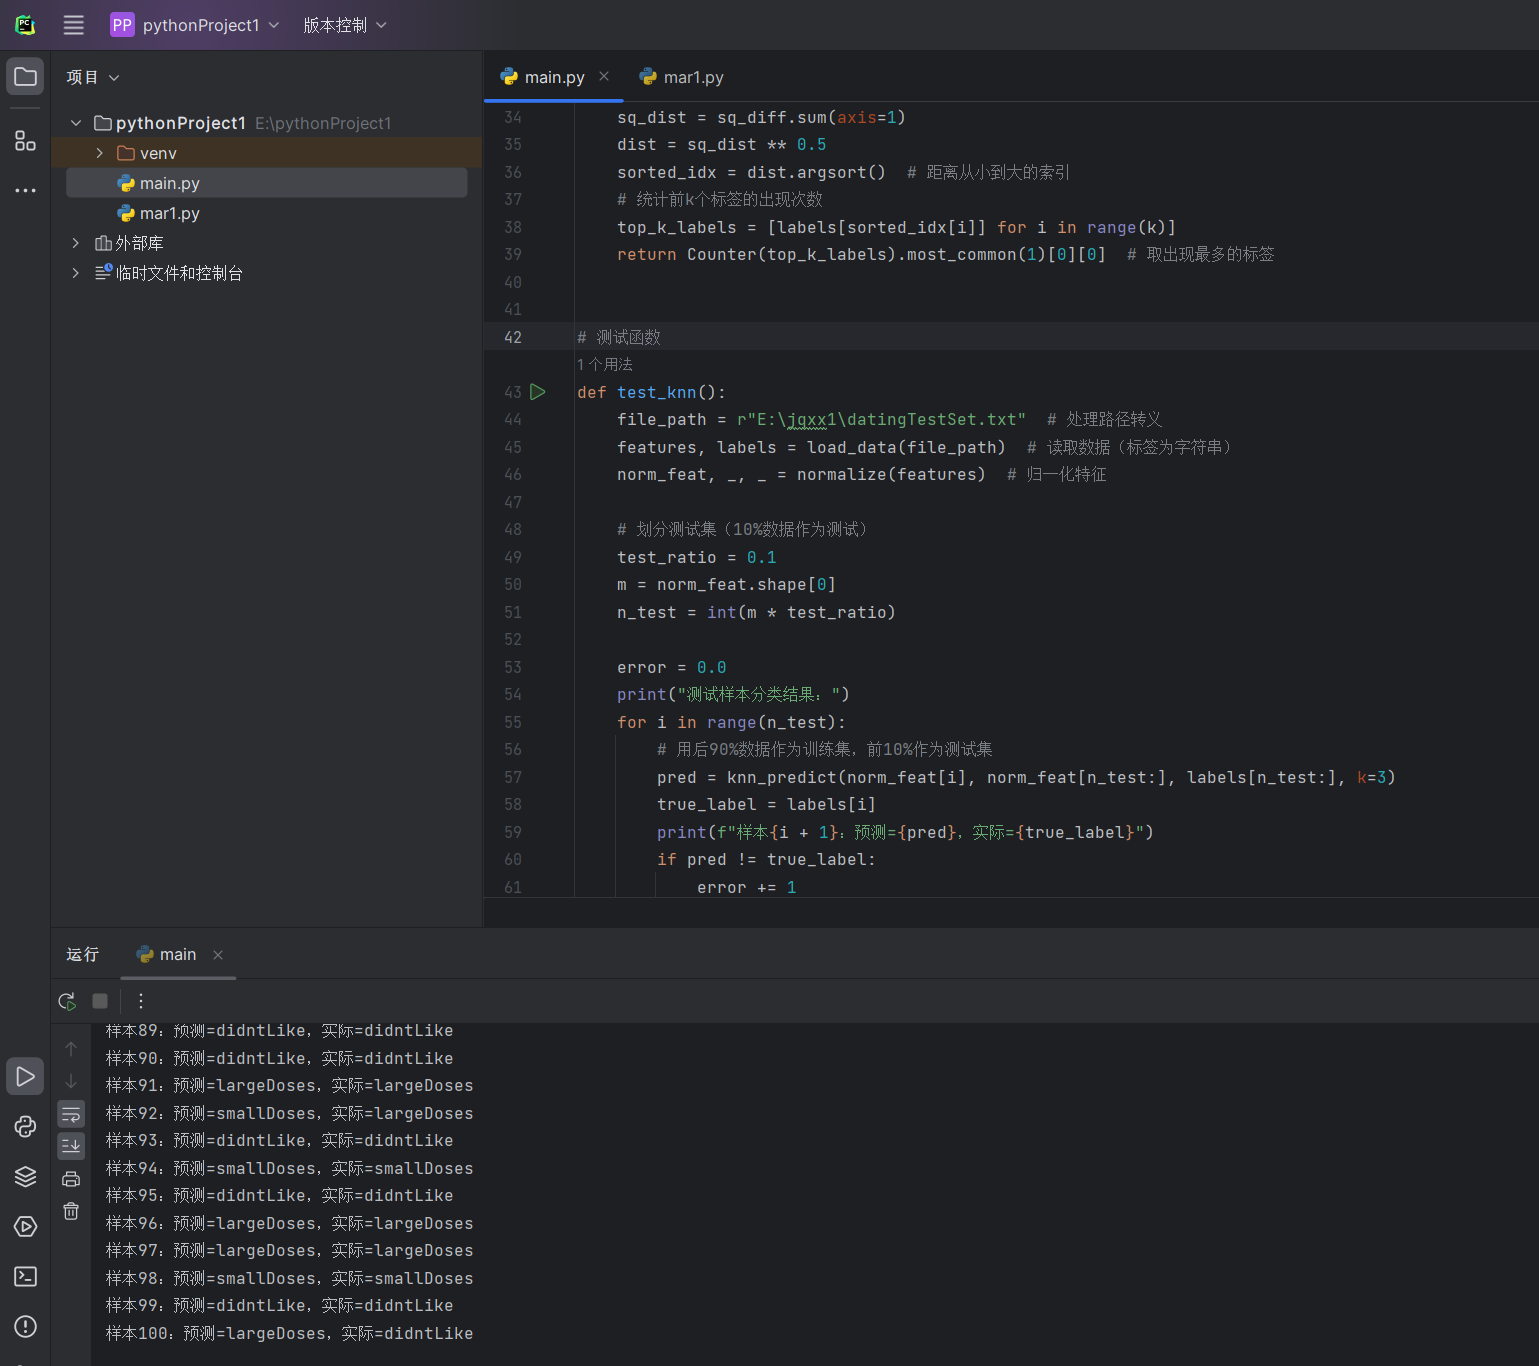
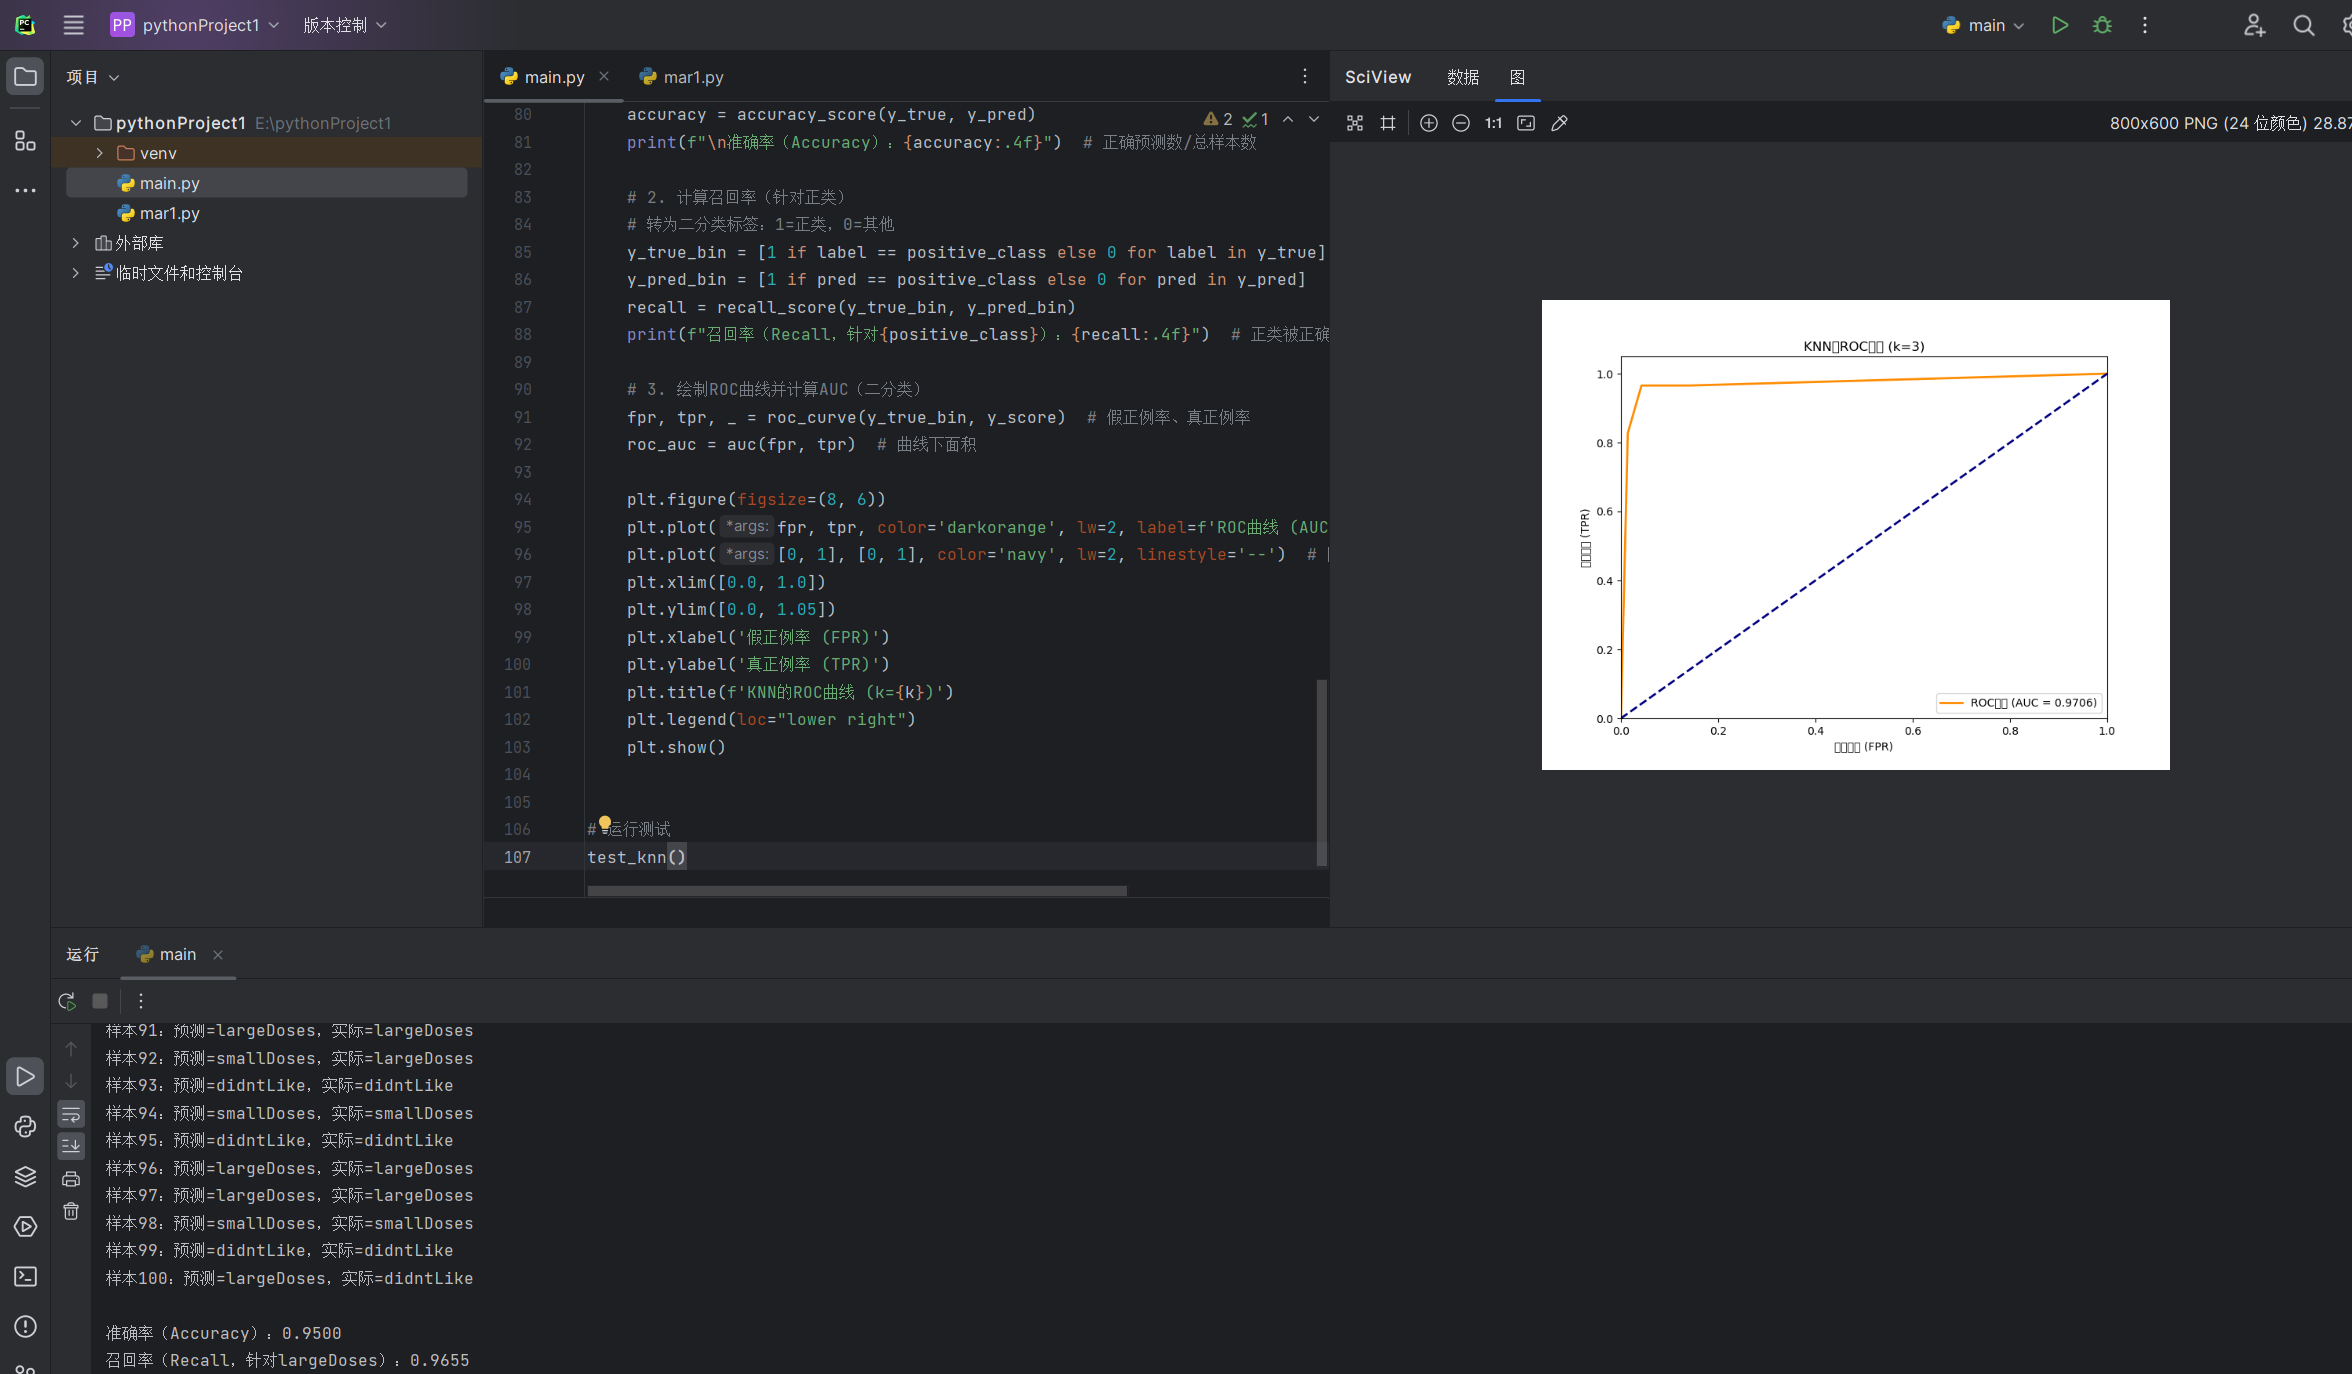
6.对逻辑进行补充,生成ROC曲线,准确率以及召回率
五、KNN算法的优缺点
KNN算法的优点很突出:它的原理和使用方式都很简单,而且训练过程的速度非常快,实际应用后得到的结果也比较理想。
不过KNN算法也有明显的缺点:一方面它对计算机的内存空间要求比较高,另一方面在对新数据进行预测的阶段,运算速度可能会比较慢。
更多推荐

 3
 0
- 0


 已为社区贡献4条内容

所有评论(0)