
计算机毕业设计之基于大数据的汽车推荐系统的设计与实现
摘要
基于大数据的汽车推荐系统通过整合海量汽车数据与用户行为数据,利用协同过滤、内容推荐等算法,为用户提供个性化的购车建议。系统采用分布式架构,结合MySQL数据库和Python开发技术,通过Flask框架实现业务逻辑。核心功能包括数据采集、清洗、推荐算法模块和用户交互界面。系统不仅显著提升了用户的购车体验,还帮助汽车企业优化库存管理和营销策略。此外,系统在实现过程中注重数据安全和隐私保护,采用加密技术和访问控制机制,确保用户数据的安全存储和传输。
系统运用随机森林回归算法对处理过的数据进行分析。模型选择、模型训练和模型部署是核心环节,通过建立预测模型,系统能够识别出影响汽车销售的的关键因素,并进行市场趋势预测和消费者行为分析。为了使分析结果易于理解和传播,数据可视化模块将复杂的数字信息转化为直观的图表和报告。首页和个人中心提供了定制化的视图,允许用户根据自己的喜好和需求浏览数据。销售统计数据、榜单统计、预测销量、品牌类型和车辆类型的可视化展示,有助于决策者快速把握市场动态。
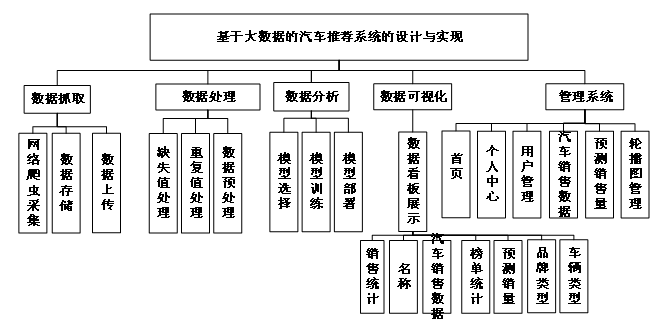
基于大数据的汽车推荐系统主要由五个功能模块构成,分别是数据抓取、数据处理、数据分析、数据可视化和管理系统。每个模块都有其独特的功能和作用,共同协作以确保系统的有效运行。
数据抓取:此模块负责从各种在线来源收集汽车相关信息,包括网络爬虫采集、数据存储和数据上传。通过自动化脚本和API接口,系统可以实时获取最新的汽车市场数据、用户评价、销售数据等,为后续的处理和分析打下基础。
数据处理:这一步涉及对原始数据进行清洗、转换和整合。缺失值处理和重复值处理是关键步骤,确保数据的质量和准确性。此外,数据预处理还包括格式标准化、异常值检测等,以便于后续的数据分析和建模。
数据分析:在这个阶段,系统运用随机森林回归算法对处理过的数据进行分析。模型选择、模型训练和模型部署是核心环节,通过建立预测模型,系统能够识别出影响汽车销售的的关键因素,并进行市场趋势预测和消费者行为分析。
数据可视化:为了使分析结果易于理解和传播,数据可视化模块将复杂的数字信息转化为直观的图表和报告。首页和个人中心提供了定制化的视图,允许用户根据自己的喜好和需求浏览数据。销售统计数据、榜单统计、预测销量、品牌类型和车辆类型的可视化展示,有助于决策者快速把握市场动态。
管理系统:这是系统的控制中心,负责日常运营和维护。用户管理模块确保只有授权人员才能访问敏感数据;汽车销售数据管理模块跟踪每辆车的销售表现;预测销售量模块基于历史数据和当前市场状况对未来销售情况进行预估;轮播图管理模块则用于网站或应用程序界面的美化与信息传达。
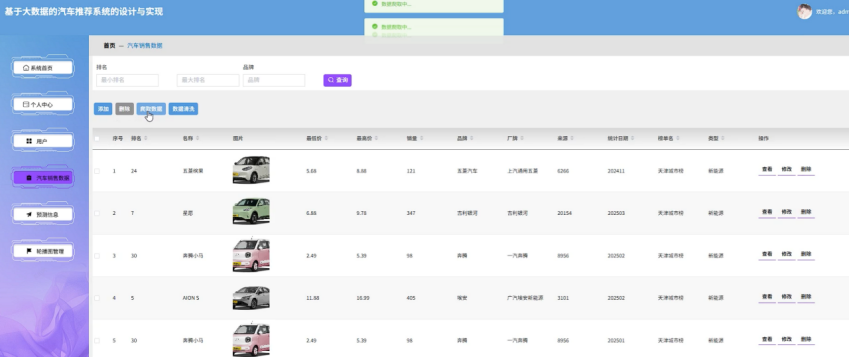
在数据爬取方面,系统利用定制化的爬虫程序,自动从抓取汽车的销量数据,采用了反爬虫策略,能够高效、稳定地获取数据,在数据清洗阶段,系统利用Spark的强大数据处理能力,对爬取到的数据进行去重、缺失值处理、异常值检测和格式统一等操作,确保数据的质量和一致性。新增销量信息时,用户通过前端界面提交数据,后台服务将数据写入数据库,同时进行数据验证和完整性检查。删除操作允许管理员移除无效或过时的销量记录。修改功能则允许用户对现有数据进行更新,以反映最新的销量情况。查询功能则通过构建索引和执行SQL查询,快速检索数据库中的销量信息,支持多种查询条件,如按排名、品牌等进行筛选。
更多推荐



 3
 0
- 0


 已为社区贡献65条内容

所有评论(0)