
【向量Milvus】---- Docker部署Milvus向量数据库 保姆级教程
·
文章目录
一、前言 📖
随着**RAG检索增强生成、大模型应用普及,传统关系型数据库无法高效处理高维向量相似度检索。Milvus** 作为开源高性能向量数据库,广泛用于存储Embedding向量。
本文采用**Docker Compose**一键部署单机版Milvus,全程命令可直接复制运行,最后附带Python向量检索实战案例,快速上手向量检索开发。
二、Milvus是什么 🧠
Milvus 是由Zilliz开源、专为向量相似度搜索设计的分布式向量数据库。
- 核心能力:存储高维向量,支持**
L2距离、余弦相似度**等度量方式 - 底层依赖:
etcd(元数据存储)、MinIO(持久化对象存储) - 部署形态:单机Standalone、集群分布式;本文使用单机模式,适合开发测试
三、应用场景 🌐
RAG知识库问答:文档向量化存储,检索相关片段送入大模型- 多模态检索:以图搜图、音频、视频相似度匹配
- 个性化推荐:用户/商品Embedding向量召回相似内容
- 风控异常检测:行为特征向量识别异常样本
- 生物信息检索:分子、基因高维特征比对
四、下载安装 🚀
环境前提
服务器已安装 Docker + Docker Compose
步骤1:下载编排文件
新建目录存放配置文件
F:\docker-service\milvus
mkdir milvus && cd milvus
# 下载官方docker-compose配置 到指定目录 F:\docker-service\milvus
 wget https://github.com/milvus-io/milvus/releases/download/v2.6.20/milvus-standalone-docker-compose.yml -O F:\docker-service\milvus\docker-compose.yml
国内下载缓慢可手动浏览器打开链接保存文件
步骤2:启动Milvus服务
# 进入目录
cd F:\docker-service\milvus

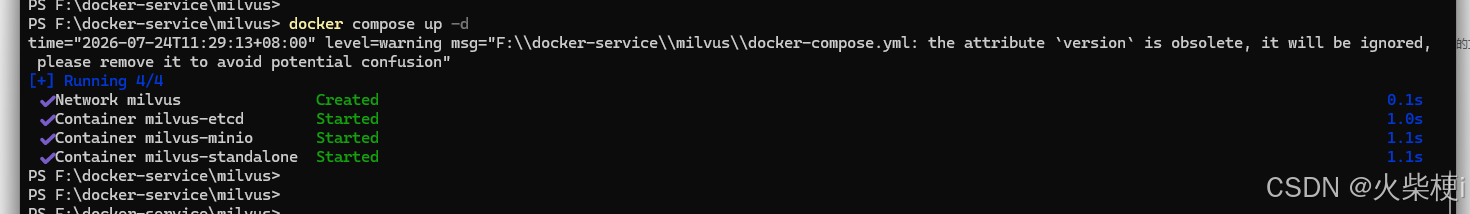
docker compose up -d
启动后自动拉起3个容器:
- milvus-standalone:主服务,默认端口
19530 - milvus-etcd:元数据服务
- milvus-minio:持久化存储
步骤3:查看运行状态
docker compose ps

步骤4:常用运维命令
# 查看实时日志
docker compose logs -f milvus-standalone

# 停止服务
docker compose down

# 停止并清理数据(谨慎!)
docker compose down -v
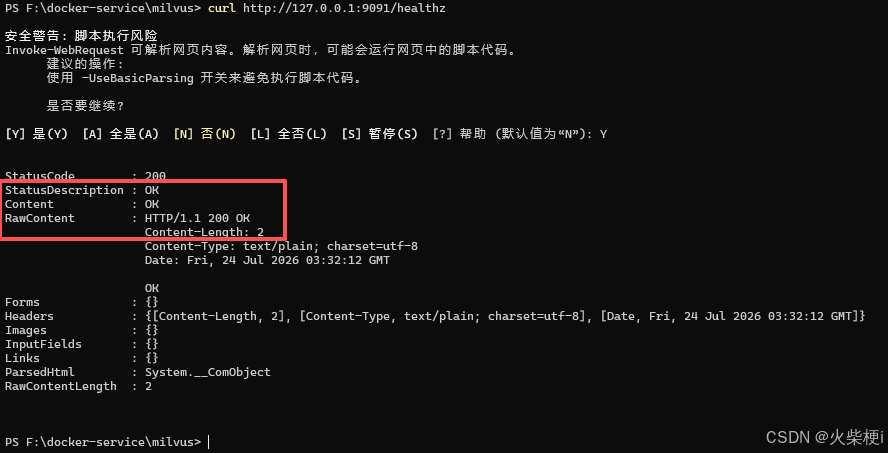
访问地址:curl http://127.0.0.1:9091/healthz ,客户端通过该地址连接Milvus
五、实战案例 💡
使用 pymilvus 实现:连接库→创建集合→插入向量→相似度检索
1. 安装依赖
#依赖1
pip install pymilvus
#依赖2
pip install sentence-transformers
2. Python完整示例代码
import os
import time
from pymilvus import MilvusClient, DataType

os.environ['HF_ENDPOINT'] = 'https://hf-mirror.com'

def print_cost(start, desc: str):
    cost = round(time.time() - start, 3)
    print(f"✅【{desc}】耗时: {cost} s")
    return time.time()

if __name__ == "__main__":
    total_start = time.time()
    step_start = time.time()

    print("=" * 50)
    print("1. 开始连接Milvus服务")
    client = MilvusClient(uri="http://127.0.0.1:19530")
    step_start = print_cost(step_start, "连接Milvus")

    coll_name = "leave_application"
    vec_dim = 384

    print("\n2. 清理旧集合")
    if client.has_collection(coll_name):
        client.drop_collection(coll_name)
        print("等待集合彻底销毁...")
        wait_times = 0
        while client.has_collection(coll_name) and wait_times < 10:
            time.sleep(0.5)
            wait_times += 1
        print("旧集合删除完毕")
    step_start = print_cost(step_start, "删除旧集合")

    print("\n3. 使用自定义Schema创建集合 + IP索引(重点!不再用dimension简易模式)")
    # 手动定义结构
    schema = MilvusClient.create_schema(auto_id=False, enable_dynamic_field=True)
    schema.add_field(field_name="id", datatype=DataType.INT64, is_primary=True)
    schema.add_field(field_name="vector", datatype=DataType.FLOAT_VECTOR, dim=vec_dim)
    schema.add_field(field_name="content", datatype=DataType.VARCHAR, max_length=1000)

    # 索引参数:IP
    index_params = MilvusClient.prepare_index_params()
    index_params.add_index(
        field_name="vector",
        index_type="FLAT",
        metric_type="IP"
    )

    client.create_collection(
        collection_name=coll_name,
        schema=schema,
        index_params=index_params
    )
    step_start = print_cost(step_start, "创建集合与索引")

    # 加载模型
    from sentence_transformers import SentenceTransformer
    print("\n4. 加载中文Embedding模型")
    model = SentenceTransformer('all-MiniLM-L6-v2')
    step_start = print_cost(step_start, "加载SentenceTransformer模型")

    # 请假数据
    leave_data_text = [
        {"id": 1, "content": "张三,申请6月10日请事假1天,家中需要处理房屋装修事宜"},
        {"id": 2, "content": "李四,6月12日申请病假2天,感冒发烧需要居家休养,附有医院诊断单"},
        {"id": 3, "content": "王五,申请6月10日休事假,回老家办理证件,请假时长一天"},
        {"id": 4, "content": "赵六,6月15日申请年假3天,计划外出旅游散心"},
        {"id": 5, "content": "孙七,6月12日身体不适,申请病假一天,去医院就诊"}
    ]

    print("\n5. 文本向量化")
    insert_list = []
    for item in leave_data_text:
        vec = model.encode(item["content"], normalize_embeddings=True)
        insert_list.append({
            "id": item["id"],
            "vector": vec,
            "content": item["content"]
        })
    step_start = print_cost(step_start, "全部文本向量化")

    print("\n6. 插入数据")
    res = client.insert(collection_name=coll_name, data=insert_list)
    print("插入结果:", res)
    # 强制落盘,保证数据立即可检索(Windows Docker必加!)
    client.flush(collection_name=coll_name)
    step_start = print_cost(step_start, "插入向量数据+flush")

    def search_leave(query_text, top_k=3):
        t0 = time.time()
        query_vec = model.encode(query_text, normalize_embeddings=True)
        result = client.search(
            collection_name=coll_name,
            data=[query_vec],
            limit=top_k,
            metric_type="IP",   # 和建索引完全一致
            output_fields=["content"]
        )
        cost = round(time.time() - t0, 3)
        print(f"\n【查询】{query_text} | 查询耗时:{cost}s")
        print("匹配结果:")
        hits = result[0]
        if not hits:
            print("无匹配记录!")
            return
        for hit in hits:
            print(f"相似度:{round(hit['distance'],4)} | {hit['entity']['content']}")

    # 查询测试
    search_leave("6月10日谁请了事假")
    search_leave("哪些员工申请病假")
    search_leave("谁请假出去旅游")

    print("\n" + "="*50)
    print(f"程序全部执行完毕,总耗时 {round(time.time() - total_start,3)} s")
测试结果:
F:\docker-service\milvus>py 2.py
==================================================
1. 开始连接Milvus服务
✅【连接Milvus】耗时: 0.02 s

2. 清理旧集合
等待集合彻底销毁...
旧集合删除完毕
✅【删除旧集合】耗时: 1.178 s

3. 使用自定义Schema创建集合 + IP索引(重点!不再用dimension简易模式)
✅【创建集合与索引】耗时: 2.583 s

4. 加载中文Embedding模型
Loading weights: 100%|█████████████████████████████████████████████████████████████████████████████████████████████████████████| 103/103 [00:00<00:00, 5866.72it/s]
✅【加载SentenceTransformer模型】耗时: 12.811 s

5. 文本向量化
✅【全部文本向量化】耗时: 0.064 s

6. 插入数据
插入结果: {'insert_count': 5, 'ids': [1, 2, 3, 4, 5]}
✅【插入向量数据+flush】耗时: 2.074 s

【查询】6月10日谁请了事假 | 查询耗时:0.022s
匹配结果:
相似度:0.773 | 张三,申请6月10日请事假1天,家中需要处理房屋装修事宜
相似度:0.7177 | 孙七,6月12日身体不适,申请病假一天,去医院就诊
相似度:0.6625 | 王五,申请6月10日休事假,回老家办理证件,请假时长一天

【查询】哪些员工申请病假 | 查询耗时:0.014s
匹配结果:
相似度:0.4099 | 孙七,6月12日身体不适,申请病假一天,去医院就诊
相似度:0.4032 | 张三,申请6月10日请事假1天,家中需要处理房屋装修事宜
相似度:0.3717 | 赵六,6月15日申请年假3天,计划外出旅游散心

【查询】谁请假出去旅游 | 查询耗时:0.015s
匹配结果:
相似度:0.6229 | 赵六,6月15日申请年假3天,计划外出旅游散心
相似度:0.4957 | 张三,申请6月10日请事假1天,家中需要处理房屋装修事宜
相似度:0.4798 | 孙七,6月12日身体不适,申请病假一天,去医院就诊

==================================================
程序全部执行完毕,总耗时 18.782 s

F:\docker-service\milvus>
小结 ✅
本文完成**Docker Compose**部署Milvus单机版,理清基础架构,并提供可直接运行的向量检索Demo。开发环境推荐使用本方案;生产环境建议采用Milvus集群模式,增加资源限制、数据备份与账号鉴权。
六、可视化平台 Attu
docker-compose.yml 加服务
  attu:
    container_name: milvus-attu
    image: zilliz/attu:v2.6
    ports:
      - "8000:3000"
    environment:
      MILVUS_URL: standalone:19530
    depends_on:
      - standalone
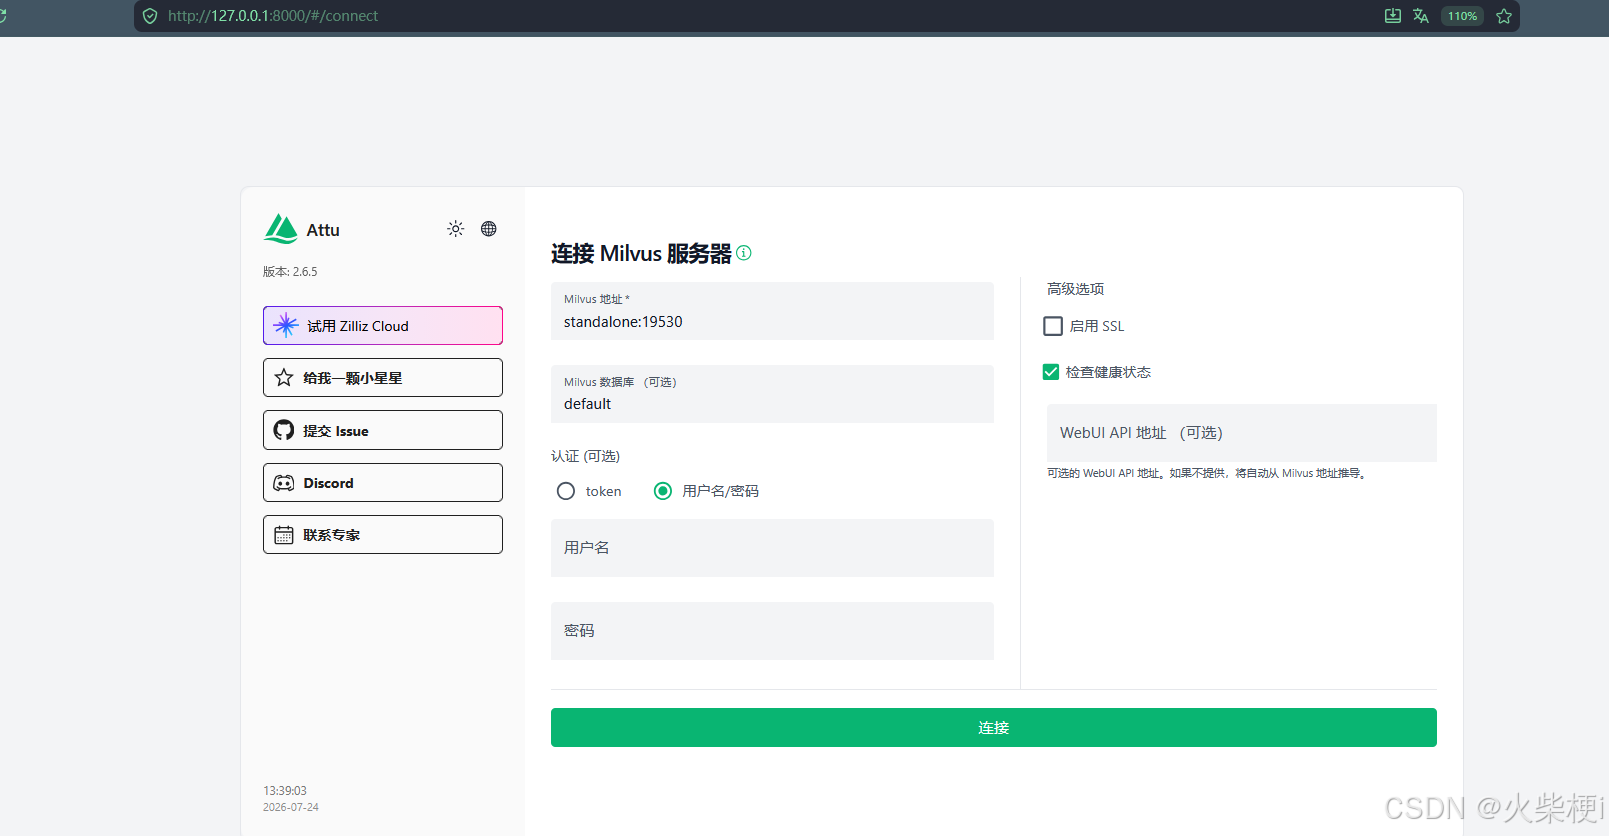
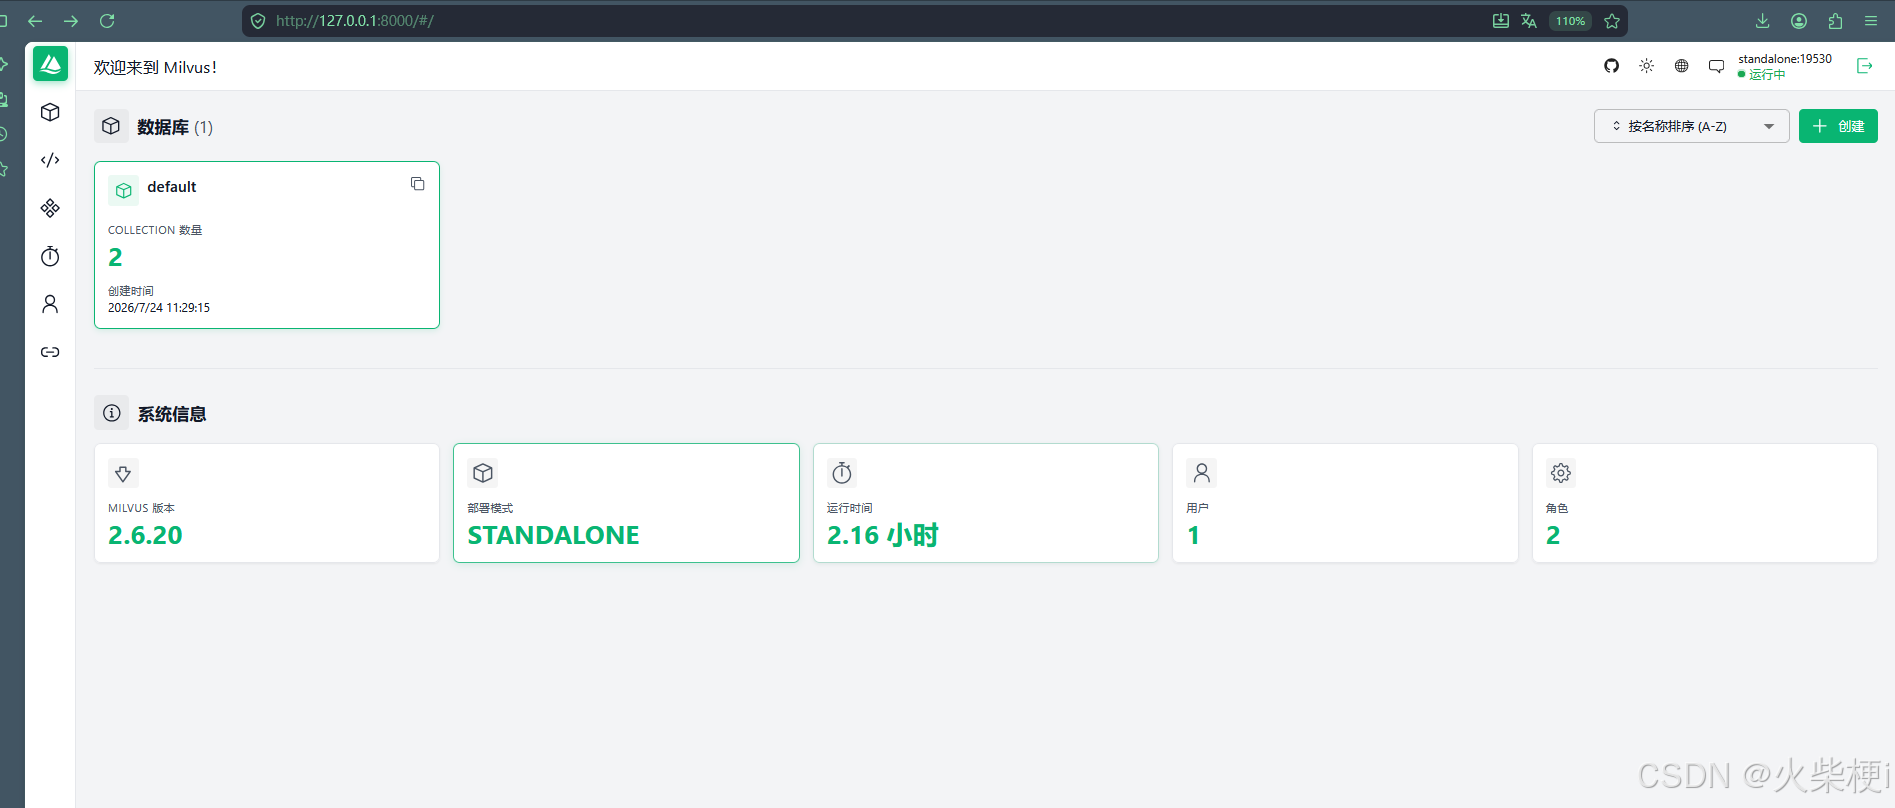
milvus-attu:可视化管理平台,端口 8000
Attu 可视化后台:http://服务器IP:8000
更多推荐


 2
 0
- 0


 已为社区贡献74条内容

所有评论(0)