
计算机毕业设计Hadoop+Spark+Hive招聘可视化 招聘数据分析数据仓库 招聘推荐系统 职位推荐系统 就业推荐系统 招聘爬虫 招聘大数据 大数据毕业设计✅
·
博主介绍:✌全网粉丝10W+,前互联网大厂软件研发、集结硕博英豪成立工作室。专注于计算机相关专业项目实战6年之久,选择我们就是选择放心、选择安心毕业✌
> 🍅想要获取完整文章或者源码,或者代做,拉到文章底部即可与我联系了。🍅🍅感兴趣的可以先收藏起来,点赞、关注不迷路,大家在毕设选题,项目以及论文编写等相关问题都可以给我留言咨询,希望帮助同学们顺利毕业 。🍅
1、毕业设计:2026年计算机专业毕业设计选题汇总(建议收藏)✅
2、大数据毕业设计:2026年选题大全 深度学习 python语言 JAVA语言 hadoop和spark(建议收藏)✅
1、项目介绍
技术栈:Python3.9、Django框架、Sqlite数据库、Scrapy爬虫框架、Echarts可视化、协同过滤推荐算法、Layui前端
研究背景:
拉勾网每日新增数万技术岗位,信息过载使求职者难以快速定位匹配职位;传统搜索缺乏个性化,亟需基于用户行为的智能推荐与可视化分析提升择业效率。
研究意义:
本系统通过Scrapy自动爬取并清洗拉勾网职位数据,结合协同过滤算法为用户定向推荐岗位,同时提供多维度可视化分析,可为毕业设计展示“爬虫-算法-可视化”完整闭环,预计节省30%职位筛选时间,显著提升求职匹配度。
2、项目界面
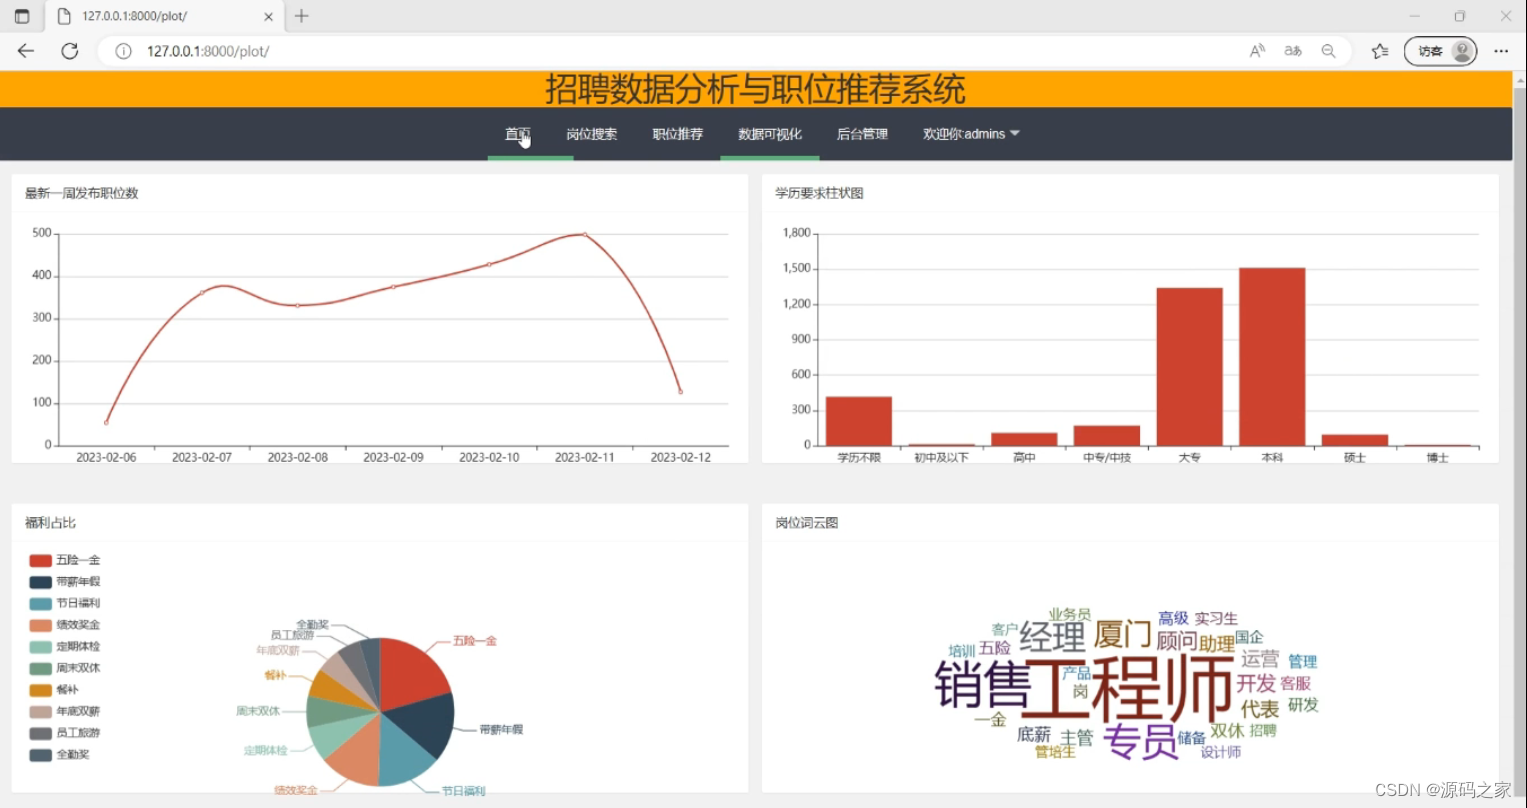
(1)数据分析可视化界面
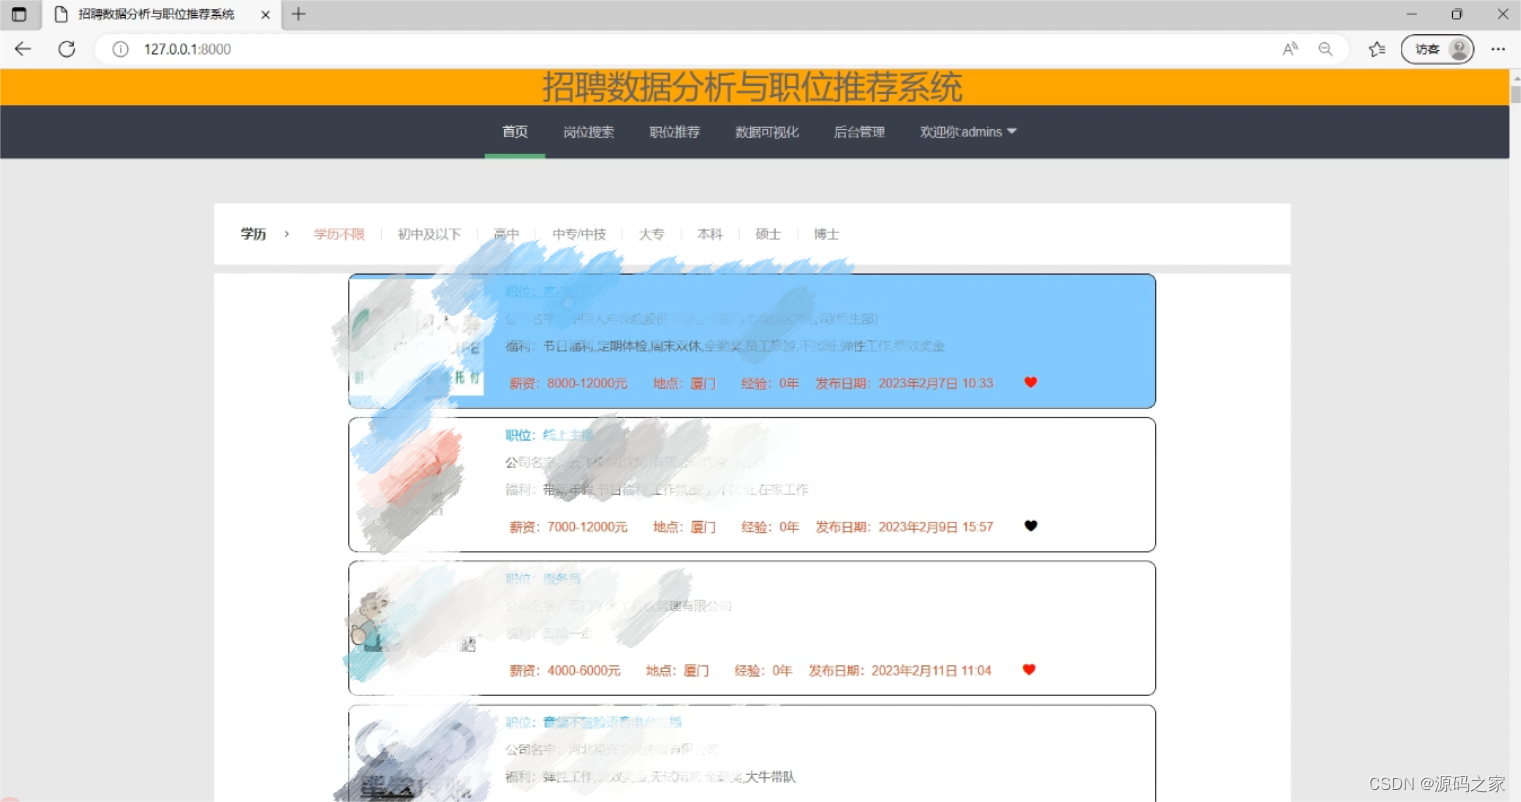
(2)首页------数据筛选界面
(3)招聘数据详情页

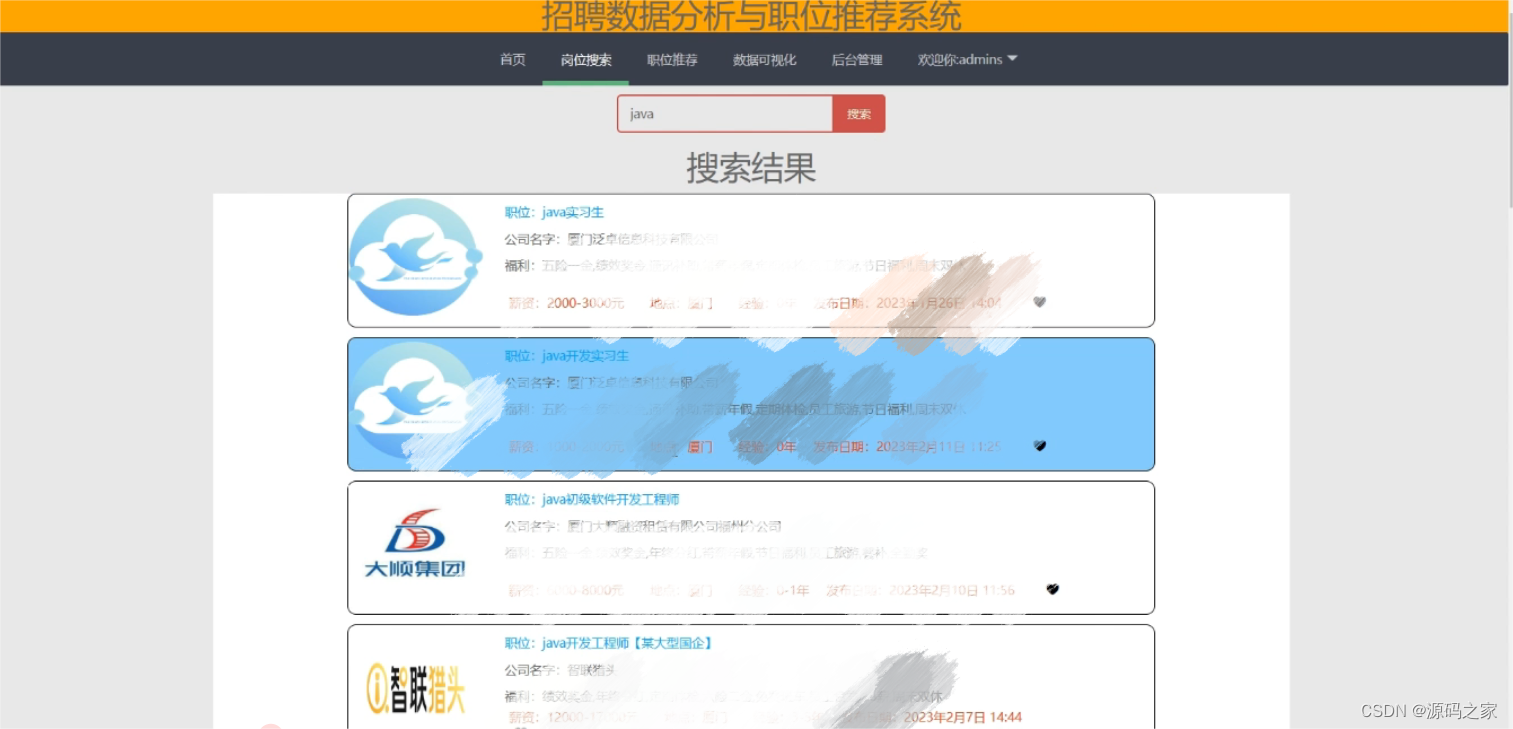
(4)推荐模块
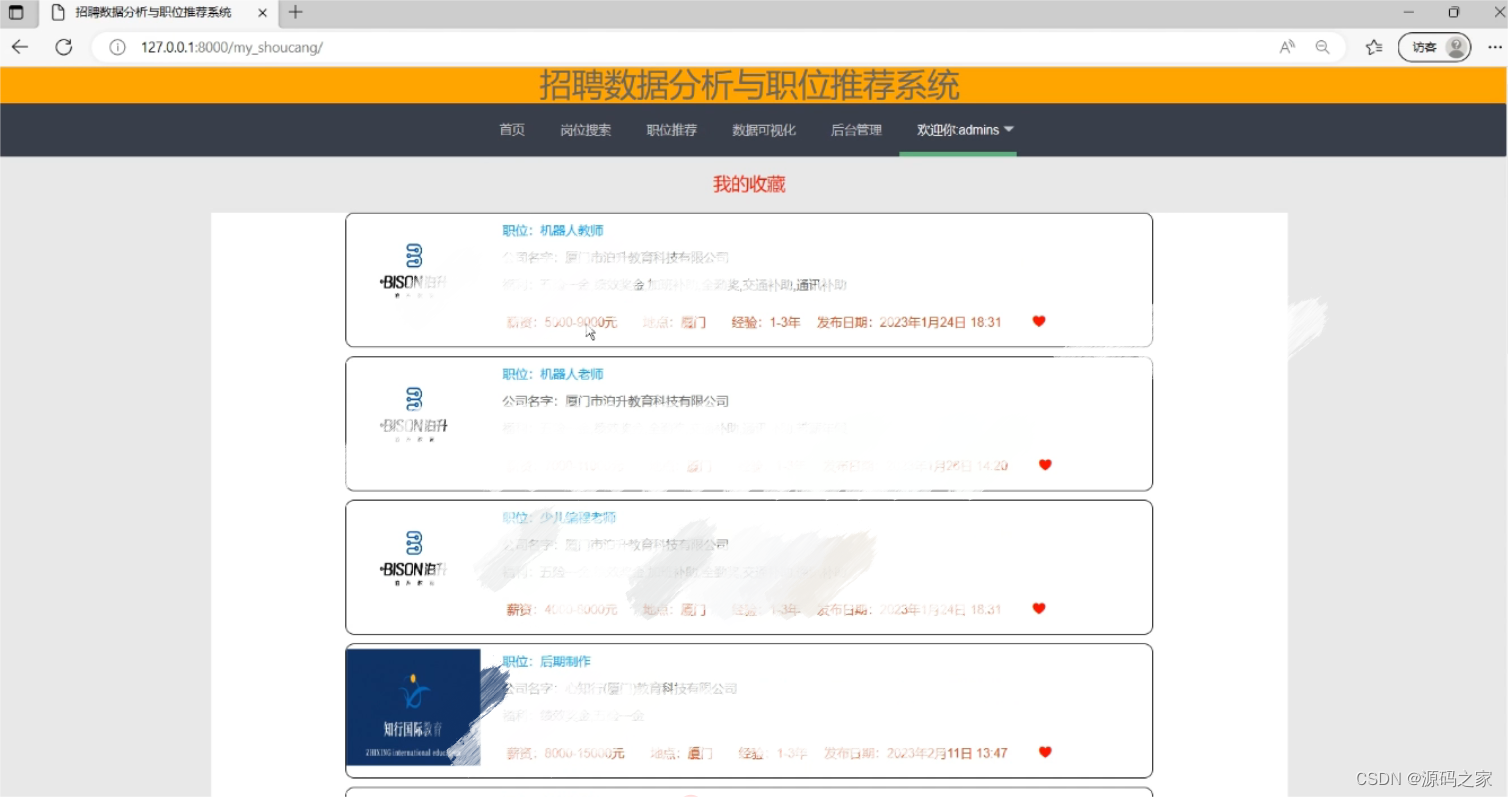
(5)我的收藏
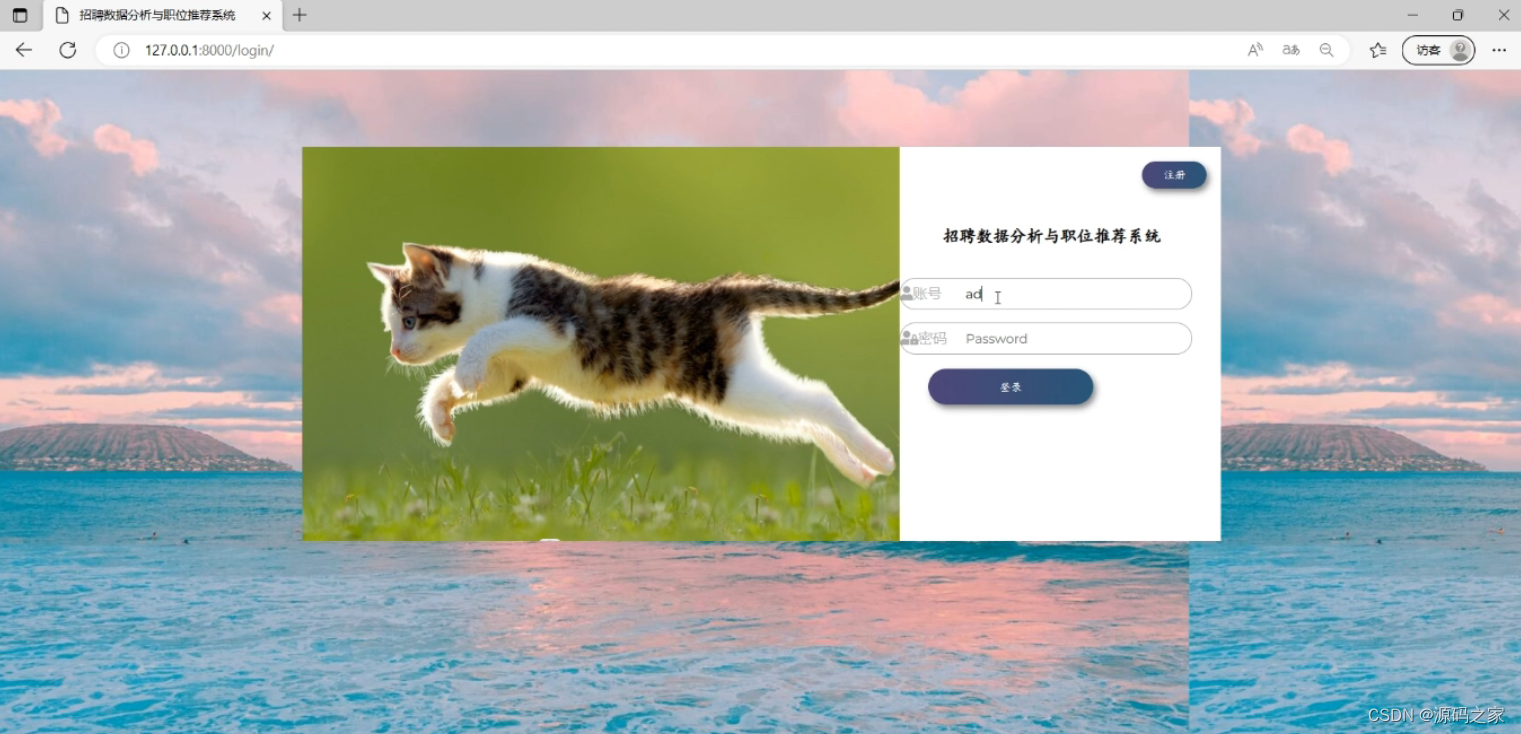
(6)注册登录模块
3、项目说明
系统功能设计如下:
- 数据爬取:使用Scrapy爬虫框架实现对拉勾网招聘信息的爬取,并对职位数据进行统一清洗(薪资单位、经验格式等)。
- 职位信息展示:通过Django框架将清洗后的数据展示在系统首页,支持按学历筛选,详情页记录用户浏览行为。
- 职位收藏:用户点击心形图标收藏职位,系统记录用户ID与职位ID。
- 职位搜索:支持关键词搜索职位名称与公司名称。
- 可视化分析:使用ECharts展示最新职位折线图、学历要求柱状图、福利饼图及岗位词云。
- 用户注册登录:支持手机号注册,同一手机号不可重复注册。
- 用户信息修改:可重置密码与手机号。
- 职位推荐:根据用户浏览与收藏记录,使用协同过滤算法计算兴趣相似度,定向推荐职位。
系统以Python3.9为基础,Django承载Web服务,Sqlite存储用户行为与职位数据,Layui提供响应式界面,ECharts完成多维图表渲染。通过数据可视化与协同过滤推荐,有效提升求职者岗位匹配效率,为个人与企业提供有益参考。
4、核心代码
(1)推荐模块Python代码:
```python
class KNN:
    def __init__(self, train):
        self.train = train

int(float(score))

    def ItemSimilarity(self):
        cooccur = dict()  # 物品-物品的共现矩阵
        buy = dict()  # 物品被多少个不同用户购买N
        for user, items in self.train.items():
            for i in items.keys():
                buy.setdefault(i, 0)
                buy[i] += 1
                cooccur.setdefault(i, {})
                for j in items.keys():
                    if i == j: continue
                    cooccur[i].setdefault(j, 0)
                    cooccur[i][j] += 1 / math.log(1 + len(items) * 1.0)
        # 计算职位相似度矩阵
        self.similar = dict()
        for i, related_items in cooccur.items():
            self.similar.setdefault(i, {})
            for j, cij in related_items.items():
                self.similar[i][j] = cij / (math.sqrt(buy[i] * buy[j]))
        # print(self.similar)
        return self.similar

    # 给用户user推荐,前K个相关用户,前N个物品
    def Recommend(self, user, K=10, N=10):
        rank = dict()
        action_item = self.train[user]
        # print(action_item)
        # 用户user产生过行为的item和评分
        for item, score in action_item.items():
            sortedItems = sorted(self.similar[item].items(), key=lambda x: x[1], reverse=True)[0:K]
            for j, wj in sortedItems:
                if j in action_item.keys():
                    continue
                rank.setdefault(j, 0)
                rank[j] += score * wj
        return dict(sorted(rank.items(), key=lambda x: x[1], reverse=True)[0:N])
5、源码获取方式
🍅由于篇幅限制,获取完整文章或源码、代做项目的,查看我的【用户名】、【专栏名称】、【顶部选题链接】就可以找到我啦🍅
感兴趣的可以先收藏起来,点赞、关注不迷路,下方查看👇🏻获取联系方式👇🏻
更多推荐


 30
 0
- 0


 已为社区贡献336条内容

所有评论(0)