
JavaSE---Arrays工具类、Lambda表达式、集合进阶、数据结构、泛型、Set系列集合
本篇博客继上一篇内容继续记录听黑马课的时候的笔记以及课堂上练习的代码,文章图源于我在听课的时候所截的屏,所以有些不清晰,请见谅。下面是课程链接,可点击自行跳转。
 http:// https://www.bilibili.com/video/BV17F411T7Ao/?share_source=copy_web&vd_source=d521b664e1113402904fa9336bd1d0ac
目录
Arrays
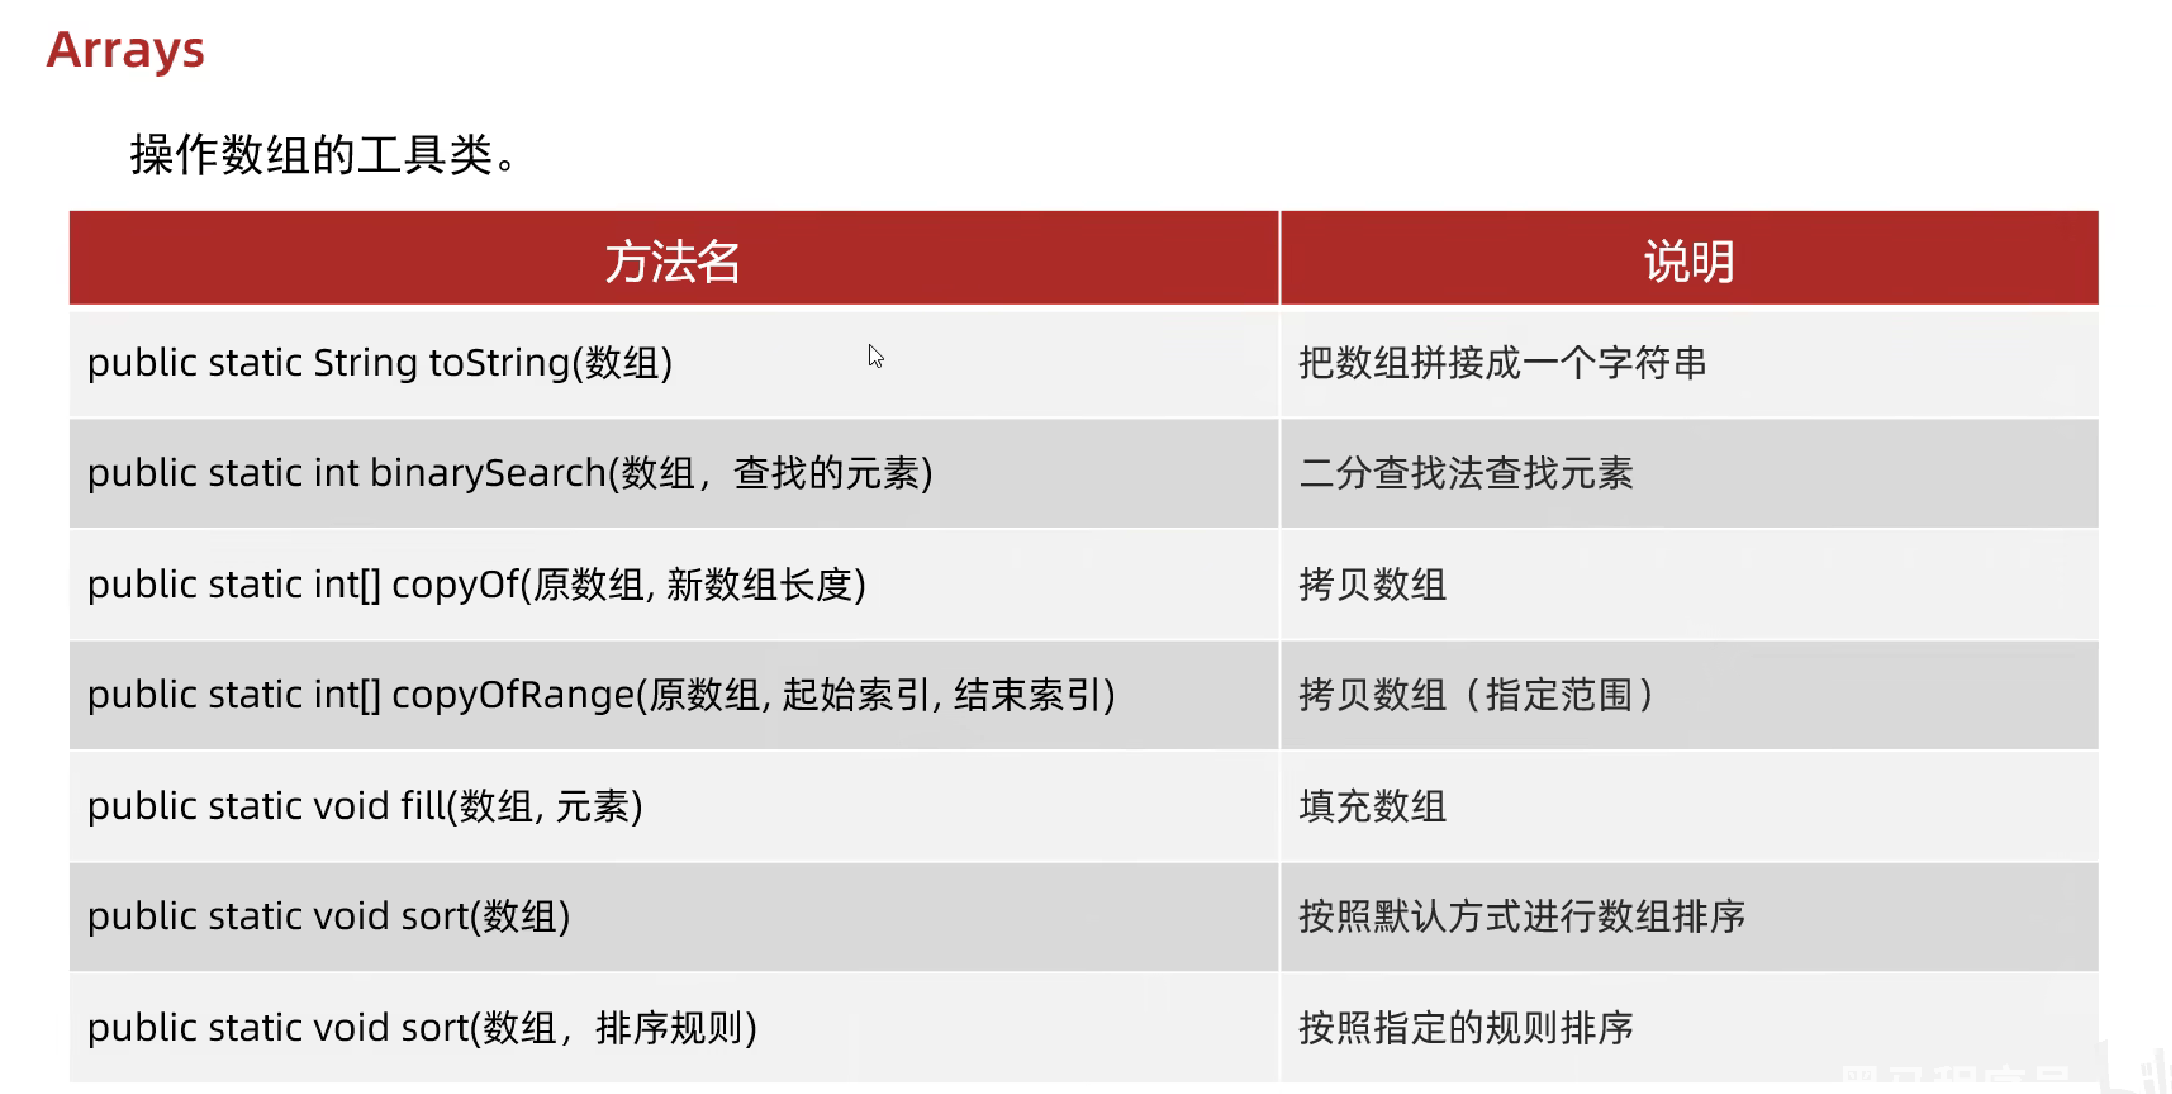
小练手(Arrays工具类方法运用):
package algorithmDemo.mysort;

import java.util.Arrays;
import java.util.Comparator;

public class arrayDemo {
    public static void main(String[] args) {
        //定义数组
        int[] arr = {1,2,6,5,3,4,7,8,9};
        //把数组拼接成一个字符串
        System.out.println(Arrays.toString(arr));
        System.out.println("-------------------");
        //二分查找法查找元素
        // 细节 2:如果要查找的元素是存在的,那么返回的是真实的索引
        // 但是,如果要查找的元素是不存在的,返回的是 - 插入点 - 1
        // 疑问:为什么要减 1 呢?
        // 解释:如果此时,我现在要查找数字 0,那么如果返回的是 - 插入点,就会出现问题了。
        // 如果要查找数字 0,此时 0 是不存在的,但是按照上面的规则,插入点,应该就是 -0
        // 为了避免这样的情况,Java 在这个基础上又减 1
        int findIndex = Arrays.binarySearch(arr,1);
        System.out.println(findIndex);
        int findIndex2 = Arrays.binarySearch(arr,0);
        System.out.println(findIndex2);
        System.out.println("-------------------");
        //拷贝数组
        // 参数一:老数组
        // 参数二:新数组的长度
        // 方法的底层会根据第二个参数来创建新的数组
        // 如果新数组的长度是小于老数组的长度,会部分拷贝
        // 如果新数组的长度是等于老数组的长度,会完全拷贝
        // 如果新数组的长度是大于老数组的长度,会补上默认初始值
        int[] newArr = Arrays.copyOf(arr,2);
        System.out.println(Arrays.toString(newArr));
        int[] newArr2 = Arrays.copyOf(arr,12);
        System.out.println(Arrays.toString(newArr2));
        System.out.println("--------------------");
        //拷贝数组指定范围
        int[] newArr3 = Arrays.copyOfRange(arr,0,3);
        System.out.println(Arrays.toString(newArr3));
        System.out.println("---------------------");
        //填充数组
        Arrays.fill(newArr3,66);
        System.out.println(Arrays.toString(arr));
        System.out.println("---------------------");
        //按照默认方式进行数组排序
        Arrays.sort(arr);
        System.out.println(Arrays.toString(arr));
        System.out.println("--------------------");
        //按照设定规则进行排序
        Integer[] arr1 = {9,8,5,2,3,7,0,1};
        //o1-o2 : 升序排序
        //o2-o1 : 降序排序
        Arrays.sort(arr1,new Comparator<Integer>(){
            @Override
            public int compare(Integer o1, Integer o2) {
                System.out.println("o1:" + o1);
                System.out.println("o2:" + o2);
                return o2-o1;
            }
        });
        System.out.println(Arrays.toString(arr1));

    }
}
指定排序规则sort()方法细节:
只能给引用数据类型的数组进行排序
如果数组是基本数据类型的,需要变成其对于的包装类
第二个参数是一个接口,所以我们在调用方法的时候,需要传递这个接口的实现类对象,作为排序的规则。
但是这个实现类,我只要使用一次,所以就没有必要单独的去写一个类,直接采取匿名内部类的方式就可以了
底层原理:
利用插入排序 + 二分查找的方式进行排序的。
默认把0索引的数据当做是有序的序列,1索引到最后认为是无序的序列。
遍历无序的序列得到里面的每一个元素,假设当前遍历得到的元素是A元素
把A往有序序列中进行插入,在插入的时候,是利用二分查找确定A元素的插入点。
拿着A元素,跟插入点的元素进行比较,比较的规则就是compare方法的方法体
如果方法的返回值是负数,拿着A继续跟前面的数据进行比较
如果方法的返回值是正数,拿着A继续跟后面的数据进行比较
如果方法的返回值是0,也拿着A跟后面的数据进行比较
直到能确定A的最终位置为止。
compare方法的形式参数:
参数一 o1: 表示在无序序列中,遍历得到的每一个元素
参数二 o2: 有序序列中的元素
返回值:
负数:表示当前要插入的元素是小的,放在前面
正数:表示当前要插入的元素是大的,放在后面
0: 表示当前要插入的元素跟现在的元素比是一样的也会放在后面
Lambda表达式

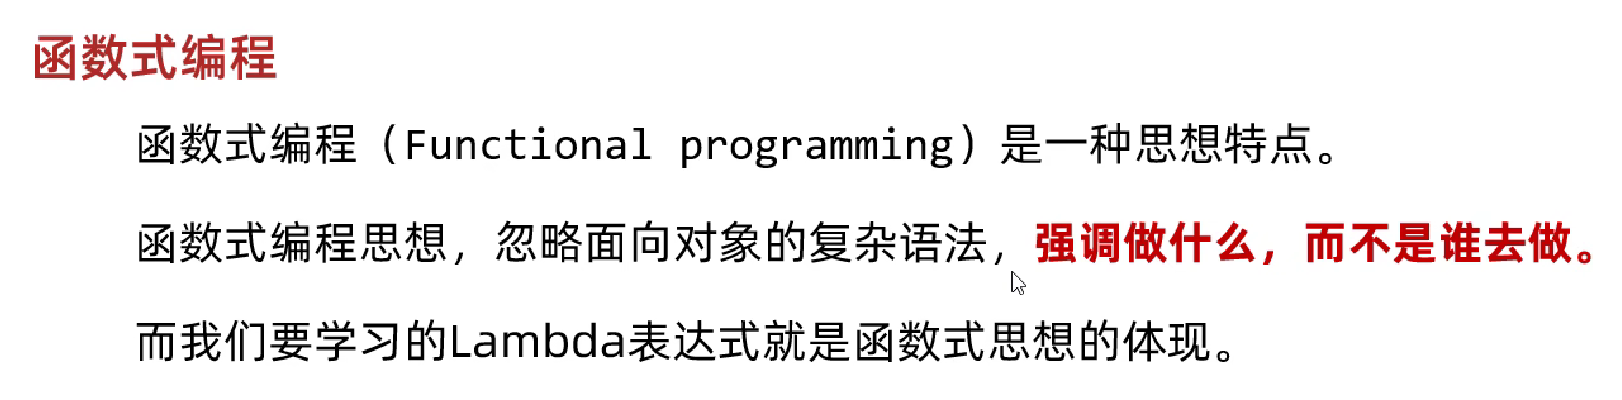

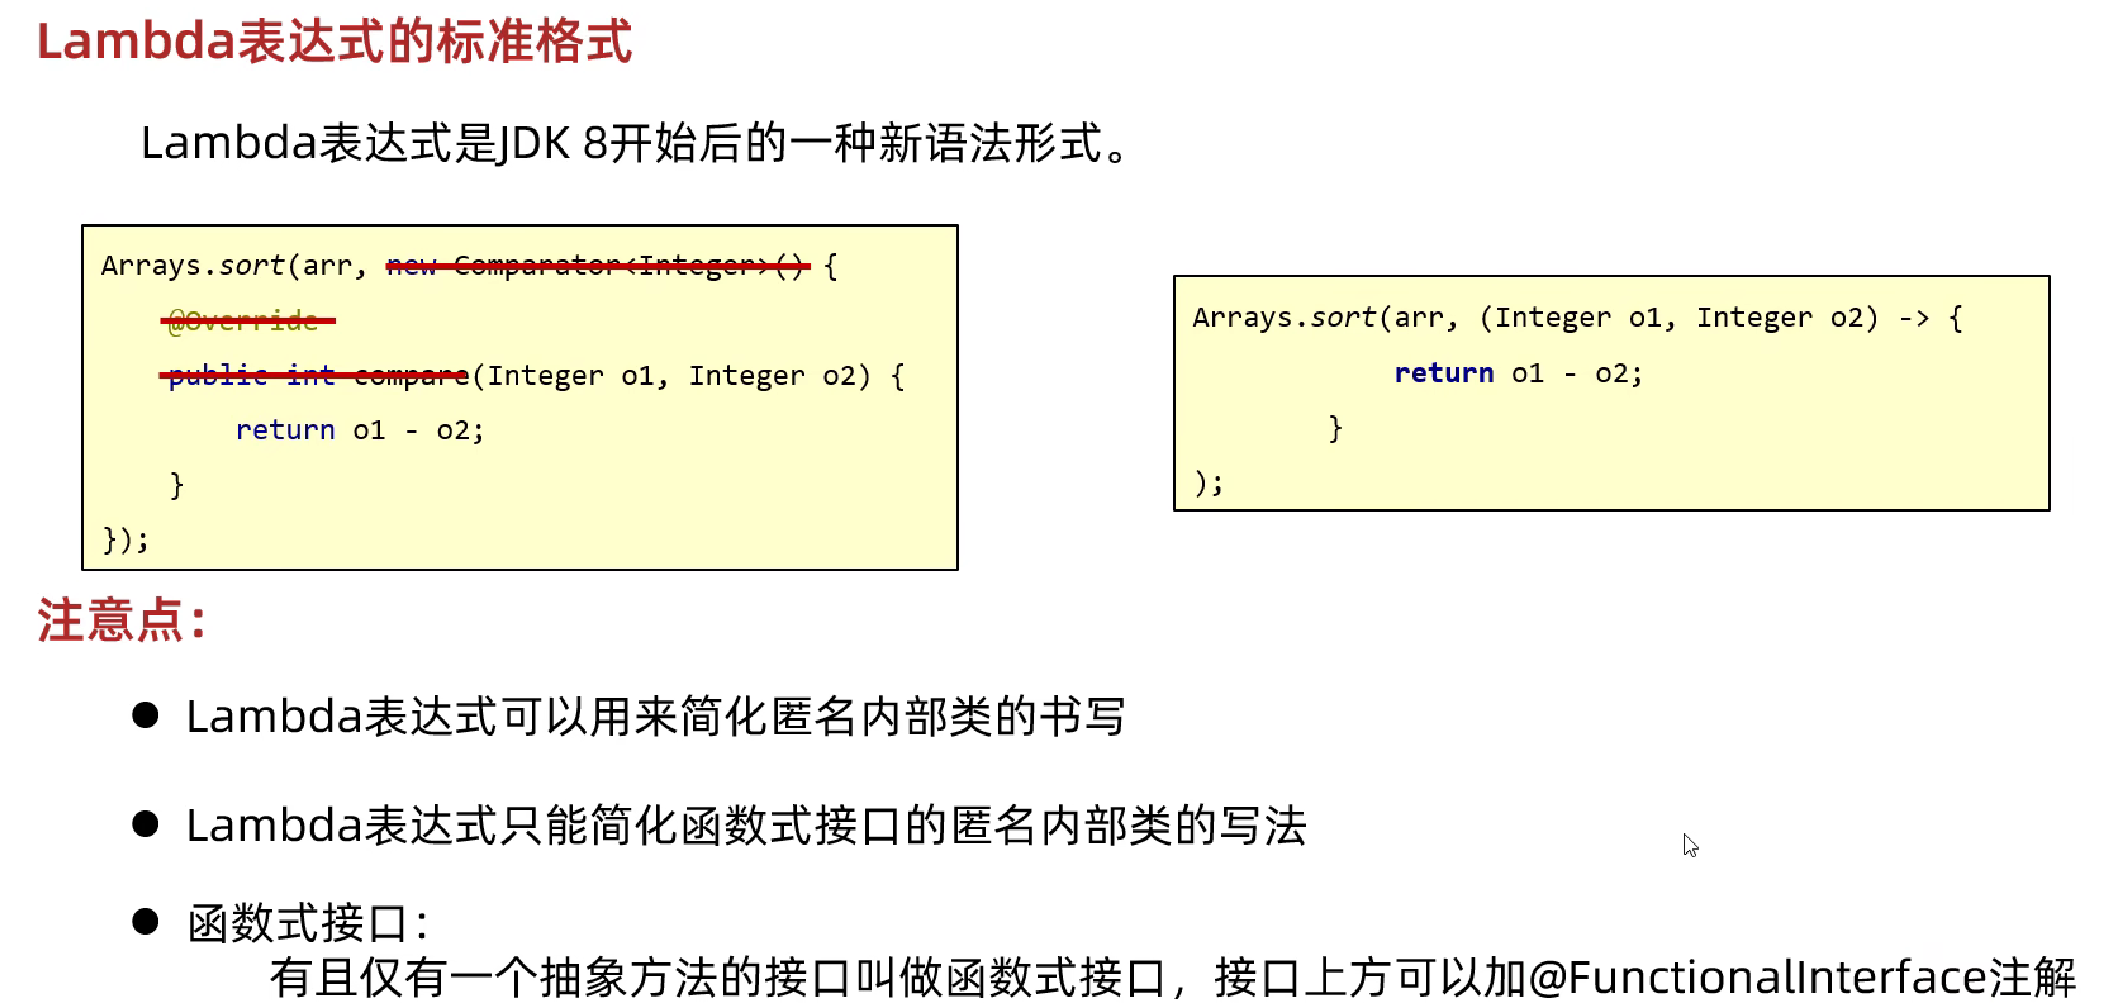
小练手(将匿名内部类变为Lambda表达式):
package algorithmDemo.lambdaDemo;

public class lambdaTest1 {
    public static void main(String[] args) {
        //匿名内部类实现
        method(new Swim() {
            @Override
            public void swimming() {
                System.out.println("正在游泳....");
            }
        });
        //lambda表达式实现
        //只关注方法体
        method(()->{
                System.out.println("正在游泳....");
            }
        );
    }
    public static void method(Swim s){
        s.swimming();
    }
}
interface Swim{
    public abstract void swimming();
}

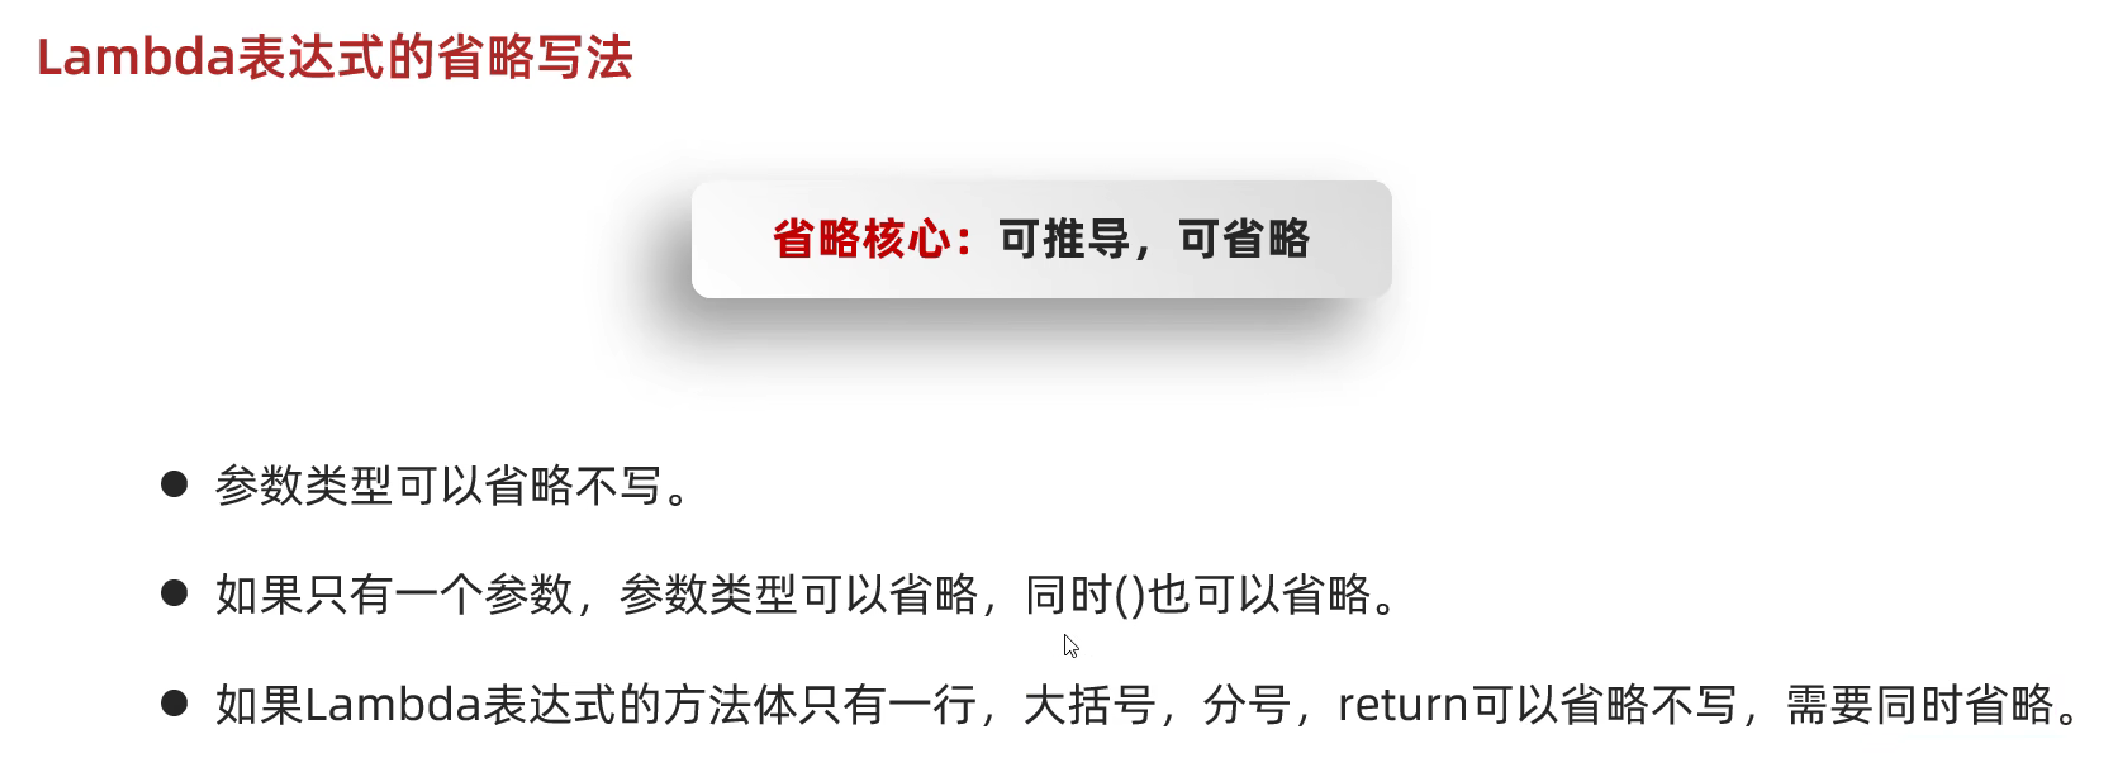
可以对Lambda表达式在刚才的基础上再进行省略简化
lambda的省略规则:
1.参数类型可以省略不写。
2.如果只有一个参数,参数类型可以省略,同时()也可以省略。
3.如果Lambda表达式的方法体只有一行,大括号,分号,return可以省略不写,需要同时省略。
小练手(将Lambda表达式运用省略写法):
package algorithmDemo.lambdaDemo;

import java.util.Arrays;
import java.util.Comparator;

public class test2 {
    public static void main(String[] args) {
        Integer[] arr1 = {1,2,3,4,5,12,56,32};
        Integer[] arr2 = {1,2,3,4,5,12,56,32};
        Integer[] arr3 = {1,2,3,4,5,12,56,32};
        //匿名内部类完整实现
        Arrays.sort(arr1,new Comparator<Integer>() {
            @Override
            public int compare(Integer o1, Integer o2) {
                return o2-o1;
            }
        });
        System.out.println(Arrays.toString(arr1));
        /**
         * lambda 的省略规则:
         * 1. 参数类型可以省略不写。
         * 2. 如果只有一个参数,参数类型可以省略,同时 () 也可以省略。
         * 3. 如果 Lambda 表达式的方法体只有一行,大括号,分号,return 可以省略不写,需要同时省略。
         * */
        //Lambda表达式完整格式
        Arrays.sort(arr2,(Integer o1, Integer o2) -> {
                return o2-o1;
            }
        );
        System.out.println(Arrays.toString(arr1));
        //Lambda表达式省略格式
        Arrays.sort(arr3,( o1,  o2) -> o2-o1 );
        System.out.println(Arrays.toString(arr1));

    }
}
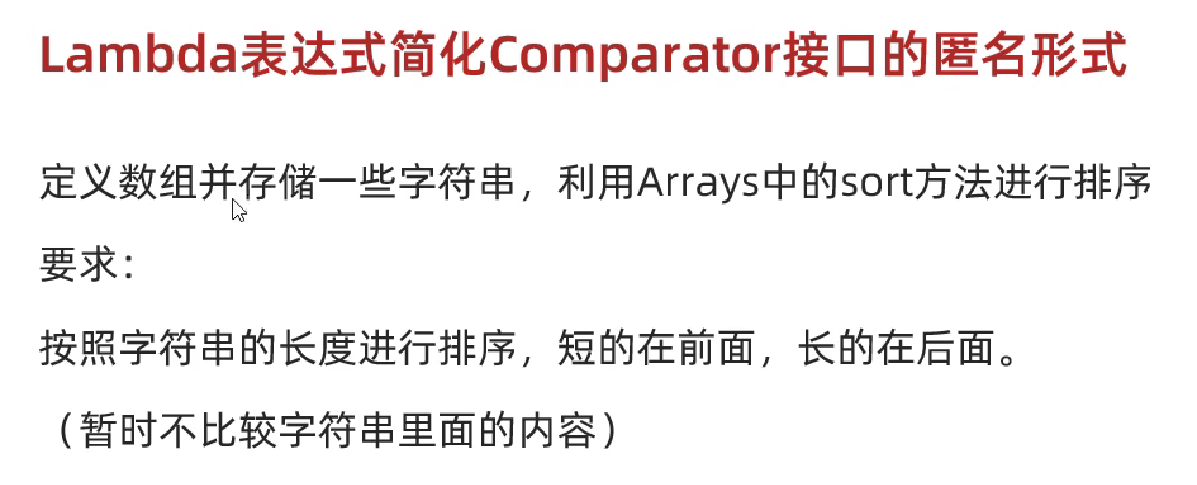
小练手(根据字符串长度进行排序):
package algorithmDemo.lambdaDemo;

import java.util.Arrays;
import java.util.Comparator;

public class test3 {
    public static void main(String[] args) {
        //定义数组,实现短的在前面,长的在后面
        String[] arr1 = {"aaa","a","aaaa","aa"};
        String[] arr2 = {"aaa","a","aaaa","aa"};
        String[] arr3 = {"aaa","a","aaaa","aa"};
        //匿名内部类实现
        Arrays.sort(arr1,new Comparator<String>() {
            @Override
            public int compare(String o1, String o2) {
                return o1.length()-o2.length();
            }
        });
        System.out.println(Arrays.toString(arr1));
        //Lambda表达式完整实现
        Arrays.sort(arr2,(String o1, String o2) -> {
                return o1.length()-o2.length();
            }
        );
        System.out.println(Arrays.toString(arr2));
        //Lambda表达式省略实现
        Arrays.sort(arr3,( o1,  o2) ->   o1.length()-o2.length());
        System.out.println(Arrays.toString(arr3));

    }
}
五道经典算法题
题一(朋友信息排序)
按照要求进行排序
定义数组并存储一些朋友对象,利用arrays中的sort方法进行排序
要求1:属性有姓名,年龄,身高。
要求2:按照年龄的大小进行排序,年龄一样,按照身高排序,身高一样按照姓名的字母进行排序。
姓名中不要有中文或特殊字符,会涉及到后面的知识)
//根据在ASCII表中的位置来进行比较
String s1 = "abc";//99
String s2 = "abd";//100
int i = s1.compareTo(s2);
System.out.println(i);//-1
小练手(对朋友信息进行排序):
package algorithmDemo.lambdaDemo;

import java.util.Arrays;
import java.util.Comparator;

public class test4 {
    public static void main(String[] args) {
        /**
         * 定义数组并存储一些朋友对象,利用arrays中的sort方法进行排序
         * 要求1:属性有姓名,年龄,身高。
         * 要求2:按照年龄的大小进行排序,年龄一样,按照身高排序,身高一样按照姓名的字母进行排序。
         * 姓名中不要有中文或特殊字符,会涉及到后面的知识)
         * */
        Friend f1 = new Friend("Tom",18,175);
        Friend f2 = new Friend("Rose",19,172);
        Friend f3 = new Friend("Jack",23,176);
        Friend f4 = new Friend("Jennie",23,162);

        //定义数组进行存储朋友信息
        Friend[] friends = {f1,f2,f3,f4};
        Friend[] friends1 = {f1,f2,f3,f4};

        //匿名内部类实现
        Arrays.sort(friends,new Comparator<Friend>() {
            @Override
            public int compare(Friend o1, Friend o2) {
                //按照年龄的大小进行排序,年龄一样,按照身高排序,身高一样,按照姓名的字母进行排序
                double num = o1.getAge()-o2.getAge();
                if (num == 0){
                    num = o1.getHeight()-o2.getHeight();
                }
                if (num == 0){
                    num = o1.getName().compareTo(o2.getName());
                }
                if (num >0){
                    return 1;
                }else if (num <0){
                    return -1;
                }else {
                    return 0;
                }
            }
        });
        System.out.println(Arrays.toString(friends));
        //Lambda表达式实现
        Arrays.sort(friends1,( o1,  o2) ->{
                //按照年龄的大小进行排序,年龄一样,按照身高排序,身高一样,按照姓名的字母进行排序
                double num = o1.getAge()-o2.getAge();
                if (num == 0){
                    num = o1.getHeight()-o2.getHeight();
                }
                if (num == 0){
                    num = o1.getName().compareTo(o2.getName());
                }
                if (num >0){
                    return 1;
                }else if (num <0){
                    return -1;
                }else {
                    return 0;
                }
        });
        System.out.println(Arrays.toString(friends1));
    }
}
题二(兔子数量计算)
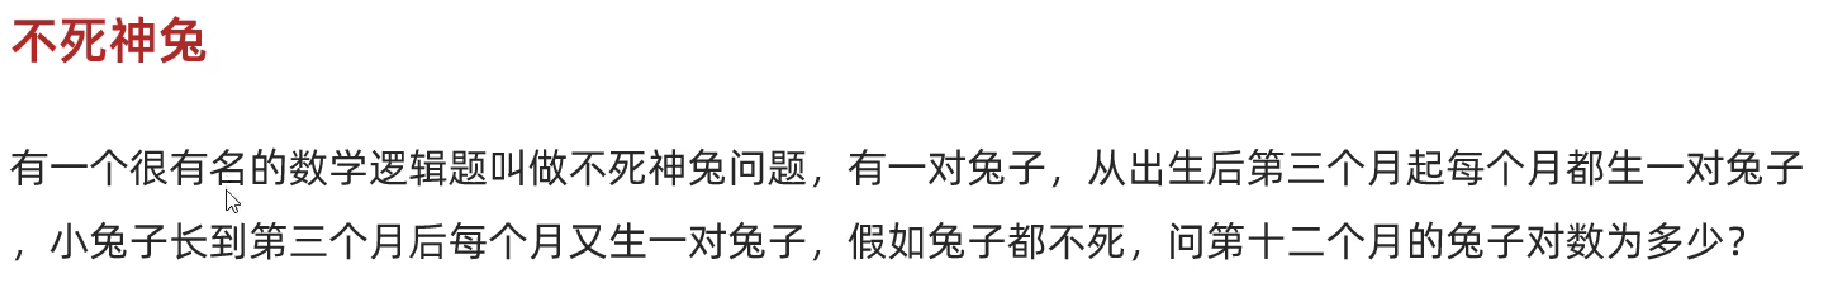
分析:实心圆圈代表为成熟兔子,空心圆圈代表新生兔子还没长熟还不能生小兔子
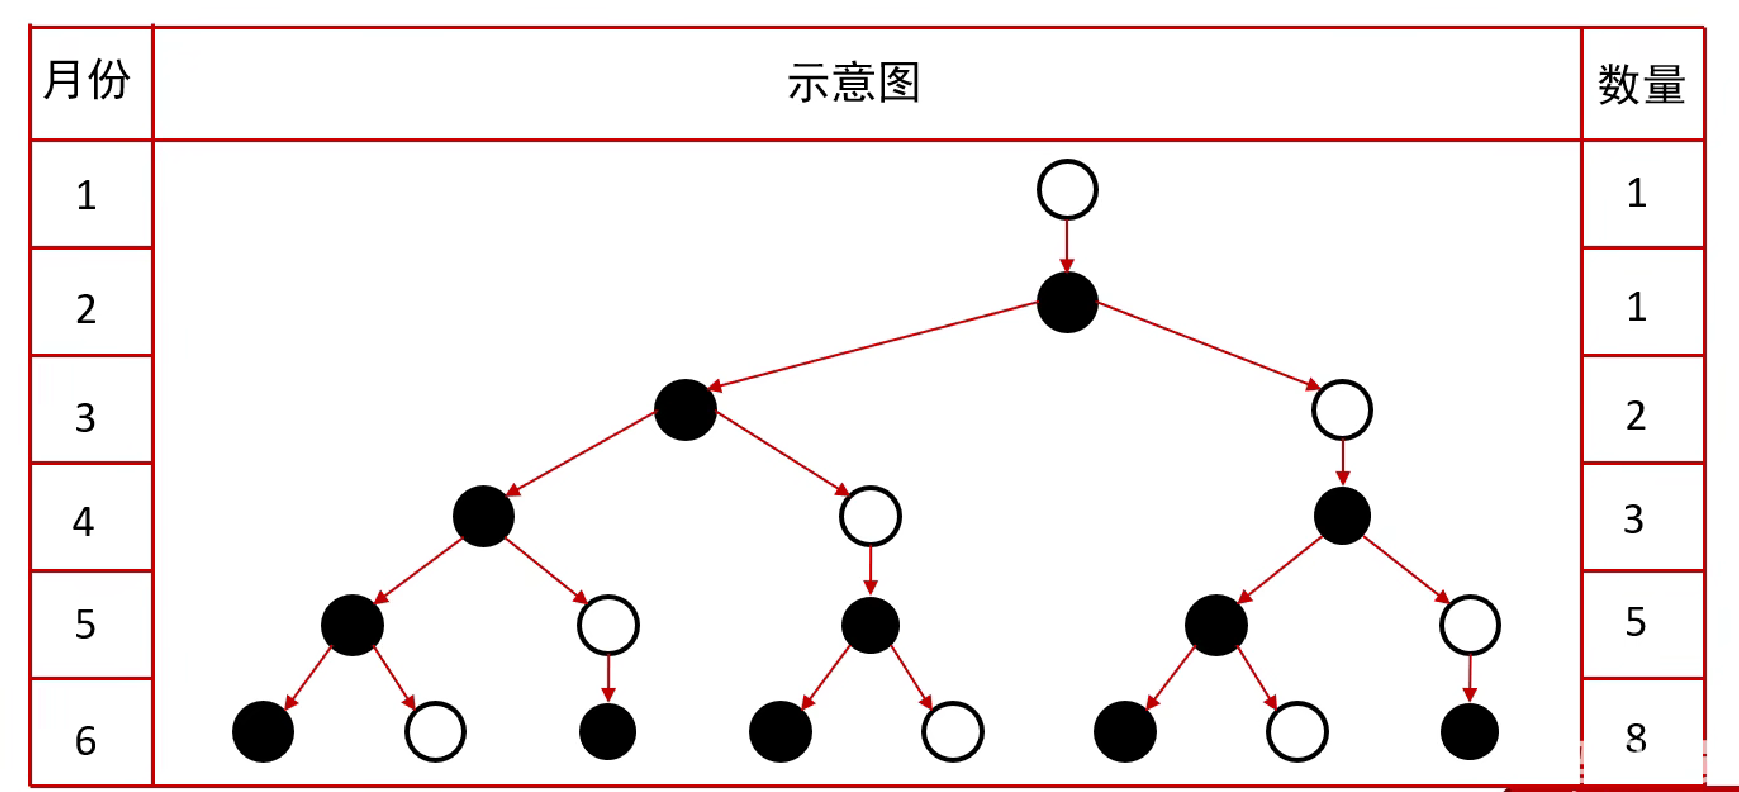
发现规律:从第三个月份开始,该月份的兔子对数等于前两个月份兔子数的总和
小练手(不死神兔):
package algorithmDemo.testDemo;

public class test2 {
    public static void main(String[] args) {
        //斐波那契数列实现
        System.out.println(getSum(12));
    }
    public static int getSum(int month){
        if (month == 1 || month == 2){
            return 1;
        }else {
            return getSum(month - 1) + getSum(month - 2);
        }
    }
}
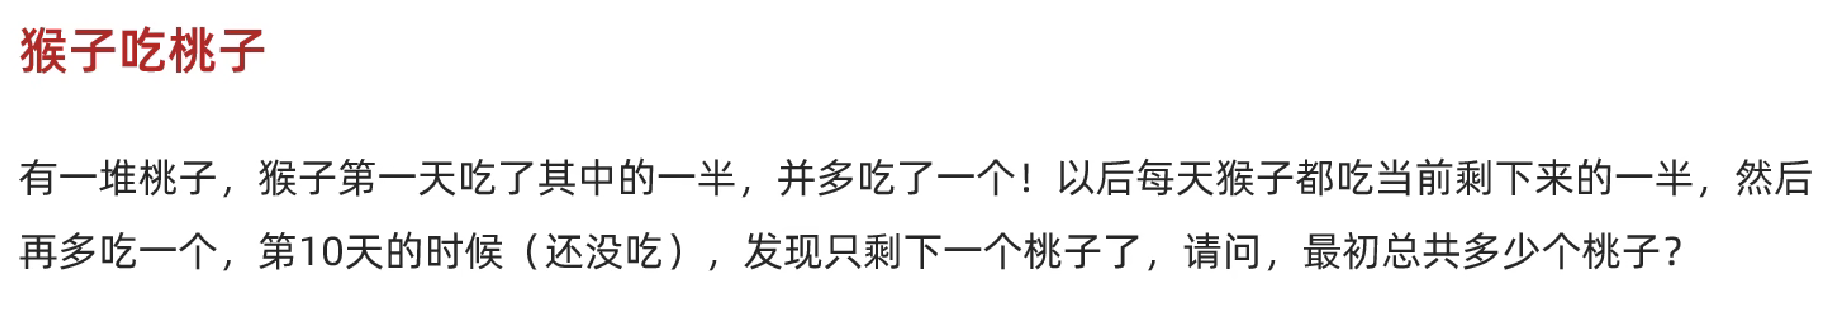
题三(猴子吃桃子)
小练手(猴子吃桃):
package algorithmDemo.testDemo;

public class test3 {
    public static void main(String[] args) {
        /**
         * 有一堆桃子,猴子第一天吃了其中的一半,并多吃了一个,以后每天猴子都吃当前剩下来的一半,然后
         * 再多吃一个,第10天的时候(还没吃),发现只剩下一个桃子了,请问,最初总共多少个桃子?
         * f(10) = 1
         * f(9) = (f(10)+1)*2
         * f(8) = (f(9)+1)*2
         * f(7) = (f(8)+1)*2
         * ....
         * f(1) = (f(2)+1)*2
         * */
        System.out.println(getSum(1));
    }
    public static int getSum(int day) {
        if (day == 10){
            return 1;
        }else {
            return (getSum(day +1)+1)*2;
        }
    }
}
题三(爬楼梯)
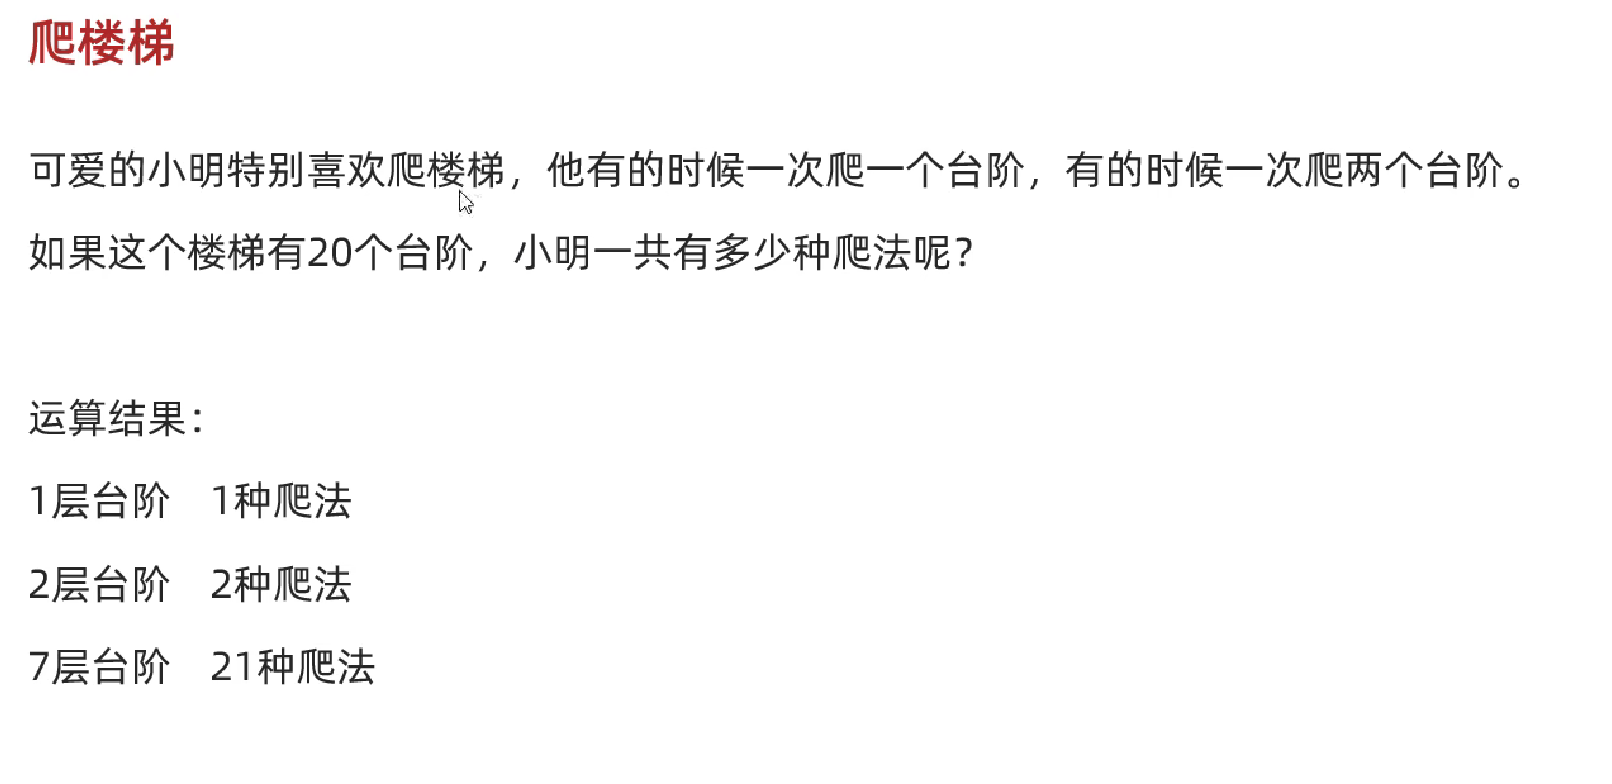
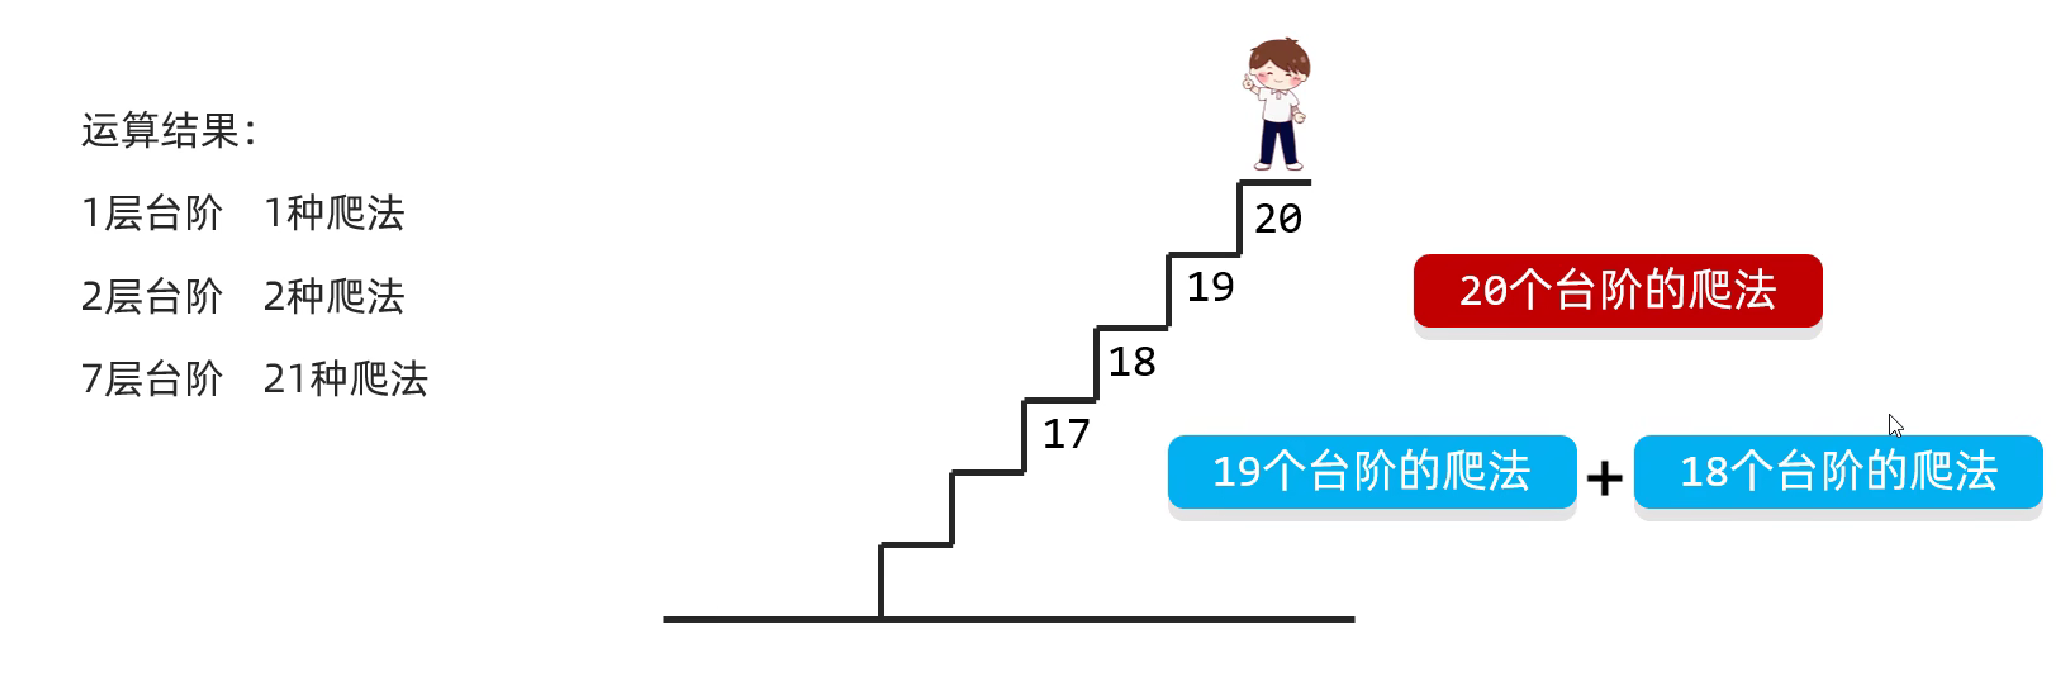
爬楼梯相当于一个斐波那契数列,而第19个台阶的爬法包括了从第十八阶爬到第二十阶的其中一种爬法
小练手(爬楼梯):
package algorithmDemo.testDemo;

public class floorTest {
        public static void main(String[] args) {
            //斐波那契数列实现
            System.out.println(getCount(20));
        }
        public static int getCount(int floor){
            if (floor == 1 ){
                return 1;
            } else if (floor == 2 ) {
                return 2;
            } else {
                return getCount(floor - 1) + getCount(floor - 2);
            }
        }
    }
集合进阶
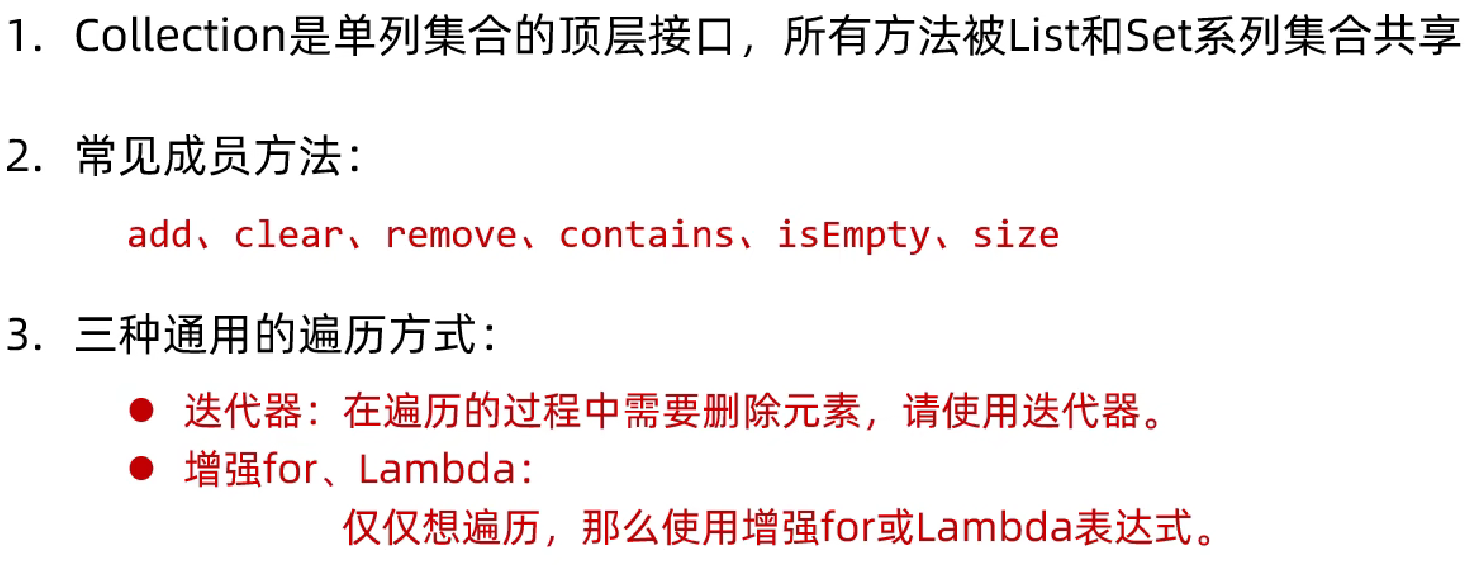
单列集合顶层接口Collection
集合体系结构
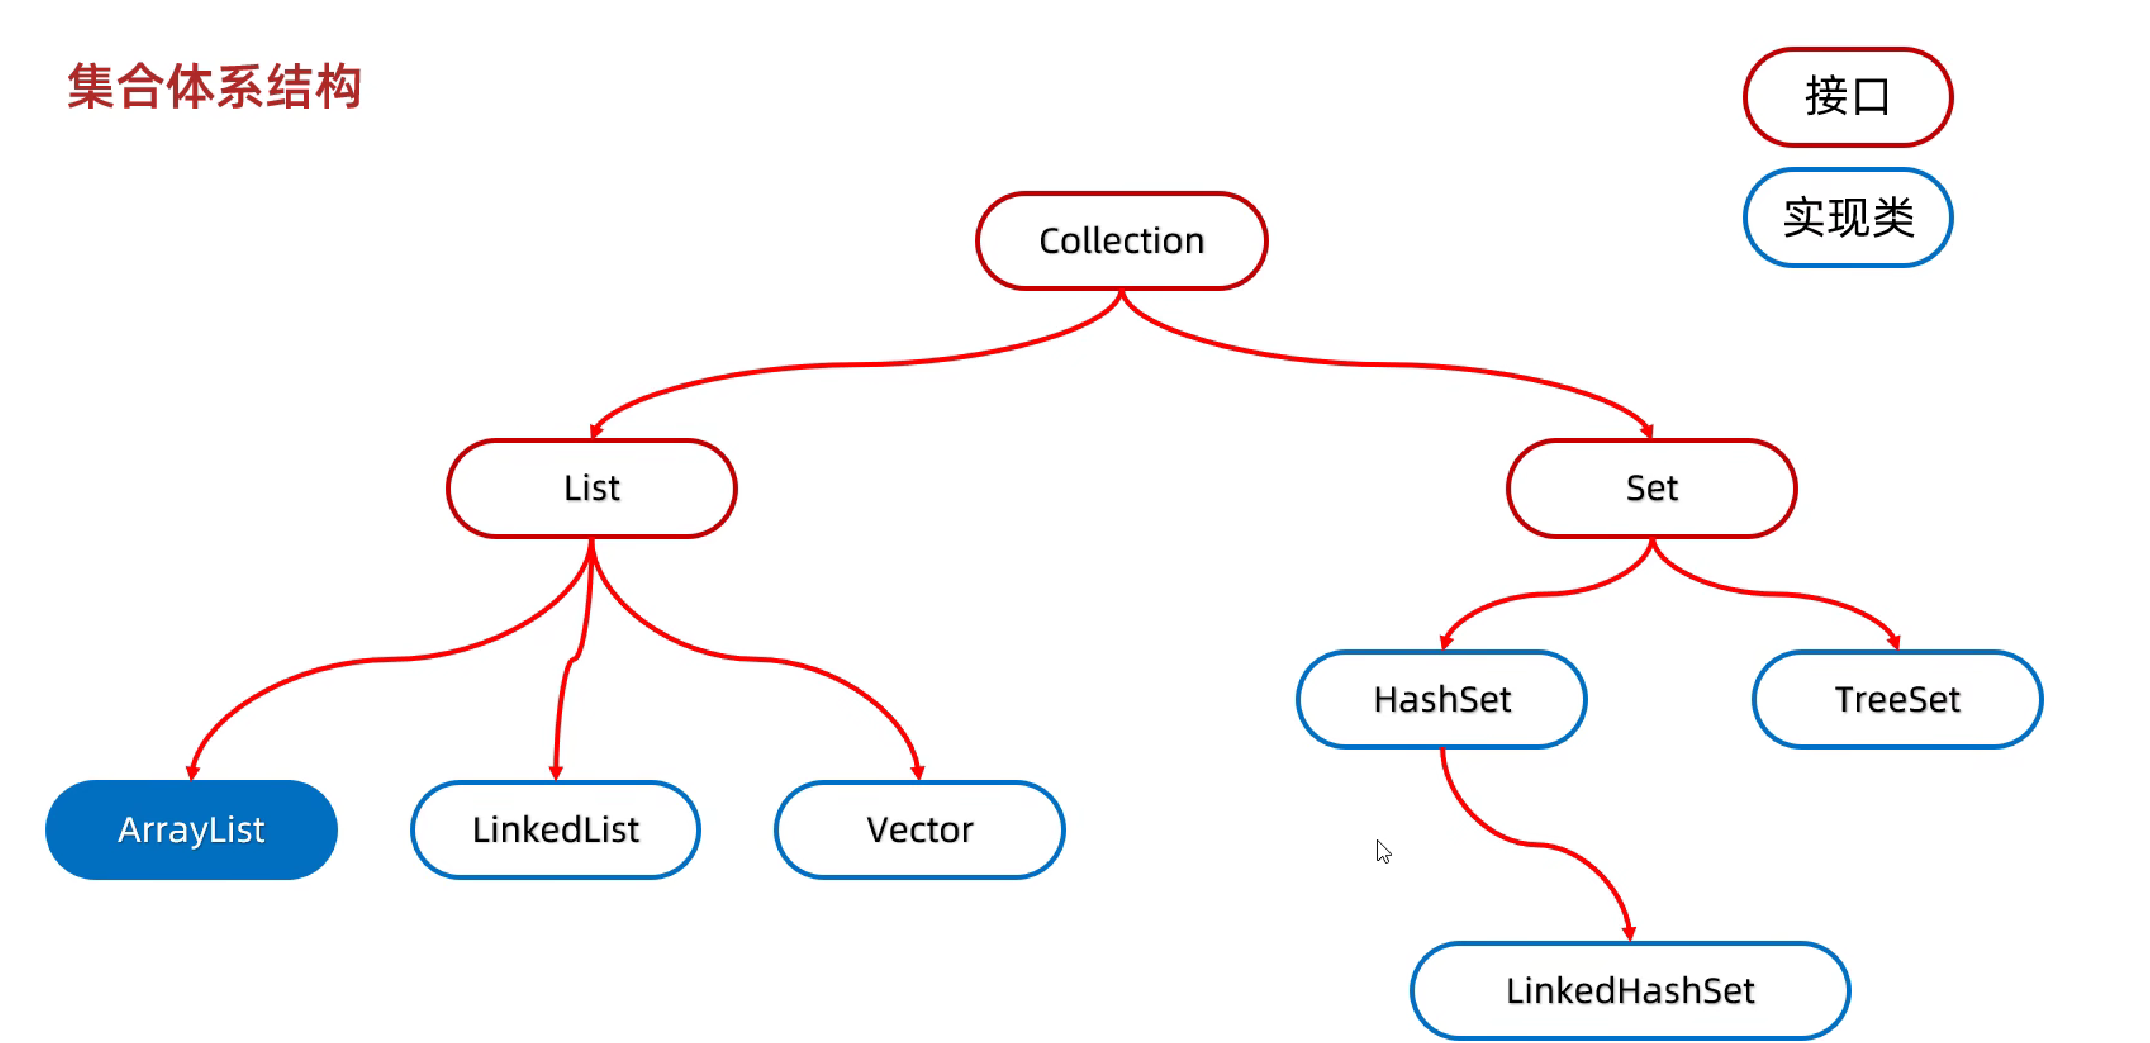
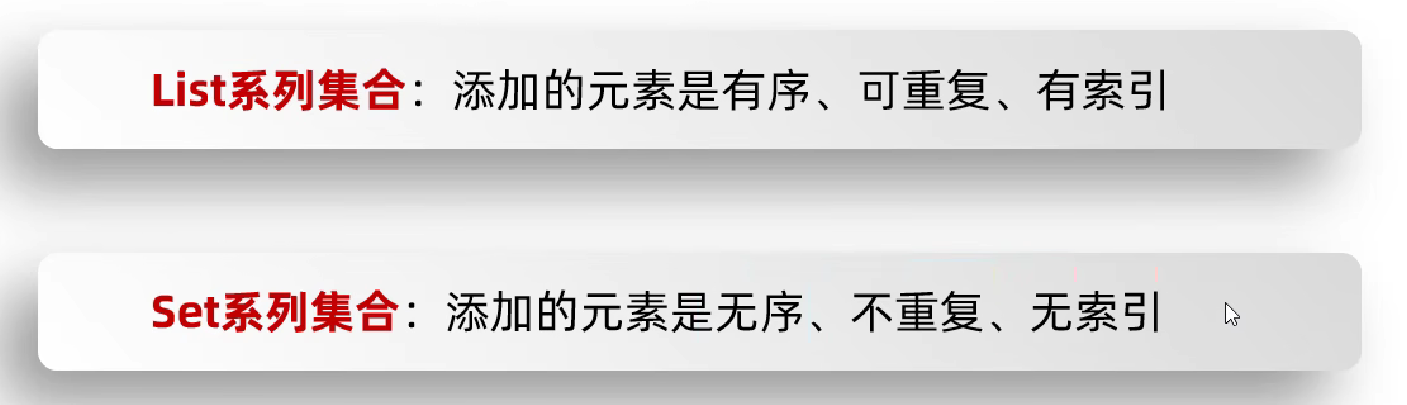
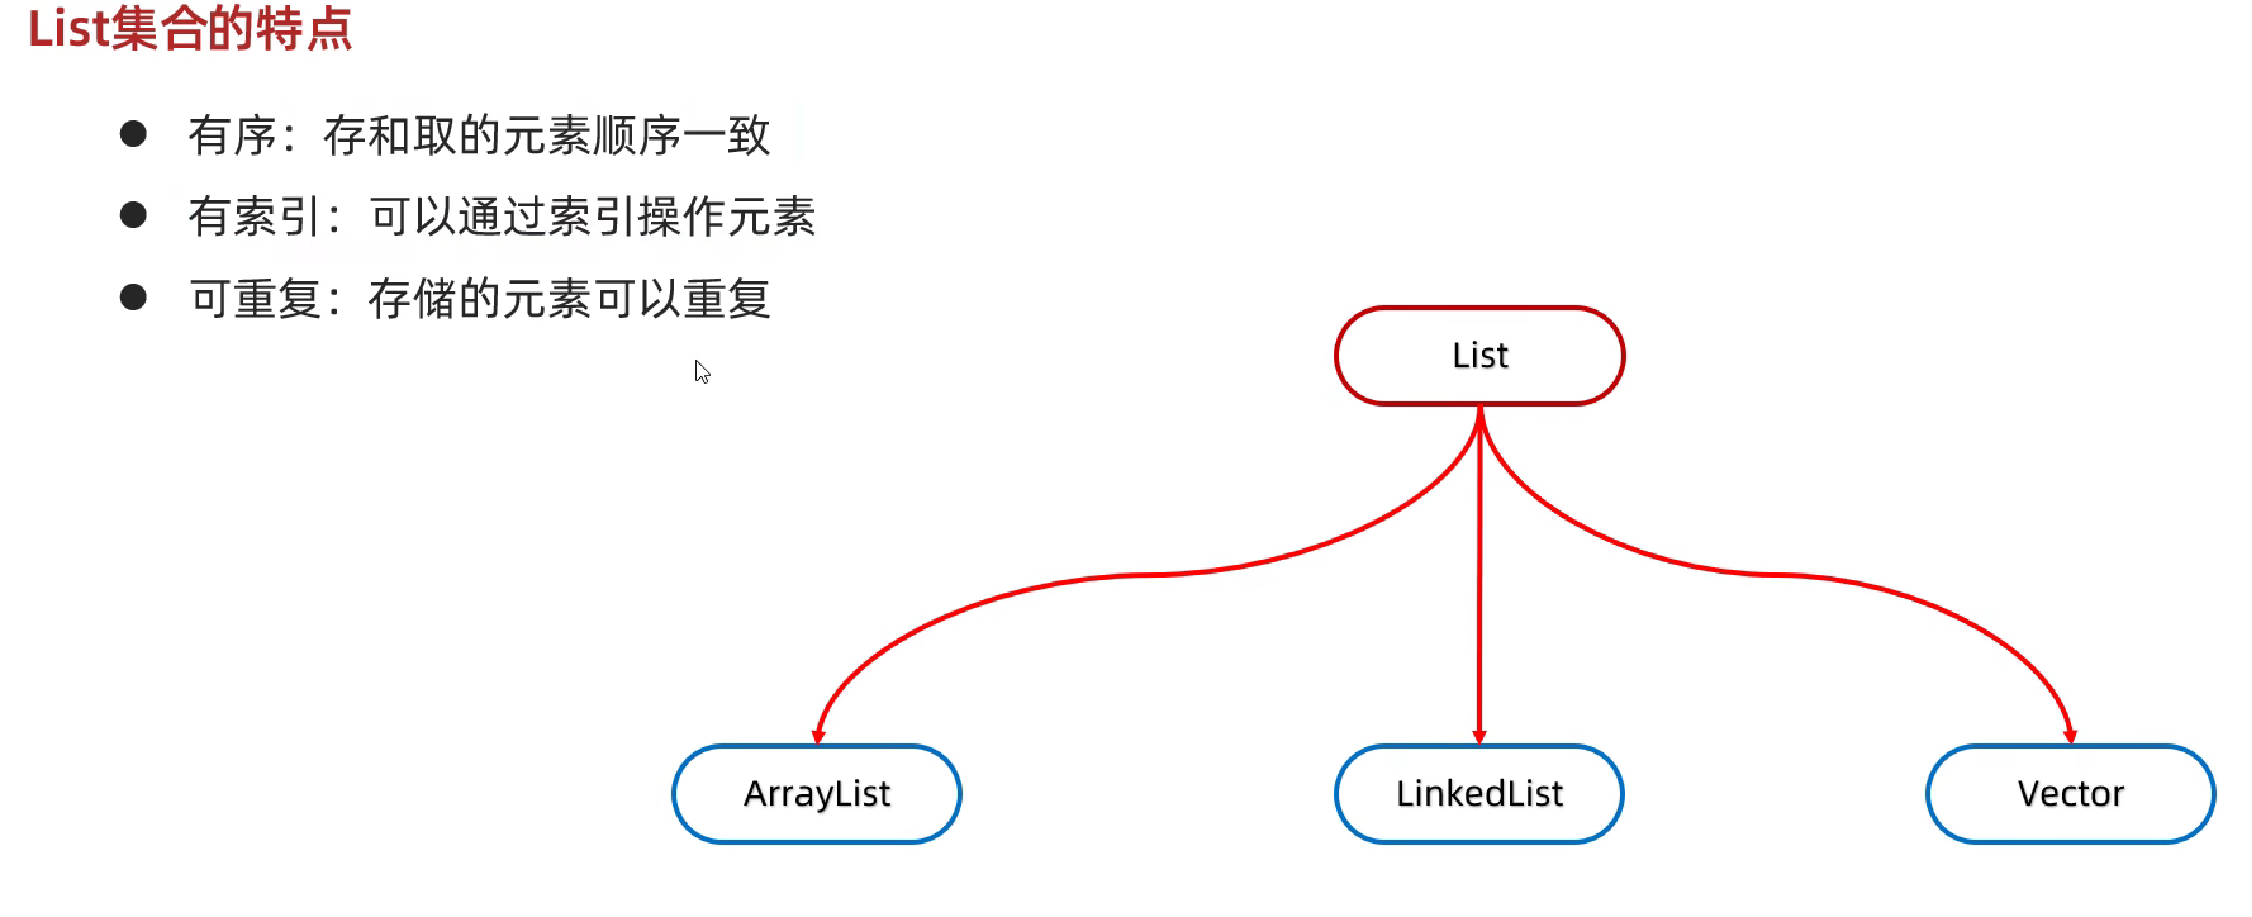
注意:这里的有序指的是我们存和取得顺序是一样的,即我存入“张三“,”李四“,”王五”,则取出得时候也是“张三“,”李四“,”王五”这个顺序,与我们之前的排序区分开。
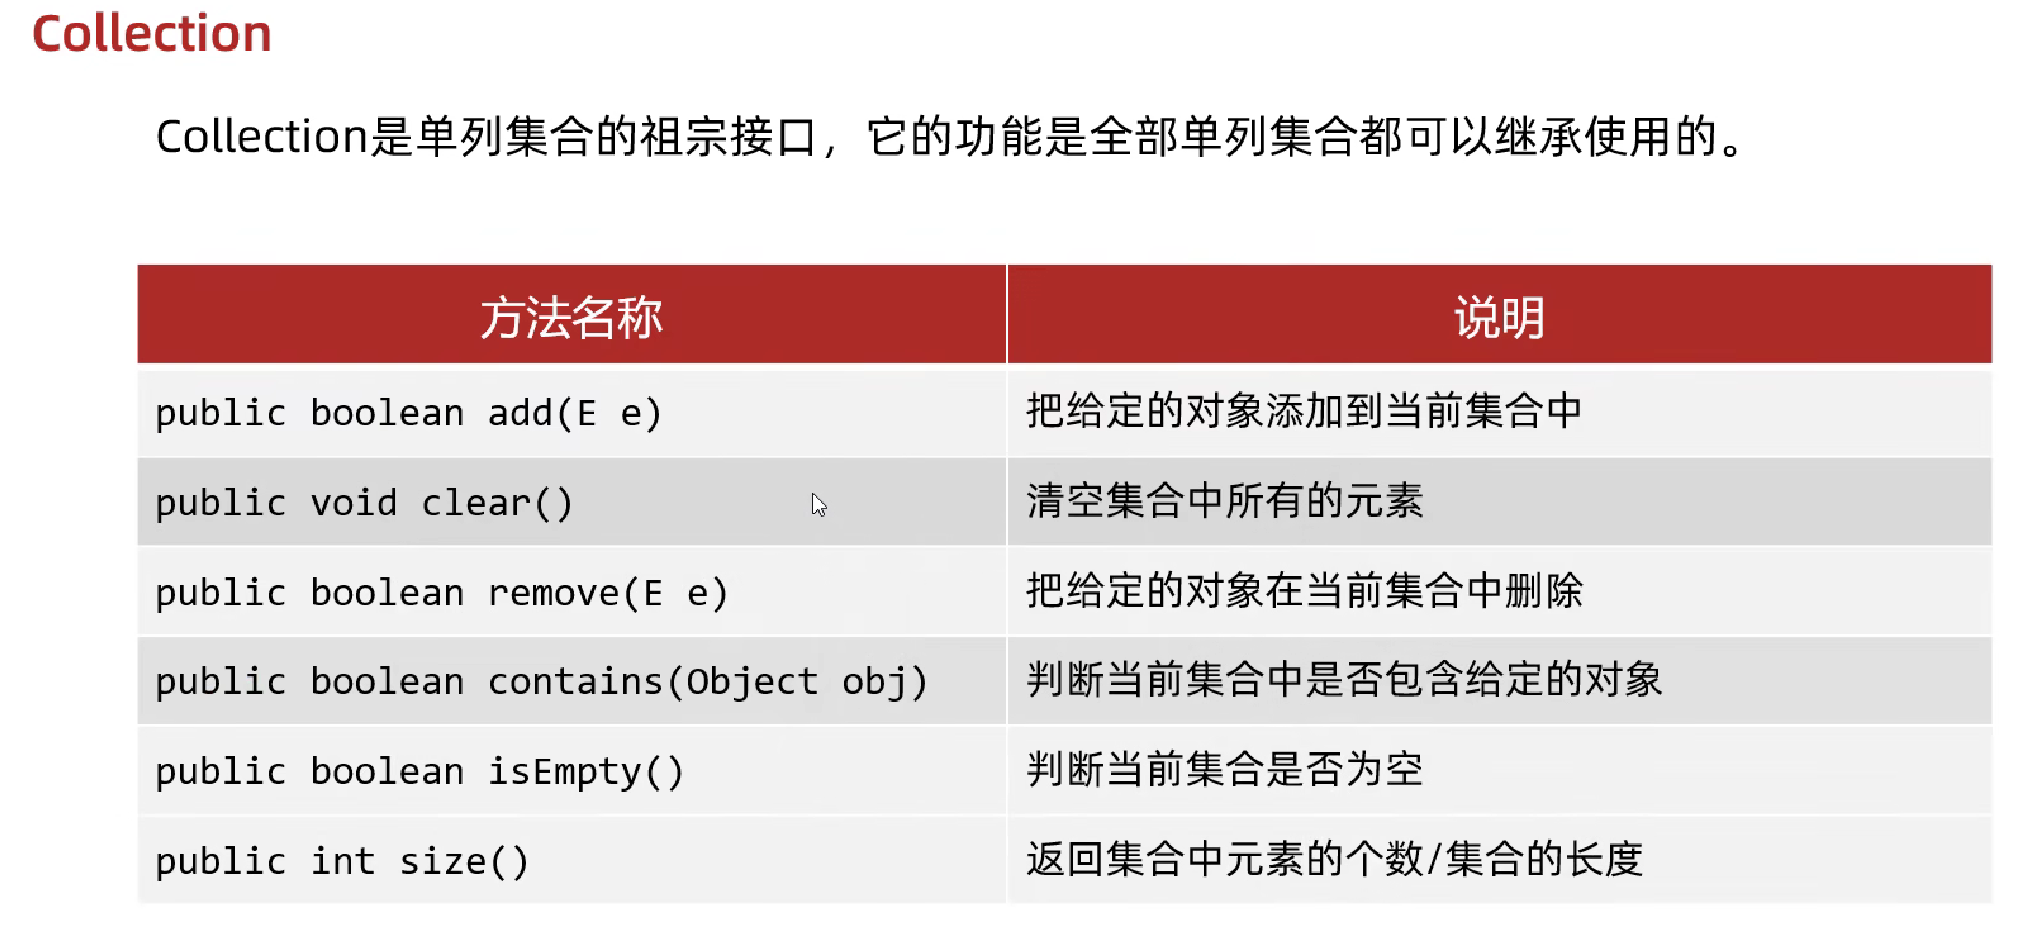
小练手(Collection方法实现):
package myCollection;

import java.util.ArrayList;
import java.util.Collection;

public class collectionTest1 {
    public static void main(String[] args) {
        /**
         * public boolean add(E e) 添加
         * public void clear() 清空
         * public boolean remove(E e) 删除
         * public boolean contains(Object obj) 判断是否包含
         * public boolean isEmpty() 判断是否为空
         * public int size() 集合长度
         * */
        //创建对象
        Collection<String> coll = new ArrayList<String>();
        //添加
        //细节1:在List系列集合中添加数据,方法会永远返回true,因为可以重复
        //细节2:在Set系列集合中添加数据,当添加元素不存在时,返回true;若存在则返回false
        coll.add("aaa");
        coll.add("bbb");
        coll.add("ccc");
        System.out.println(coll);
        //删除
        coll.remove("aaa");
        System.out.println(coll);
        //判断是否包含
        System.out.println(coll.contains("ccc"));
        //判断是否为空
        System.out.println(coll.isEmpty());
        //获取集合长度
        System.out.println(coll.size());
    }
}
对于自定义对象判断集合是否存在时,则需要对equals()方法进行重写。因为equals方法的实现是根据地址值来进行比较判断的,而对于自定义对象,每一次都会new一个新的地址,所以如果直接用equals方法则必定为false,故需要进行重写。
小练手(判断集合中自定义对象是否存在):
//student.java
package myCollection;

import java.util.Objects;

public class student {
    private String name;
    private int age;

    public student() {
    }

    public student(String name, int age) {
        this.name = name;
        this.age = age;
    }

    @Override
    public boolean equals(Object o) {
        if (o == null || getClass() != o.getClass()) {
            return false;
        }
        student student = (student) o;
        return age == student.age && Objects.equals(name, student.name);
    }

    /**
     * 获取
     * @return name
     */
    public String getName() {
        return name;
    }

    /**
     * 设置
     * @param name
     */
    public void setName(String name) {
        this.name = name;
    }

    /**
     * 获取
     * @return age
     */
    public int getAge() {
        return age;
    }

    /**
     * 设置
     * @param age
     */
    public void setAge(int age) {
        this.age = age;
    }

    @Override
    public String toString() {
        return "student{name = " + name + ", age = " + age + "}";
    }
}
//collectionTest2.java
package myCollection;

import java.util.ArrayList;
import java.util.Collection;

public class collectionTest2 {
    public static void main(String[] args) {
        Collection<student> students = new ArrayList<student>();

        student stu1 = new student("zhangsan", 18);
        student stu2 = new student("lisi", 19);
        student stu3 = new student("wangwu", 20);

        students.add(stu1);
        students.add(stu2);
        students.add(stu3);

        student stu4 = new student("zhangsan", 18);

        System.out.println(students.contains(stu4));

    }
}
添加
- 细节 1:如果我们往 List 系列集合中添加数据,那么方法永远返回 true,因为 List 系列的是允许元素重复的。
- 细节 2:如果我们要往 Set 系列集合中添加数据,如果当前要添加元素不存在,方法返回 true,表示添加成功。
- 如果当前要添加的元素已经存在,方法返回 false,表示添加失败。
- 因为 Set 系列的集合不允许重复。
删除
- 细节 1:因为 Collection 里面定义的是共性的方法,所以此时不能通过索引进行删除,只能通过元素的对象进行删除。
- 细节 2:方法会有一个布尔类型的返回值,删除成功返回 true,删除失败返回 false。如果要删除的元素不存在,就会删除失败。
判断元素是否包含
- 细节:底层是依赖 equals 方法判断是否存在的。
- 所以,如果集合中存储的是自定义对象,也想通过 contains 方法来判断是否包含,那么在 javabean 类中,一定要重写 equals 方法。
Collection遍历方式
迭代器
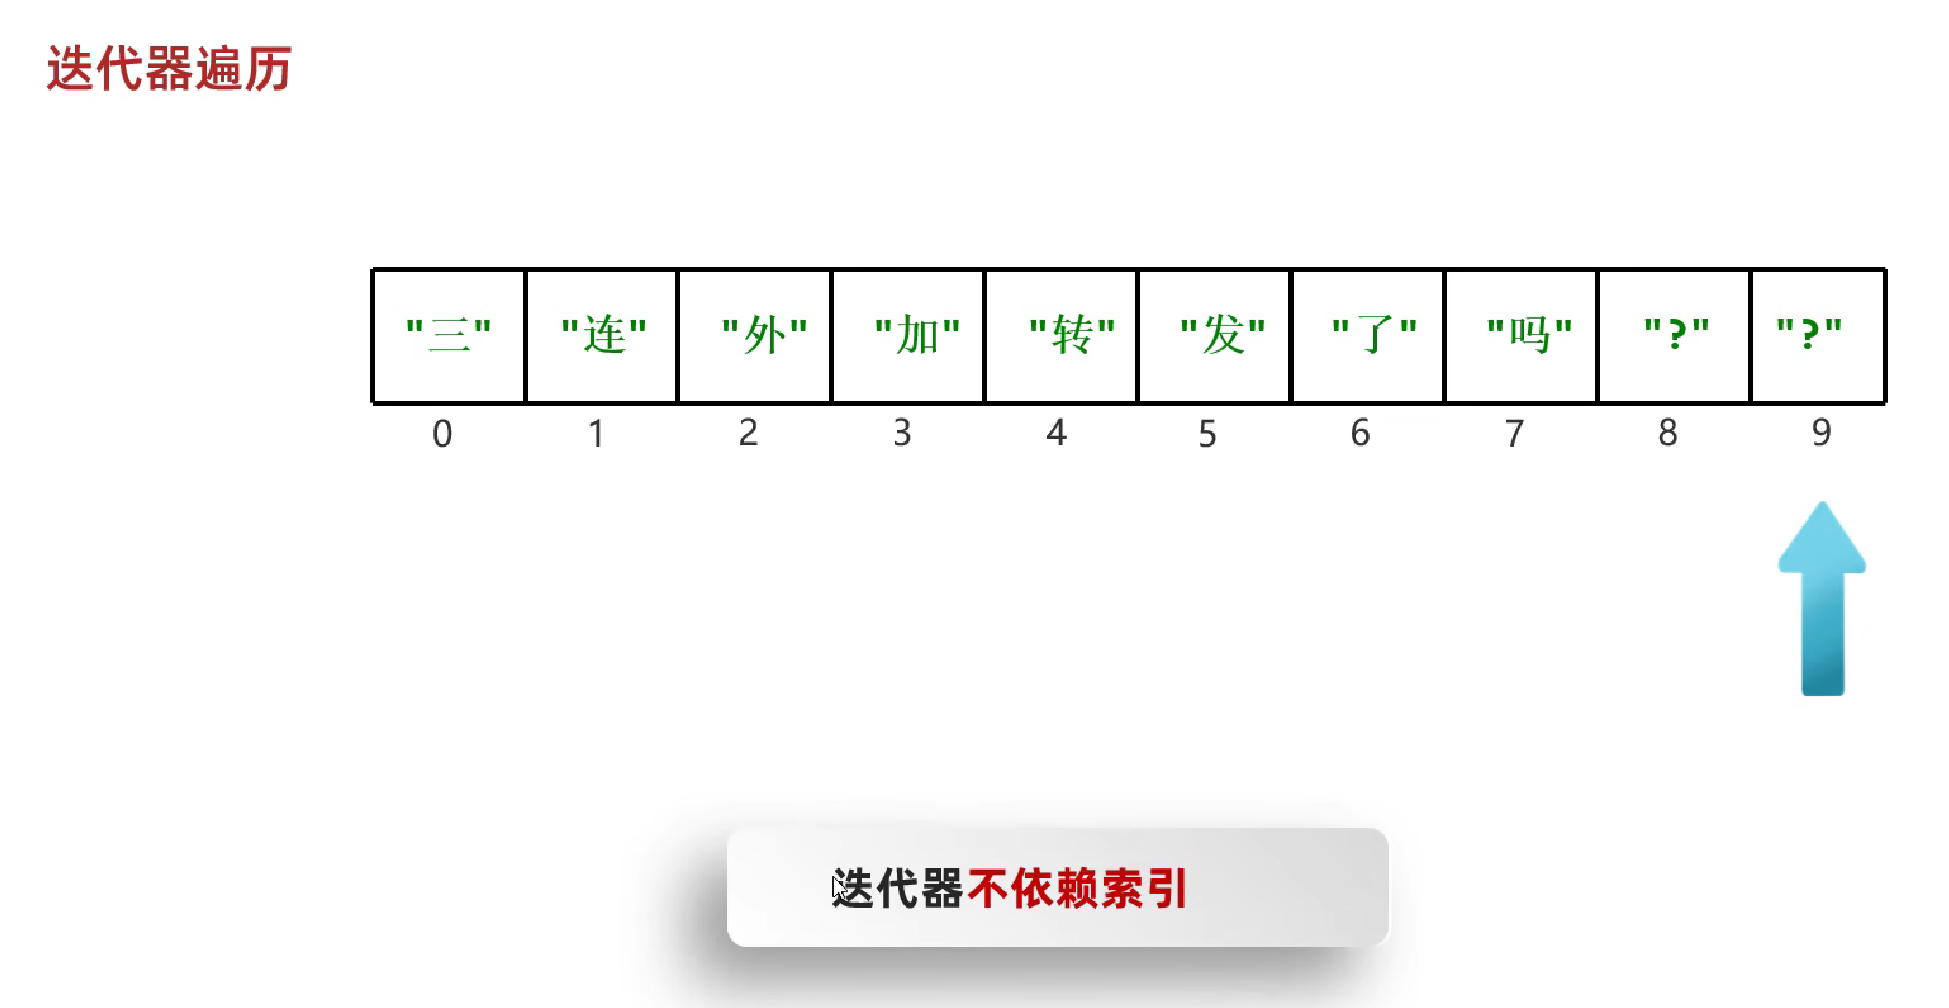
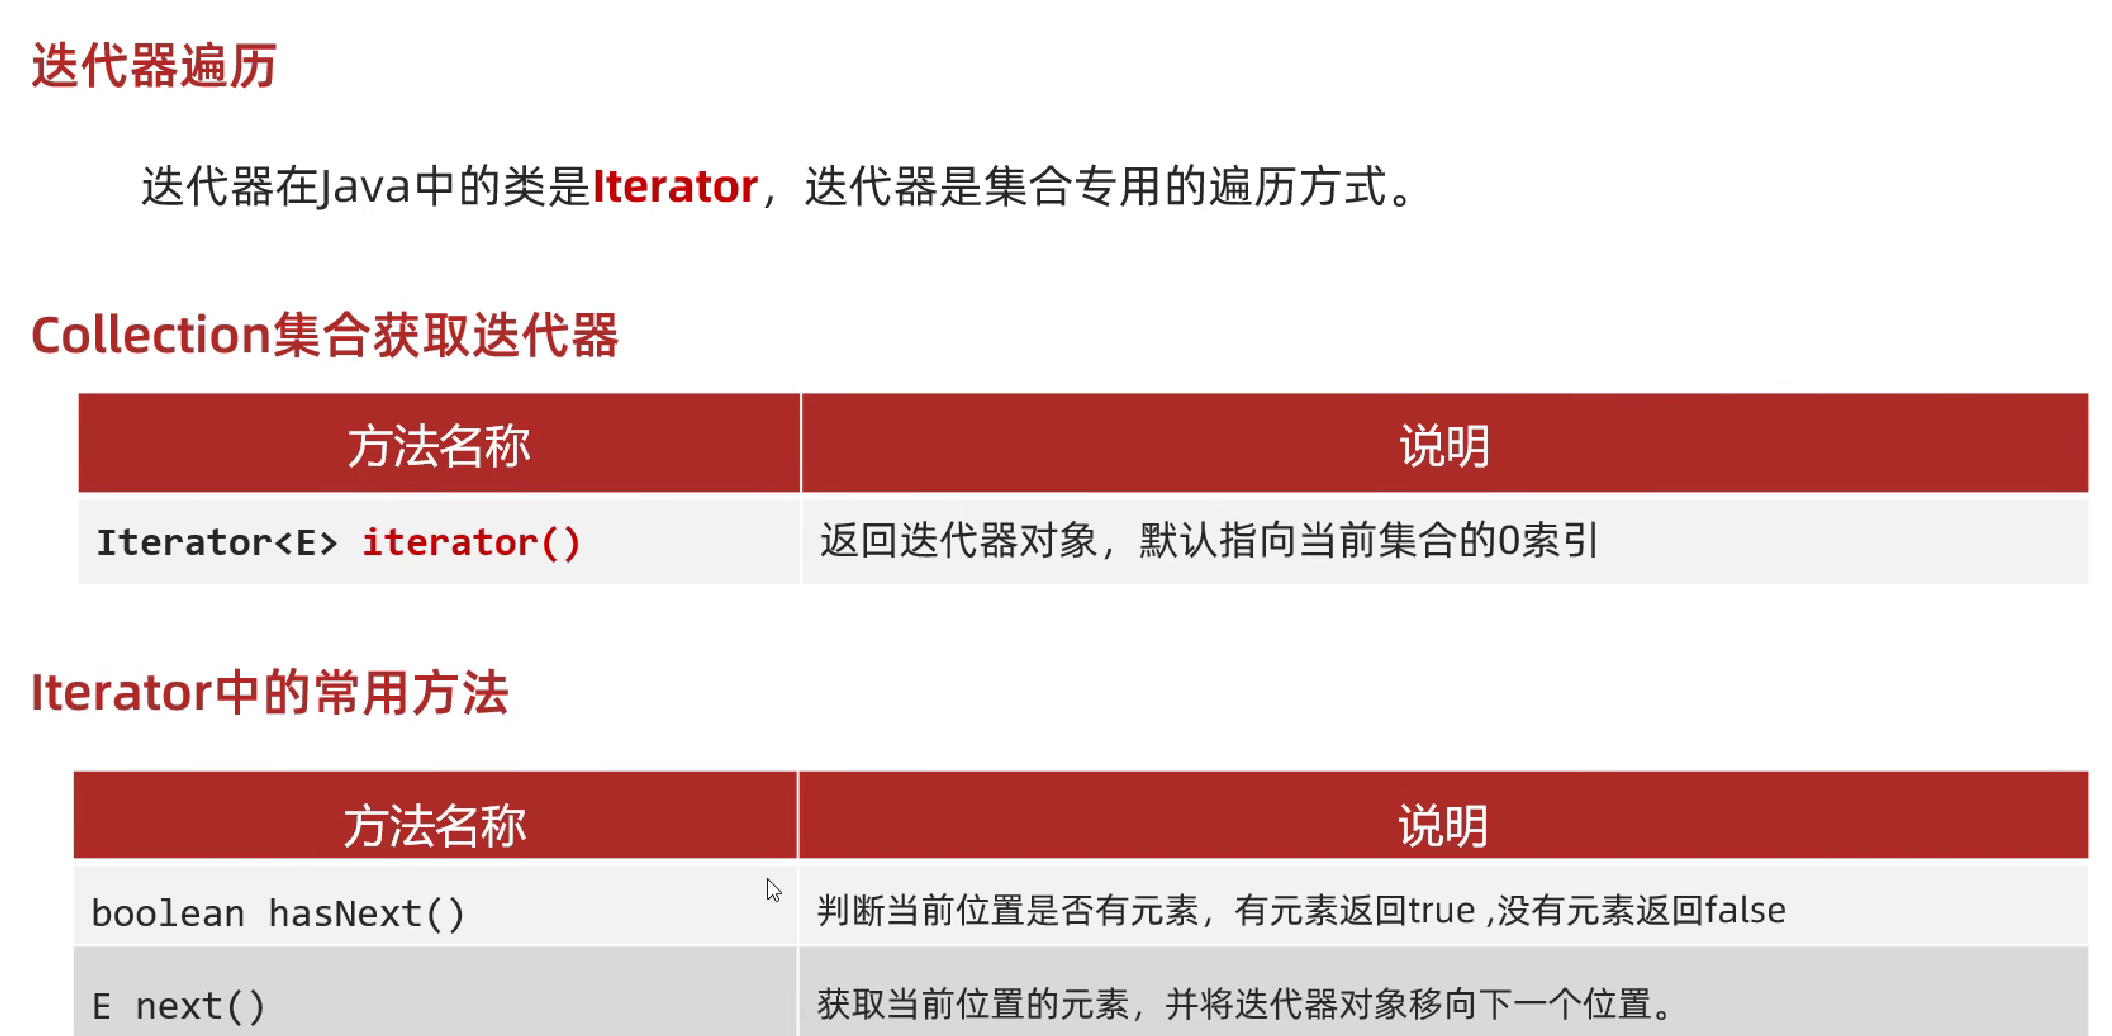
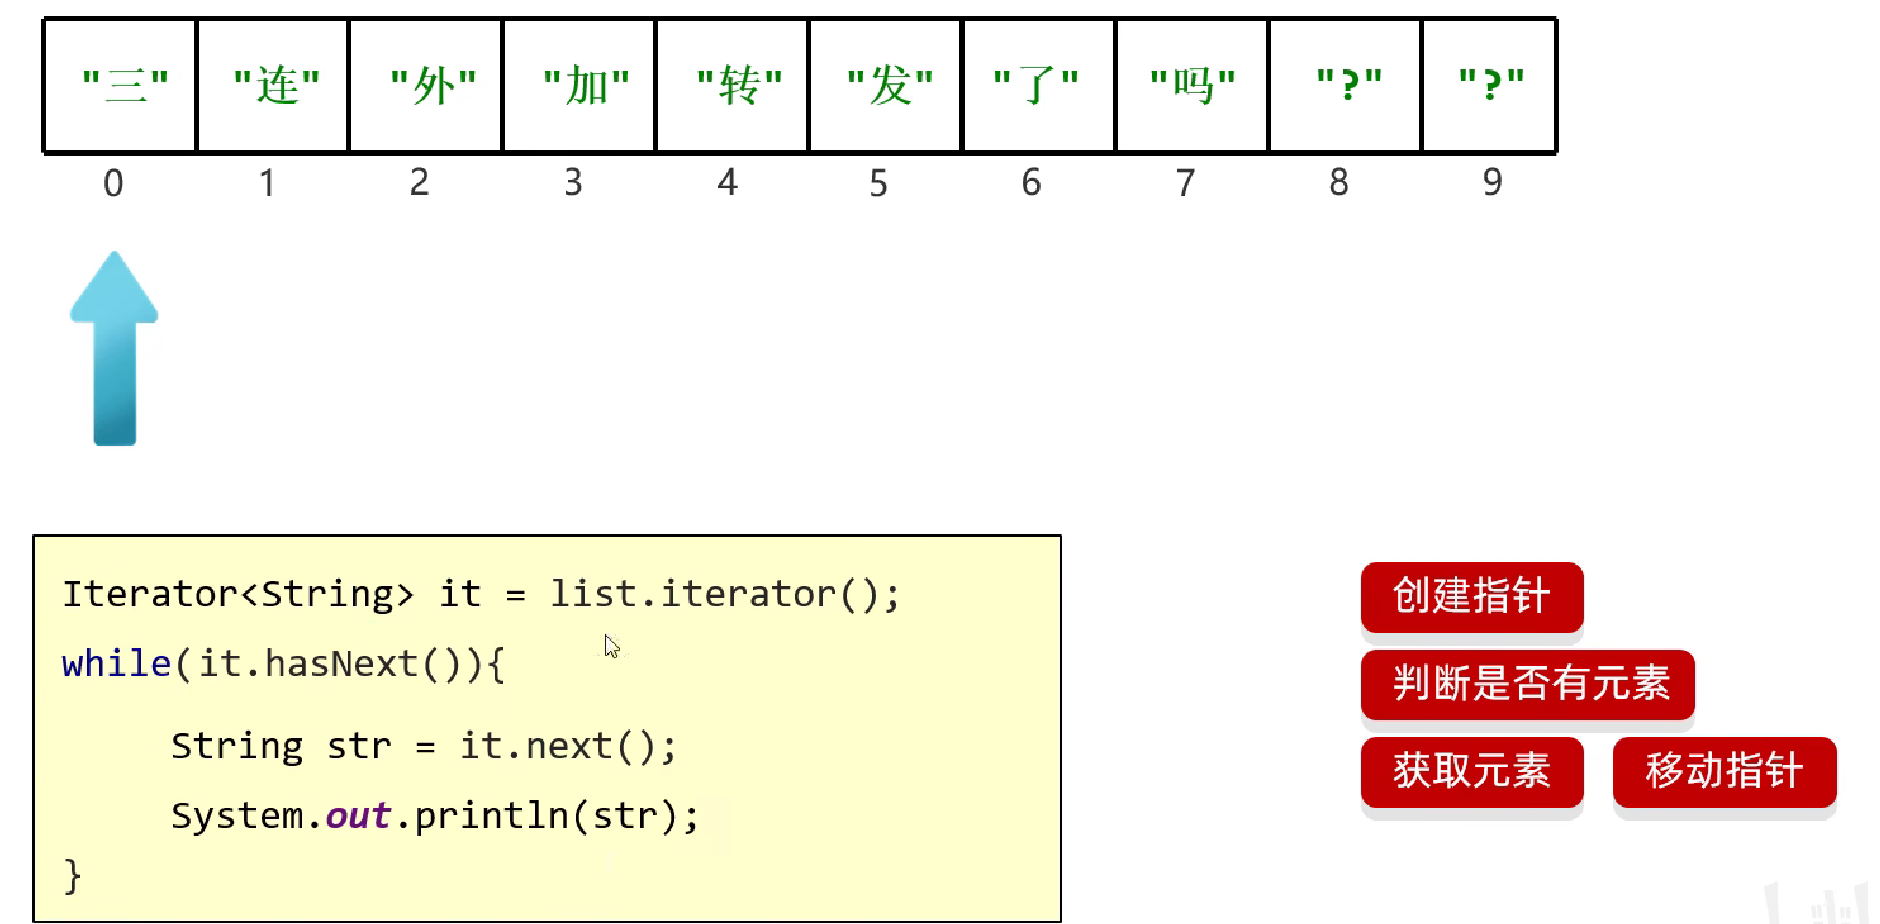
小练手(迭代器遍历):
package myCollection;

import java.util.ArrayList;
import java.util.Collection;
import java.util.Iterator;

public class collectionTest3 {
    public static void main(String[] args) {
        /*
            Collection系列集合三种通用的遍历方式:
                1.迭代器遍历
                2.增强for遍历
                3.lambda表达式遍历

            迭代器遍历相关的三个方法:
                    Iterator<E> iterator() :获取一个迭代器对象
                    boolean hasNext()      :判断当前指向的位置是否有元素
                    E next()               :获取当前指向的元素并移动指针
        */
        Collection<String> coll = new ArrayList<String>();

        coll.add("John");
        coll.add("Jane");
        coll.add("Jack");

        Iterator<String> it = coll.iterator();
        while(it.hasNext()){
            //next做两件事情,判断是否有元素,向后移动指针
            String str = it.next();
            System.out.println(str);
        }
    }
}
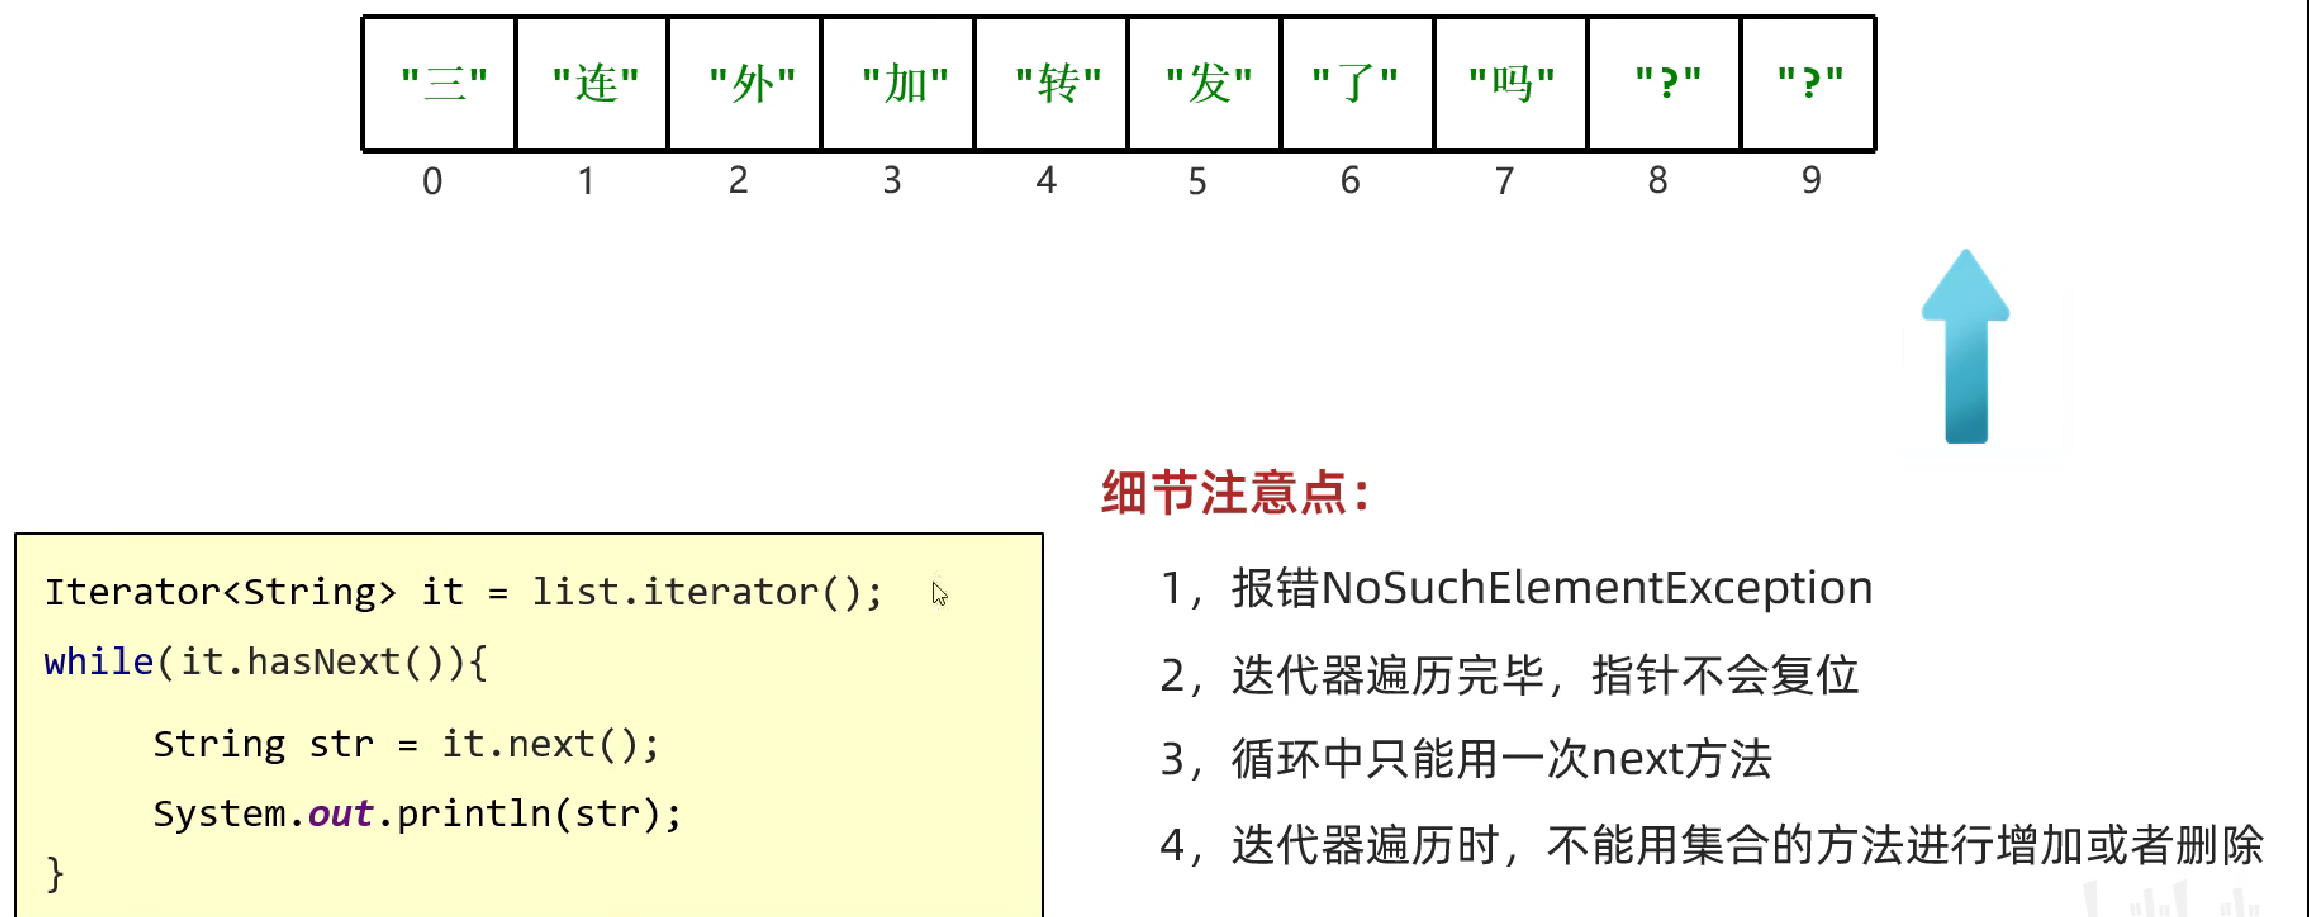
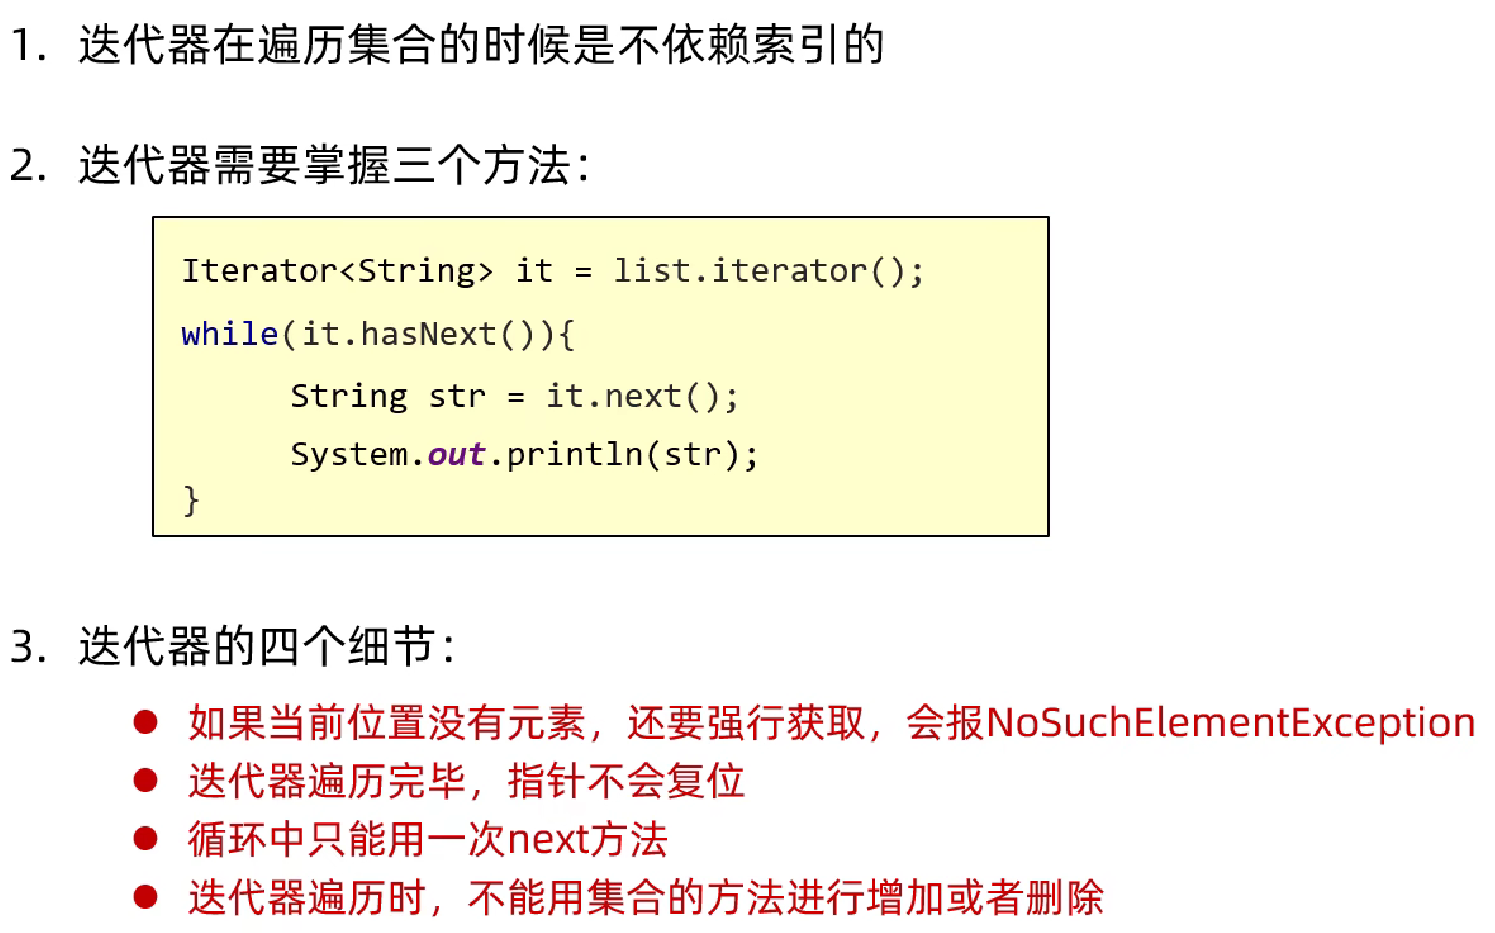
注意点:
| 报错 NoSuchElementException | 当指针已经移动到空值元素的时候时,再去使用it.next()则会报错 |
| 迭代器遍历完毕,指针不会复位 | 每一次遍历完之后,指针不会自动复位。所以,如果要多次遍历的话,需要重复遍历步骤。 |
| 循环中只能用一次 next 方法 | 如果在遍历循环中有n个指针的话,则表示遍历指针经过这一次循环之后,会移动n次。比如,若调用两次next方法,则指针会移动2次,若集合元素中为5个时,在最后一次循环中报错,导致获取空元素的next,故不能只用一次next方法。 |
| 迭代器遍历时,不能用集合的方法进行增加或者删除 | 在遍历时,不能用集合方法进行增加或删除,会发生报错。可以用迭代器的方法进行删除,但添加操作目前还不能实现 |
增强for遍历
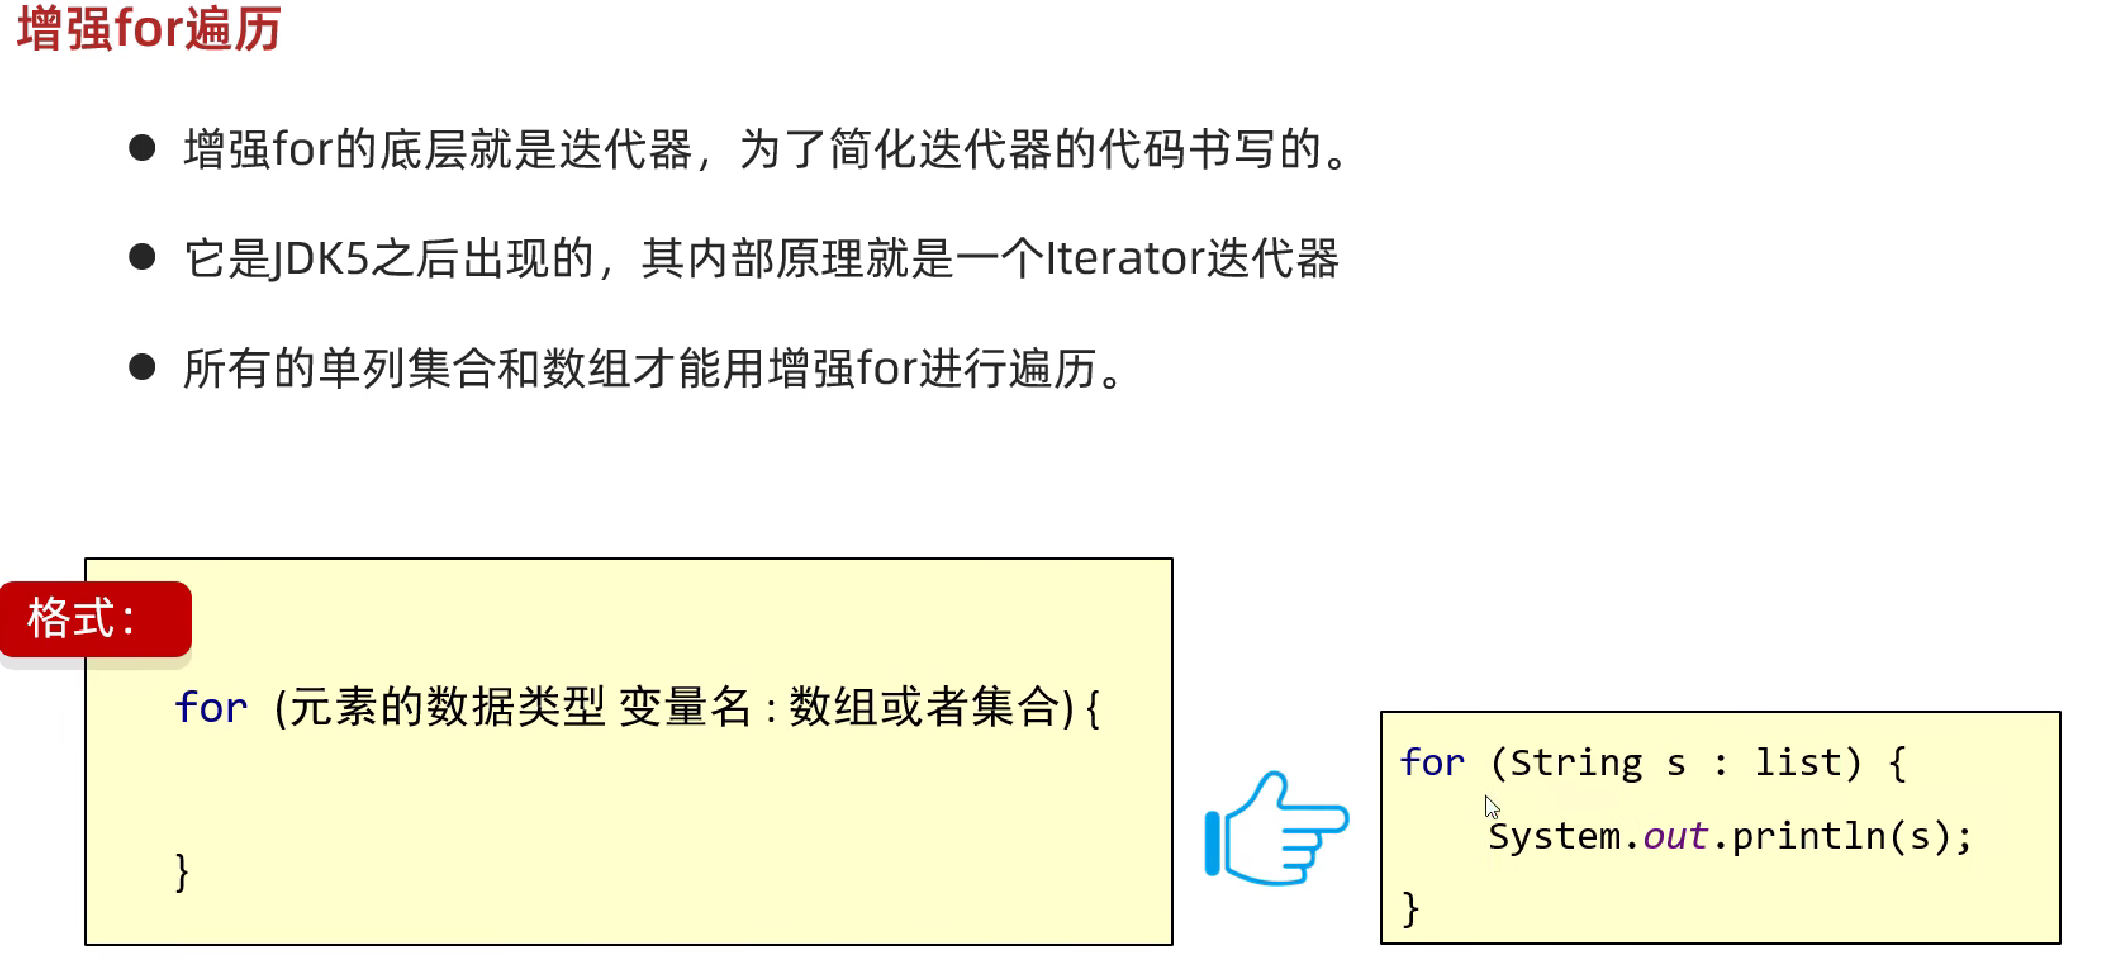
小练手(增强for遍历):
package myCollection;

import java.util.ArrayList;
import java.util.Collection;
import java.util.Iterator;

public class collectionTest4 {
    public static void main(String[] args) {
        /* Collection系列集合三种通用的遍历方式:
            1.迭代器遍历
            2.增强for遍历
            3.lambda表达式遍历

            增强for格式:
                for(数据类型 变量名: 集合/数组){

                }
           */
        Collection<String> coll = new ArrayList<String>();

        coll.add("John");
        coll.add("Jane");
        coll.add("Jack");

        for (String s : coll) {
            //s是第三方变量,用来依次表示集合中的每一个元素值
            System.out.println(s);
        }
    }
}
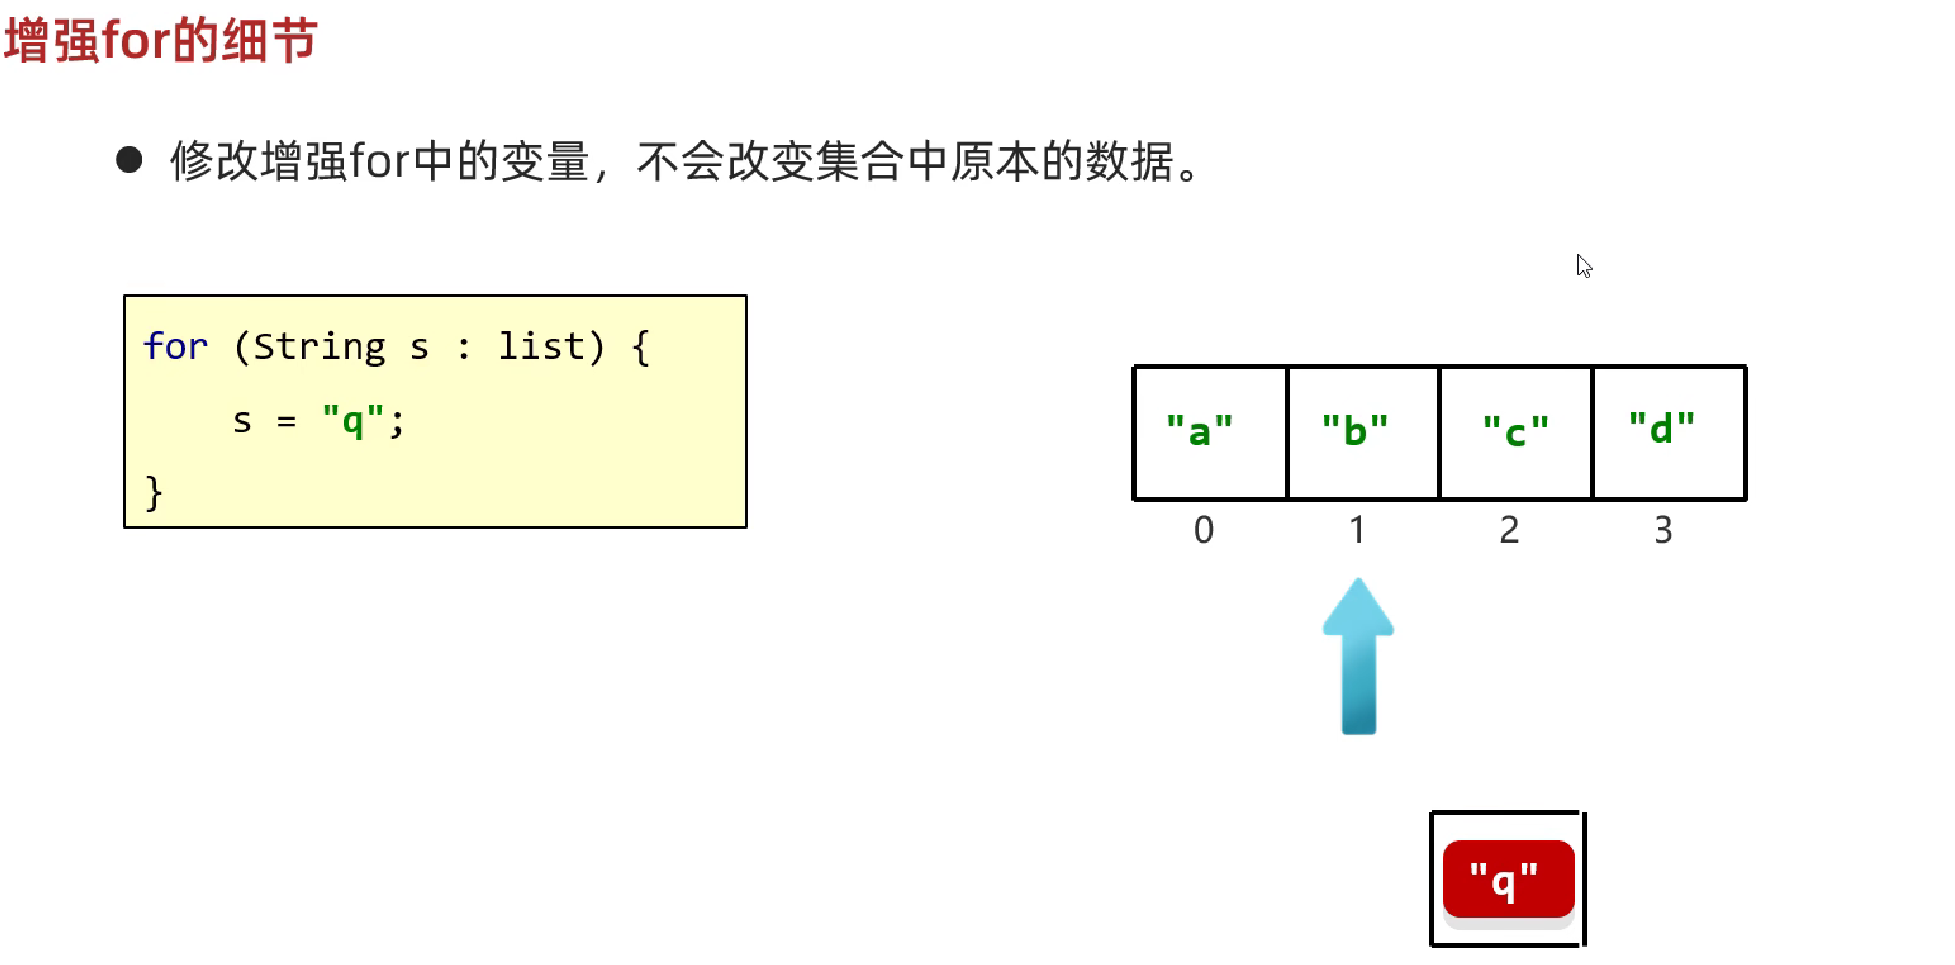
Lambda表达式遍历
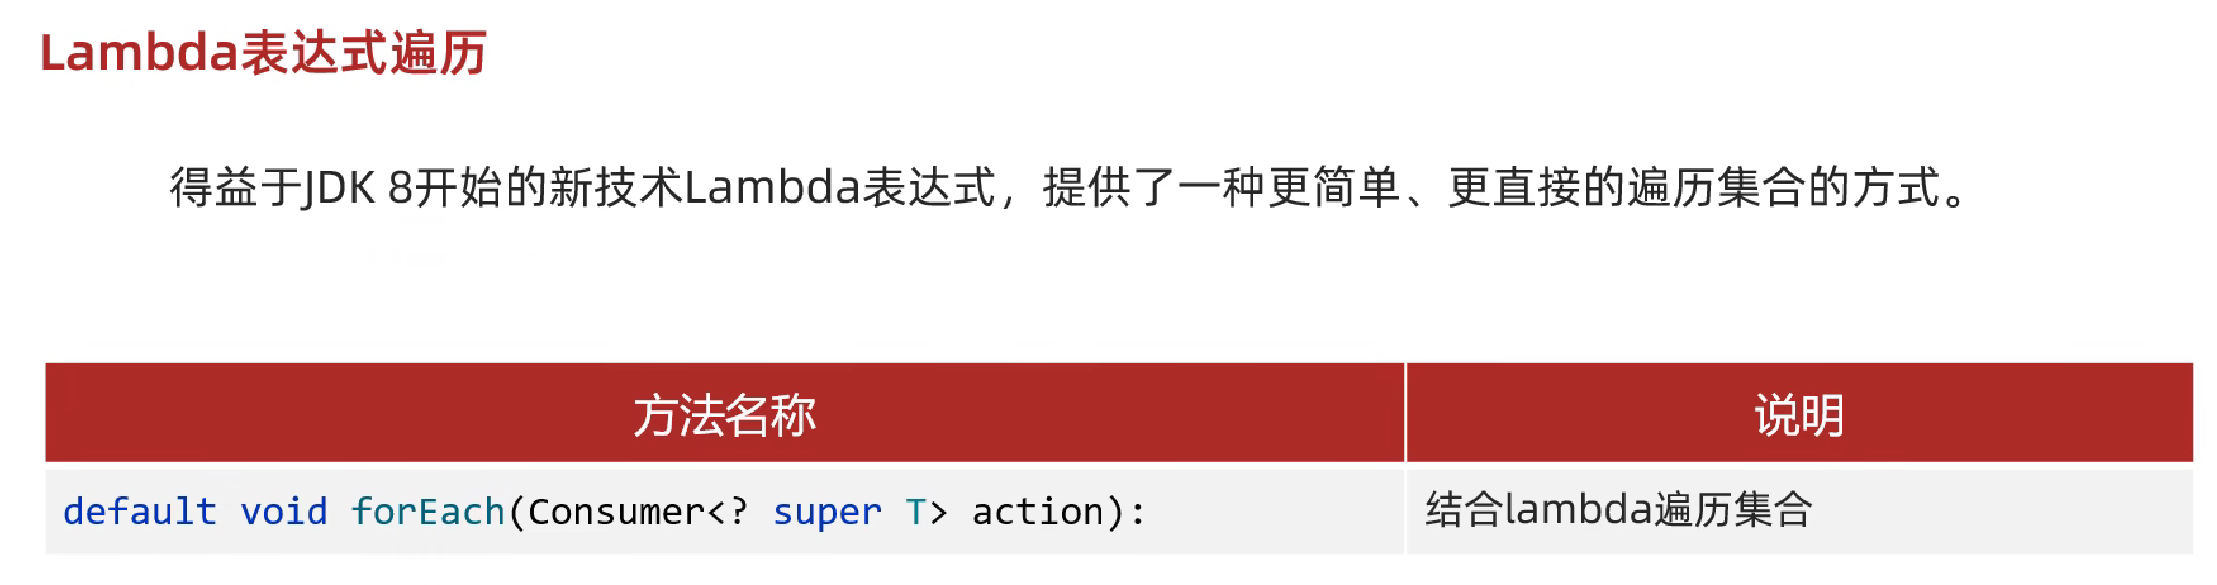
小练手(Lambda表达式遍历):
package myCollection;

import java.util.ArrayList;
import java.util.Collection;
import java.util.function.Consumer;

public class collectionTest5 {
    public static void main(String[] args) {
        /* Collection系列集合三种通用的遍历方式:
            1.迭代器遍历
            2.增强for遍历
            3.lambda表达式遍历

            lambda表达式遍历:
                    default void forEach(Consumer<? super T> action):
        */
        Collection<String> coll = new ArrayList<String>();

        coll.add("John");
        coll.add("Jane");
        coll.add("Jack");

        //匿名内部类实现
        coll.forEach(new Consumer<String>() {

            @Override
            public void accept(String s) {
                System.out.println(s);
            }
        });

        System.out.println("------------");
        //Lambda表达式实现
        coll.forEach(s ->   System.out.println(s));
    }
}
List集合
List特有方法
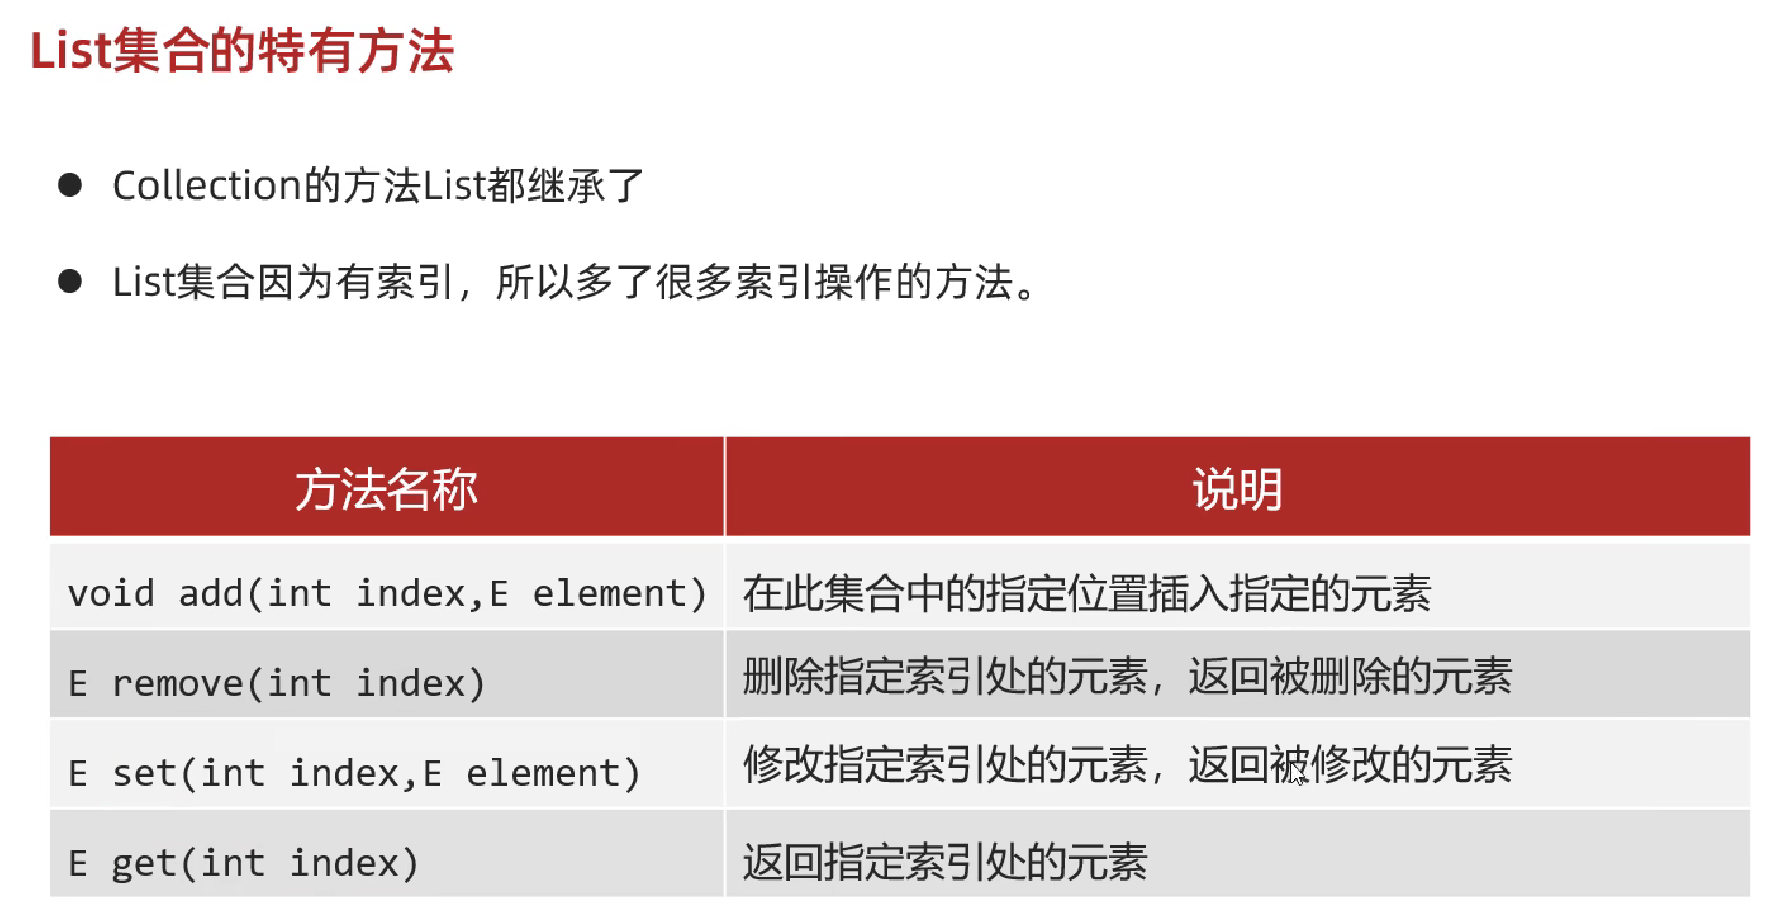
小练手(List集合方法实现):
package mylist;

import java.util.ArrayList;
import java.util.List;

public class test1 {
    public static void main(String[] args) {
        /*
        * List系列集合独有的方法:
            void add(int index,E element) 在此集合中的指定位置插入指定的元素
            E remove(int index) 删除指定索引处的元素,返回被删除的元素
            E set(int index,E element) 修改指定索引处的元素,返回被修改的元素
            E get(int index) 返回指定索引处的元素
        */
        List<String> list = new ArrayList<String>();
        list.add("aaa");
        list.add("bbb");
        list.add("ccc");

        //add(int index,E element) 在此集合中的指定位置插入指定的元素
        list.add(1,"QQQ");
        System.out.println(list);

        //E remove(int index) 删除指定索引处的元素,返回被删除的元素
        String str1 = list.remove(0);
        System.out.println(str1);
        System.out.println(list);

        //E set(int index,E element) 修改指定索引处的元素,返回被修改的元素
        String str2 = list.set(0, "ddd");
        System.out.println(str2);
        System.out.println(list);

        //E get(int index) 返回指定索引处的元素
        System.out.println(list.get(0));
    }
}
小练手(List集合删除方法细节):
package mylist;

import java.util.ArrayList;
import java.util.List;

public class test2 {
    public static void main(String[] args) {
        List<Integer> list = new ArrayList<Integer>();
        list.add(1);
        list.add(2);
        list.add(3);
        list.add(4);

        //E remove(int index) 删除指定索引处的元素,返回被删除的元素
        // 则此时删除的是 1 这个元素,还是 1 索引上的元素?
        // 因为在调用方法的时候,如果方法出现了重载现象
        // 优先调用,实参跟形参类型一致的那个方法。
        list.remove(1);
        System.out.println(list);

        //手动装箱,手动把基本数据类型的1变为Integer类型
        Integer i = Integer.valueOf(3);
        list.remove(i);
        System.out.println(list);
    }
}
List遍历方式
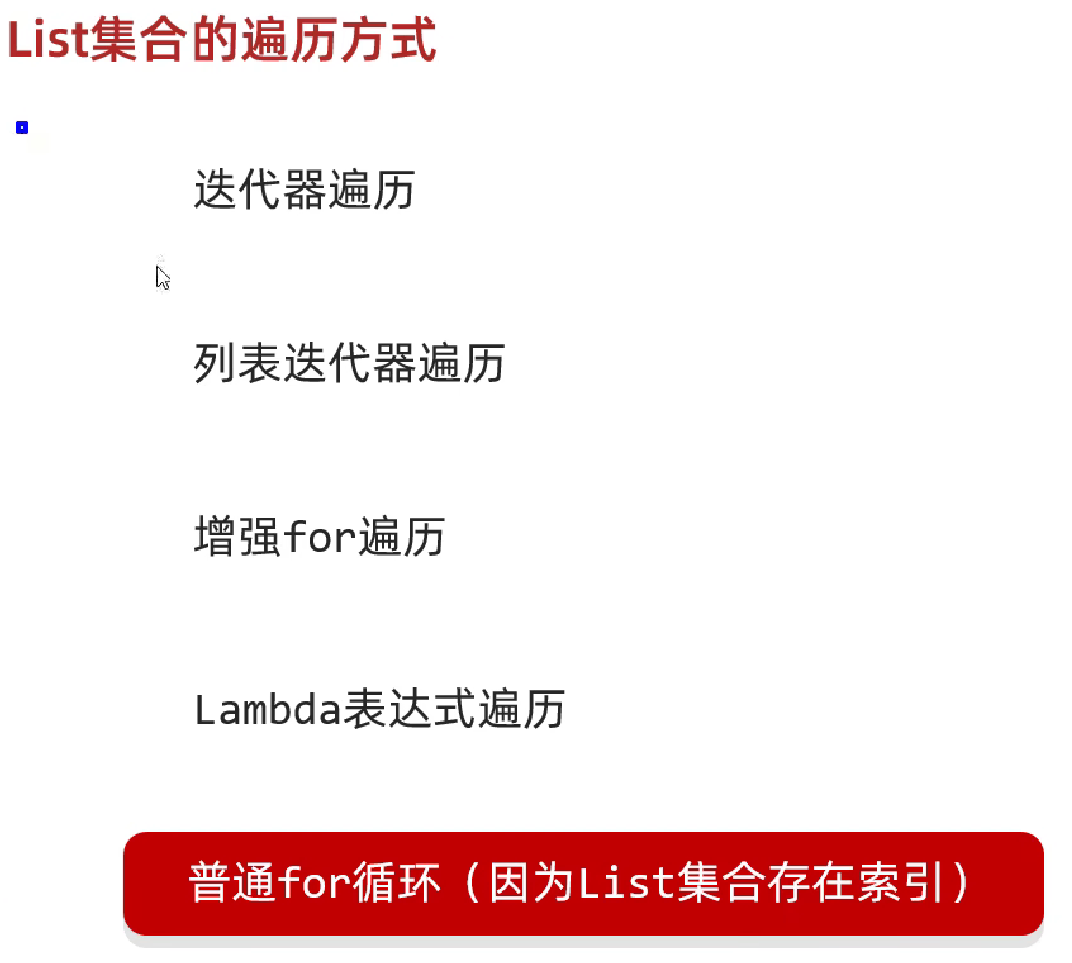
列表迭代器遍历
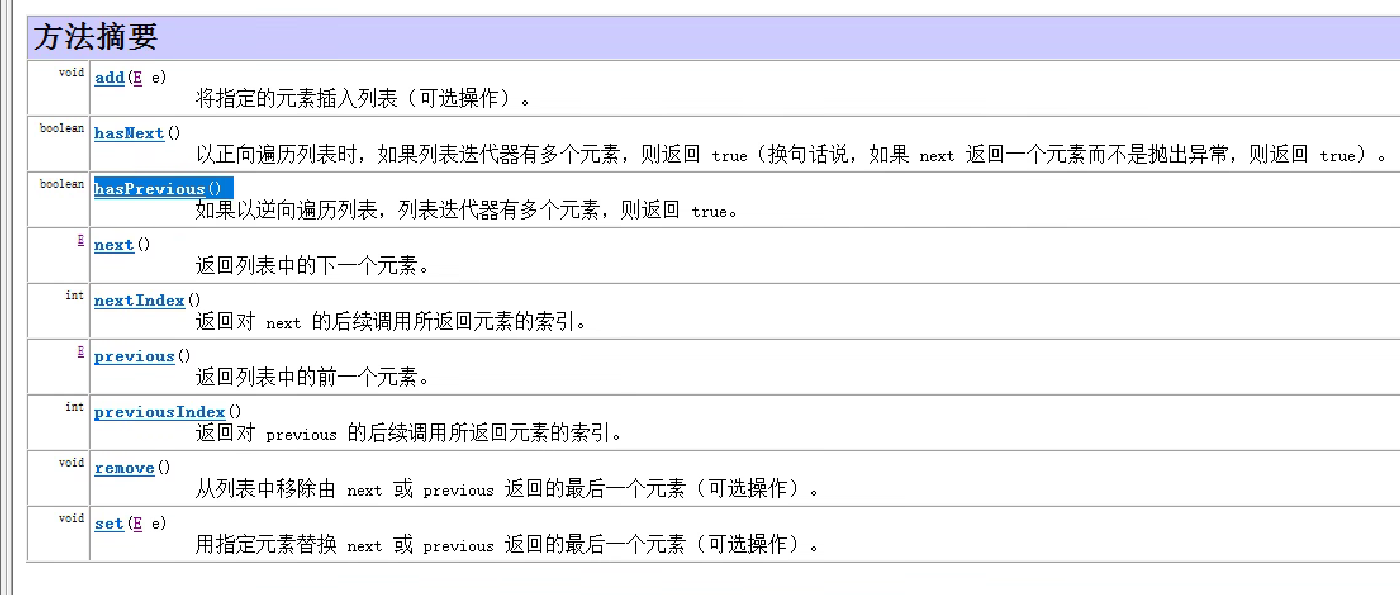
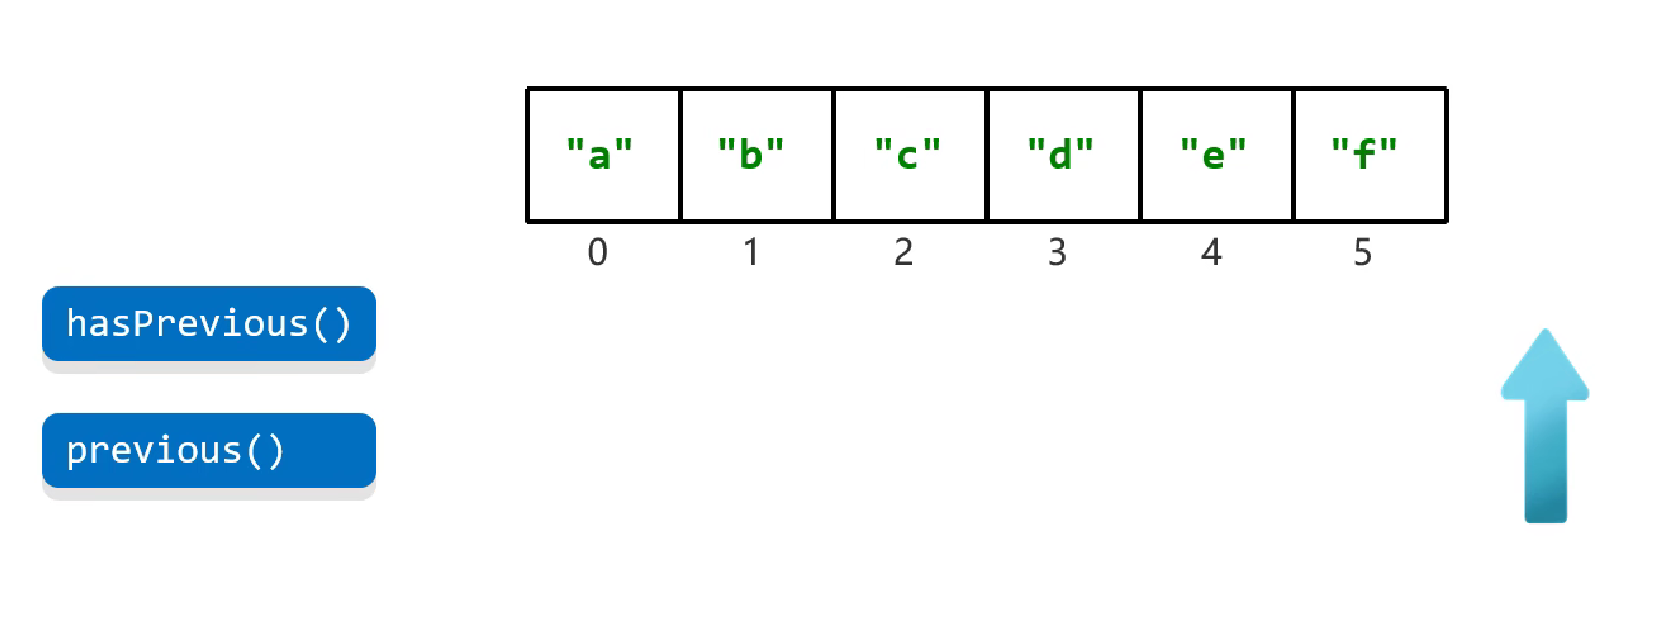
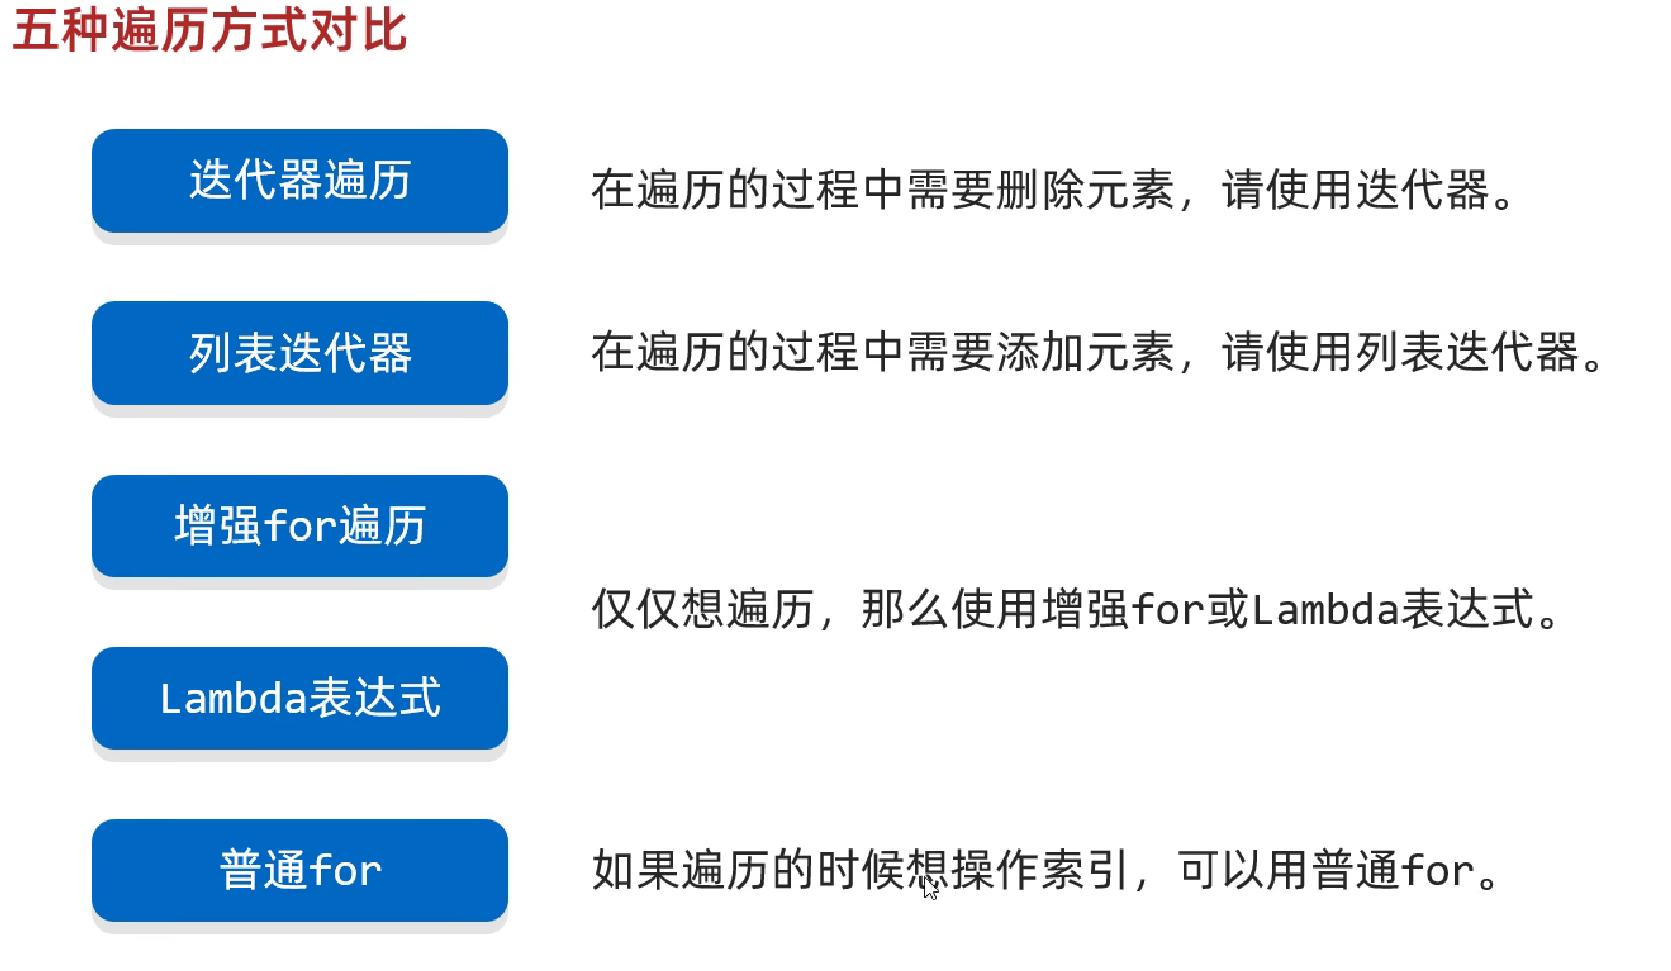
小练手(五种遍历方法实现):
package mylist;

import java.util.ArrayList;
import java.util.Iterator;
import java.util.List;
import java.util.ListIterator;
import java.util.function.Consumer;

public class test3 {
    public static void main(String[] args) {
        /**
         * List遍历
         * 1、迭代器遍历
         * 2、列表迭代遍历
         * 3、增强for遍历
         * 4、Lambda表达式遍历
         * 5、普通for遍历
         * */
        List<String> list = new ArrayList<String>();
        list.add("aaa");
        list.add("bbb");
        list.add("ccc");
        //迭代器遍历
        System.out.println("迭代器遍历");
        Iterator<String> it = list.iterator();
        while (it.hasNext()) {
            System.out.println(it.next());
        }
        //增强for遍历
        System.out.println("增强for遍历");
        for (String s : list) {
            System.out.println(s);
        }
        //Lambda表达式遍历
        System.out.println("Lambda表达式遍历");
        list.forEach( s->System.out.println(s));
        //普通for遍历,借助索引
        System.out.println("普通for遍历");
        for (int i = 0; i < list.size(); i++) {
            System.out.println(list.get(i));
        }
        //列表迭代遍历,可以在遍历的过程中增加元素
        System.out.println("列表迭代遍历");
        ListIterator<String> li = list.listIterator();
        while (li.hasNext()) {
            String s = li.next();
            if (s.equals("bbb")) {
                li.add("QQQ");
            }
            System.out.println(s);
        }
    }
}
数据结构(栈、队列、数组、链表)
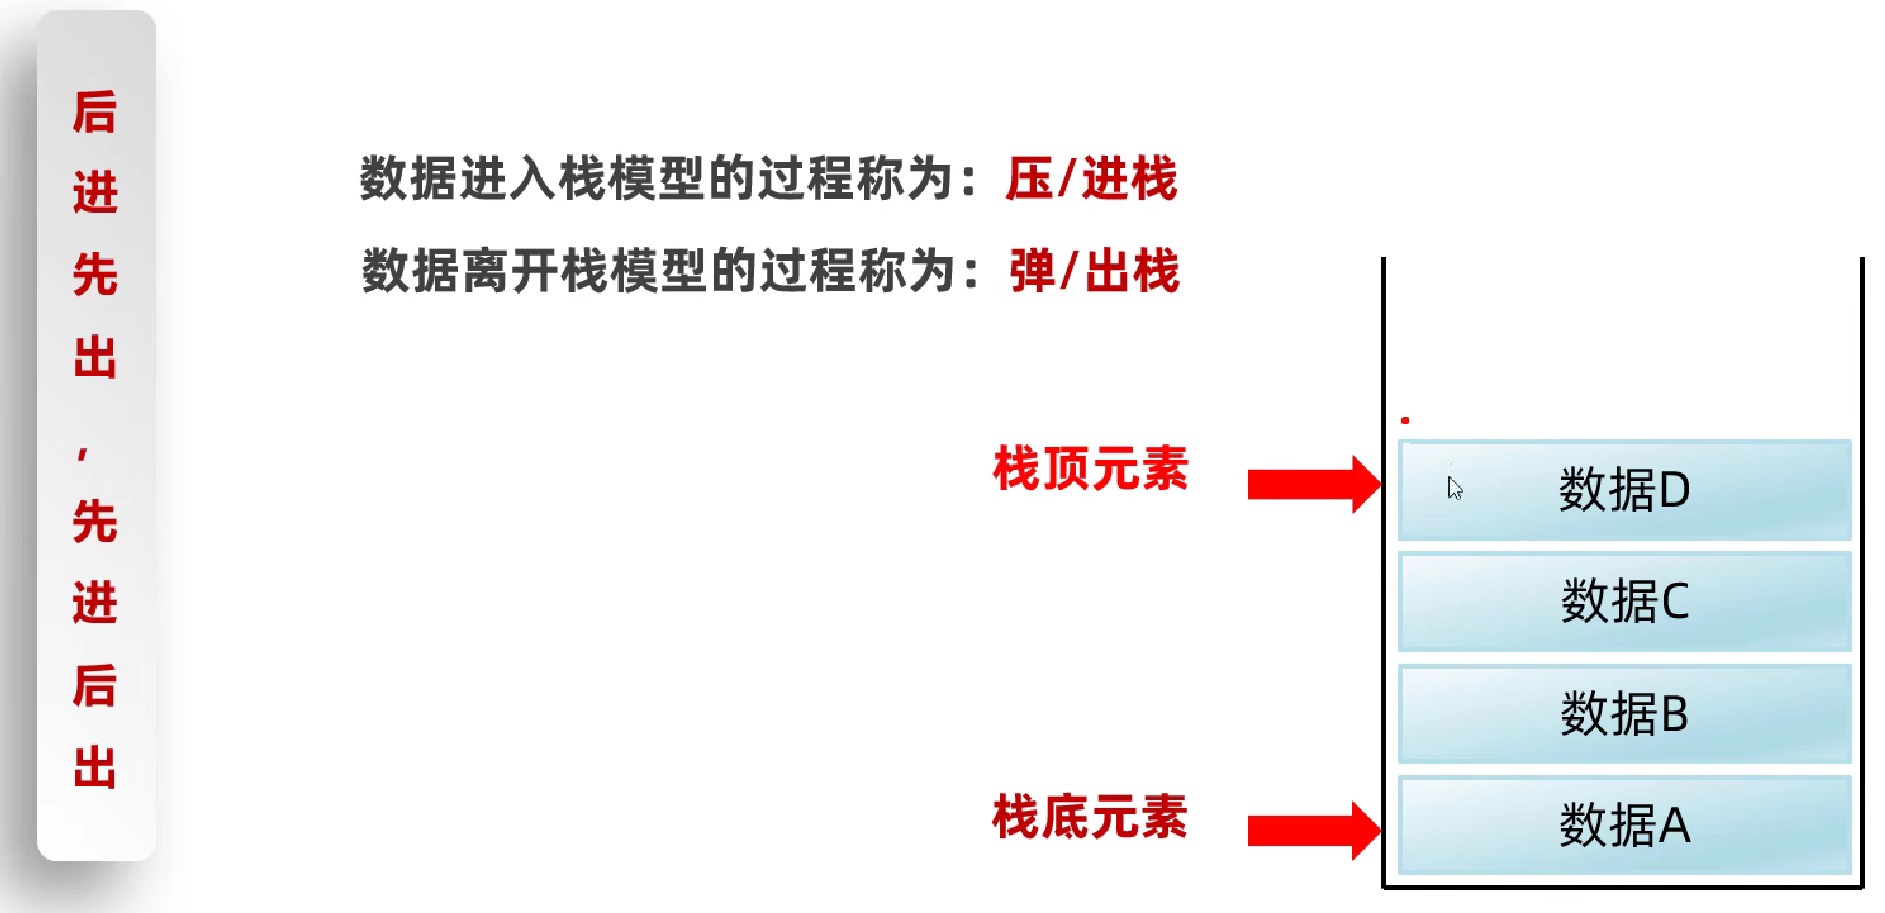
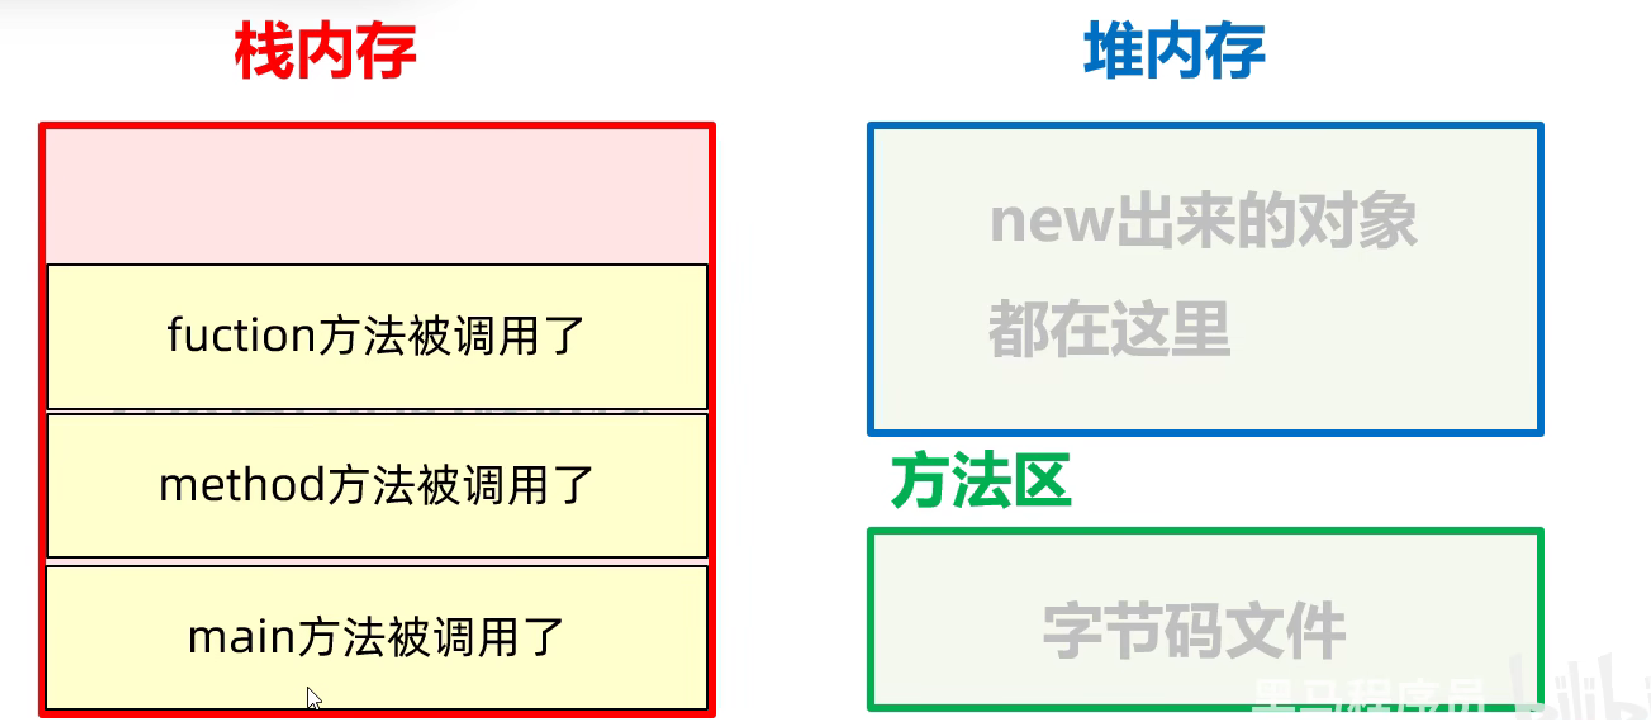
栈
队列
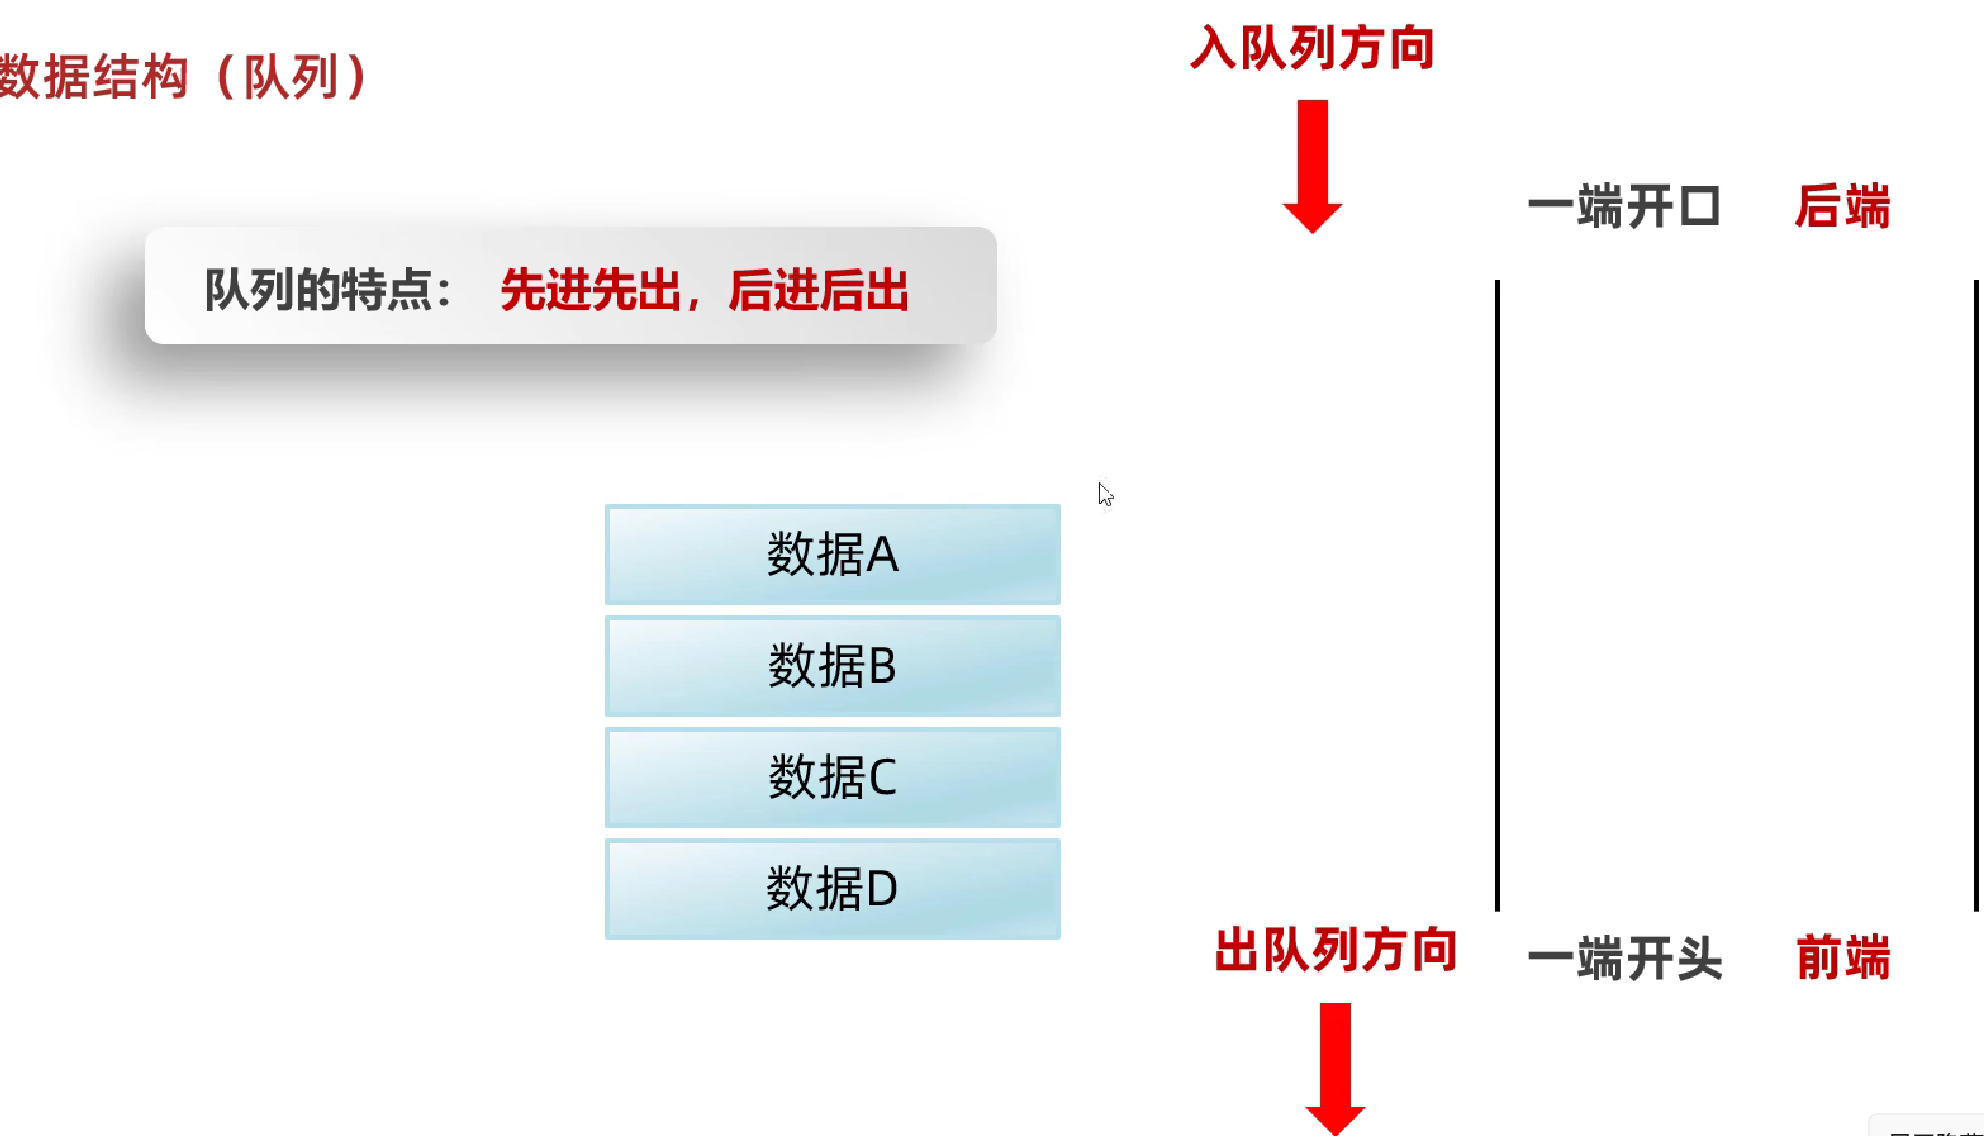
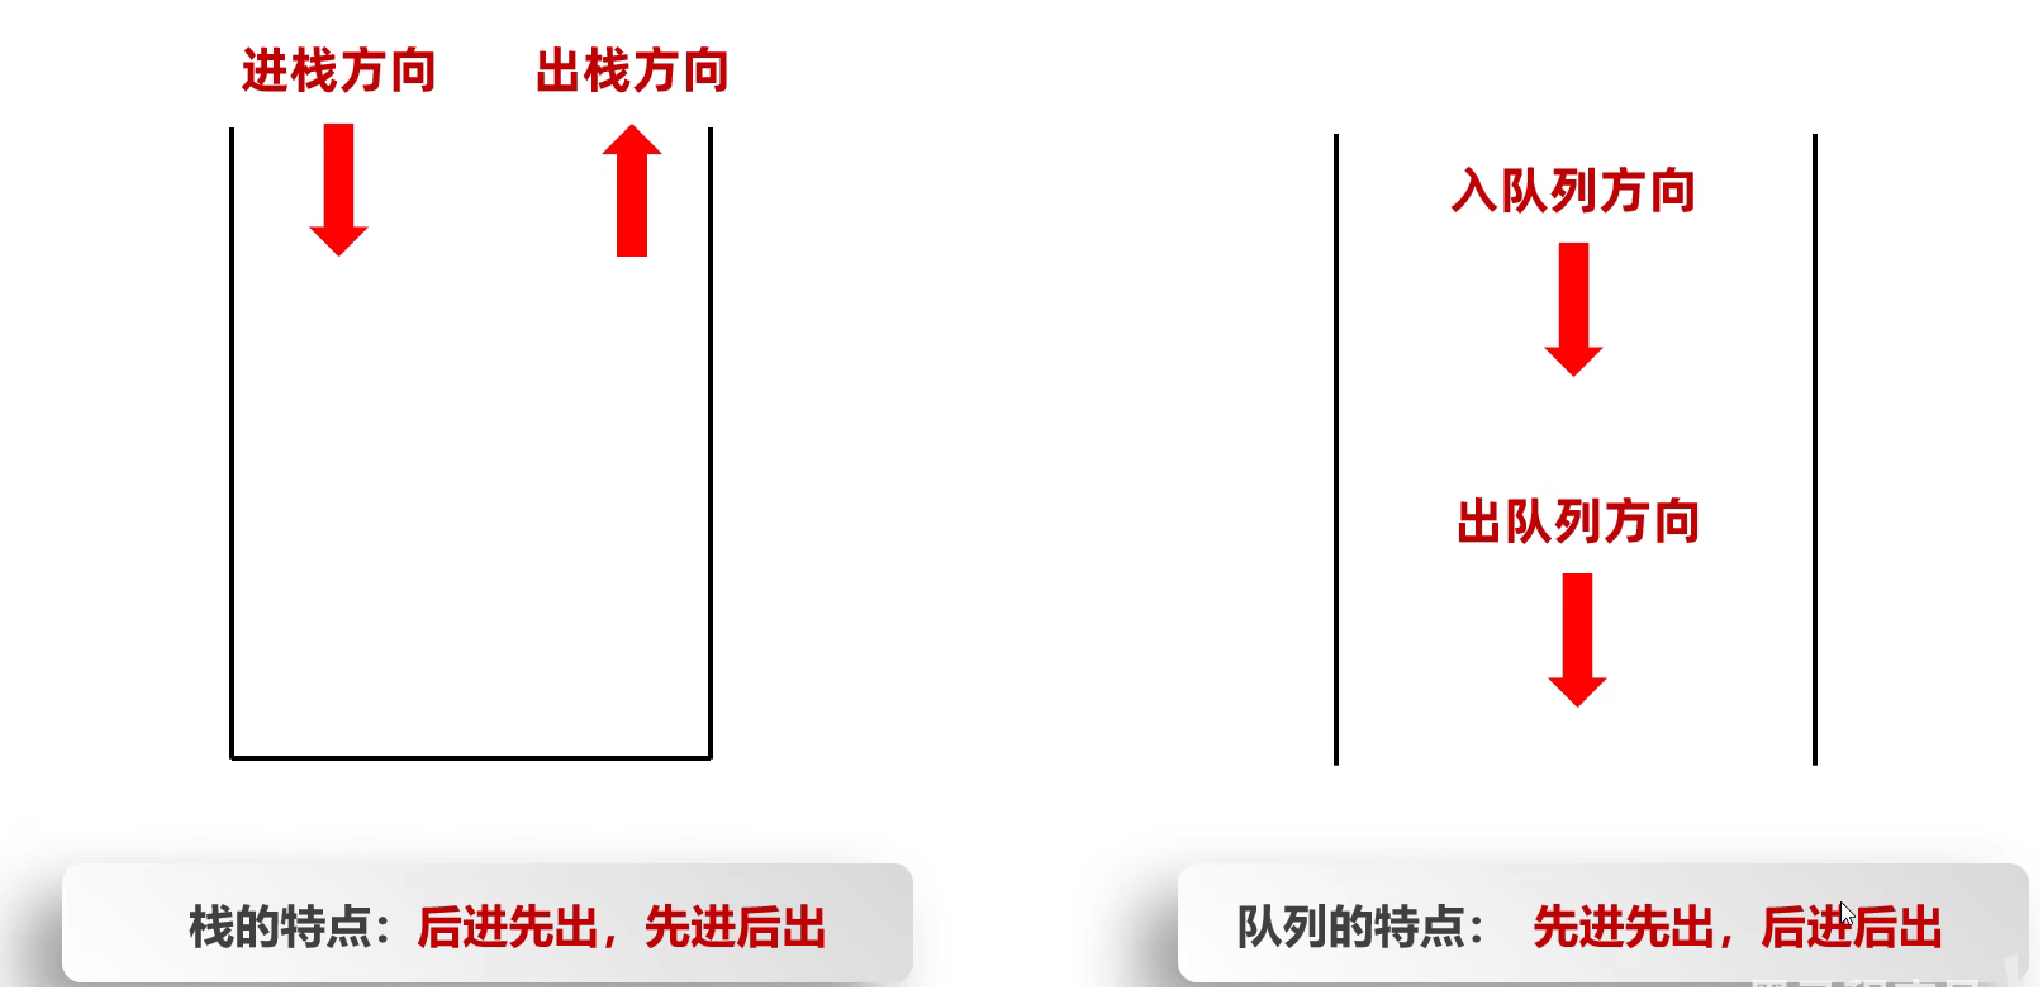
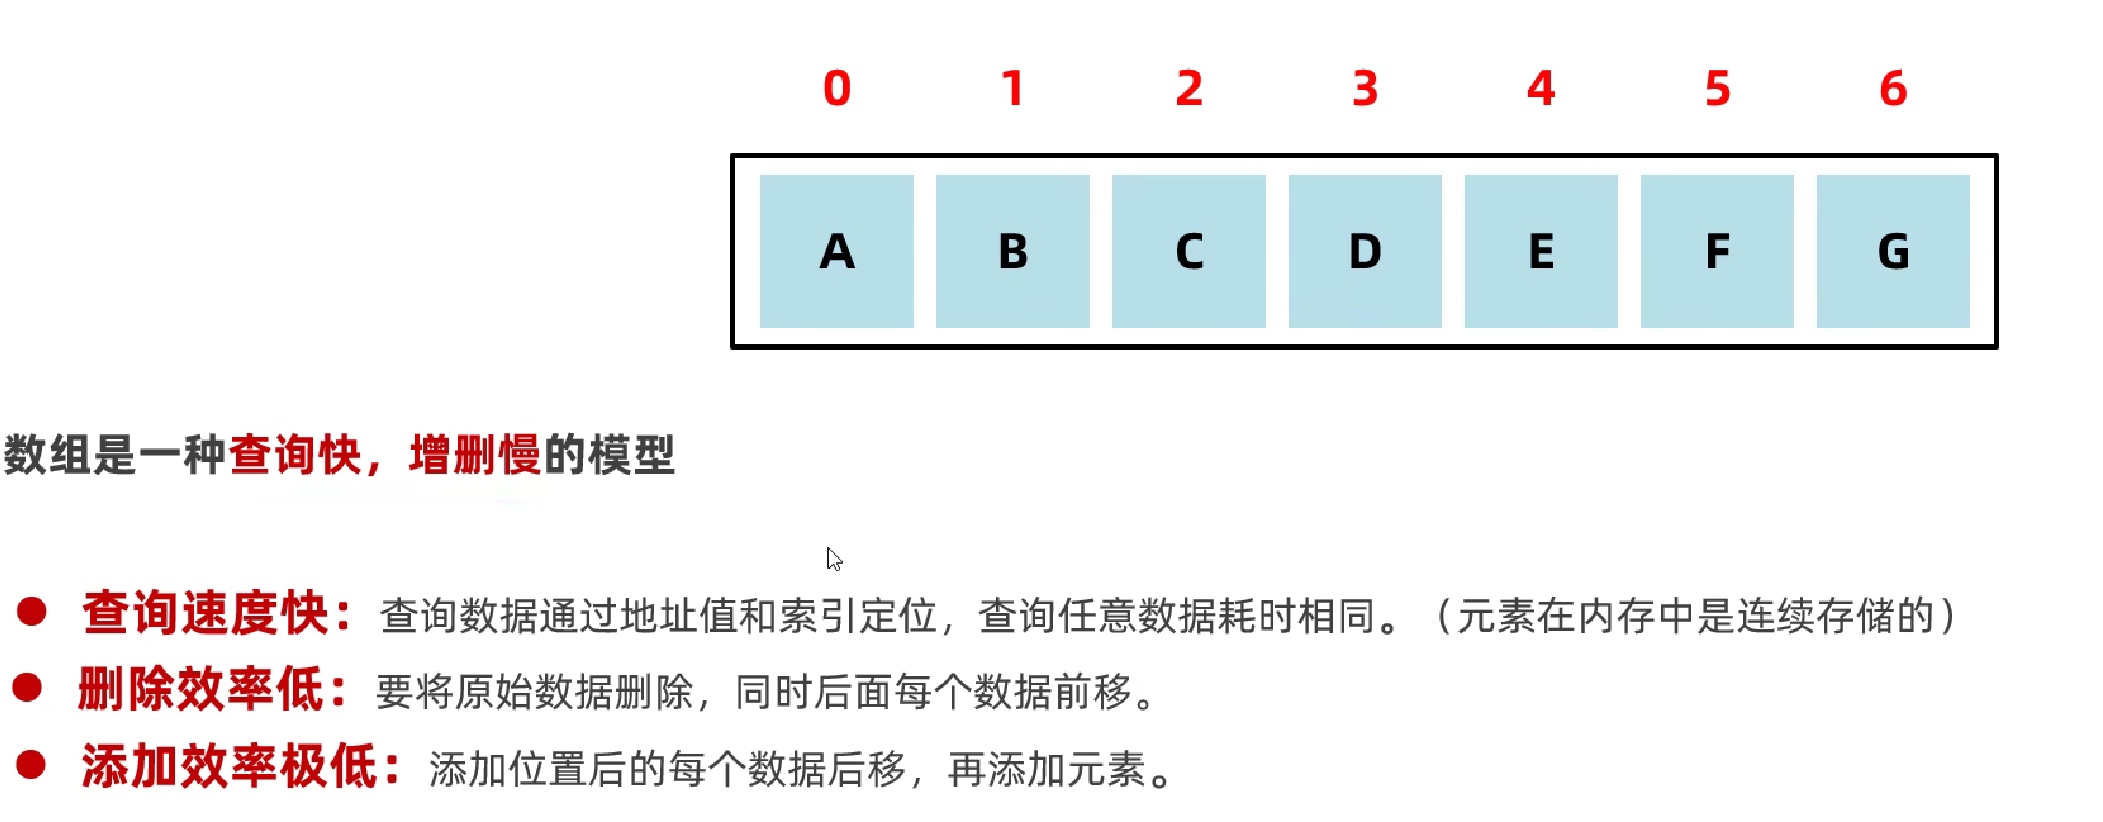
数组
链表
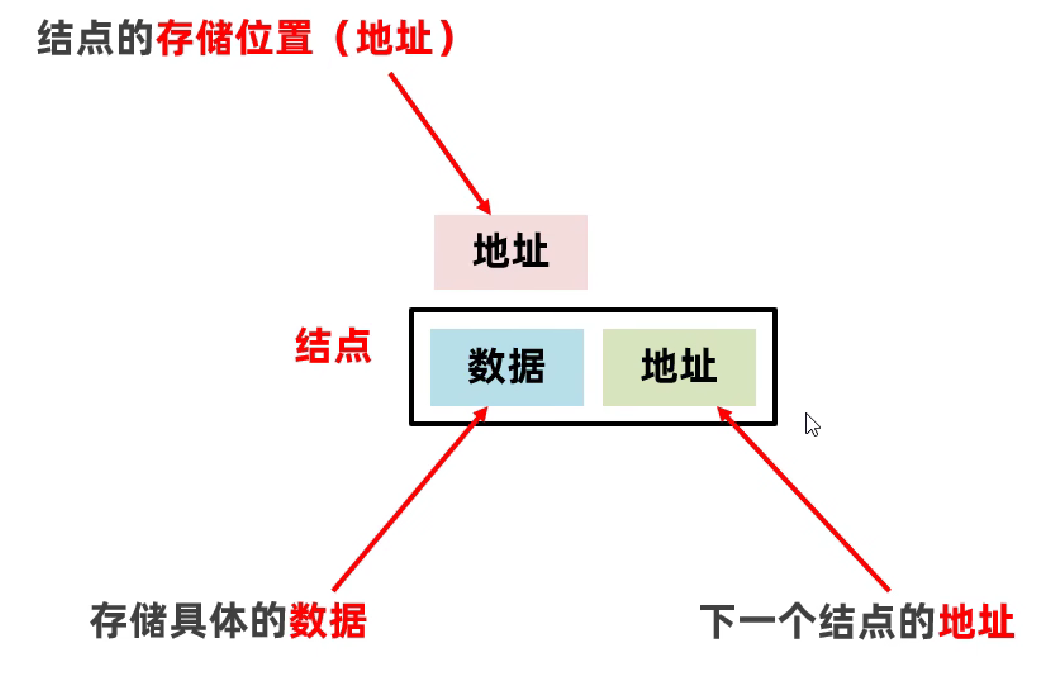
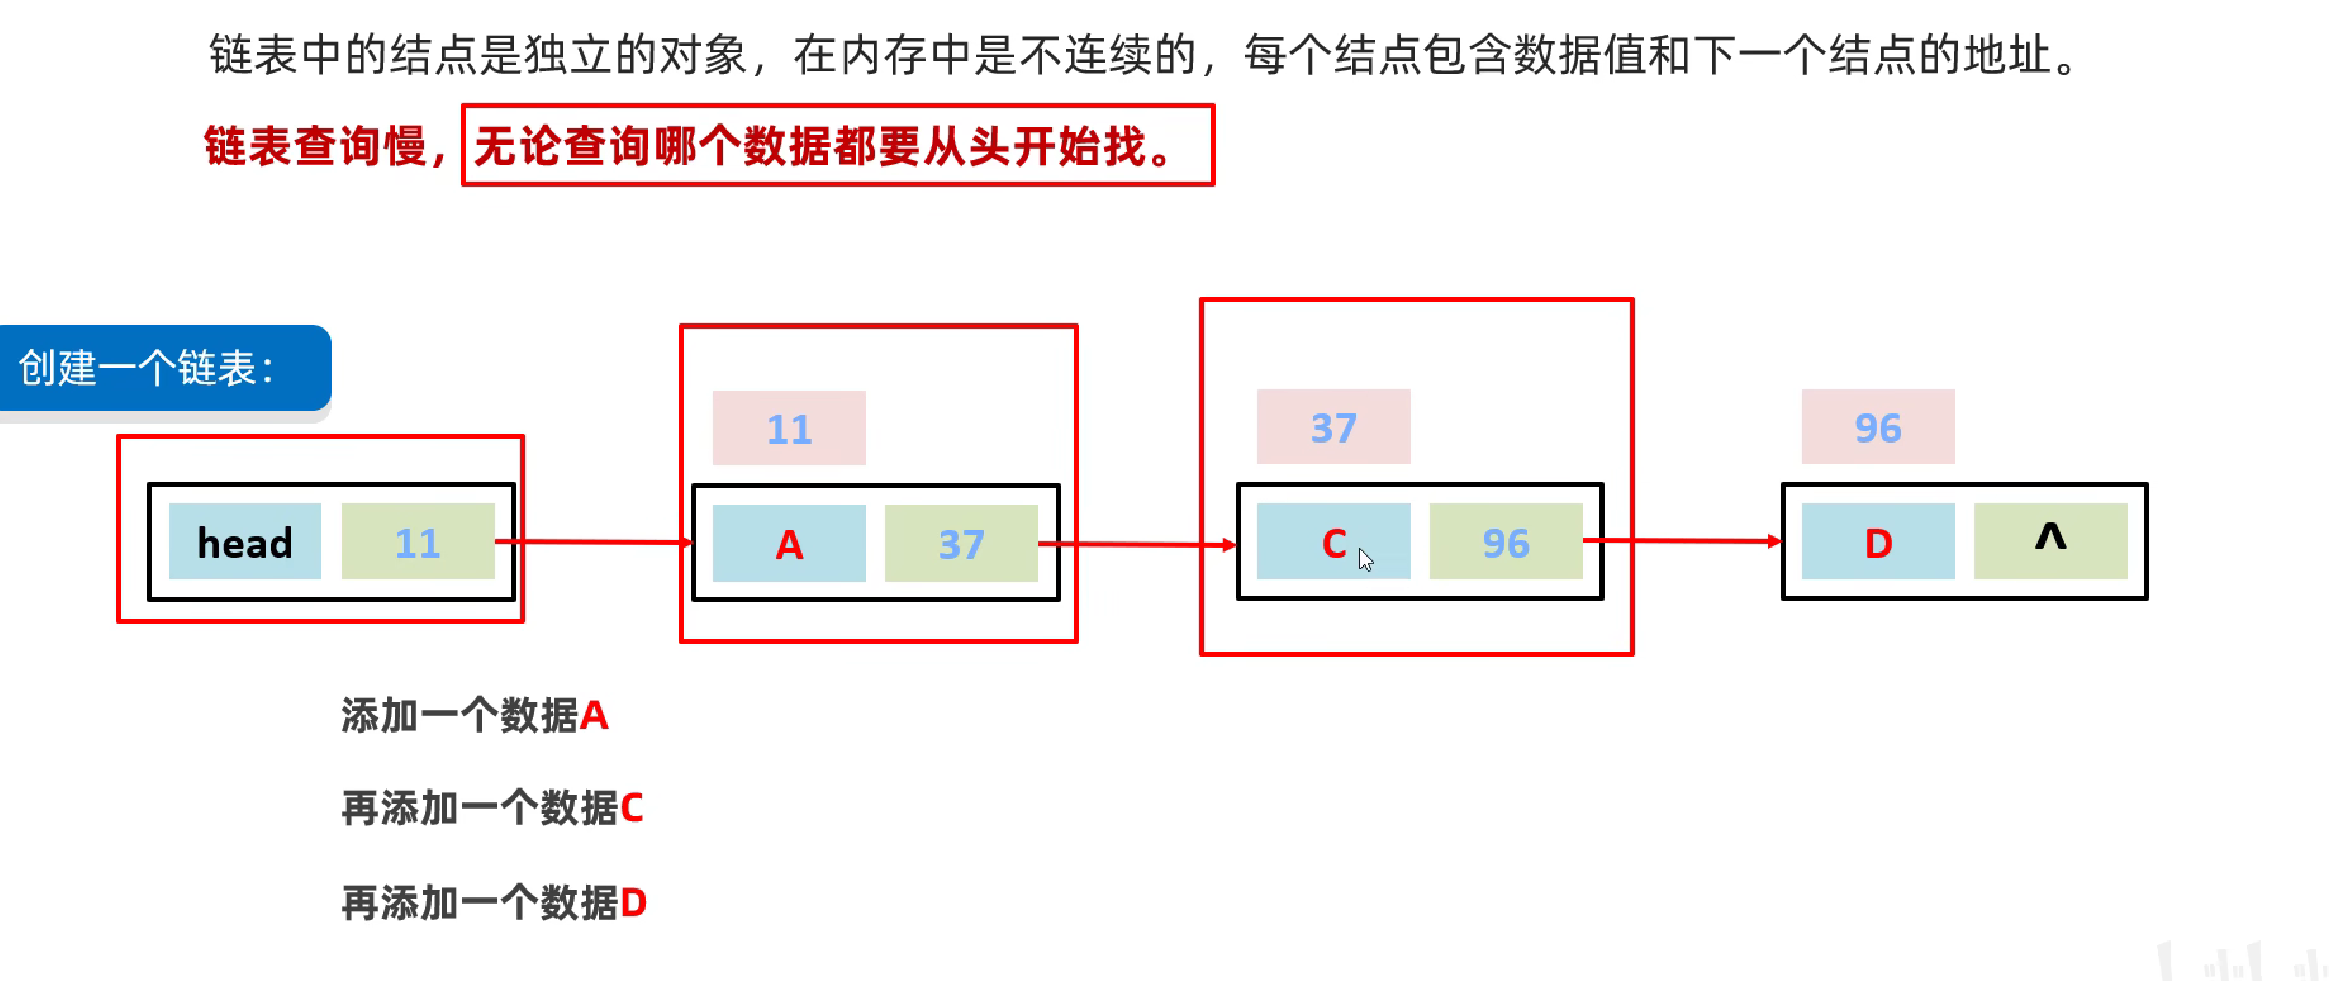
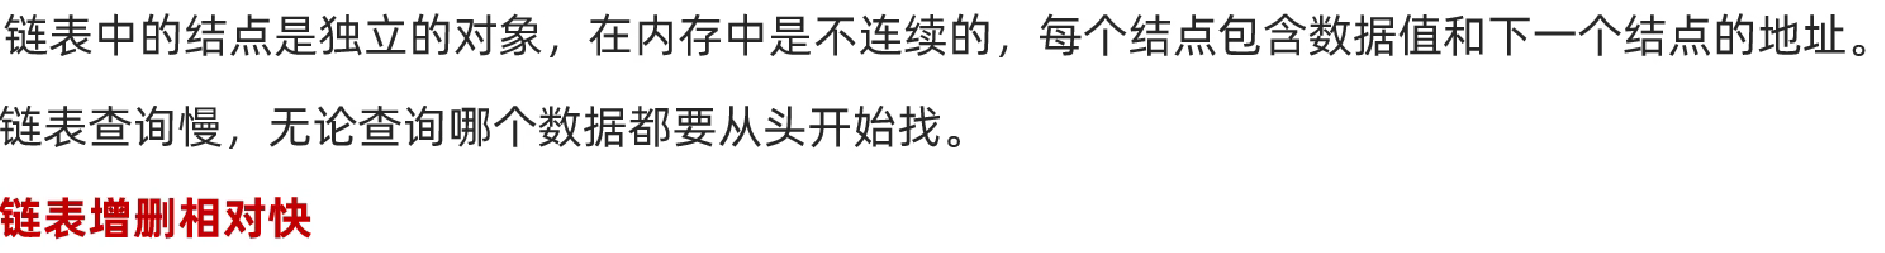
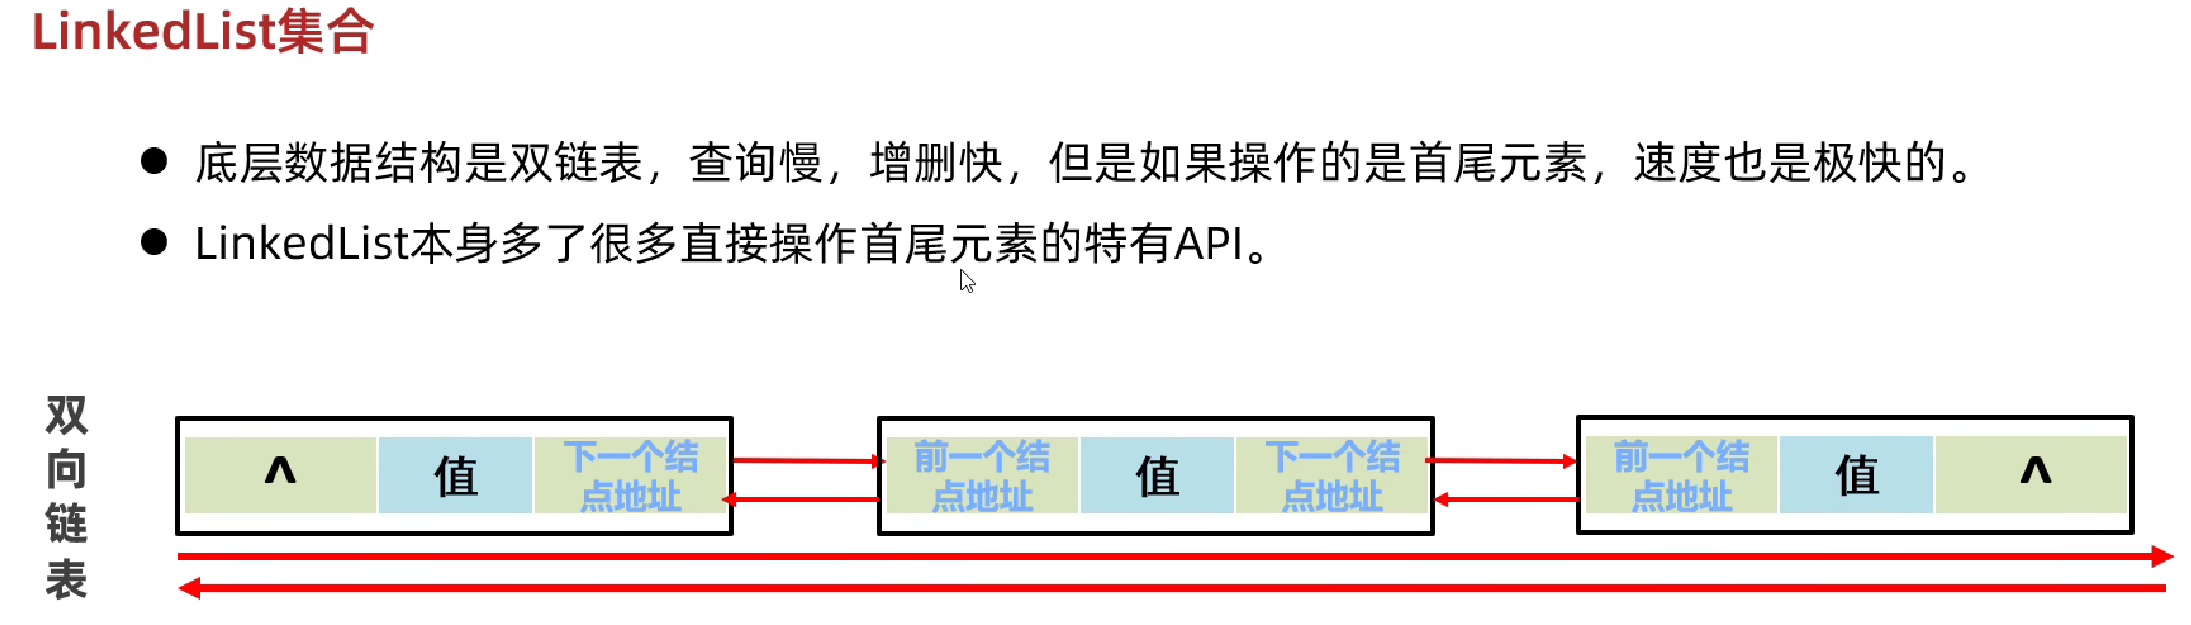
解释:对于无论查询哪个数据都要从头开始找的原因是每一个结点的地址只有该结点的上一个结点知道,因为链表存储不是一块连续的存储空间。
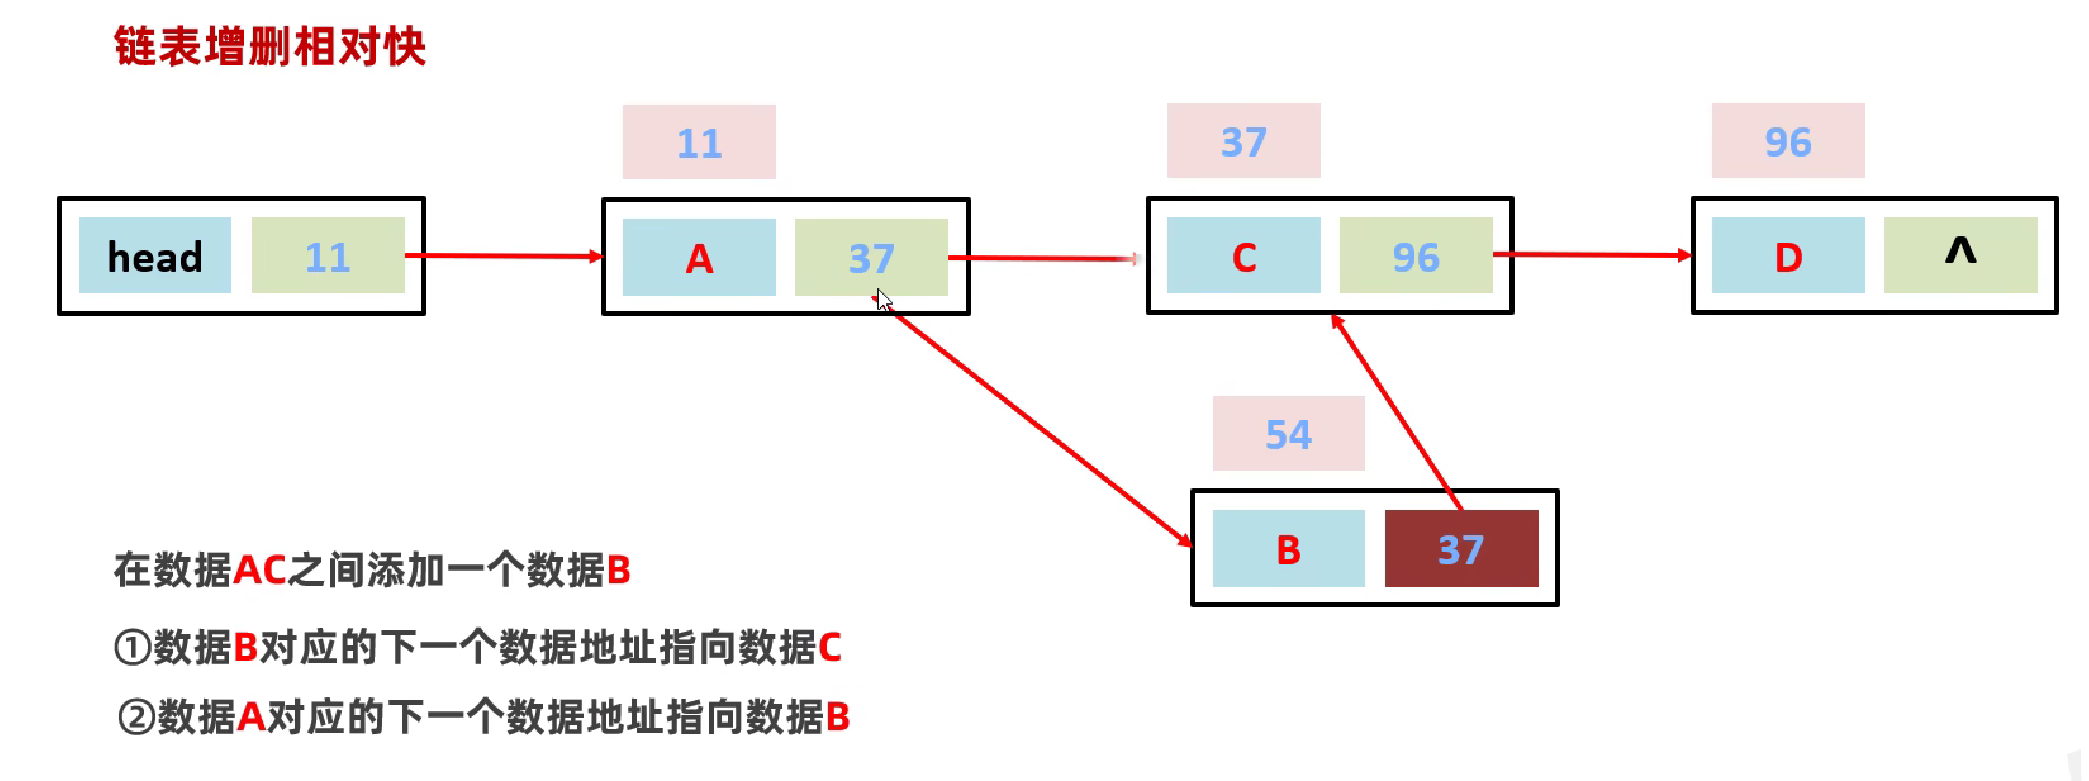
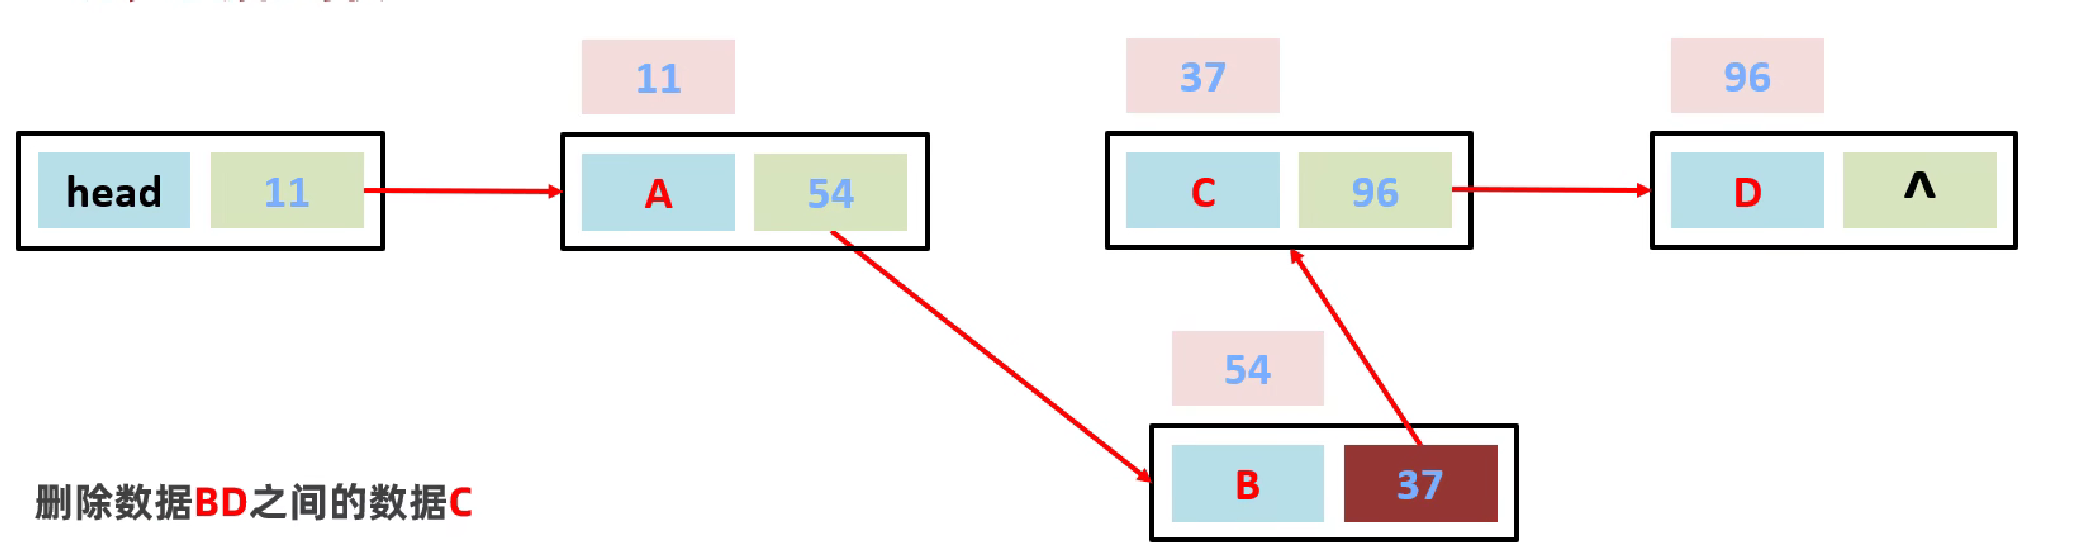
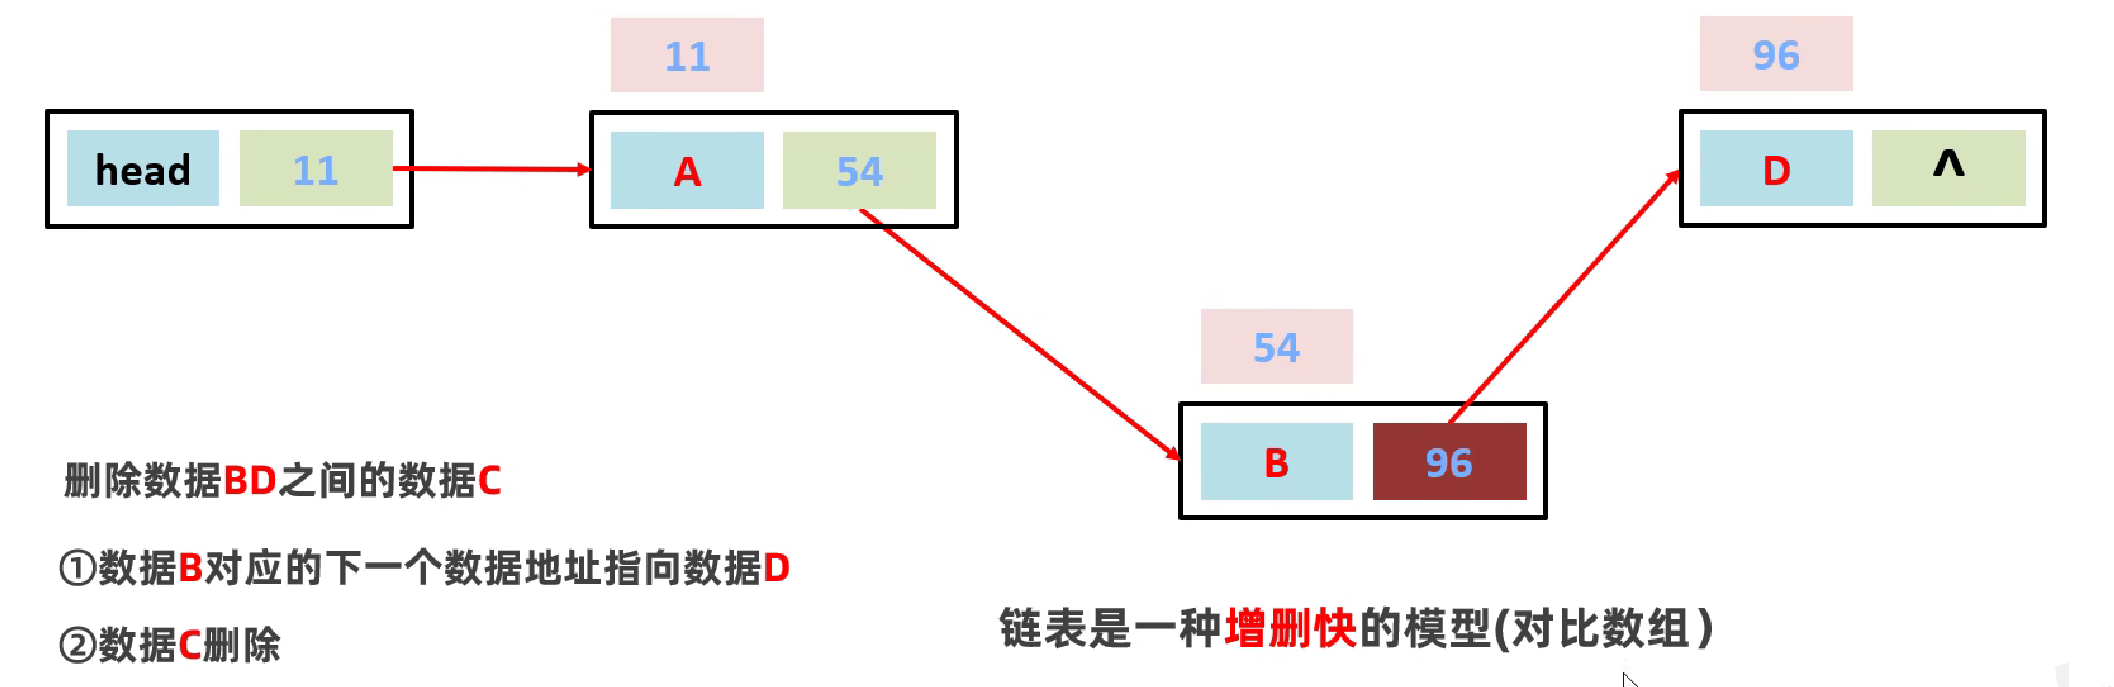
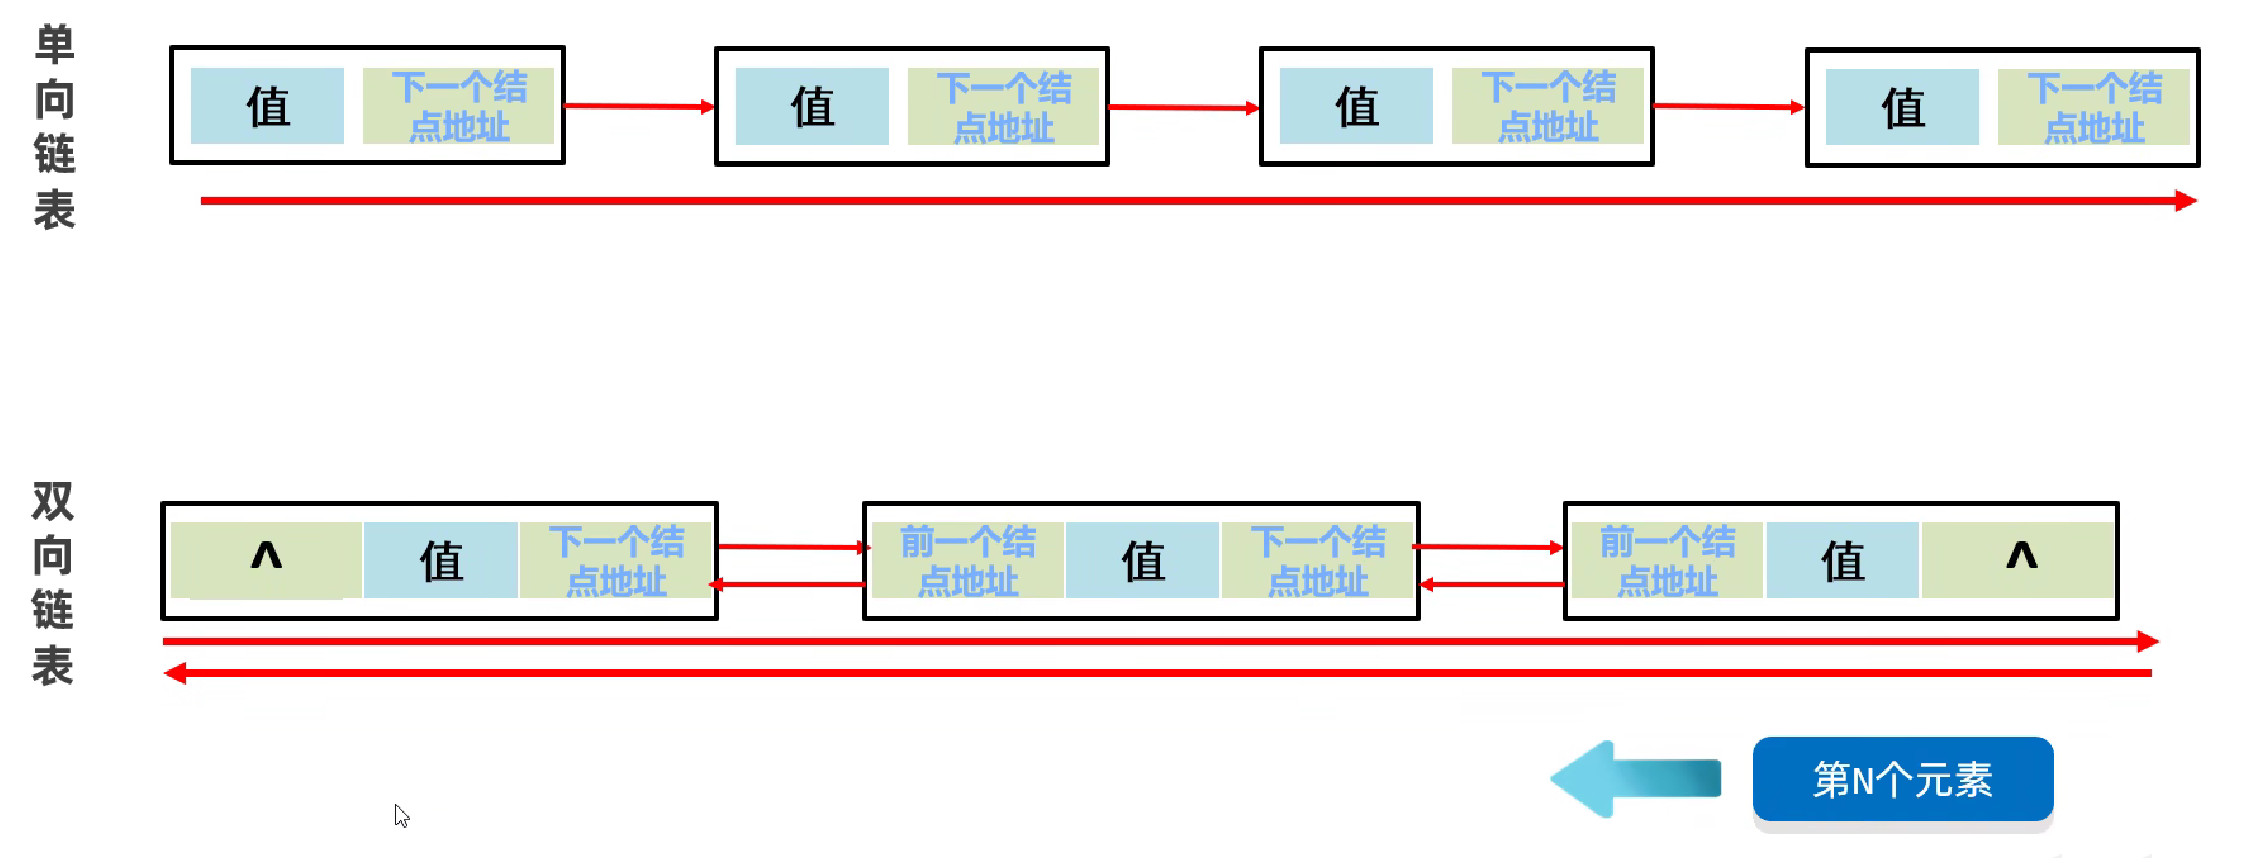
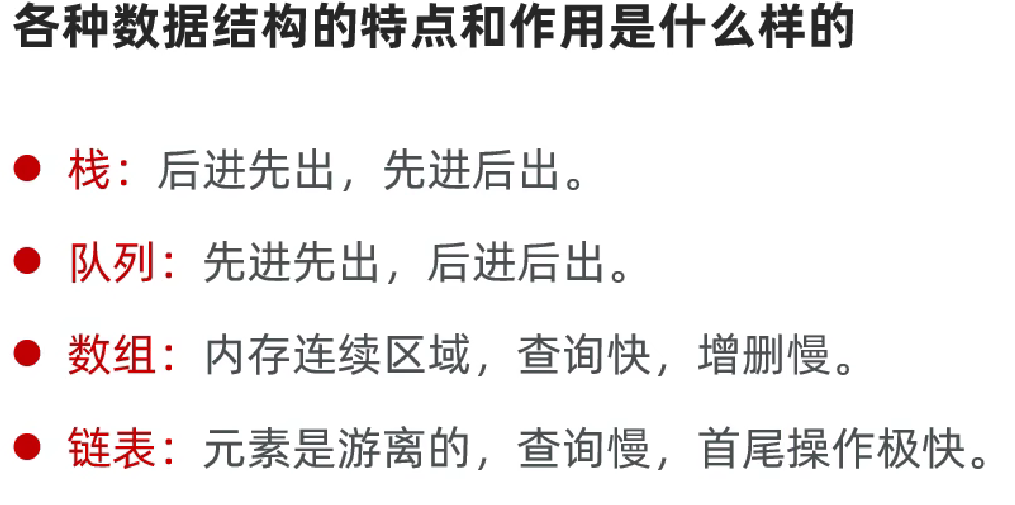
对于双向链表,当查找第N个元素时速度比较快。因为在查找时会先分别与头结点和尾结点进行比较,看看是离哪边近,之后再进行查找。
ArrayList集合
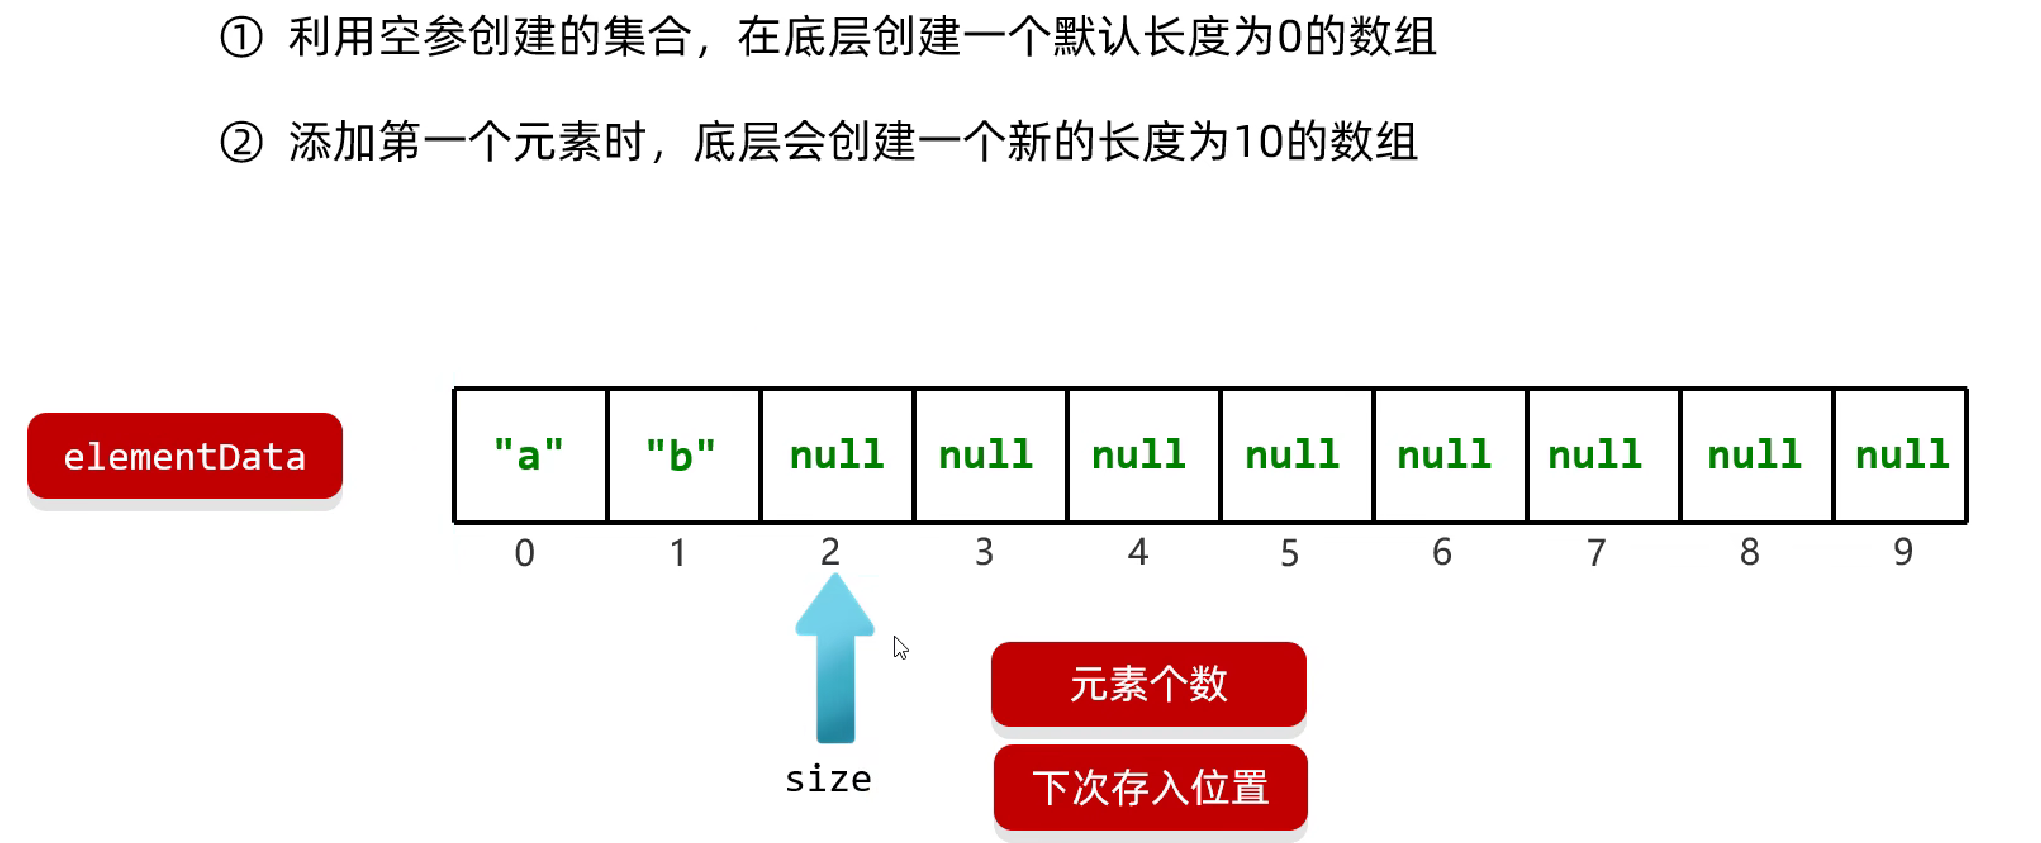
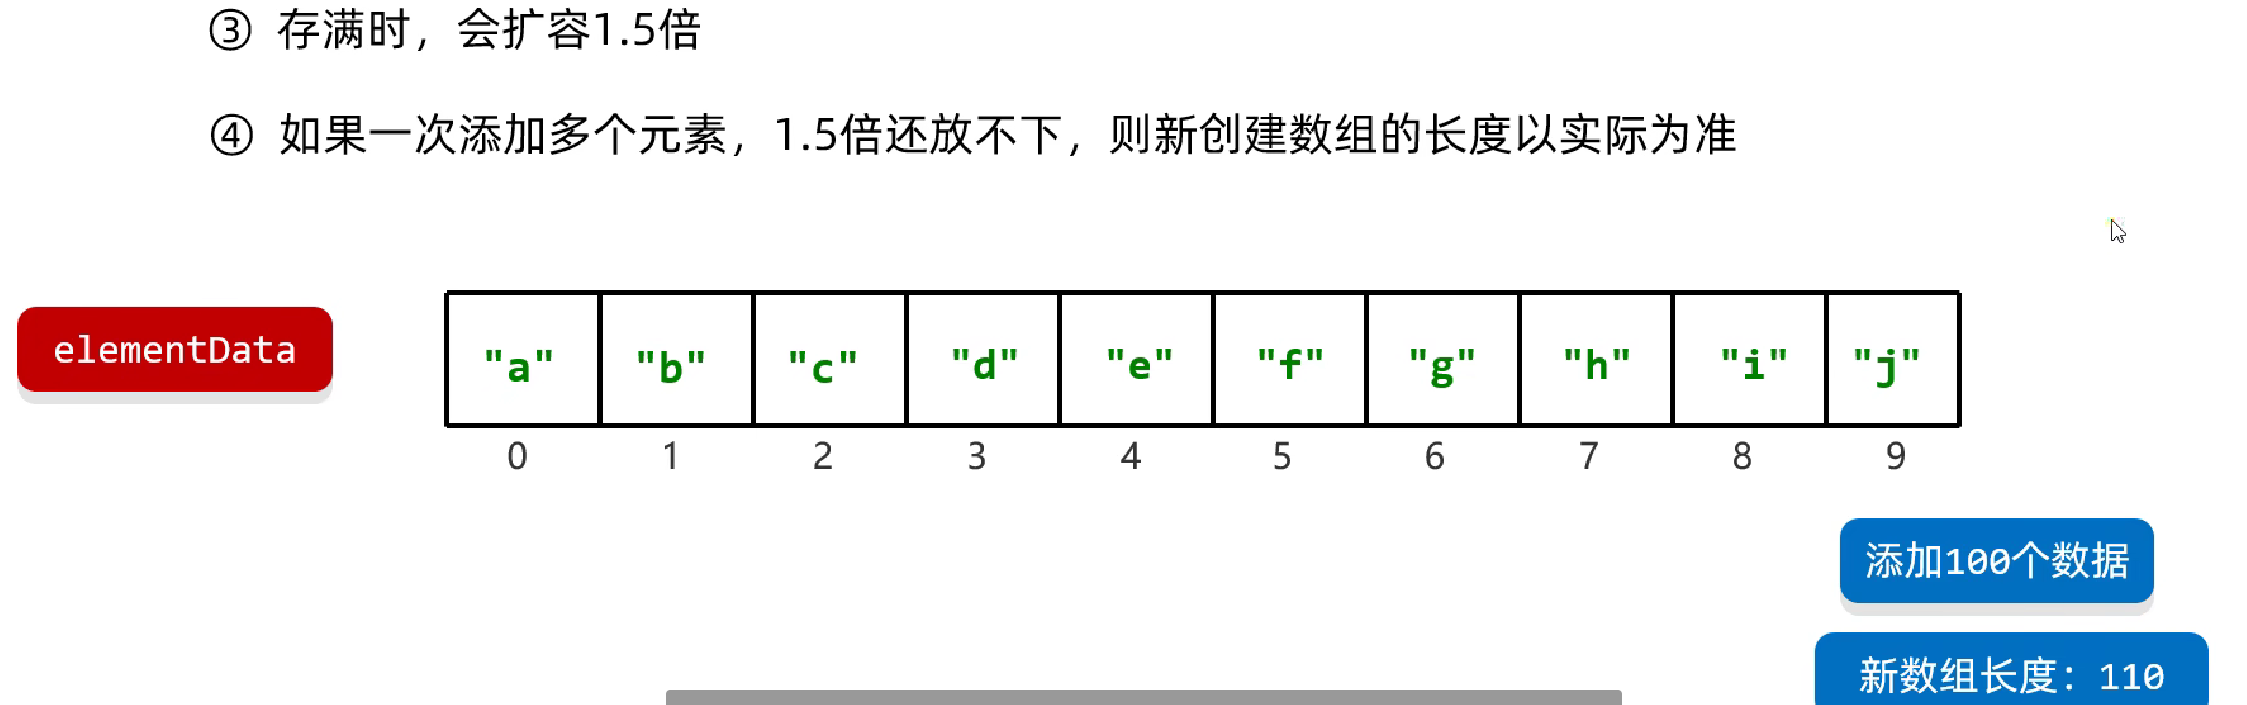
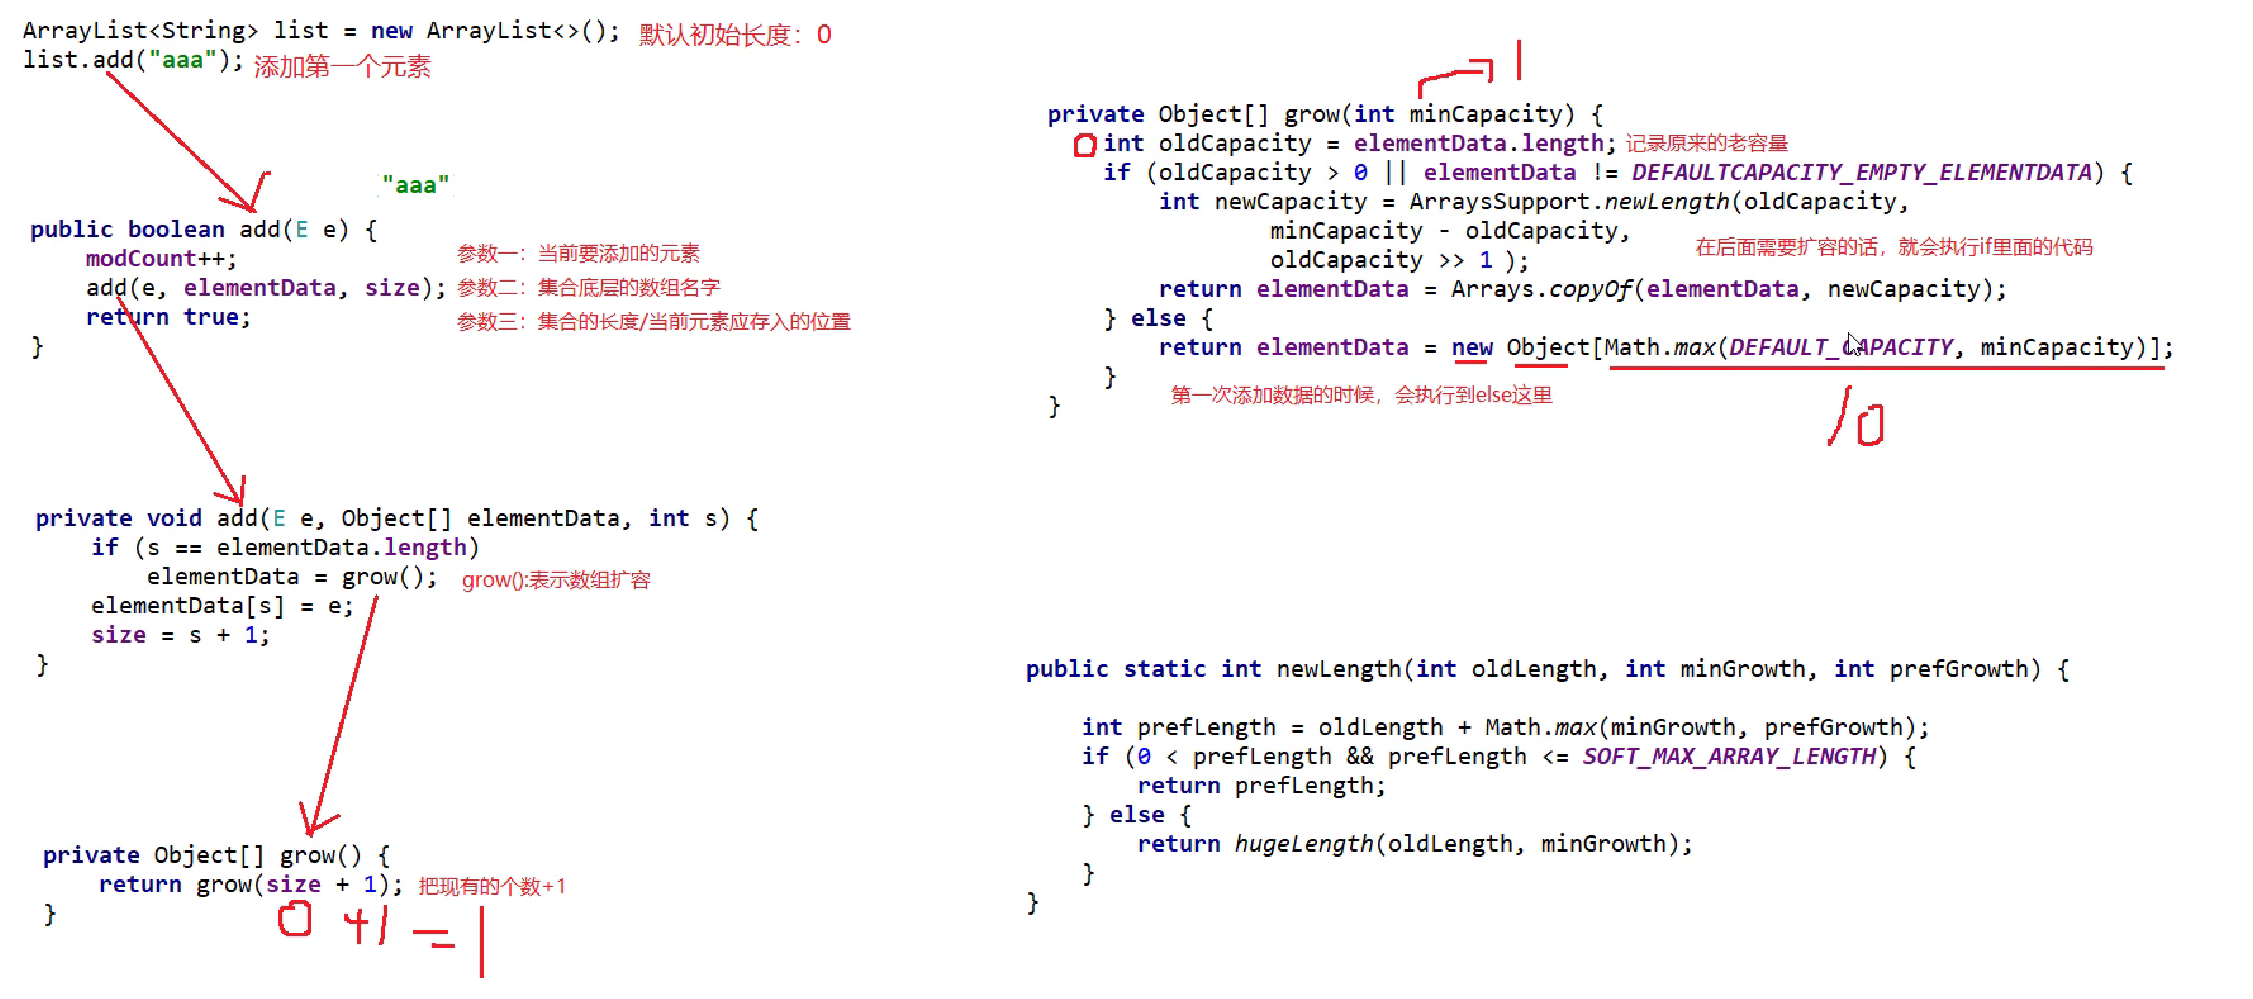
源码分析:
添加的元素未超过10这个容量时:
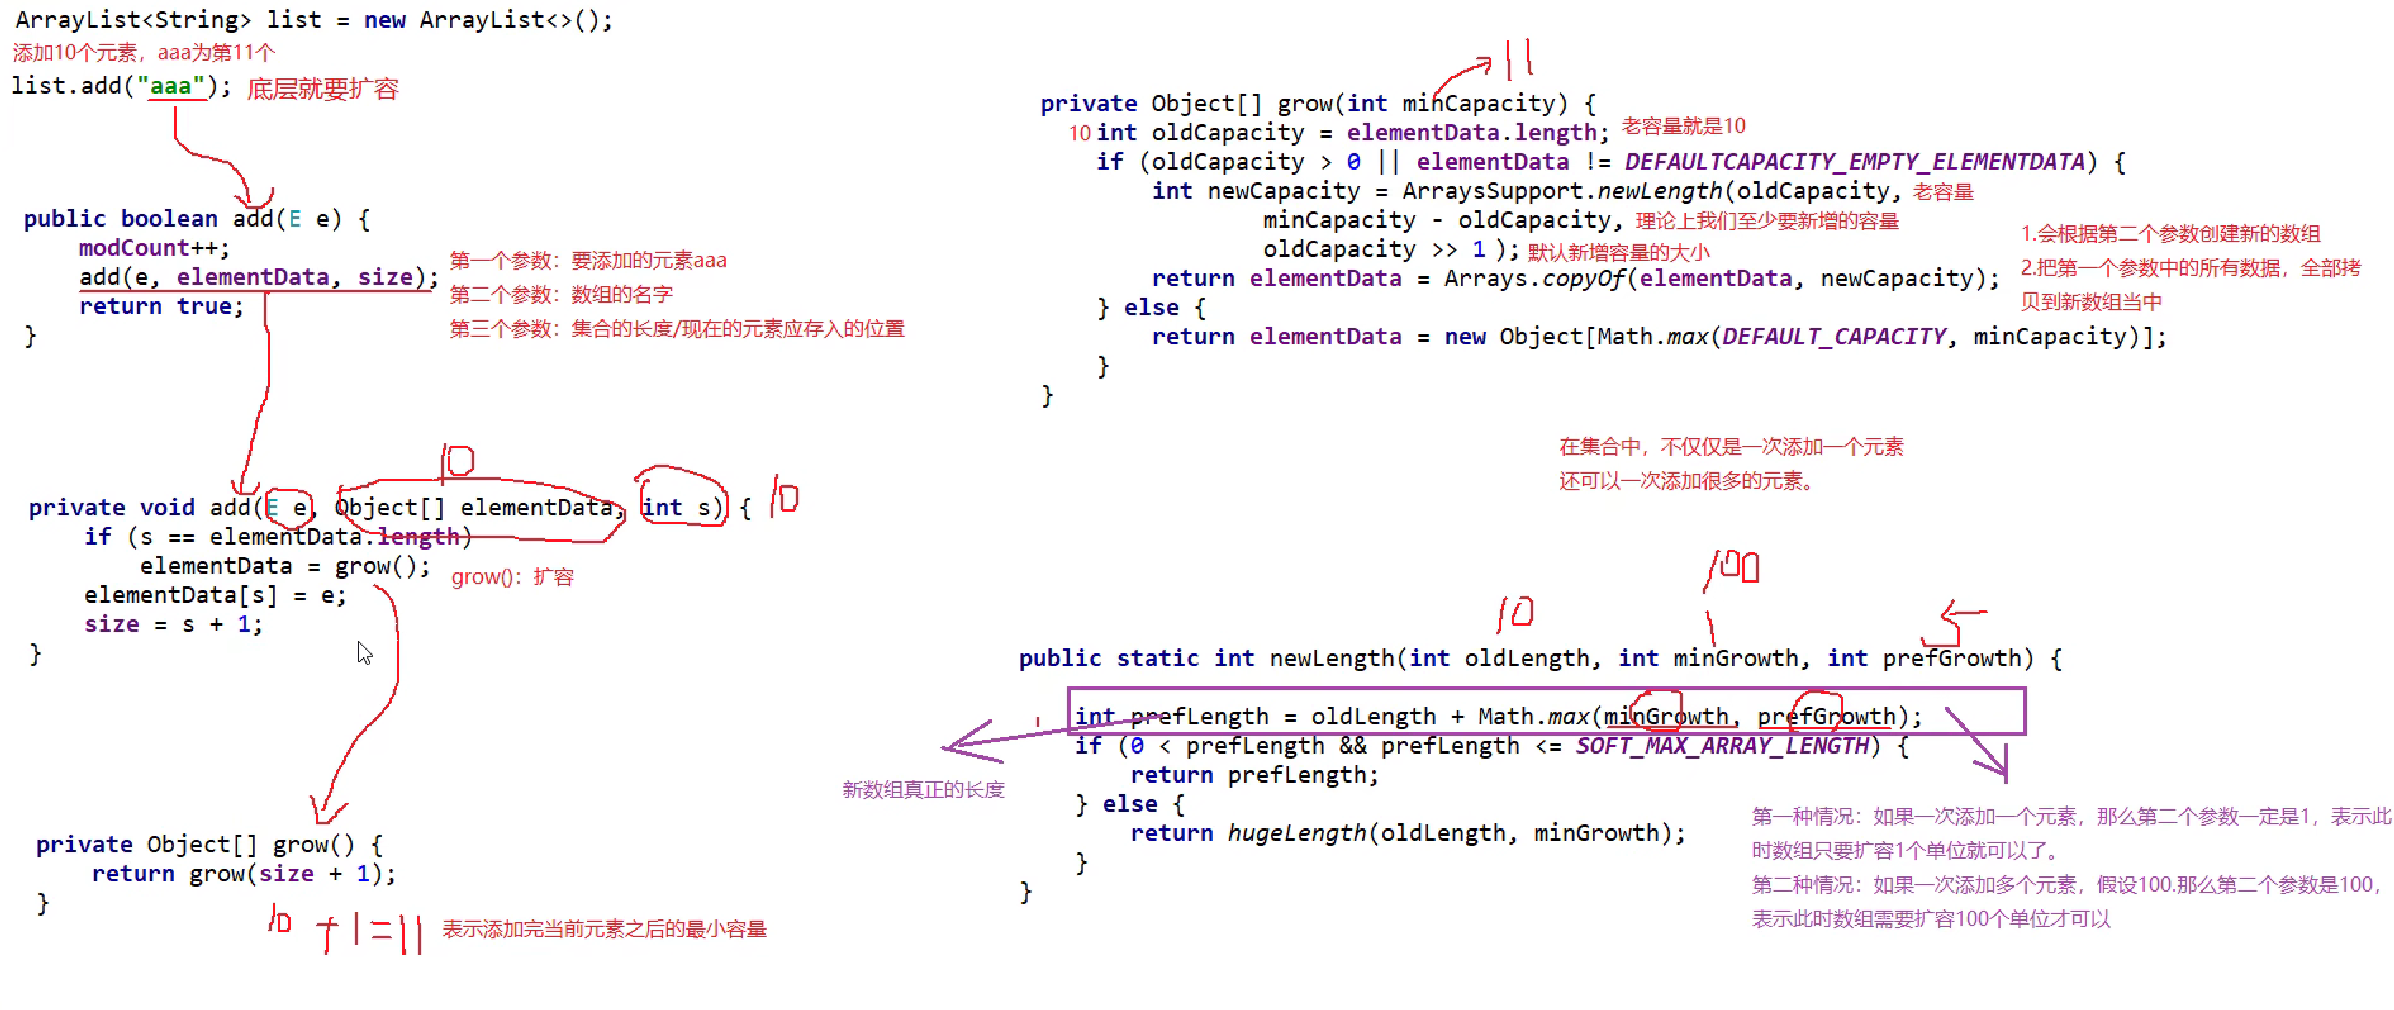
添加的元素超过10这个容量时:
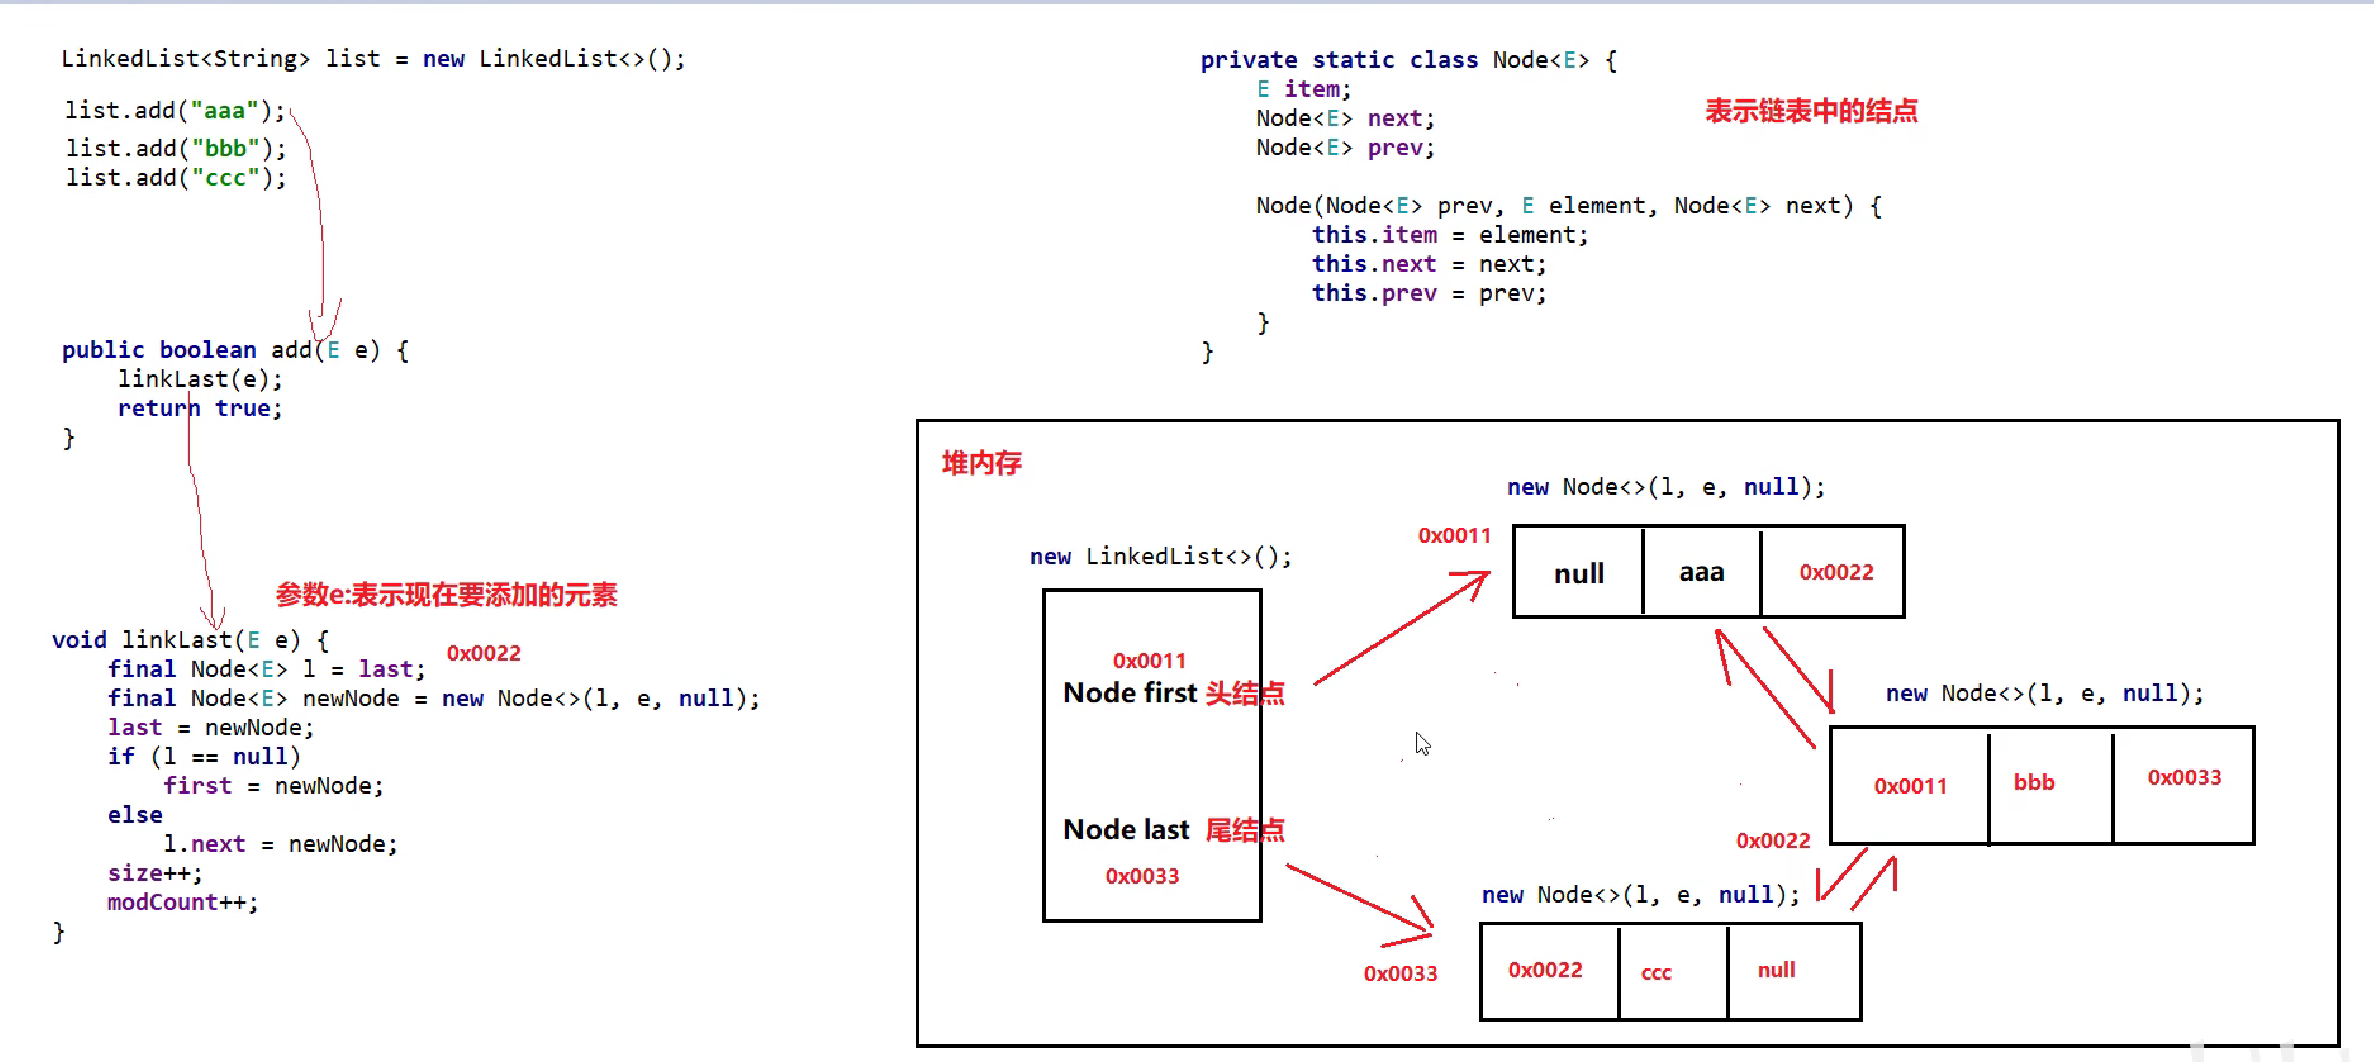
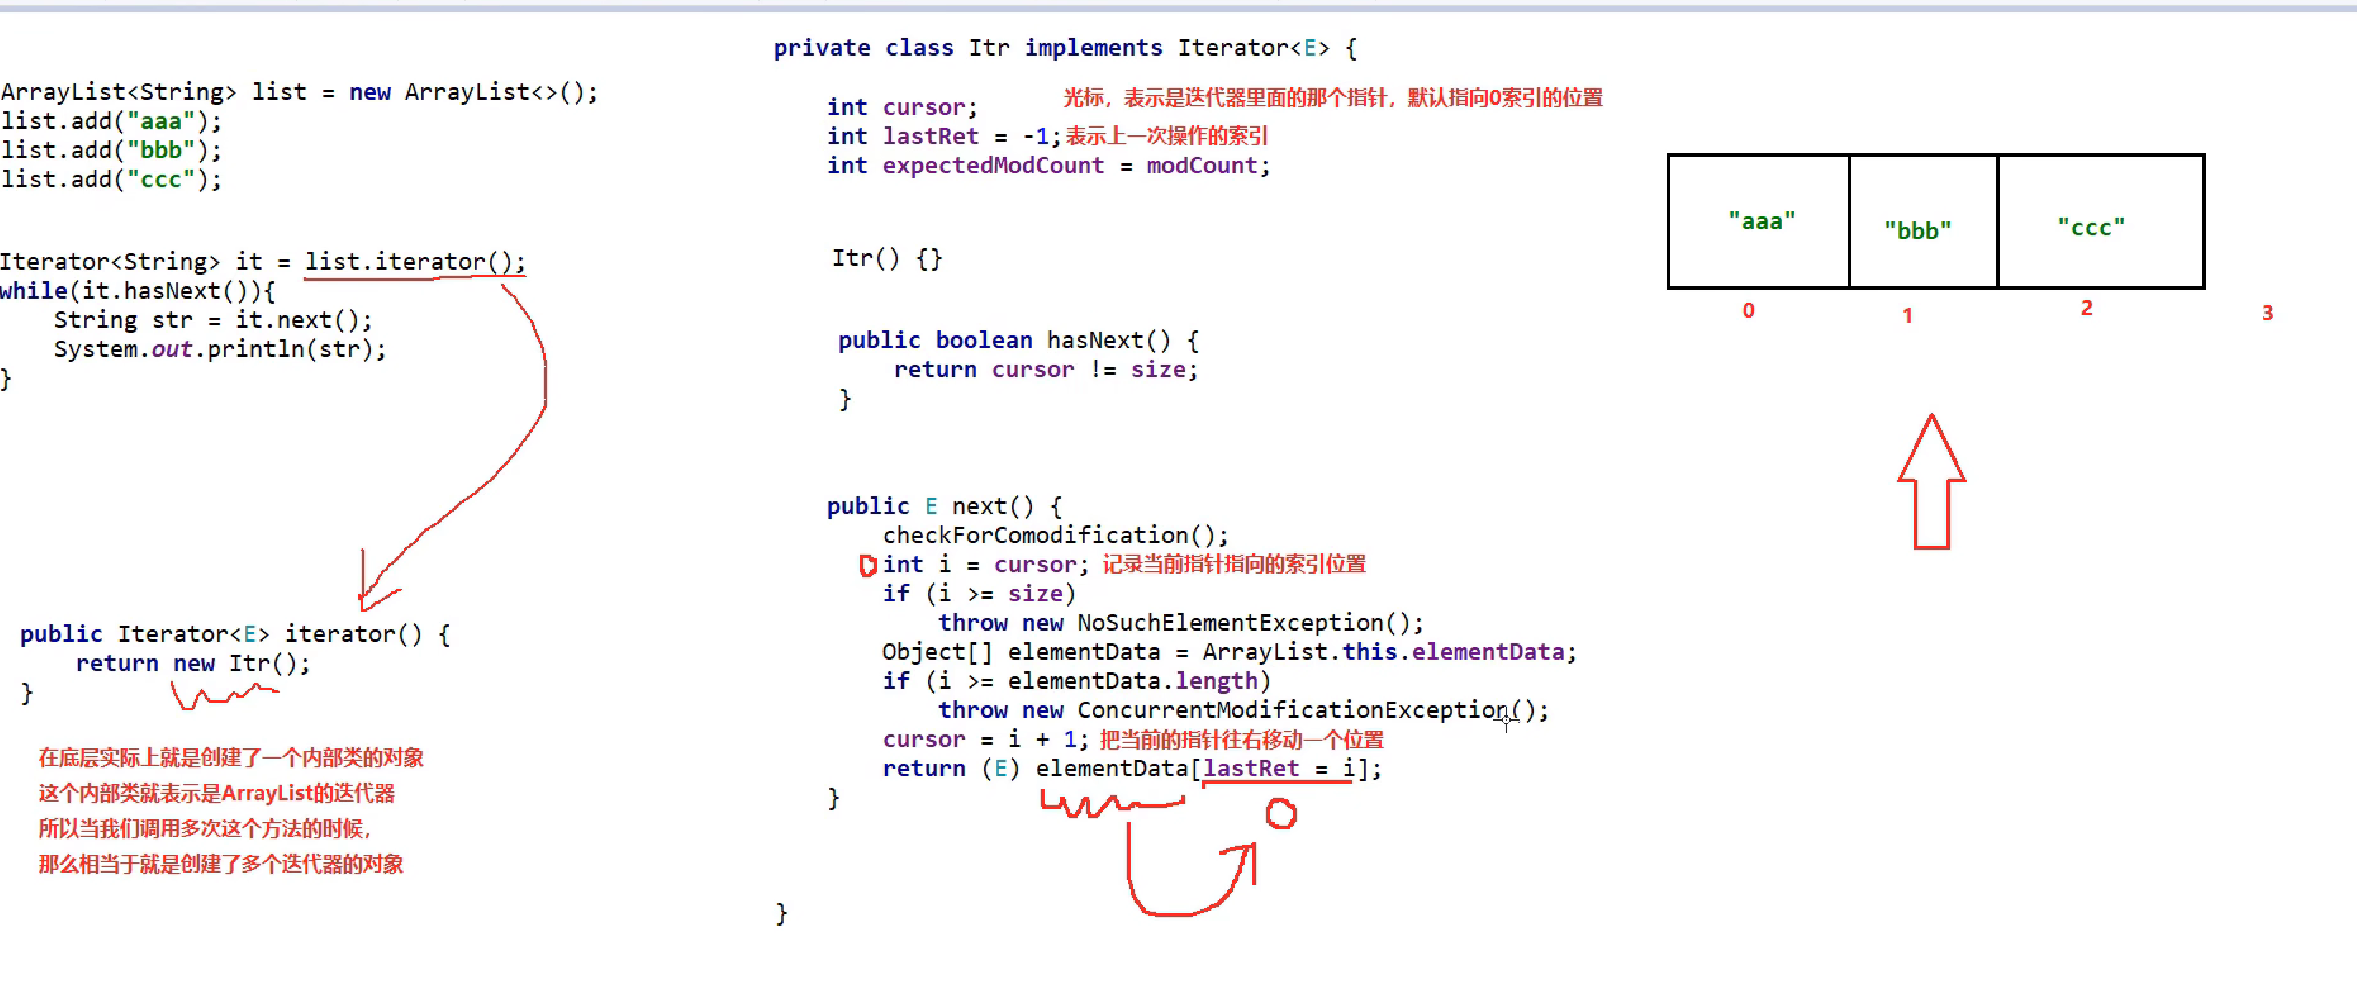
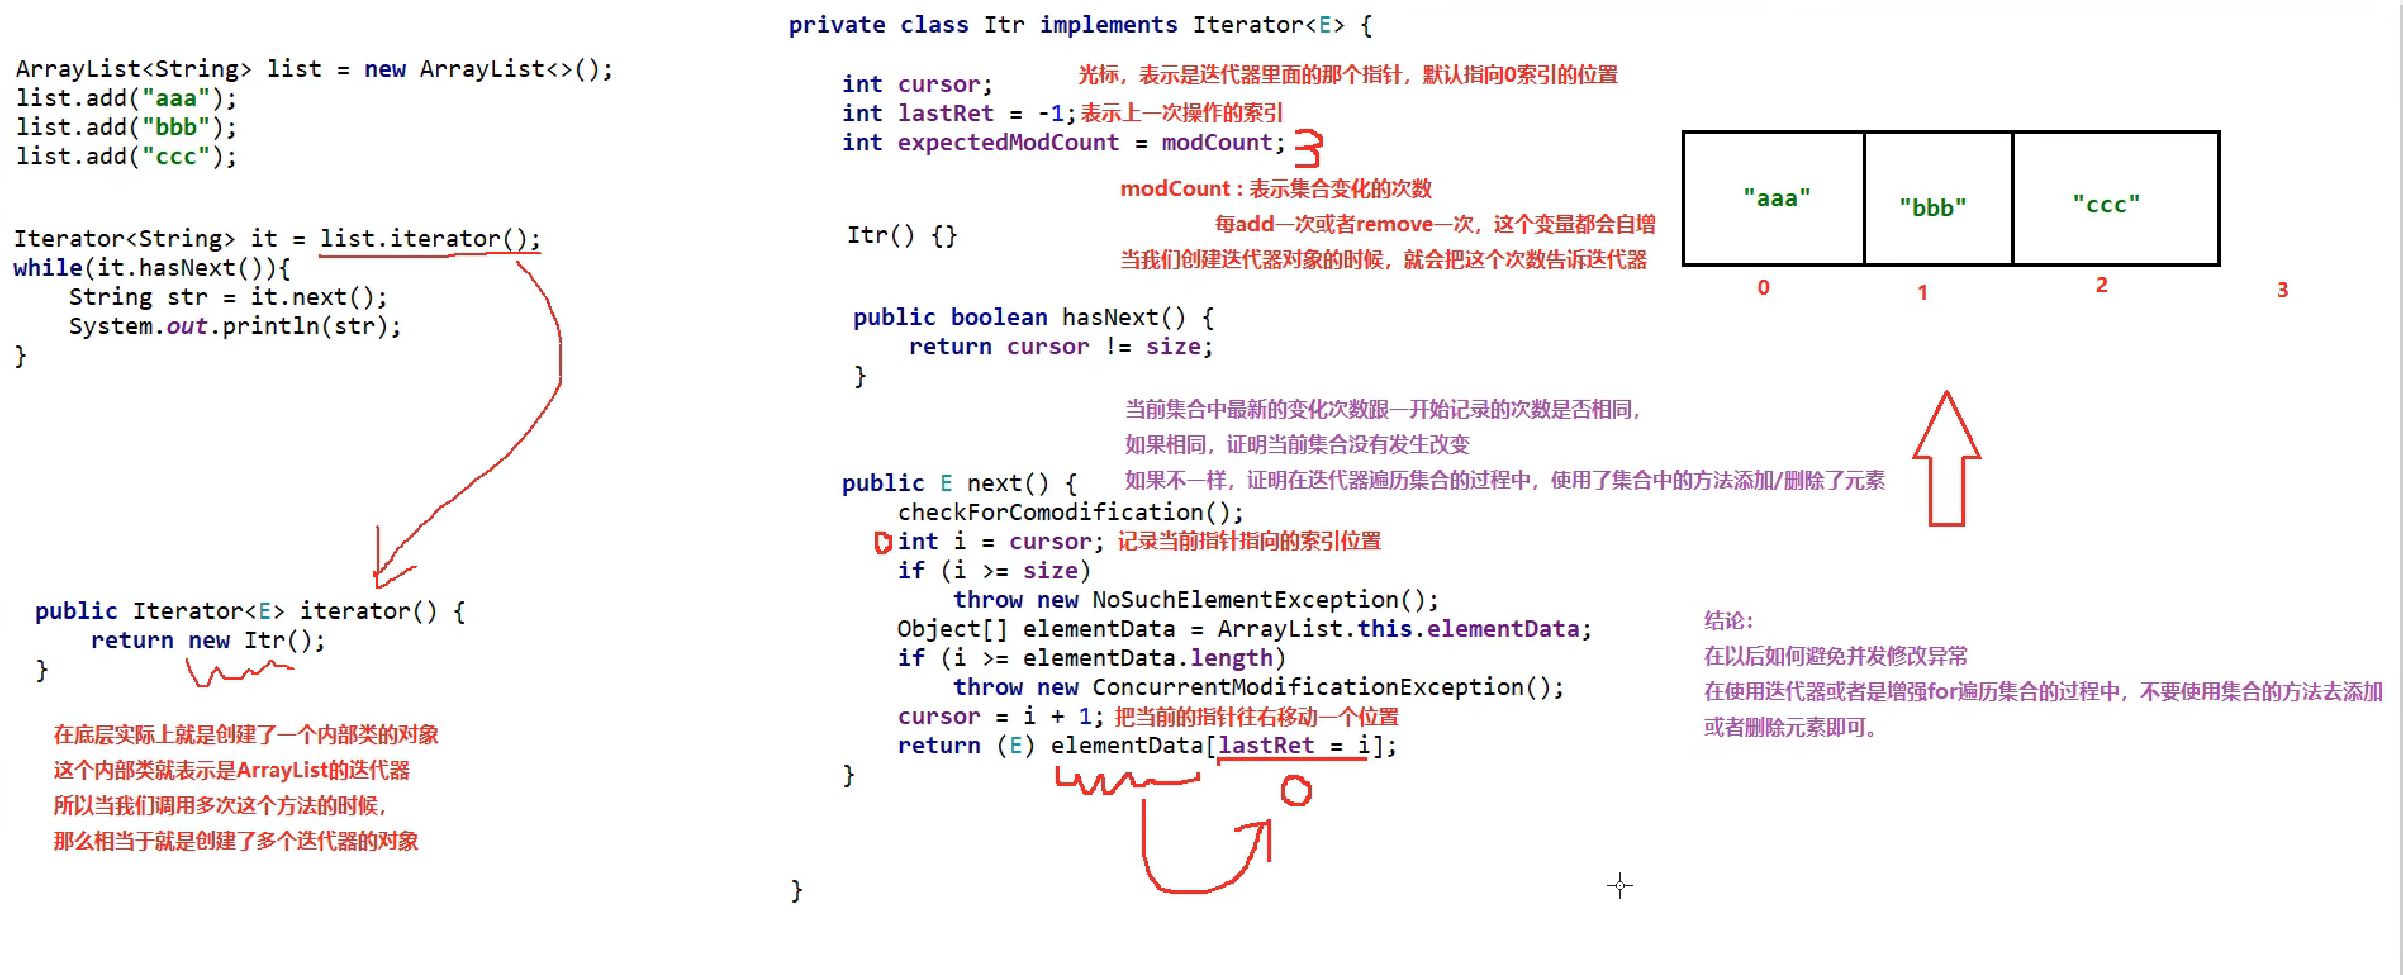
LinkList和迭代器源码分析
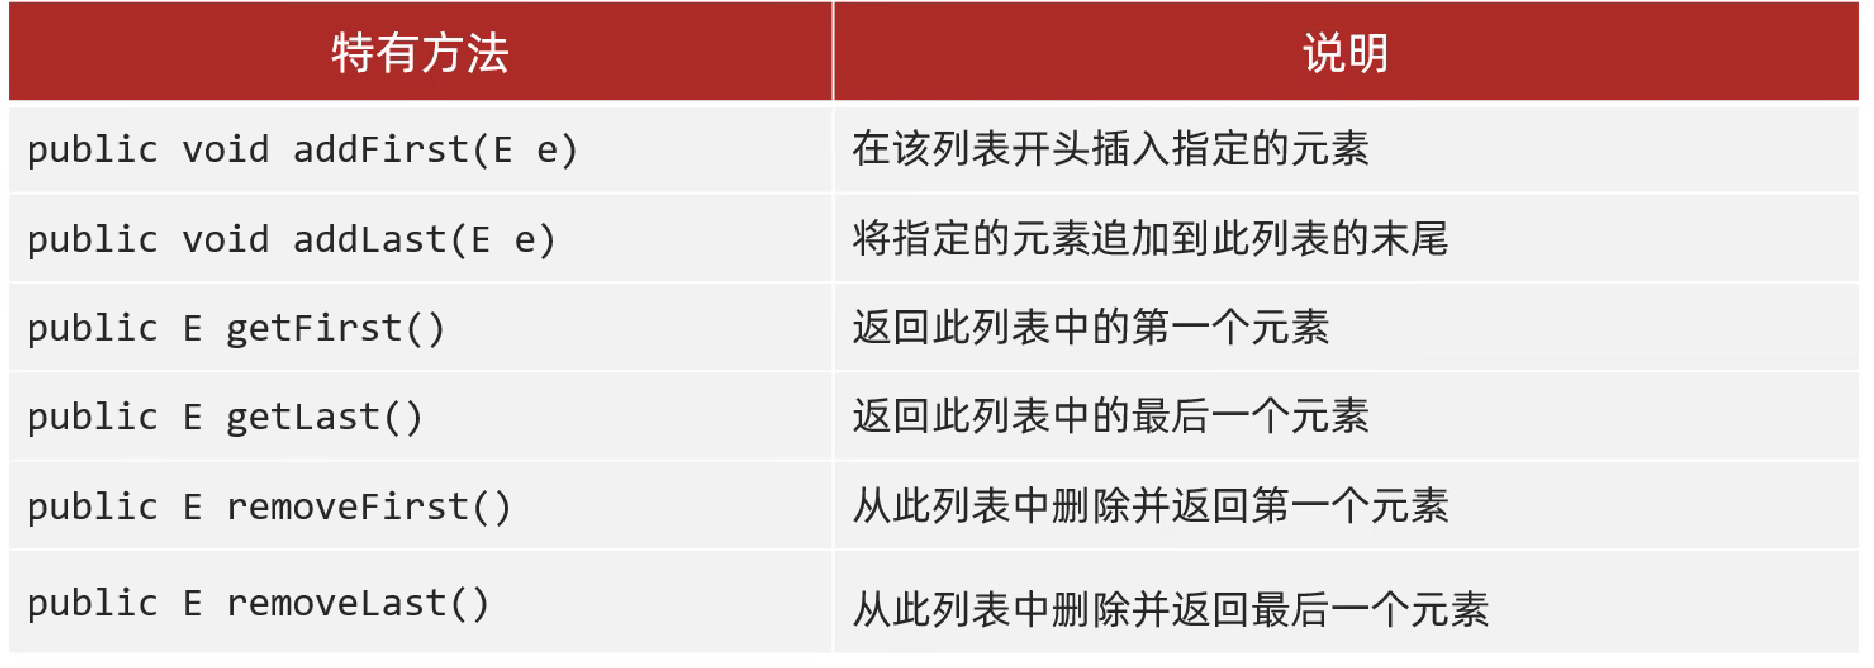
添加元素:
迭代器源码分析:
泛型
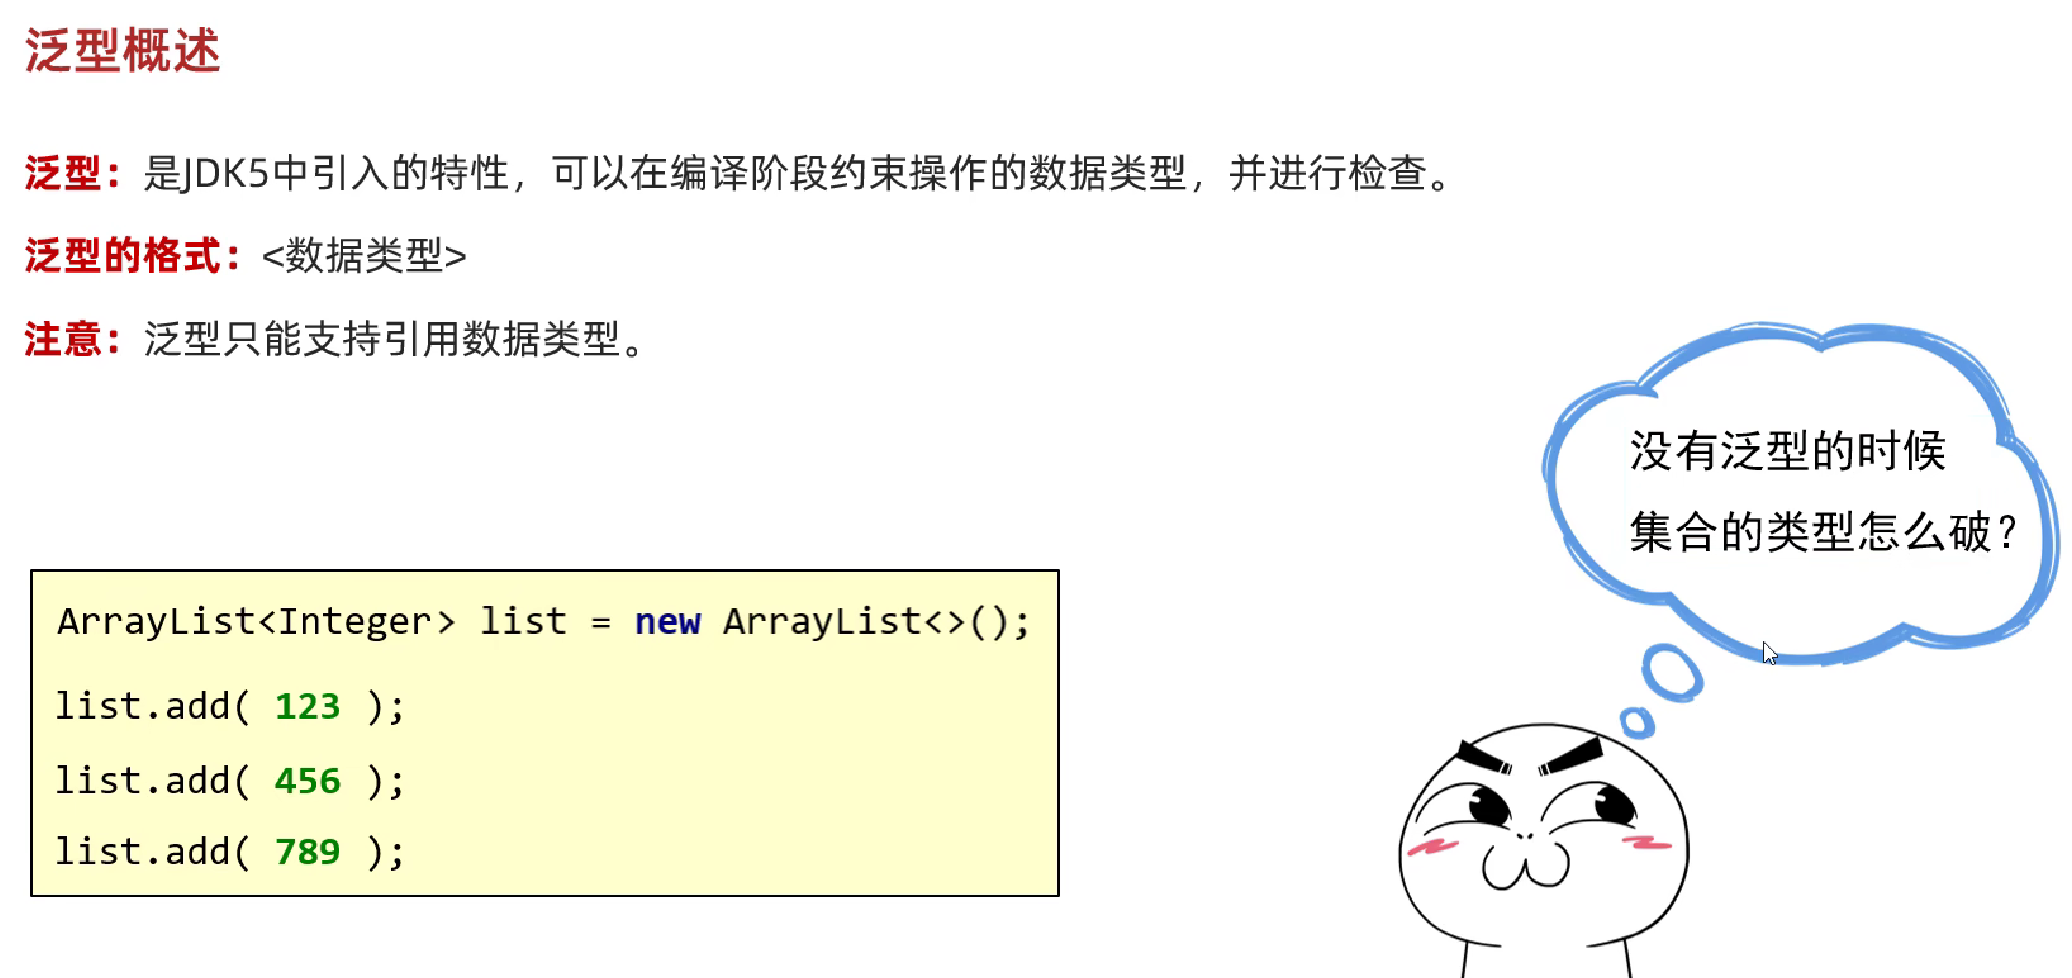
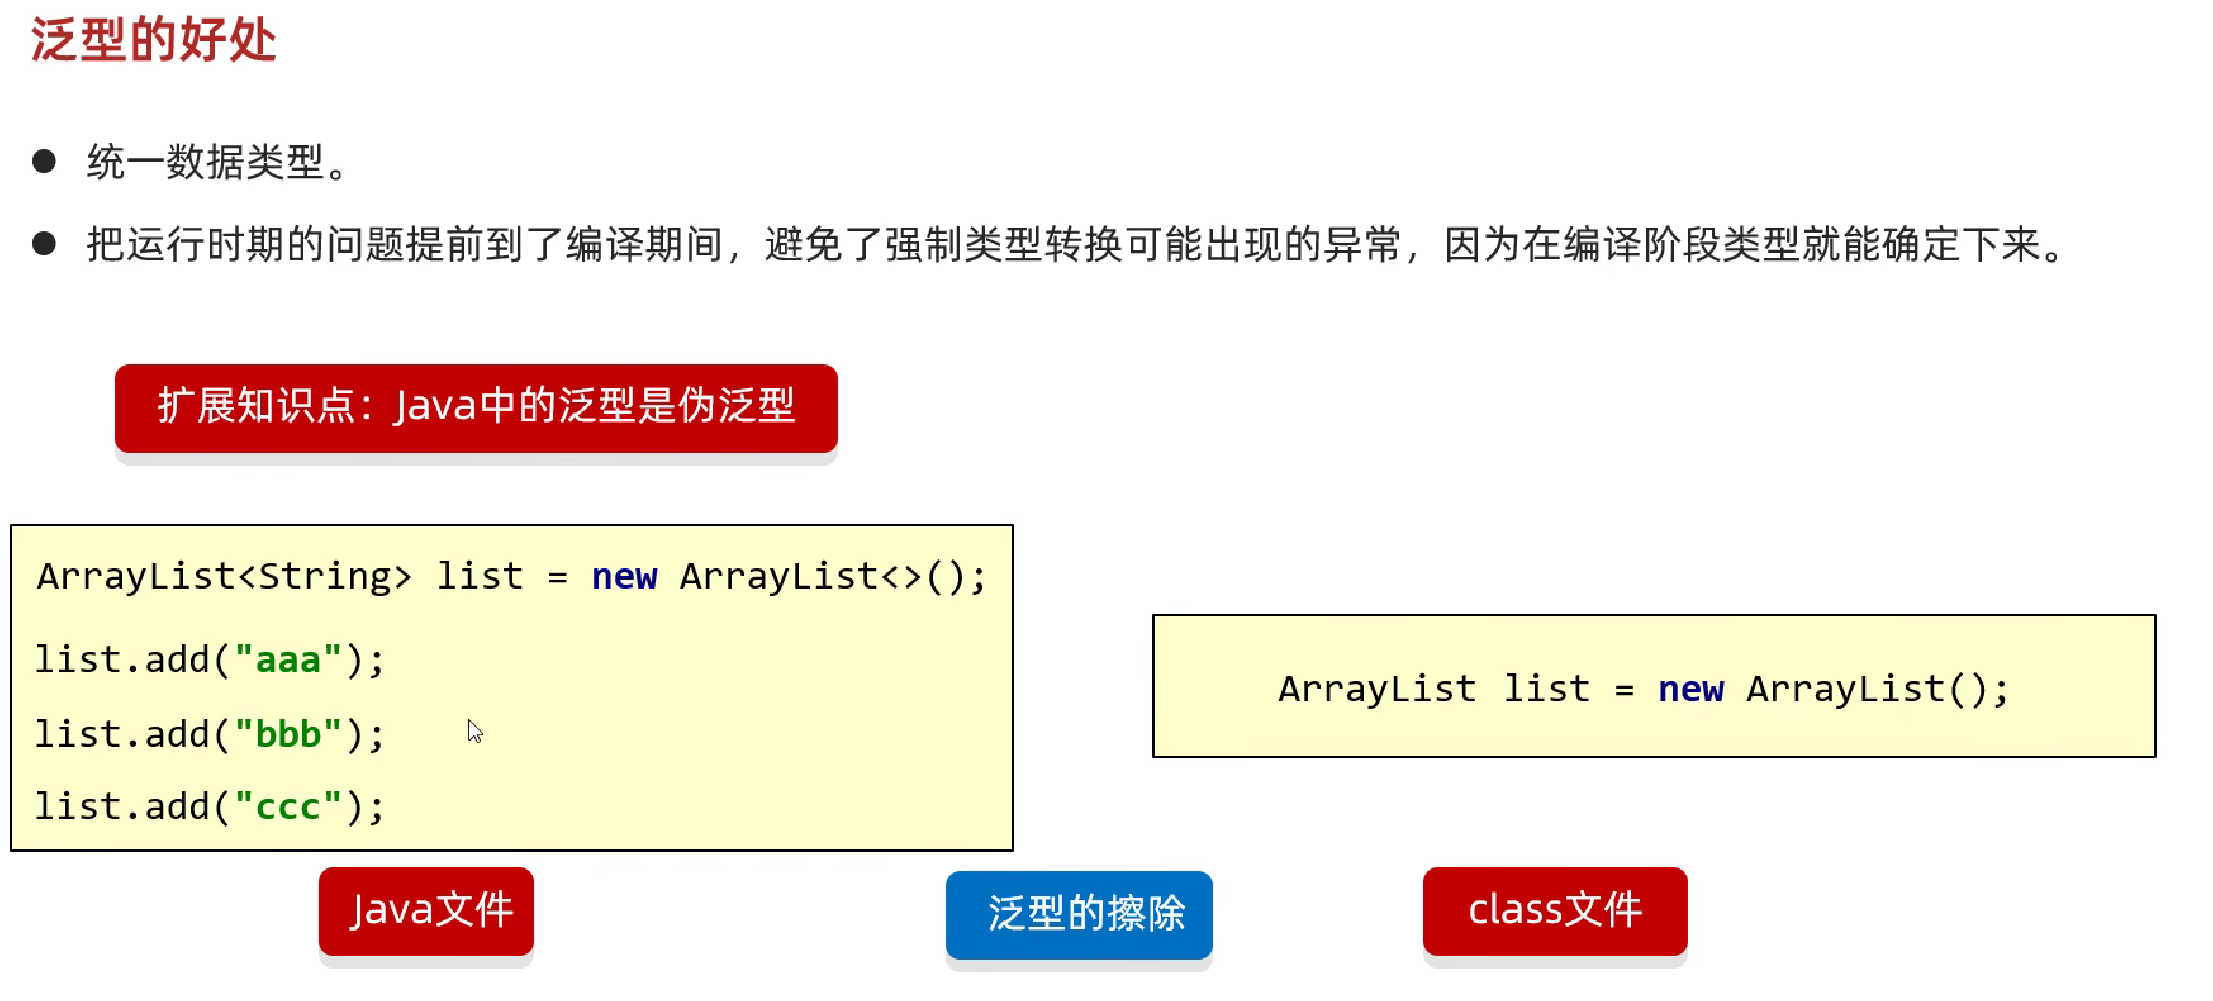
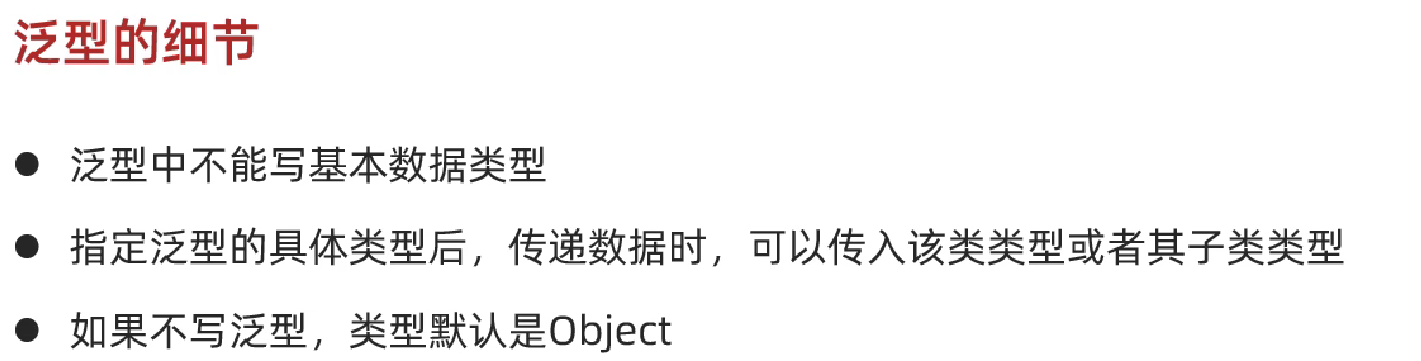
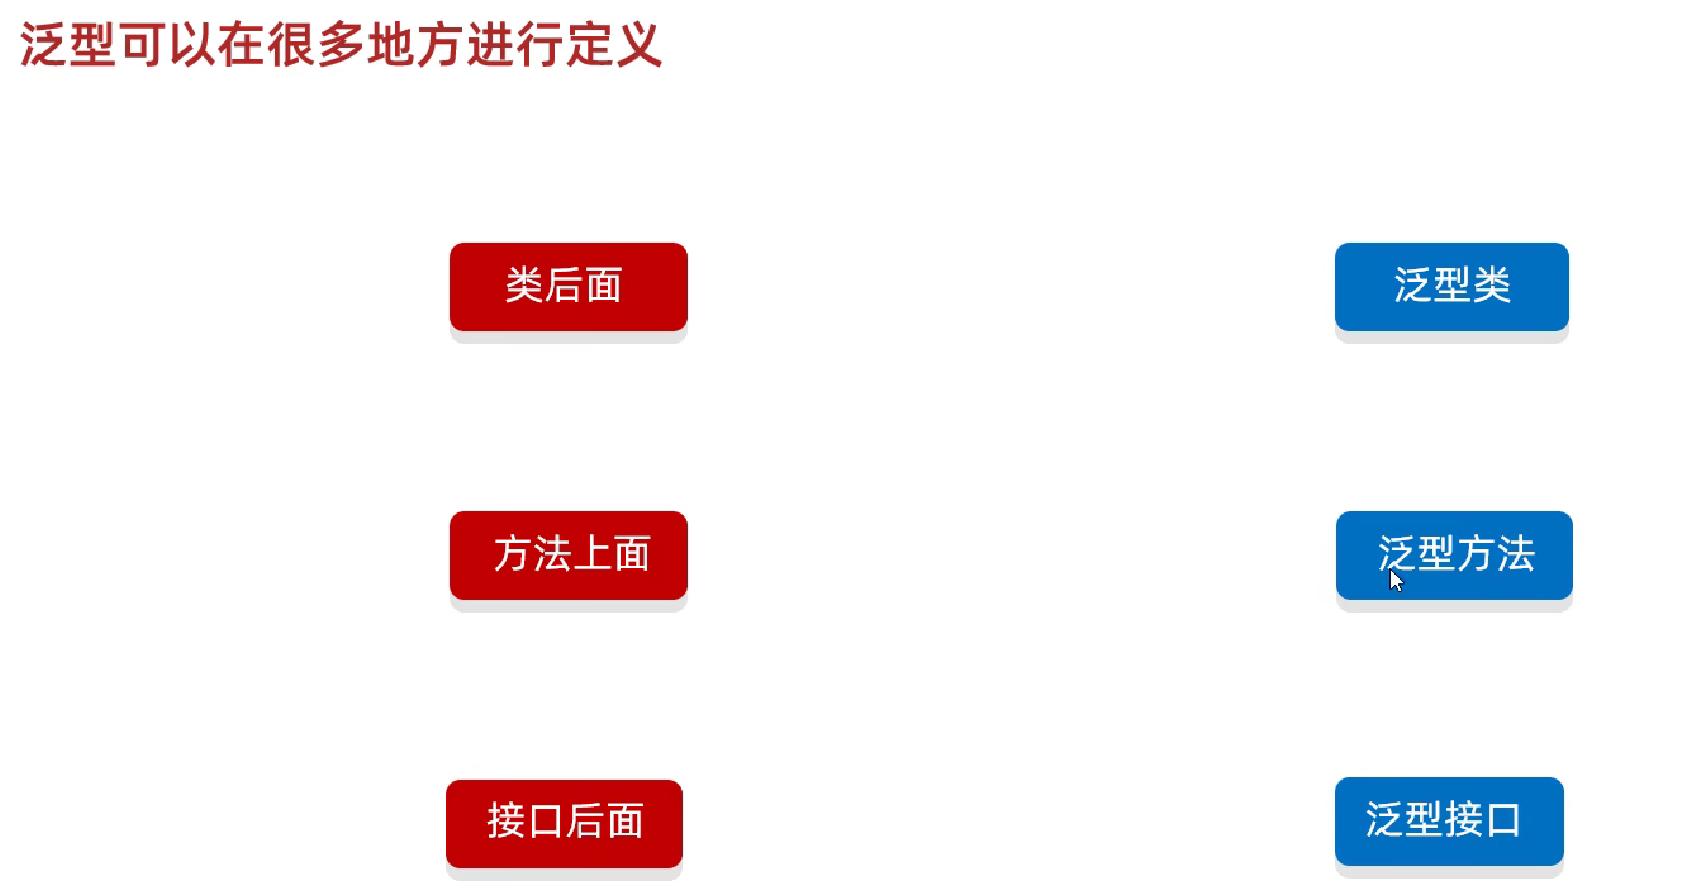
泛型类
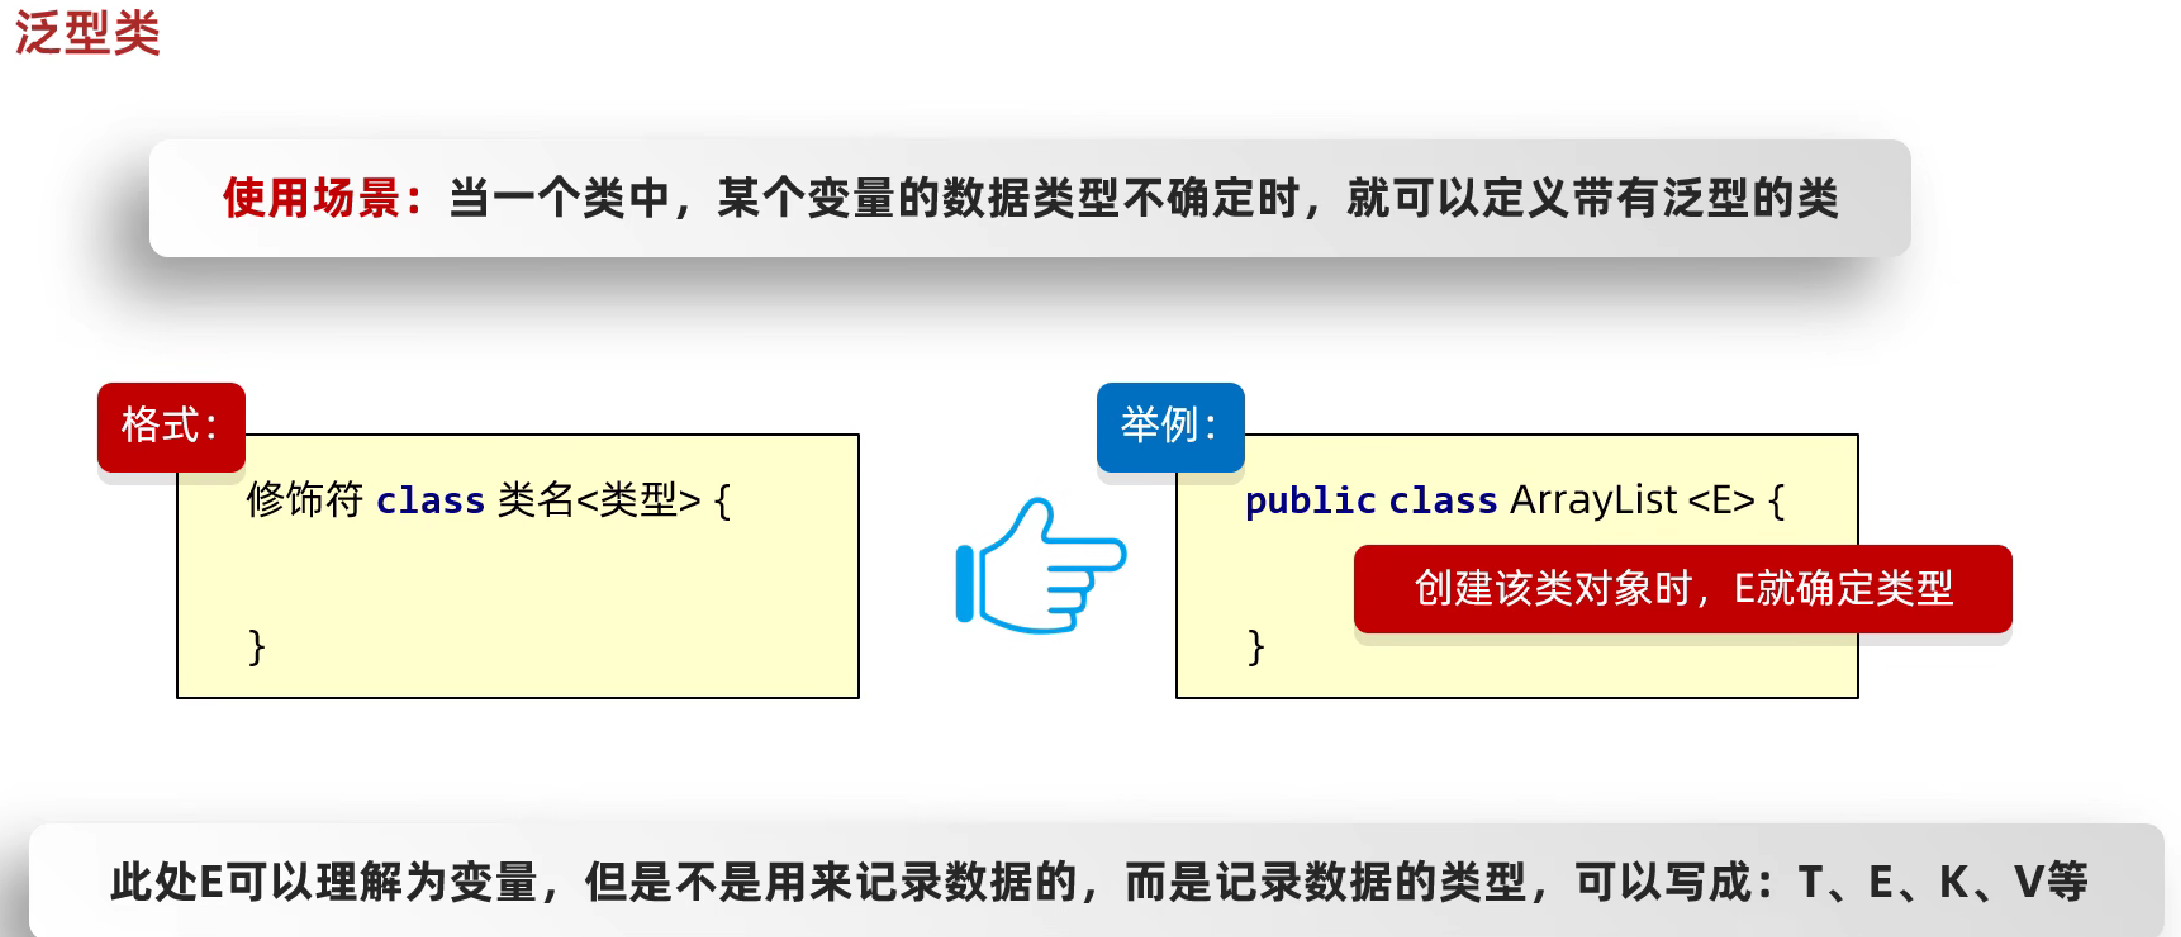
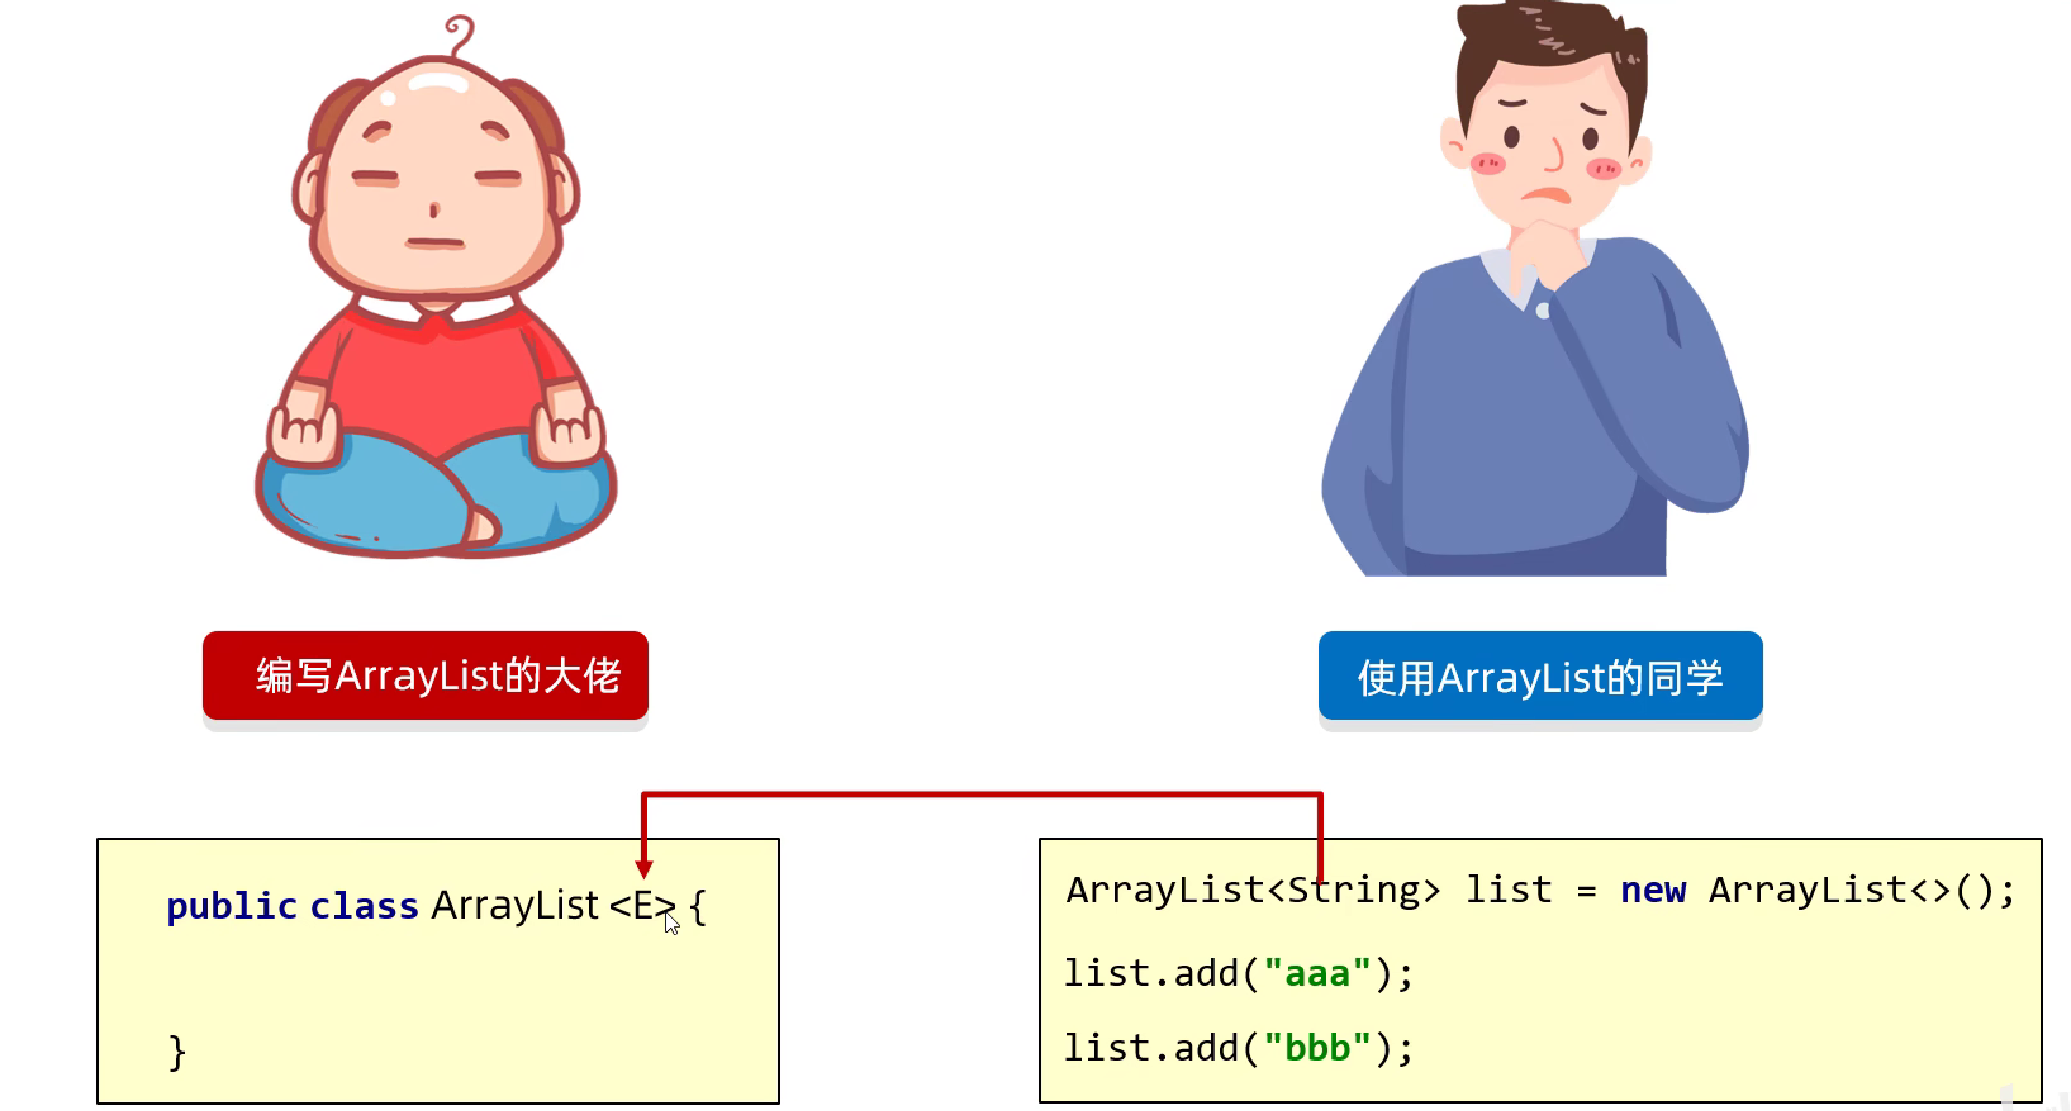
小练手(自定义一个ArrayList类,并进行调用):
//MyArrayList.java
package myCollection;

/*
*编写一个类时,若不确定类型,则该类可以定义为泛型类
* */

import java.util.Arrays;

public class MyArrayList <E>{
    Object[] obj = new Object[10];
    int size ;

    /*
    *E : 表示时不确定的类型,该类型在类名后面已经定义过了
    *e : 形参的名字,变量名
    * */
    public boolean add(E e) {
        obj[size] = e;
        size++;
        return true;
    }

    public E get(int index) {
        return (E) obj[index];
    }

    @Override
    public String toString() {
        return "MyArrayList{" +
                "obj=" + Arrays.toString(obj) +
                ", size=" + size +
                '}';
    }
}
//MyArrayListTest.java
package myCollection;

public class MyArrayListTest {
    public static void main(String[] args) {
        MyArrayList<String> myArrayList = new MyArrayList<>();
        myArrayList.add("aaa");
        myArrayList.add("bbb");
        myArrayList.add("ccc");

        System.out.println(myArrayList);
    }
}
泛型方法
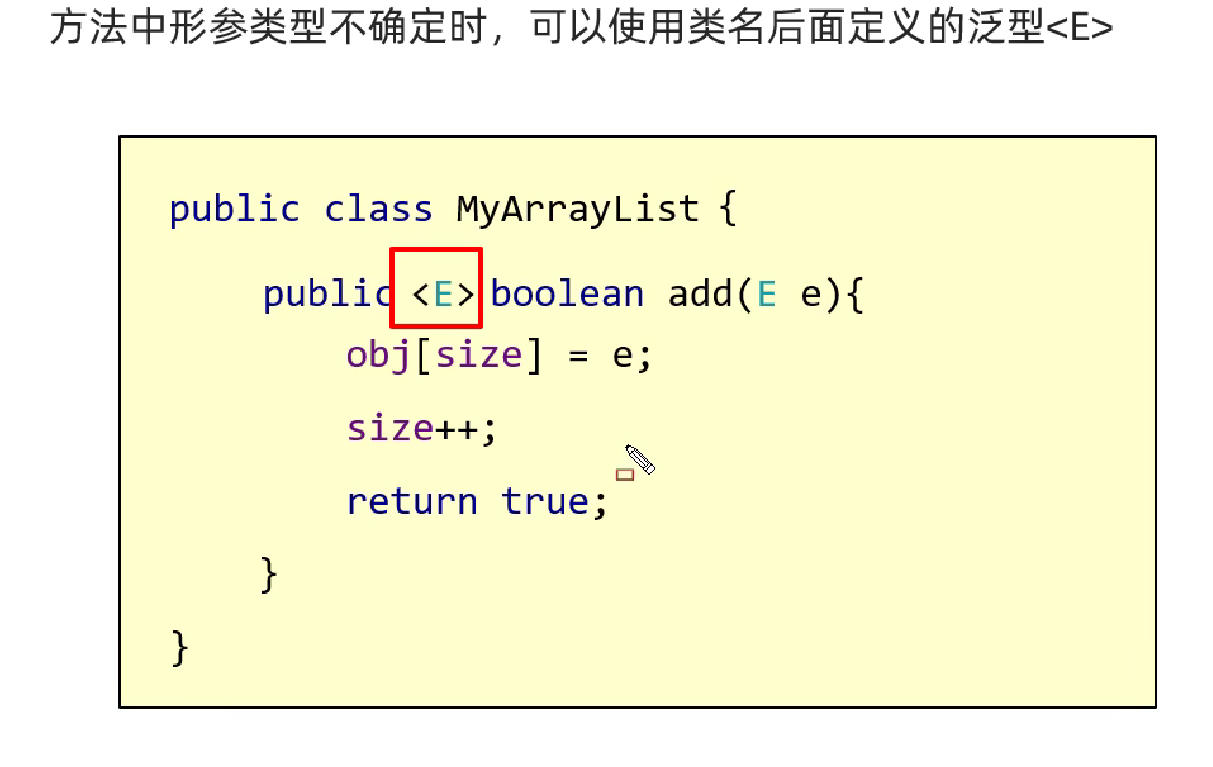
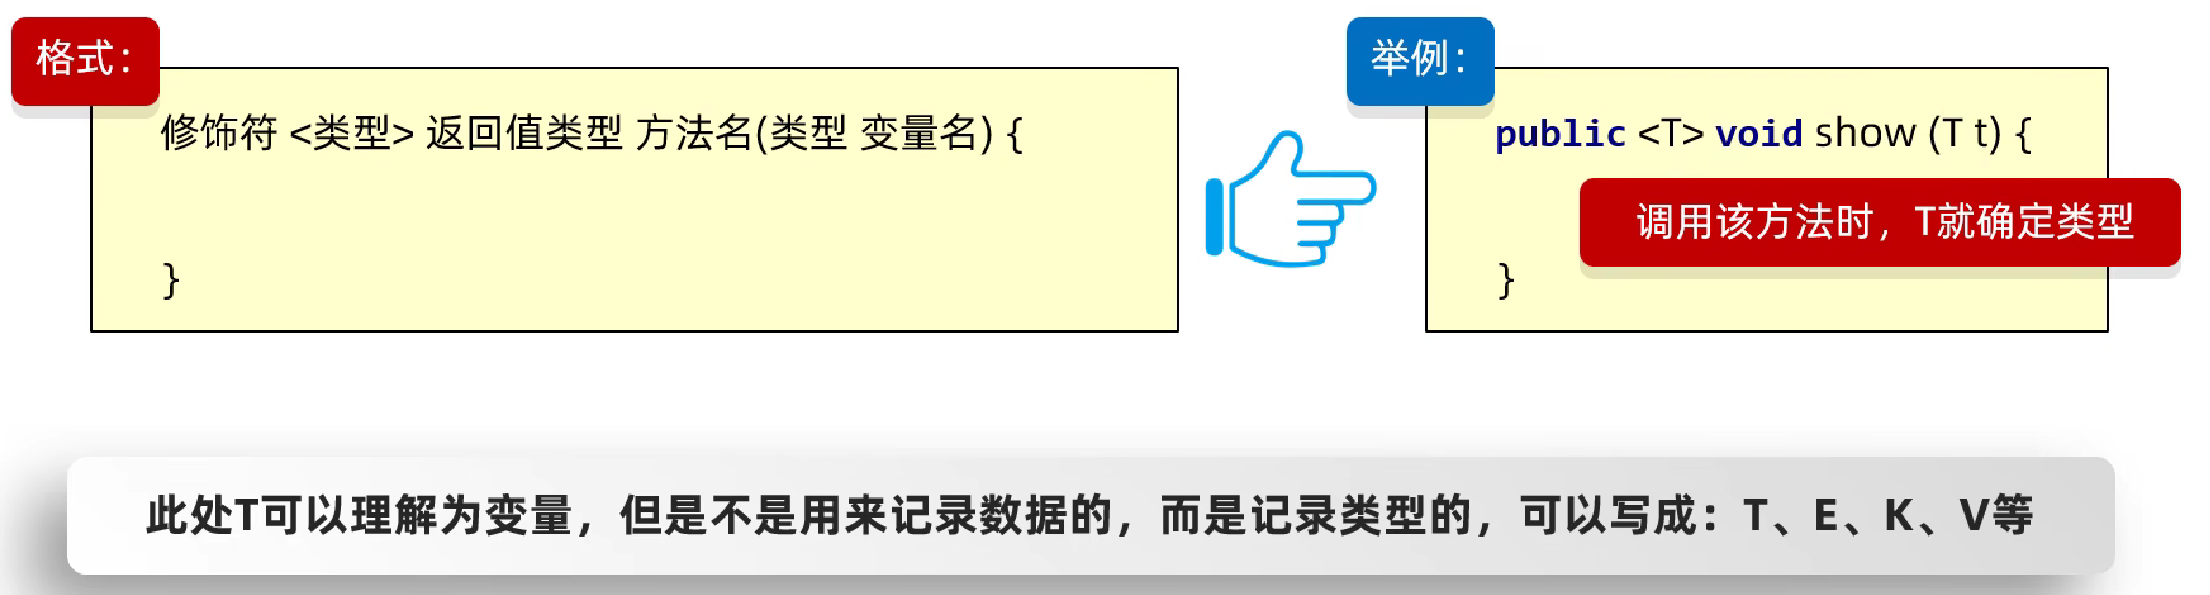
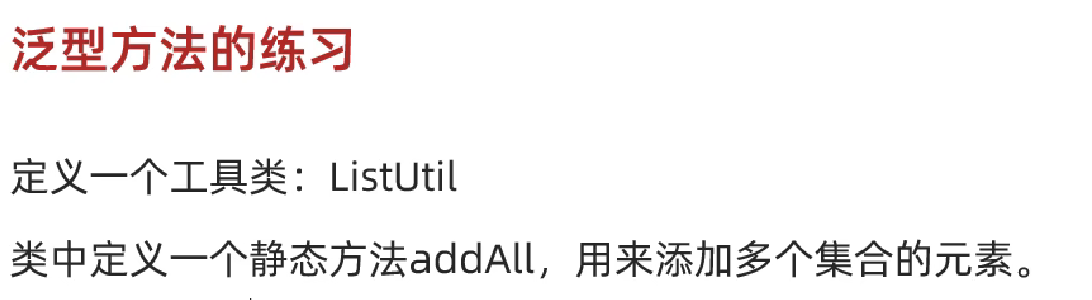
小练手(定义addAll添加多个集合元素):
//ListUtil.java
package myCollection;

import java.util.ArrayList;

public class ListUtil {
    private ListUtil() {

    }
    public static <E> void addAll(ArrayList<E> list ,E e1, E e2 ,E e3) {
        list.add(e1);
        list.add(e2);
        list.add(e3);
    }

    //不清楚所要添加元素个数时,用E...e来实现这个是一个可变参数,可以根据循环来实现添加
    public static <E> void addAll2(ArrayList<E> list ,E...e) {
        for (E element : e) {
            list.add(element);
        }
//这两种循环添加方法都可以
//        for (int i = 0; i < e.length; i++) {
//            list.add(e[i]);
//        }
    }

    public static void show(){
        System.out.println("Love yourself and love what you love!");
    }
}

//ListUtilTest.java
package myCollection;

import sun.security.util.ArrayUtil;

import java.util.ArrayList;

public class ListUtilTest {
    public static void main(String[] args) {
        ArrayList<String> li = new ArrayList<>();
        ListUtil.addAll(li,"aaa","bbb","ccc");
        System.out.println(li);

        ArrayList<Integer> li1 = new ArrayList<>();
        ListUtil.addAll2(li1,1,2,6,78,97,6);
        System.out.println(li1);
    }
}
泛型接口
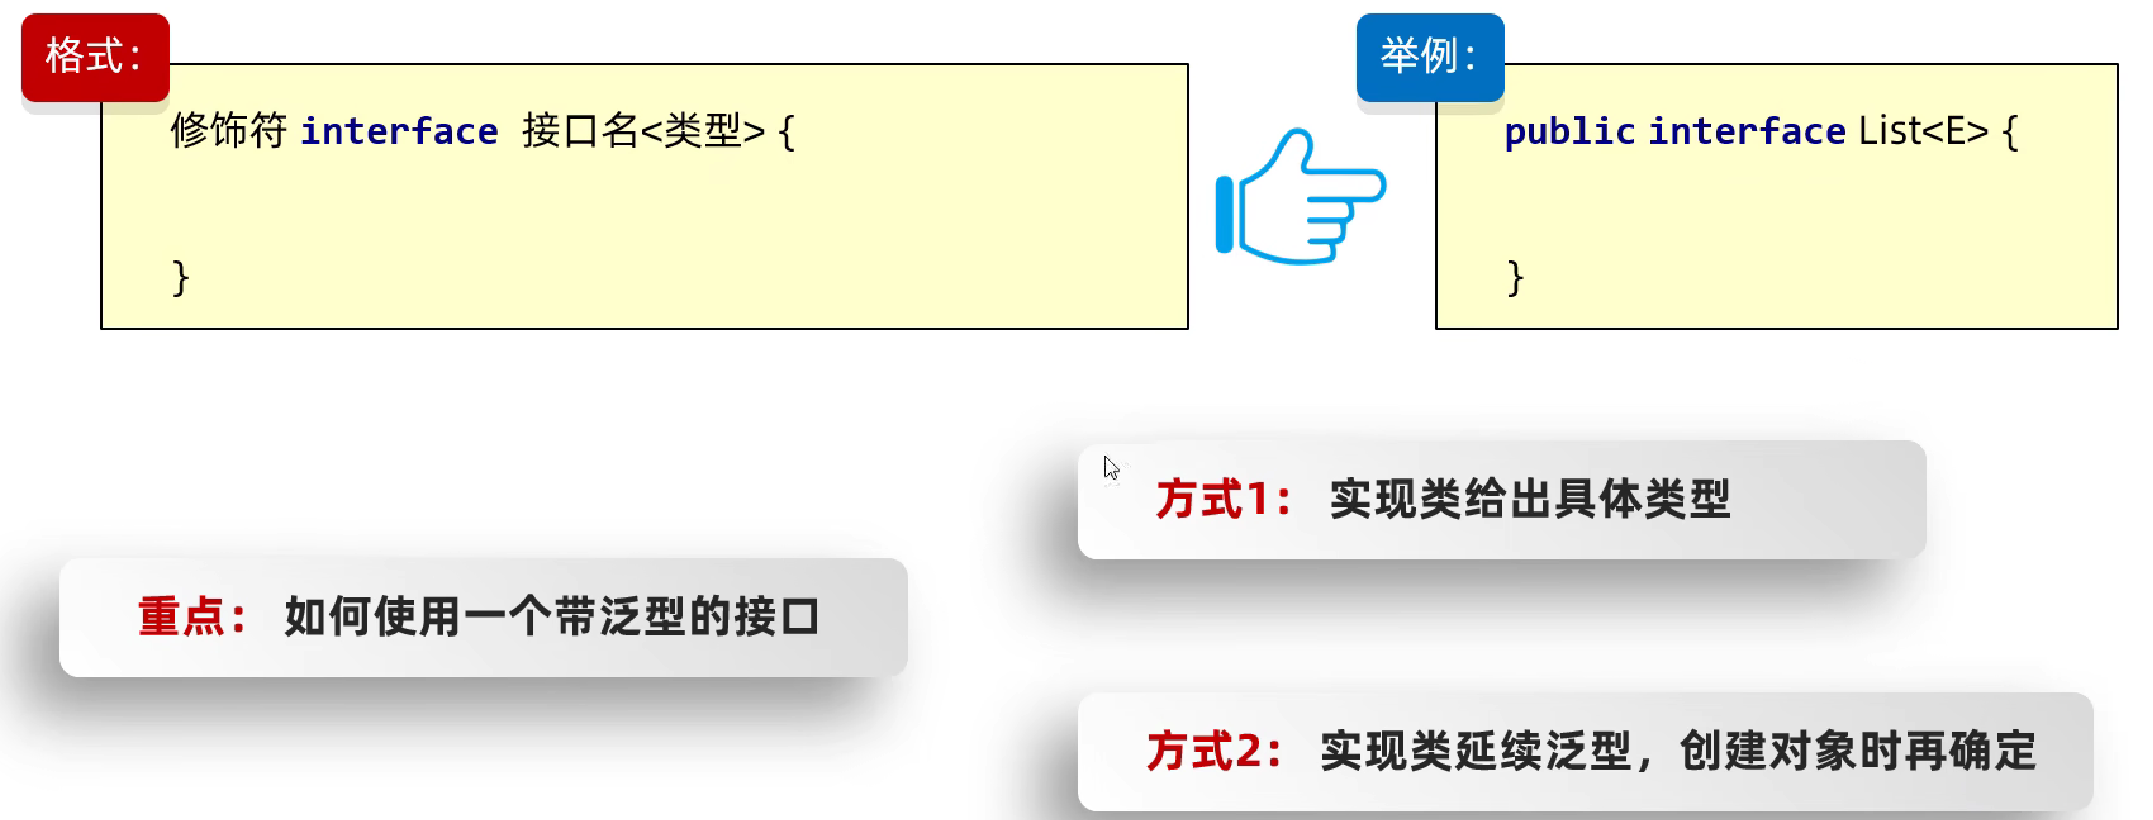
小练手(泛型接口实现):
//MyArrayList3Test.java
package myCollection;

public class MyArrayList3Test {
    public static void main(String[] args) {
        //因为在MyArrayList3中已经指定了接口类型,所以在定义的时候就不用再去说明类型
        MyArrayList3 list3 = new MyArrayList3();
        //因为在MyArrayList4用的是泛型接口,所以定义的时候就必须声明到底是哪种数据类型
        MyArrayList4<Integer> list4 = new MyArrayList4<>();
    }
}
//MyArrayList3.java
package myCollection;

import java.util.*;

public class MyArrayList3 implements List<String> {

    @Override
    public int size() {
        return 0;
    }

    @Override
    public boolean isEmpty() {
        return false;
    }

    @Override
    public boolean contains(Object o) {
        return false;
    }

    @Override
    public Iterator<String> iterator() {
        return null;
    }

    @Override
    public Object[] toArray() {
        return new Object[0];
    }

    @Override
    public <T> T[] toArray(T[] a) {
        return null;
    }

    @Override
    public boolean add(String s) {
        return false;
    }

    @Override
    public boolean remove(Object o) {
        return false;
    }

    @Override
    public boolean containsAll(Collection<?> c) {
        return false;
    }

    @Override
    public boolean addAll(Collection<? extends String> c) {
        return false;
    }

    @Override
    public boolean addAll(int index, Collection<? extends String> c) {
        return false;
    }

    @Override
    public boolean removeAll(Collection<?> c) {
        return false;
    }

    @Override
    public boolean retainAll(Collection<?> c) {
        return false;
    }

    @Override
    public void clear() {

    }

    @Override
    public String get(int index) {
        return "";
    }

    @Override
    public String set(int index, String element) {
        return "";
    }

    @Override
    public void add(int index, String element) {

    }

    @Override
    public String remove(int index) {
        return "";
    }

    @Override
    public int indexOf(Object o) {
        return 0;
    }

    @Override
    public int lastIndexOf(Object o) {
        return 0;
    }

    @Override
    public ListIterator<String> listIterator() {
        return null;
    }

    @Override
    public ListIterator<String> listIterator(int index) {
        return null;
    }

    @Override
    public List<String> subList(int fromIndex, int toIndex) {
        return Collections.emptyList();
    }
}
//MyArrayList4.java
package myCollection;

import java.util.*;

public class MyArrayList4 <E>  implements List<E> {
    @Override
    public int size() {
        return 0;
    }

    @Override
    public boolean isEmpty() {
        return false;
    }

    @Override
    public boolean contains(Object o) {
        return false;
    }

    @Override
    public Iterator<E> iterator() {
        return null;
    }

    @Override
    public Object[] toArray() {
        return new Object[0];
    }

    @Override
    public <T> T[] toArray(T[] a) {
        return null;
    }

    @Override
    public boolean add(E e) {
        return false;
    }

    @Override
    public boolean remove(Object o) {
        return false;
    }

    @Override
    public boolean containsAll(Collection<?> c) {
        return false;
    }

    @Override
    public boolean addAll(Collection<? extends E> c) {
        return false;
    }

    @Override
    public boolean addAll(int index, Collection<? extends E> c) {
        return false;
    }

    @Override
    public boolean removeAll(Collection<?> c) {
        return false;
    }

    @Override
    public boolean retainAll(Collection<?> c) {
        return false;
    }

    @Override
    public void clear() {

    }

    @Override
    public E get(int index) {
        return null;
    }

    @Override
    public E set(int index, E element) {
        return null;
    }

    @Override
    public void add(int index, E element) {

    }

    @Override
    public E remove(int index) {
        return null;
    }

    @Override
    public int indexOf(Object o) {
        return 0;
    }

    @Override
    public int lastIndexOf(Object o) {
        return 0;
    }

    @Override
    public ListIterator<E> listIterator() {
        return null;
    }

    @Override
    public ListIterator<E> listIterator(int index) {
        return null;
    }

    @Override
    public List<E> subList(int fromIndex, int toIndex) {
        return Collections.emptyList();
    }
}
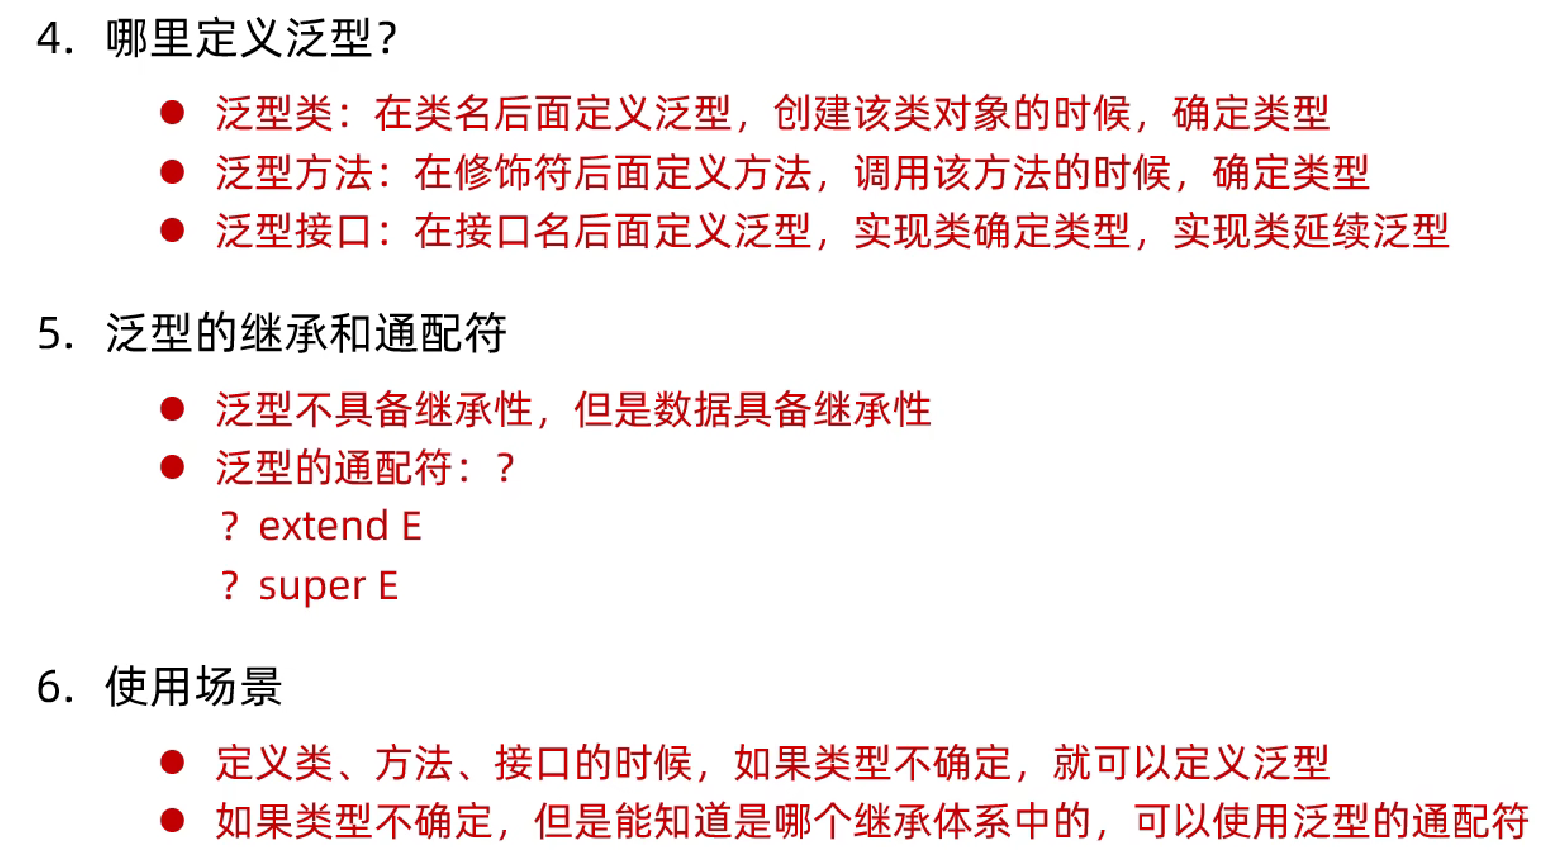
泛型的继承和通配符
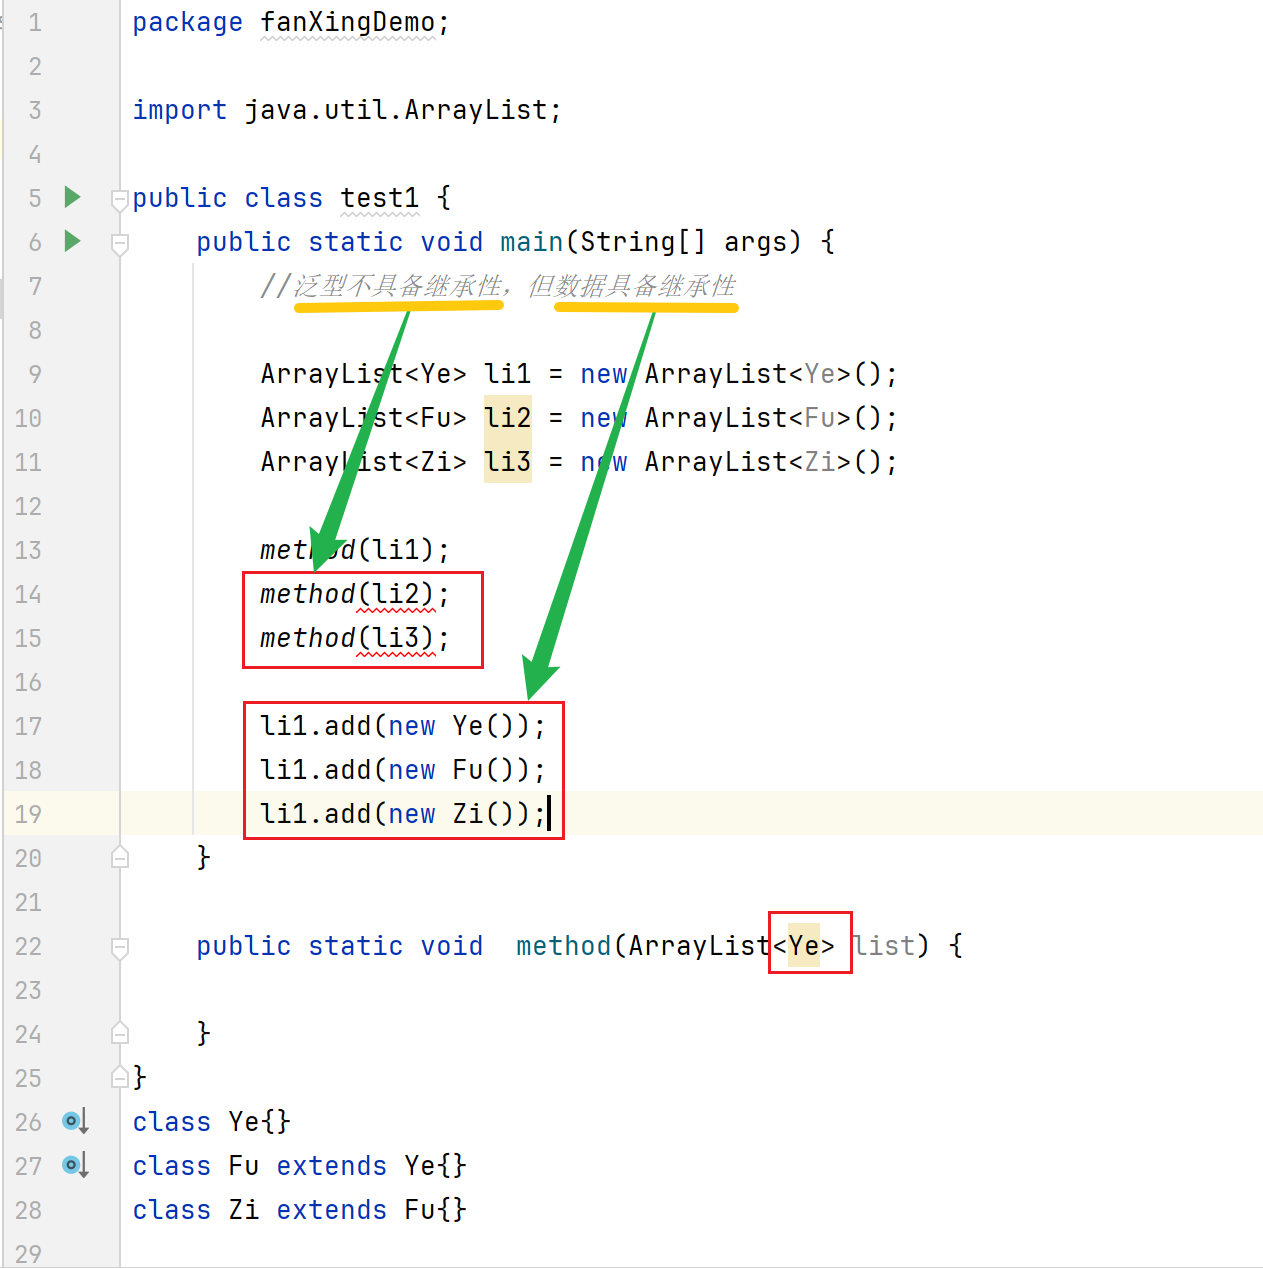
此时,泛型里面写的是什么类型,那么只能传递什么类型的数据。
弊端: 利用泛型方法有一个小弊端,此时他可以接受任意的数据类型 Ye Fu Zi Student
希望:本方法虽然不确定类型,但是以后我希望只能传递Ye Fu Zi
此时我们就可以使用泛型的通配符:
?也表示不确定的类型
它可以进行类型的限定
? extends E: 表示可以传递E或者E所有的子类类型
? super E:表示可以传递E或者E所有的父类类型
应用场景:
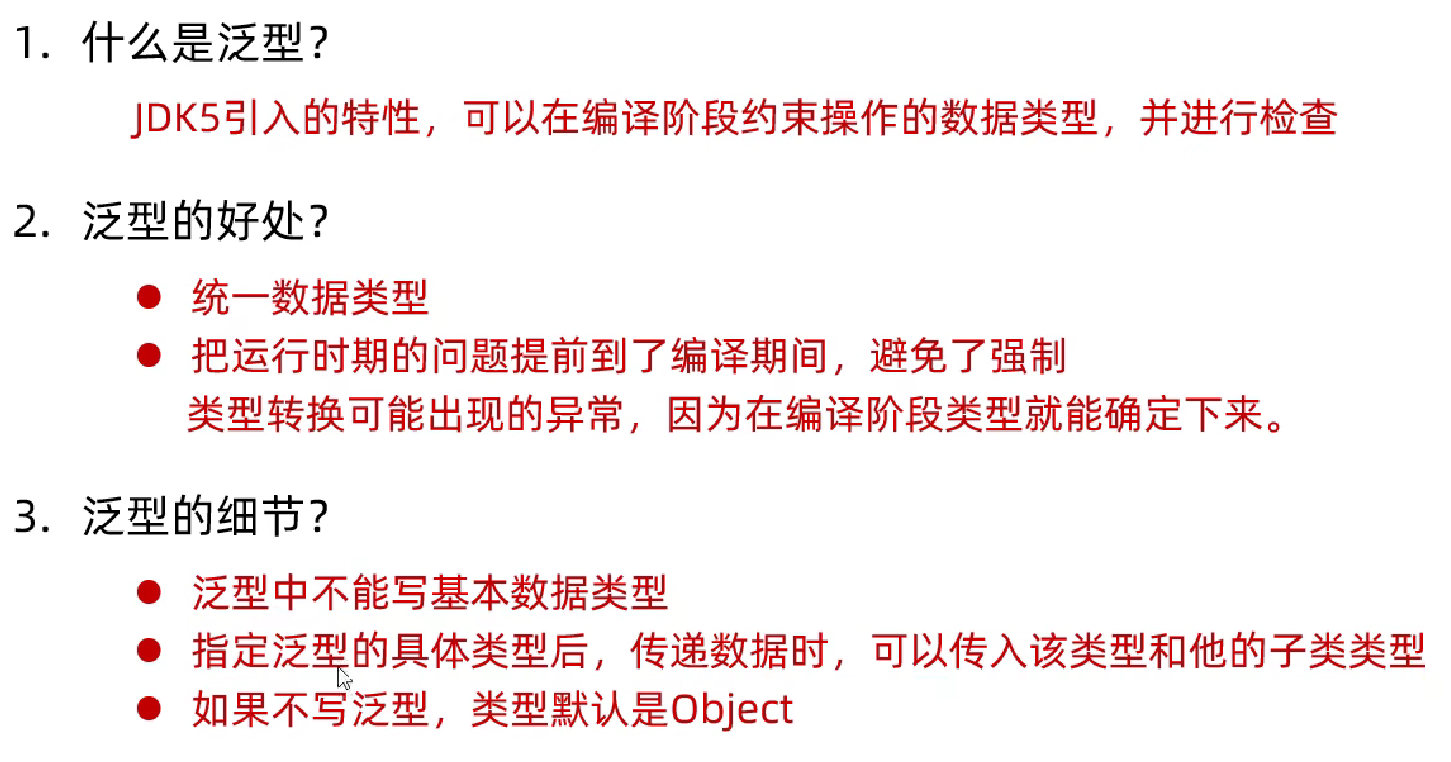
1. 如果我们在定义类、方法、接口的时候,如果类型不确定,就可以定义泛型类、泛型方法、泛型接口。
2. 如果类型不确定,但是能知道以后只能传递某个继承体系中的,就可以泛型的通配符
泛型的通配符:
关键点:可以限定类型的范围。
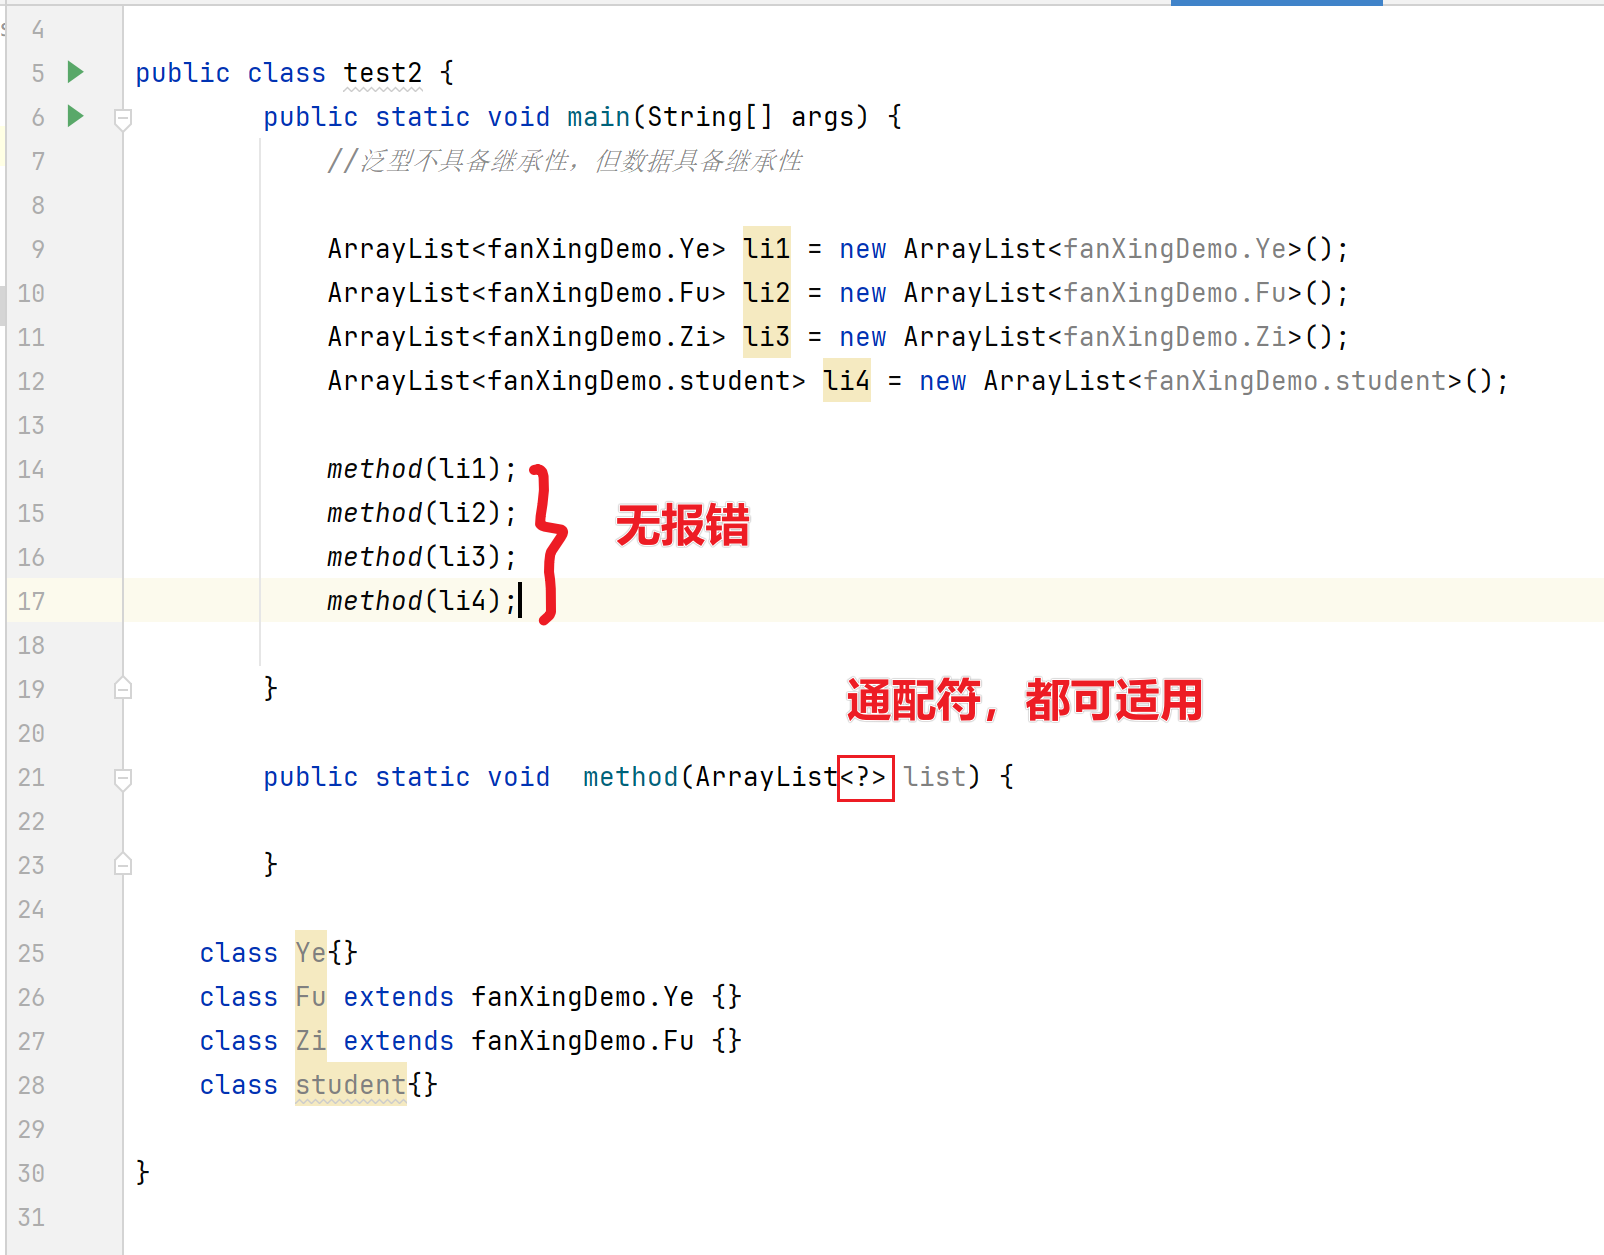
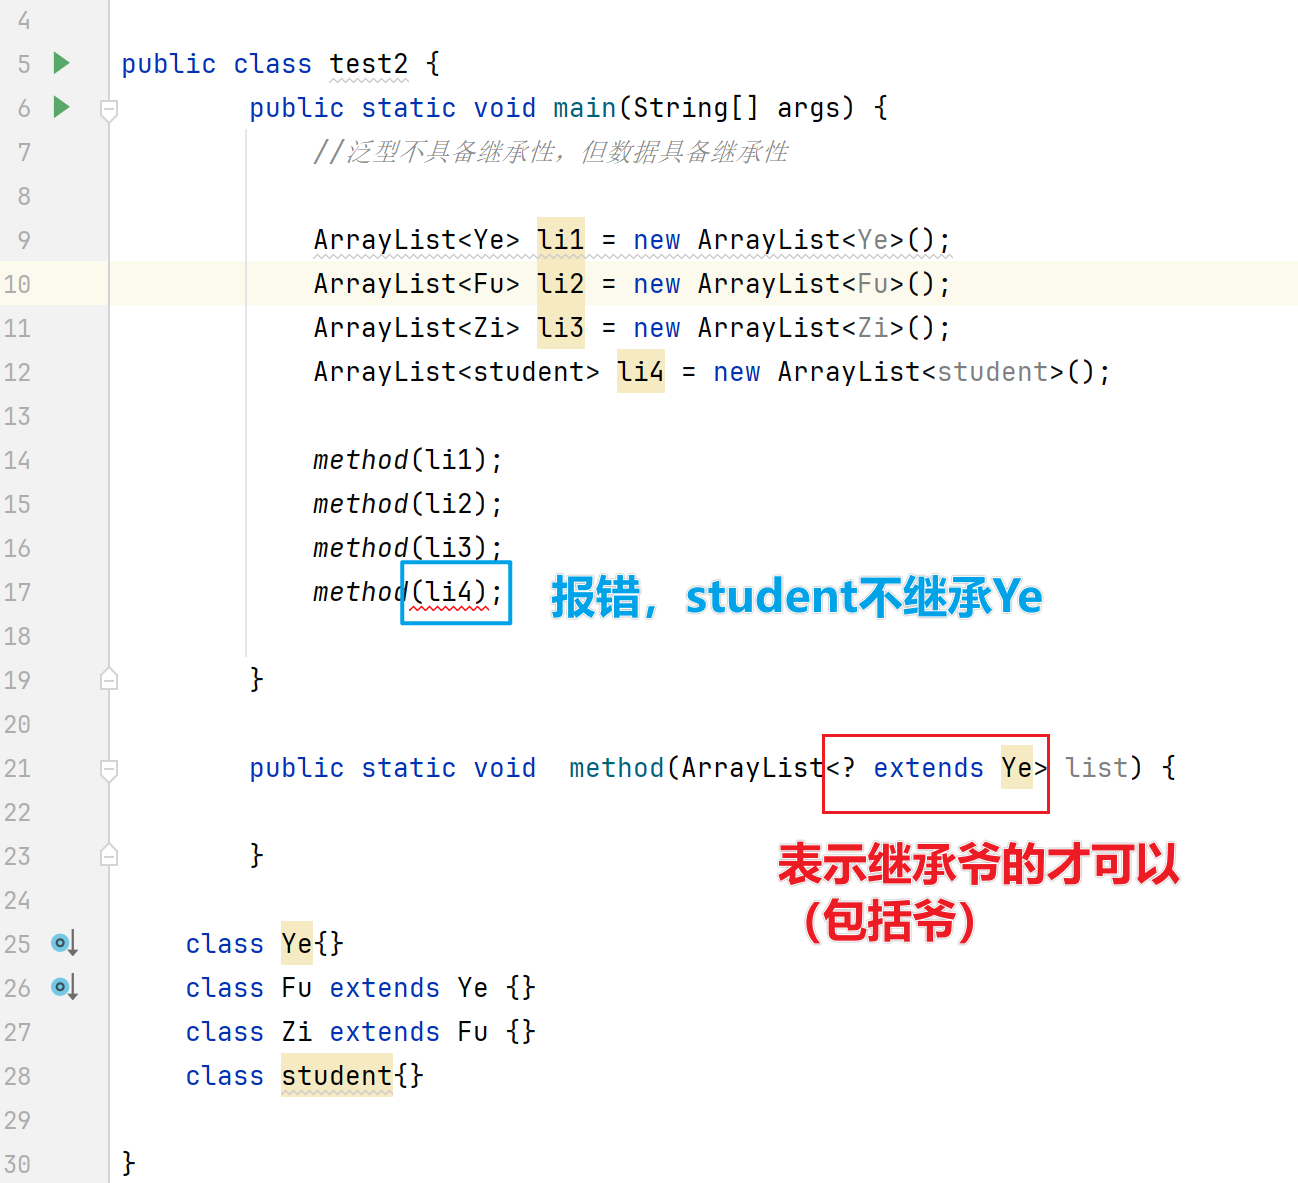
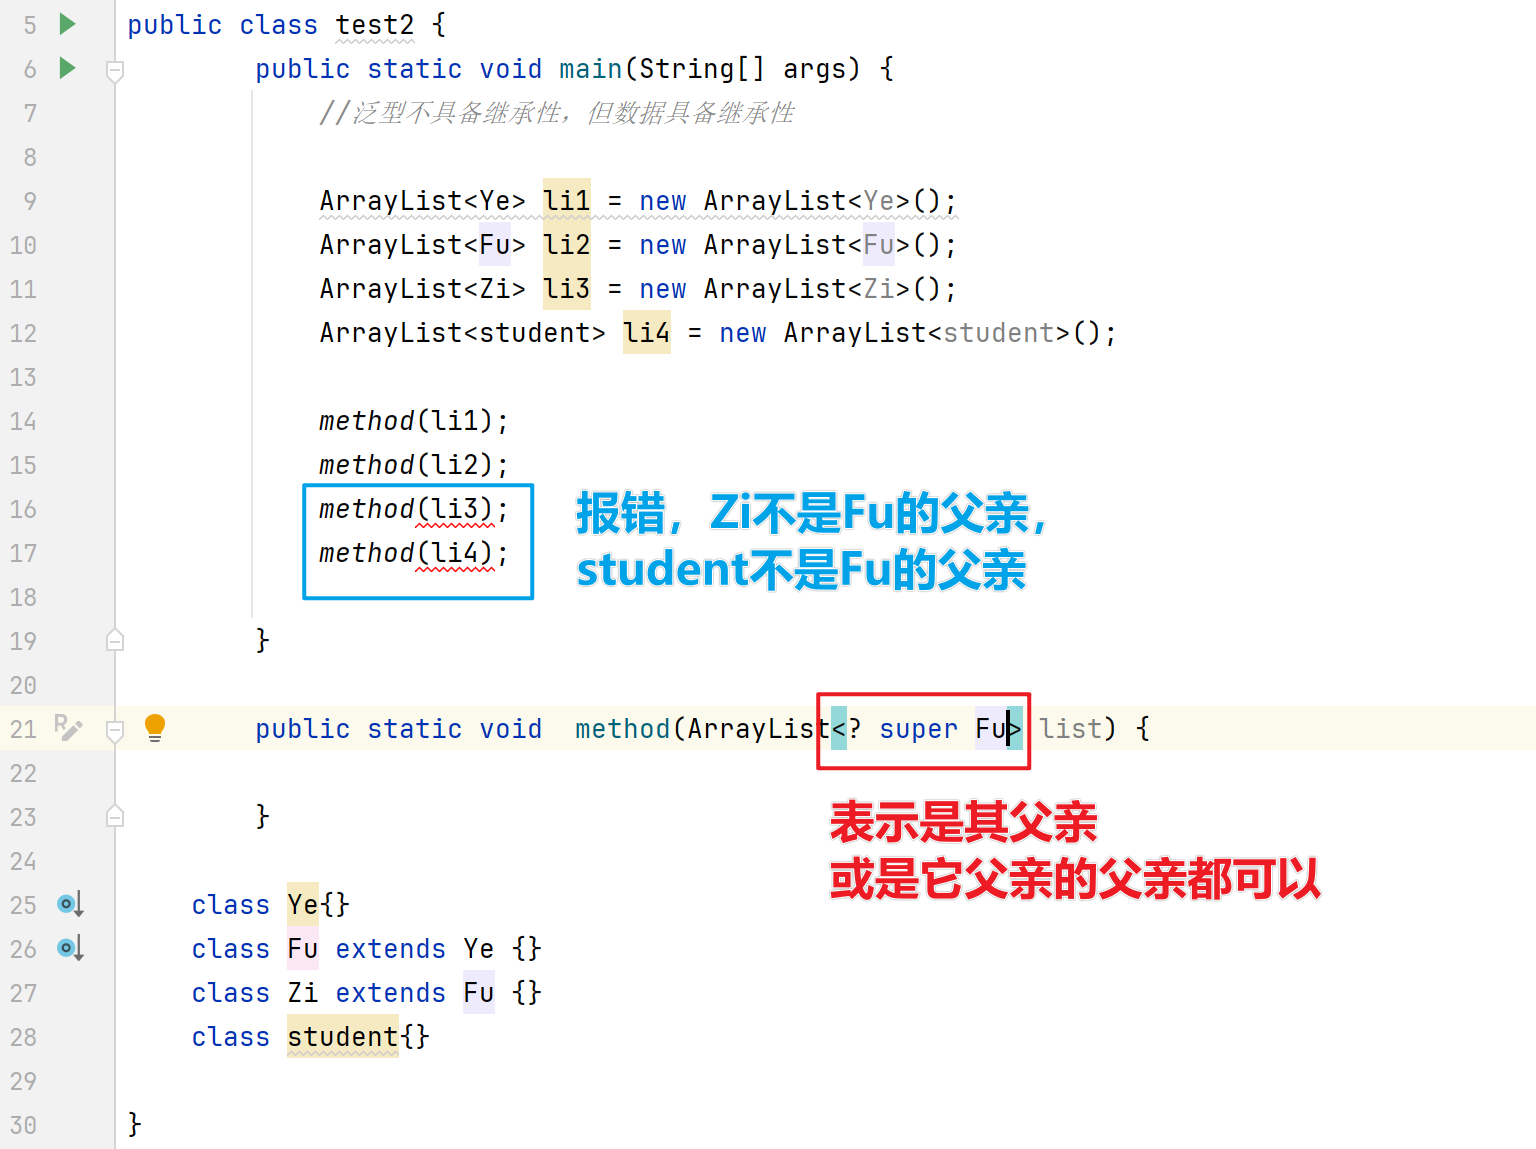
根据完整代码来体会:
package fanXingDemo;

import java.util.ArrayList;

public class test2 {
        public static void main(String[] args) {
            //泛型不具备继承性,但数据具备继承性

            ArrayList<Ye> li1 = new ArrayList<Ye>();
            ArrayList<Fu> li2 = new ArrayList<Fu>();
            ArrayList<Zi> li3 = new ArrayList<Zi>();
            ArrayList<student> li4 = new ArrayList<student>();

            method(li1);
            method(li2);
           // method(li3);
           // method(li4);

        }

        public static void  method(ArrayList<? super Fu> list) {

        }

    class Ye{}
    class Fu extends Ye {}
    class Zi extends Fu {}
    class student{}

}
综合练习
当不确定姓名和年龄的类型时可以借助泛型类。
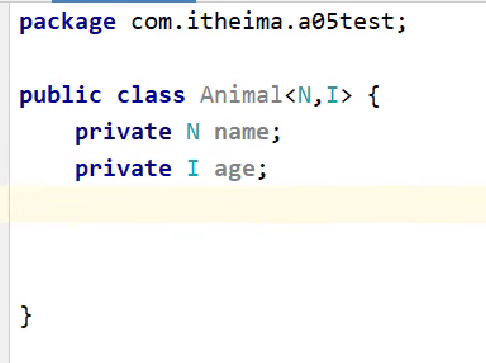
题目:
需求:
定义一个继承结构:
                         动物
                          |
                 猫              狗
                 |               |
           波斯猫  狸花猫      泰迪  哈士奇

属性:名字,年龄
行为:吃东西
波斯猫方法体打印:一只叫做XXX的,X岁的波斯猫,正在吃小饼干
狸花猫方法体打印:一只叫做XXX的,X岁的狸花猫,正在吃鱼
泰迪方法体打印:一只叫做XXX的,X岁的泰迪,正在吃骨头,边吃边蹭
哈士奇方法体打印:一只叫做XXX的,X岁的哈士奇,正在吃骨头,边吃边拆家

测试类中定义一个方法用于饲养动物
public static void keepPet(ArrayList<?> list){
    //遍历集合,调用动物的eat方法
}

要求1:该方法能养所有品种的猫,但是不能养狗
要求2:该方法能养所有品种的狗,但是不能养猫
要求3:该方法能养所有的动物,但是不能传递其他类型
代码实现:
//animal.java
package fanXingDemo;

public abstract class animal {
    private String name;
    private int age;

    public animal() {
    }

    public animal(String name, int age) {
        this.name = name;
        this.age = age;
    }

    public abstract void eat();

    /**
     * 获取
     * @return name
     */
    public String getName() {
        return name;
    }

    /**
     * 设置
     * @param name
     */
    public void setName(String name) {
        this.name = name;
    }

    /**
     * 获取
     * @return age
     */
    public int getAge() {
        return age;
    }

    /**
     * 设置
     * @param age
     */
    public void setAge(int age) {
        this.age = age;
    }

    public String toString() {
        return "animal{name = " + name + ", age = " + age + "}";
    }
}
//cat.java
package fanXingDemo;

public abstract class cat extends animal {

}
//dog.java
package fanXingDemo;

public abstract class dog extends animal{


}
//bosiCat.java
package fanXingDemo;

public class bosiCat extends cat{
    @Override
    public void eat() {
        System.out.println("一只叫做"+getName()+"的,"+getAge()+"岁的波斯猫,正在吃小饼干");
    }
}
//LihuaCat.java
package fanXingDemo;

public class LihuaCat extends cat{

    @Override
    public void eat() {
        System.out.println("一只叫做"+getName()+"的,"+getAge()+"岁的狸花猫,正在吃鱼");
    }
}
//TeddyDog.java
package fanXingDemo;

public class TeddyDog extends dog{

    @Override
    public void eat() {
        System.out.println("一只叫做"+getName()+"的,"+getAge()+"岁的泰迪,正在吃骨头,边吃边蹭");
    }
}
//HaDog.java
package fanXingDemo;

public class HaDog extends dog{

    @Override
    public void eat() {
        System.out.println("一只叫做"+getName()+"的,"+getAge()+"岁的哈士奇,正在吃骨头,边吃边拆家");
    }
}
//practiceTest.java
package fanXingDemo;

import java.util.ArrayList;

public class practiceTest {
    public static void main(String[] args) {
        /*
            需求:
            定义一个继承结构:
                                     动物
                                      |
                             猫              狗
                             |               |
                       波斯猫  狸花猫      泰迪  哈士奇

            属性:名字,年龄
            行为:吃东西
            波斯猫方法体打印:一只叫做XXX的,X岁的波斯猫,正在吃小饼干
            狸花猫方法体打印:一只叫做XXX的,X岁的狸花猫,正在吃鱼
            泰迪方法体打印:一只叫做XXX的,X岁的泰迪,正在吃骨头,边吃边蹭
            哈士奇方法体打印:一只叫做XXX的,X岁的哈士奇,正在吃骨头,边吃边拆家

            测试类中定义一个方法用于饲养动物
            public static void keepPet(ArrayList<?> list){
                //遍历集合,调用动物的eat方法
            }

            要求1:该方法能养所有品种的猫,但是不能养狗
            要求2:该方法能养所有品种的狗,但是不能养猫
            要求3:该方法能养所有的动物,但是不能传递其他类型

        */
        ArrayList<LihuaCat> li1 = new ArrayList<>();
        ArrayList<bosiCat> li2 = new ArrayList<>();
        ArrayList<TeddyDog> li3 = new ArrayList<>();
        ArrayList<HaDog> li4 = new ArrayList<>();

        keepPet(li1);
        keepPet(li2);
        keepPet(li3);
        keepPet(li4);

    }
    //要求1:该方法能养所有品种的猫,但是不能养狗
//    public static void keepPet(ArrayList<? extends cat> list){
//        //遍历集合,调用动物的eat方法
//    }
    //要求2:该方法能养所有品种的狗,但是不能养猫
//    public static void keepPet(ArrayList<? extends dog> list){
//        //遍历集合,调用动物的eat方法
//    }
    //要求1:该方法能养所有品种的猫,但是不能养狗
    public static void keepPet(ArrayList<? extends animal> list){
        //遍历集合,调用动物的eat方法
    }
}
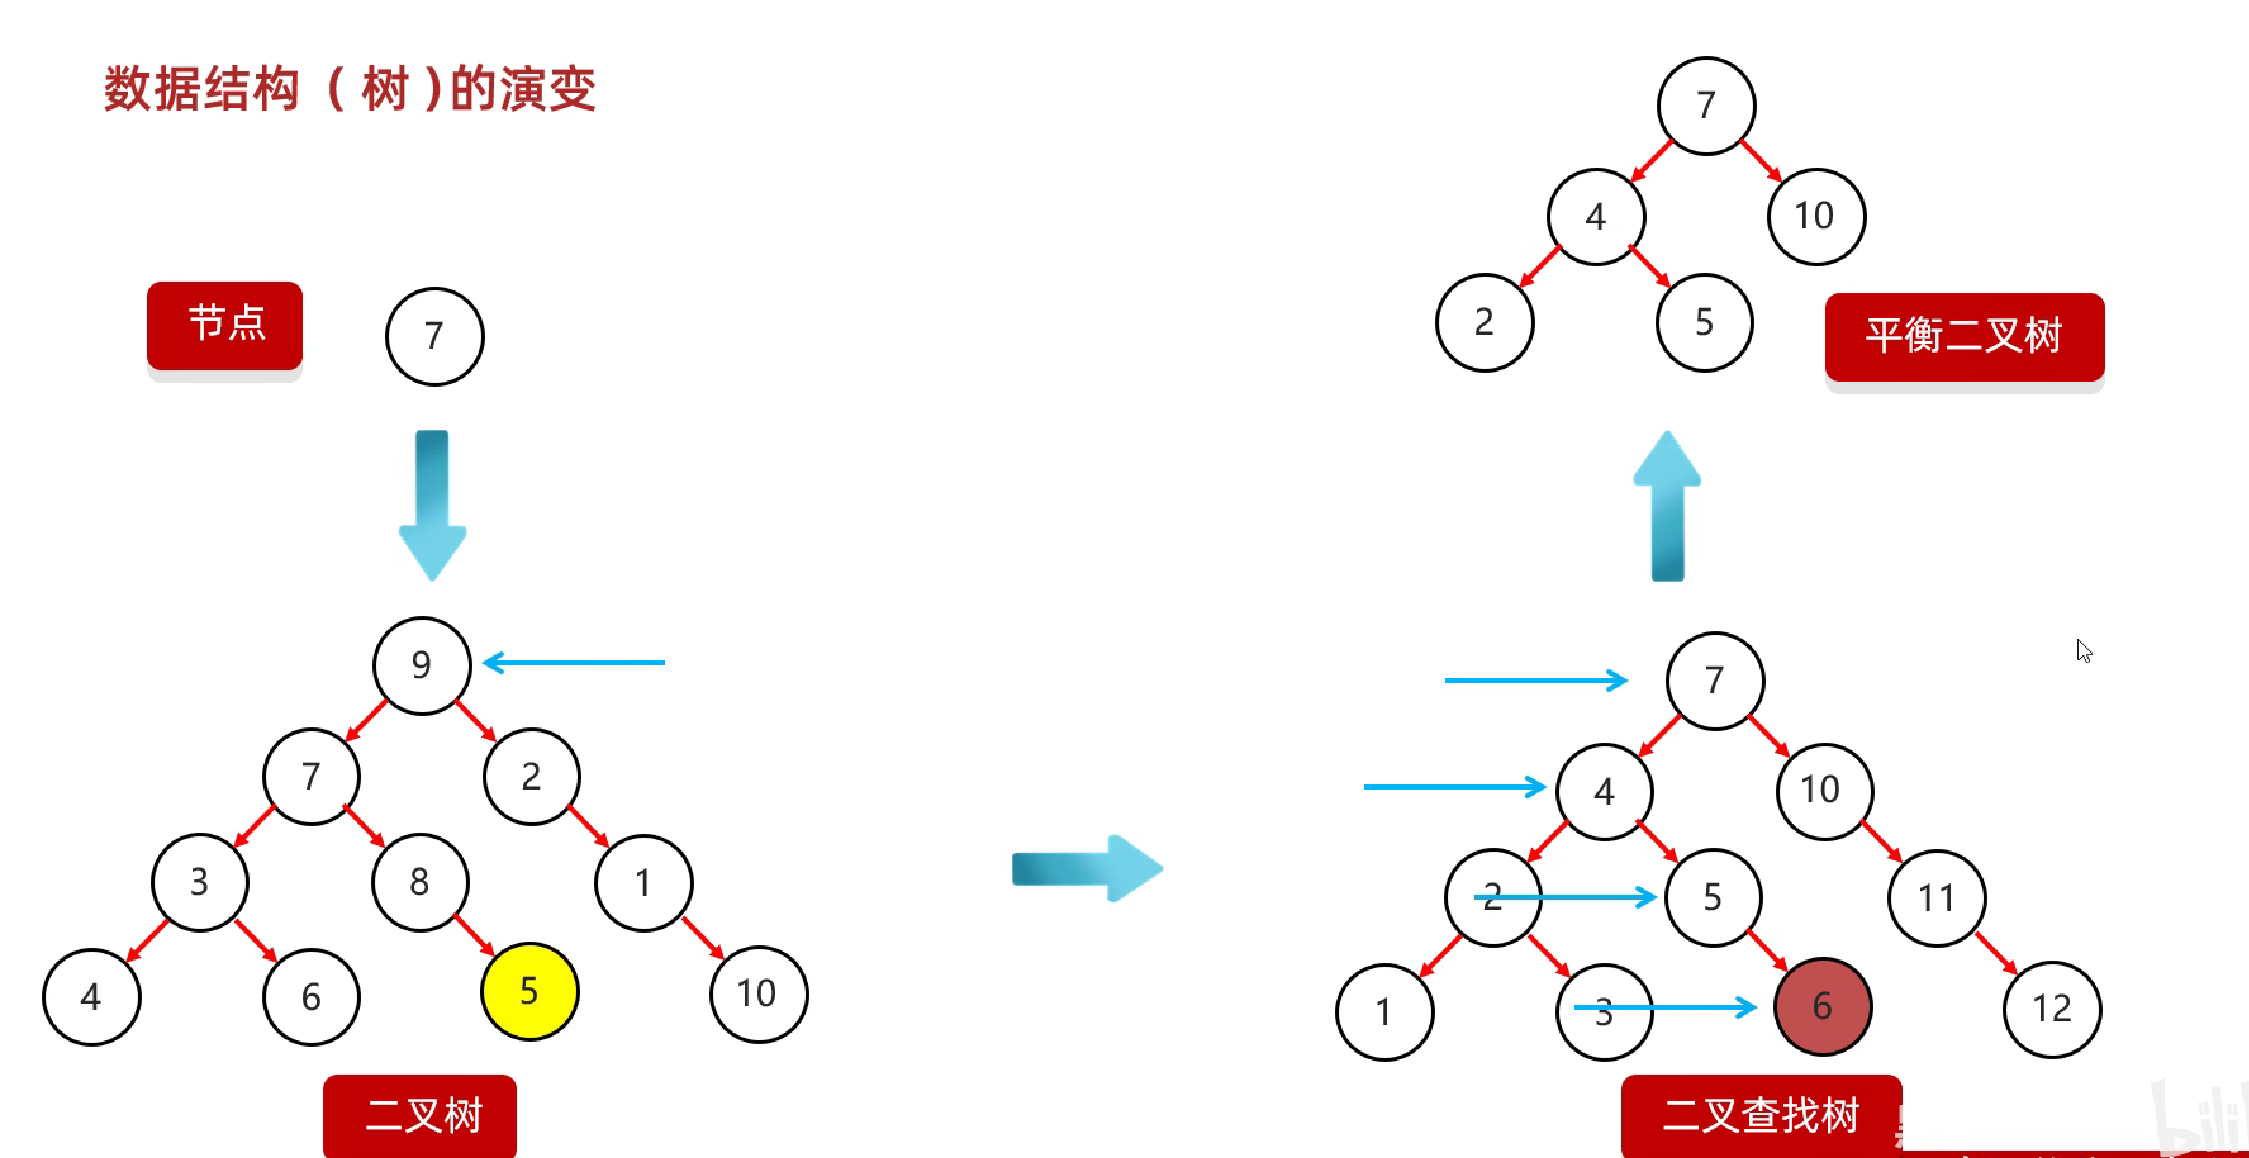
数据结构(二叉树、二叉查找树、二叉平衡树)
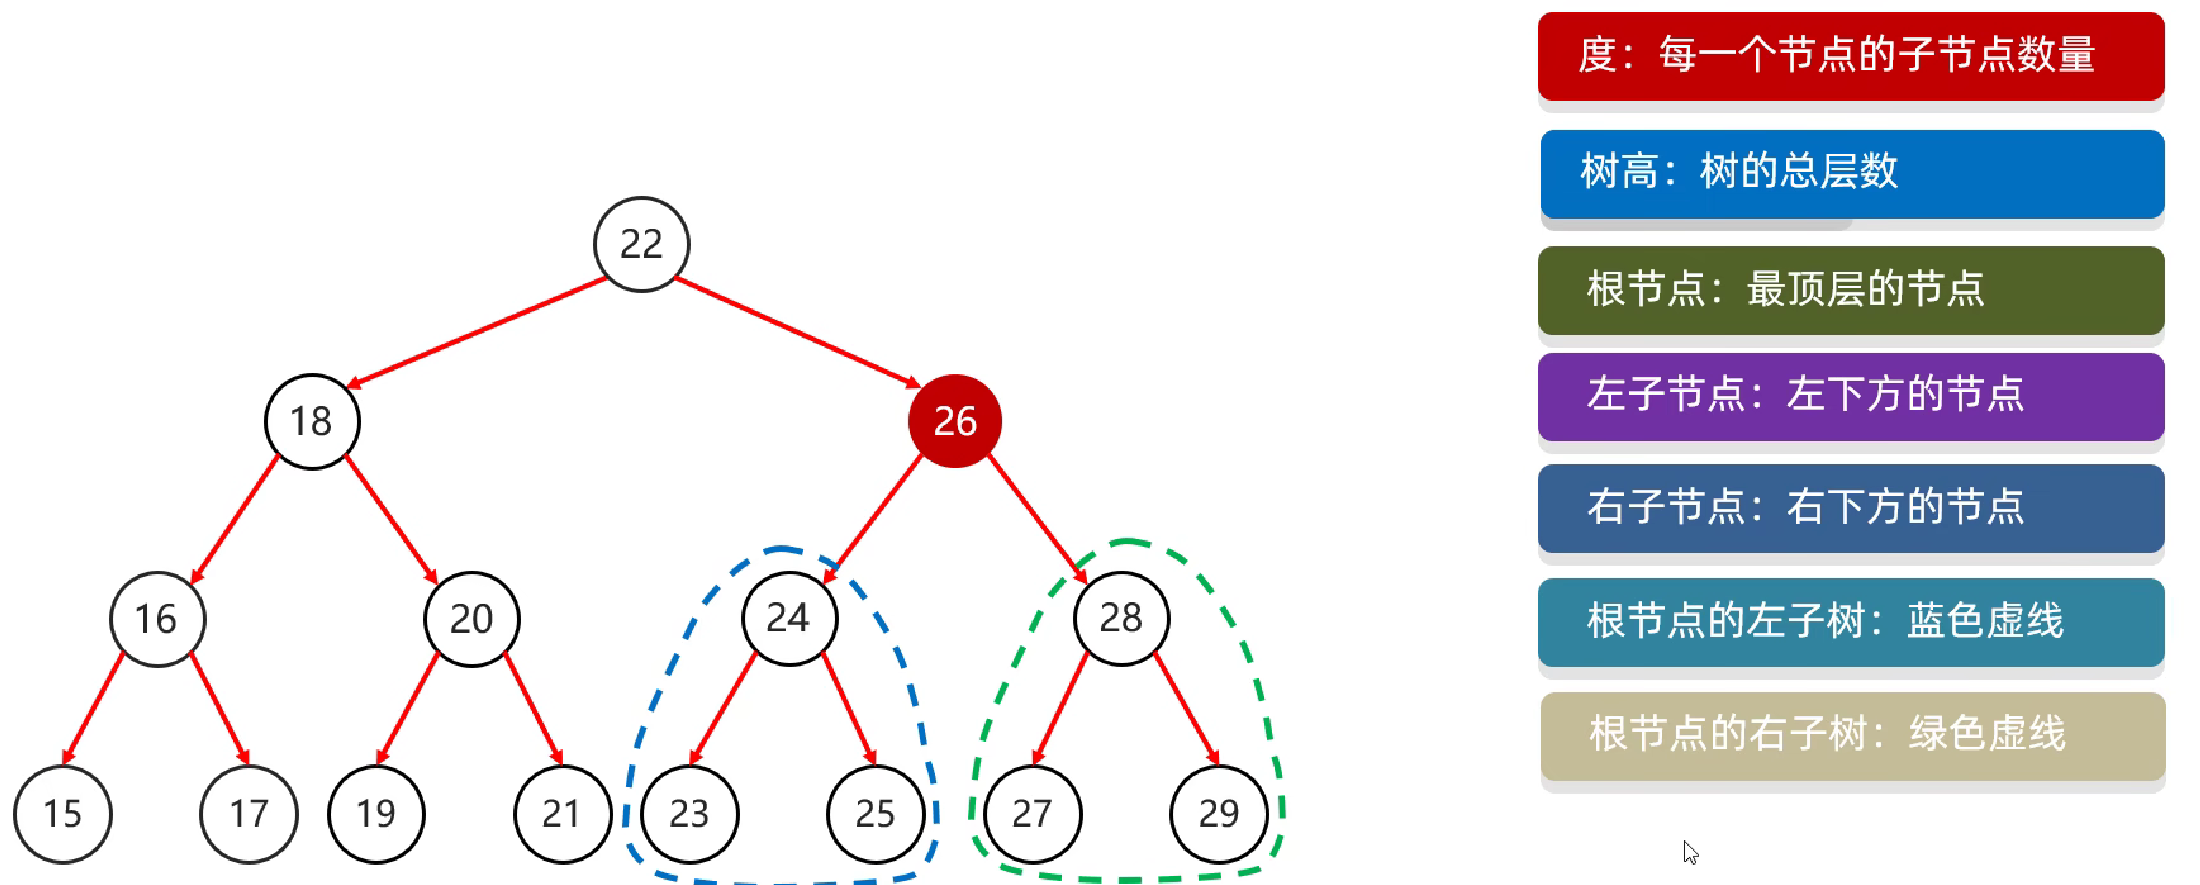
二叉树
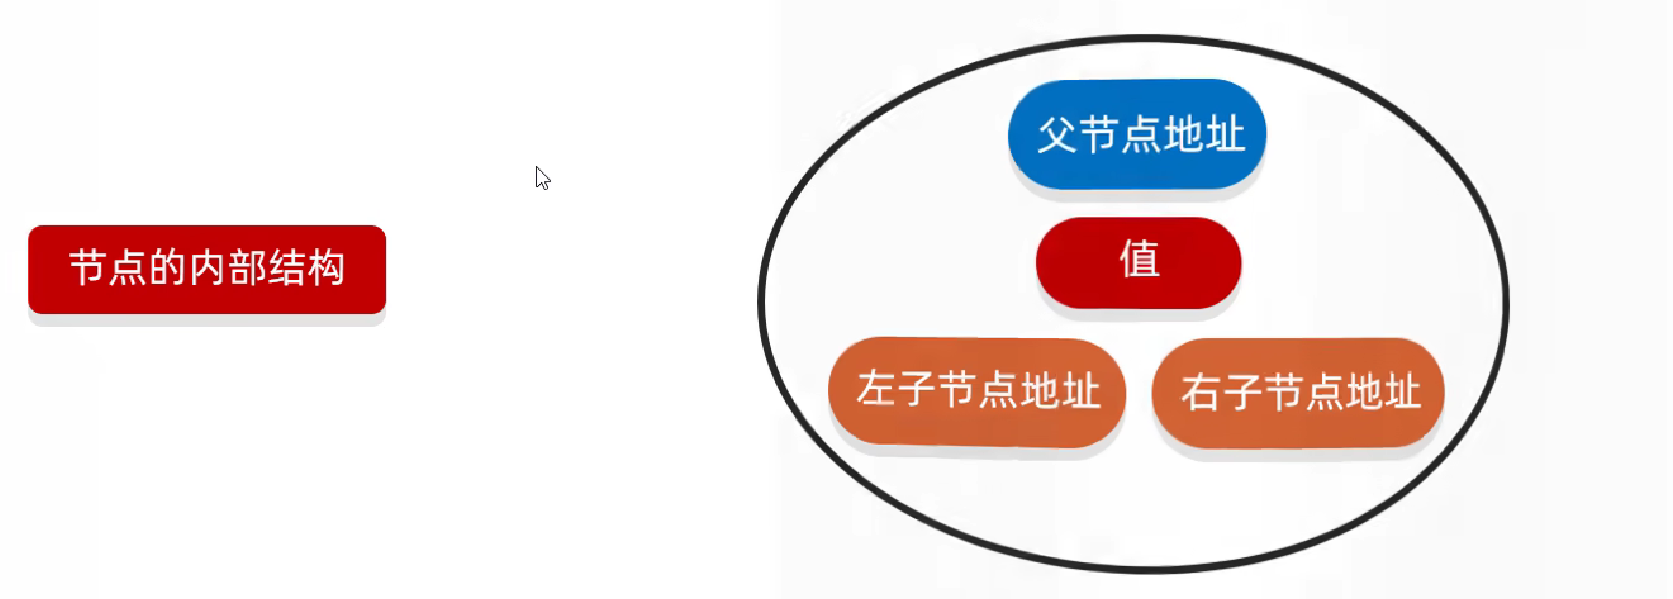
二叉树内部结构:
二叉查找树
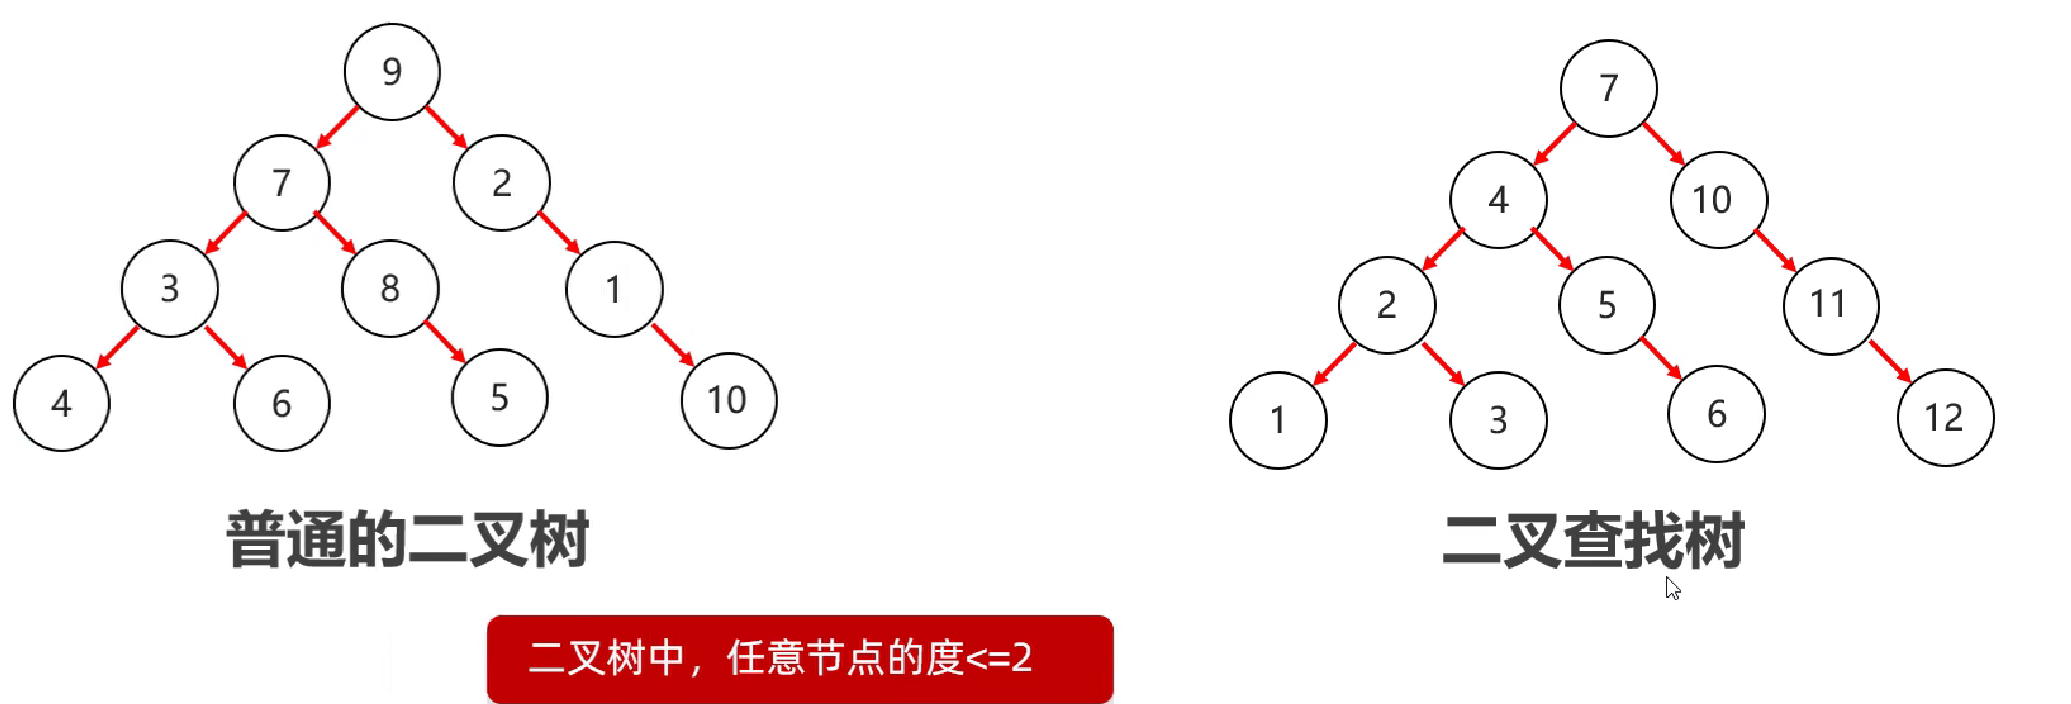
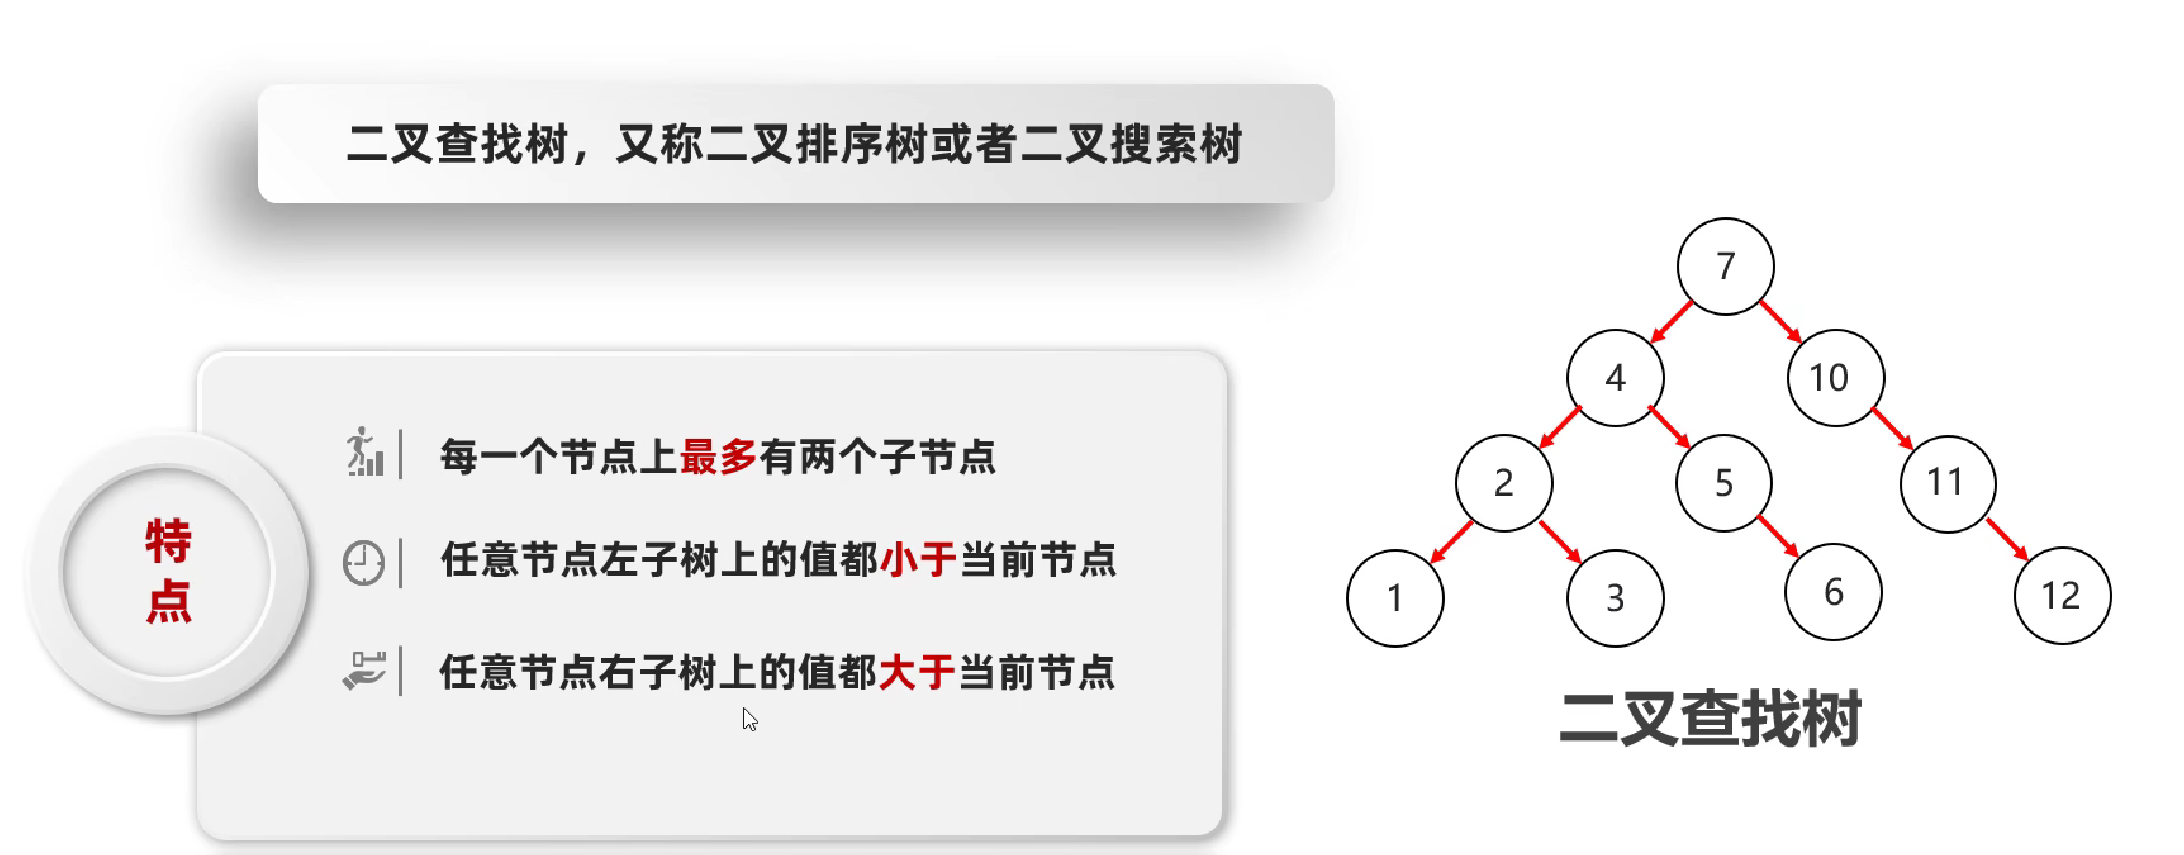
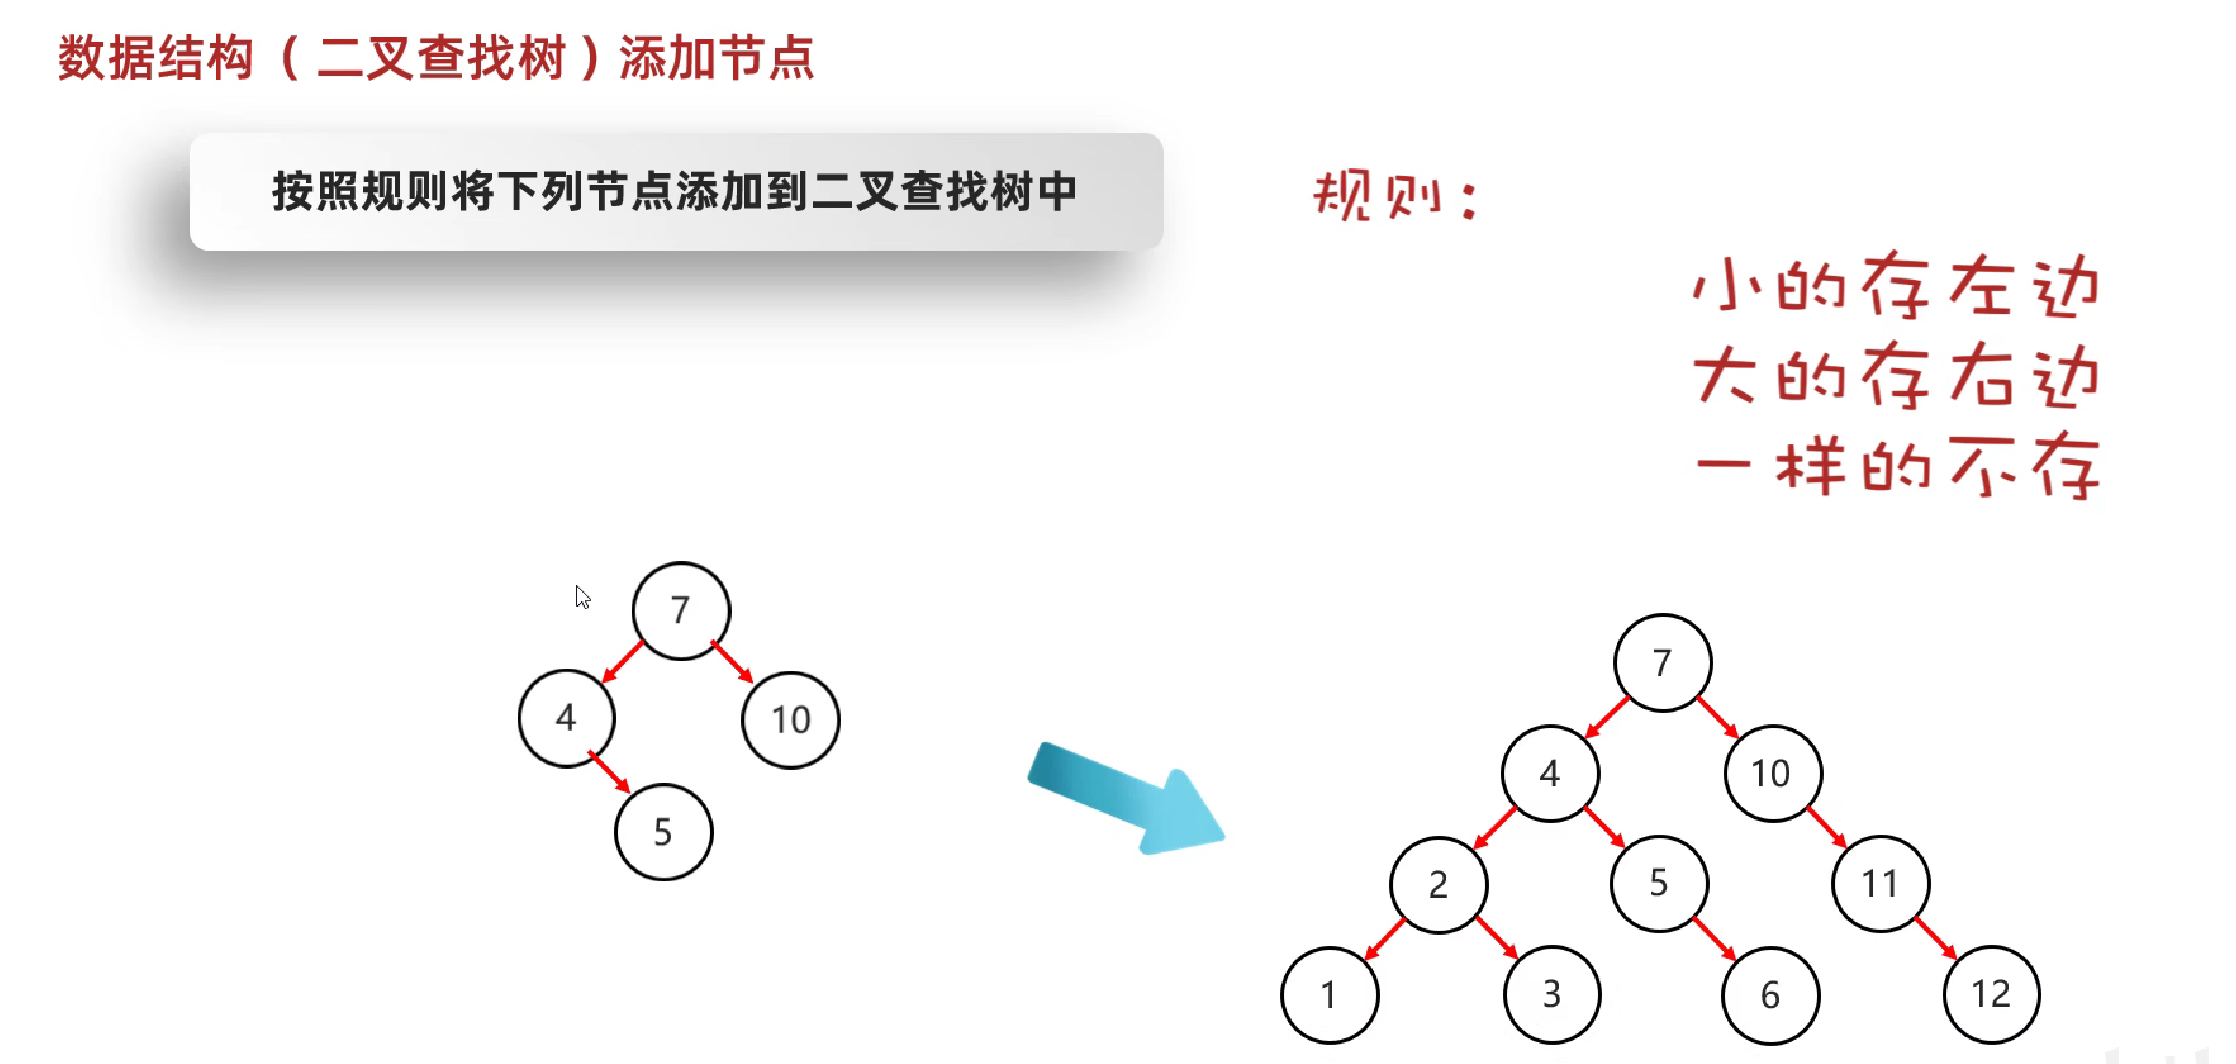
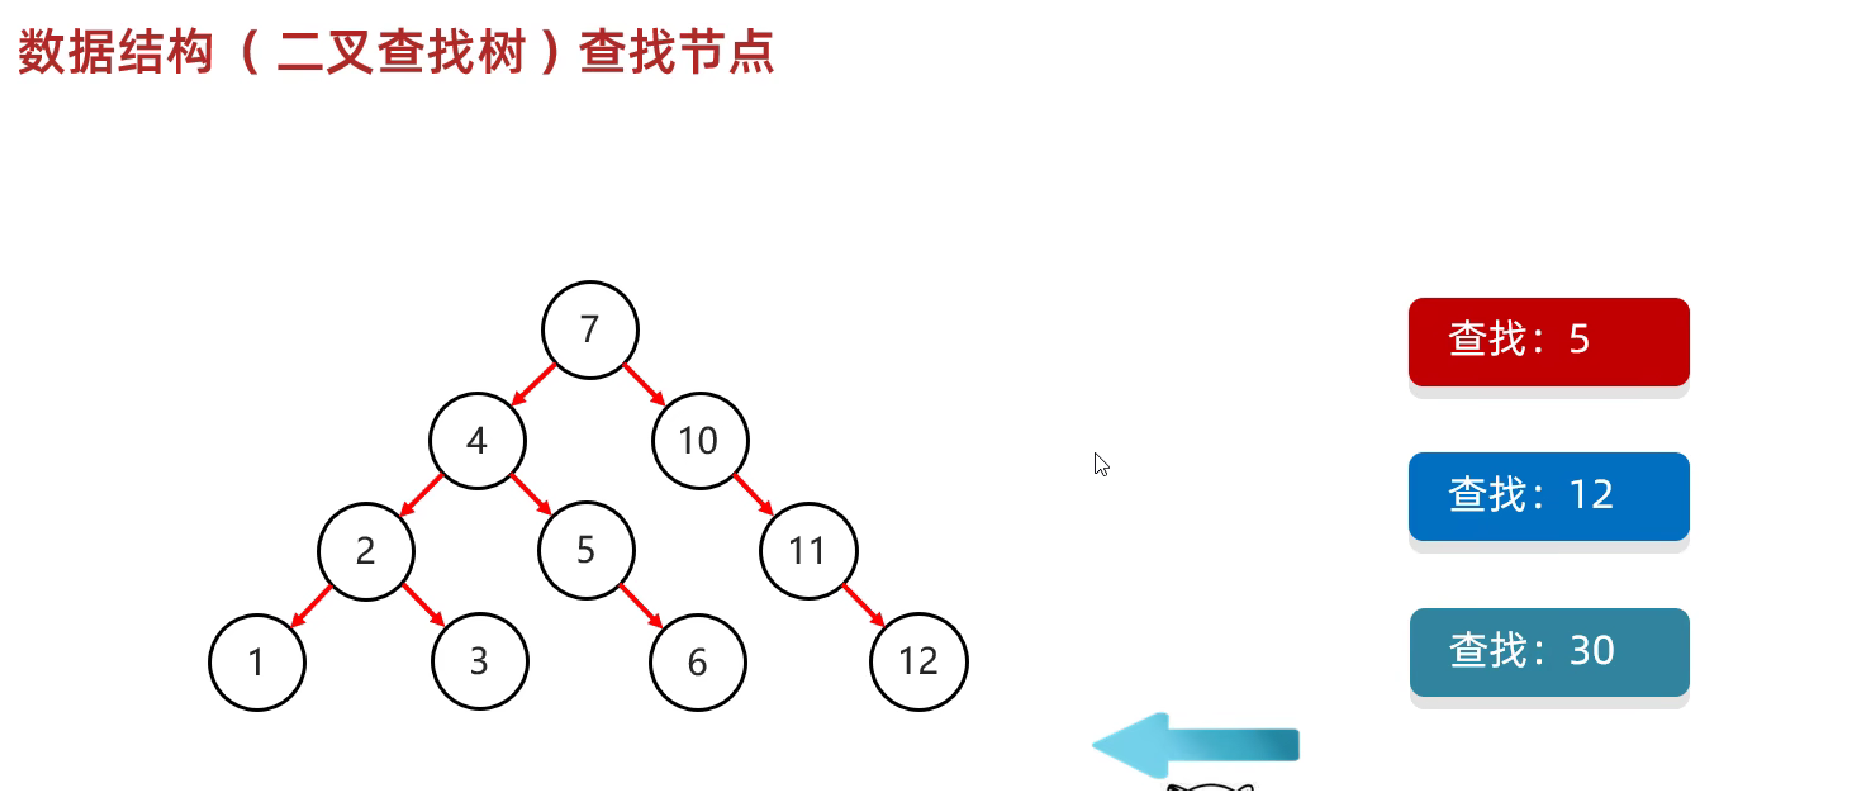
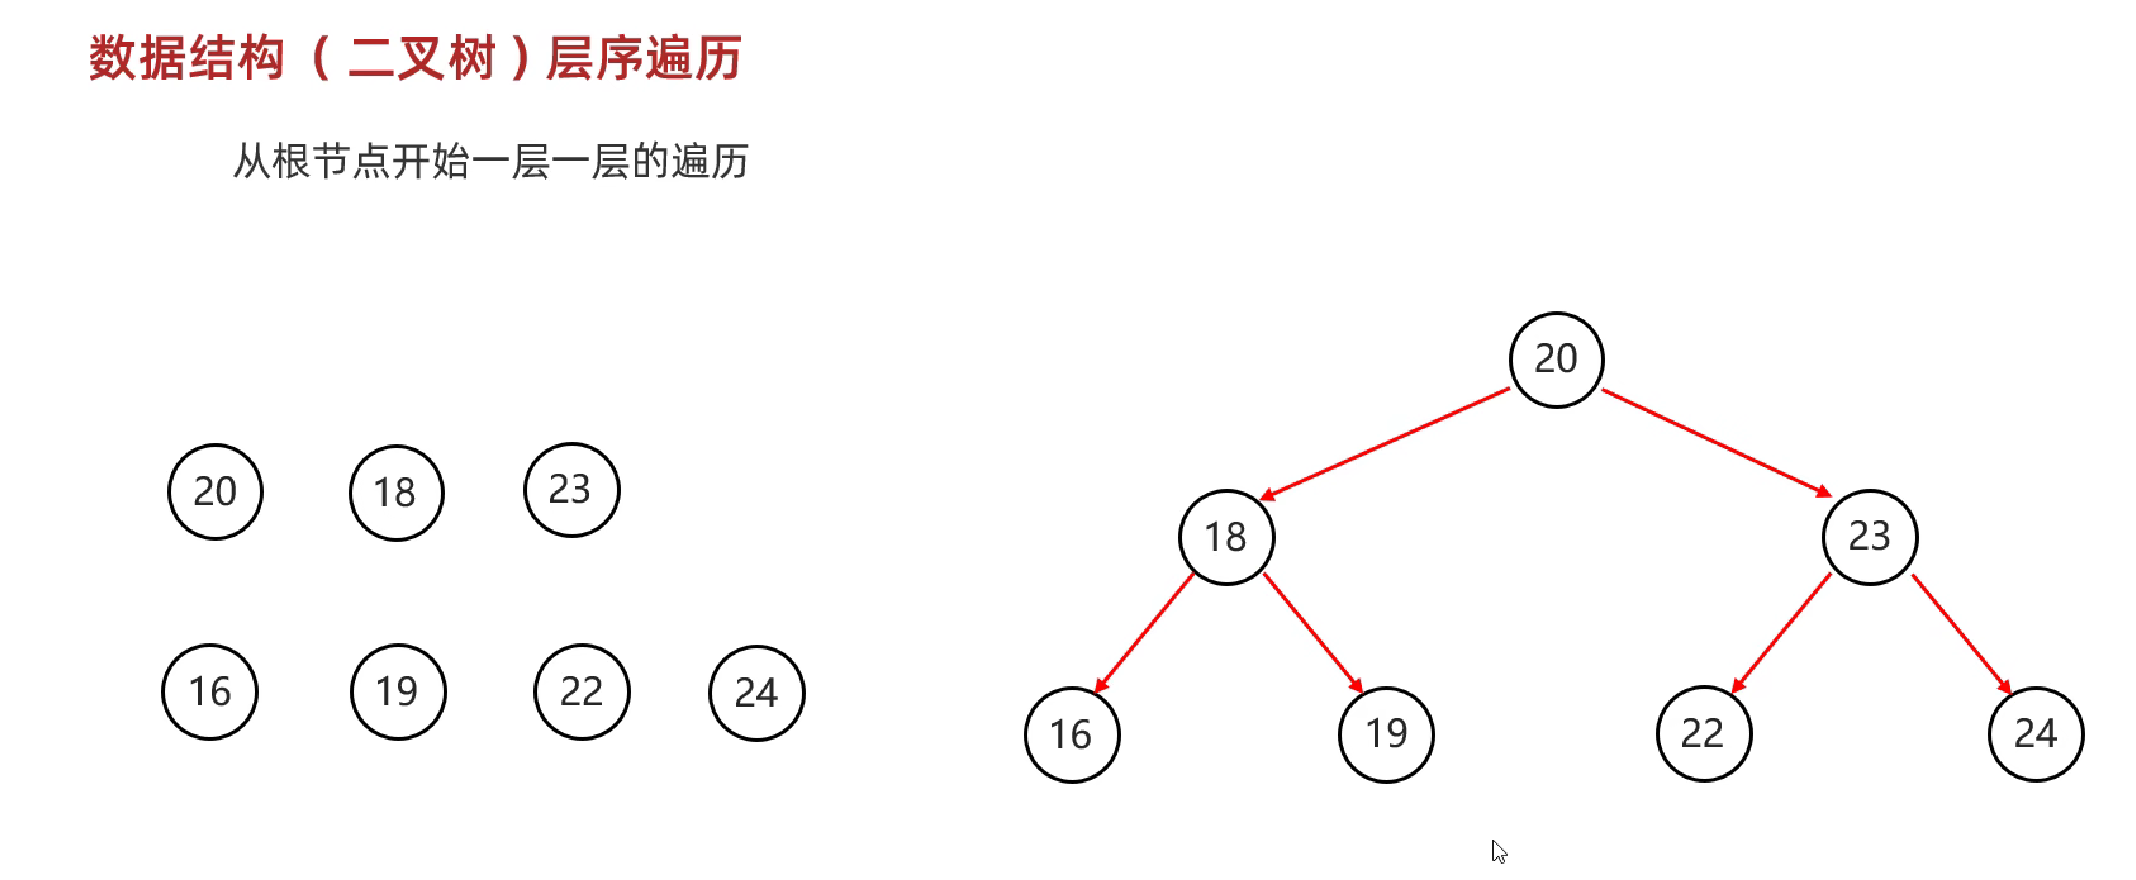
先去和根节点的值进行比较,看是否大或小,大的话就去右子树查找,小的话就去左子树进行查找,之后再依次重复以上操作,直到找到为止。
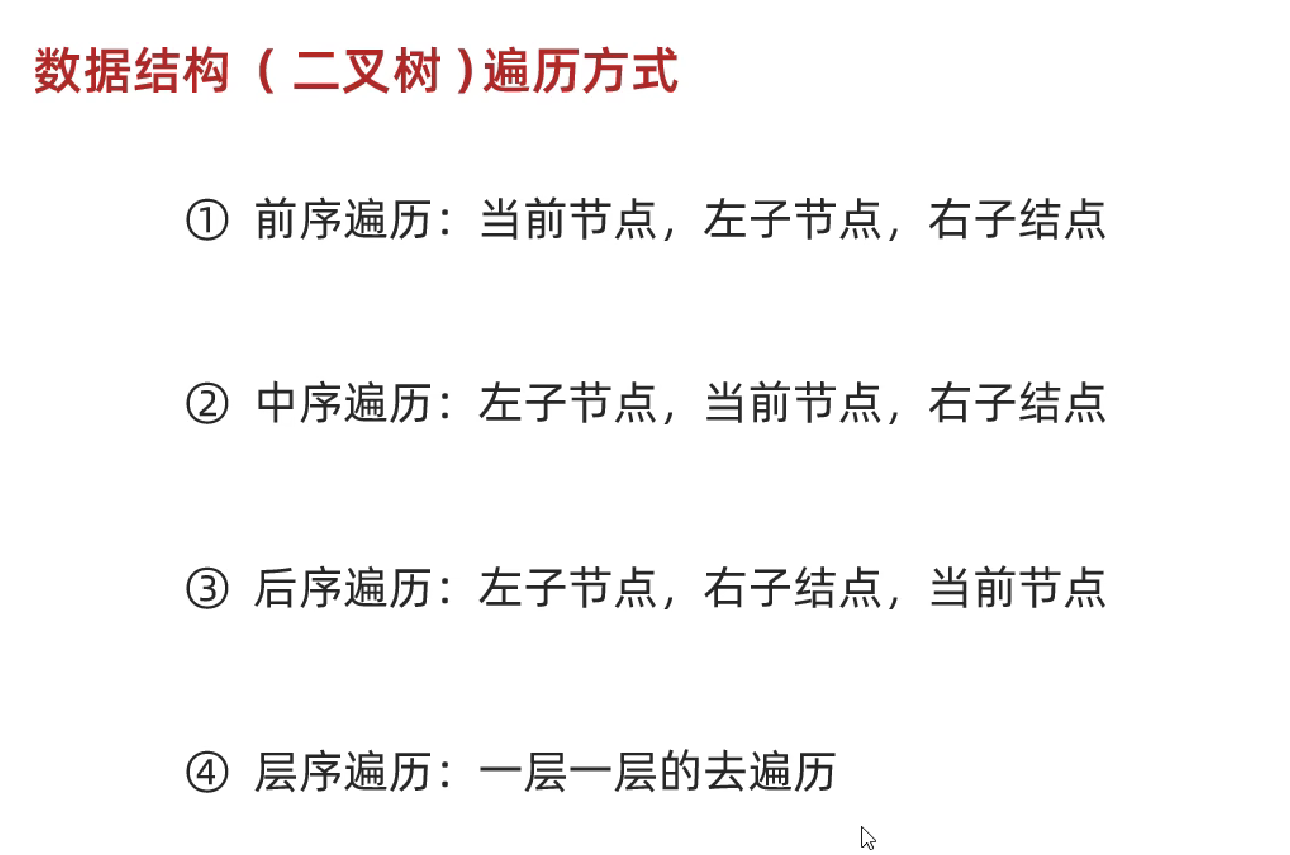
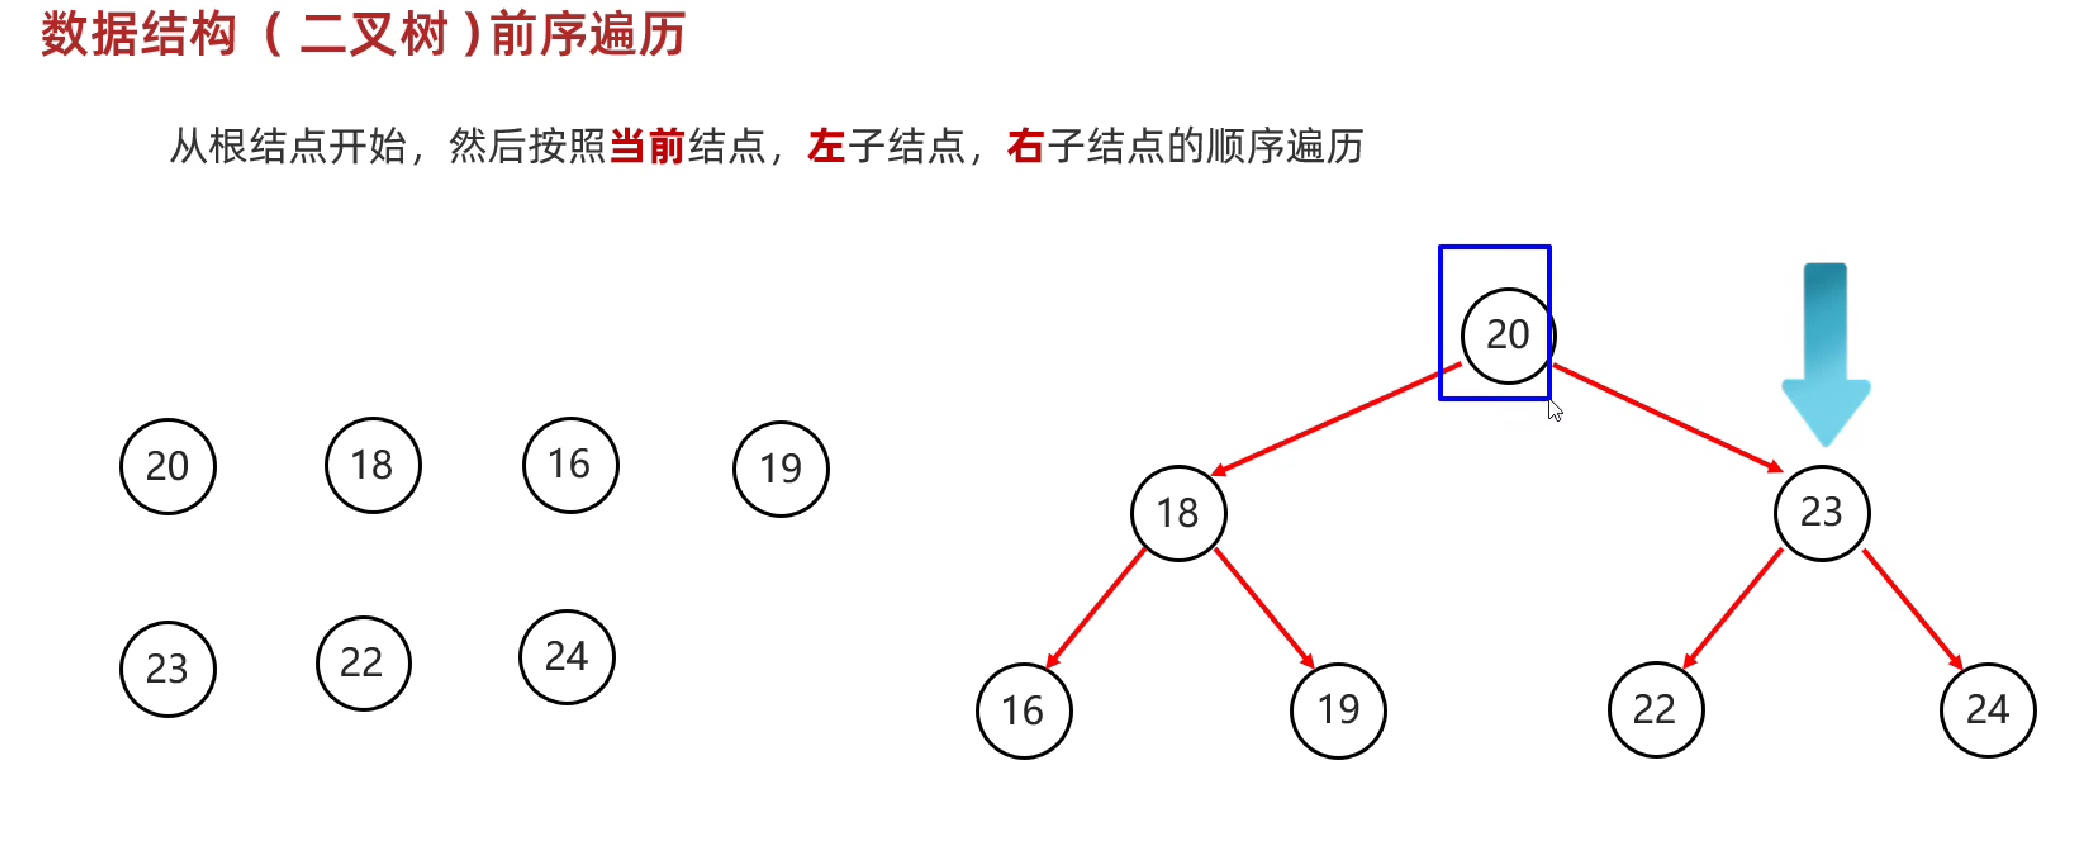
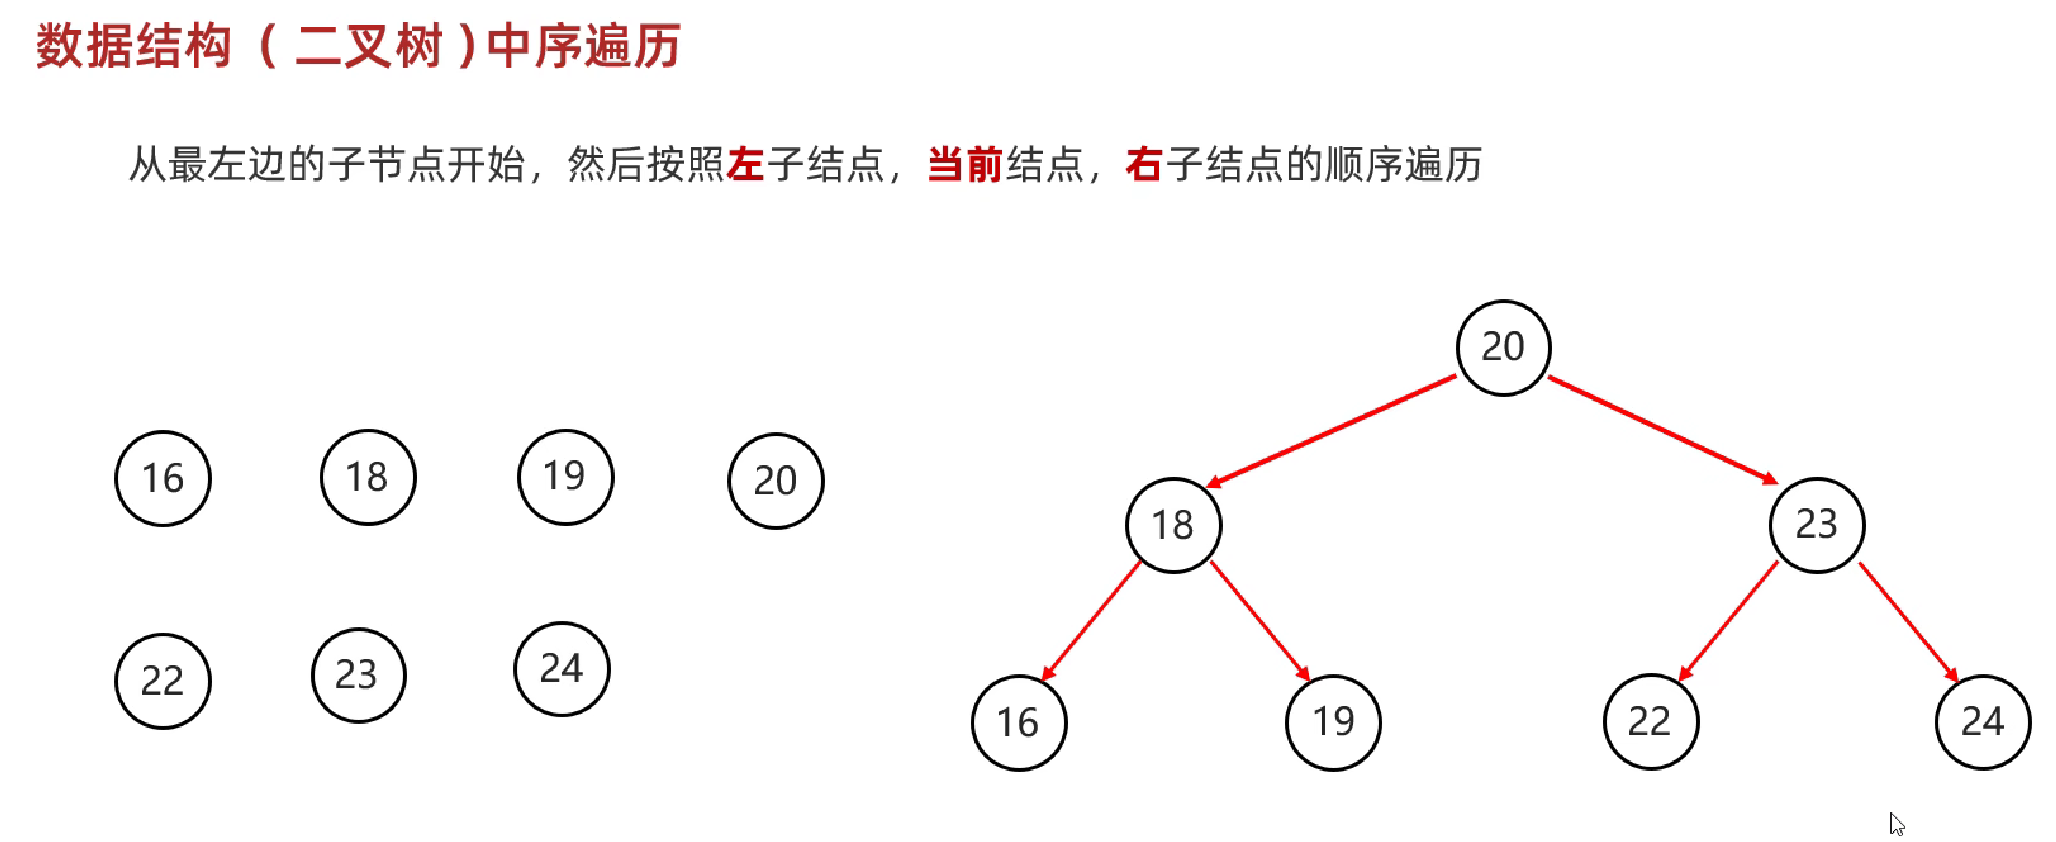
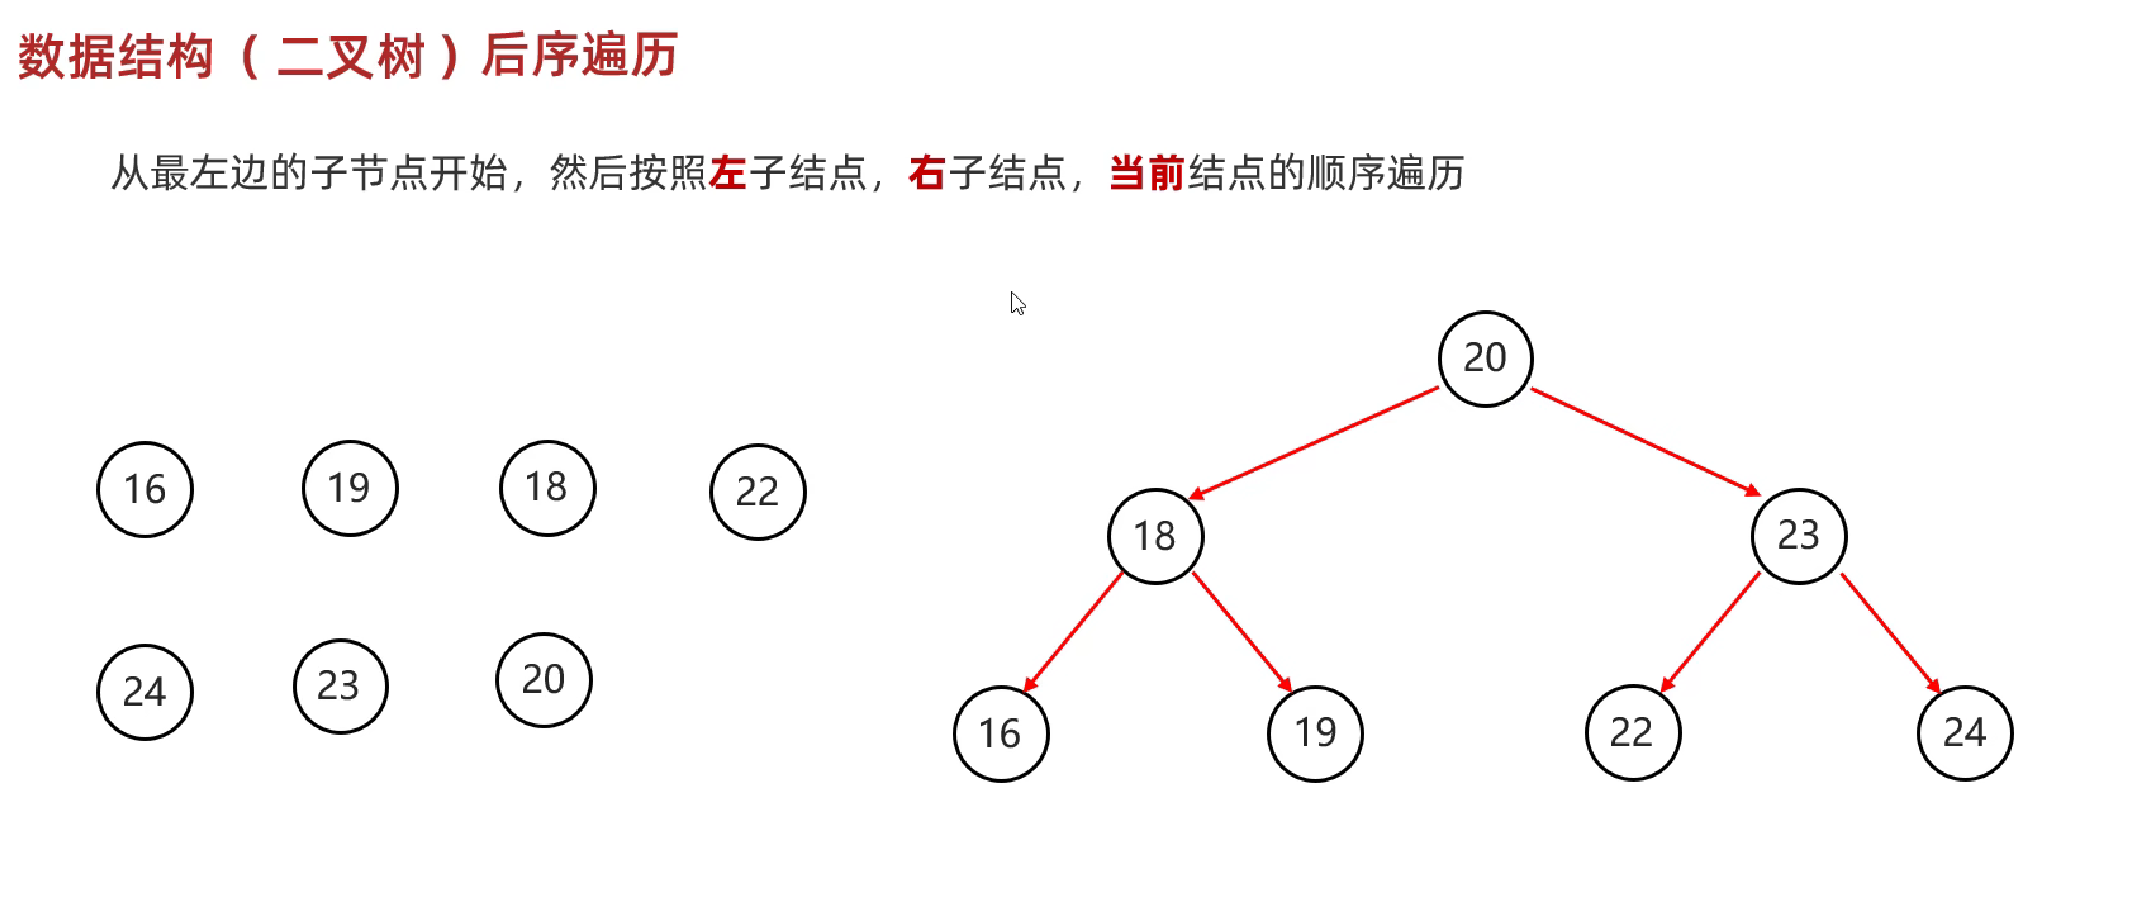
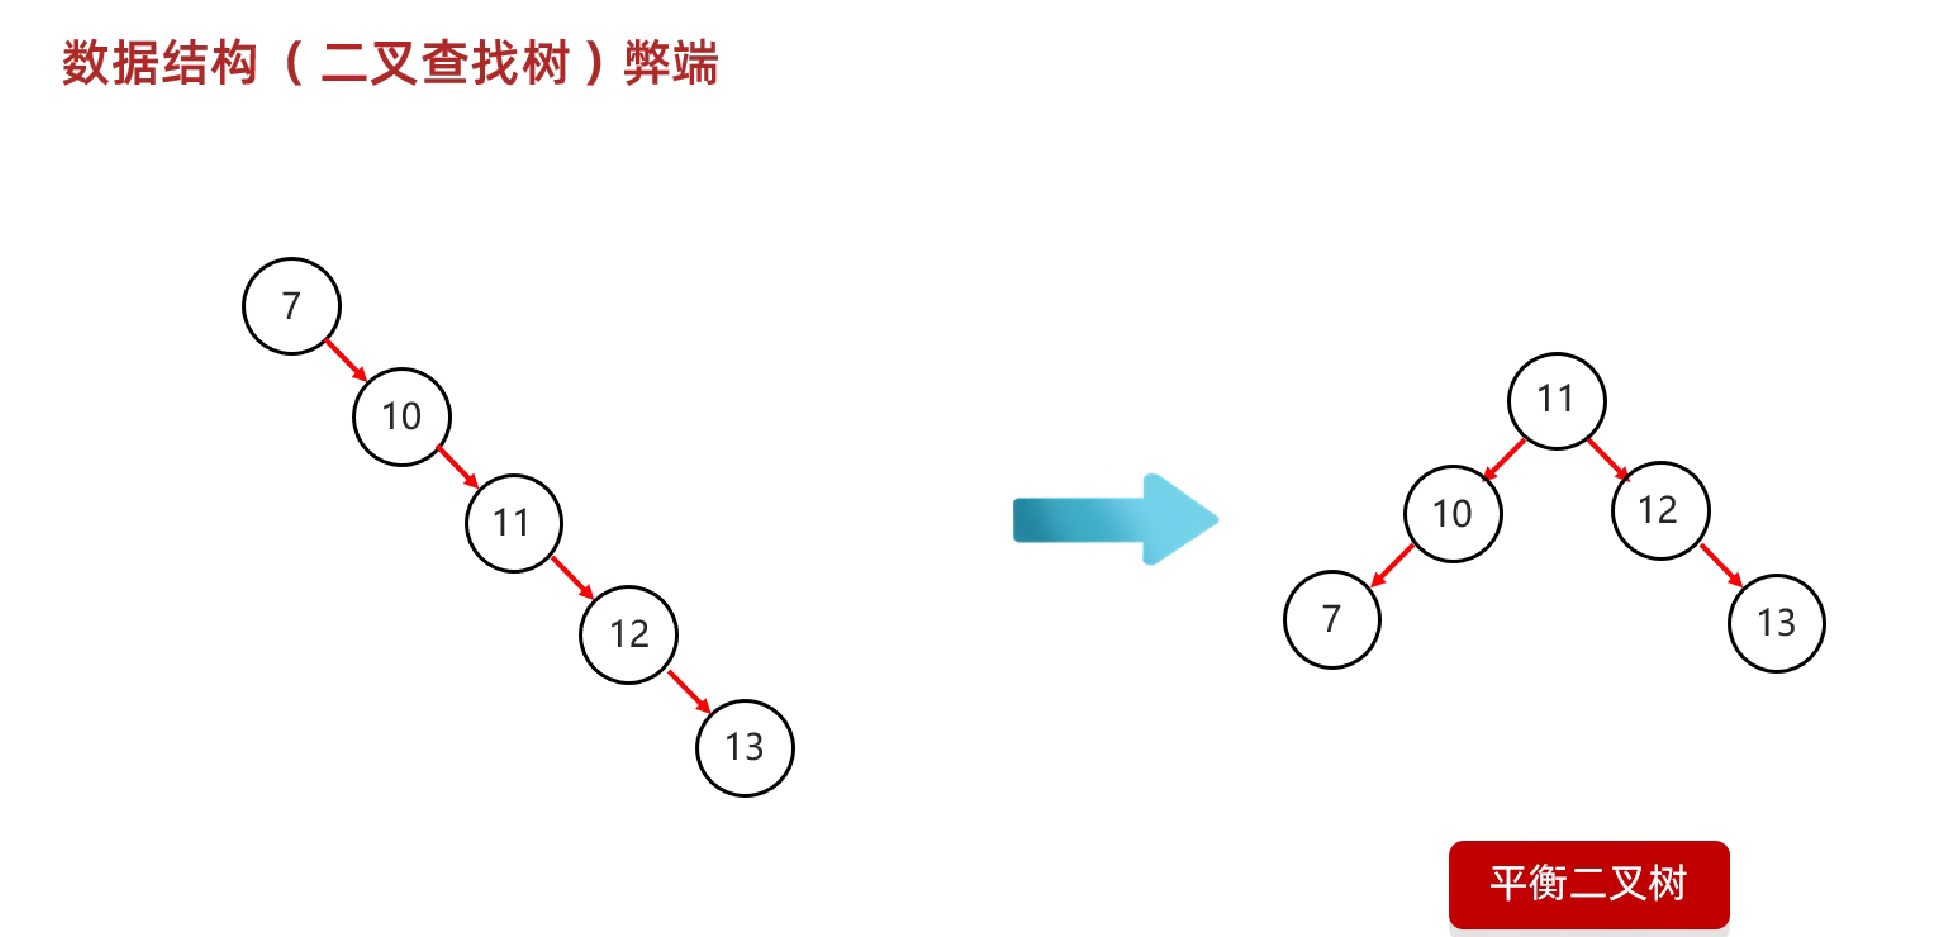
平衡二叉树
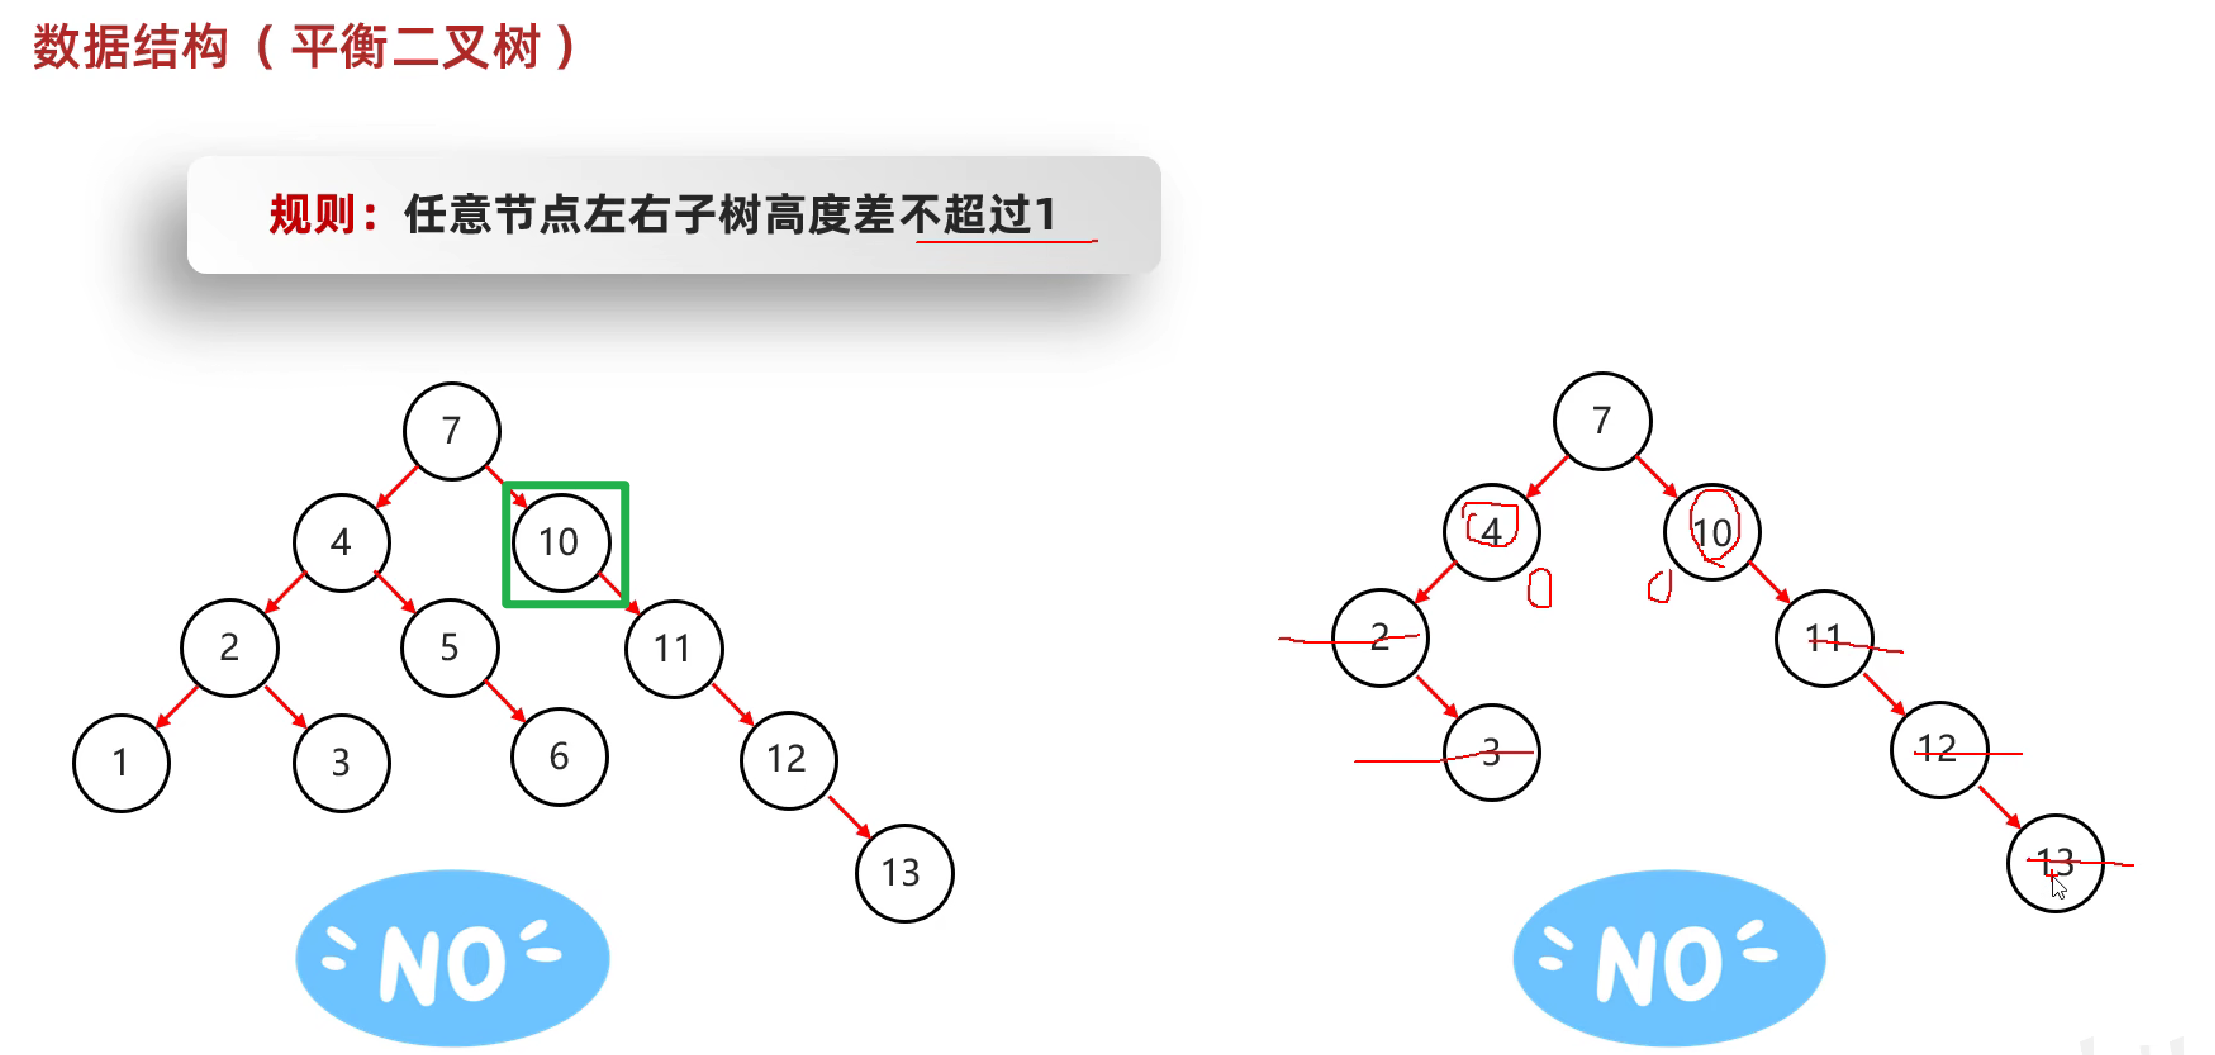
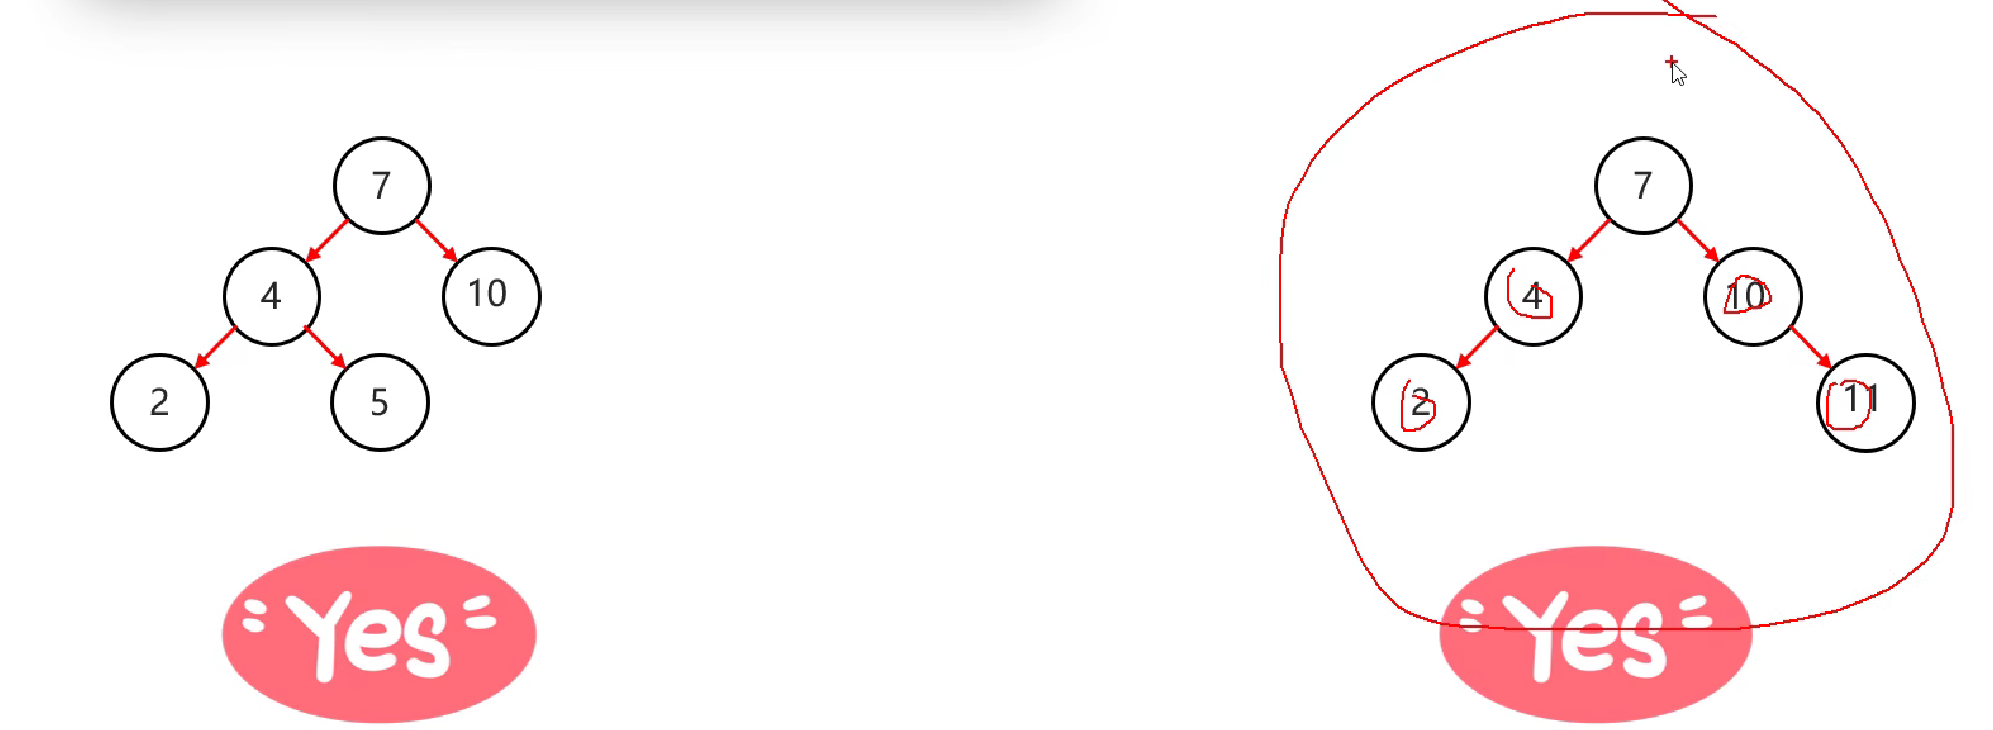
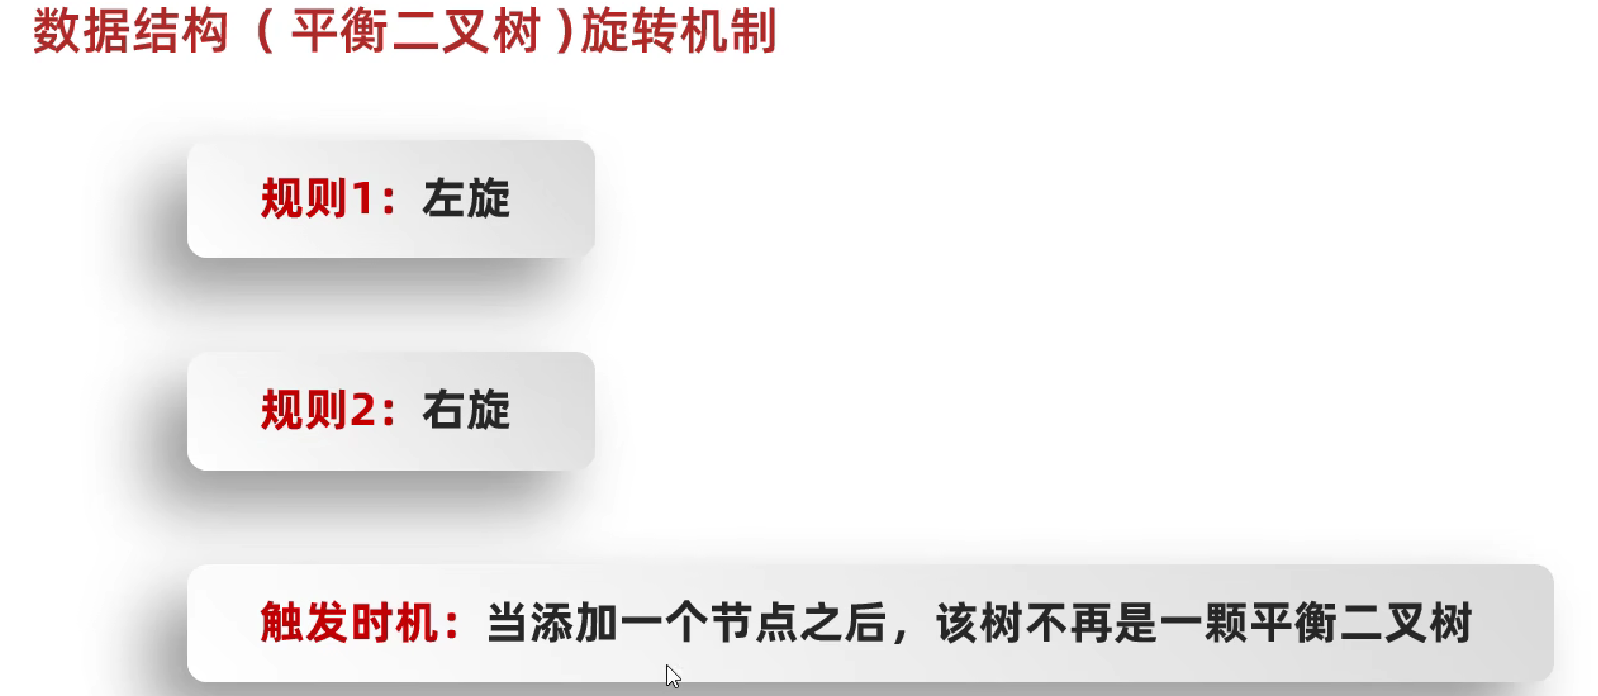
平衡二叉树旋转机制
感觉这一部分需要想象,可以去看课程搭配使用。
左旋
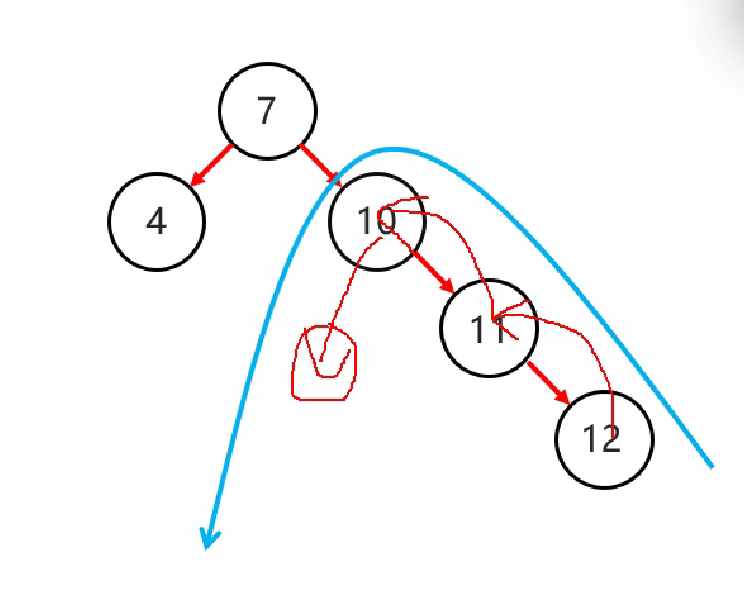
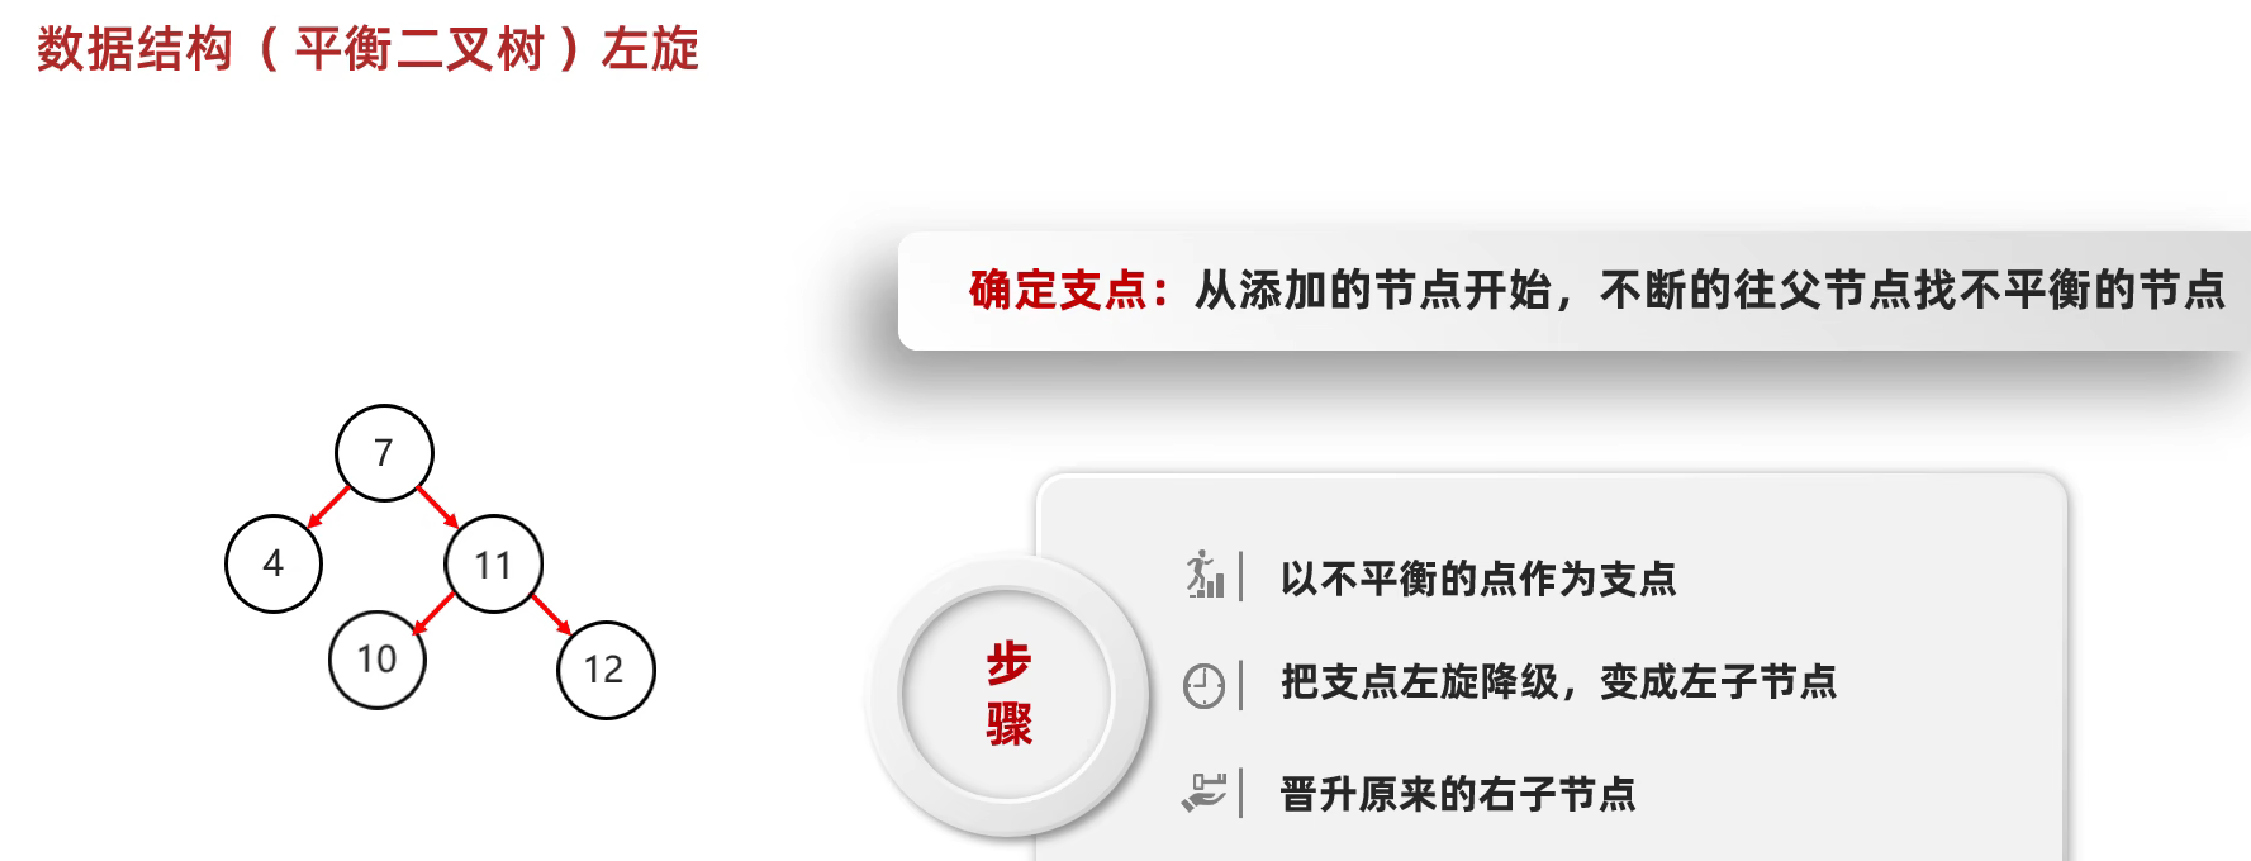
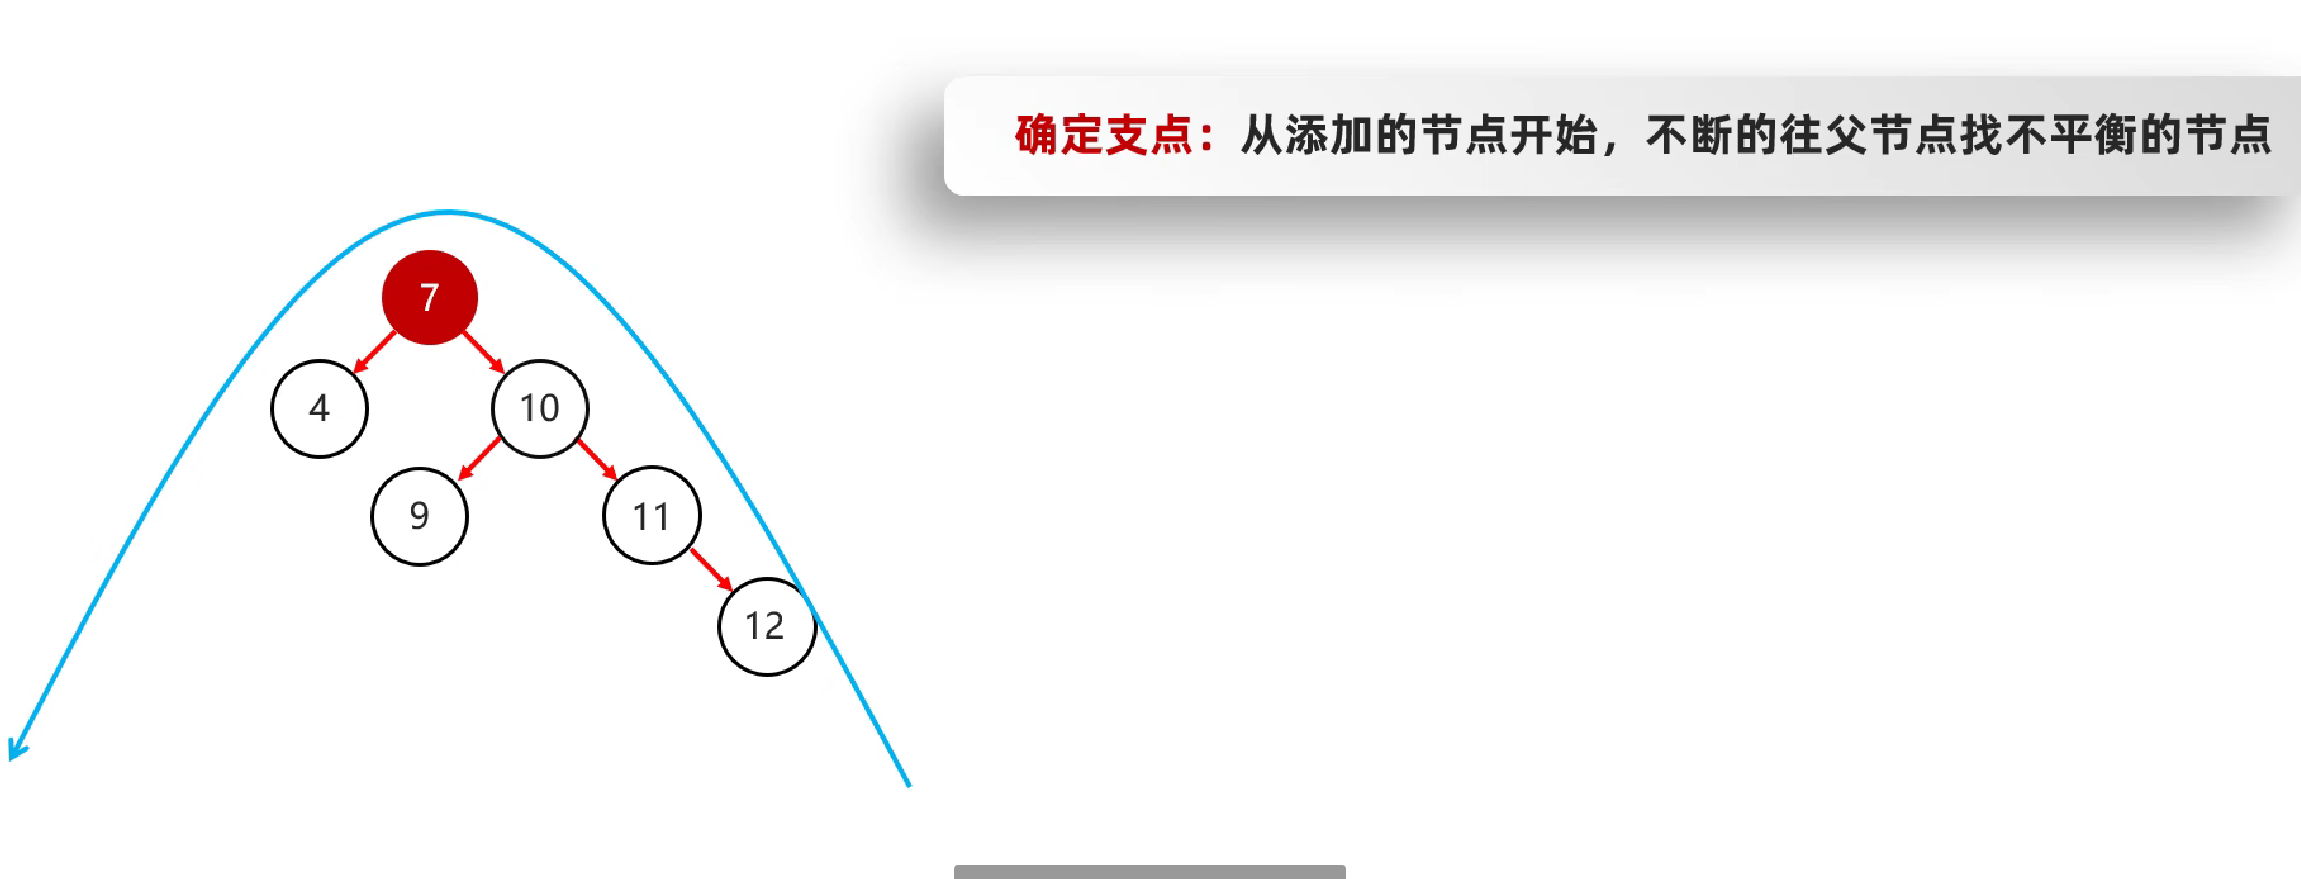
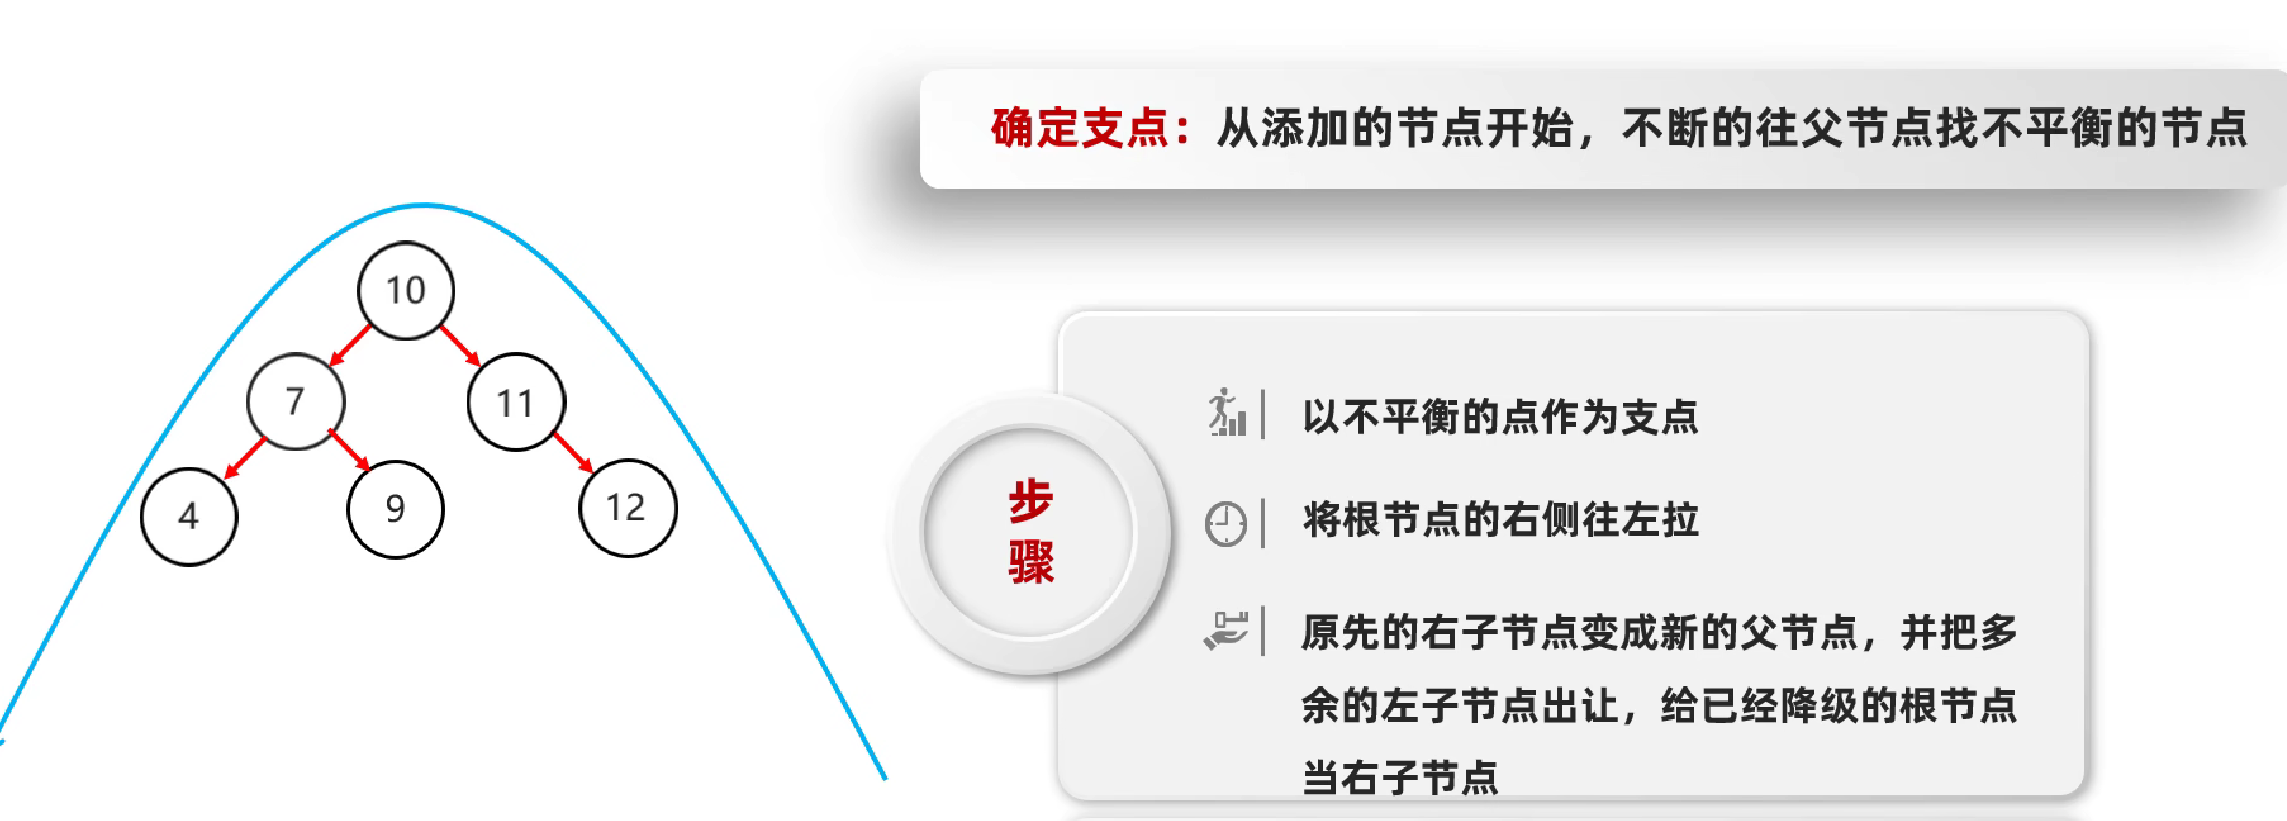
右旋
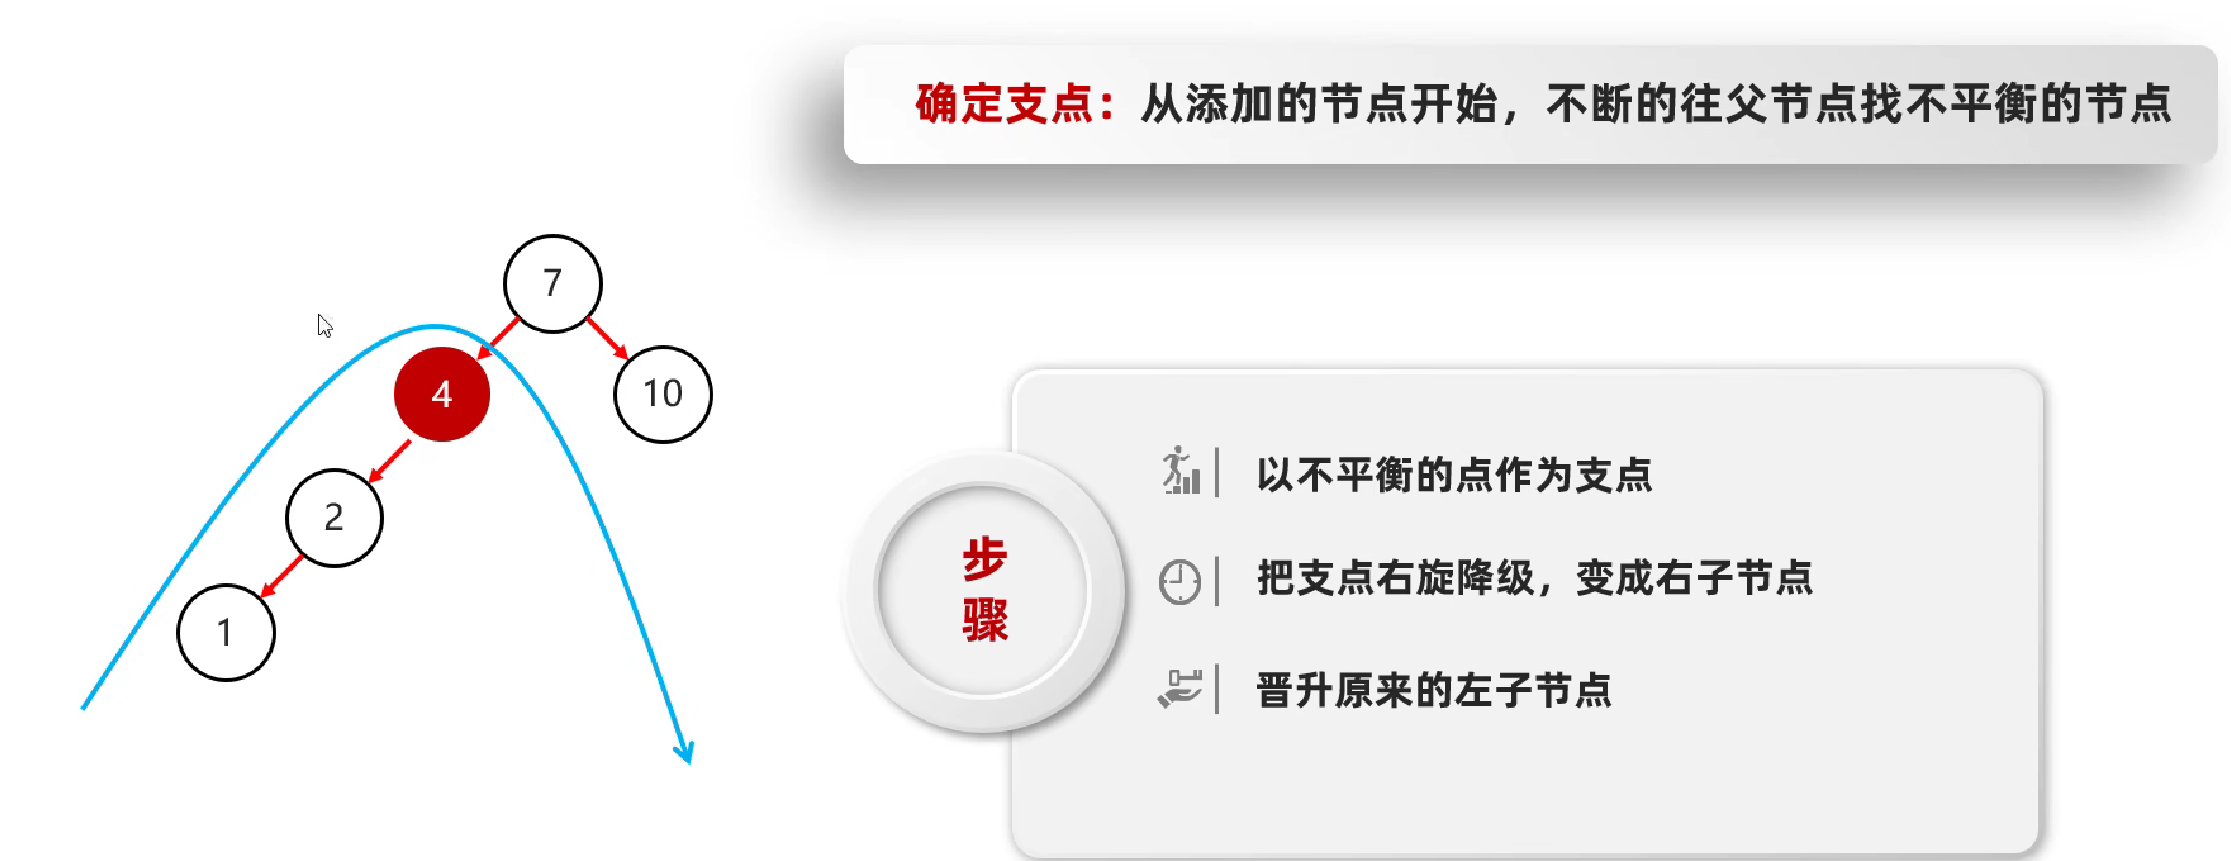
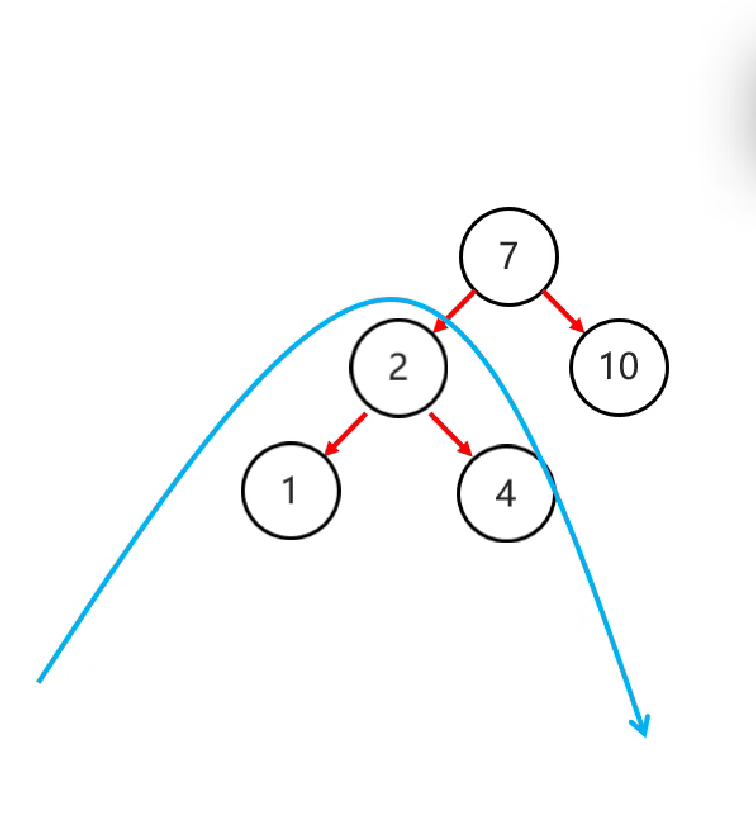
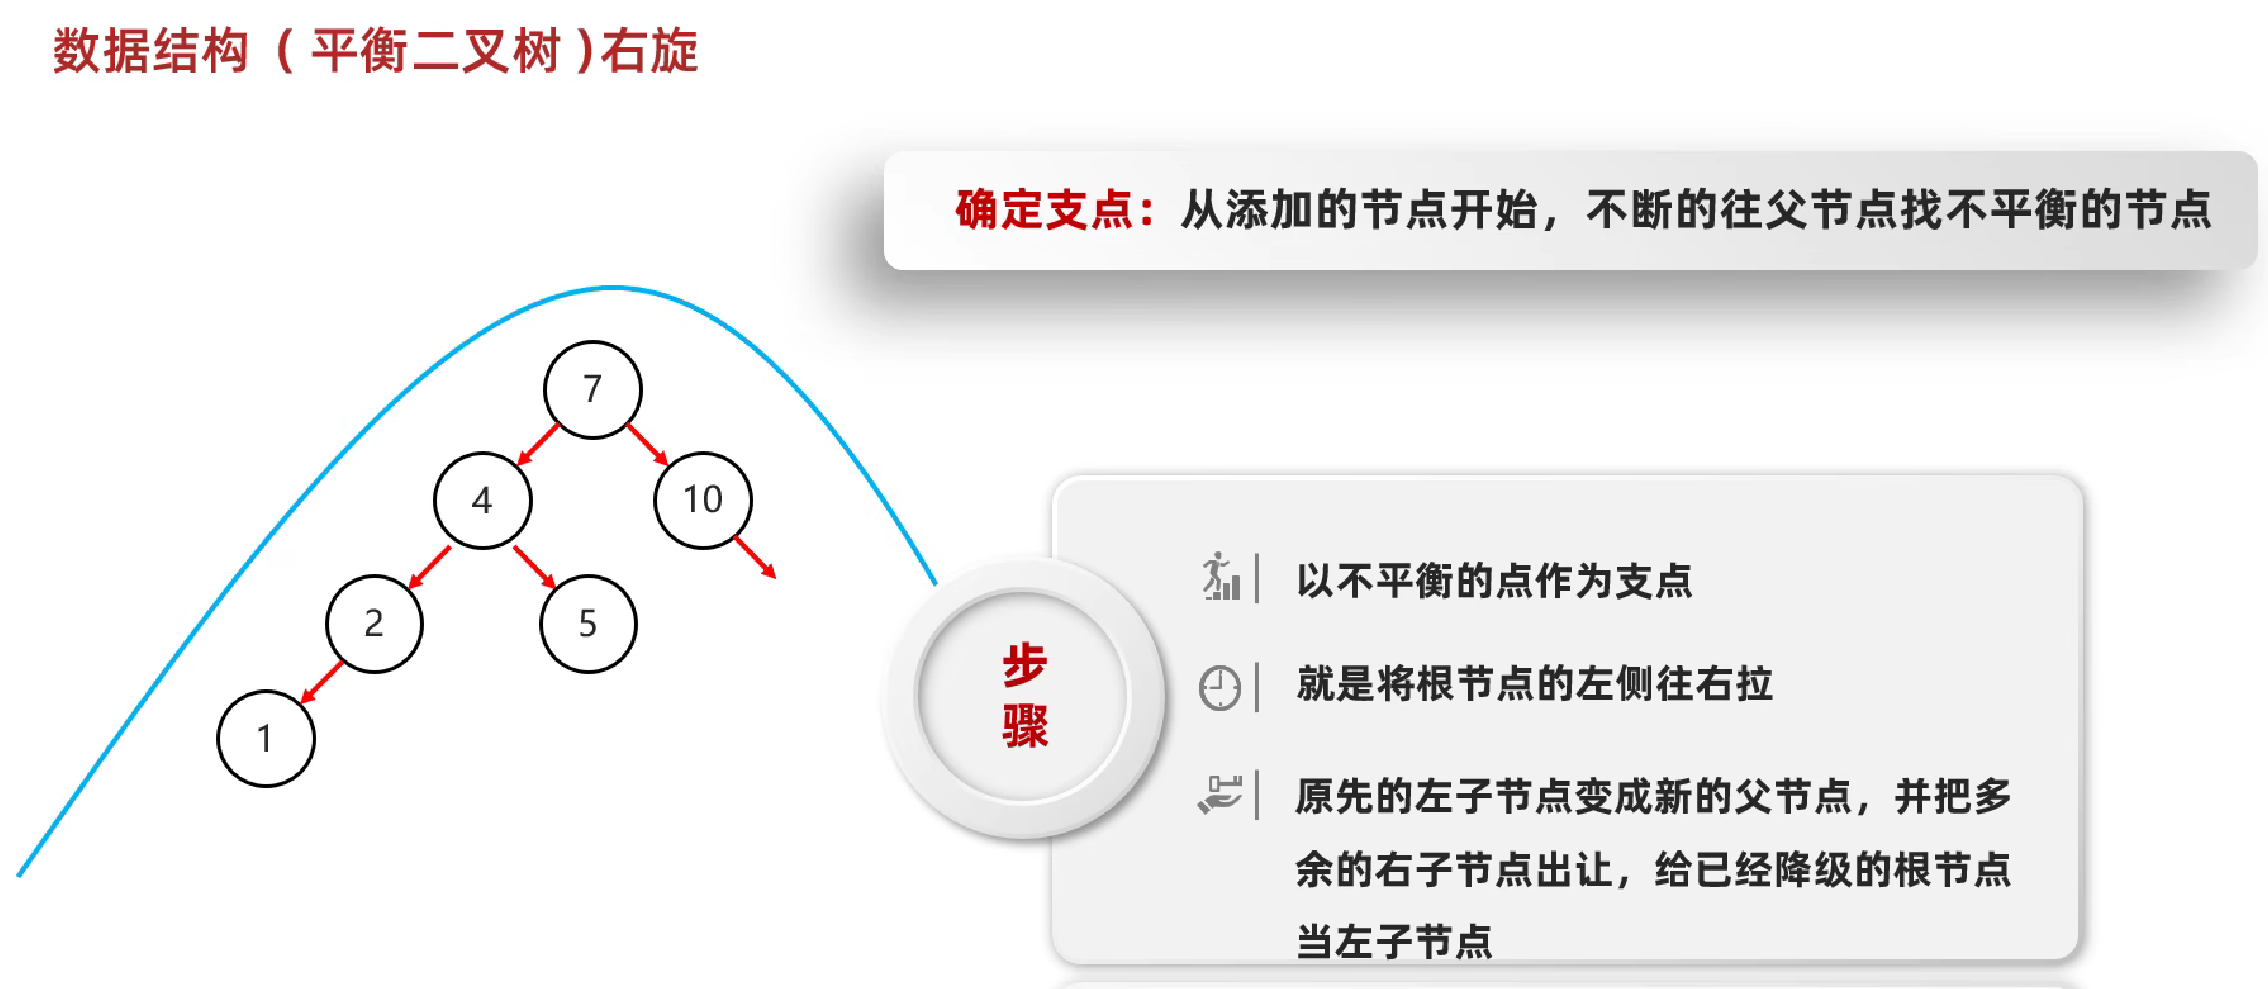
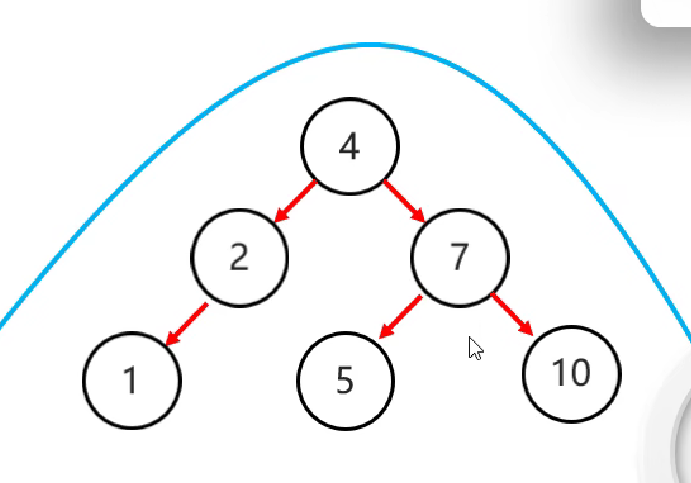
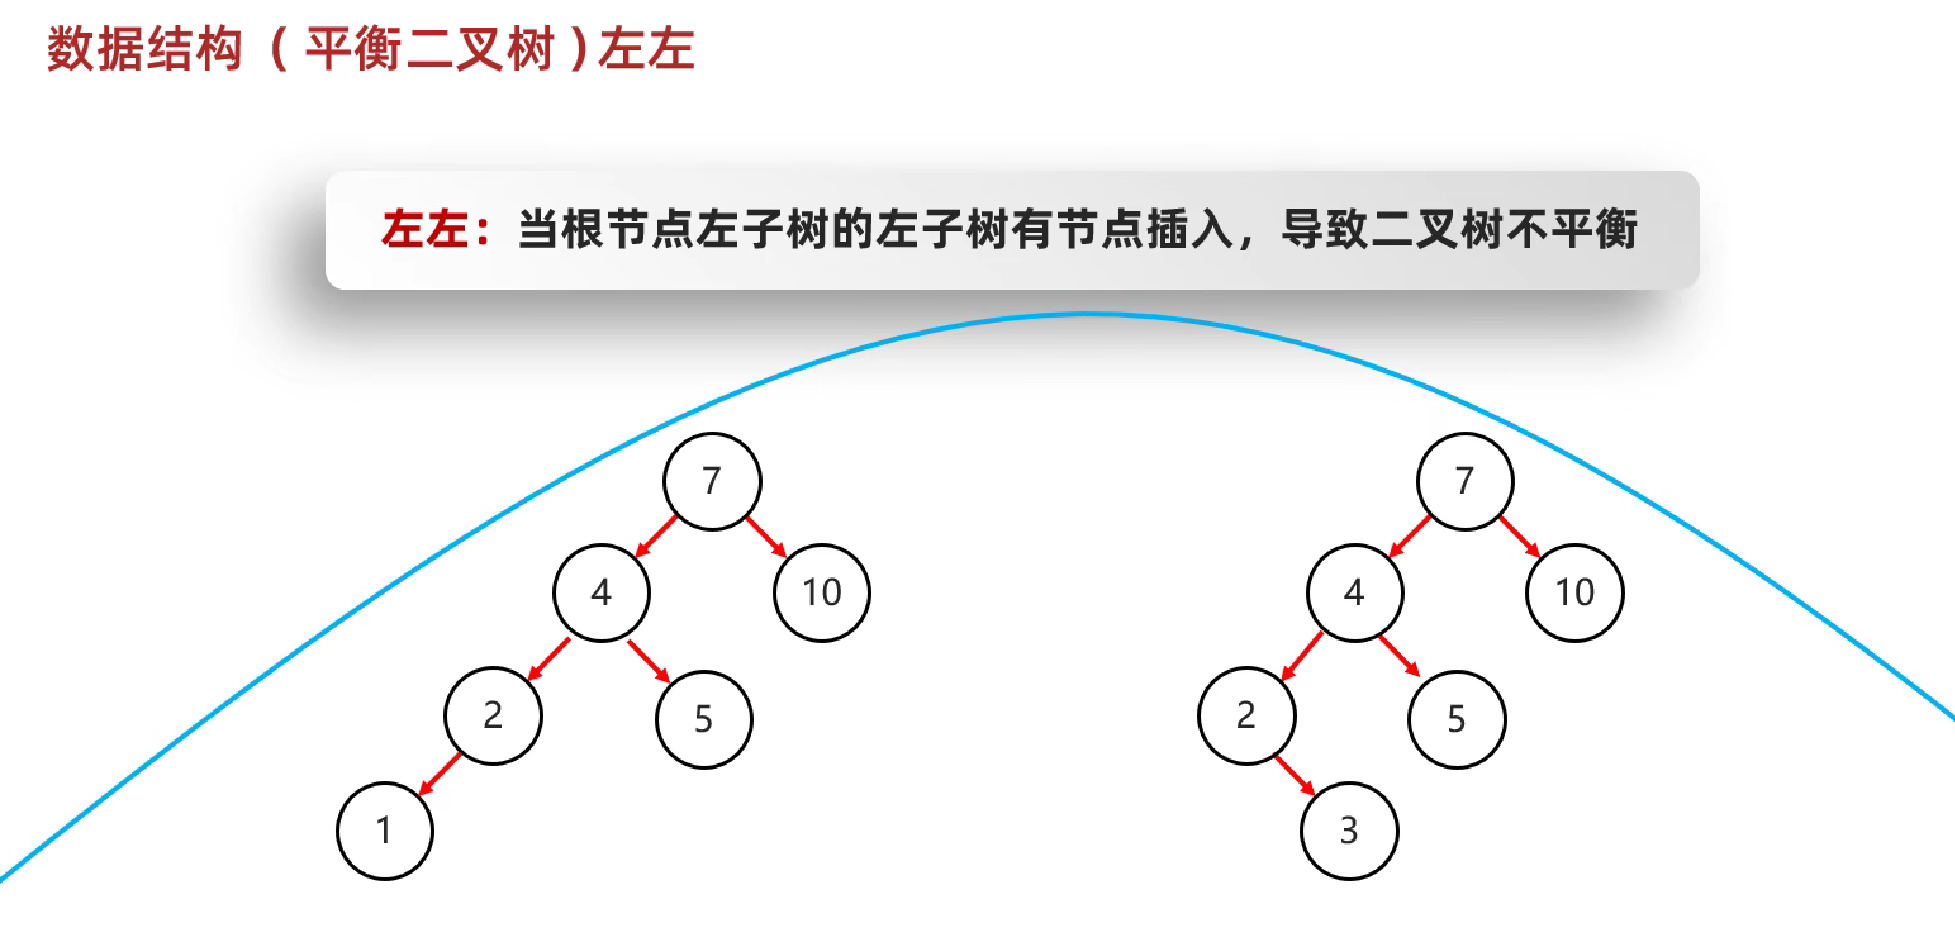
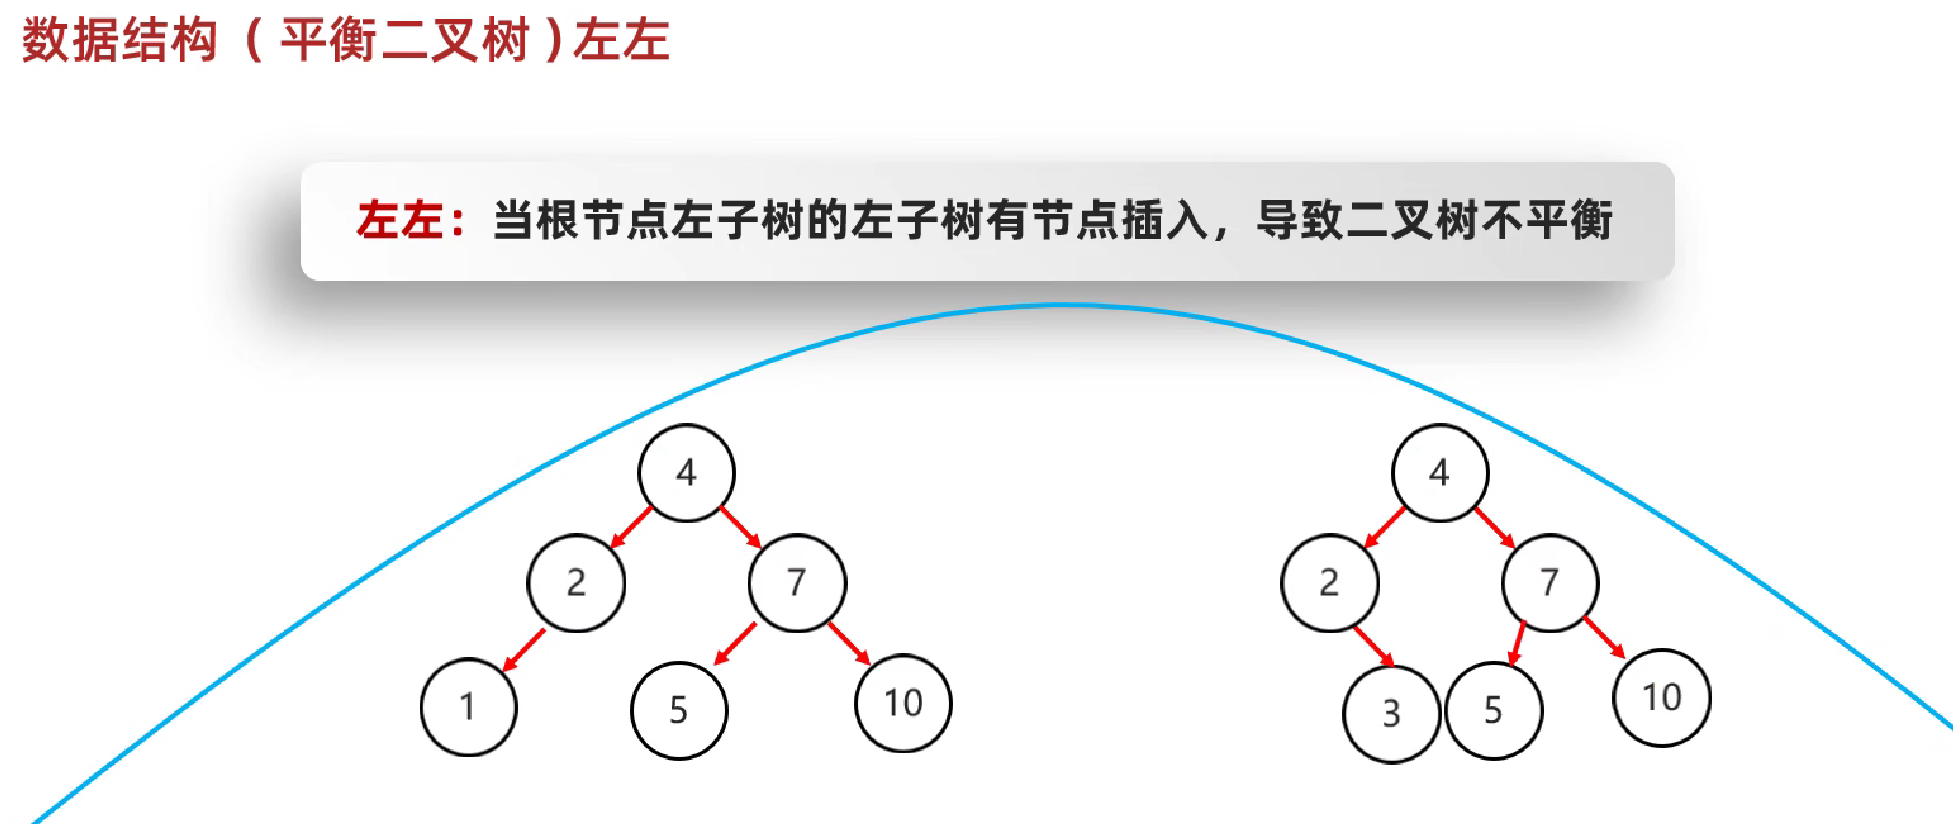
数据结构(平衡二叉树)需要旋转的四种情况
①左左 ②左右 ③右右 ④右左
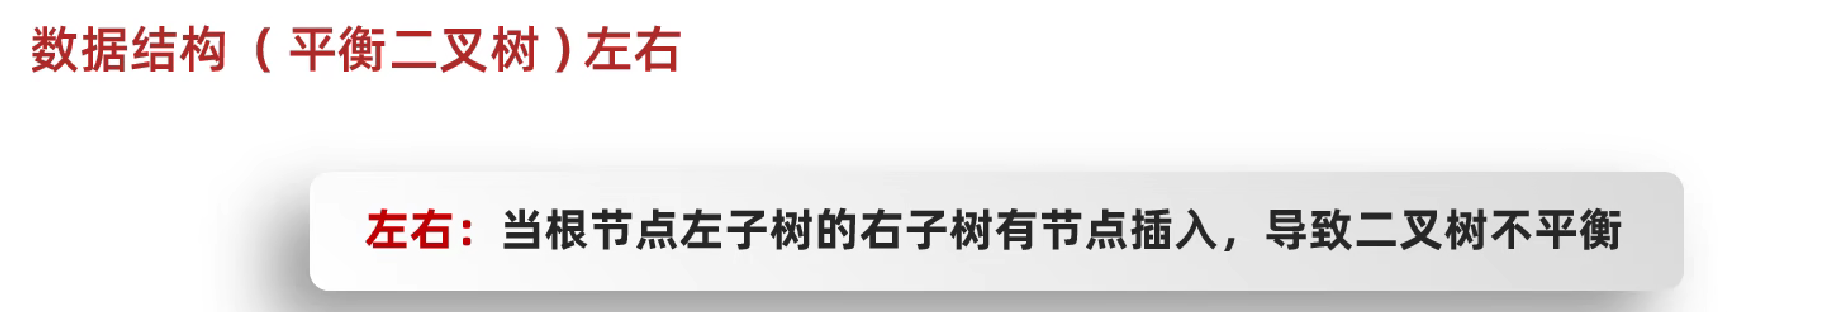
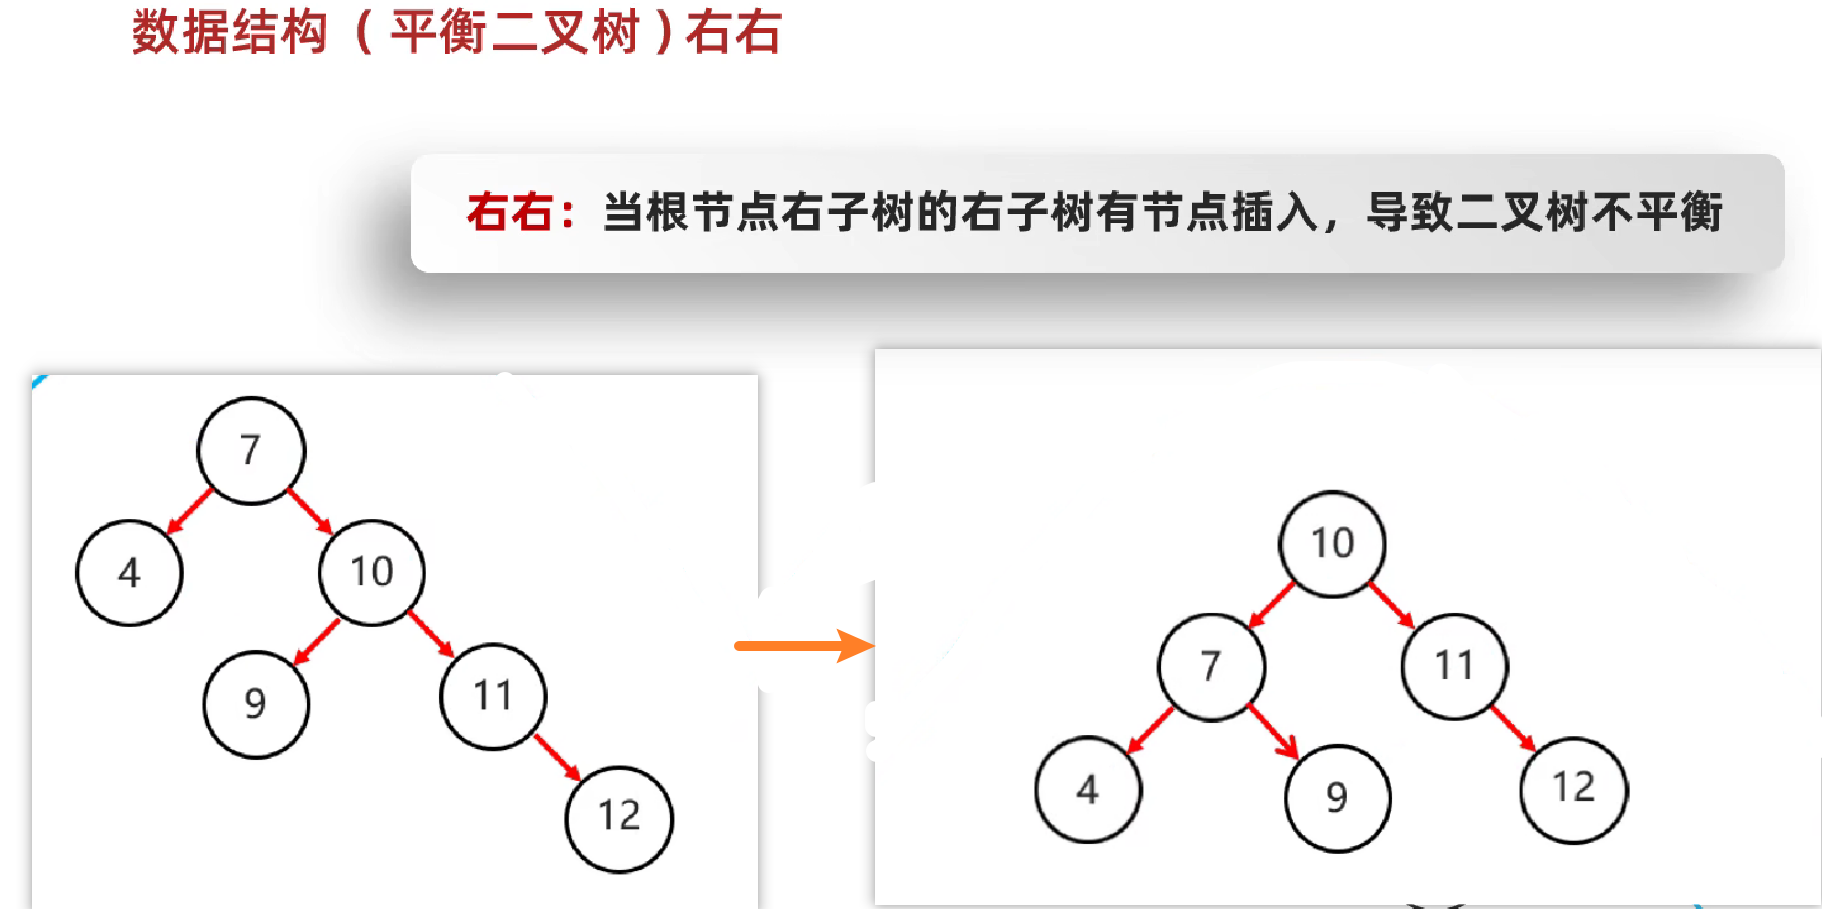
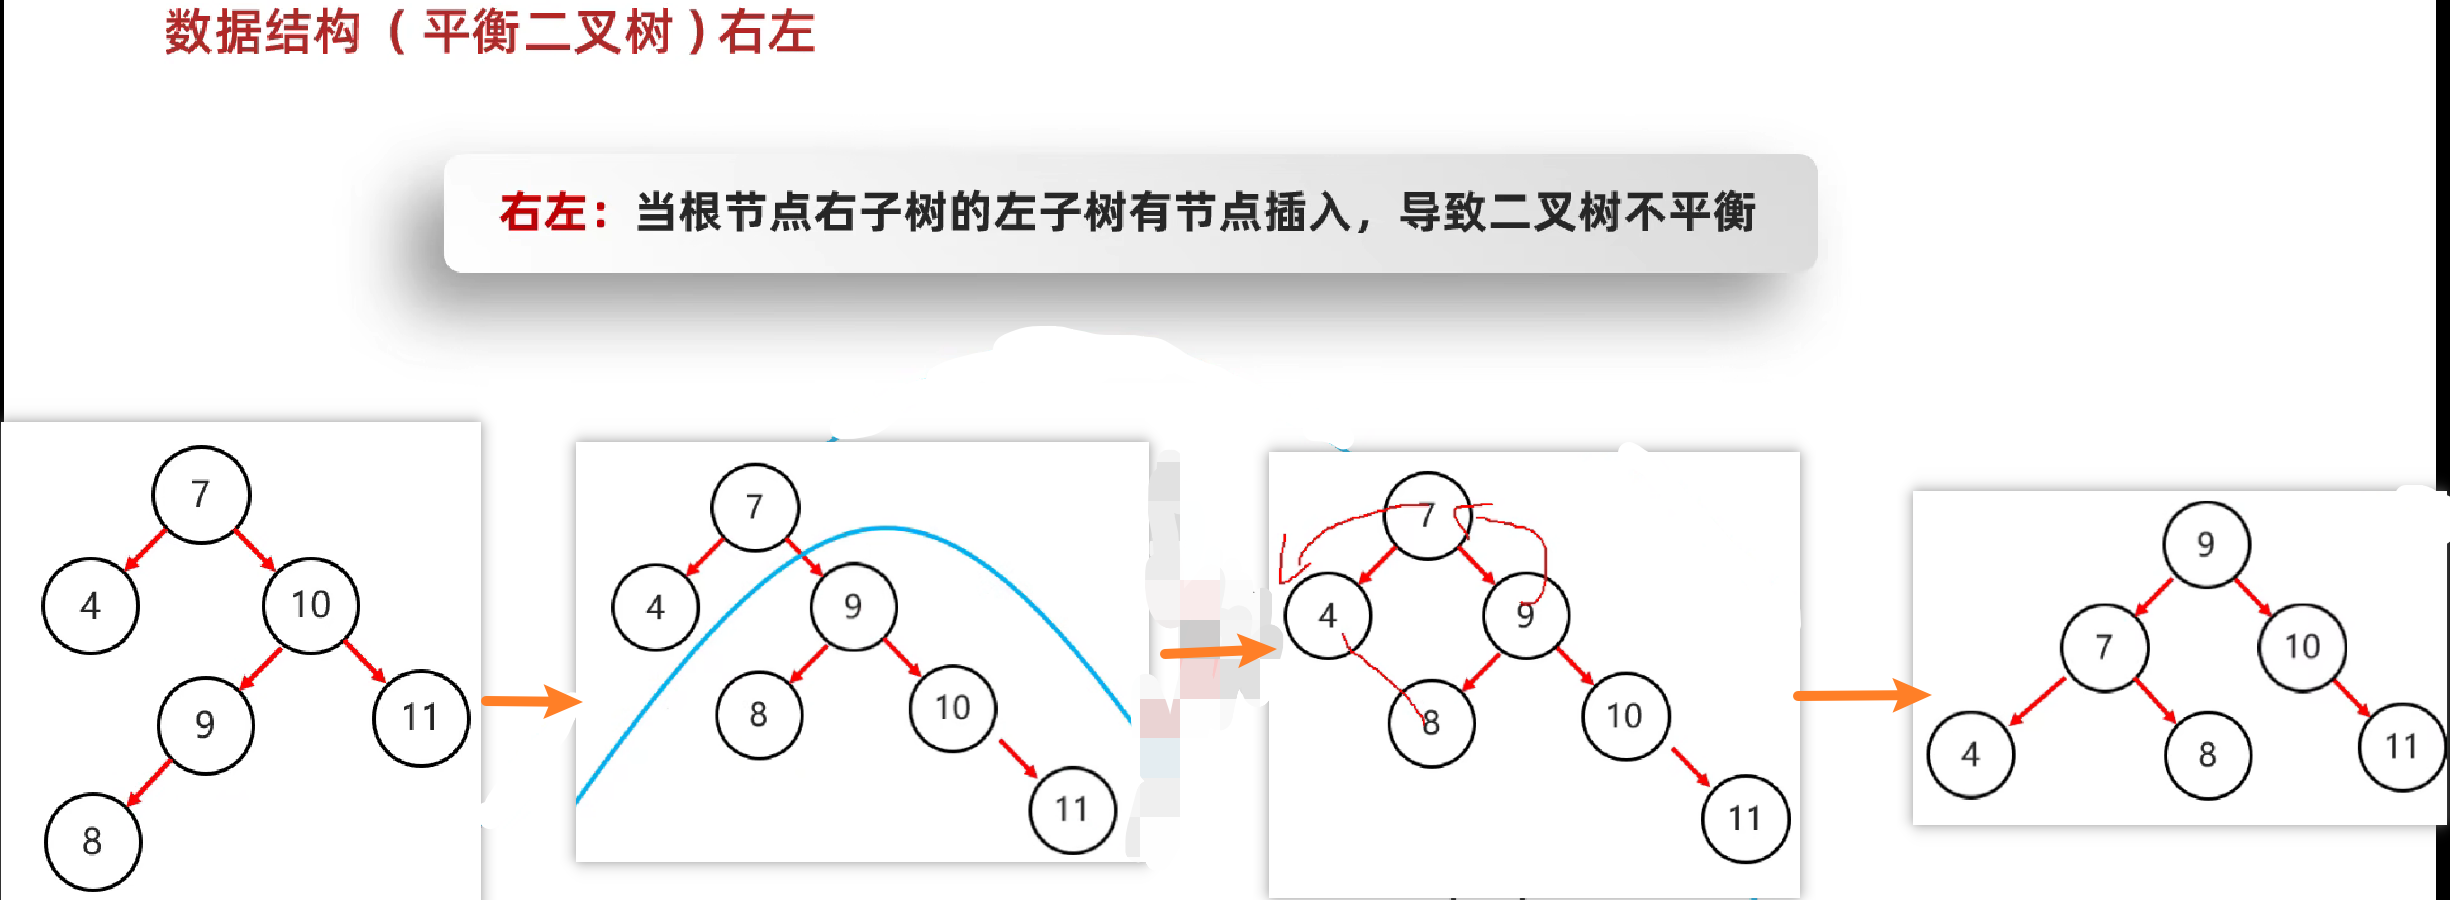
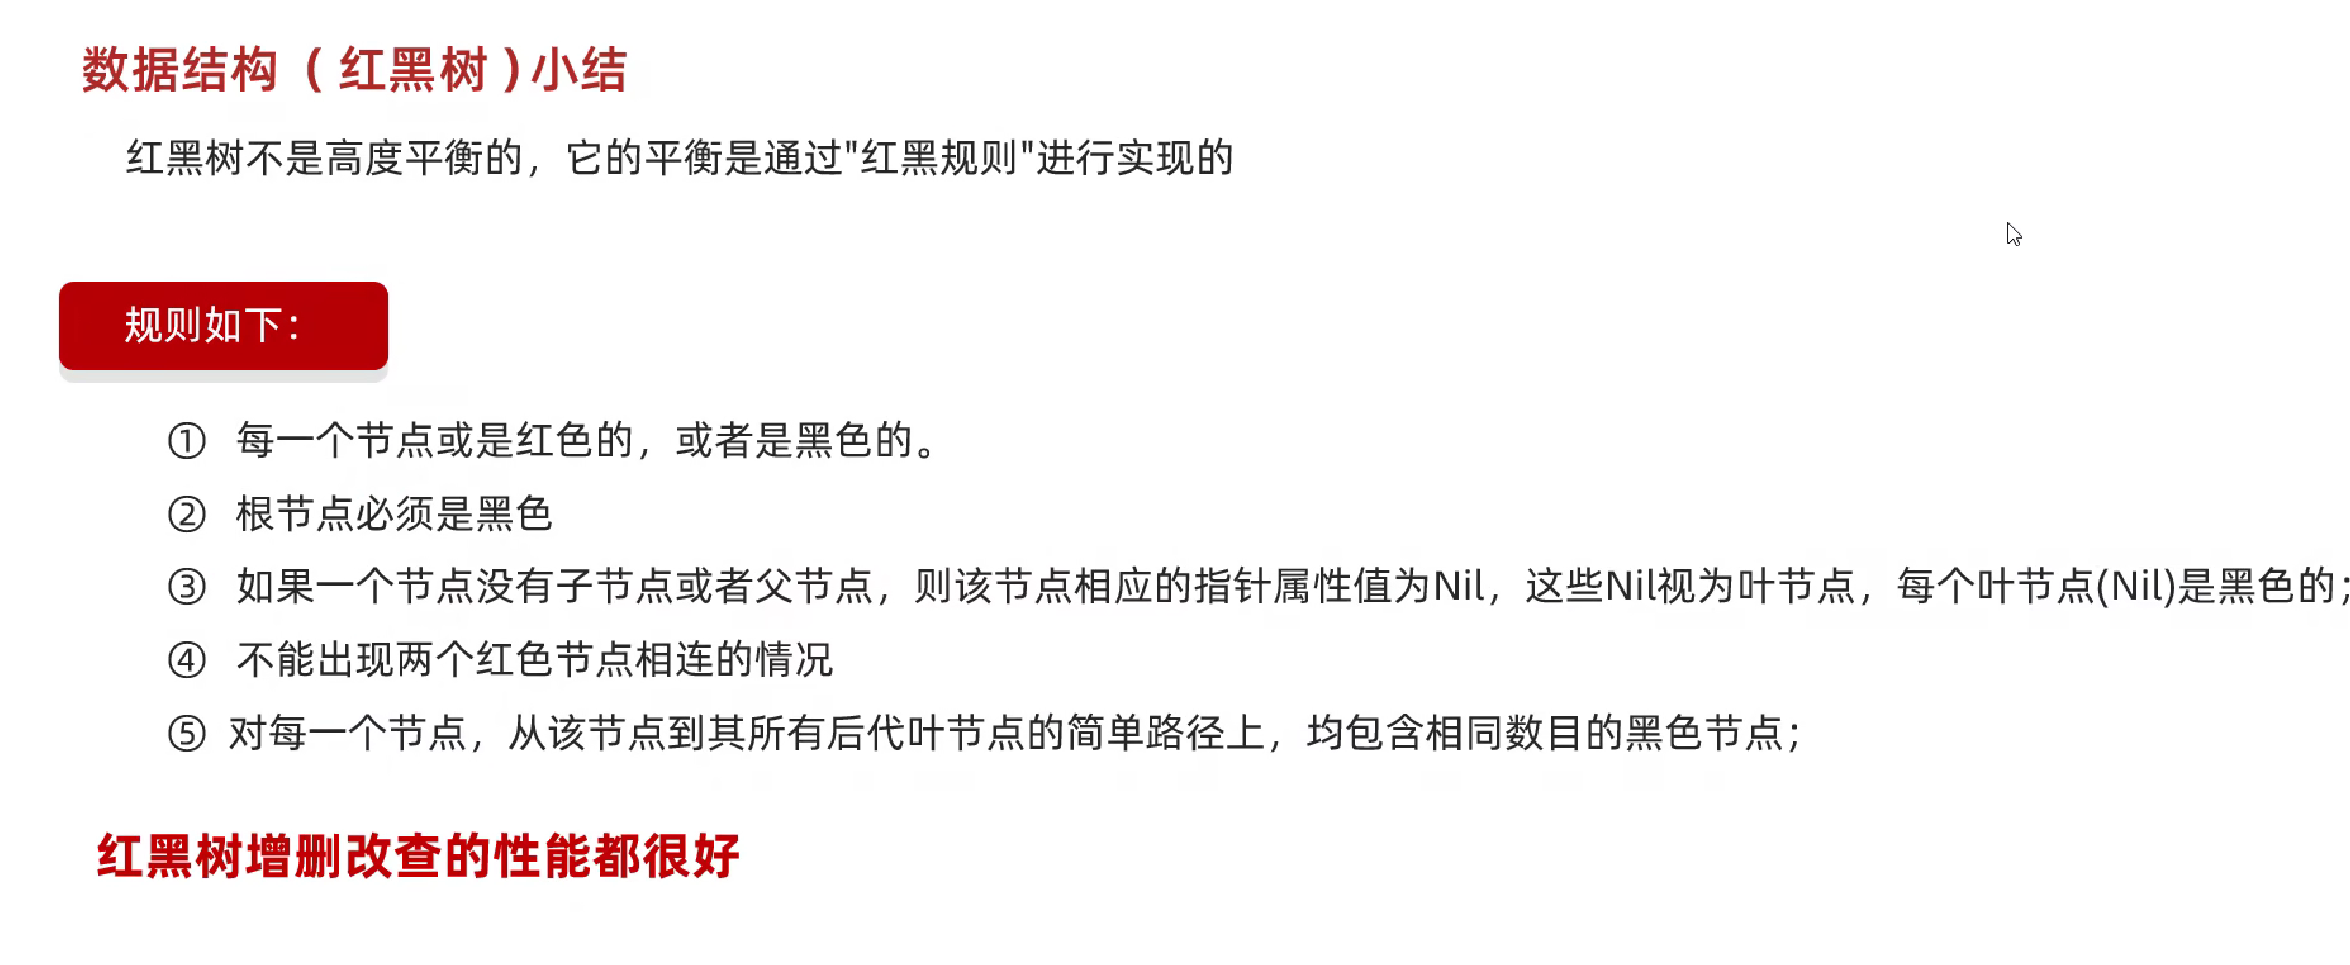
红黑树
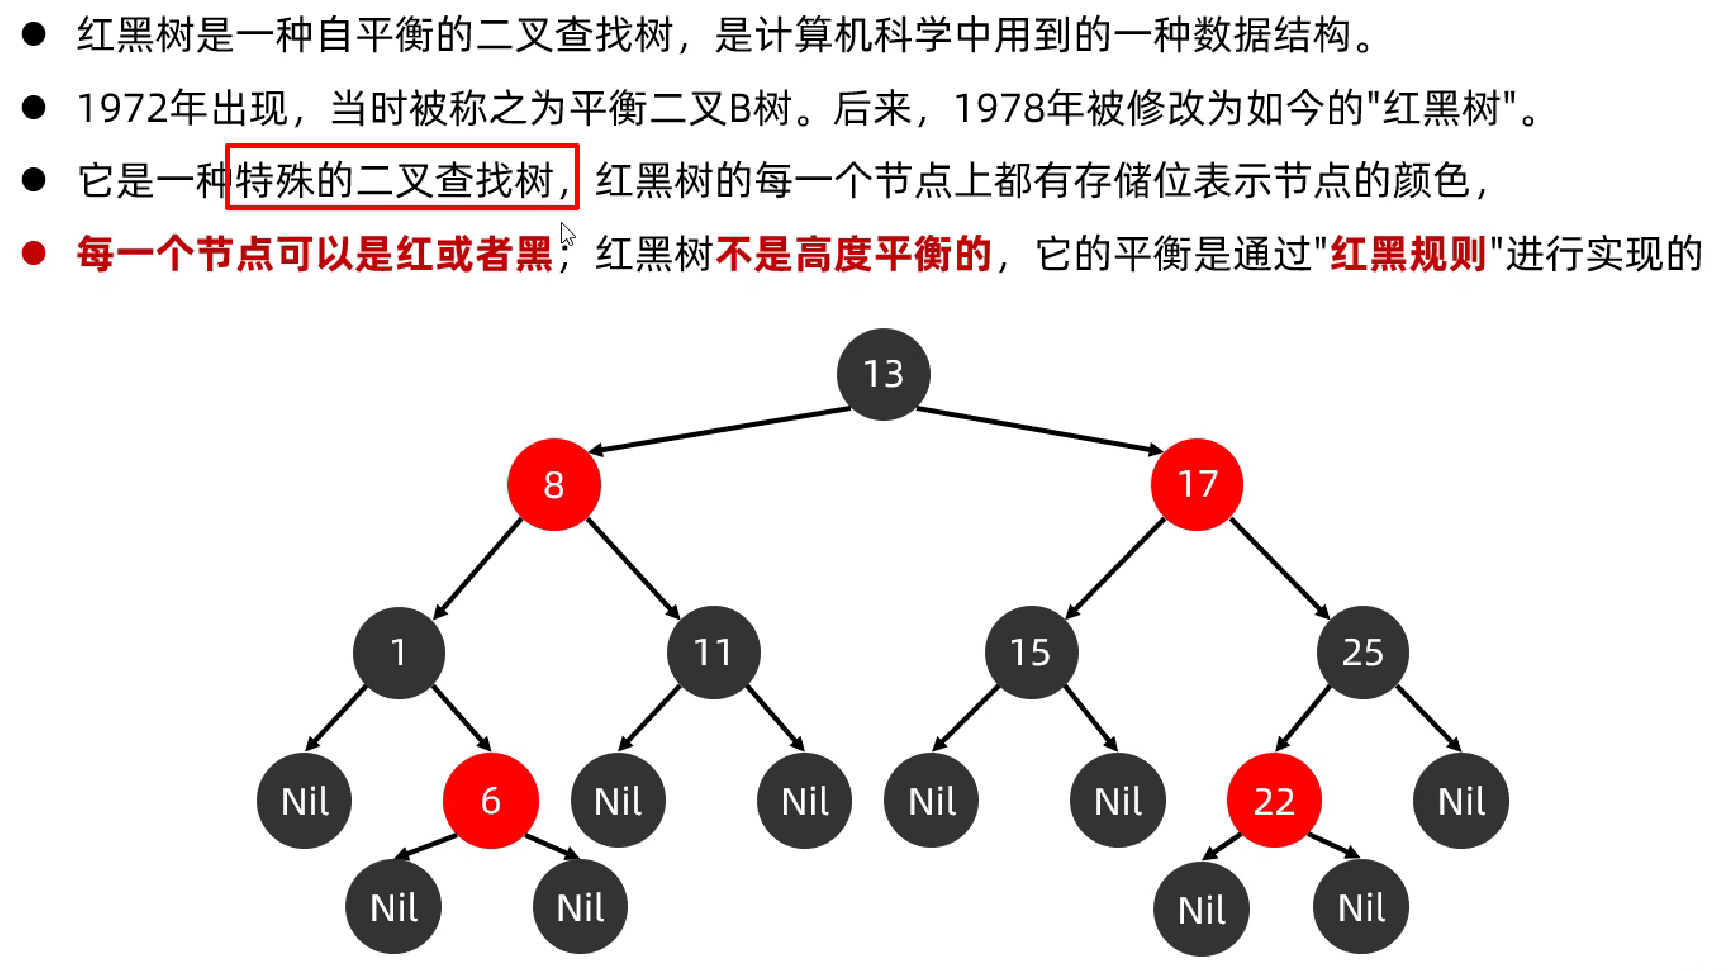
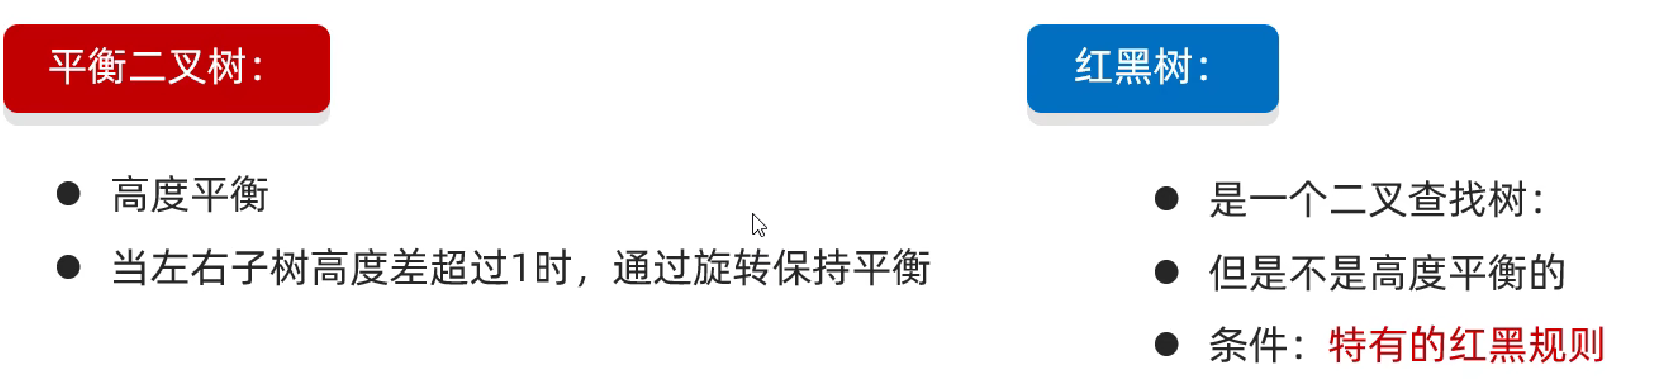
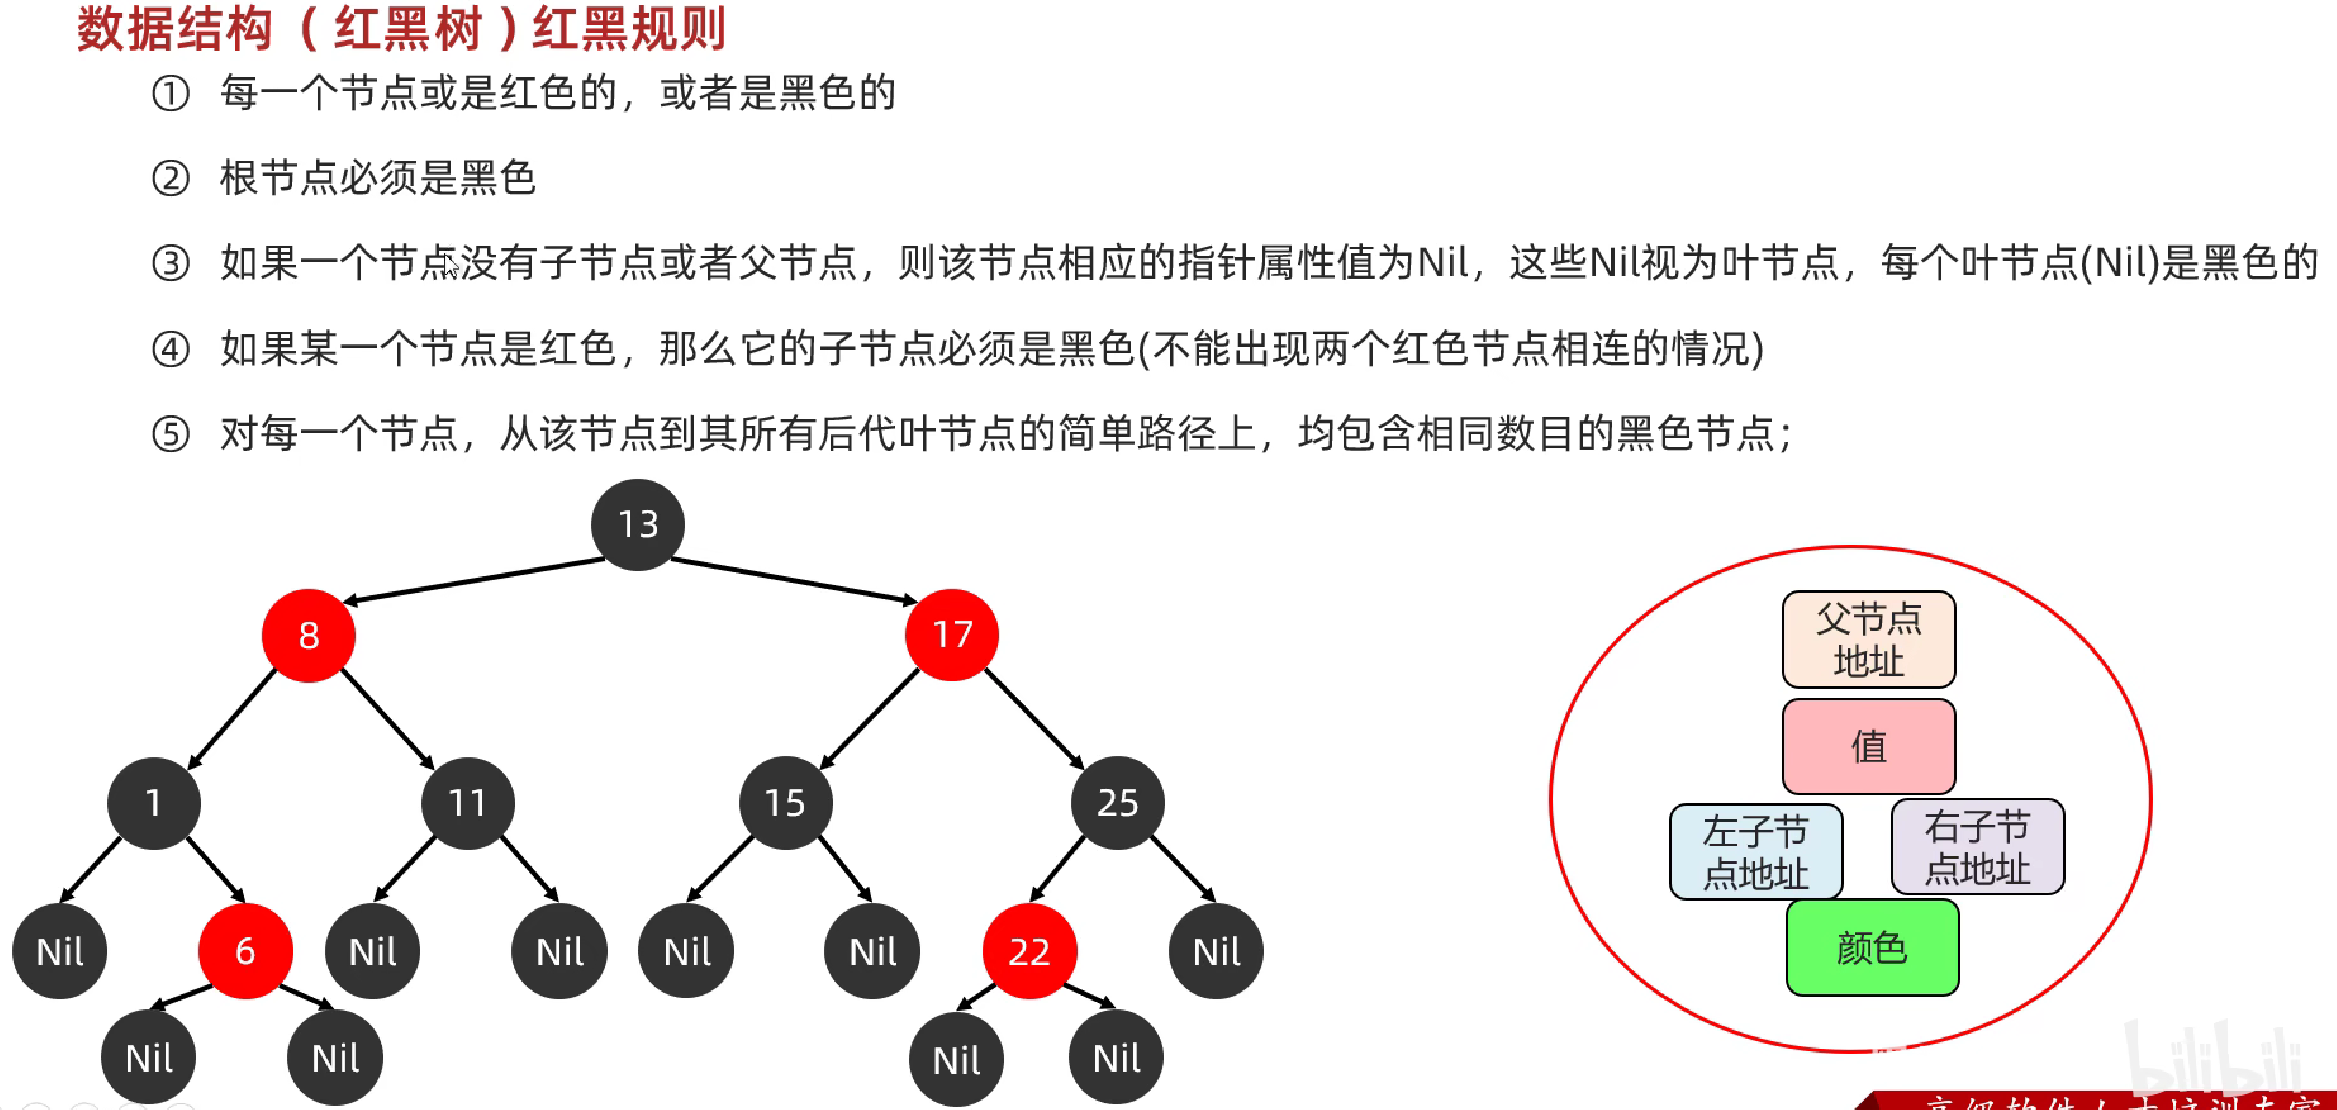
对于第⑤点规则解释:
1)后代:该节点的所有子节点都是该节点的后代
2)叶节点:度为1,即Nil节点
3)简单路径:不能折返,只能一条路走到头,看该路径上面的黑色节点个数
添加三个黑色节点20、18、23时:
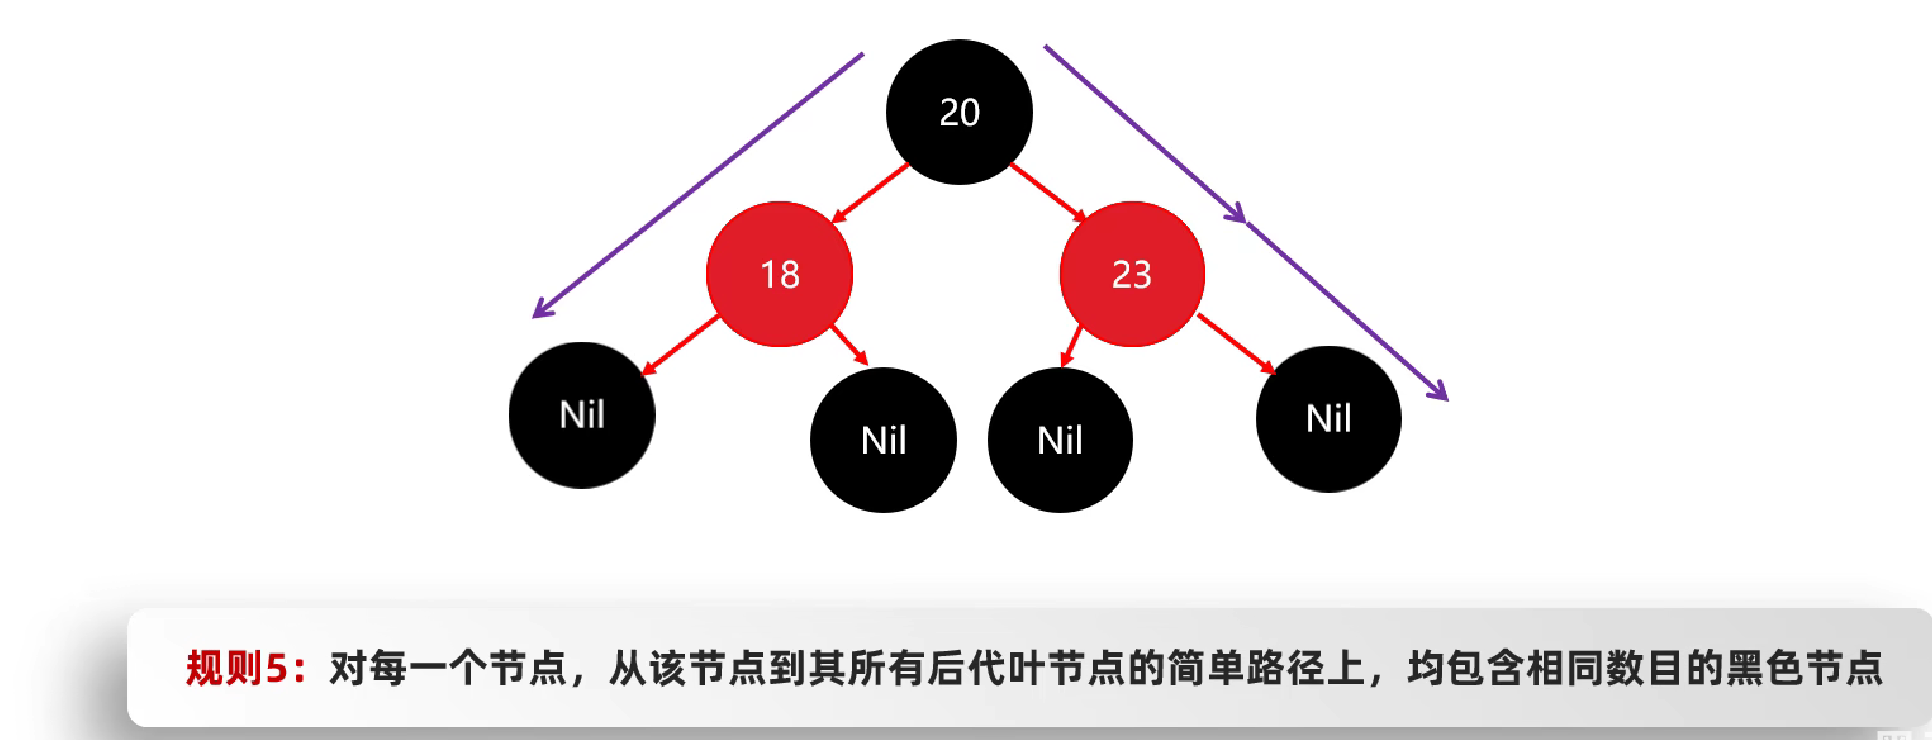
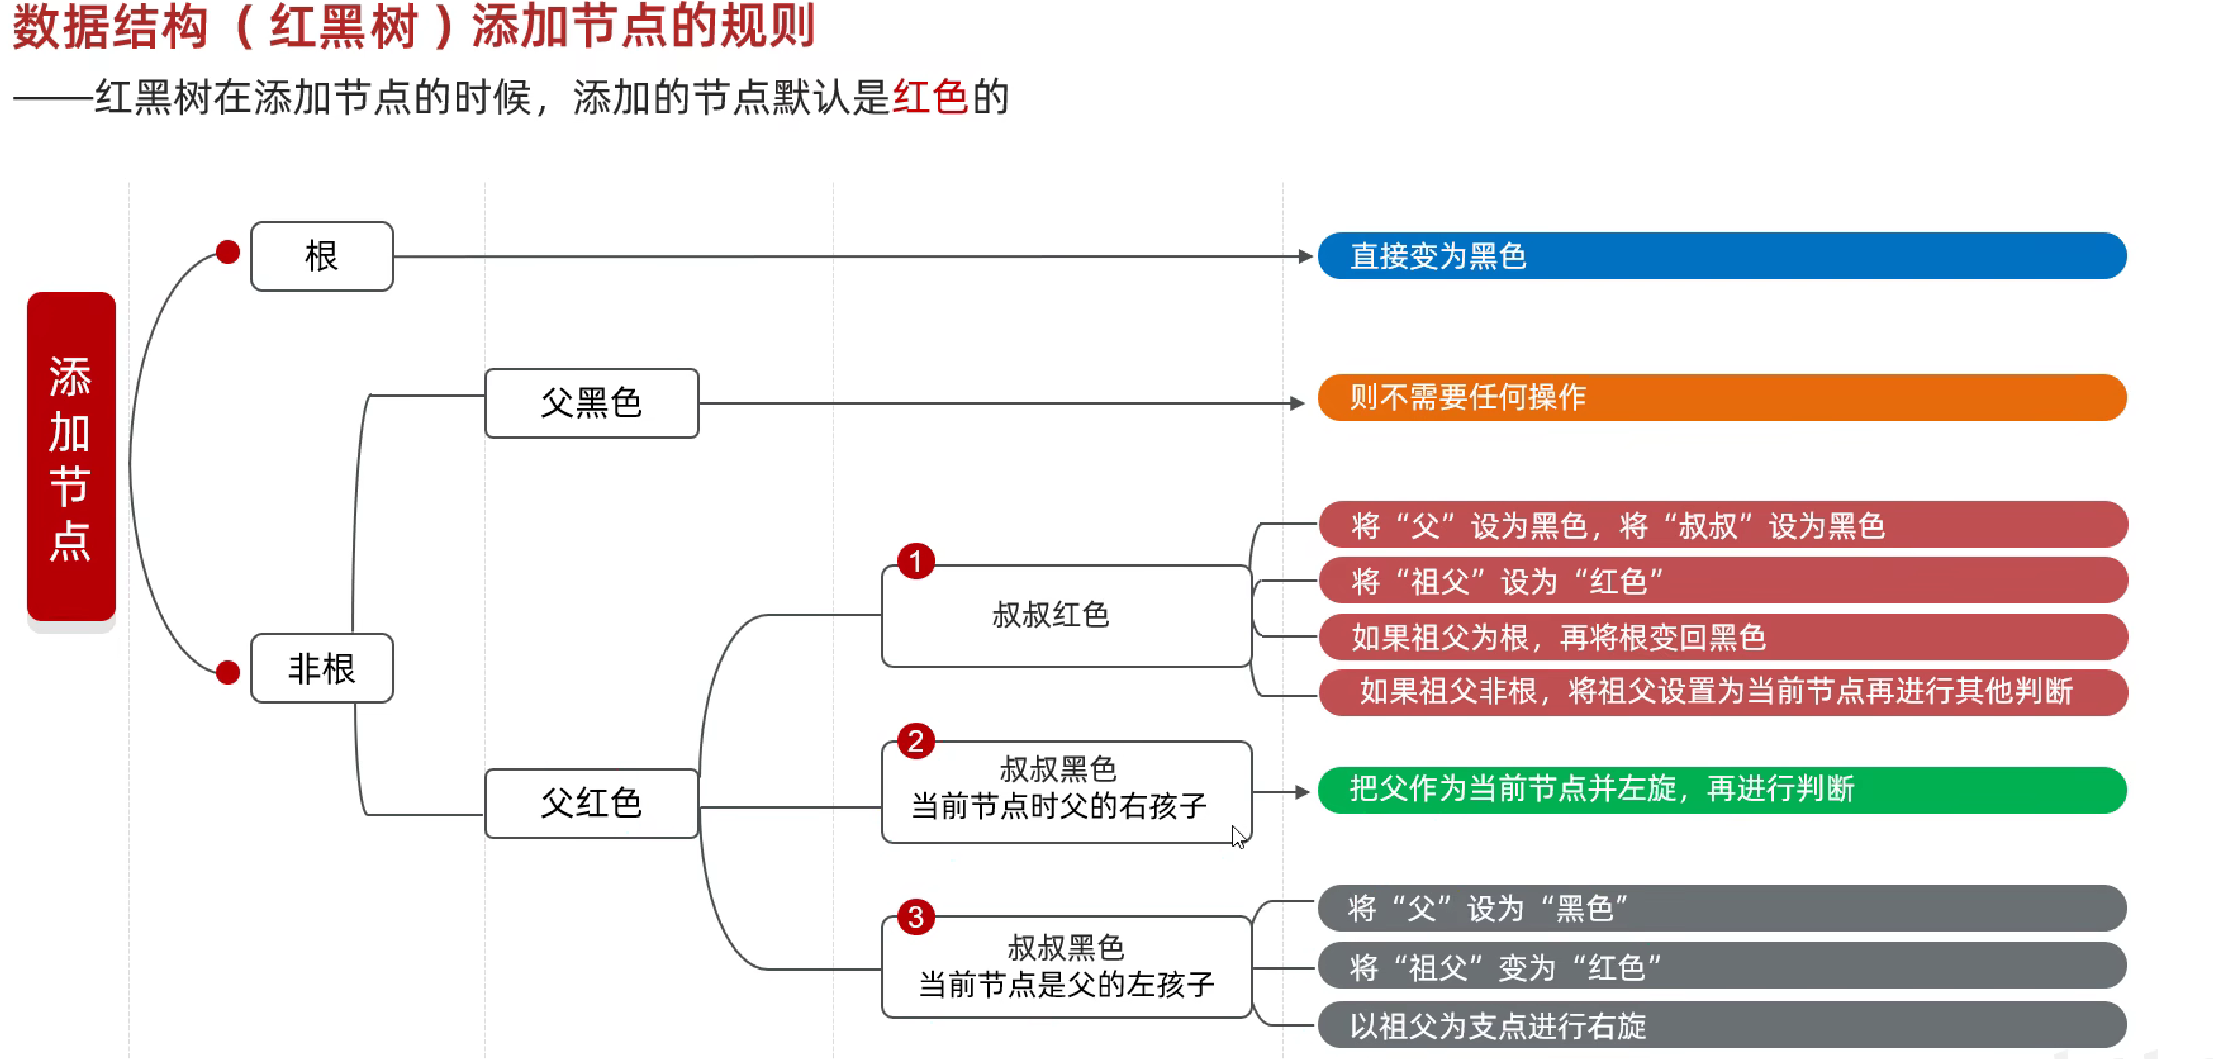
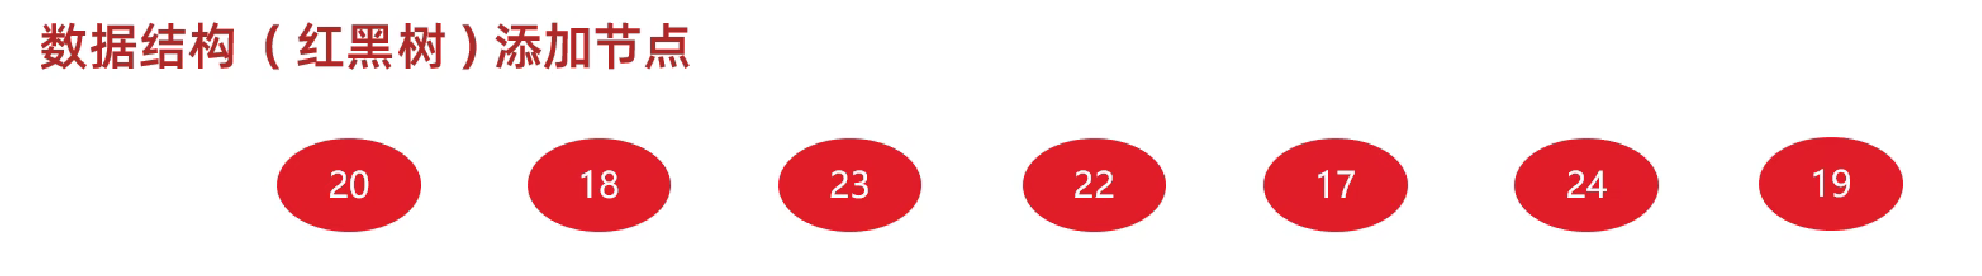
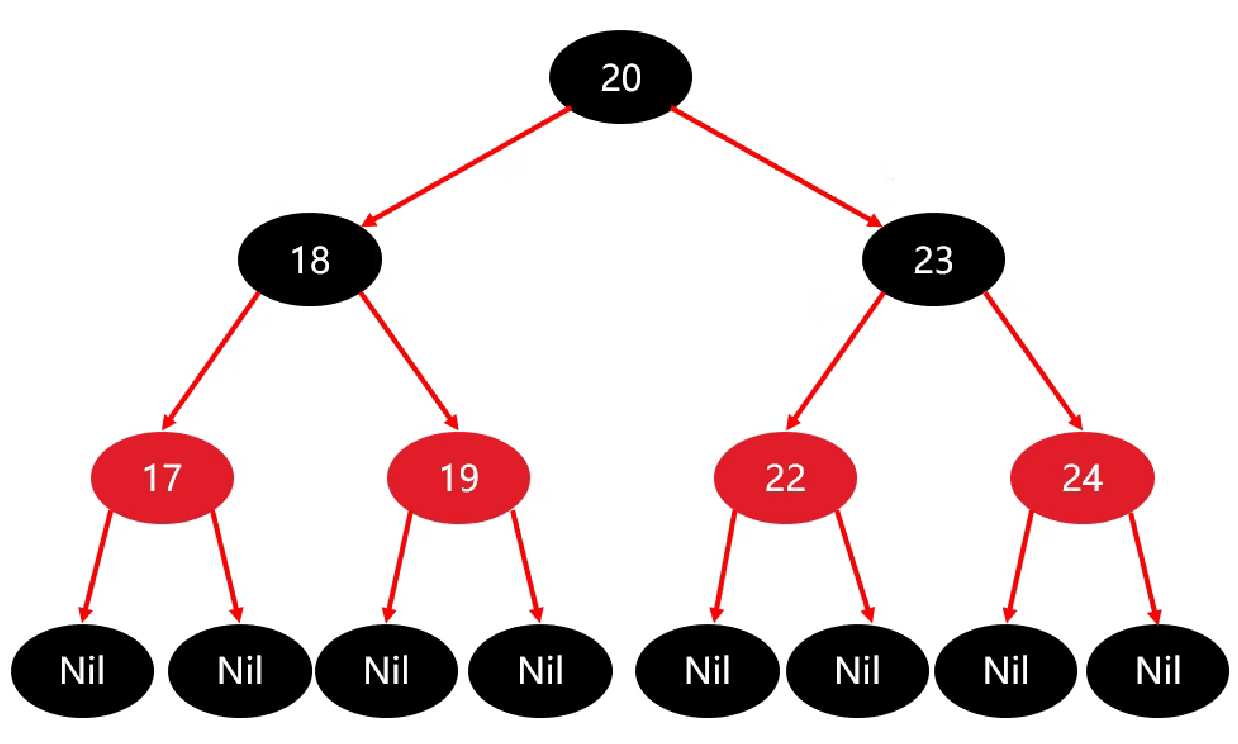
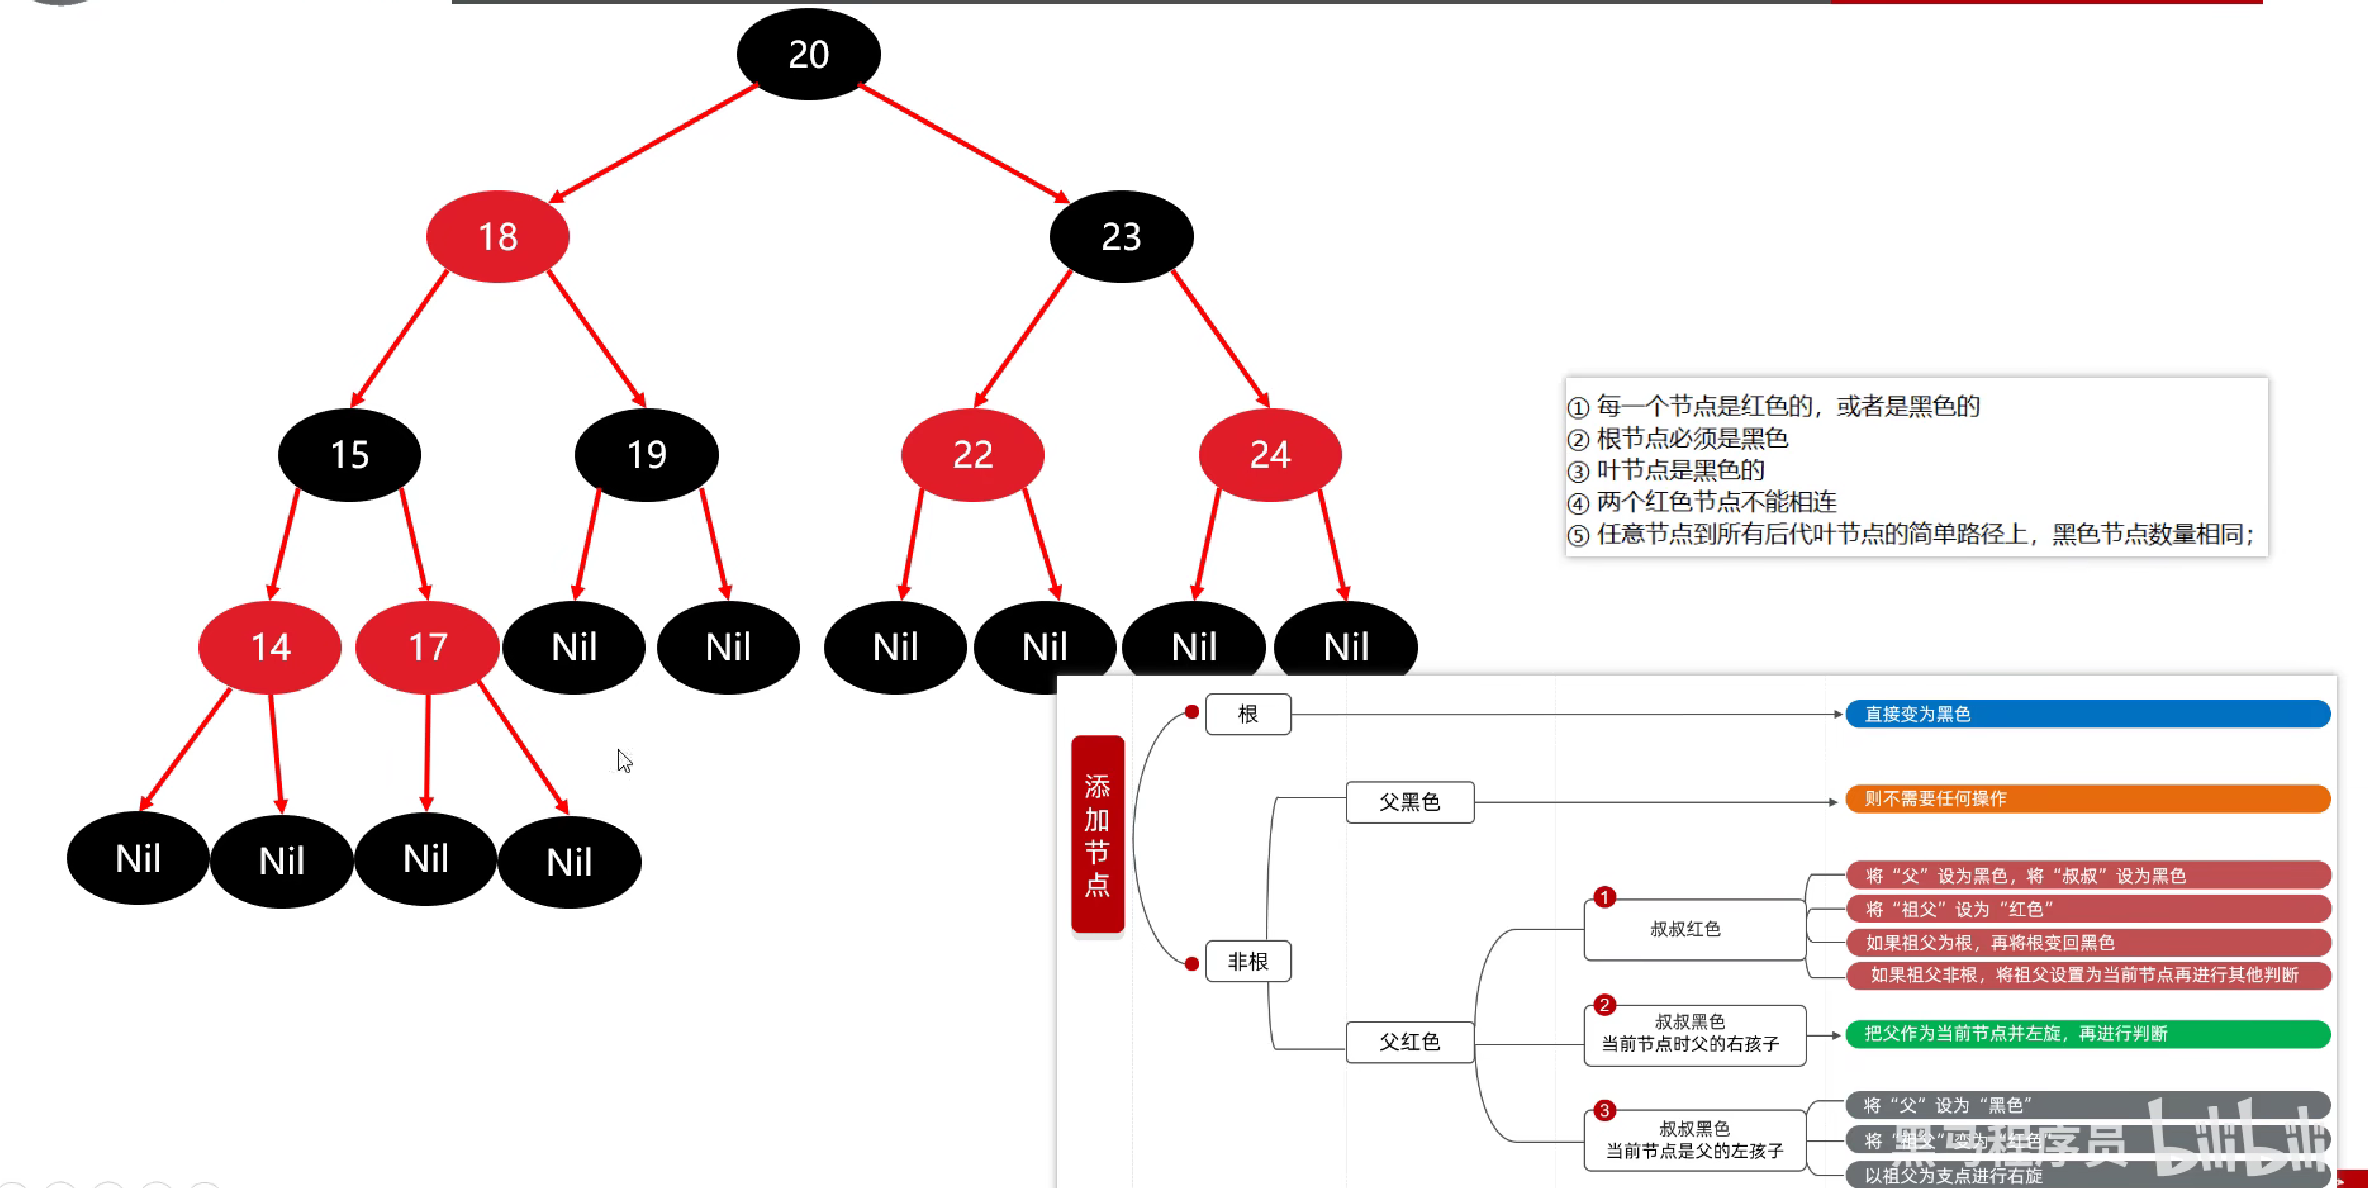
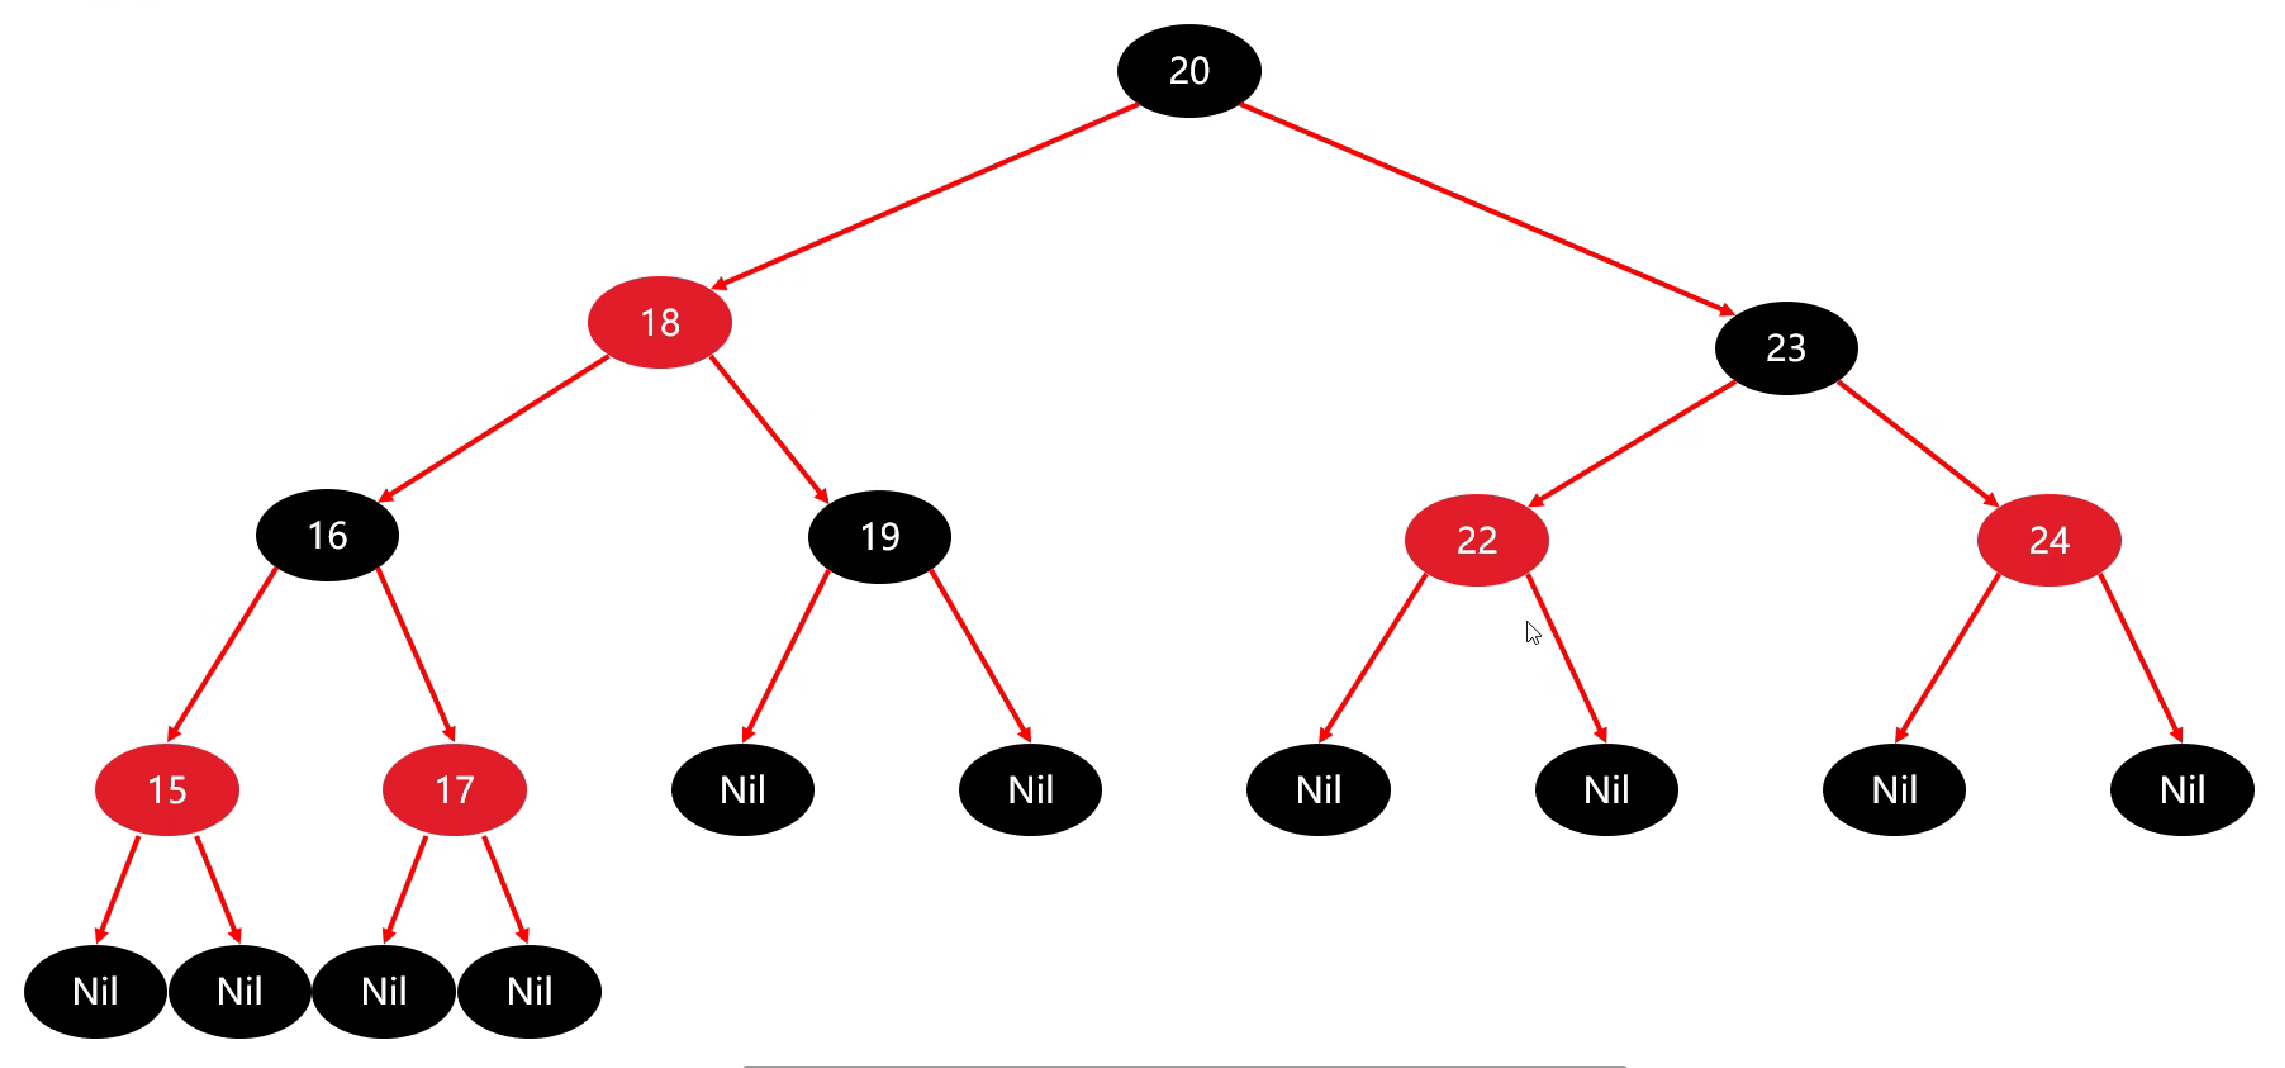
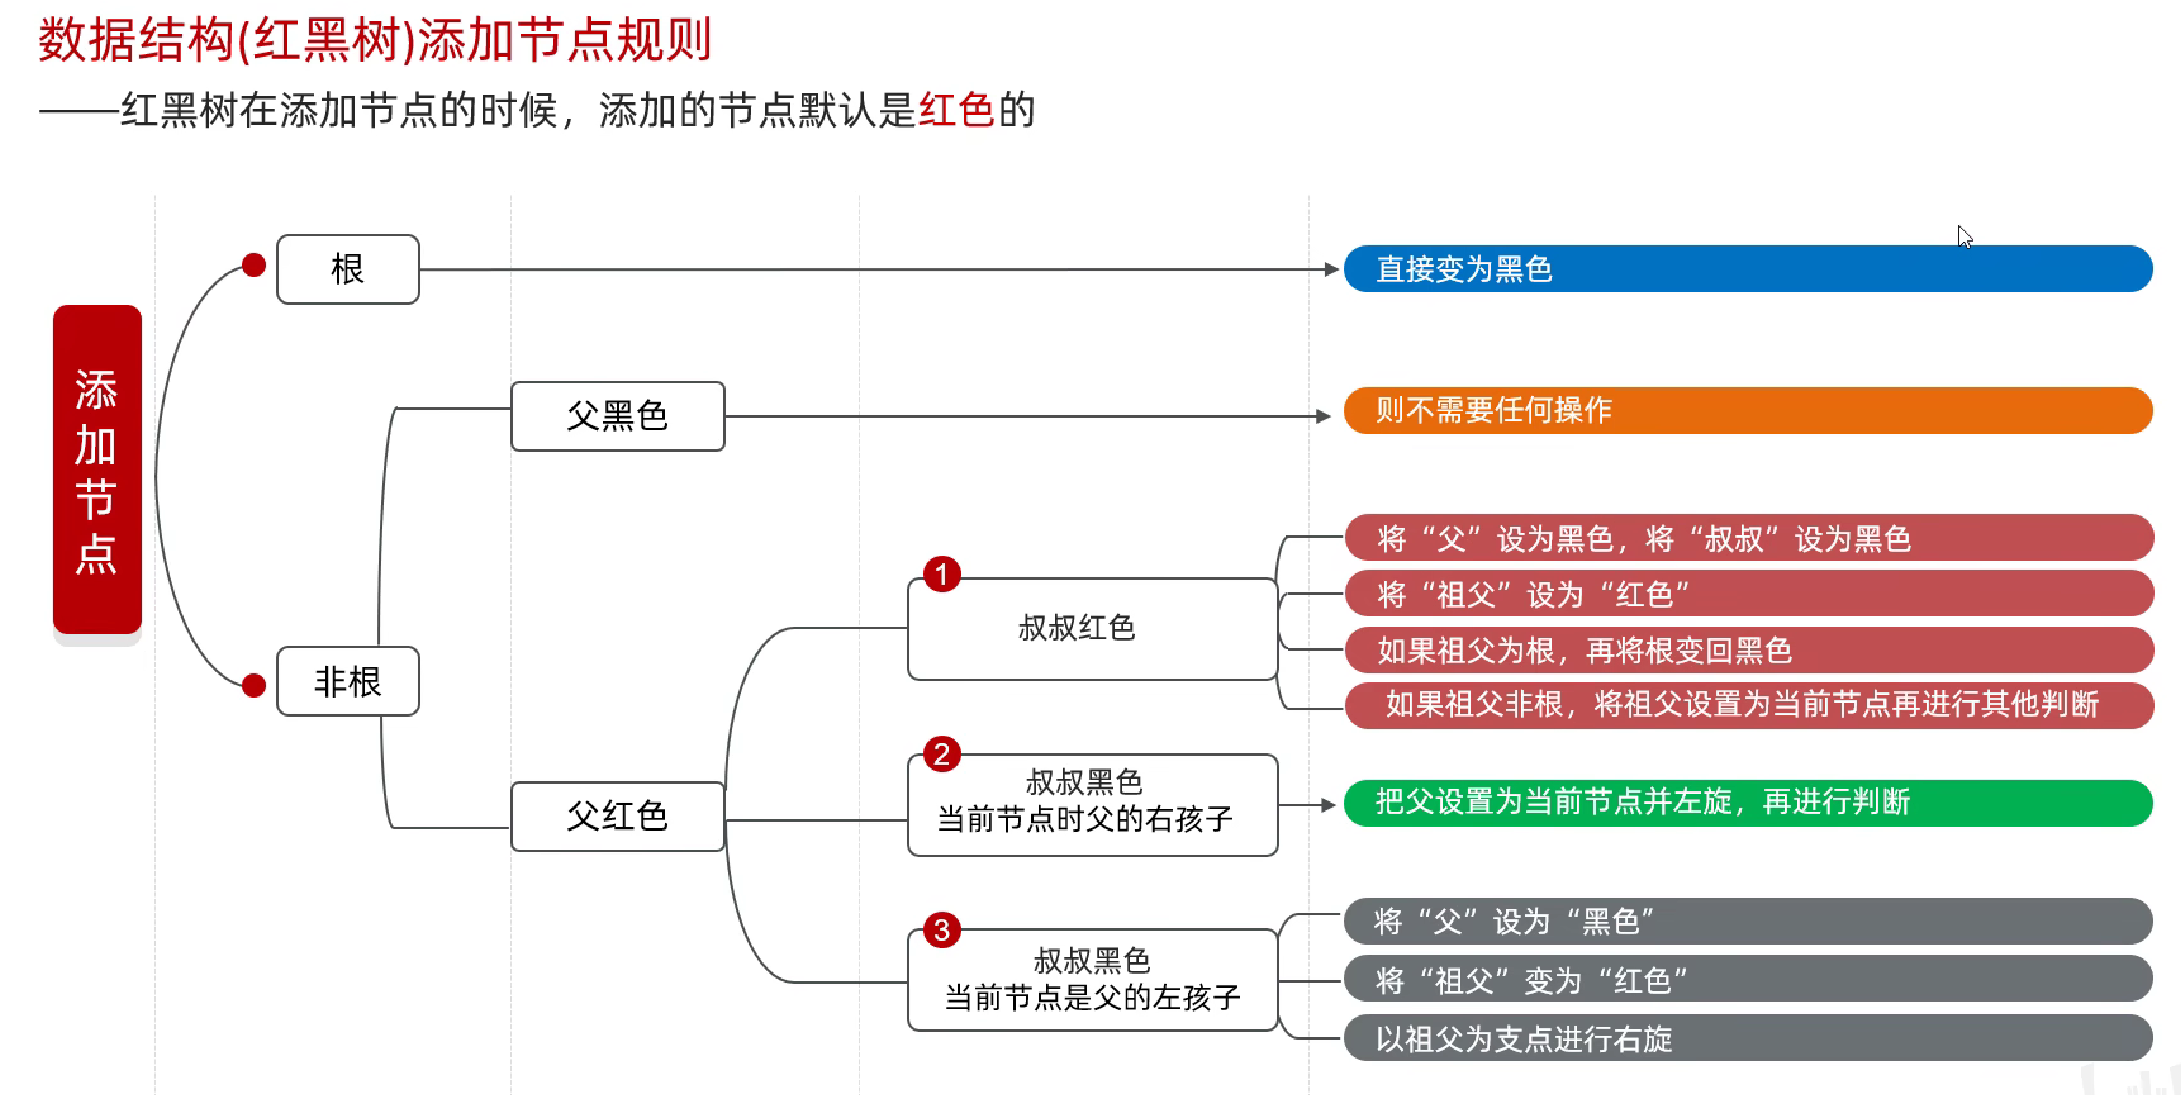
在添加的时候,按照这个添加节点规则进行添加即可。需注意,有可能在一次添加中当前判断还没结束,还会有第二次判断(父红色->叔叔红色->如果祖父非根,将祖父设置为当前节点再进行其他判断)。
Set系列集合
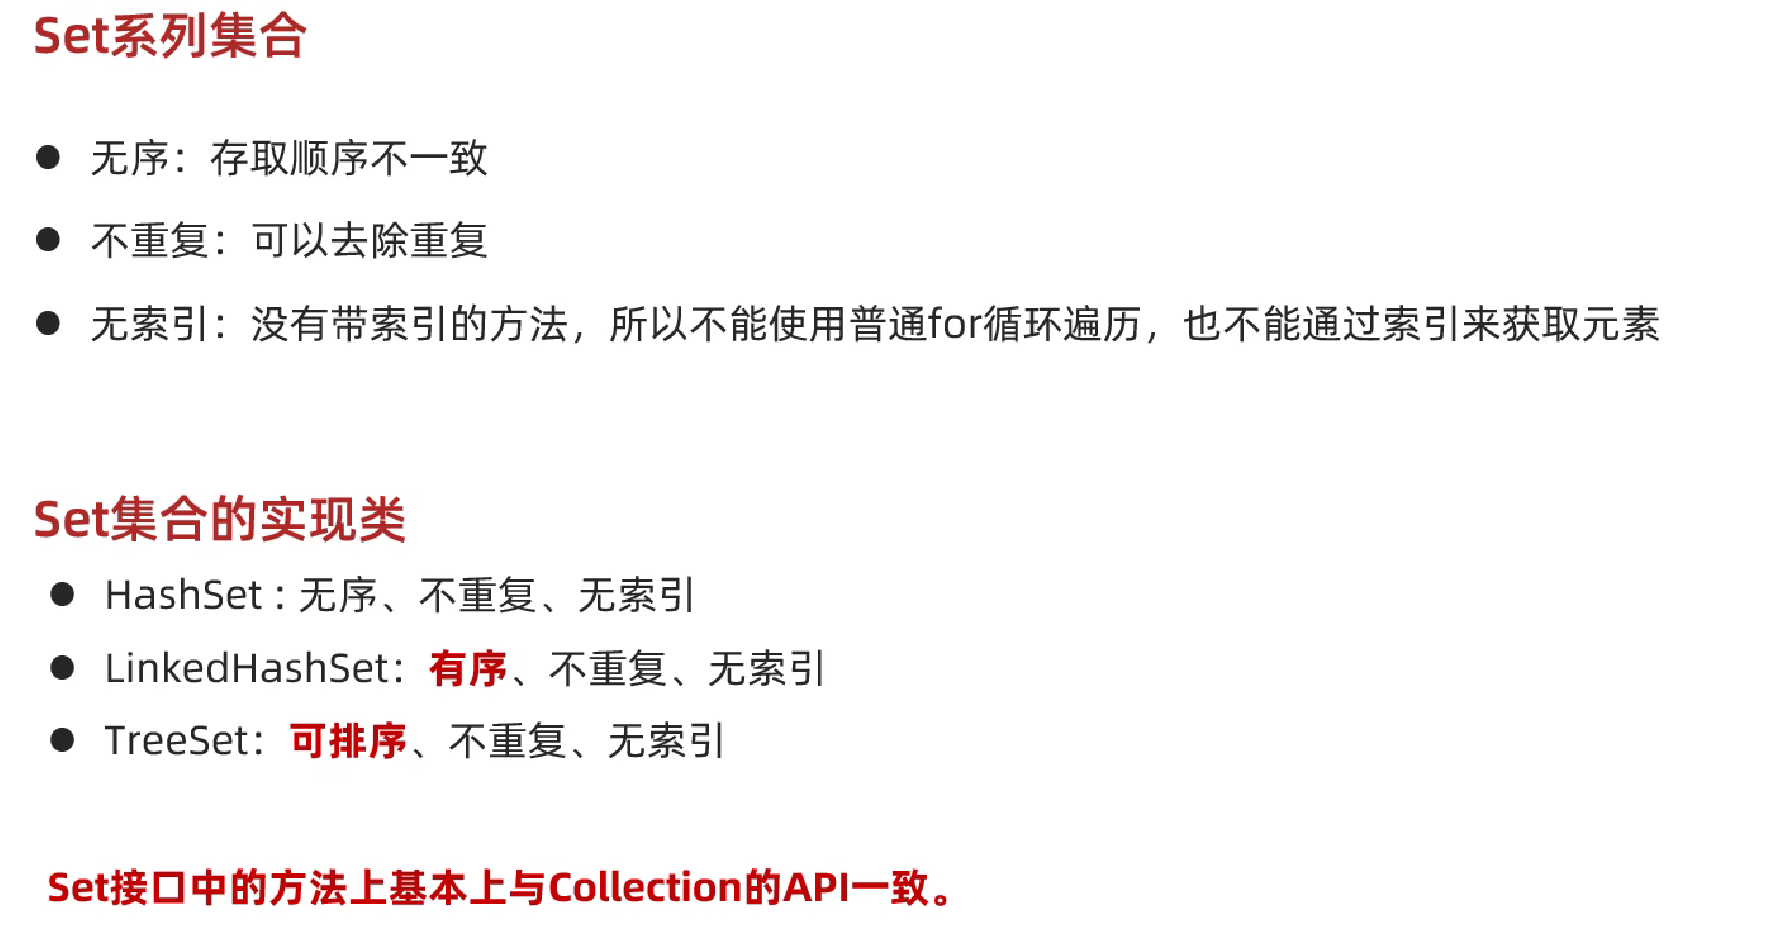
回顾Collection接口方法:
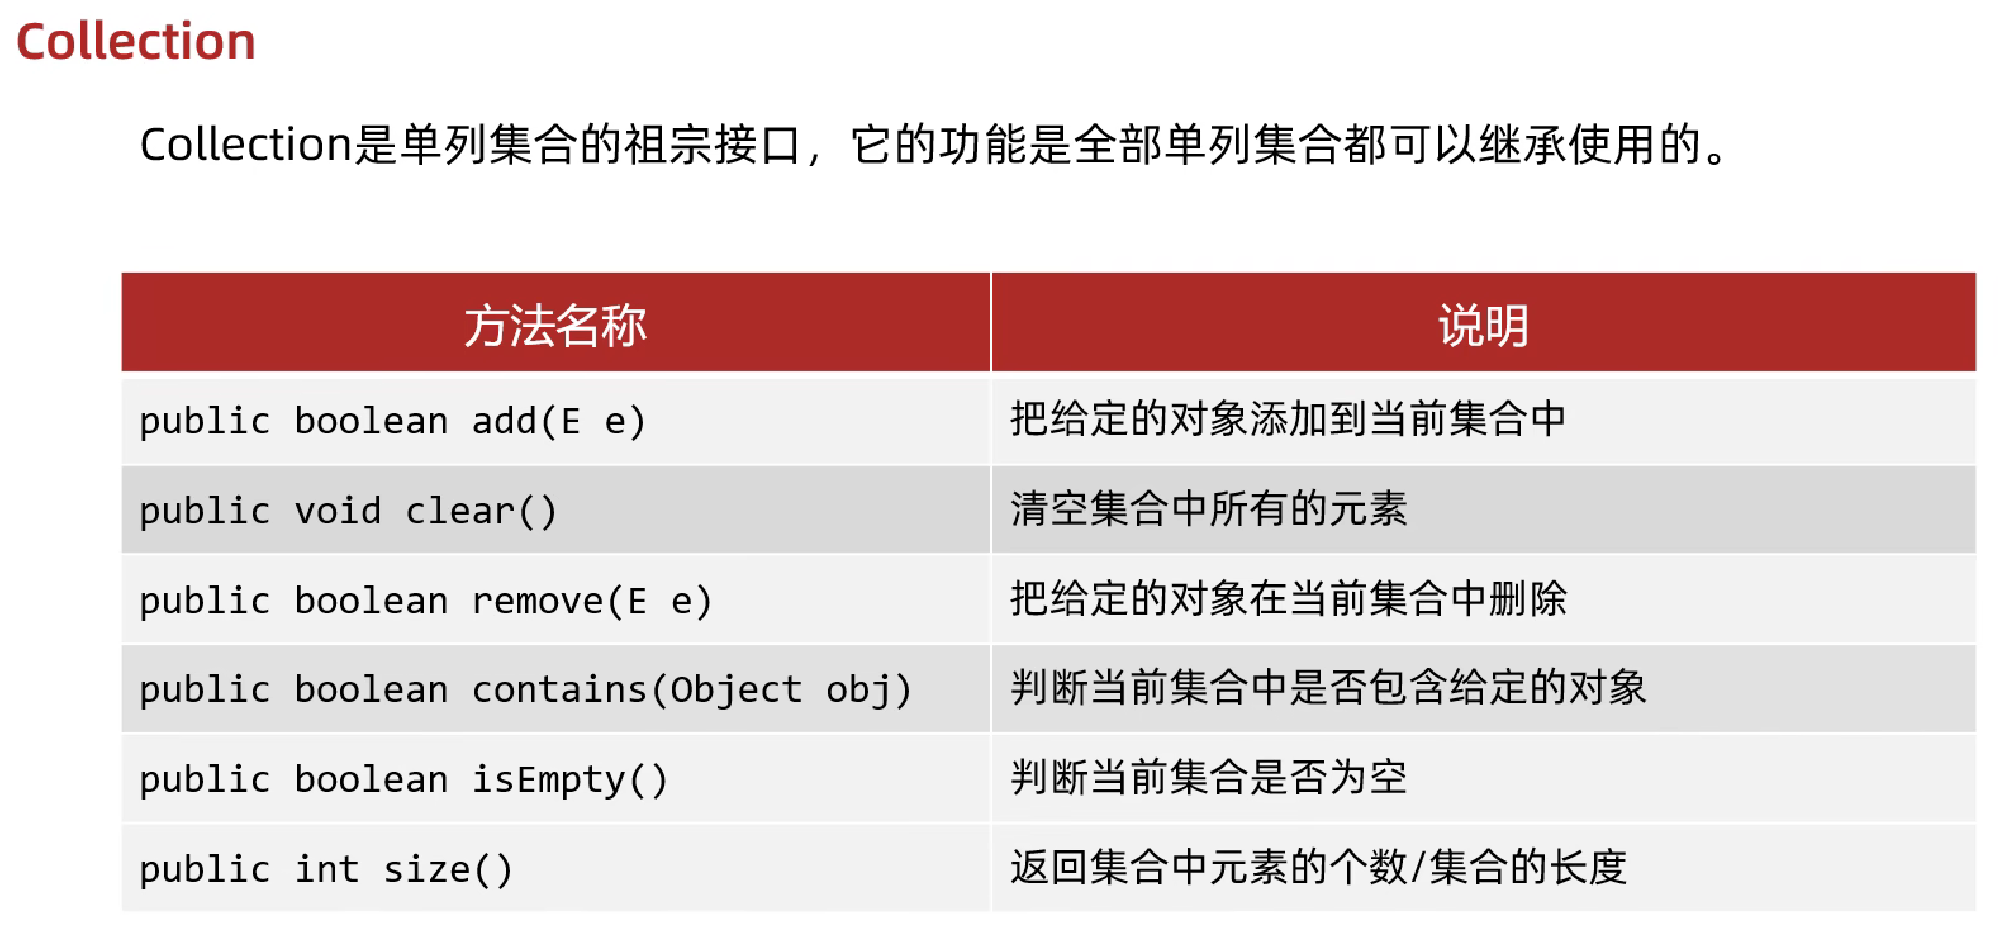
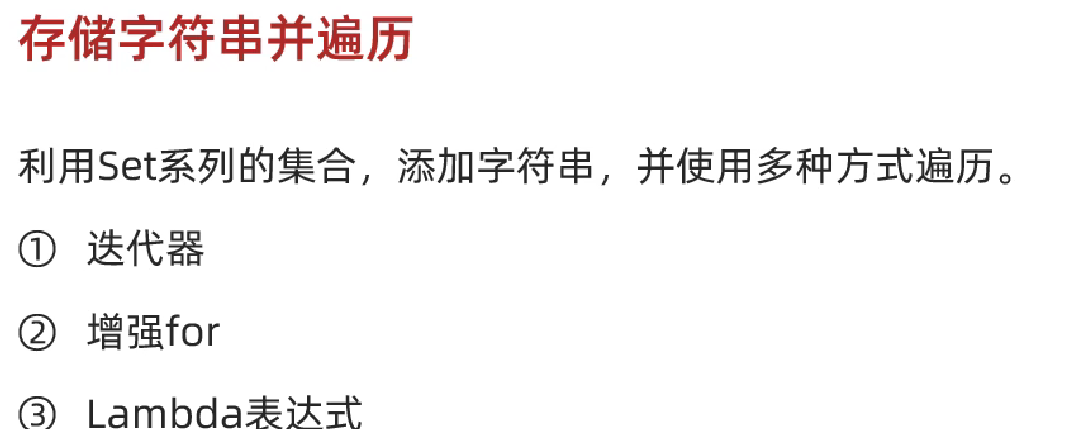
小练手(Set集合字符串遍历):
package mySet;

import java.util.HashSet;
import java.util.Iterator;
import java.util.Set;
import java.util.function.Consumer;

public class test1 {
    public static void main(String[] args) {
        Set<String> set1 = new HashSet<>();
        //Set集合添加时不能有重复的元素
        //若添加重复元素,则返回值为false,表示添加失败
        set1.add("aaa");
        set1.add("bbb");
        set1.add("ccc");

        //迭代器遍历
        System.out.println("迭代器遍历:");
        Iterator<String> it = set1.iterator();
        while (it.hasNext()) {
            String s = it.next();
            System.out.println(s);
        }

        //增强for遍历
        System.out.println("增强for遍历:");
        for (String s : set1) {
            System.out.println(s);
        }

        //Lambda表达式遍历
        System.out.println("Lambda表达式遍历:");
        set1.forEach( s -> System.out.println(s));
    }
}
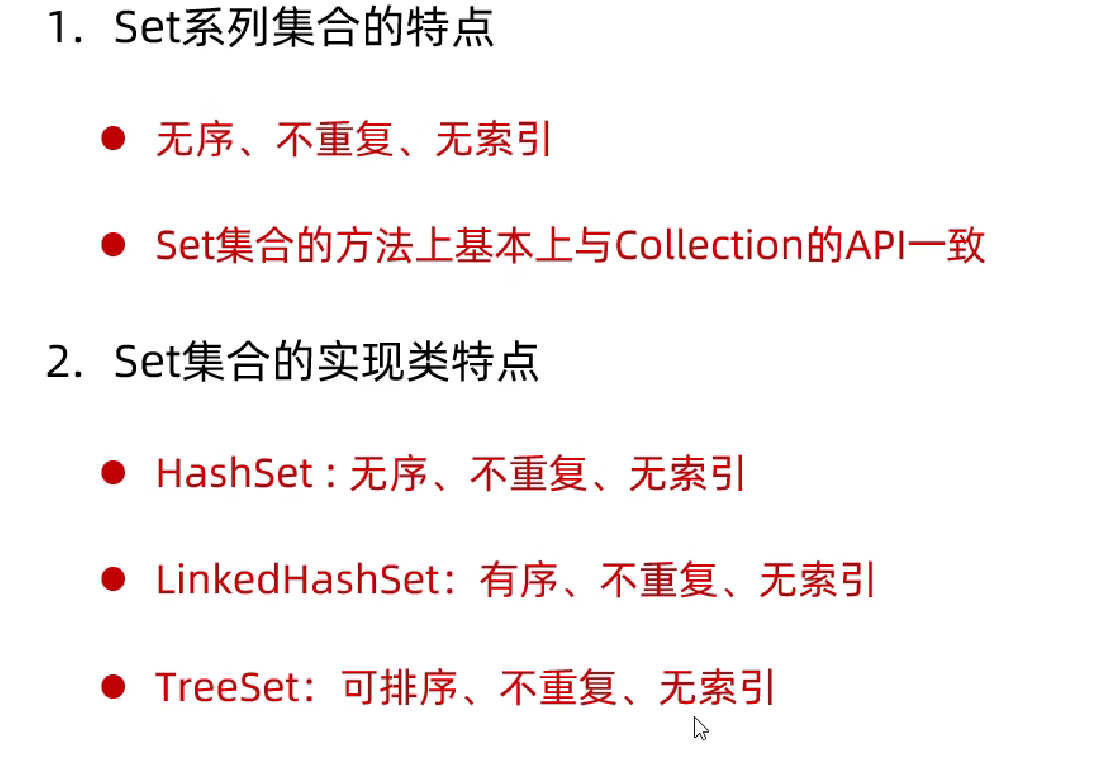
HashSet
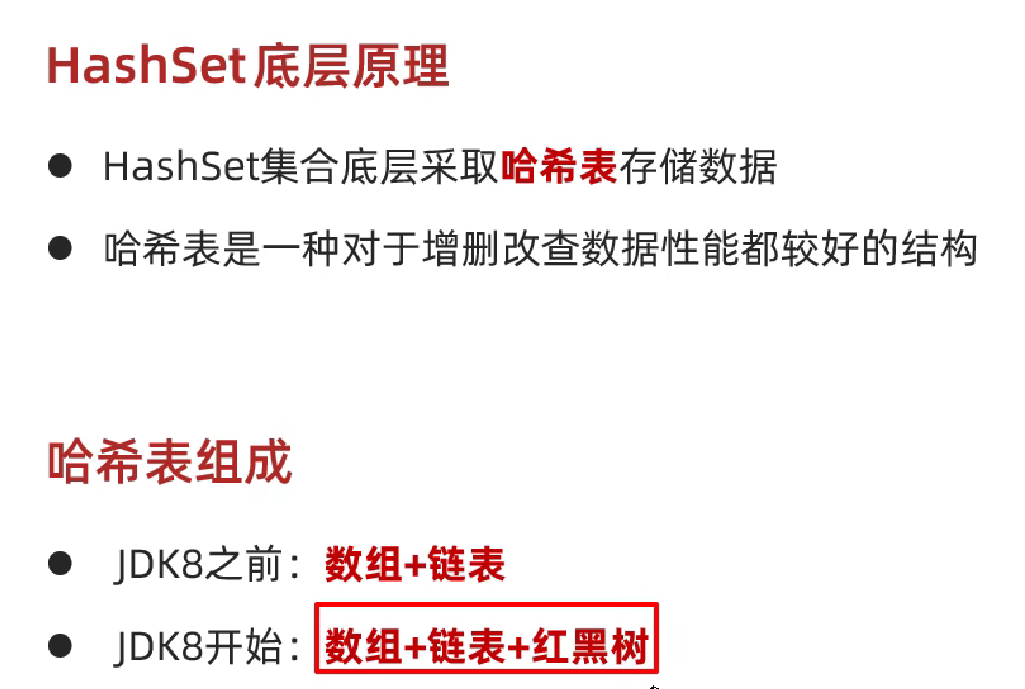
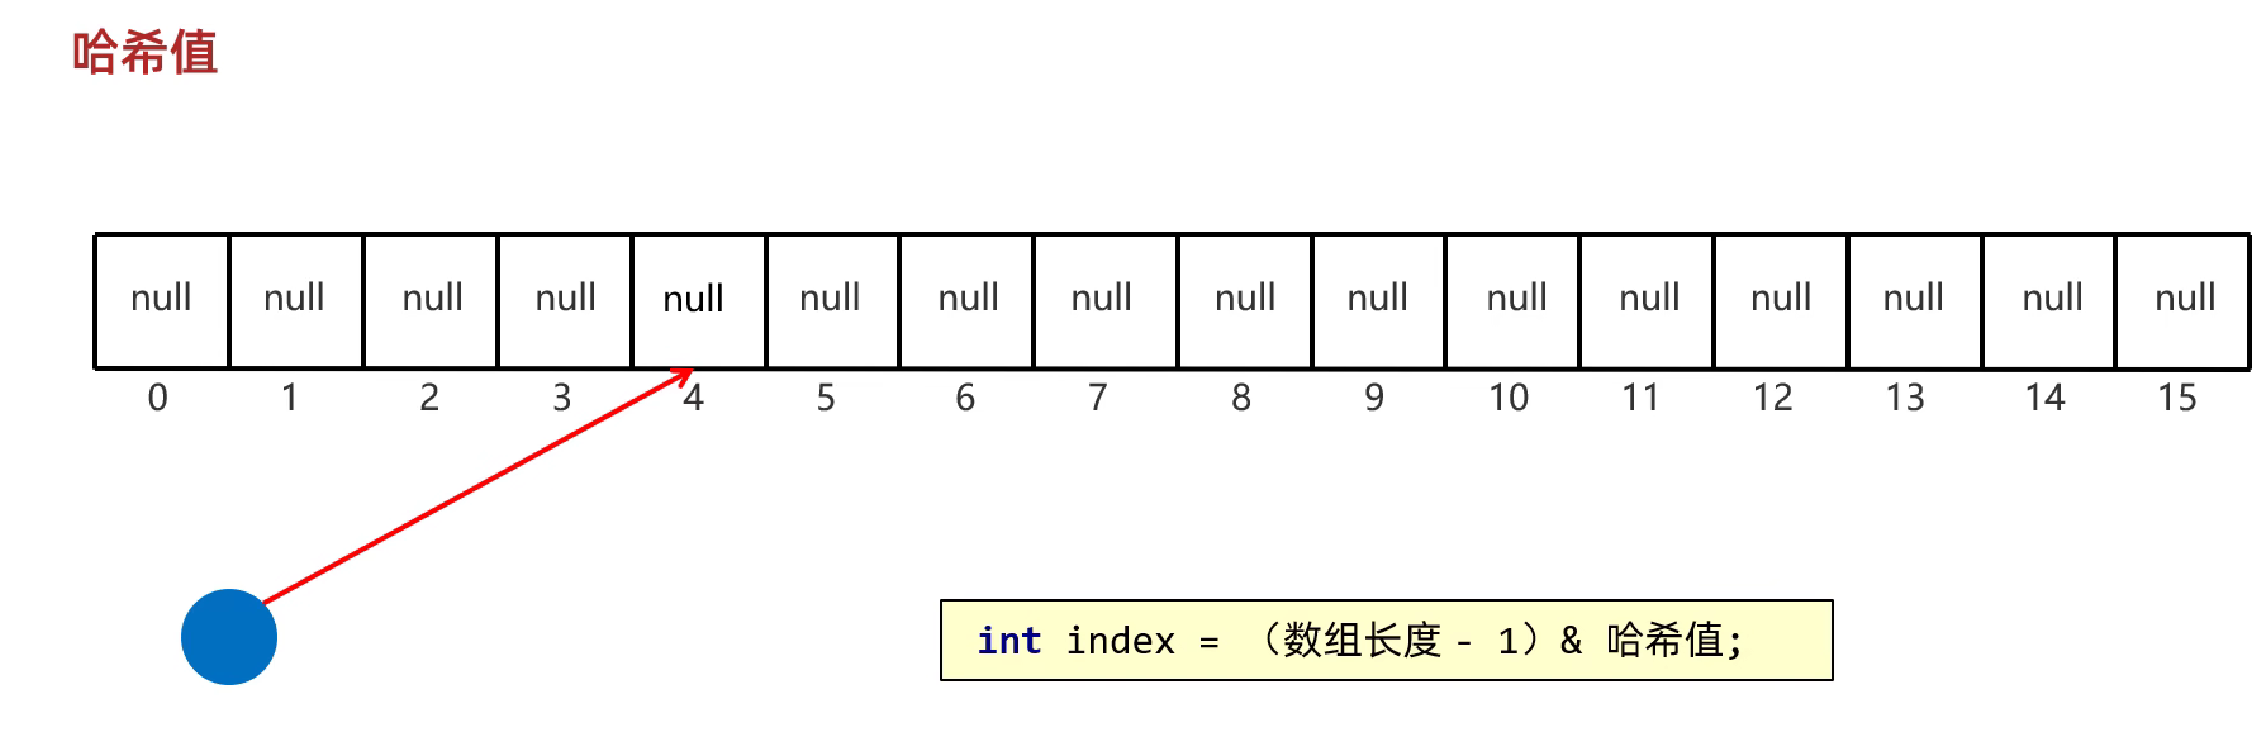
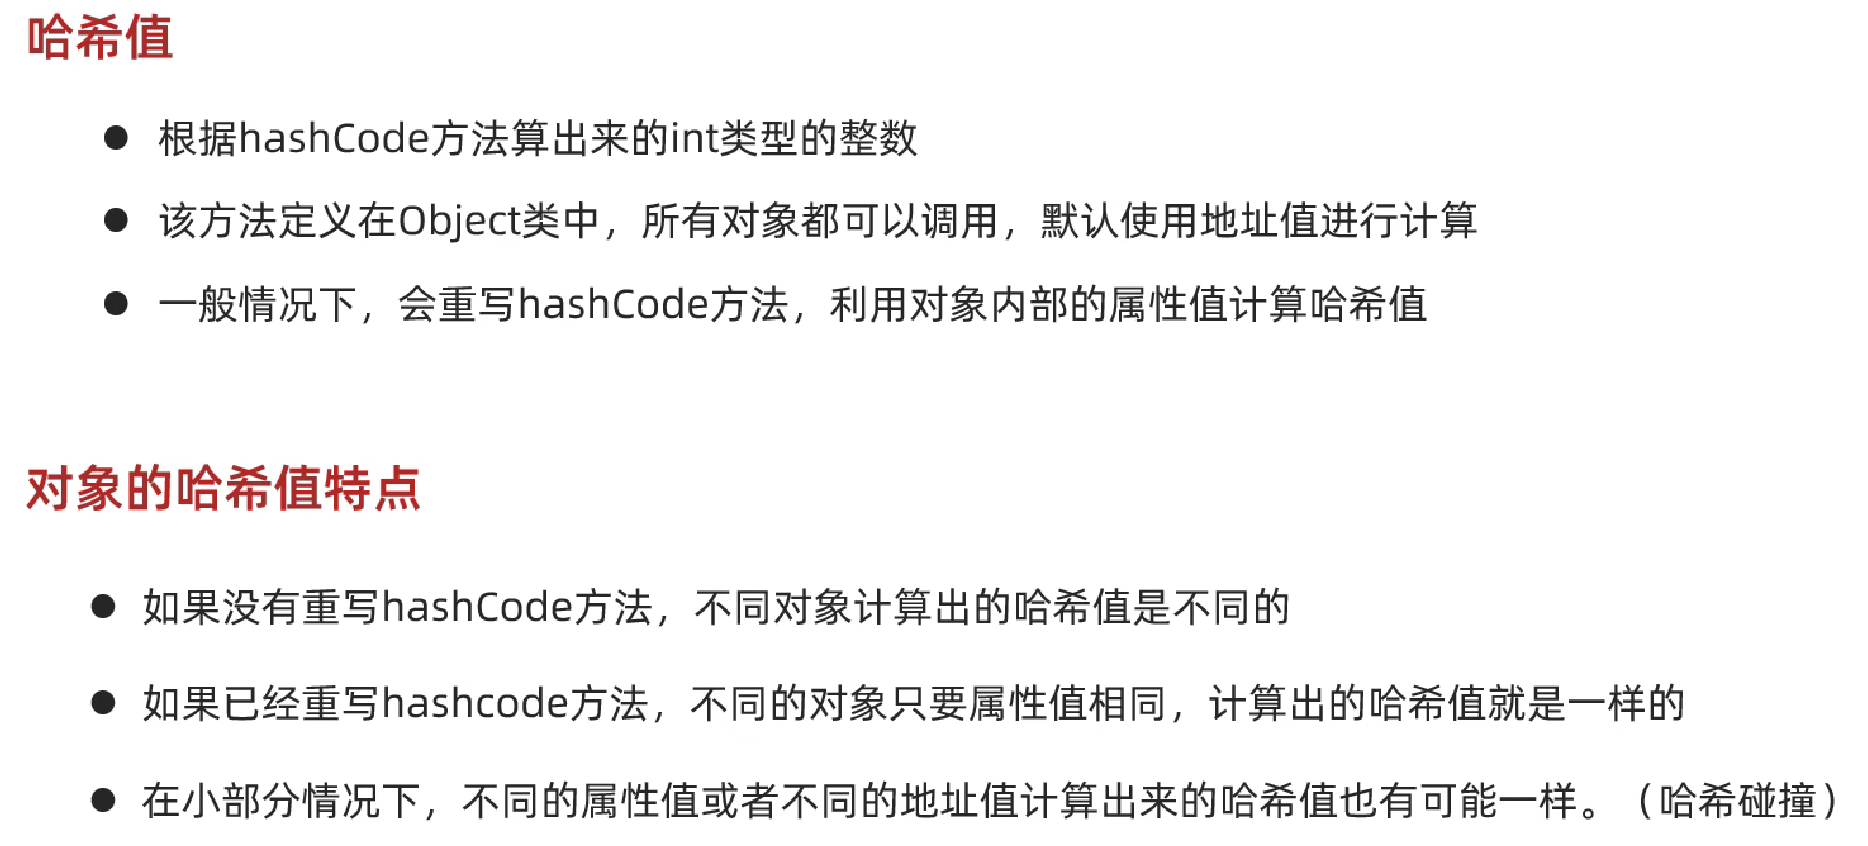
重写hashCode:
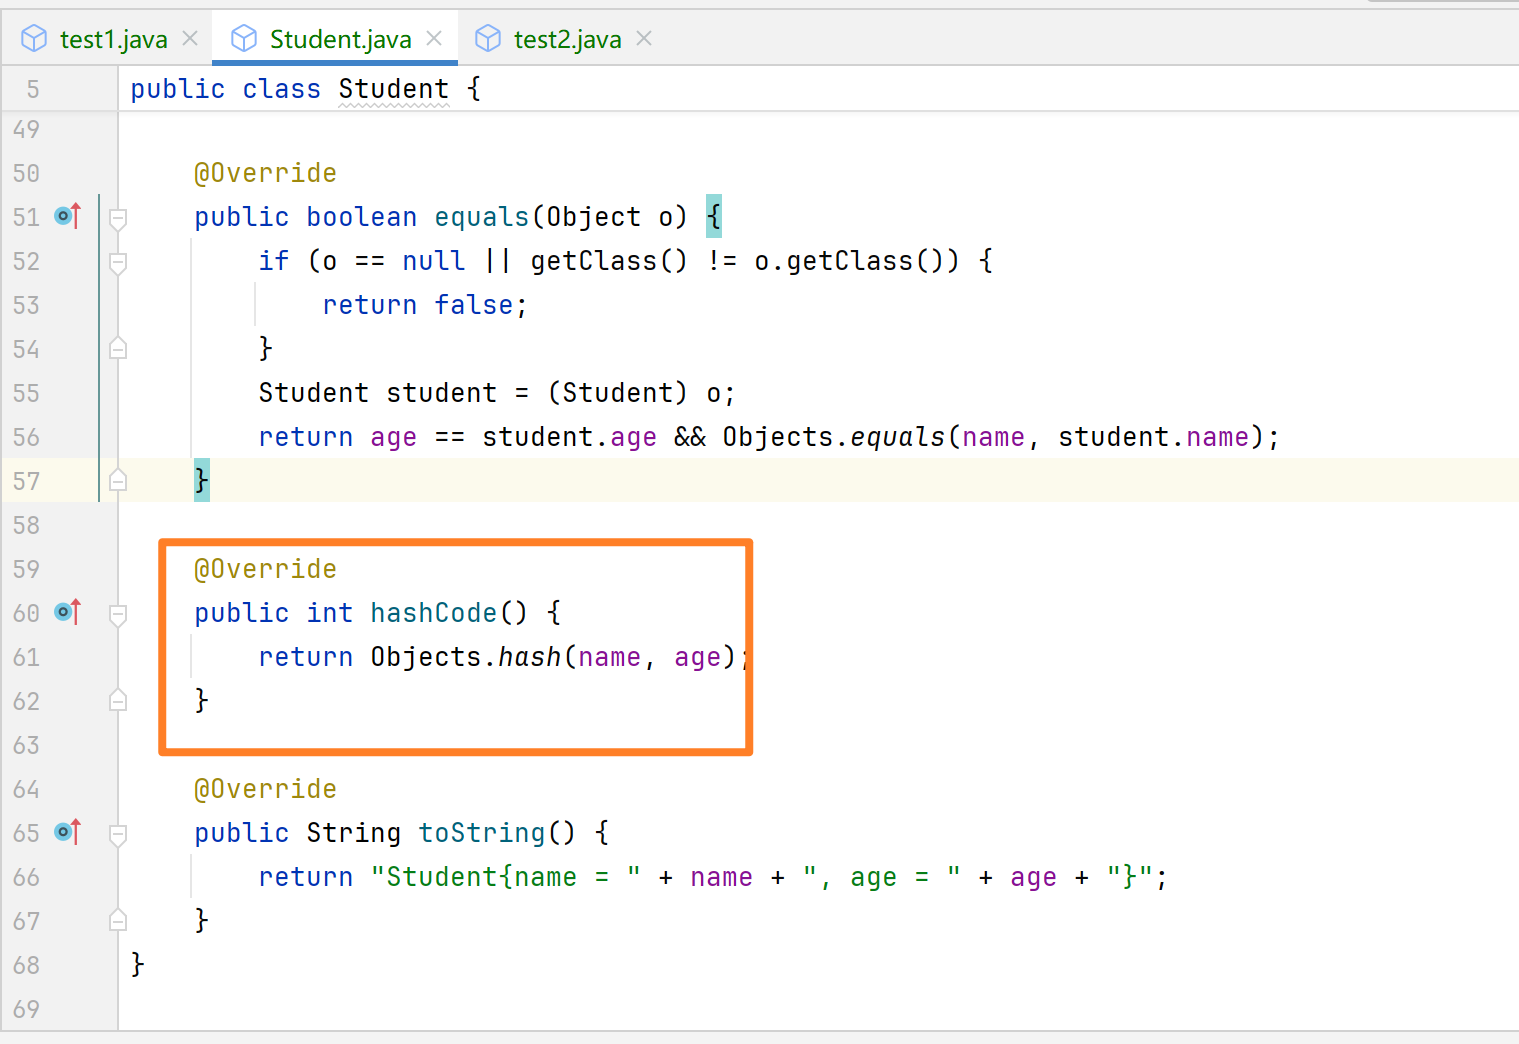
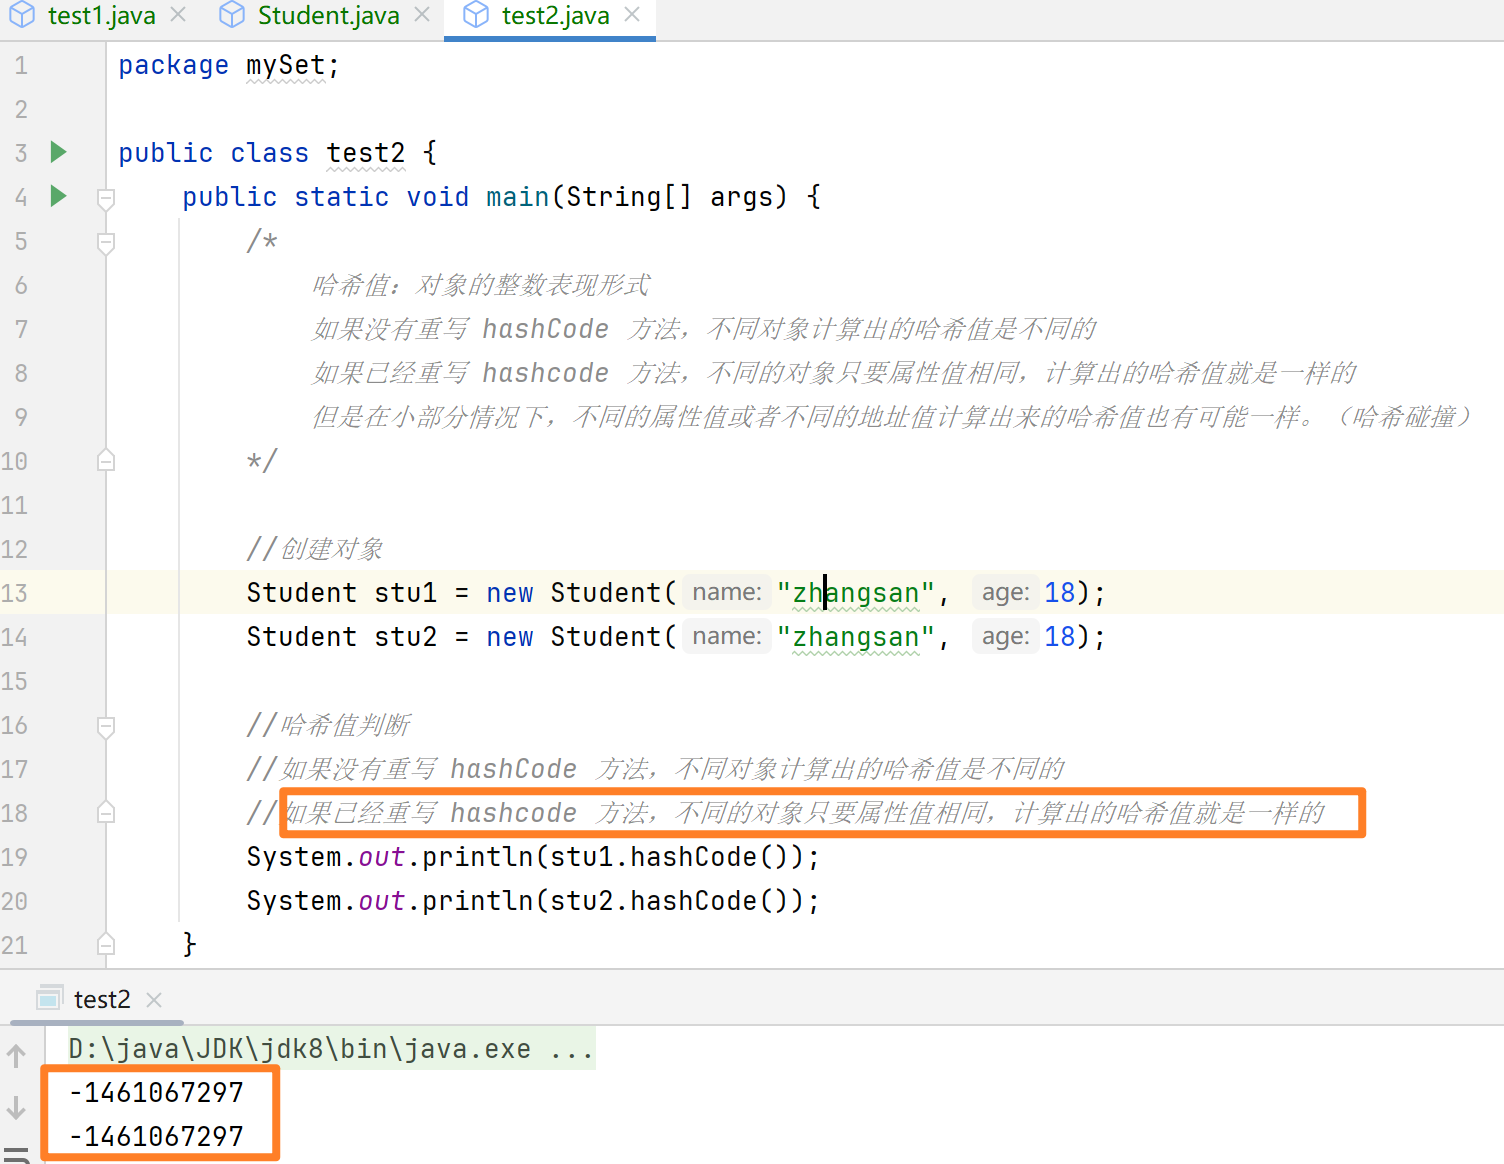
hashCode理解:
//Student.java
package mySet;

import java.util.Objects;

public class Student {
    private String name;
    private int age;


    public Student() {
    }

    public Student(String name, int age) {
        this.name = name;
        this.age = age;
    }

    /**
     * 获取
     * @return name
     */
    public String getName() {
        return name;
    }

    /**
     * 设置
     * @param name
     */
    public void setName(String name) {
        this.name = name;
    }

    /**
     * 获取
     * @return age
     */
    public int getAge() {
        return age;
    }

    /**
     * 设置
     * @param age
     */
    public void setAge(int age) {
        this.age = age;
    }

    @Override
    public boolean equals(Object o) {
        if (o == null || getClass() != o.getClass()) {
            return false;
        }
        Student student = (Student) o;
        return age == student.age && Objects.equals(name, student.name);
    }

    @Override
    public int hashCode() {
        return Objects.hash(name, age);
    }

    @Override
    public String toString() {
        return "Student{name = " + name + ", age = " + age + "}";
    }
}

//test2.java
package mySet;

public class test2 {
    public static void main(String[] args) {
        /*
            哈希值:对象的整数表现形式
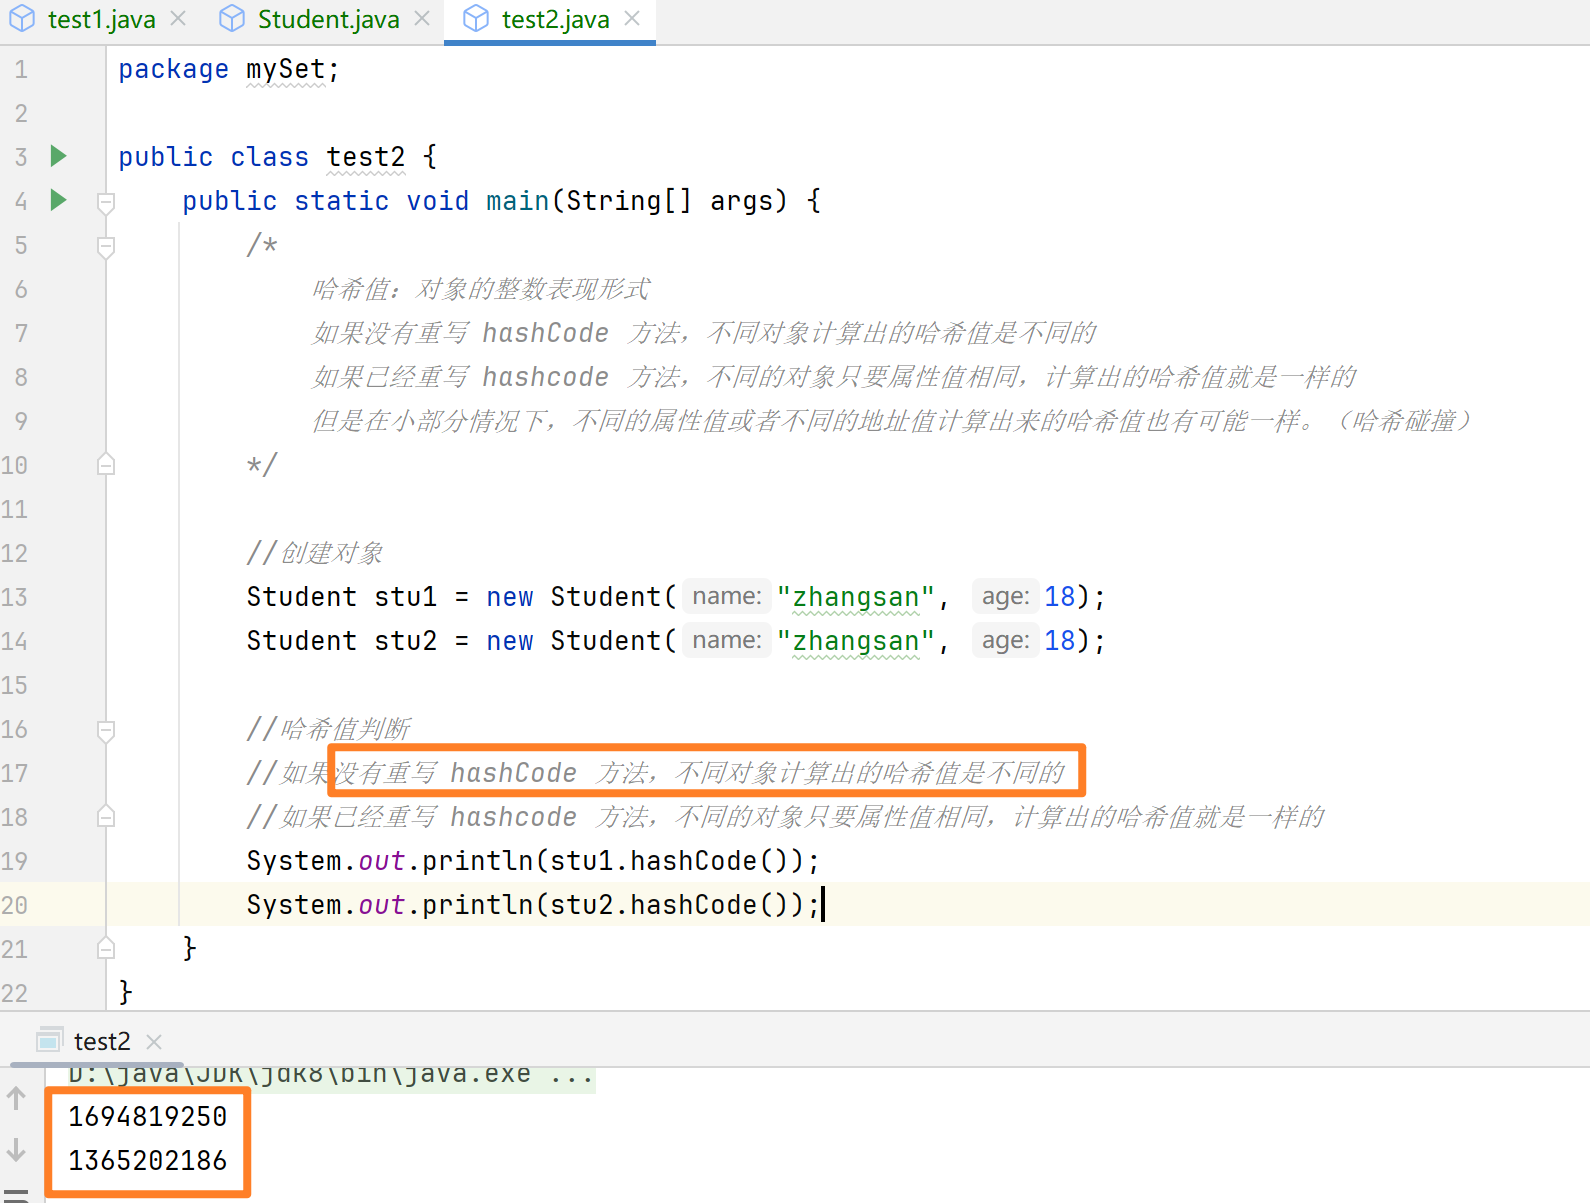
            如果没有重写 hashCode 方法,不同对象计算出的哈希值是不同的
            如果已经重写 hashcode 方法,不同的对象只要属性值相同,计算出的哈希值就是一样的
            但是在小部分情况下,不同的属性值或者不同的地址值计算出来的哈希值也有可能一样。(哈希碰撞)
        */

        //创建对象
        Student stu1 = new Student("zhangsan", 18);
        Student stu2 = new Student("zhangsan", 18);

        //哈希值判断
        //如果没有重写 hashCode 方法,不同对象计算出的哈希值是不同的
        //如果已经重写 hashcode 方法,不同的对象只要属性值相同,计算出的哈希值就是一样的
        System.out.println(stu1.hashCode());
        System.out.println(stu2.hashCode());

        //在小部分情况下,不同的属性值或者不同的地址值计算出来的哈希值也有可能一样。(哈希碰撞)
        System.out.println("abc".hashCode());//96354
        System.out.println("acD".hashCode());//96354
    }
}
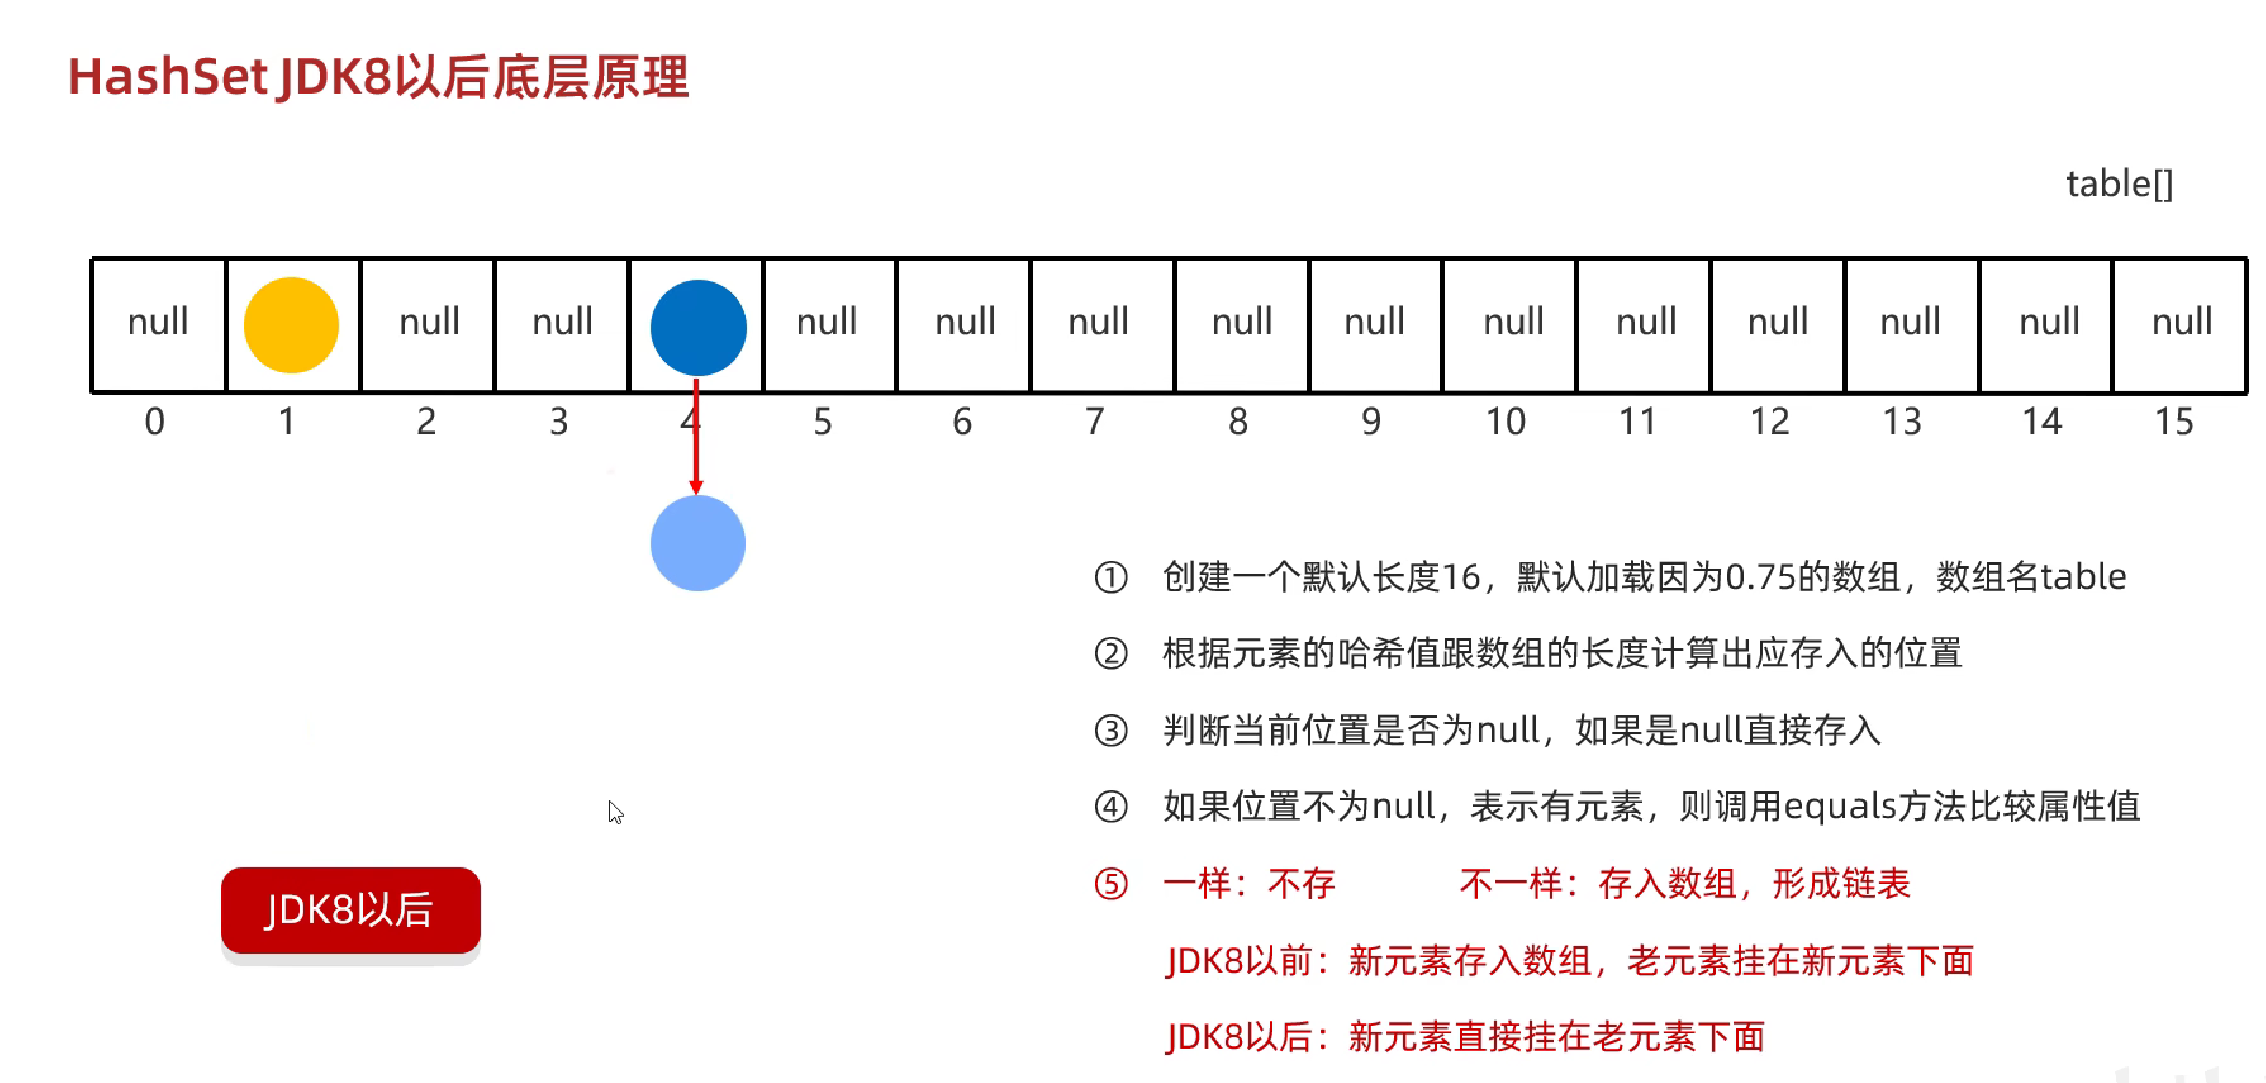
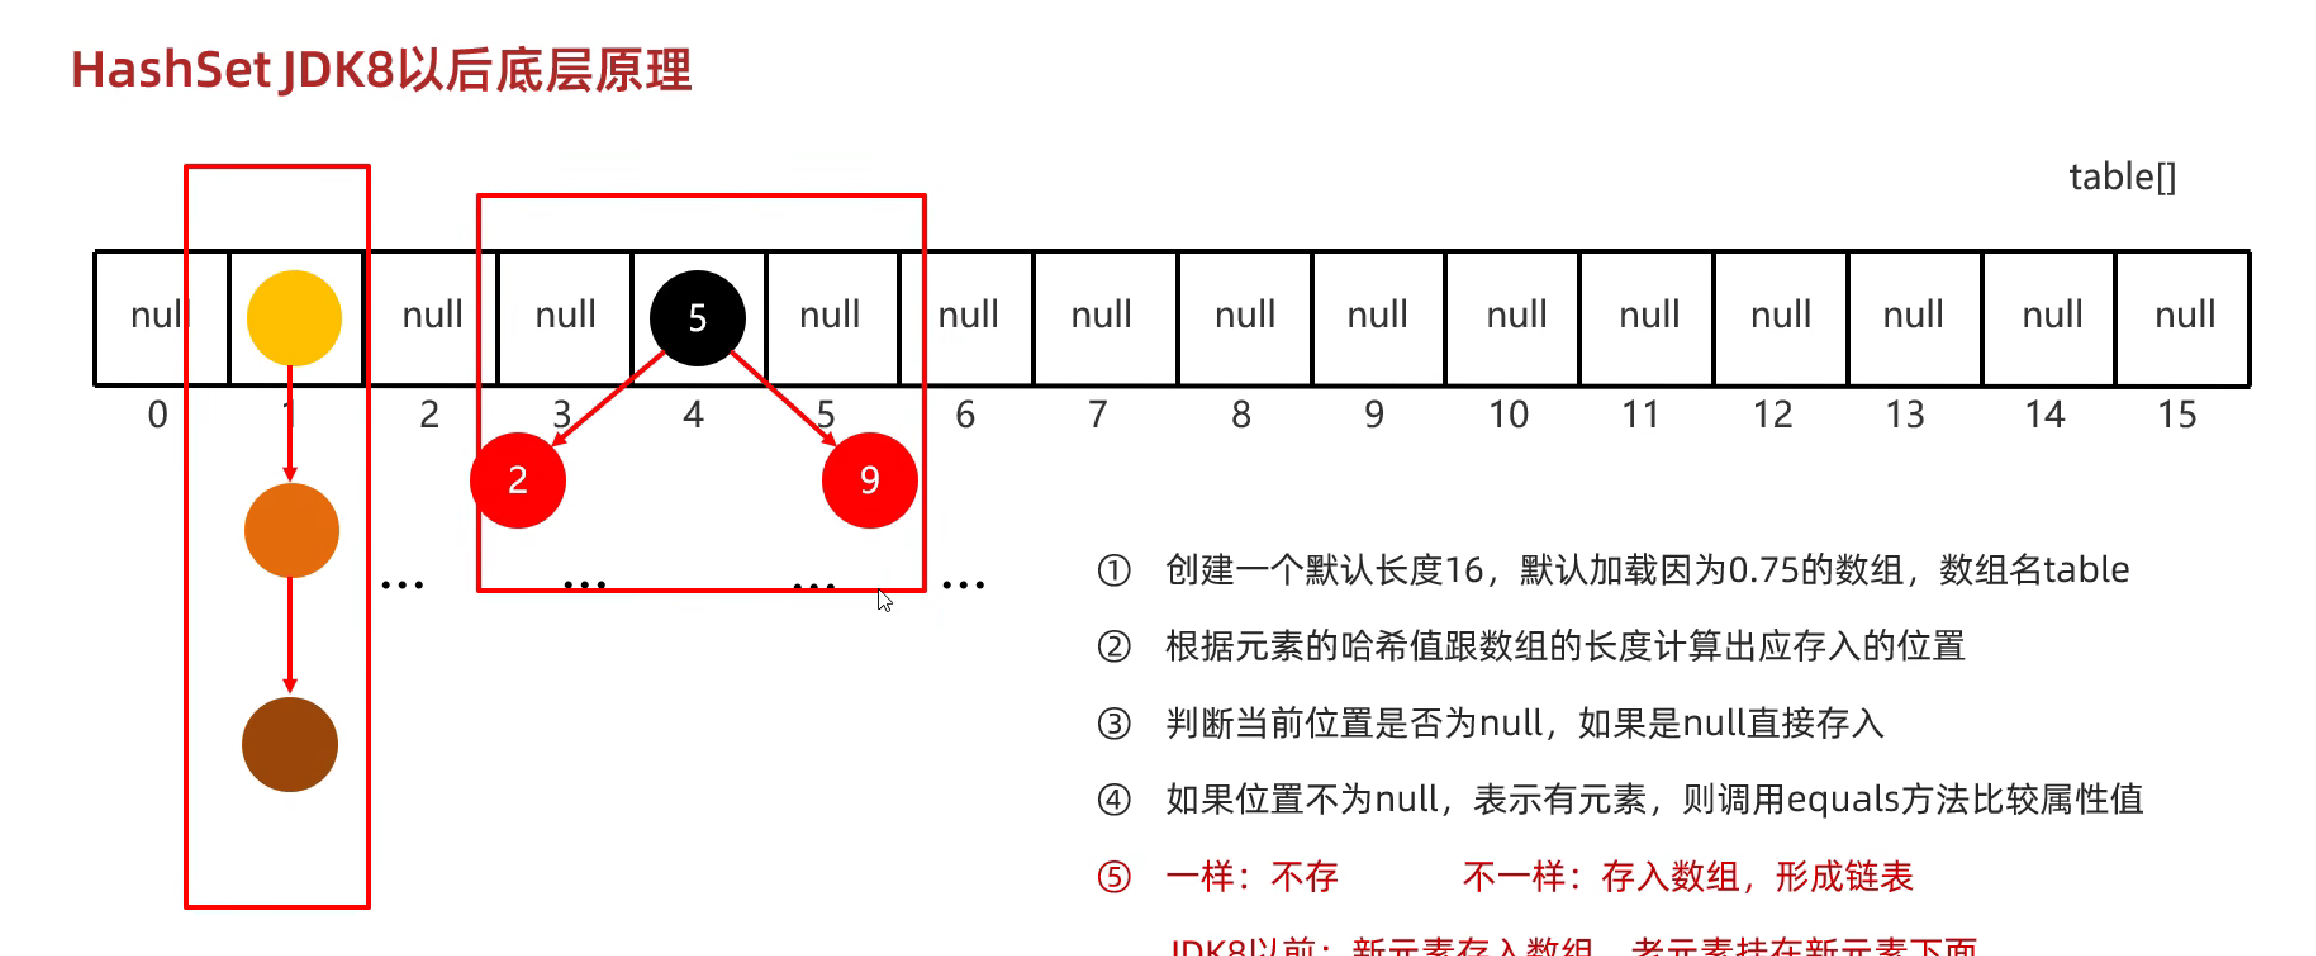
注意:这里的加载因就是HashSet的扩容时机,当数组里面存了16×0.75=12个元素的时候,那么此时数组就会扩容成原先的两倍,也就是说此时它是由长度为16扩容到了32 。还有一种情况就是,当有的链表比较长了,链表的长度大于8,而且数组的长度大于等于64的时候,那么当前的列表,就会自动的去转成红黑树,从而提高了查找效率
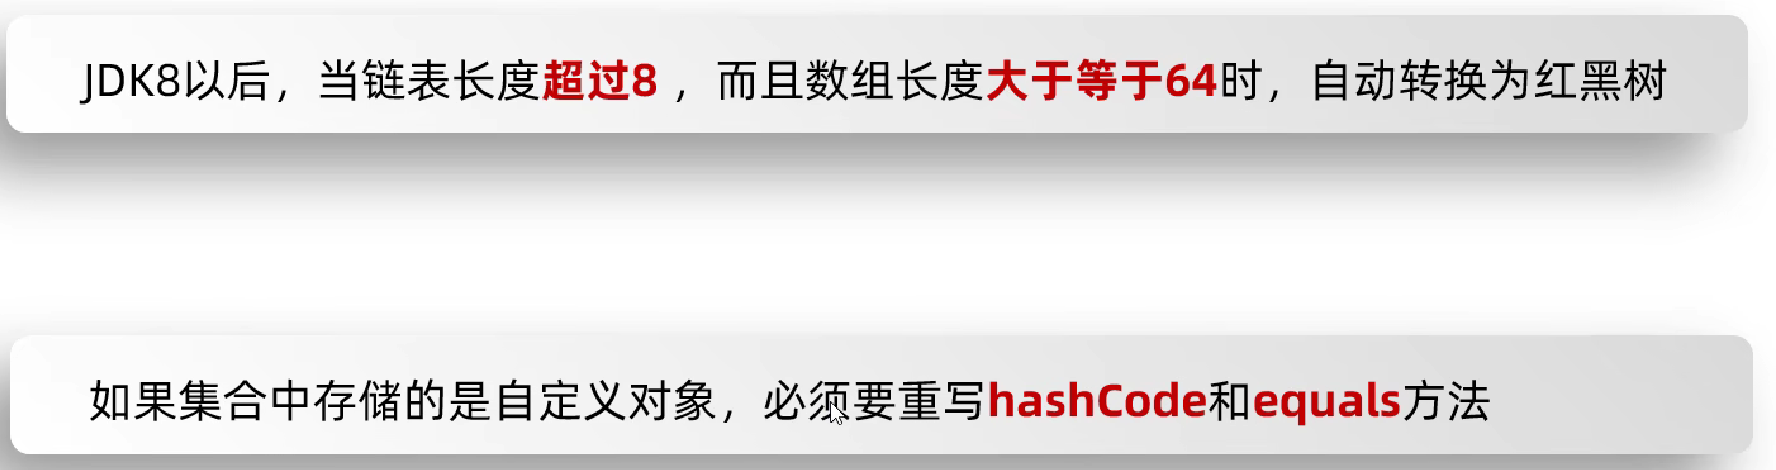
重写哈希code的目的是我们想要根据属性值去计算哈希值,而后面重写equals的目的就是我们想要在比较的时候比的也是对象内部的属性值。
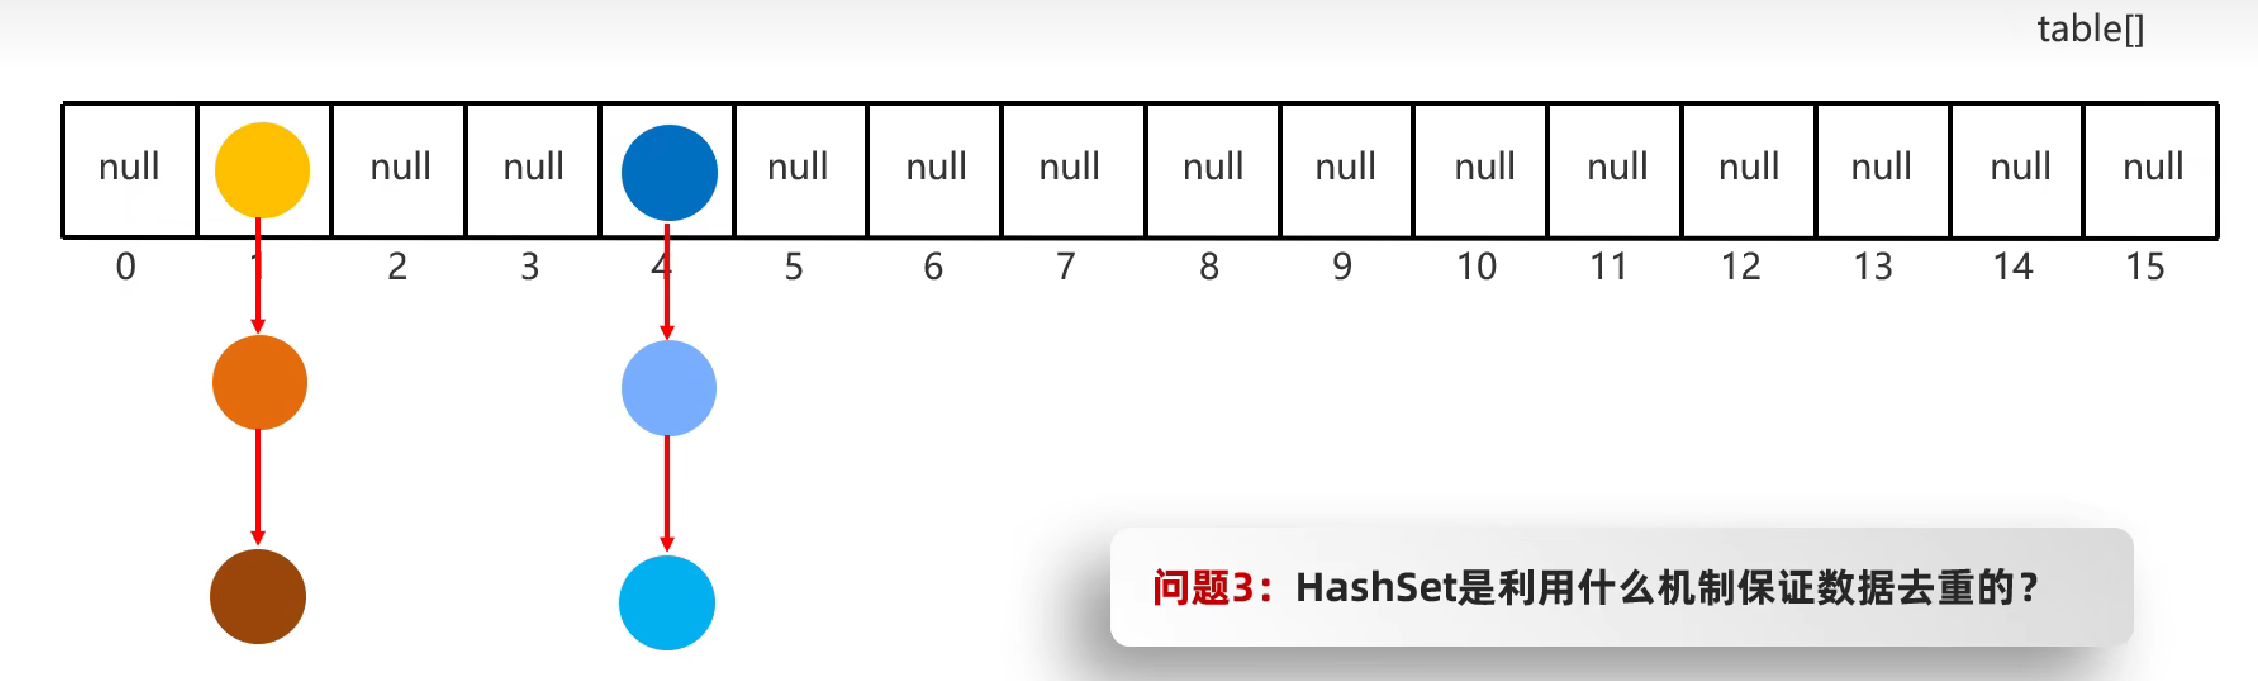
第一个问题:HashSet为什么存和取的顺序不一样?
以上面的这个哈希表为例,哈希set它在遍历的时候,是从数组的0索引开始,一条链表一条链表这样子去遍历的,也就是说首先会先去看它的0索引,那此时0索引,是没有元素的,是none那此时它就会跳过,再来看一索引。一索引下面挂了一条链表,所以说,就会把链表里面所有的元素,去遍历完毕,然后再去看2索引,3索引那么这里都是none,所以说跳过再去看4索引,4索引也是链表,所以还会把这根链表全部地去遍历完毕。如果说在这里它不是链表是红黑树,也是去把这棵树去遍历完毕。所以说我们来想它在遍历的时候,首先第一个要获取这里的黄色的元素,然后第二个,第三个,然后蓝色,是这样的一个遍历顺序。但我们在添加的时候,这个黄色,就一定是第一个添加到数组当中的吗,不见得吧,所以说,它的存和取的顺序是有可能不一样的。
第二个问题:HashSet为什么没有索引?
因为哈希set它不够纯粹,在底层呢,是数组链表,红黑树这三个组合而成的,不好定义谁是0索引,谁是一索引,不好规定,如果说按照这个数组的索引,但是它下面这里还挂着其他元素,我们以黄色的这条链表为例,这么多的元素都是一索引不合适,所以干脆就取消了哈希set的索引机制。
第三个问题:HashSet是利用什么样的机制,去保证数据的唯一,也就是进行数据去重的?
利用两个方法,第一个hashCode第二个equals,利用hashCode方法,可以得到哈希值,而哈希值就可以确定当前元素是添加在数组的哪个位置,然后再去调用第二个方法equals去比较对象内部的属性值是不是相同,所以在这儿我们要切记一点,如果说哈希set里面存储的是自定义对象,那么一定要重写哈希code和equals方法。
小练手(利用HashSet集合去除重复元素):
//Student.java
package mySet;

import java.util.Objects;

public class Student {
    private String name;
    private int age;


    public Student() {
    }

    public Student(String name, int age) {
        this.name = name;
        this.age = age;
    }

    /**
     * 获取
     * @return name
     */
    public String getName() {
        return name;
    }

    /**
     * 设置
     * @param name
     */
    public void setName(String name) {
        this.name = name;
    }

    /**
     * 获取
     * @return age
     */
    public int getAge() {
        return age;
    }

    /**
     * 设置
     * @param age
     */
    public void setAge(int age) {
        this.age = age;
    }

    @Override
    public boolean equals(Object o) {
        if (o == null || getClass() != o.getClass()) {
            return false;
        }
        Student student = (Student) o;
        return age == student.age && Objects.equals(name, student.name);
    }

    @Override
    public int hashCode() {
        return Objects.hash(name, age);
    }

    @Override
    public String toString() {
        return "Student{name = " + name + ", age = " + age + "}";
    }
}
//test3.java
package mySet;

import java.util.HashSet;

public class test3 {
    public static void main(String[] args) {
        /*
            需求:创建一个存储学生对象的集合,存储多个学生对象。使用程序实现在控制台遍历该集合。
            要求:学生对象的成员变量值相同,我们就认为是同一个对象
         */

        //创建对象
        Student stu1 = new Student("zhangsan", 18);
        Student stu2 = new Student("zhangsan", 18);
        Student stu3 = new Student("lisi", 19);

        HashSet<Student> hs = new HashSet<>();

        System.out.println(hs.add(stu1));
        System.out.println(hs.add(stu2));
        System.out.println(hs.add(stu3));

        System.out.println(hs);

    }
}
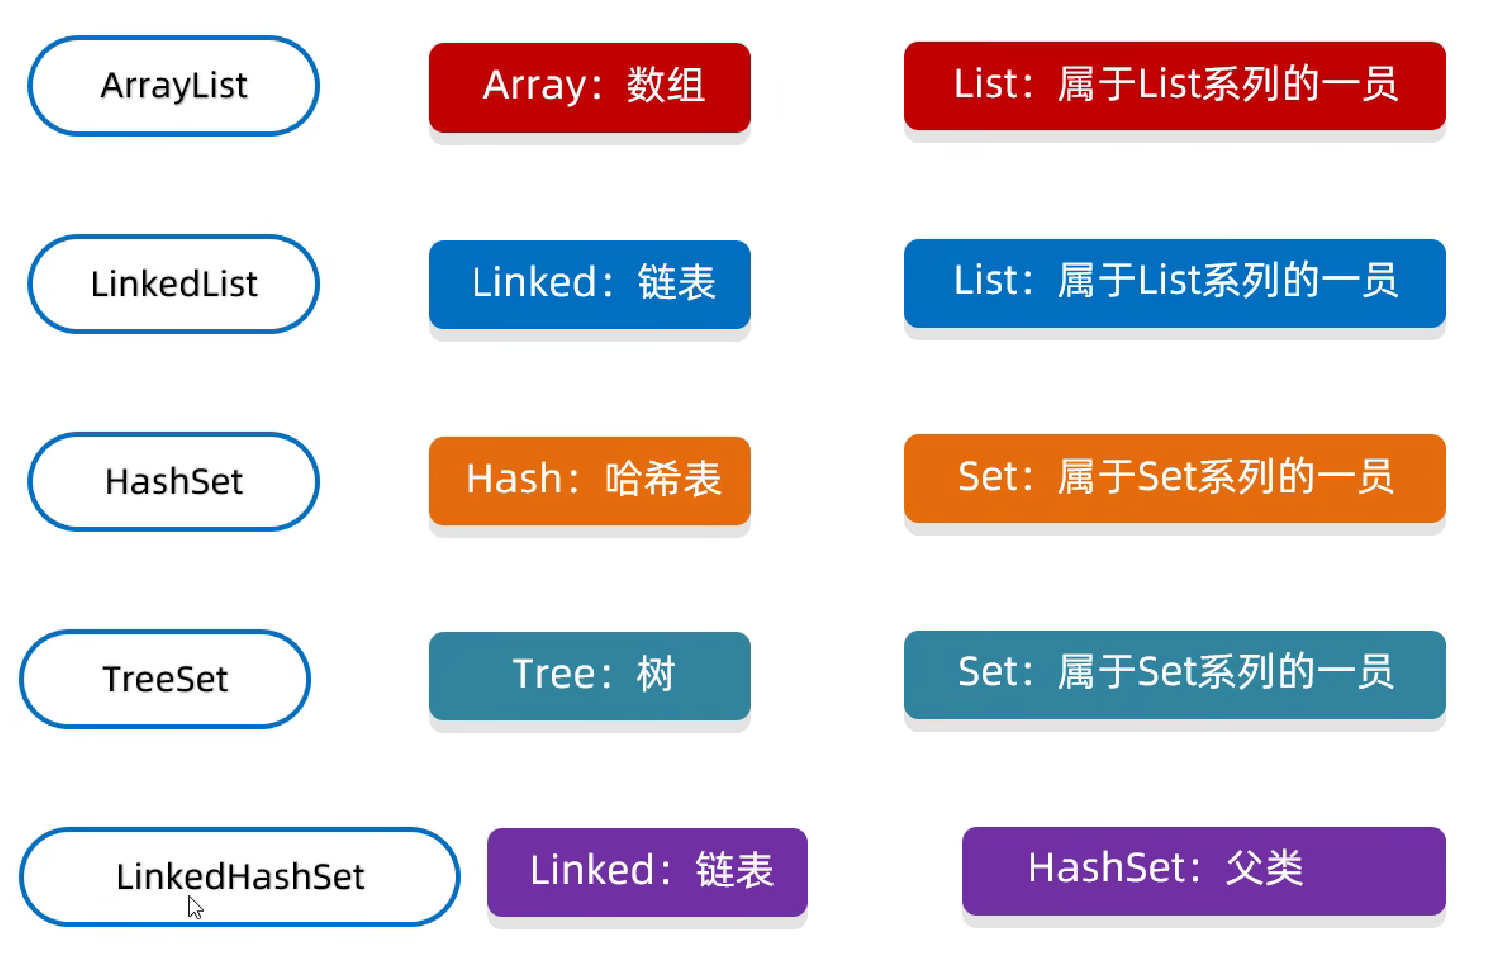
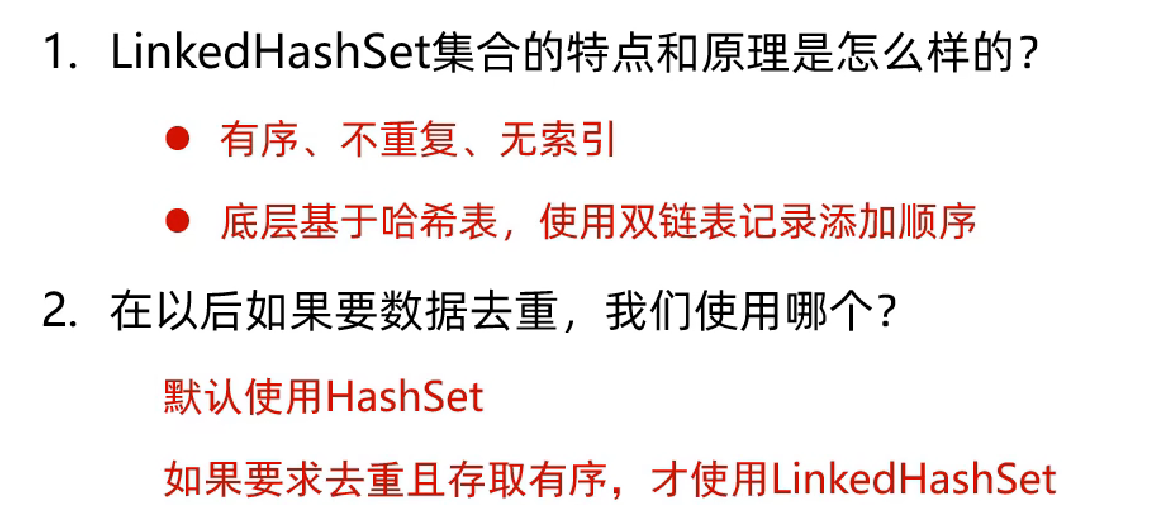
LinkedHashSet
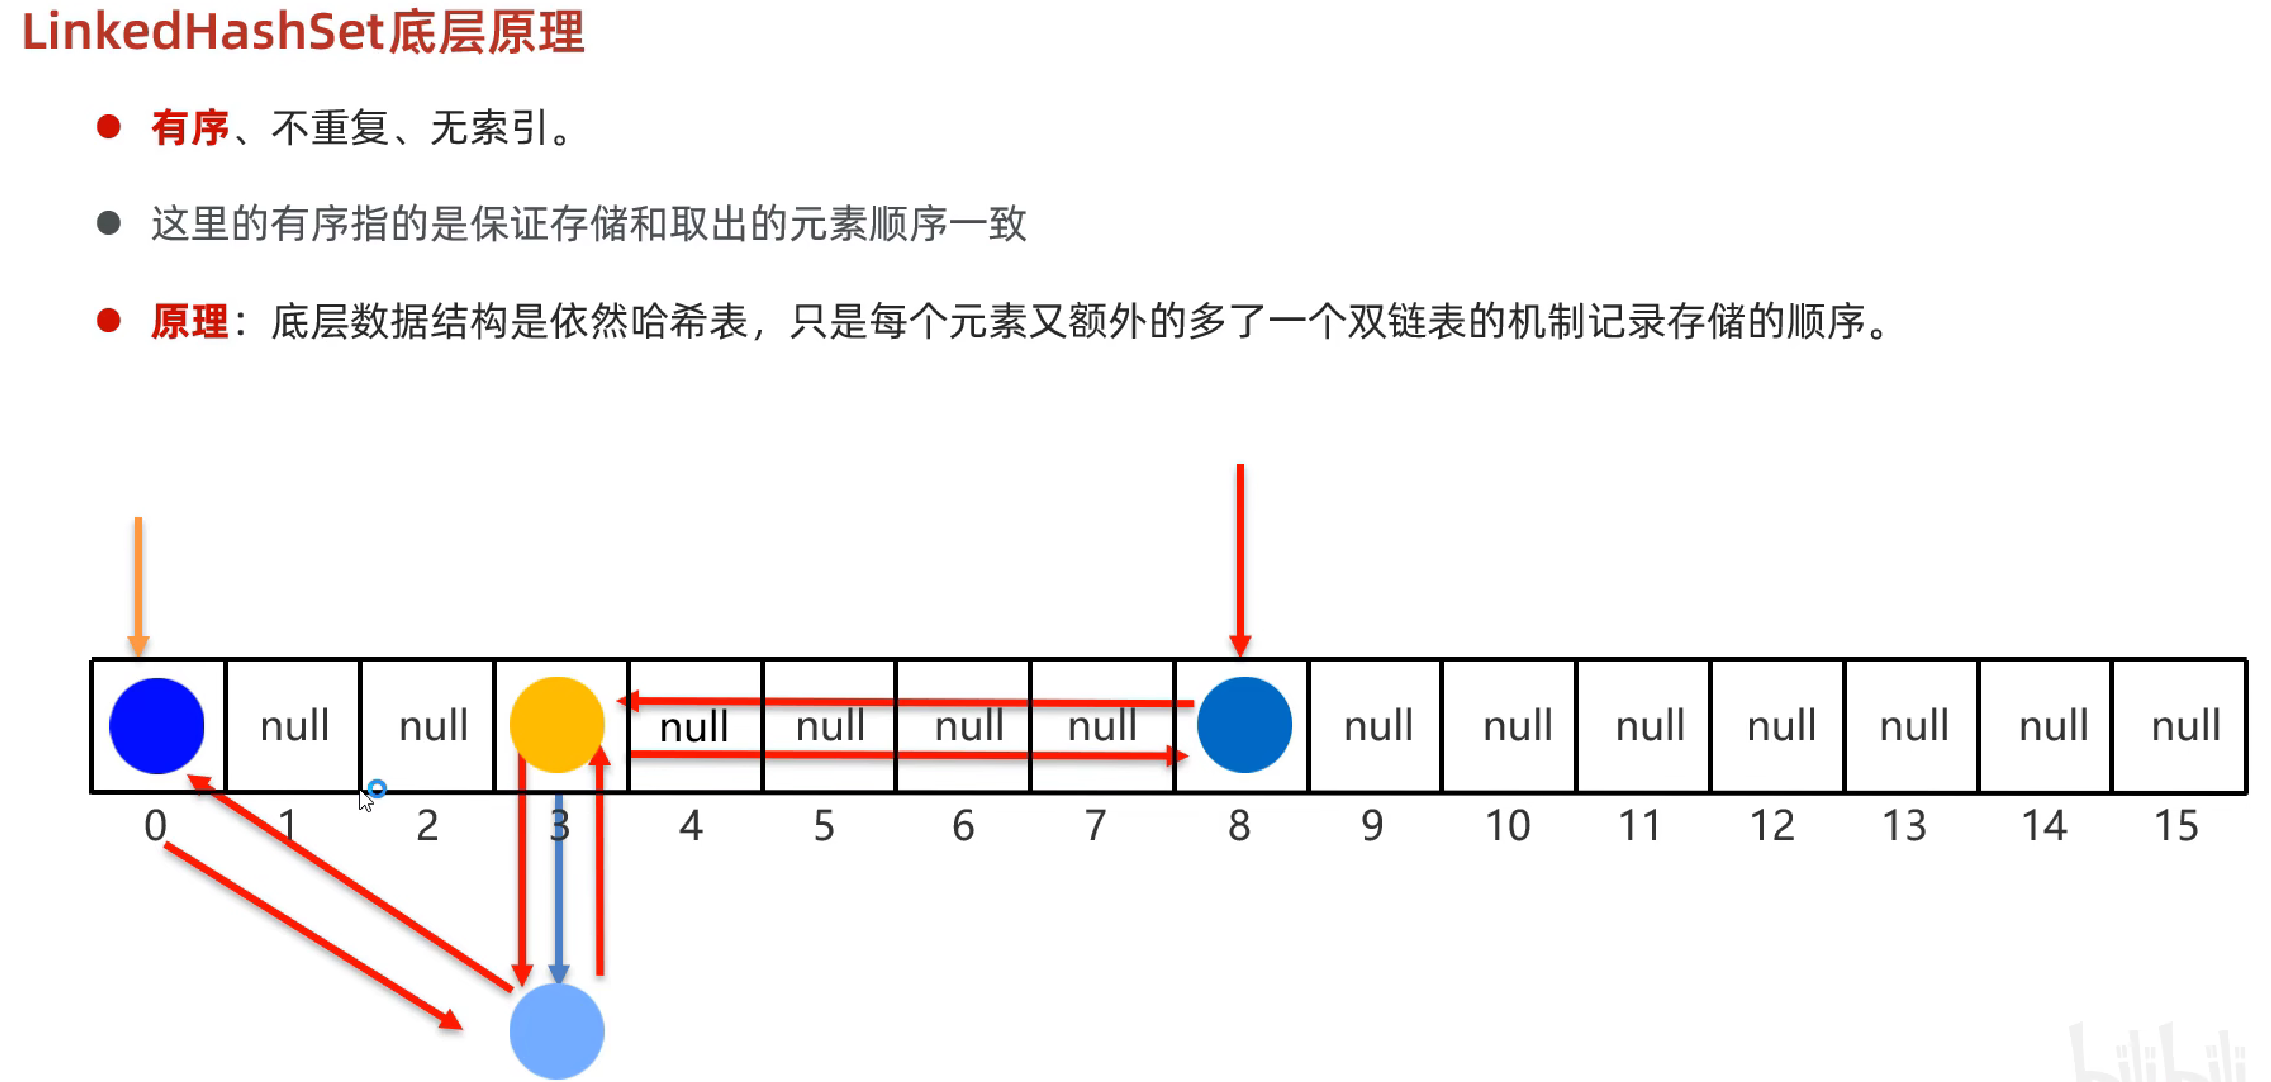
小练手(理解LinkedHashSet实现添加和读取元素是有序的):
package mySet;

import java.util.HashSet;
import java.util.LinkedHashSet;

public class test4 {
    public static void main(String[] args) {
        //创建对象
        Student stu1 = new Student("zhangsan", 18);
        Student stu2 = new Student("zhangsan", 18);
        Student stu3 = new Student("lisi", 19);

        LinkedHashSet<Student> lhs = new LinkedHashSet<>();

        System.out.println(lhs.add(stu1));
        System.out.println(lhs.add(stu2));
        System.out.println(lhs.add(stu3));

        System.out.println(lhs);
    }
}
TreeSet
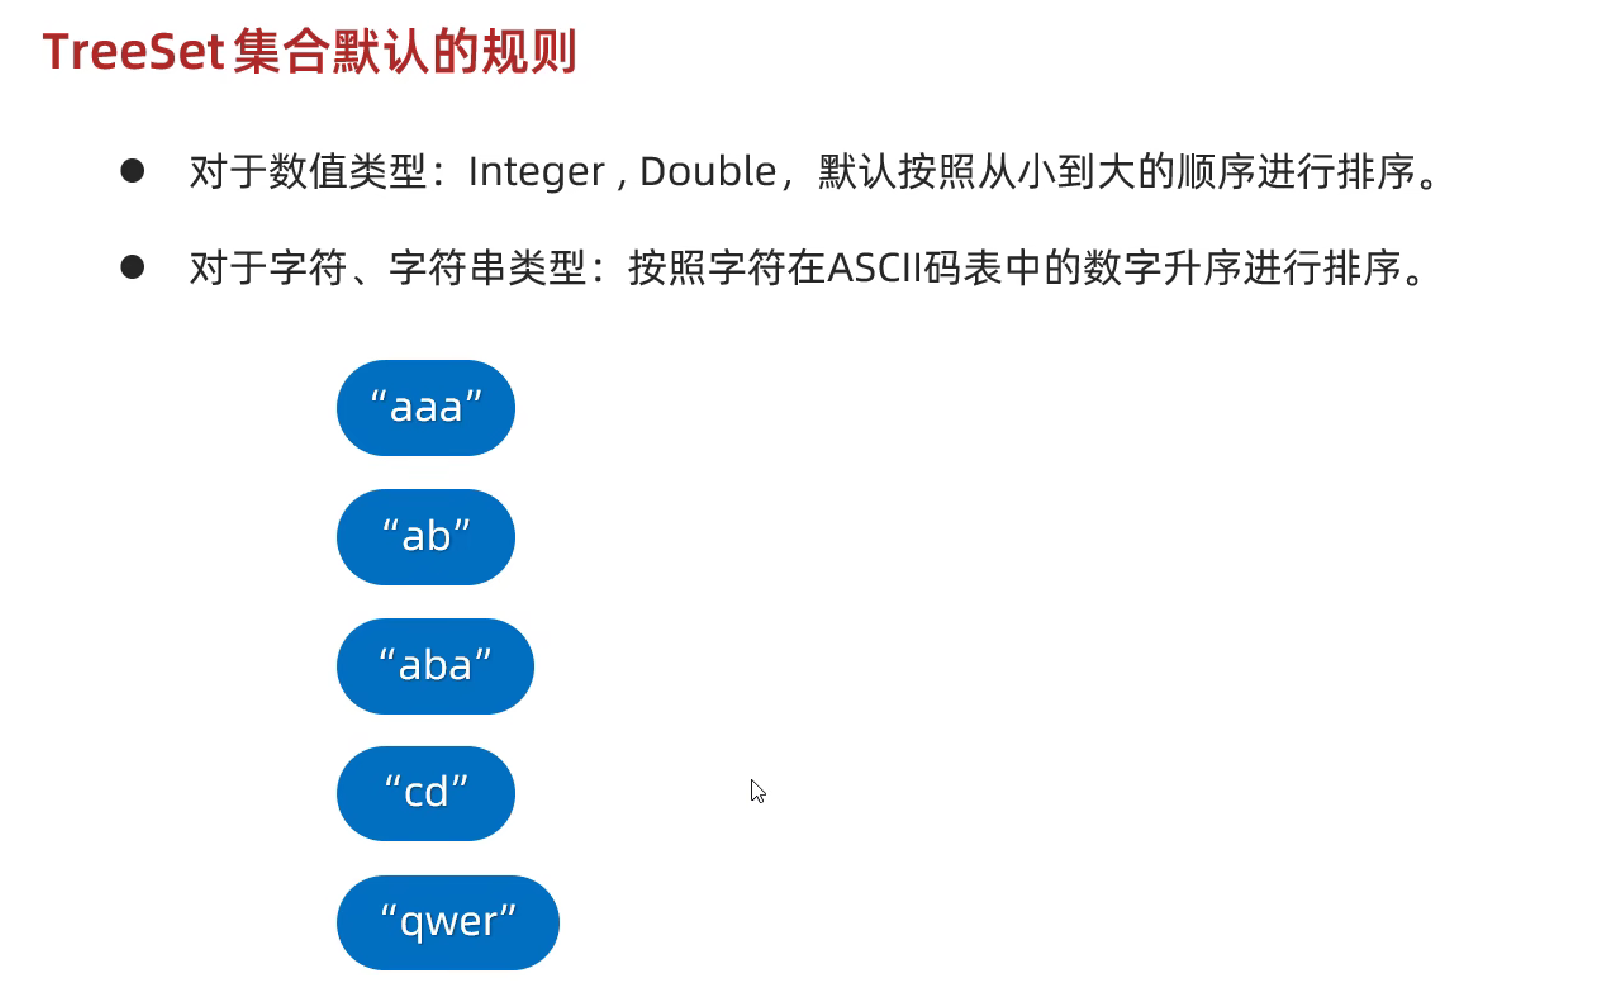
默认规则
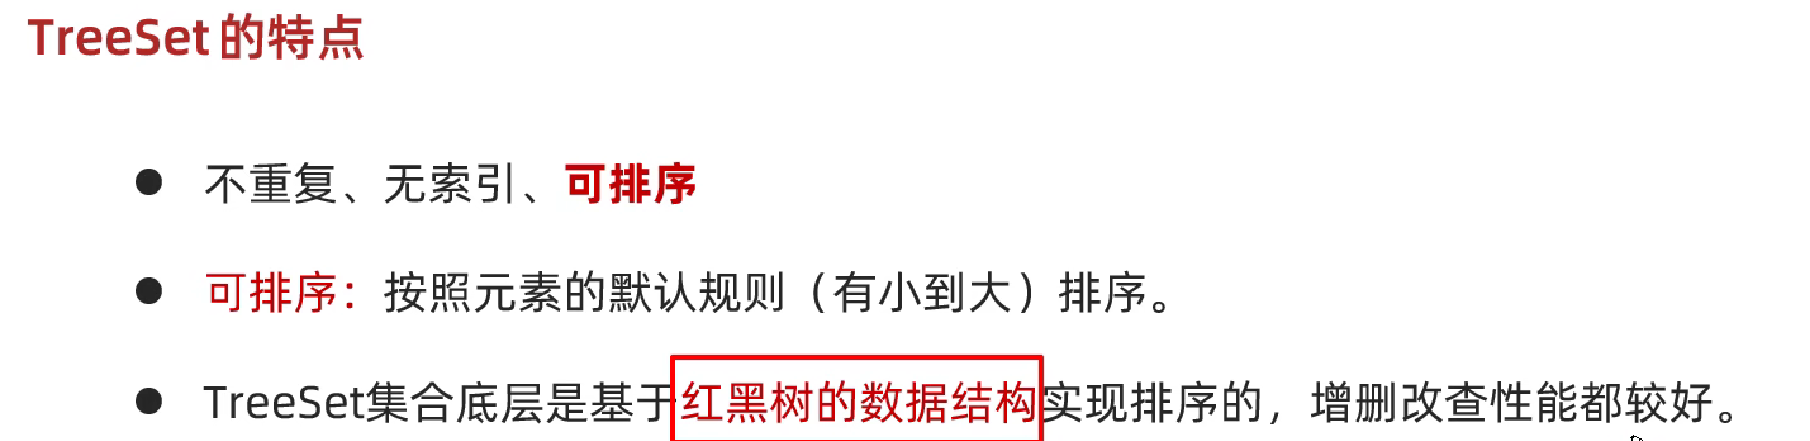
小练手(TreeSet排序):
package myTreeSet;

import java.util.Iterator;
import java.util.TreeSet;
import java.util.function.Consumer;

public class test1 {
    public static void main(String[] args) {
        //将集合中的数据从小到大进行排序
        //创建TreeSet
        TreeSet<Integer> ts = new TreeSet<>();

        //添加数据
        ts.add(6);
        ts.add(2);
        ts.add(5);
        ts.add(4);

        //打印数据
        System.out.println(ts);//[2, 4, 5, 6]
        System.out.println("-----------------");

        //遍历
        //迭代器遍历
        Iterator<Integer> it = ts.iterator();
        while (it.hasNext()) {
            Integer i = it.next();
            System.out.println(i);
        }
        System.out.println("-------------");
        //增强for遍历
        for (Integer t : ts) {
            System.out.println(t);
        }
        System.out.println("--------------");
        //Lambda表达式遍历
//        ts.forEach(new Consumer<Integer>() {
//            @Override
//            public void accept(Integer integer) {
//                System.out.println(integer);
//            }
//        });
        ts.forEach( i ->System.out.println(i));


    }
}
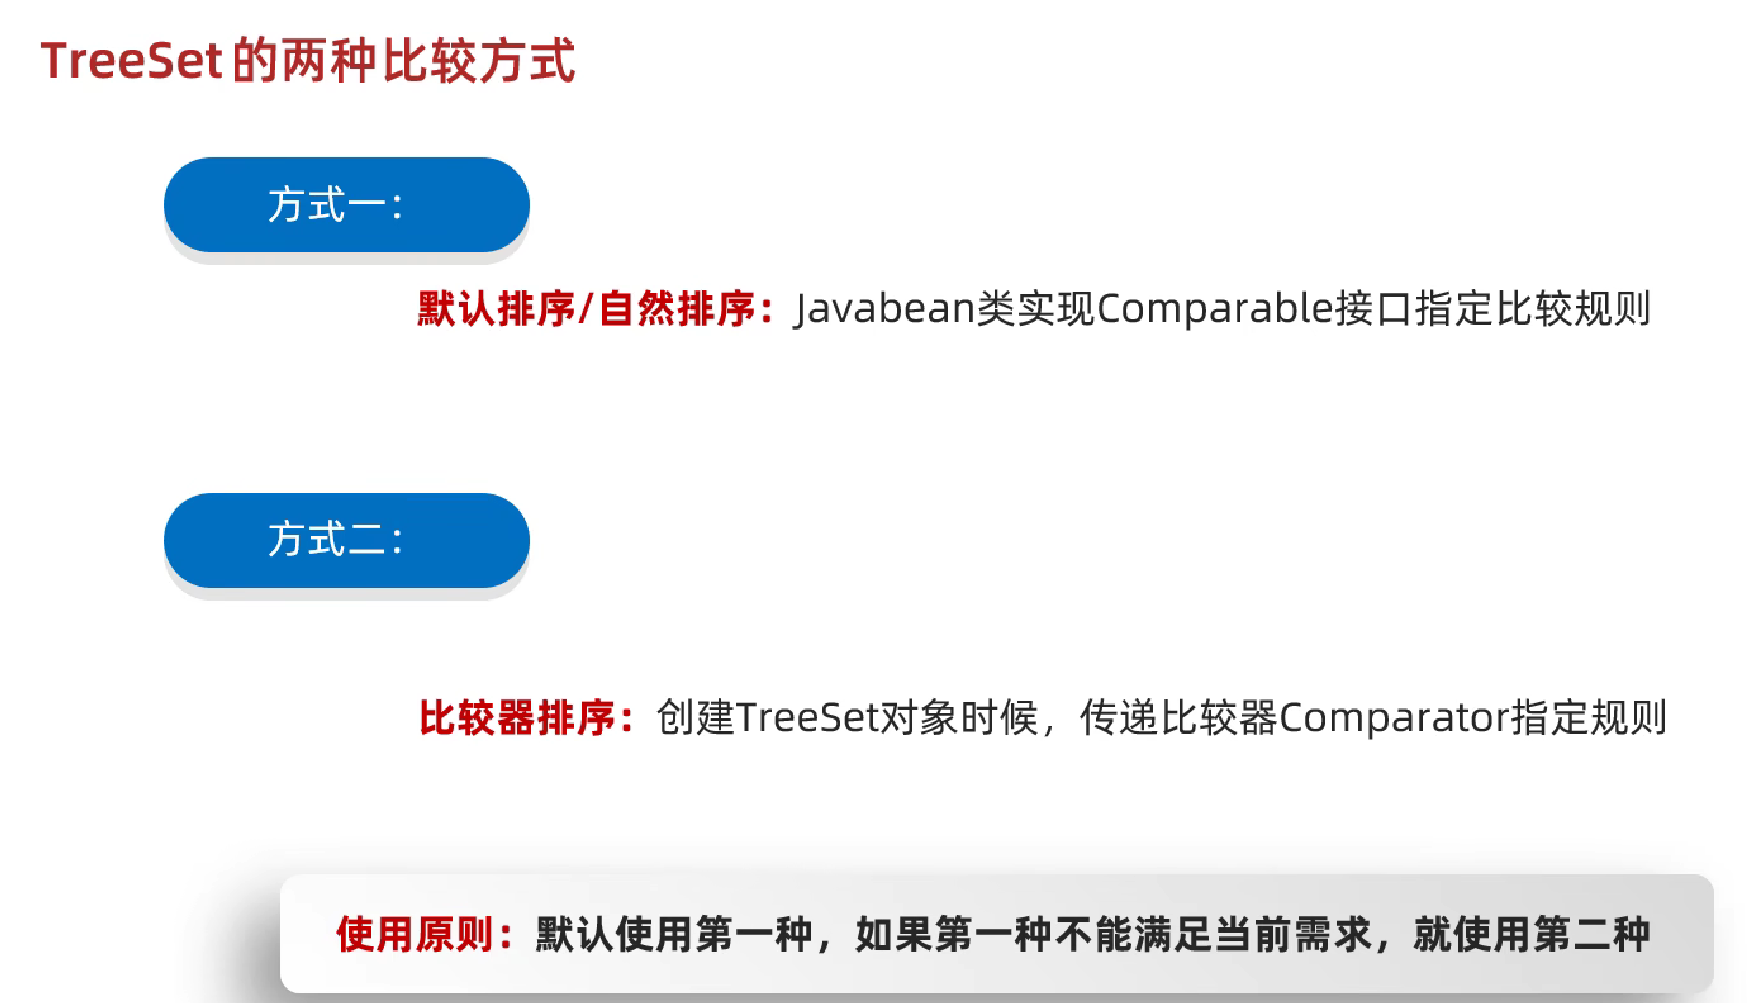
TreeSet两种比较方式
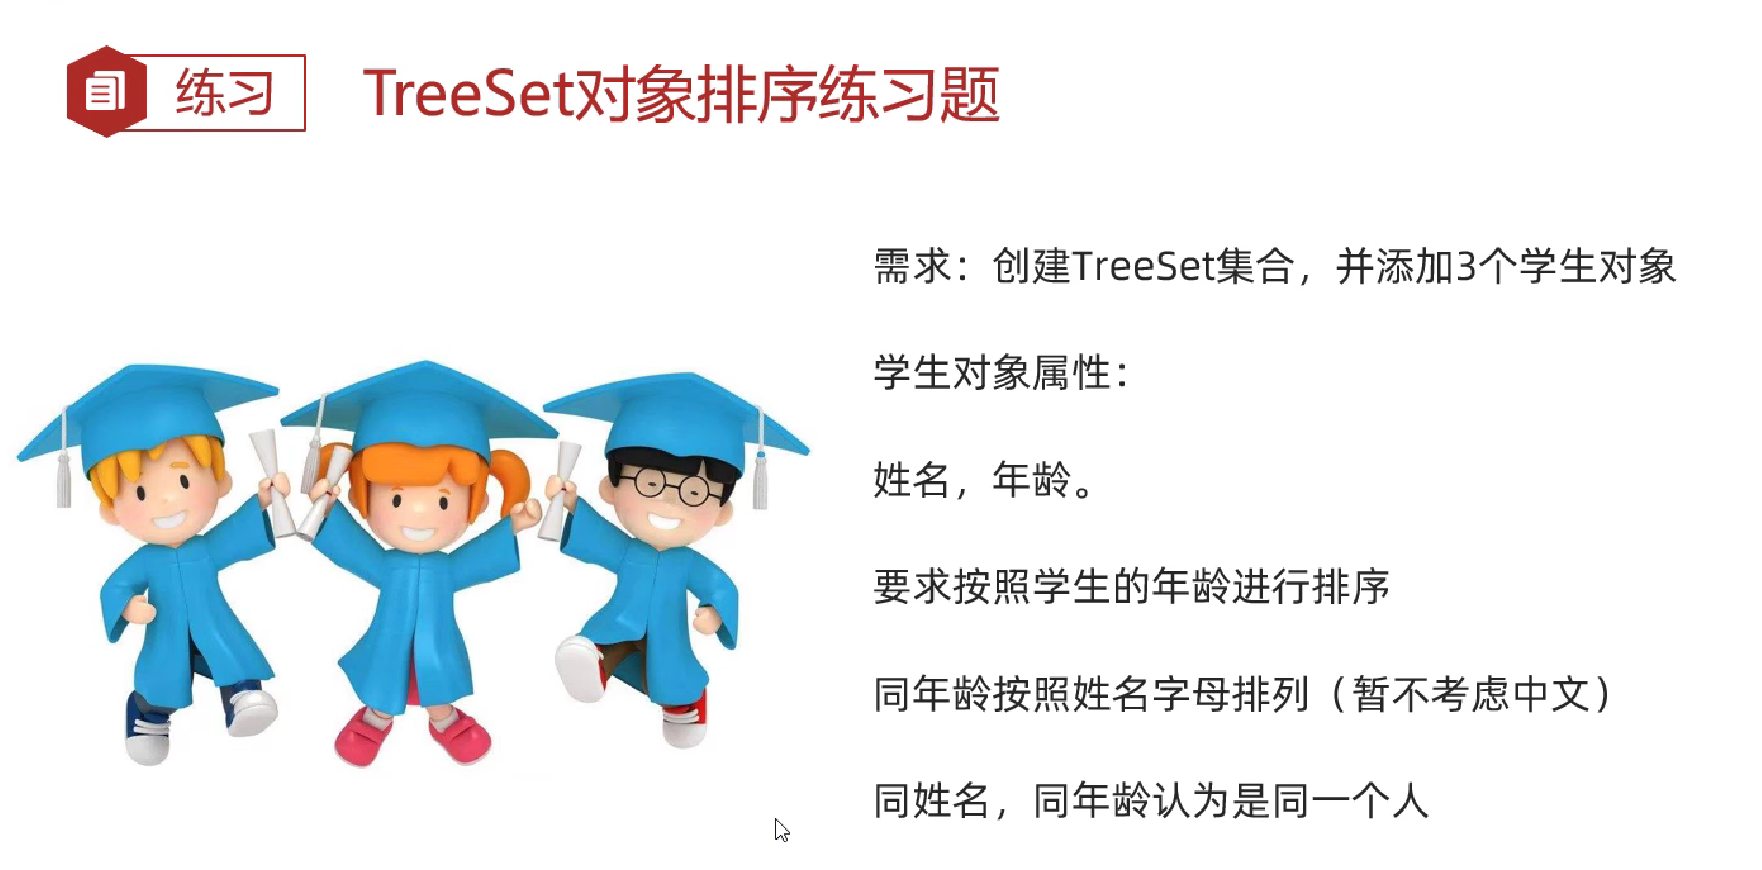
小练手(TreeSet对于自定义对象排序方法一):
//Student.java
package mySet;

import java.util.Objects;

public class Student implements Comparable<Student> {
    private String name;
    private int age;


    public Student() {
    }

    public Student(String name, int age) {
        this.name = name;
        this.age = age;
    }

    /**
     * 获取
     * @return name
     */
    public String getName() {
        return name;
    }

    /**
     * 设置
     * @param name
     */
    public void setName(String name) {
        this.name = name;
    }

    /**
     * 获取
     * @return age
     */
    public int getAge() {
        return age;
    }

    /**
     * 设置
     * @param age
     */
    public void setAge(int age) {
        this.age = age;
    }


    @Override
    public String toString() {
        return "Student{name = " + name + ", age = " + age + "}";
    }

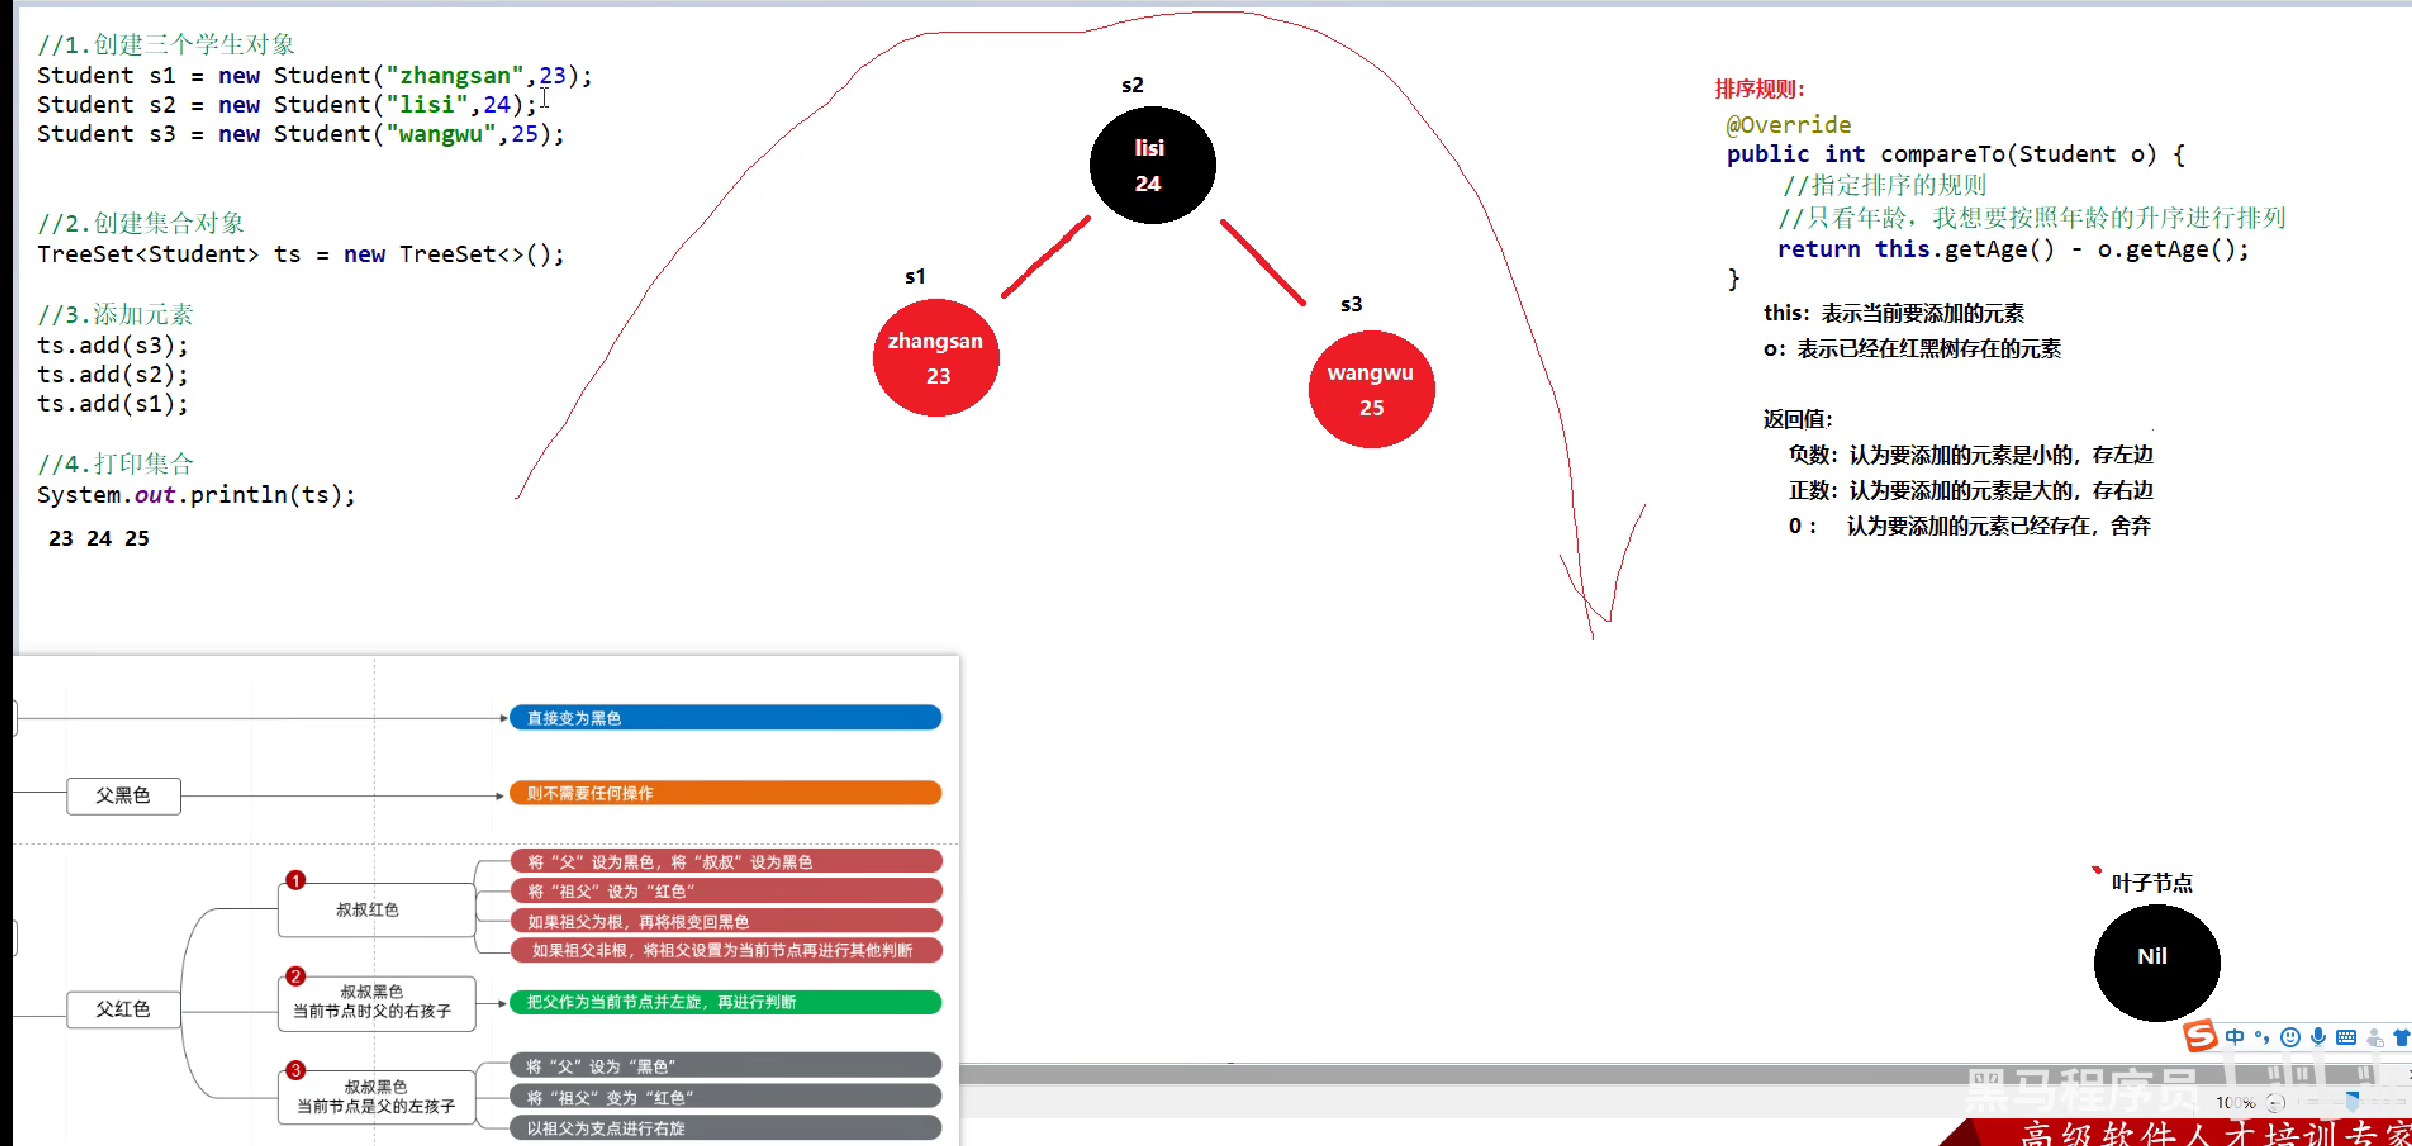
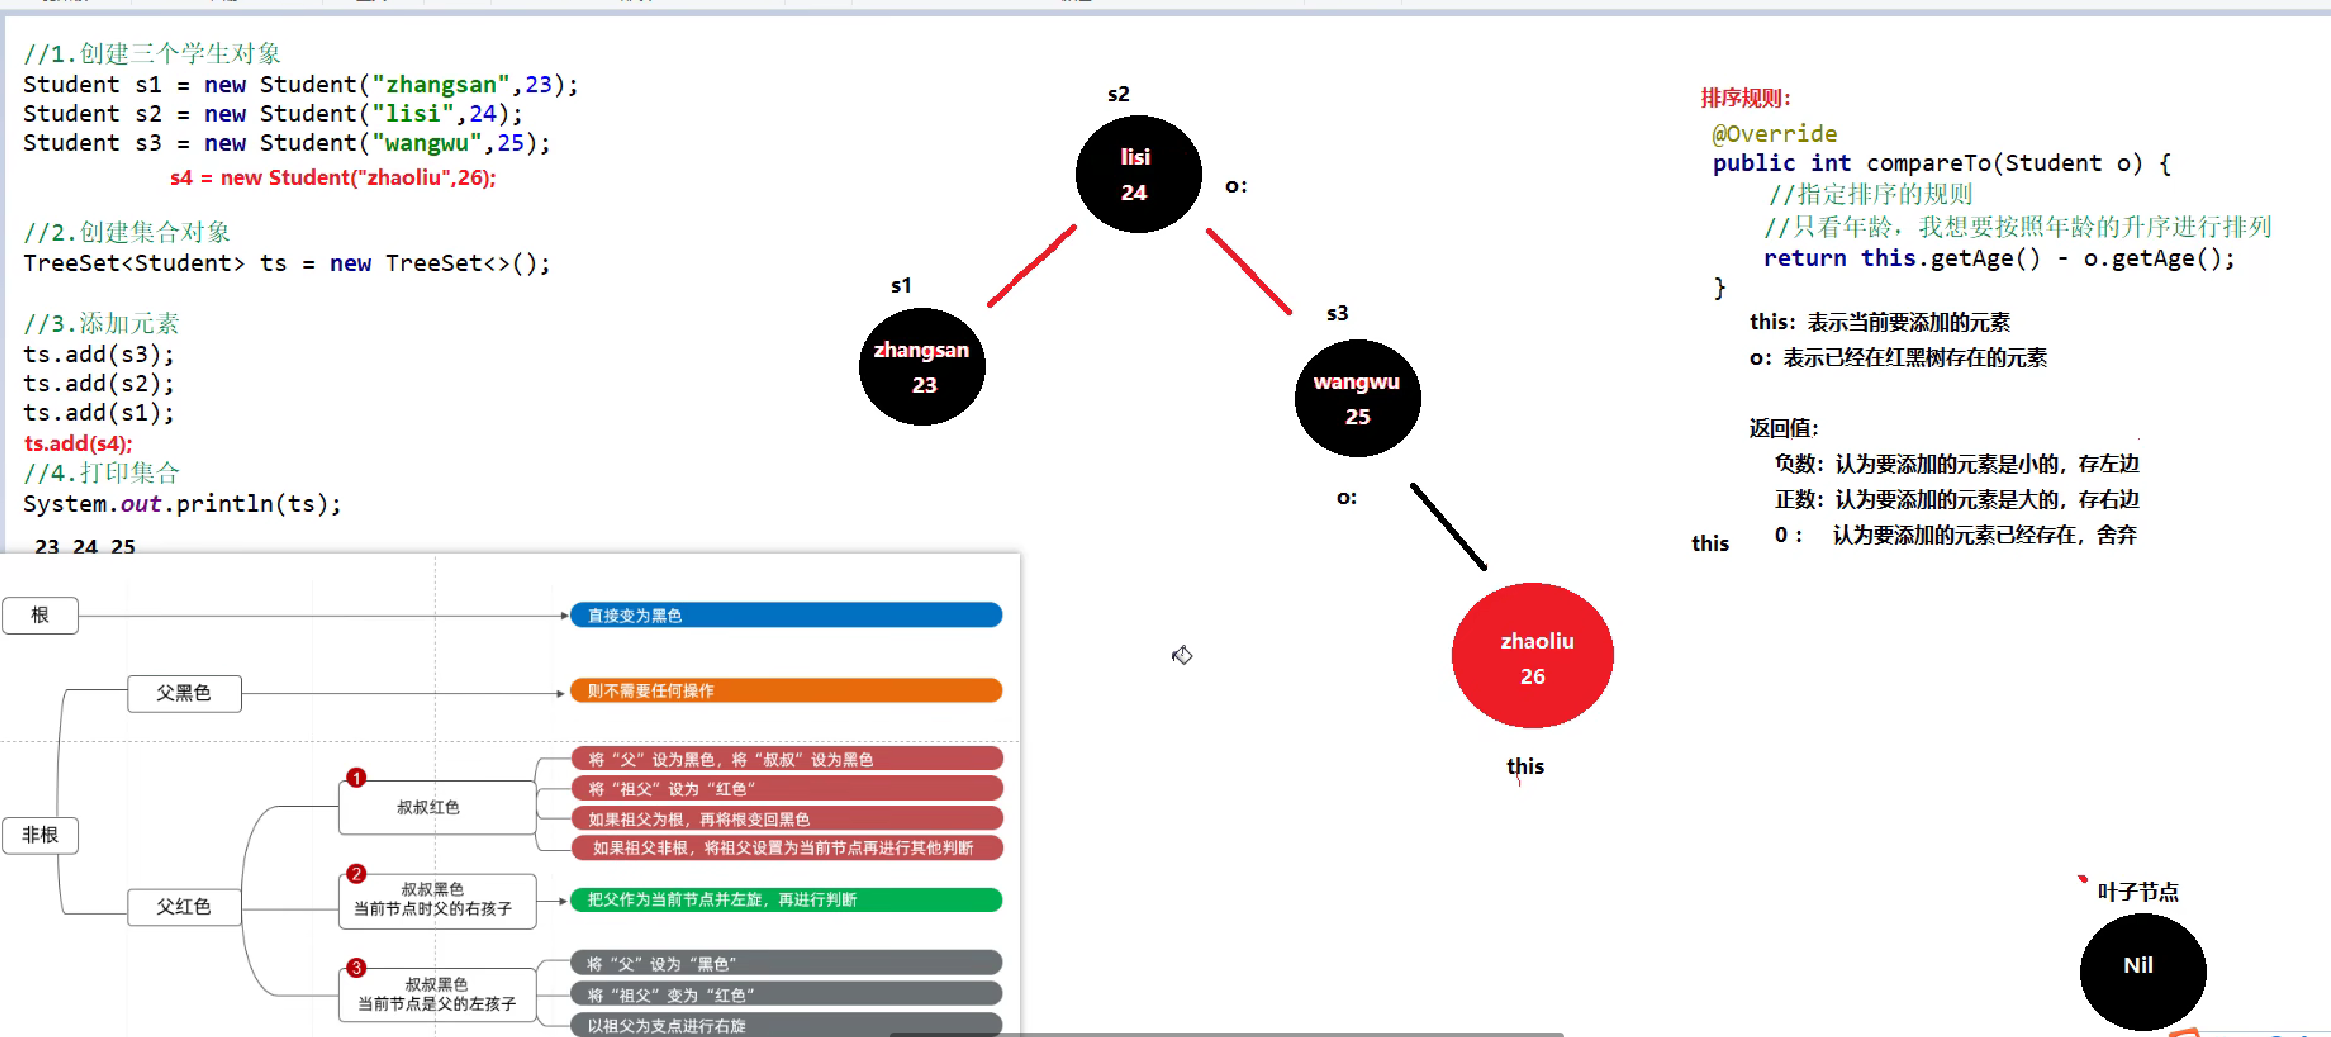
    //this:表示当前要添加的元素
    //o:表示已经在红黑树存在的元素

    //返回值:
    //负数:表示当前要添加的元素是小的,存左边
    //正数:表示当前要添加的元素是大的,存右边
    //0 :表示当前要添加的元素已经存在,舍弃
    @Override
    public int compareTo(Student o) {
        System.out.println("-----------");
        System.out.println("this:"+this);
        System.out.println("o:"+o);
        return this.age - o.age;
    }
}
//treeSetTest2.java
package mySet;

import java.util.TreeSet;

public class treeSetTest2 {
    public static void main(String[] args) {
        /*
            需求:创建TreeSet集合,并添加3个学生对象
            学生对象属性:
            姓名,年龄。
            要求按照学生的年龄进行排序
            同年龄按照姓名字母排列(暂不考虑中文)
            同姓名,同年龄认为是同一个人

            方法一:默认排序规则/自然排序
            Student实现Comparable接口,重写里面的抽象方法,再指定比较规则

        */
        //创建对象
        Student stu1 = new Student("zhangsan", 18);
        Student stu2 = new Student("lisi", 22);
        Student stu3 = new Student("wangwu", 26);
        Student stu4 = new Student("zhaoliu", 24);

        //创建TreeSet
        TreeSet<Student> tss = new TreeSet<>();

        //添加元素
        tss.add(stu1);
        tss.add(stu2);
        tss.add(stu3);
        tss.add(stu4);

        //打印元素
        System.out.println(tss);
    }
}
小练手(比较器排序):
package mySet;

import java.util.Comparator;
import java.util.TreeSet;

public class treeSetTest3 {
    public static void main(String[] args) {
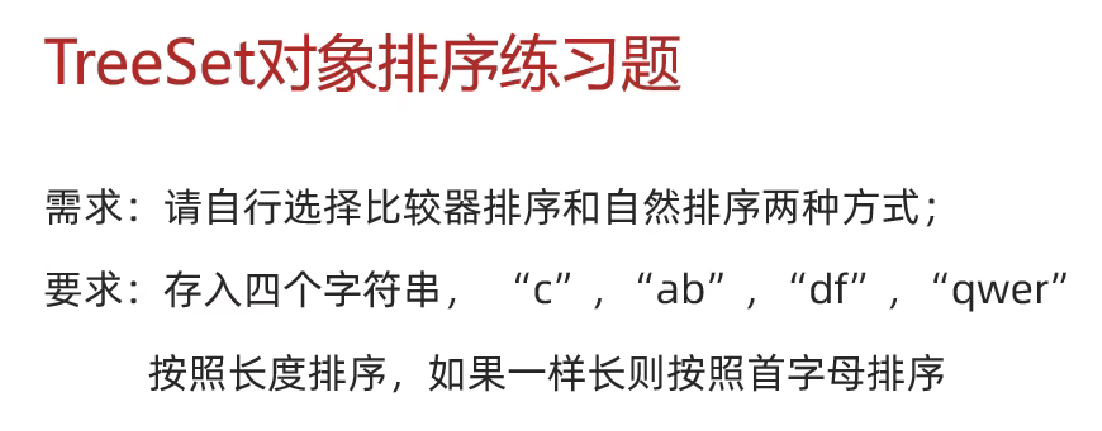
        //按照第二种排序方式进行排序,比较器排序
        //创建集合
        //o1:当前要添加的元素
        //o2:已经在红黑树存在的元素
        //返回值规则跟之前是一样的
        //匿名内部类实现
//        TreeSet<String> ts = new TreeSet<>(new Comparator<String>() {
//
//            @Override
//            public int compare(String o1, String o2) {
//                //按照长度进行排序
//                int i = o1.length() - o2.length();
//                //若长度一样就按照首字母进行排序
//                if (i == 0){
//                    return o1.compareTo(o2);
//                }
//                return i;
//            }
//        });
        //Lambda表达式实现
        TreeSet<String> ts = new TreeSet<>(( o1,  o2) ->{
                //按照长度进行排序
                int i = o1.length() - o2.length();
                //若长度一样就按照首字母进行排序
                if (i == 0){
                    return o1.compareTo(o2);
                }
                return i;
            }
        );

        //添加元素
        ts.add("a");
        ts.add("bd");
        ts.add("ac");
        ts.add("adp");

        //打印集合
        System.out.println(ts);
    }
}
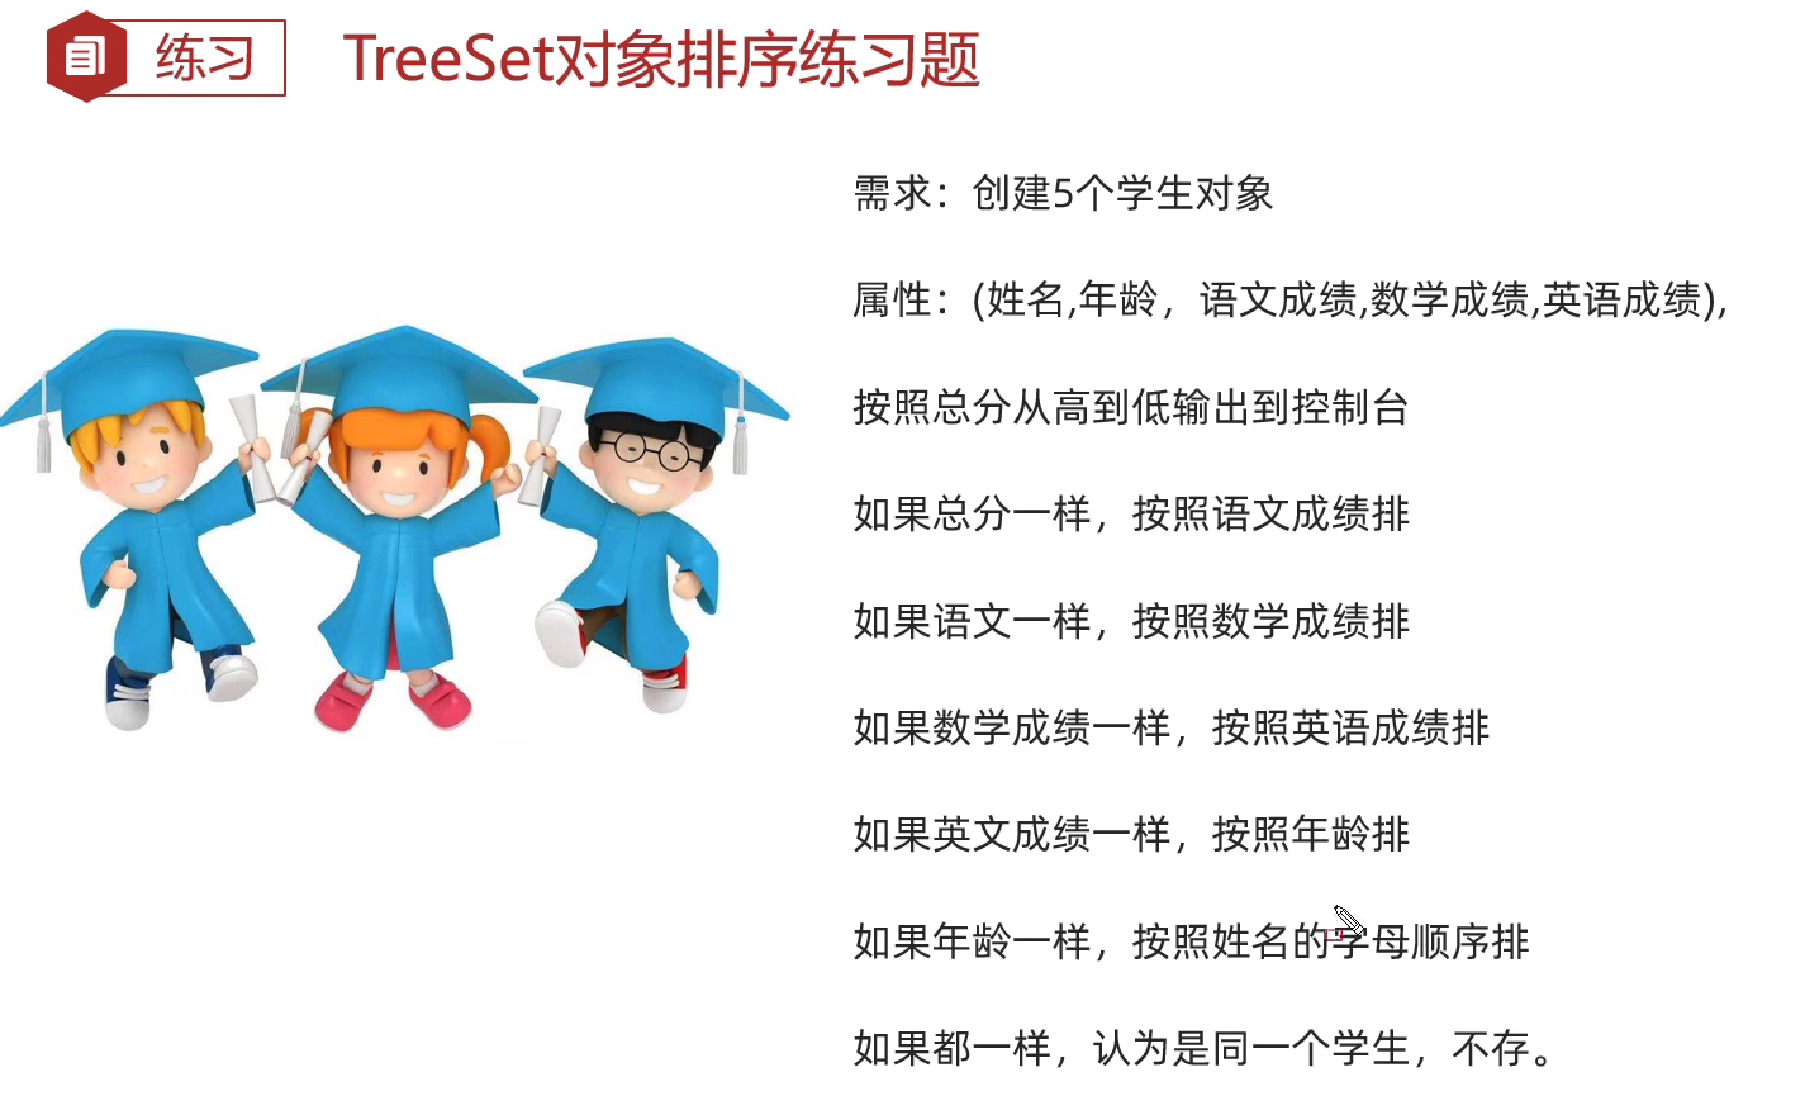
小练手(对象排序练习):
//Student1.java
package mySet;

public class Student1 implements Comparable<Student1> {
    private String name;
    private int age;
    private int chinese;
    private int math;
    private int english;

    public Student1() {
    }

    public Student1(String name, int age, int chinese, int math, int english) {
        this.name = name;
        this.age = age;
        this.chinese = chinese;
        this.math = math;
        this.english = english;
    }

    /**
     * 获取
     * @return name
     */
    public String getName() {
        return name;
    }

    /**
     * 设置
     * @param name
     */
    public void setName(String name) {
        this.name = name;
    }

    /**
     * 获取
     * @return age
     */
    public int getAge() {
        return age;
    }

    /**
     * 设置
     * @param age
     */
    public void setAge(int age) {
        this.age = age;
    }

    /**
     * 获取
     * @return chinese
     */
    public int getChinese() {
        return chinese;
    }

    /**
     * 设置
     * @param chinese
     */
    public void setChinese(int chinese) {
        this.chinese = chinese;
    }

    /**
     * 获取
     * @return math
     */
    public int getMath() {
        return math;
    }

    /**
     * 设置
     * @param math
     */
    public void setMath(int math) {
        this.math = math;
    }

    /**
     * 获取
     * @return english
     */
    public int getEnglish() {
        return english;
    }

    /**
     * 设置
     * @param english
     */
    public void setEnglish(int english) {
        this.english = english;
    }

    public String toString() {
        return "Student1{name = " + name + ", age = " + age +",total="+(chinese+math+english)+",chinese = " + chinese + ", math = " + math + ", english = " + english + "}";
    }

    /**
     *             按照总分从高到低输出到控制台
     *             如果总分一样,按照语文成绩排
     *             如果语文一样,按照数学成绩排
     *             如果数学成绩一样,按照英语成绩排
     *             如果英文成绩一样,按照年龄排
     *             如果年龄一样,按照姓名的字母顺序排
     *             如果都一样,认为是同一个学生,不存。
     * */
    @Override
    public int compareTo(Student1 o) {
        int sum1 = this.getChinese()+this.getMath()+this.getEnglish();
        int sum2 = this.getChinese()+this.getMath()+this.getEnglish();
        //按照总分从高到低排
        int i = sum1-sum2;
        if (i == 0){
            //如果总分一样,按照语文成绩排
            i = this.getChinese() - o.getChinese();
        }
        if (i == 0){
            //如果语文一样,按照数学成绩排
            i = this.getMath() - o.getMath();
        }
        if (i == 0){
            //如果英文成绩一样,按照年龄排
            i = this.getEnglish() - o.getEnglish();
        }
        if (i == 0){
            //如果英文成绩一样,按照年龄排
            i = this.getAge() - o.getAge();
        }
        if (i == 0){
            //如果年龄一样,按照姓名的字母顺序排
            i = this.getName().compareTo(o.getName());
        }
        return i;
    }
}
//treeSetTest4.java
package mySet;

import java.util.TreeSet;

public class treeSetTest4 {
    public static void main(String[] args) {
        /*
            按照总分从高到低输出到控制台
            如果总分一样,按照语文成绩排
            如果语文一样,按照数学成绩排
            如果数学成绩一样,按照英语成绩排
            如果英文成绩一样,按照年龄排
            如果年龄一样,按照姓名的字母顺序排
            如果都一样,认为是同一个学生,不存。
        */

        //创建student对象
        Student1 stu1 = new Student1("zhangsan", 18, 89, 76, 60);
        Student1 stu2 = new Student1("lisi", 26, 92, 86, 90);
        Student1 stu3 = new Student1("wangwu", 22, 91, 66, 30);

        //创建集合
        TreeSet<Student1> ts = new TreeSet<>();

        //添加元素
        ts.add(stu1);
        ts.add(stu2);
        ts.add(stu3);

        //打印集合元素
        System.out.println(ts);
        for (Student1 t : ts) {
            System.out.println(t);
        }
    }
}
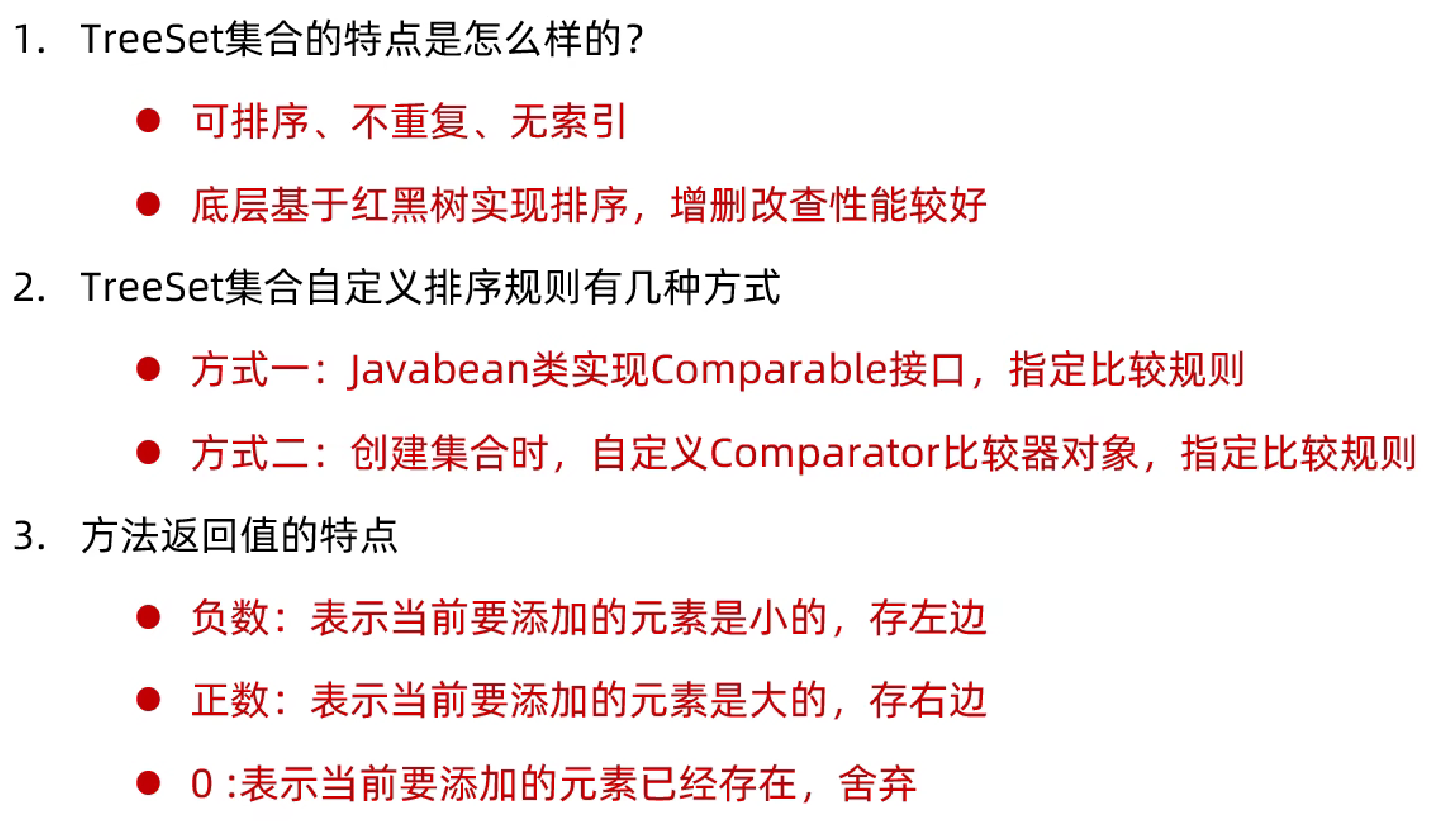
注意:当方式一和方式二同时存在时,是以方式二为准
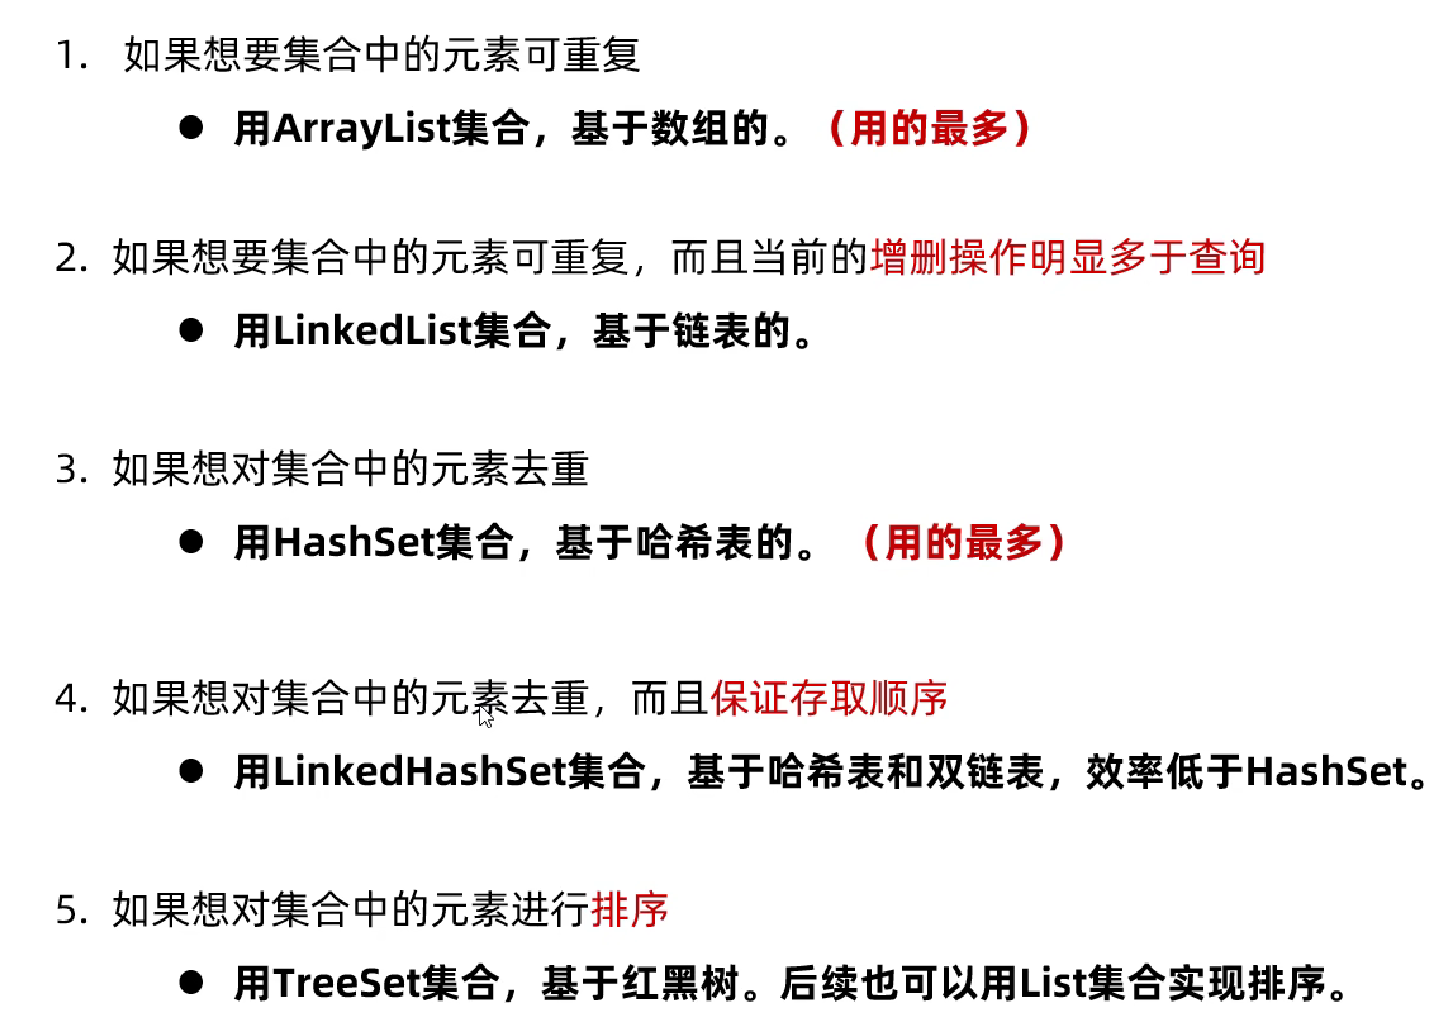
终于听完Java SE 上半部分了
完结撒花*★,°*:.☆( ̄▽ ̄)/$:*.°★* 。
更多推荐


 23
 0
- 0


 已为社区贡献2条内容

所有评论(0)