
亚马逊云科技高效解决方案,助力出海企业提升AI模型效果
在推荐系统和广告系统领域,处理变长特征序列一直是重要且具有挑战性的问题。特别是在DSP(Demand-Side Platform)广告系统中,精排序(Re-ranking)模型需要同时处理用户的历史行为序列、广告的历史展示序列等多种变长特征,这些特征的处理质量直接影响模型的效果。
目前业界在使用TensorFlow处理变长特征时面临以下几个主要痛点:
1.数据表示的局限性。
稀疏特征的存储效率低下。
序列长度不一致导致的计算资源浪费。
2.工程实现的复杂性。
TensorFlow针对变长序列特征的支持比较复杂。
自定义算子开发成本高。
实现比较复杂,公开的Internet网络上找不到可以直接参考的代码。
分布式训练场景下海量的特征数据的预处理需要优化。
基于以上技术挑战,本文提出并实践了在Amazon SageMaker上,实现TensorFlow变长特征处理及模型训练的解决方案,包括:
1.数据处理。
特征维度规模达到数百量级的多维特征处理。
将变长序列的特征处理为定长序列的特征,或者仍然保持为变长序列的特征。
pyspark分布式集群特征处理。
2.模型训练。
实现基于padding和序列长度截断的定长序列的训练;
实现保持原始长度的变长序列训练方案;
CPU+parameterserver Strategy的分布式训练。
解决方案及对比
下文将详细介绍在TensorFlow 2.x框架下基于padding和截断的定长序列特征、保持变长序列特征的两种训练方案,两种方案各有特色,分别适用于不同的应用场景,旨在建立一个高效、可扩展的变长特征处理框架,为推荐和广告系统的模型训练提供更好的支持。
方案1
tf.feature_column+tf.keras API
(变长序列特征截断且padding为定长序列特征)
核心特点:序列长度截断+padding+每个特征使用单独的embedding table。
数据处理:通过Amazon Sagemaker processing job或Amazon EMR Spark集群将ORC格式转换为TFRecord格式,并进行序列截断和填充。
优势:该方案实现相对简单;且有很多客户也是使用的类似的方案。
方案2
tf.keras.layers processing+tf.keras API
(保持变长特征序列)
核心特点:变长序列处理+特征共享Embedding表。
数据处理:通过Amazon SageMaker processing job或Amazon EMR Spark集群将ORC格式转换为TFRecord格式。
优势:不需要额外的特征处理的工作,与现有推荐系统上下游更好地集成。
方案对比分析
为帮助工程师更直观地理解两种方案的差异,从多个维度进行详细对比。
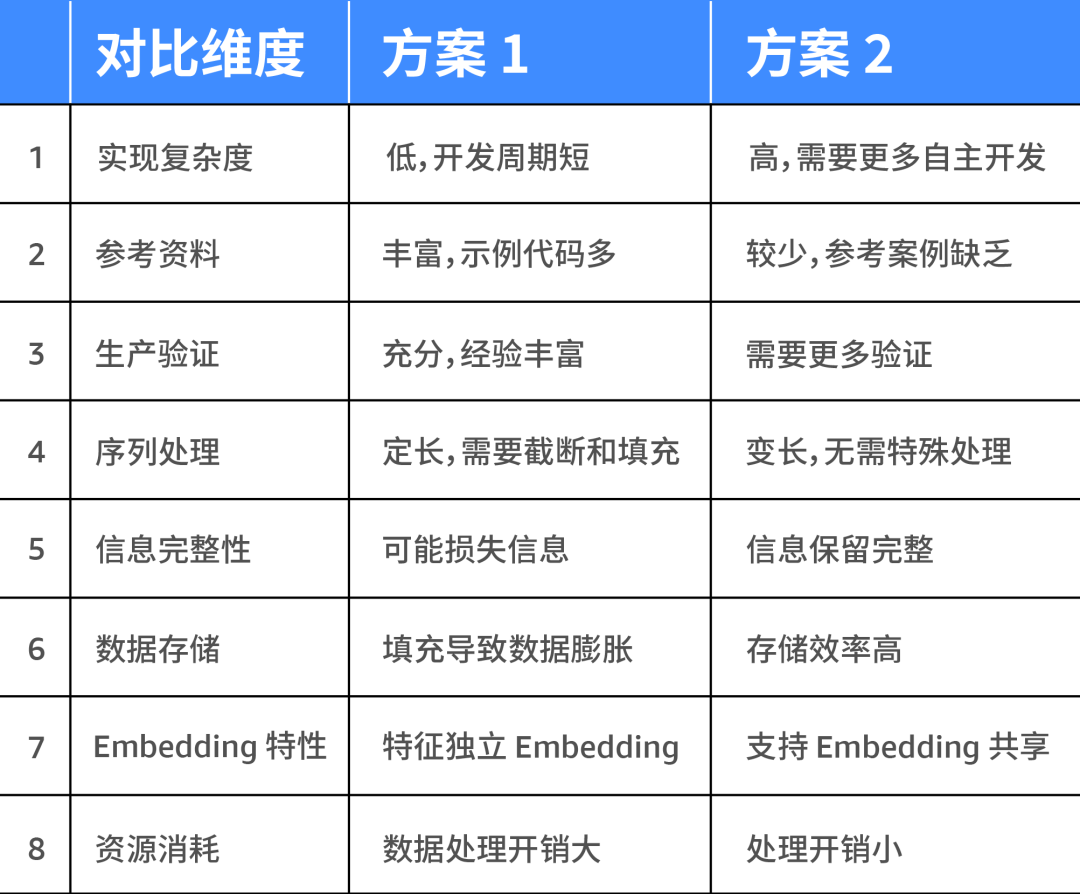
在实际的项目中,可以根据业务场景和不同的考虑因素,如序列长度特征数量,计算资源约束,开发周期要求,模型效果等综合考虑。
如果对模型效果要求较高,且计算资源充足,推荐采用方案2;如果开发周期紧张,且能够接受序列截断带来的有限模型效果影响,可以考虑方案1。
下文将分别详细介绍两种方案落地实施的具体技术实现方法。
实施落地的挑战及对应解决方法
在将理论方案转化为实际可落地的解决方案时,遇到了许多技术挑战。这些挑战主要集中在特征数据处理、TensorFlow变长特征模型训练,分布式处理等方面,本章将详细介绍这些挑战及其解决方案。
在介绍详细方案实施前,先介绍下特征数据结构和模型的网络结构。
训练模型示例
使用一个简单的DNN神经网络来demo变长特征的训练模型,包括如下结构:
1.SimpleChannel层:
使用了一个简单的全连接网络(一个Dense层)。
第一个Dense层使用ReLU激活函数。
返回四个值,但s1、s2、s3只是简单的占位符,没有实际的计算意义。
2.SimpleEmbedding层:
简单的Embedding Dense示例,只包含一个Dense层用于嵌入处理。
模型示例代码如下:
##使用了一个简单的全连接网络(两个Dense层),第一个Dense层使用ReLU激活函数。##返回四个值,但s1, s2, s3只是简单的占位符,没有实际的计算意义。class SimpleChannel(tf.keras.layers.Layer):    def __init__(self, in_size, out_size):        super().__init__()        self.in_size = in_size        self.fl = int(in_size / 4)        self.out_size = out_size            def build(self, input_shape):        self.dense = tf.keras.layers.Dense(self.out_size, activation='relu')        super().build(input_shape)            def call(self, inputs, i1, i2, i3):        # 简化处理,直接使用一个Dense层        x = self.dense(inputs)                # 为了保持输出格式一致,我们仍然返回四个值        s1 = tf.reduce_sum(x[:, :self.out_size//3], axis=1, keepdims=True) + i1        s2 = tf.reduce_sum(x[:, self.out_size//3:2*self.out_size//3], axis=1, keepdims=True) + i2        s3 = tf.reduce_sum(x[:, 2*self.out_size//3:], axis=1, keepdims=True) + i3                return x, s1, s2, s3
#简单的embedding dense 示例,只包含一个 Dense 层用于嵌入处理class SimpleEmbedding(tf.keras.layers.Layer):    def __init__(self, out_size, emb_size):        super().__init__()        self.out_size = out_size        self.emb_size = emb_size            def build(self, input_shape):        self.dense = tf.keras.layers.Dense(self.out_size * self.emb_size, activation='relu')        super().build(input_shape)
    def call(self, inputs):        # 简化embedding处理,直接使用一个Dense层        return self.dense(inputs)
左右滑动查看完整示意
特征数据结构
根据以往广告媒体类客户项目中遇到的变长特征情况,构造了dummy的特征数据,具体格式如下:
一共300+特征列,一个label字段列。
如果某一列是单值特征,字符串通过\003可分成两部分,第⼀部分是根据明⽂特征计算出的64位⽆符号整型哈希值;第二部分是哈希值对应的weight。
如果某一列是多值特征,字符串通过\001分成多个单值特征,每个单值特征的构成与上述描述⼀致。
label字段列,共有两个取值:0代表负样本;1代表正样本。
一个label字段列(目标特征字段),共有两个取值:0代表负样本,1代表正样本。
变长特征示例如下。
特征列名 1(单值特征):_11001值:12249734119335549443\0030.6931471特征列名 2(多值特征):_12001值:13237249145391275771\0030.693147\00118246459961346429377\0030.693147...省略label 列名:label值:0左右滑动查看完整示意
方案1
变长序列特征截断且padding为定长序列特征
变长特征padding处理
该方案使用TF的feature column API在模型训练时传入特征训练数据,该API只能接收定长序列的特征字段类型。因此需要额外的处理和变换来将原始的变长特征序列进行变换,统一转成固定长度的特征序列。并且由于原始特征字段不定长,在转换时需要考虑填充到多大的固定的长度,如何填充的问题。
生产环境下通常特征数据量巨大,比如TB级别海量的原始ORC压缩文件,因此使用Amazon SageMaker pyspark的processing job来实现具体的定长特征转换的工作。
Amazon SageMaker Processing Job提供了强大的分布式处理能力,能够高效地并行处理大规模数据集特别是TB级别的海量特征数据。它能够自动配置和管理Spark集群,实现按需弹性扩展,避免了手动维护集群的复杂性。
通过集成Apache Spark和MLlib,可以轻松使用各种内置的特征工程和机器学习算子。同时与Amazon SageMaker的其他组件无缝集成,简化了从数据处理到模型部署的端到端机器学习工作流程。更多信息您可以参阅附录中的Amazom SageMaker Processing Job资料。
针对特征填充长度和填充weigth权重值方法的问题,在具体转换job之前,先分别运行统计特征基数和最大序列长度的pyspark job,从而获取每个特征列所有唯一值和最大变长值的序列长度,具体如下。
spark = SparkSession.builder.appName("FeatureColumnStats").getOrCreate()# 读取数据df = spark.read.format("orc") \.option("compression", "snappy") \.option("recursiveFileLookup", "true") \.load("s3://sagemaker-us-west-2-687912291502/mv-poc/raw/")feature_columns = [col for col in df.columns if col.startswith('_')]# 对每个特征列lambda调用,统计最大序列长度def process_column_lenth(dataframe, column_name):return dataframe.agg(lit(column_name).alias("column_name"),max(when((col(column_name).isNull()) | (col(column_name) == ""),0).otherwise(size(split(col(column_name), '\x01')))).alias("max_sequence_length"))# 对每个特征列lambda调用,提取所有的唯一值并存入单独的列表def process_column_unique(dataframe, column_name):return dataframe.select(lit(column_name).alias("column_name"),collect_set(when((split(split(col(column_name), '\x01')[0], '\x03')[0] != '') &(split(split(col(column_name), '\x01')[0], '\x03')[0].isNotNull()),split(split(col(column_name), '\x01')[0], '\x03')[0])).alias("unique_values"))# 处理每个特征列的唯一值及最大序列长度feature_dfs_lenth = [process_column_lenth(df, col_name) for col_name in feature_columns]feature_dfs_unique = [process_column_unique(df, col_name) for col_name in feature_columns]我们使用 pyspark DataFrame API 进行分布式处理,并通过 spark broadcast 广播将唯一值和最大序列长度字典数据分发到每个 pyspark worker 工作节点:FEATURE_HASH_DICT = load_feature_hash_dict(args.feature_hash_dict)FEATURE_LENTH_DICT = load_feature_lenth_dict(args.feature_lenth_dict)sc = spark.sparkContextFEATURE_HASH_DICT_BROADCAST = sc.broadcast(FEATURE_HASH_DICT)FEATURE_LENTH_DICT_BROADCAST = sc.broadcast(FEATURE_LENTH_DICT)## 拆分到多个分区df = df.repartition(args.num_partitions)feature_columns = [col for col in df.columns if col.startswith('_')]df_processed = df.rdd.mapPartitions(lambda iterator: process_partition(iterator, feature_columns, FEATURE_HASH_DICT_BROADCAST,FEATURE_LENTH_DICT_BROADCAST,args.padding_lenth)).toDF()
左右滑动查看完整示意
特征处理逻辑如下:
label列保持不变。
对feature每一列进行padding的时候,传入之前统计的所有列的唯一值和最大序列长度的字典。
如果该列的值数量已经是统计出的该列唯一值长度,则不再填充,截断为唯一值长度大小。
如果没有达到唯一值长度,则按该列的最大变长值进行key和weight的填充,从该特征列唯一值字典没有出现的key中随机选择一个。
填充weight value值的时候,需要设置为一个极小值(比如10e-7=0.00000001,之所以不能设置为0,是因为feature_column API的要求),以便让padding的特征对之后特征处理没有影响。
对于结构化特征的建模,序列特征很长不一定模型效果就好,且padding太长会导致特征数据膨胀,因此本例将序列特征截断到一定长度(比如10)来做演示。
def process_feature(value, hash_set, column_lenth,padding_lenth):    result = []
    if value:  # 如果 value 不是空字符串        features = value.split('\x01')        for feature in features:            hash_value, weight = feature.split('\x03')            hash_int = int(hash_value)            iffloat(weight) == 0:                weight = "0.00000001"            result.append(f"{hash_value}\x03{weight}")            if len(result) >= padding_lenth:                break  # 如果已经有10个键,就停止处理
    # 如果结果中的键少于10个,才从hash_set中补充    if len(result) < column_lenth and len(result) < padding_lenth:        fill_count = 1        while len(result) < column_lenth:            fill_hash = f"00000000000000{fill_count}"            result.append(f"{fill_hash}\x030.000000001")            fill_count = fill_count+1            if len(result) >= padding_lenth:                break  # 达到最长个数的键就停止    return'\x01'.join(result)
左右滑动查看完整示意
特征数据padding完成之后,即可使用TensorFlow的FixedLenFeature构造特征定长特征列,并使用categorical_column_with_hash_bucket进行特征加权,具体代码如下。
# 对每个特征列按照padding长度构造FixedLenFeaturefor start, end in feature_cl:    feature_description.update({      'id__{}'.format(colname): tf.io.FixedLenFeature([(sequence_length['_{}'.format(colname)]], tf.string)          for colname in range(start, end+1)      })
    feature_description.update({      'weighted_id__{}'.format(colname): tf.io.FixedLenFeature(sequence_length['_{}'.format(colname)]], tf.float32)          for colname in range(start, end+1)  })
左右滑动查看完整示意
根据特征的基数来选择hash bucket size。
for key, value in feature_hash.items():new_key = key# Get the length of the value (array)length = len(value)# Determine the value of hash_bucket_size based on the lengthif length <= TEN_MILLION:hash_bucket_size[new_key] = length*3else:# If it exceeds 10 million, take the fourth root of the valuehash_bucket_size[new_key] = int(math.pow(length, 0.25))tf.print("hash_bucket_size:")for key, value in hash_bucket_size.items():tf.print(f"{key}: {value}")
左右滑动查看完整示意
使用categorical_column_with_hash_bucket和weighted_categorical_column对特征列的weight值进行value加权。
sparse_col = {  colname:  tf.feature_column.categorical_column_with_hash_bucket(colname, hash_bucket_size=min(hash_bucket_size[colname.split("id_")[-1]],10), dtype=tf.string)    for colname in feature_description.keys() if colname.startswith('id__')}

weighted_sparse_col = {    'weighted_{}'.format(colname) : tf.feature_column.weighted_categorical_column(col, 'weighted_{}'.format(colname))      for colname, col in sparse_col.items()  }
左右滑动查看完整示意
Amazon SageMaker TensorFlow
定长特征模型训练
准备好TensorFlow的定长特征相关逻辑代码后,使用Amazon SageMaker的Training Job来拉起TensorFlow的分布式训练。
Amazon SageMaker Training Job为TensorFlow提供了完整的分布式训练支持,可以轻松配置多实例多GPU的训练环境,充分利用分布式计算资源加速模型训练。它原生支持TensorFlow的分布式策略,包括PS参数服务器、distributed strategy等模式。且通过内置的MLOps功能,可以自动记录训练指标、模型版本和实验跟踪,实现完整的模型生命周期管理。
Training Job还提供了自动超参数调优、热启动训练等高级特性,并能与Amazon SageMaker其他服务无缝集成,简化了从训练到部署的全流程。更多信息可以参阅附录中的Amazon SageMaker训练资料。
在Amazon SageMaker中拉起上面章节中的定长特征模型训练代码示例如下。
original_job_name = 'tensorflow-poc'job_name = f"{original_job_name}-{timestamp}"print(job_name)environment = {'job_name': job_name,               'feature_lenth_dict':'s3://sagemaker-us-west-2-687912291502/tf_train/features_20240710_041505/part-00000-f02ce9a7-3057-4b81-b6aa-520954364de1-c000.json',               'feature_hash_dict':'s3://sagemaker-us-west-2-687912291502/tf_train/features_20240710_041505/part-00000-757be5db-4d45-493f-a7b9-836104157742-c000.json'              }
from sagemaker.tensorflow import TensorFlow
wide_deep_estimator = TensorFlow(entry_point='./DNN-varlen-feature-raggedtensor.py',                             role=role,                             source_dir = './train/',                             max_run=86400*3,                             use_spot_instances=True,                             max_wait=86400*3,                             instance_count=20,                             train_volume_size=400,                             instance_type='ml.m6i.8xlarge',                             input_mode='FastFile',                             framework_version='2.14',                             py_version='py310',                             subnets=['subnet-0cd82a76a056fabab'], # Should be same vpc with FSx, best to use same subnet with FSx                             security_group_ids=['sg-0193c82932eb9f168','sg-04c9ce51b0c7665e7','sg-0af43c5507997cdb7',], # Needed when use FSx                             keep_alive_period_in_seconds=1800,                             environment=environment,                             distribution={'parameter_server': {'enabled': True}})                                                       inputs = {'training1': train_s3_1,'fsx': fsx_fs}wide_deep_estimator.fit(inputs, job_name = job_name)
左右滑动查看完整示意
上文代码所示Amazon SageMaker Training Job主要需要注意的点:
1.environment=environment:指定环境变量,传递模型训练需要的其他数据,比如上面章节提及的变长特征所有唯一值feature_lenth_dict字典及最大序列长度feature_lenth_dict字典。
2.instance_count=20,instance_type=’ml.m6i.8xlarge’:指定训练机器机型及数量,从而方便的拉起多机CPU分布式训练集群。
3.input_mode=’FastFile’:启用fastfile mode进行定长特征数据的流式ingestion,不用预先将TB级别训练数据加载到训练算力机磁盘,而是batch批量边训练边load加载。
4.inputs= {‘training1′: train_s3_1,’fsx’: fsx_fs}:指定Amazon S3路径的特征数据路径,Amazon SageMaker会自动ingest Amazon S3上的训练数据到多台算力机的/opt/ml/data/trainging1/对应目录下;指定fsx lustre存储挂载,tensorflow多机上的模型checkpoint就可以使用FSX共享存储目录保存。
5.distribution={‘parameter_server’: {‘enabled’: True}}):启用tensorflow的PS参数服务器,Amazon SageMaker会自动拉起tensorflow的分布式训练集群,从而在训练脚本中可以方便的获取leader/worker等节点。
方案2
保持变长特征序列
变长特征转换
由于不需要对变长特征再做padding填充或者截断,特征处理会轻量级很多,只需要对原来的特征weight值进行与方案1同样的极小值处理和tfrecord格式转换,这此处还是用一个pyspark sagemaker processing job进行分布式的处理,其代码示例如下。
def create_example(row, feature_columns):    feature = {}    for col in feature_columns:        if'\x01' in row[col]:            values = row[col].split('\x01')        else:            values = [row[col]]                int64_list = []        float_list = []                for value in values:            parts = value.split('\x03')            if len(parts) >= 1:                try:                    int64_list.append(str(parts[0]))                except ValueError:                    print("too big to convert into int ",str(parts[0]))                    int64_list.append(0)                        if len(parts) >= 2:                try:                    float_list.append(float(parts[1]))                except ValueError:                    float_list.append(0.0)
        feature[f"id_{col}"] = int64_list        feature[f"weighted_id_{col}"] = float_list
    feature['target'] = int(row['label'])    return feature
def process_partition(iterator, feature_columns):        for row in iterator:        processed_row = {}        for column in feature_columns:            processed_row[column] = process_feature(row[column],column)        processed_row['label'] = row['label']        yield create_example(processed_row, feature_columns)

        def main():    args = parse_args()        spark = SparkSession.builder\            .appName("FeatureProcessing") \            .config("spark.driver.extraJavaOptions", "-Dlog4j.rootCategory=ERROR,console -Dlog4j.logger.org.apache.spark=ERROR -Dlog4j.logger.org.apache.hadoop=ERROR") \            .config("spark.executor.extraJavaOptions", "-Dlog4j.rootCategory=ERROR,console -Dlog4j.logger.org.apache.spark=ERROR -Dlog4j.logger.org.apache.hadoop=ERROR") \            .getOrCreate()    sc = spark.sparkContext
    df = spark.read.format("orc").option("compression", "snappy").load(args.input_data_uri)    df = df.repartition(args.num_partitions)    feature_columns = [col for col in df.columns if col.startswith('_')]    df_processed = df.rdd.mapPartitions(        lambda iterator: process_partition(iterator, feature_columns)    ).toDF()
左右滑动查看完整示意
Amazon SageMaker TensorFlow
变长特征模型训练
以上方案1中,把变长特征通过截断和padding,处理为定长的序列特征字段,该方案会导致特征数据膨胀问题,比如原来某一特征列在原始数据中只有5个多值key和weight权重,而如果特征基数为10,需要padding为定长10的特征序列,则会膨胀一倍。对于该特征大部分记录中都没有到10或者基数的时候,每条记录都会数据膨胀。
在TB级别海量特征场景下,数据膨胀的问题会更加明显(10TB数据会增长到20TB),特征处理的资源开销会是一个需要考虑的问题。
因此另一个方案就是保持原有的不定长特征序列,在TensorFlow中对不定长特征进行统一的embedding编码,并进行训练,这是最理想的方式,没有单独的特征处理的job,且与数据平台上下游衔接也更加平滑。
但是目前业界不定长特征列在TensorFlow中并没有官方通用的方法,本文中给出了一种使用RaggedTensor表示shape不规整的tensor的方法及对应的TensorFlow训练代码,详见附录中sample示例,其关键的实现具体如下。
1.封装DenseToRaggedLayer(tf.keras.layers.Layer)把Dense Tensor转为RaggedTensor,从而表示shape不规整的Tensor。
class DenseToRaggedLayer(tf.keras.layers.Layer):        def __init__(self, ignore_value, **kwargs):        super(DenseToRaggedLayer, self).__init__(**kwargs)        self.ignore_value = ignore_value
    def call(self, inputs):        return tf.RaggedTensor.from_tensor(inputs, padding=self.ignore_value)
左右滑动查看完整示意
不同长度的特征列share一个embedding table。
share_embedding_sparse_config = [ {'name': 'share_emb_1', 'columns': { colname : {} for colname in feature_description.keys() if colname.startswith('id_')}, 'bucket_size': 50000000, #5000w + 4K mini batch per work can work on r5.4xlarge. 'embedding_size': 16},]左右滑动查看完整示意
2.使用keras.layers.Hashing以便支持RaggedTensor,并构造带有权重的share embedding。
带有权重的share embedding的实现需要注意以下事项。
1.在keras中,tf.keras.layers.Embedding没有combiner选项,但可以使用tf.keras.layers.Dense实现相同的效果,可参考下方链接。
2.在keras中,tf.keras没有直接实现share embedding的layer,直接用同一个layer针对不同的input调用就间接实现了share。
3.在keras中,使用preprocessing API的时候,使用CategoryEncoding API的参数count_weights把权重带入,注意count_weights是支持变长权重的。
Amazon Bedrock
https://aws.amazon.com/cn/bedrock/
3.使用keras.layers.CategoryEncoding以便支持RaggedTensor。
for conf in share_embedding_sparse_config:        shared_embedding = tf.keras.layers.Dense(conf['embedding_size'], use_bias=False)        for feature_name, inner_conf in conf['columns'].items():            cur_input = keras.Input(shape=(None,), name=feature_name, dtype=tf.string) #id特征            weight_name = 'weighted_' + feature_name            weigh_cur_input = keras.Input(shape=(None,), name=weight_name, dtype=tf.float32) #id特征的权重            #preprocessing.Hashing支持tf.sparse tensor            #下面的hashing的output_mode要设定为int(索引编号),否则会因为bucket size很大,占用很多的内存。            ragged_hashed_input = tf.keras.layers.Hashing(num_bins=conf['bucket_size'], name=feature_name + '_hash', output_mode='int',)(DenseToRaggedLayer(name=feature_name + '_rag', ignore_value = '-1')(cur_input))                      #为了使用特征的权重,这里需要把参数output_mode设置为count            encoded_data = tf.keras.layers.CategoryEncoding(num_tokens=conf['bucket_size'], output_mode='count', sparse=True)(ragged_hashed_input, count_weights= DenseToRaggedLayer(name=weight_name + '_rag', ignore_value = 0)(weigh_cur_input))            shared_emb_data = shared_embedding(encoded_data)                                             deep_raw_inputs.append(cur_input)            deep_raw_inputs.append(weigh_cur_input)            deep_inputs.append(shared_emb_data)        # BUILD MODEL
    deep = layers.Concatenate()(deep_inputs)
左右滑动查看完整示意
在接收变长特征训练数据时,通过map操作,使用tf.io.parse_example根据预定义的feature_description将数据解析成特征字典,从解析后的特征字典中提取并移除标签(target)。
在处理成字典的时候,给没有值的ID特征填充一个无意义的值“-1”,并且确保给被填充的ID特征对应的权重为0,从而消除这些填充ID的影响,具体代码示例如下。
def parse_record_batch(message): parsed_feature_dict = tf.io.parse_example(message, feature_description) label = parsed_feature_dict.pop('target') for feature_name, cur_tensor in parsed_feature_dict.items(): if feature_name.startswith('id'): parsed_feature_dict[feature_name] = tf.sparse.to_dense(cur_tensor, '-1') if feature_name.startswith('weighted'): #给id特征对应的padding的权重设定为'0',从而把padding的id的特征值的影响去除 parsed_feature_dict[feature_name] = tf.sparse.to_dense(cur_tensor, 0) return parsed_feature_dict, label左右滑动查看完整示意
变长特征训练的Amazon SageMaker Training Job与上文定长padding方式的Amazon SageMaker Training Job一致,entry point调整为变长训练的脚本(本文中为DNN-varlen-feature-raggedtensor.py),同样参数中启动TensorFlow PS参数服务器。
wide_deep_estimator = TensorFlow(entry_point='./DNN-varlen-feature-raggedtensor.py', role=role, source_dir = './train/', instance_count=20, instance_type='ml.m6i.8xlarge', framework_version='2.14', py_version='py310', subnets=['subnet-0cd82a76a056fabab'], # Should be same vpc with FSx, best to use same subnet with FSx security_group_ids=['sg-0193c82932eb9f168','sg-04c9ce51b0c7665e7','sg-0af43c5507997cdb7',], # Needed when use FSx keep_alive_period_in_seconds=1800, environment=environment, distribution={'parameter_server': {'enabled': True}})左右滑动查看完整示意
总结
本文介绍了在Amazon SageMaker上训练TensorFlow变长特征模型的技术方案和落地实践经验。
通过本文,算法的小伙伴可以提高训练数据特征存储和处理的效率,优化计算资源利用率,确保分布式训练的扩展性。

附录
Amazon SageMaker服务
https://docs.aws.amazon.com/zh_cn/sagemaker/latest/dg/machine-learning-environments.html
Amazon SageMaker Processing Job
https://docs.aws.amazon.com/sagemaker/latest/dg/processing-job-frameworks-pytorch.html
Amazon SageMaker TensorFlow训练
https://sagemaker.readthedocs.io/en/stable/frameworks/tensorflow/using_tf.html#training-with-parameter-servers
Tensorflow Dense embedding参考
https://tensorflow.google.cn/guide/migrate/migrating_feature_columns?hl=zh-cn%EF%BC%89
Sample代码示例
https://github.com/aws-samples/tensorflow_varlen_distribute_training_sample_code
本篇作者
唐清原
亚马逊云科技高级解决方案架构师,负责Data Analytic&人工智能与机器学习产品服务架构设计以及解决方案。10+数据领域研发及架构设计经验,在大数据BI、数据湖、推荐系统、MLOps等平台项目有丰富实战经验。
梁宇辉
亚马逊云科技机器学习产品技术专家,负责基于亚马逊云科技的机器学习方案的咨询与设计,专注于机器学习的推广与应用,深度参与了很多真实客户的机器学习项目的构建以及优化。对于深度学习模型分布式训练,推荐系统和计算广告等领域具有丰富经验。
我们正处在Agentic AI爆发前夜。企业要从"成本优化"转向"创新驱动",通过完善的数据战略和AI云服务,把握全球化机遇。亚马逊将投入1000亿美元在AI算力、云基础设施等领域,通过领先的技术实力和帮助“中国企业出海“和”服务中国客户创新“的丰富经验,助力企业在AI时代突破。
更多推荐



 0
 0
- 0


 已为社区贡献143条内容

所有评论(0)