
基于Hadoop+Spark的深圳房产数据系统架构设计思路
·
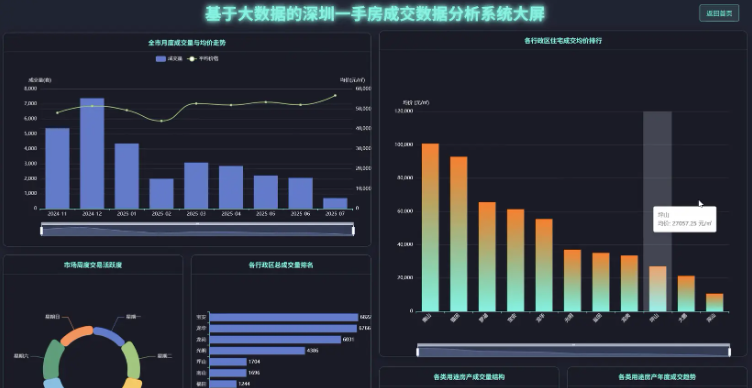
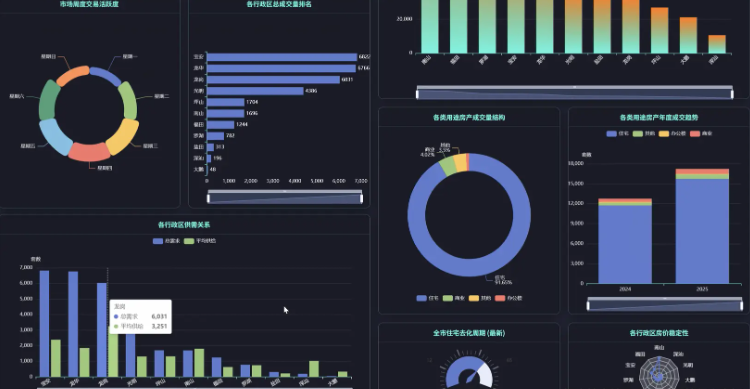
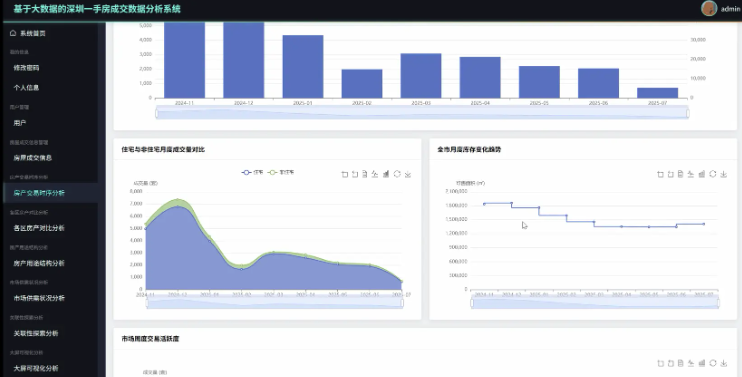
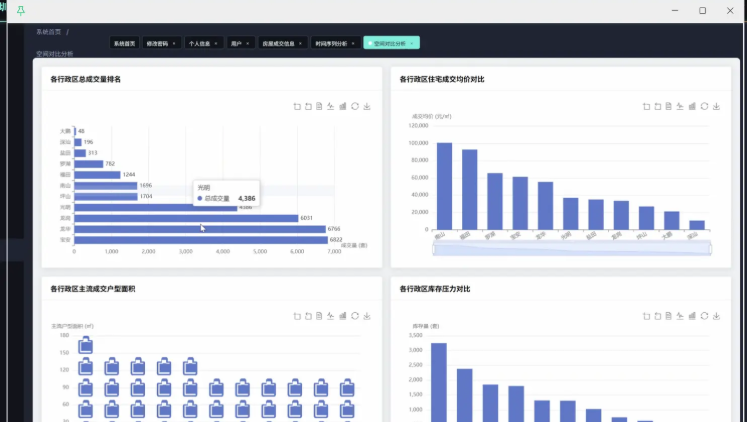
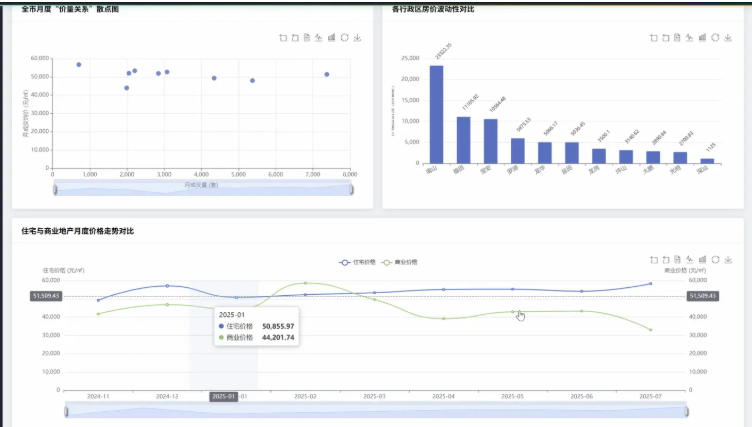
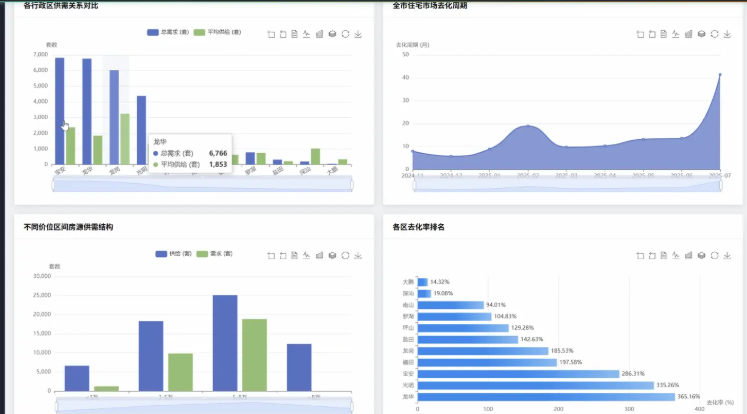
基于大数据的深圳一手房成交数据分析系统是一套运用现代大数据技术栈构建的房地产市场数据分析平台。该系统采用Hadoop分布式文件系统作为数据存储基础,结合Spark计算引擎进行大规模数据处理与分析,通过Django框架提供稳定的后端服务支撑,前端采用Vue+ElementUI+Echarts技术栈实现用户交互界面。系统核心功能围绕深圳房地产市场的五大分析维度展开:时间趋势分析追踪全市月度成交量与均价变化轨迹,空间对比分析揭示各行政区域市场表现差异,用途结构分析解析住宅与非住宅物业的市场占比,供需关系分析评估市场去化能力与库存压力,关联性探索分析挖掘价格驱动因素。系统通过Spark SQL进行高效的数据查询与统计计算,利用Pandas和NumPy进行数据清洗与预处理,最终以直观的图表形式展现分析结果,为房地产市场参与者提供数据驱动的决策支持工具。
大数据框架:Hadoop+Spark(本次没用Hive,支持定制) 开发语言:Python+Java(两个版本都支持) 后端框架:Django+Spring Boot(Spring+SpringMVC+Mybatis)(两个版本都支持) 前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery 详细技术点:Hadoop、HDFS、Spark、Spark SQL、Pandas、NumPy 数据库:MySQL
更多推荐



 2
 0
- 0


 已为社区贡献31条内容

所有评论(0)