
kubernetes的控制器
一 什么是控制器
官方文档:
https://v1-30.docs.kubernetes.io/zh-cn/docs/concepts/workloads/controllers/
控制器也是管理pod的一种手段
- 自主式pod:pod退出或意外关闭后不会被重新创建
- 控制器管理的 Pod:在控制器的生命周期里,始终要维持 Pod 的副本数目
Pod控制器是管理pod的中间层,使用Pod控制器之后,只需要告诉Pod控制器,想要多少个什么样的Pod就可以了,它会创建出满足条件的Pod并确保每一个Pod资源处于用户期望的目标状态。如果Pod资源在运行中出现故障,它会基于指定策略重新编排Pod
当建立控制器后,会把期望值写入etcd,k8s中的apiserver检索etcd中我们保存的期望状态,并对比pod的当前状态,如果出现差异代码自驱动立即恢复
二 控制器常用类型
| 控制器名称 | 控制器用途 |
|---|---|
| Replication Controller | 比较原始的pod控制器,已经被废弃,由ReplicaSet替代 |
| ReplicaSet | ReplicaSet 确保任何时间都有指定数量的 Pod 副本在运行 |
| Deployment | 一个 Deployment 为 Pod 和 ReplicaSet 提供声明式的更新能力 |
| DaemonSet | DaemonSet 确保全指定节点上运行一个 Pod 的副本 |
| StatefulSet | StatefulSet 是用来管理有状态应用的工作负载 API 对象。 |
| Job | 执行批处理任务,仅执行一次任务,保证任务的一个或多个Pod成功结束 |
| CronJob | Cron Job 创建基于时间调度的 Jobs。 |
| HPA全称Horizontal Pod Autoscaler | 根据资源利用率自动调整service中Pod数量,实现Pod水平自动缩放 |
三 replicaset控制器
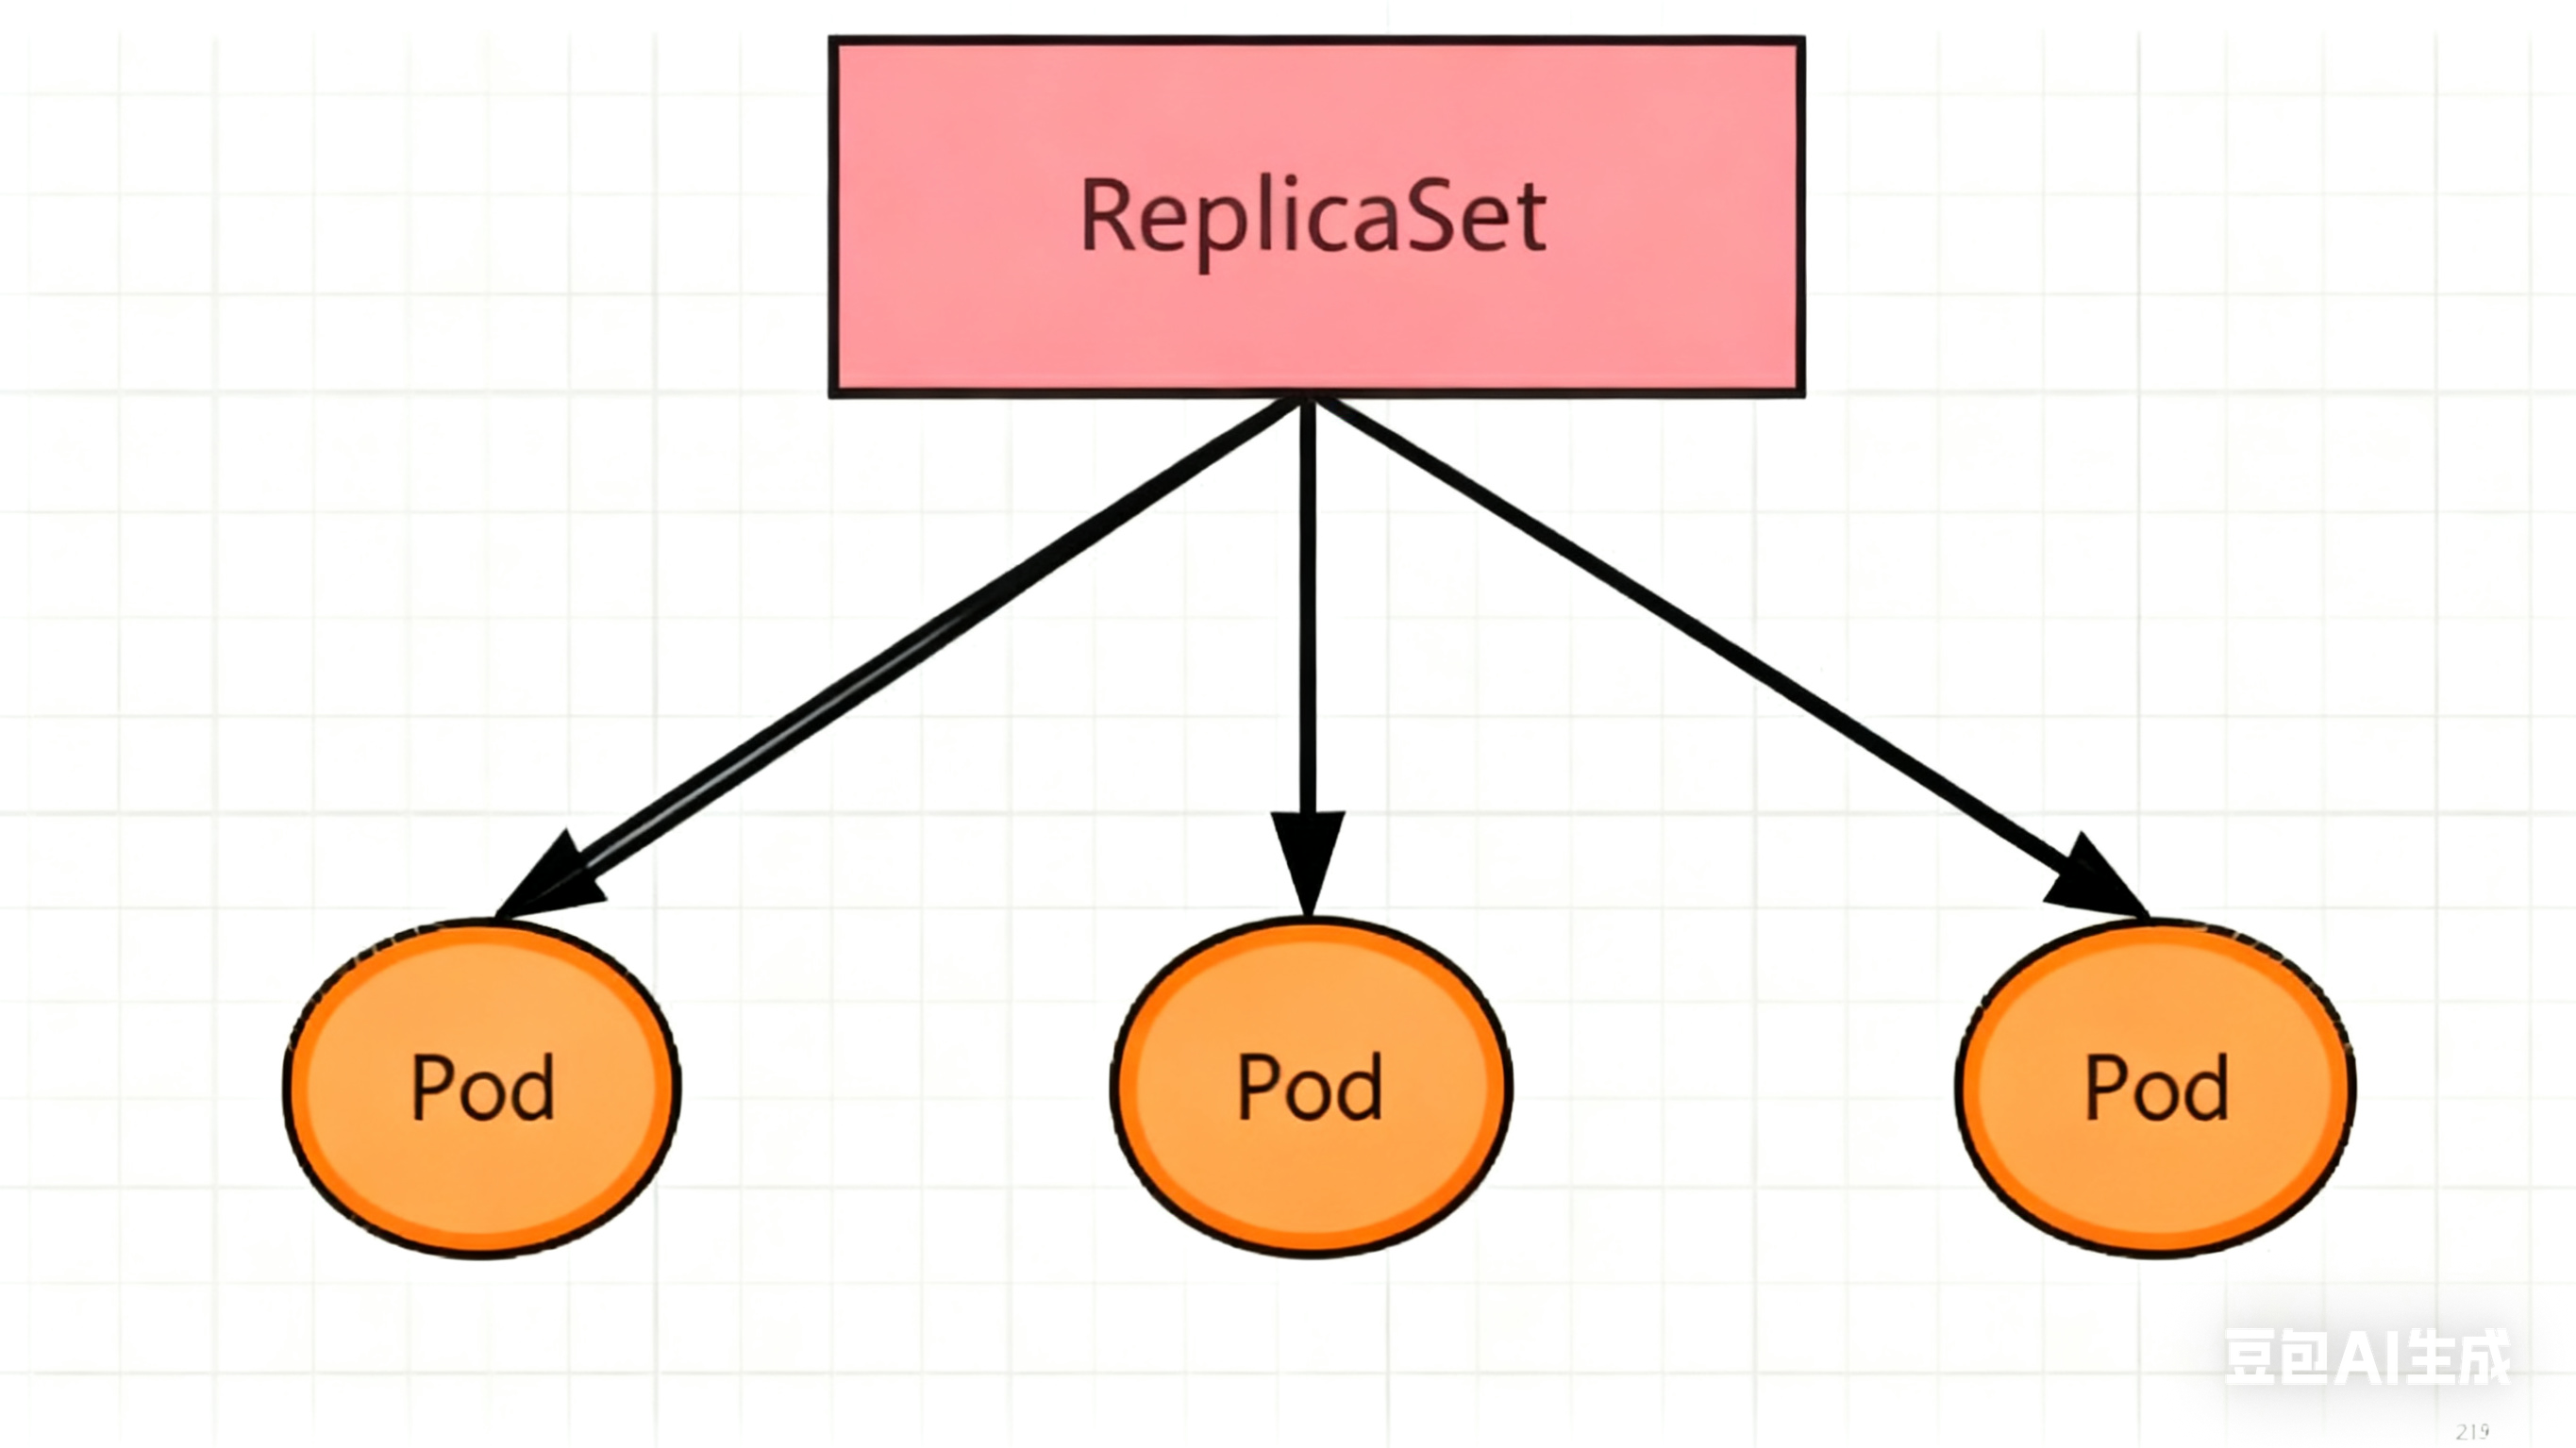
3.1 ReplicaSet 功能
ReplicaSet 的核心作用是:保证集群中始终有「指定数量的 Pod 副本」在运行。如果某个 Pod 崩溃、被删除,ReplicaSet 会自动新建 Pod,维持 “副本数不变”。
它是 Deployment 的 “底层支撑”(Deployment 通过管理 ReplicaSet 间接管理 Pod),但生产中一般不直接使用 ReplicaSet,而是用更强大的 Deployment。
3.2 replicaset参数说明
| 参数名称 | 字段类型 | 参数说明 |
|---|---|---|
| spec | Object | 详细定义对象,固定值就写Spec |
| spec.replicas | integer | 指定维护pod数量 |
| spec.selector | Object | Selector是对pod的标签查询,与pod数量匹配 |
| spec.selector.matchLabels | string | 指定Selector查询标签的名称和值,以key:value方式指定 |
| spec.template | Object | 指定对pod的描述信息,比如lab标签,运行容器的信息等 |
| spec.template.metadata | Object | 指定pod属性 |
| spec.template.metadata.labels | string | 指定pod标签 |
| spec.template.spec | Object | 详细定义对象 |
| spec.template.spec.containers | list | Spec对象的容器列表定义 |
| spec.template.spec.containers.name | string | 指定容器名称 |
| spec.template.spec.containers.image | string | 指定容器镜像 |
3.3 replicaset 示例
# 先看看kubectl create能创建哪些资源(这里没有直接的replicaset命令,所以用其他方式生成配置)
[root@master pod]# kubectl create
clusterrolebinding   (Create a cluster role binding for a particular cluster role)
clusterrole          (Create a cluster role)
configmap            (Create a config map from a local file, directory or literal value)
cronjob              (Create a cron job with the specified name)
deployment           (Create a deployment with the specified name)
ingress              (Create an ingress with the specified name)
job                  (Create a job with the specified name)
namespace            (用指定的名称创建一个命名空间)
poddisruptionbudget  (Create a pod disruption budget with the specified name)
priorityclass        (Create a priority class with the specified name)
quota                (Create a quota with the specified name)
rolebinding          (Create a role binding for a particular role or cluster role)
role                 (Create a role with single rule)
secret               (Create a secret using a specified subcommand)
serviceaccount       (创建一个指定名称的服务账户)
service              (Create a service using a specified subcommand)
token                (Request a service account token)
# 因为kubectl create没有直接的replicaset命令,所以先创建一个deployment的配置,再改成replicaset
[root@master pod]# kubectl create deployment replicaset --image myapp:v1 --dry-run=client -o yaml > replicaset.yml
# 编辑配置文件,把kind从Deployment改成ReplicaSet,调整参数
[root@master pod]# vim replicaset.yml
# 最终的配置文件内容如下
[root@master pod]# cat replicaset.yml
apiVersion: apps/v1  # API版本,固定写法
kind: ReplicaSet     # 资源类型,这里是ReplicaSet
metadata:
  labels:            # 给ReplicaSet自己打的标签(方便管理)
    app: replicaset
  name: replicaset    # ReplicaSet的名字
spec:
  replicas: 2         # 期望2个Pod副本
  selector:           # 选择要管理的Pod(通过标签匹配)
    matchLabels:
      app: replicaset # 只管带app: replicaset标签的Pod
  template:           # Pod模板(创建Pod的依据)
    metadata:
      labels:
        app: replicaset # Pod的标签,必须和selector里的一致,否则ReplicaSet不认
    spec:
      containers:     # 容器配置
      - image: myapp:v1 # 用myapp:v1镜像
        name: myapp     # 容器名字叫myapp

# 执行配置文件,创建ReplicaSet
[root@master pod]# kubectl apply -f replicaset.yml
replicaset.apps/replicaset created

# 编辑配置文件,把replicas改成3,保存后生效(让ReplicaSet维持3个Pod)
[root@master pod]# kubectl edit -f replicaset.yml
replicaset.apps/replicaset edited
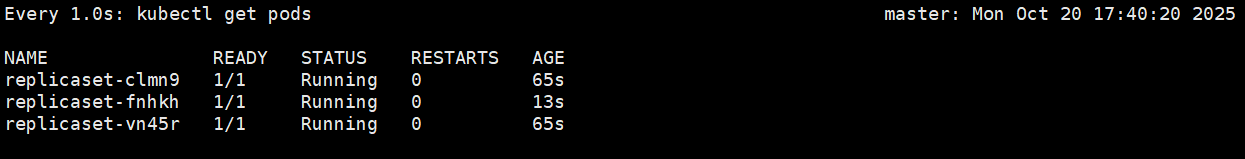
测试:删除一个pod
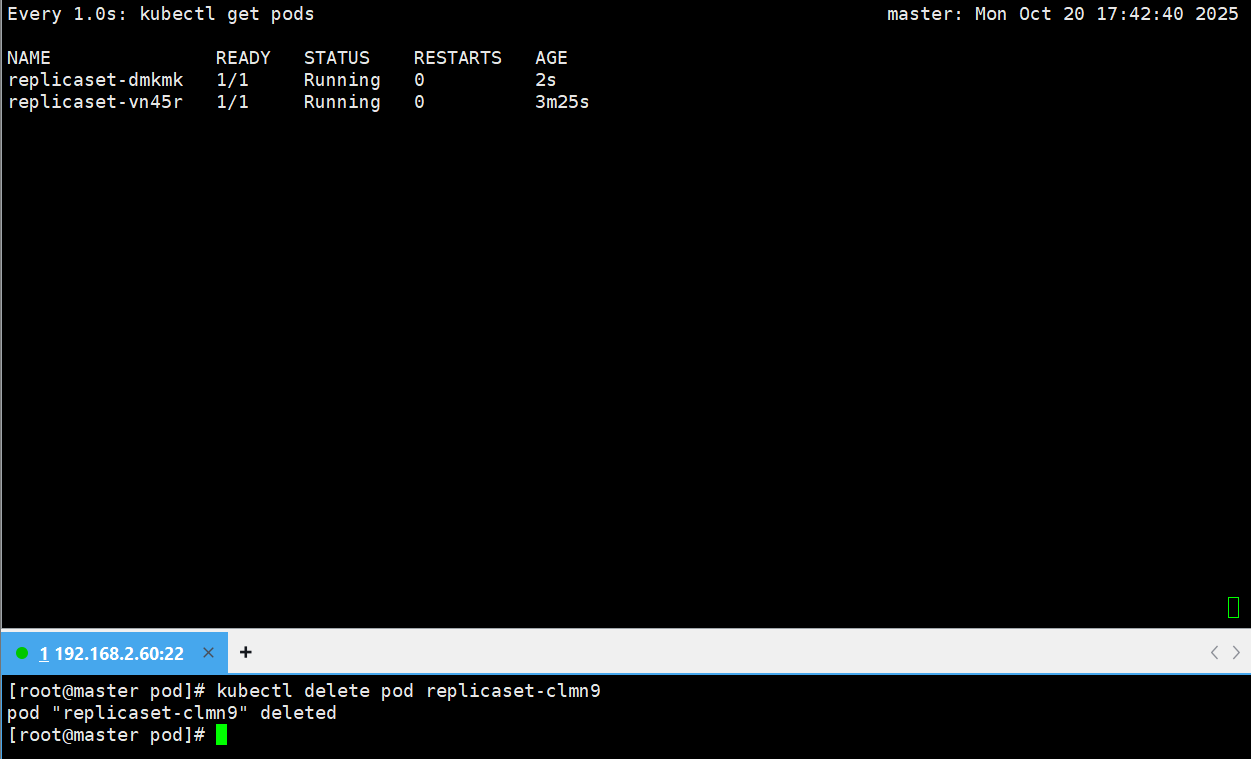
结果:
执行kubectl apply -f replicaset.yml后,K8s 会创建一个 ReplicaSet,并根据模板创建 2 个带app: replicaset标签的 Pod。当通过kubectl edit把 replicas 改成 3 后,ReplicaSet 会自动新增 1 个 Pod,保持总数量为 3。如果手动删除一个 Pod(比如执行kubectl delete pod <pod名>),ReplicaSet 会立刻检测到数量不够,马上新建一个 Pod 补上,始终维持你设定的副本数。
总结:
ReplicaSet 的核心就是 “保数量”。先定义清楚想要几个 Pod(replicas),用标签(matchLabels)把 ReplicaSet 和 Pod 绑在一起(确保它只管自己的 Pod),再写好 Pod 的模板(用什么镜像、叫什么名字)。这样不管 Pod 出什么意外,ReplicaSet 都会自动 “补位”,保证数量不变。
四、Deployment 控制器
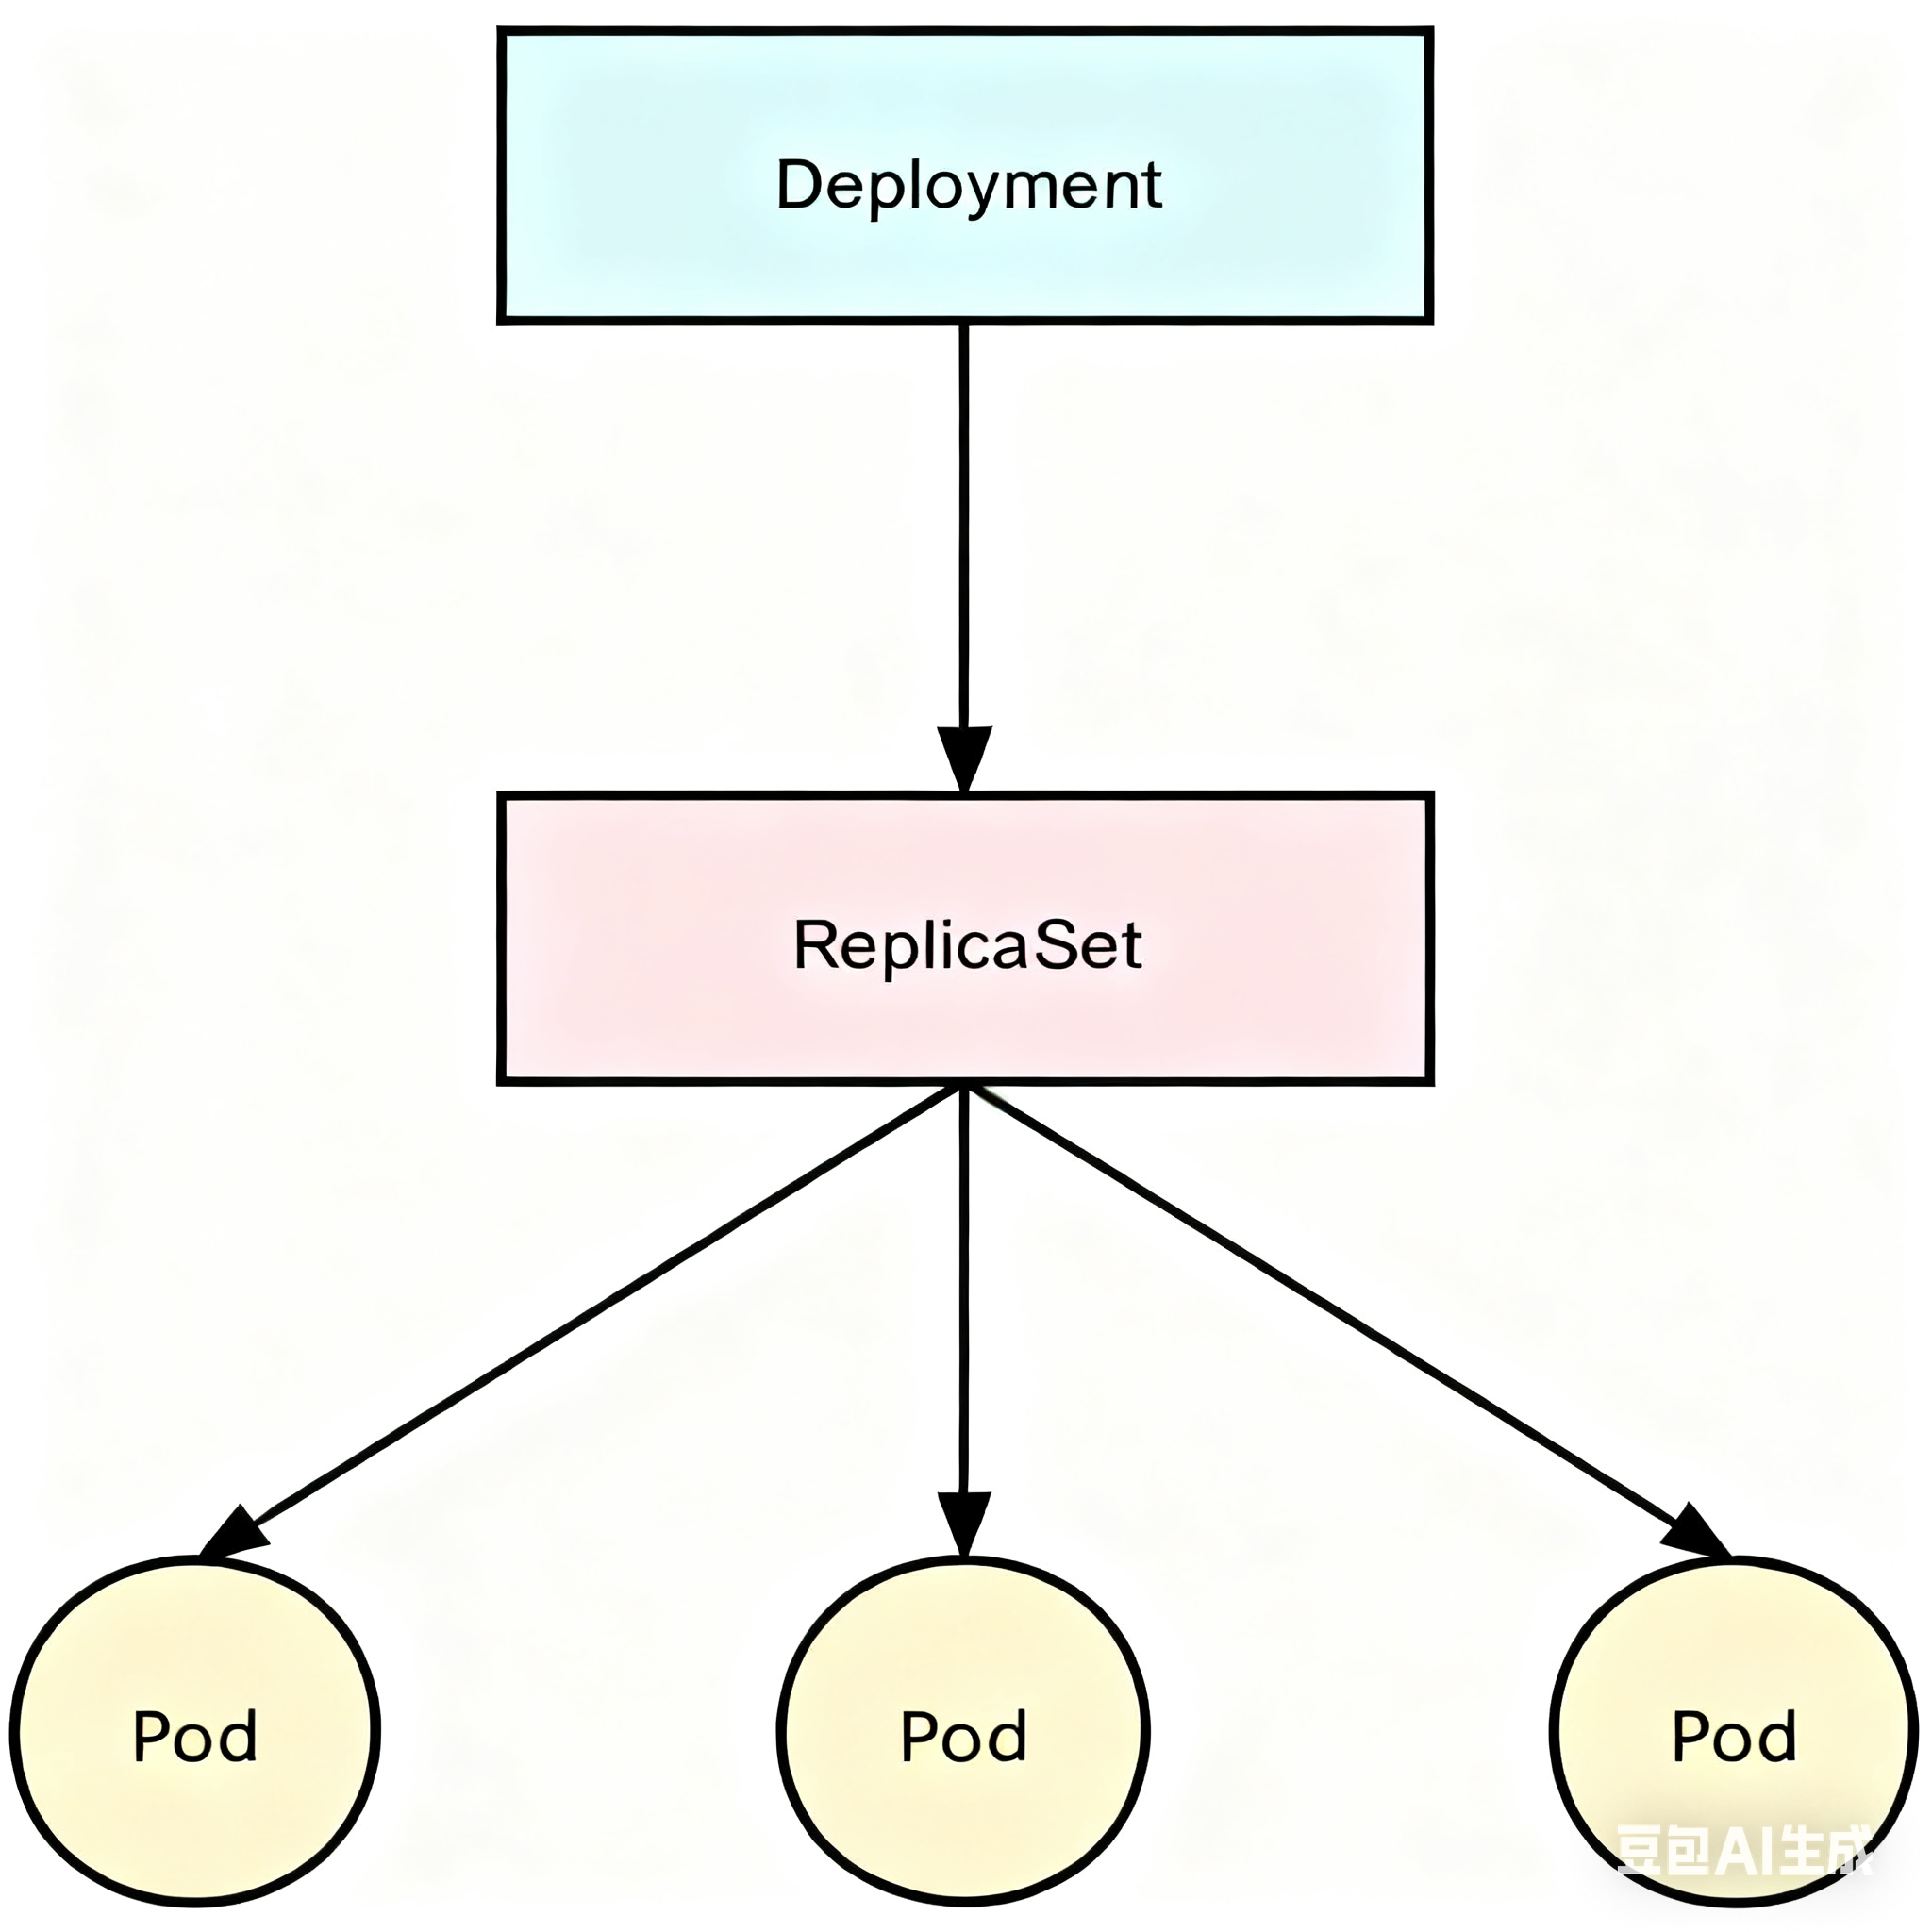
4.1 Deployment 控制器的功能
Deployment 是最常用的控制器,它基于 ReplicaSet,额外支持:
- 版本迭代:平滑升级 Pod 的镜像版本(如从
nginx:1.23升级到1.24)。 - 版本回滚:若升级出问题,可一键回滚到历史版本。
- 滚动更新:逐步替换旧 Pod 为新 Pod,过程中不中断服务(用户无感知)。
- 暂停 / 恢复更新:更新过程中可暂停,调整后再恢复。
# 创建一个deployment的配置文件(--dry-run=client表示只生成配置不实际创建,-o yaml输出为yaml格式)
[root@master pod]# kubectl create deployment deployment --image myapp:v1 --dry-run=client -o yaml > deployment.yml
[root@master pod]# vim deployment.yml
[root@master pod]# cat deployment.yml
apiVersion: apps/v1
kind: Deployment     # 资源类型是Deployment
metadata:
  labels:
    app: deployment  # Deployment的标签
  name: deployment   # Deployment的名字
spec:
  replicas: 4        # 期望4个Pod
  selector:
    matchLabels:
      app: deployment # 管理带app: deployment标签的Pod
  template:           # Pod模板
    metadata:
      labels:
        app: deployment # Pod的标签(和selector对应)
    spec:
      containers:
      - image: myapp:v1 # 初始用myapp:v1镜像
        name: myapp     # 容器名

# 执行配置,创建Deployment(会自动创建一个ReplicaSet和4个Pod)
[root@master pod]# kubectl apply -f deployment.yml
deployment.apps/deployment created

# 查看Deployment的更新历史(此时只有1个版本)
[root@master pod]# kubectl rollout history deployment
deployment.apps/deployment
REVISION  CHANGE-CAUSE
1         <none>
4.2 deployment控制器示例
4.2.1 版本迭代
# 编辑配置文件,把镜像改成myapp:v2
[root@master pod]# vim deployment.yml
[root@master pod]# cat deployment.yml
apiVersion: apps/v1
kind: Deployment
metadata:
  labels:
    app: deployment
  name: deployment
spec:
  minReadySeconds: 5  # 等待5秒确认新Pod就绪(避免刚启动就认为可用)
  replicas: 4
  selector:
    matchLabels:
      app: deployment
  template:
    metadata:
      labels:
        app: deployment
    spec:
      containers:
      - image: myapp:v2 # 镜像从v1升级到v2
        name: myapp

# 应用更新(Deployment会触发滚动更新)
[root@master pod]# kubectl apply -f deployment.yml
deployment.apps/deployment configured
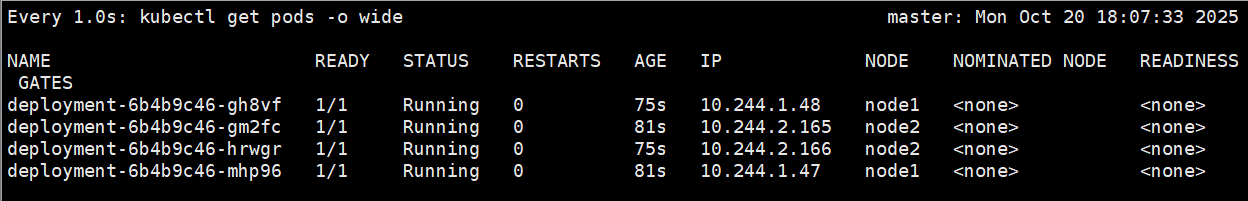
未更新前
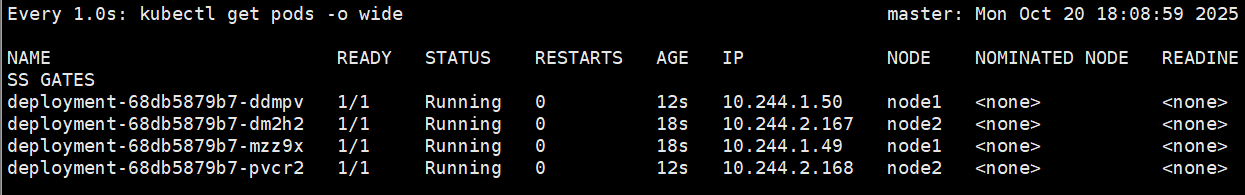
更新后,开一个新的pod,然后再关一个旧的pod
[root@master pod]# curl 10.244.2.168
Hello MyApp | Version: v2 | <a href="hostname.html">Pod Name</a>
修改镜像版本并执行kubectl apply后,Deployment 会创建一个新的 ReplicaSet(对应 v2 版本),然后逐步用新 Pod 替换旧 Pod(v1 版本)。过程中先启动新 Pod,等新 Pod 就绪(这里等了 5 秒),再删除旧 Pod,保证始终有足够的 Pod 提供服务,不会中断。
4.2.2 版本回退
# 查看当前配置的镜像(确认是v2)
[root@master pod]# grep image deployment.yml
      - image: myapp:v2
# 编辑配置,改回v1
[root@master pod]# vim deployment.yml
[root@master pod]# grep image deployment.yml
      - image: myapp:v1
# 应用更新(触发回滚,用v1镜像重建Pod)
[root@master pod]# kubectl apply -f deployment.yml
deployment.apps/deployment configured

# 查看Pod,都是新创建的(对应v1版本)
[root@master pod]# kubectl get pods -o wide
NAME                        READY   STATUS    RESTARTS   AGE   IP             NODE    NOMINATED NODE   READINESS GATES
deployment-6b4b9c46-6h9qx   1/1     Running   0          28s   10.244.2.173   node2   <none>           <none>
deployment-6b4b9c46-p5z4k   1/1     Running   0          16s   10.244.2.174   node2   <none>           <none>
deployment-6b4b9c46-qp4v8   1/1     Running   0          22s   10.244.1.55    node1   <none>           <none>
deployment-6b4b9c46-tvt8k   1/1     Running   0          10s   10.244.1.56    node1   <none>           <none>

# 访问新Pod,确认版本回退到v1
[root@master pod]# curl 10.244.2.173
Hello MyApp | Version: v1 | <a href="hostname.html">Pod Name</a>
将镜像改回 v1 并应用后,Deployment 会再次创建新的 ReplicaSet(对应 v1 版本),重复滚动更新过程,最终所有 Pod 都换成 v1 版本。旧的 v2 版本 ReplicaSet 会被保留(但副本数设为 0),方便后续可能的再次升级。
4.2.3 滚动更新策略
# 编辑配置,添加滚动更新策略
[root@master pod]# cat deployment.yml
apiVersion: apps/v1
kind: Deployment
metadata:
  labels:
    app: deployment
  name: deployment
spec:
  minReadySeconds: 5
  strategy:           # 更新策略配置
    rollingUpdate:
      maxSurge: 1     # 最多能比期望副本数多1个Pod(比如总共有4个,更新时最多5个)
      maxUnavailable: 0 # 更新过程中,不可用的Pod数量不能超过0(必须全可用)
  replicas: 4
  selector:
    matchLabels:
      app: deployment
  template:
    metadata:
      labels:
        app: deployment
    spec:
      containers:
      - image: myapp:v1
        name: myapp

# 访问旧Pod(v2版本)
[root@master pod]# curl 10.244.2.167
Hello MyApp | Version: v2 | <a href="hostname.html">Pod Name</a>

# 应用更新(按新策略执行滚动更新)
[root@master pod]# kubectl apply -f deployment.yml
deployment.apps/deployment configured

# 访问新Pod(v1版本)
[root@master pod]# curl 10.244.2.169
Hello MyApp | Version: v1 | <a href="hostname.html">Pod Name</a>
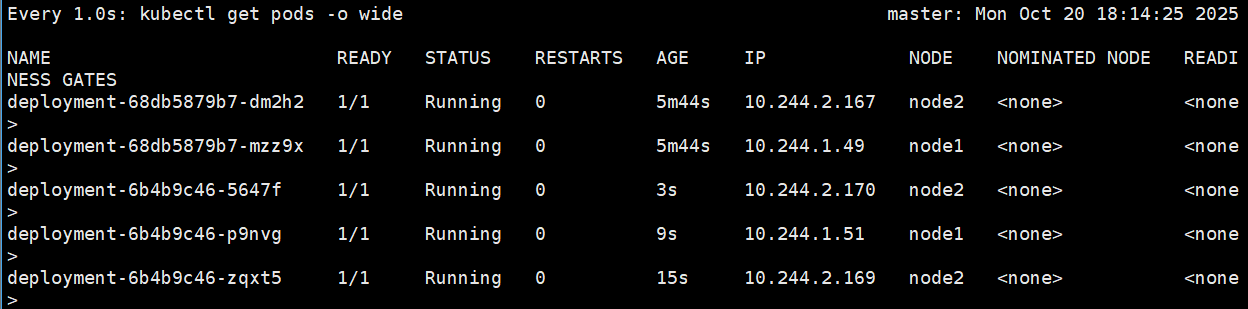
效果
结果:
添加strategy.rollingUpdate后,更新过程会受maxSurge和maxUnavailable限制:每次最多新增 1 个 Pod(总数量不超过 5),且旧 Pod 删除前必须确保新 Pod 已就绪(不可用数量为 0)。这种策略适合对可用性要求高的服务,避免更新时出现服务中断。
4.2.4 暂停 / 恢复更新
# 暂停Deployment的更新(此时即使改配置,也不会立即执行更新)
[root@master pod]# kubectl rollout pause deployment deployment
deployment.apps/deployment paused

# 确认当前Pod还是v1版本
[root@master pod]# curl 10.244.2.173
Hello MyApp | Version: v1 | <a href="hostname.html">Pod Name</a>

# 编辑配置,把镜像改成v2(但因为暂停了,不会生效)
[root@master pod]# vim deployment.yml
[root@master pod]# grep image deployment.yml
      - image: myapp:v2

# 应用配置(虽然提示配置成功,但更新被暂停,不会执行)
[root@master pod]# kubectl apply -f deployment.yml
deployment.apps/deployment configured

# 再次访问,还是v1版本(更新没执行)
[root@master pod]# curl 10.244.2.173
Hello MyApp | Version: v1 | <a href="hostname.html">Pod Name</a>

# 恢复更新(之前的配置生效,开始滚动更新到v2)
[root@master pod]# kubectl rollout resume deployment deployment
deployment.apps/deployment resumed

# 查看新Pod,都是v2版本
[root@master pod]# kubectl get pods -o wide
NAME                          READY   STATUS    RESTARTS   AGE   IP             NODE    NOMINATED NODE   READINESS GATES
deployment-68db5879b7-67kzd   1/1     Running   0          74s   10.244.1.57    node1   <none>           <none>
deployment-68db5879b7-85swn   1/1     Running   0          80s   10.244.2.175   node2   <none>           <none>
deployment-68db5879b7-chh9z   1/1     Running   0          62s   10.244.1.58    node1   <none>           <none>
deployment-68db5879b7-tl46x   1/1     Running   0          68s   10.244.2.176   node2   <none>           <none>

# 访问新Pod,确认是v2版本
[root@master pod]# curl 10.244.1.57
Hello MyApp | Version: v2 | <a href="hostname.html">Pod Name</a>
结果:
kubectl rollout pause会暂停更新,此时修改配置并应用不会触发 Pod 替换;执行kubectl rollout resume后,暂停解除,Deployment 会按最新配置执行滚动更新。这个功能适合更新前先做部分验证(比如先启动 1 个新 Pod 测试),没问题再继续。
总结:
Deployment 比 ReplicaSet 多了 “更新” 和 “回滚” 的能力。核心思路是:用 ReplicaSet 做 “版本快照”(每个版本对应一个 ReplicaSet),更新时创建新 ReplicaSet 逐步替换旧的,回滚时就切换回旧的 ReplicaSet。还可以通过策略控制更新节奏(一次更几个、允许多少不可用),甚至暂停更新慢慢检查,保证服务稳定。
五 daemonset控制器
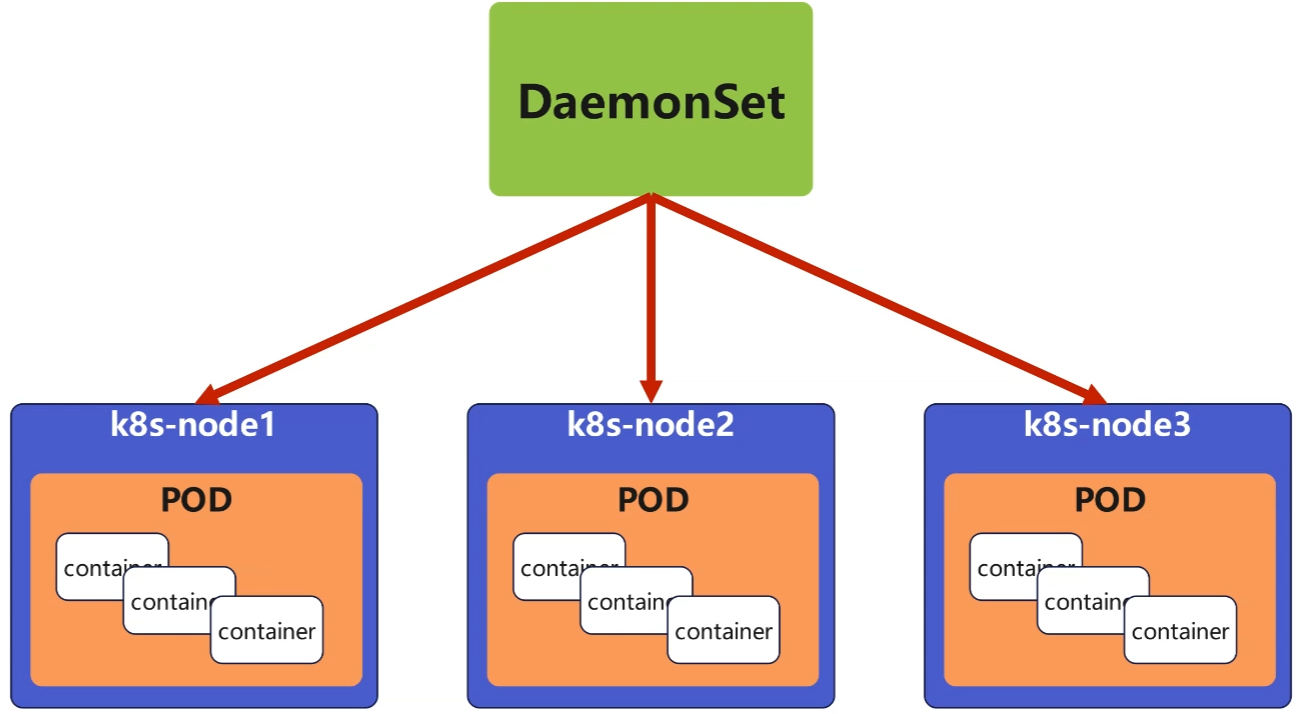
它的核心是:让集群里的 “全部节点” 或 “指定节点”,每台机器上都跑一个相同的 Pod,且长期运行不退出(比如监控、日志收集这类需要在每个节点都跑的服务)。
5.1 daemonset功能
DaemonSet 确保全部(或者某些)节点上运行一个 Pod 的副本。当有节点加入集群时, 也会为他们新增一个 Pod ,当有节点从集群移除时,这些 Pod 也会被回收。删除 DaemonSet 将会删除它创建的所有 Pod
DaemonSet 的典型用法:
- 在每个节点上运行集群存储 DaemonSet,例如 glusterd、ceph。
- 在每个节点上运行日志收集 DaemonSet,例如 fluentd、logstash。
- 在每个节点上运行监控 DaemonSet,例如 Prometheus Node Exporter、zabbix agent等
- 一个简单的用法是在所有的节点上都启动一个 DaemonSet,将被作为每种类型的 daemon 使用
- 一个稍微复杂的用法是单独对每种 daemon 类型使用多个 DaemonSet,但具有不同的标志, 并且对不同硬件类型具有不同的内存、CPU 要求
5.2 daemonset 示例
- 先查看节点是否有 “污点”(污点会阻止 Pod 调度到节点上,比如 master 节点默认有污点)
[root@master pod]# kubectl describe nodes | grep Ta
Taints:             node-role.kubernetes.io/control-plane:NoSchedule  # master节点有污点,默认不让Pod跑
Taints:             <none>  # node1节点无污点
Taints:             <none>  # node2节点无污点
# 生成DaemonSet配置文件(先用deployment命令生成,再改kind为DaemonSet)
[root@master pod]# kubectl create deployment daemonset --image myapp:v1 --dry-run=client -o yaml > daemonset.yml
# 编辑配置文件
[root@master pod]# vim daemonset.yml
# 配置文件内容
[root@master pod]# cat daemonset.yml
apiVersion: apps/v1
kind: DaemonSet  # 资源类型是DaemonSet
metadata:
  labels:
    app: daemonset
  name: daemonset
spec:
  selector:
    matchLabels:
      app: daemonset  # 管理带app: daemonset标签的Pod
  template:
    metadata:
      labels:
        app: daemonset  # Pod的标签
    spec:
      containers:
      - image: myapp:v1  # 用myapp:v1镜像
        name: myapp      # 容器名

# 创建DaemonSet
[root@master pod]# kubectl apply -f daemonset.yml
daemonset.apps/daemonset created

# 查看Pod,发现只在node1和node2上有(因为master有污点,DaemonSet默认不会在master上创建Pod)
[root@master pod]# kubectl get pods -o wide
NAME              READY   STATUS    RESTARTS   AGE   IP             NODE    NOMINATED NODE   READINESS GATES
daemonset-7cblg   1/1     Running   0          15s   10.244.1.59    node1   <none>           <none>
daemonset-rtxrz   1/1     Running   0          15s   10.244.2.177   node2   <none>           <none>
忽视污点(让 Pod 在 master 上也运行)
# 先删除之前的DaemonSet
[root@master pod]# kubectl delete -f daemonset.yml
daemonset.apps "daemonset" deleted

# 编辑配置文件,添加容忍污点的配置
[root@master pod]# vim daemonset.yml
# 新配置文件(增加了tolerations)
[root@master pod]# cat daemonset.yml
apiVersion: apps/v1
kind: DaemonSet
metadata:
  labels:
    app: daemonset
  name: daemonset
spec:
  selector:
    matchLabels:
      app: daemonset
  template:
    metadata:
      labels:
        app: daemonset
    spec:
      tolerations:  # 容忍污点配置
      - effect: NoSchedule  # 容忍“NoSchedule”类型的污点
        operator: Exists    # 只要存在这种污点就容忍(不管具体键值)
      containers:
      - image: myapp:v1
        name: myapp

# 重新创建DaemonSet
[root@master pod]# kubectl apply -f daemonset.yml
daemonset.apps/daemonset created

# 查看Pod,现在master、node1、node2上都有了(因为容忍了master的污点)
[root@master pod]# kubectl get pods -o wide
NAME              READY   STATUS    RESTARTS   AGE   IP             NODE     NOMINATED NODE   READINESS GATES
daemonset-jttwz   1/1     Running   0          3s    10.244.0.4     master   <none>           <none>
daemonset-npvf4   1/1     Running   0          3s    10.244.1.60    node1    <none>           <none>
daemonset-v8qwv   1/1     Running   0          3s    10.244.2.178   node2    <none>           <none>
- 有 3 个 Pod,分别跑在
master、node1、node2三个节点上(每个节点一个,不多不少); - 只要新节点加入集群,DaemonSet 会自动在新节点上建一个相同的 Pod;
- 执行
kubectl delete -f daemonset-example.yml会删除这个 DaemonSet,同时把它创建的所有 Pod 一起删掉(“一锅端”)。
结果:
DaemonSet 默认会在所有无污点的节点上各创建一个 Pod(如 node1、node2)。当添加tolerations配置后,Pod 可以忽略 master 节点的污点,因此 master 上也会创建一个 Pod。DaemonSet 会自动监控节点变化:新增节点时自动部署 Pod,移除节点时自动删除对应的 Pod,始终保证 “每个符合条件的节点一个 Pod”。
总结:
DaemonSet 就是要 “每个节点来一个”。比如监控服务,每个节点都得跑一个收集数据的代理,这时候就用它。如果某些节点有污点不让 Pod 跑(比如 master),就配置容忍(tolerations)让它忽略污点。这样不管节点怎么加加减减,每个节点上都会有一个对应的 Pod 在运行。
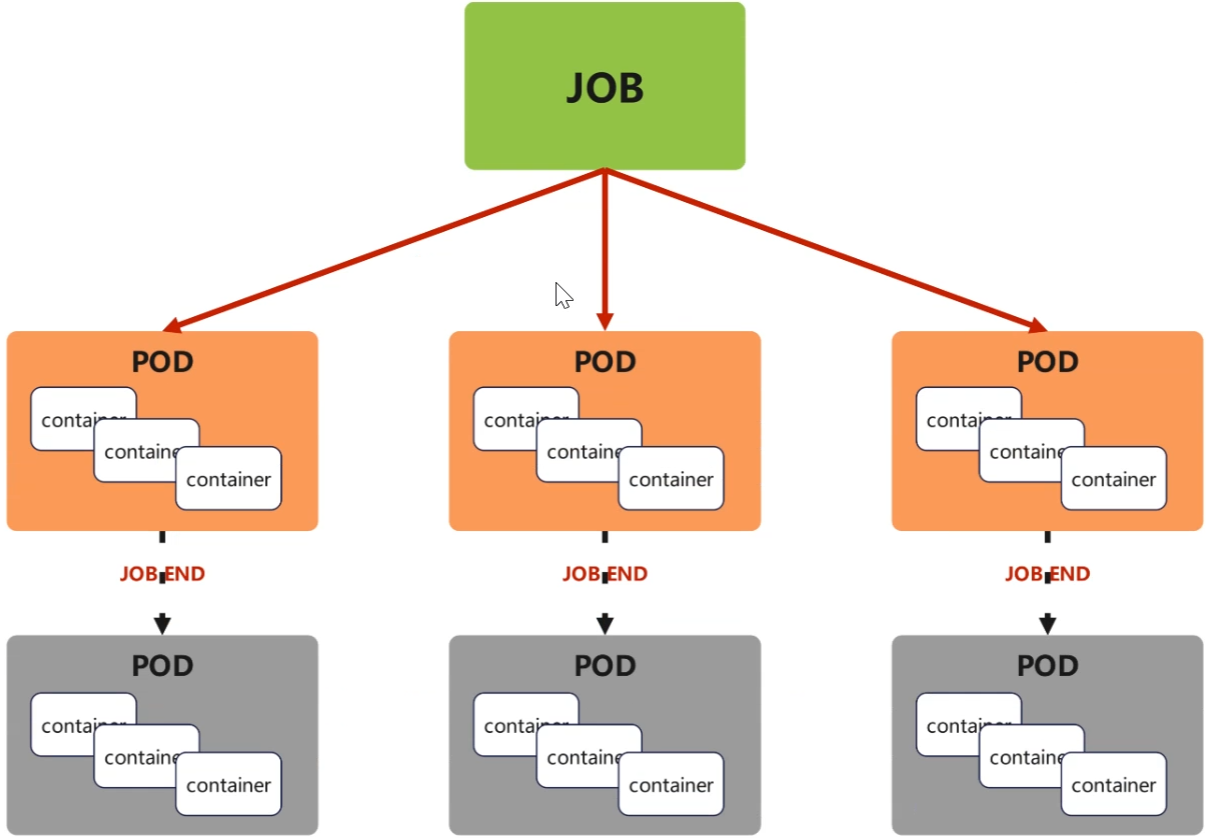
六 job 控制器:“一次性批量干活,做完就下班”
6.1 job控制器功能
# 查看当前目录文件(准备了perl镜像,用于计算π值)
[root@master ctrl]# ll
总用量 890508
-rw-r--r-- 1 root root       423 10月 18 15:01 cronjob.yml
-rw-r--r-- 1 root root       355 10月 18 14:37 daemonset.yml
-rw-r--r-- 1 root root       397 10月 18 11:50 deployment.yml
-rw-r--r-- 1 root root       307 10月 18 14:53 job.yml
-rw-r--r-- 1 root root 911857152 10月 18 14:44 perl-5.34.tar.gz  # perl镜像包
-rw-r--r-- 1 root root       303 10月 18 11:34 replicaset.yml

# 加载perl镜像到本地docker
[root@master ctrl]# docker load -i perl-5.34.tar.gz

# 给镜像打标签(方便集群内拉取)
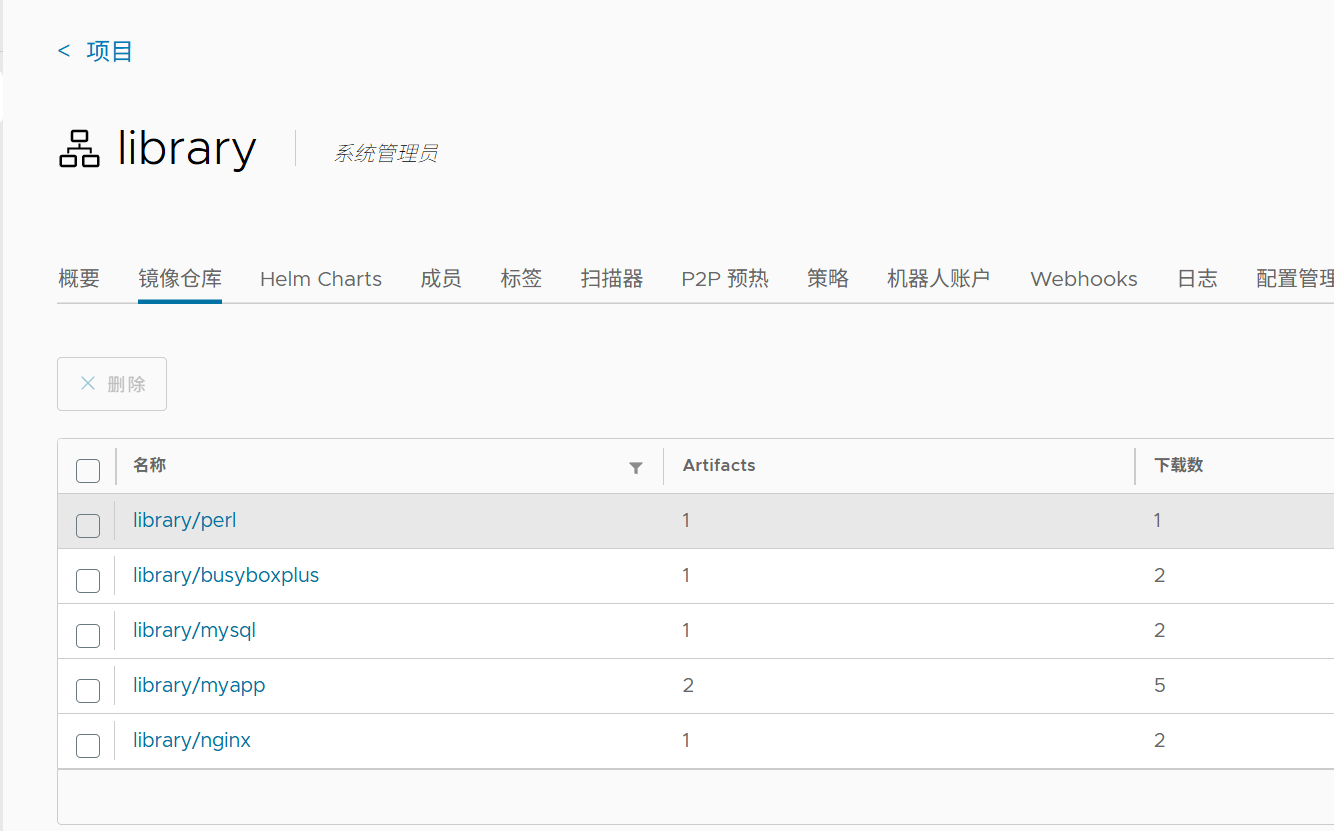
[root@master ctrl]# docker tag perl:5.34.0 rch.hjn.com/library/perl:5.34.0 ^C

# 推送到私有仓库(供K8s集群拉取)
[root@master ctrl]# docker push rch.hjn.com/library/perl:5.34.0
查看一下harbor仓库默认位置镜像
6.2 job示例
# 生成Job配置文件
[root@master ctrl]# kubectl create job job-example --image perl:5.34.0 --dry-run=client -o yaml > job.yml
# 编辑配置文件,添加任务参数
[root@master ctrl]# vim job.yml
# 配置文件内容
[root@master ctrl]# cat job.yml
apiVersion: batch/v1  # API版本(Job属于batch组)
kind: Job             # 资源类型是Job
metadata:
  name: job-example   # Job的名字
spec:
  completions: 8      # 总共有8个任务需要完成(最终成功8个Pod)
  parallelism: 2      # 每次并行运行2个Pod
  template:           # Pod模板
    metadata:
    spec:
      containers:
      - image: perl:5.34.0  # 用perl镜像
        name: job-example   # 容器名
        # 容器启动命令:计算π的2000位并打印
        command: ["perl",  "-Mbignum=bpi", "-wle", "print bpi(2000)"]
      restartPolicy: Never  # 任务失败后不重启(由Job控制重试)
  backoffLimit: 4     # 最多重试4次(4次失败后Job标记为失败)

# 创建Job
[root@master ctrl]# kubectl apply -f job.yml
job.batch/job-example created
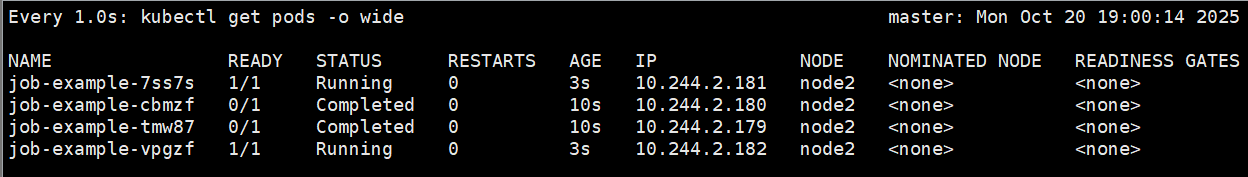
[root@master ctrl]# kubectl logs pods/job-example-46z9x
3.141592653589793238462643383279502884197169399375105820974944592307......省略
执行 kubectl apply -f job.yml 后:
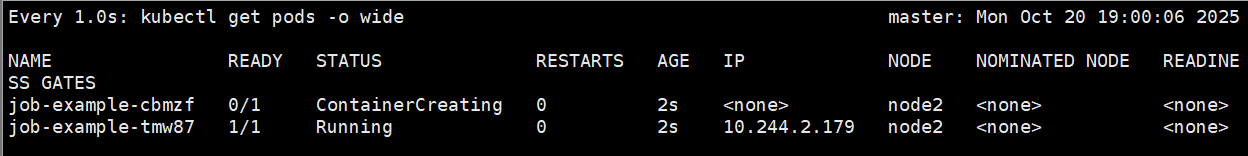
- K8s 会先创建 2 个 Pod(因为 parallelism=2),每个 Pod 都运行 “计算 π 的 2000 位” 的命令;
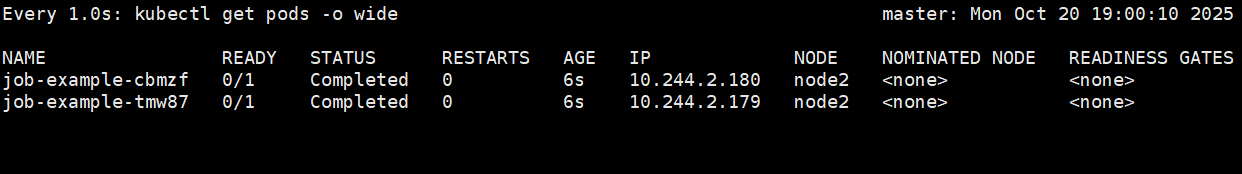
- 这 2 个 Pod 执行成功(状态变成
Completed)后,K8s 会再创建下一批 2 个 Pod; - 直到总共创建 8 个成功的 Pod(completions=6),Job 的状态会变成
Complete(任务完成); - 如果某个 Pod 失败(比如镜像拉取失败),K8s 会最多重试 4 次(backoffLimit=4),重试 4 次还失败,Job 就会标记为
Failed(任务失败)。
结果:
Job 通过completions定义总任务数(8 个),parallelism定义并行数(每次 2 个),实现了批量任务的有序执行。任务完成后,Pod 会保持Completed状态(不会自动删除),方便查看日志。如果任务失败,Job 会按backoffLimit重试,避免偶发错误导致任务终止。
总结:
Job 就是用来跑 “一次性任务” 的,比如数据计算、备份。核心是告诉它:总共要完成多少个任务(completions),一次能跑几个(parallelism),失败了最多重试几次(backoffLimit)。它会按这个规则一批批创建 Pod 执行任务,直到所有任务完成,之后就 “下班” 了,不会再创建新 Pod。
七 CronJob 控制器:“定时重复干活,到点就触发”
7.1 CronJob功能
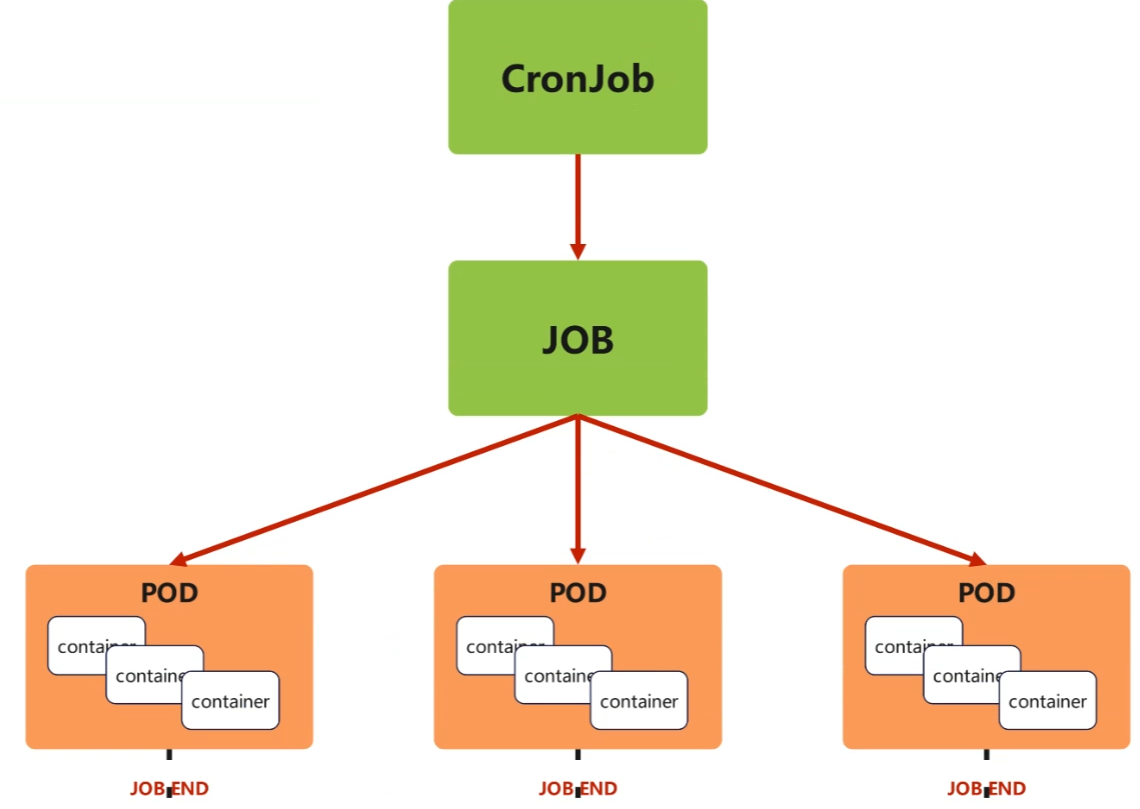
-
Cron Job 创建基于时间调度的 Jobs。
-
CronJob控制器以Job控制器资源为其管控对象,并借助它管理pod资源对象,
-
CronJob可以以类似于Linux操作系统的周期性任务作业计划的方式控制其运行时间点及重复运行的方式。
-
CronJob可以在特定的时间点(反复的)去运行job任务。
7.2 CronJob示例
# 生成CronJob配置文件(--schedule指定定时规则)
[root@master ctrl]# kubectl create cronjob cronjob-example --image busyboxplus --schedule "*/1 * * * *" --dry-run=client -o yaml > cronjob.yml
# 编辑配置文件,完善任务命令
[root@master ctrl]# vim cronjob.yml
# 配置文件内容
[root@master ctrl]# cat cronjob.yml
apiVersion: batch/v1  # API版本
kind: CronJob         # 资源类型是CronJob
metadata:
  name: cronjob-example  # CronJob的名字
spec:
  jobTemplate:         # 定义要定时执行的Job模板
    metadata:
      name: cronjob-example
    spec:
      template:
        metadata:
        spec:
          containers:
          - image: busyboxplus  # 用busyboxplus镜像(带shell工具)
            name: cronjob-example
            # 容器命令:打印当前时间和一句消息
            command:
            - /bin/sh
            - -c
            - date; echo Hello from the Kubernetes cluster
          restartPolicy: OnFailure  # 任务失败时重启容器
  schedule: '*/1 * * * *'  # 定时规则:每分钟执行一次(和Linux的crontab格式一样)

# 创建CronJob
[root@master ctrl]# kubectl apply -f cronjob.yml
cronjob.batch/cronjob-example created

# 查看CronJob状态(确认调度规则生效)
[root@master ctrl]# kubectl get cronjobs.batch cronjob-example
NAME              SCHEDULE      TIMEZONE   SUSPEND   ACTIVE   LAST SCHEDULE   AGE
cronjob-example   */1 * * * *   <none>     False     0        37s             73s

# 查看某个定时任务生成的Pod日志(确实每分钟打印一次时间和消息)
[root@master ctrl]# kubectl logs pods/cronjob-example-29349318-mmbhr
Mon Oct 20 11:18:00 UTC 2025
Hello from the Kubernetes cluster
结果:
CronJob 通过schedule: '*/1 * * * *'定义了 “每分钟执行一次” 的规则,每次执行时会根据jobTemplate创建一个 Job,再由 Job 创建 Pod 执行命令(打印时间和消息)。执行成功后,Pod 状态为Completed,CronJob 会继续按 schedule 定时触发新的 Job,实现周期性任务。
总结:
CronJob 就像手机闹钟,到点就触发任务。比如每天凌晨 3 点备份数据,就用它。核心是写对定时规则(和 Linux 的 crontab 一样),然后定义好每次要执行的 Job(比如跑个脚本)。它会按时创建 Job,Job 再创建 Pod 干活,完事儿后 Pod 保留,方便查日志。
更多推荐

 30
 0
- 0


 已为社区贡献5条内容

所有评论(0)