
机器学习(2) 无监督学习
·
简介
- 无监督学习的特点是在没有标签或者目标变量的数据集上进行学习,换句话说,只提供了特征 x x x,不提供标签 y y y。与监督学习不同,无监督学习不需要预先知道“正确答案”,而是通过算法自动发现数据中的隐藏模式、结构或规律
主要特征
- 无标签数据:只有输入数据,没有对应的输出标签
- 模式发现:自动识别数据中的潜在结构和关系
- 探索性分析:用于数据探索和理解数据分布
常见应用场景
- 聚类分析:将相似的数据点分组
- 降维:减少数据特征维度,保留主要信息
- 异常检测:识别数据中的异常值
- 关联规则挖掘:发现数据项之间的关联关系
下面是一个使用k-means算法计算聚类中心坐标的例子
import numpy as np
import matplotlib.pyplot as plt
from sklearn.cluster import KMeans
from sklearn.datasets import make_blobs

# 生成示例数据
# 创建3个聚类中心,每个聚类100个样本点
X, _ = make_blobs(n_samples=300, centers=3, cluster_std=1.0,
                  center_box=(-10.0, 10.0), random_state=42)

# 创建K-Means模型,设置聚类数为3
kmeans = KMeans(n_clusters=3, random_state=42, n_init=10)

# 训练模型并预测聚类标签
cluster_labels = kmeans.fit_predict(X)

# 获取聚类中心
cluster_centers = kmeans.cluster_centers_

# 可视化结果
plt.figure(figsize=(10, 6))

# 绘制数据点,不同颜色表示不同聚类
colors = ['red', 'blue', 'green']
for i in range(3):
    cluster_points = X[cluster_labels == i]
    plt.scatter(cluster_points[:, 0], cluster_points[:, 1],
               c=colors[i], label=f'聚类 {i+1}', alpha=0.7)

# 绘制聚类中心
plt.scatter(cluster_centers[:, 0], cluster_centers[:, 1],
           c='black', marker='x', s=200, linewidths=3, label='聚类中心')

plt.title('K-Means 聚类结果')
plt.xlabel('特征 1')
plt.ylabel('特征 2')
plt.legend()
plt.grid(True, alpha=0.3)
plt.show()

# 输出聚类信息
print(f"聚类中心坐标:")
for i, center in enumerate(cluster_centers):
    print(f"聚类 {i+1}: ({center[0]:.2f}, {center[1]:.2f})")

print(f"\n各聚类的样本数量:")
unique, counts = np.unique(cluster_labels, return_counts=True)
for cluster_id, count in zip(unique, counts):
    print(f"聚类 {cluster_id+1}: {count} 个样本")
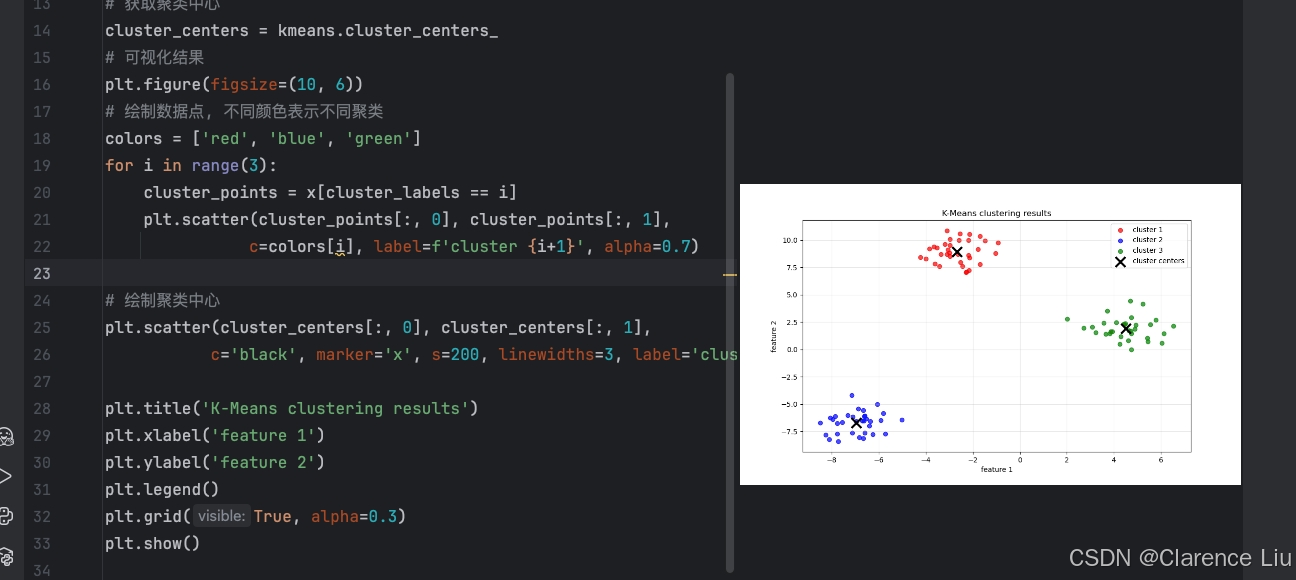
- 这个例子展示了无监督学习的核心思想,在没有预先标记的情况下,算法自动发现了数据中的三个自然分组,并确定了每个分组的中心位置
更多推荐

 5
 0
- 0


 已为社区贡献5条内容

所有评论(0)