
深度学习核心1.0之神经网络基础、激活函数、损失函数、数值微分、梯度下降法和简单神经网络的创建
深度学习的特点:
使用多层神经网络,能够自动提取数据的多层次特征。
适合处理非结构化数据,如图像、音频、文本等。
依赖大量数据和计算资源,训练时间较长。
模型复杂,通常被视为“黑箱”,解释性较差。
一、神经网络基础
1.1、神经网络构成
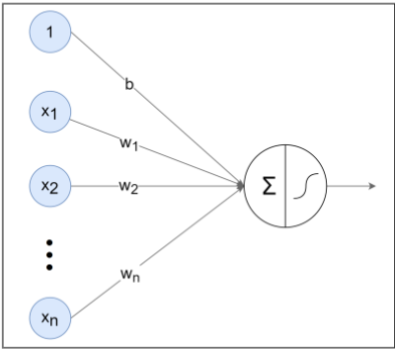
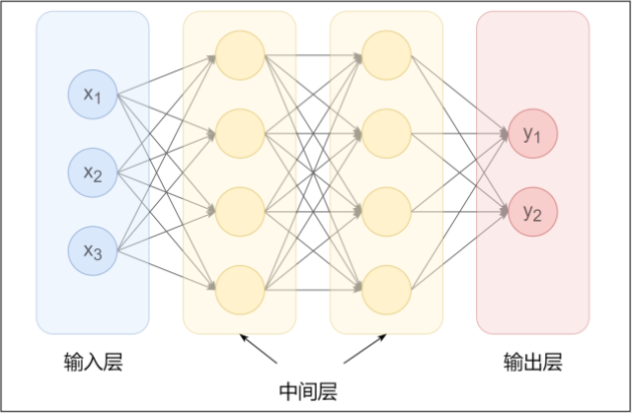
人工神经网络(Artificial Neural Network,ANN)简称神经网络(NN),是一种模仿生物神经网
络结构和功能的计算模型。
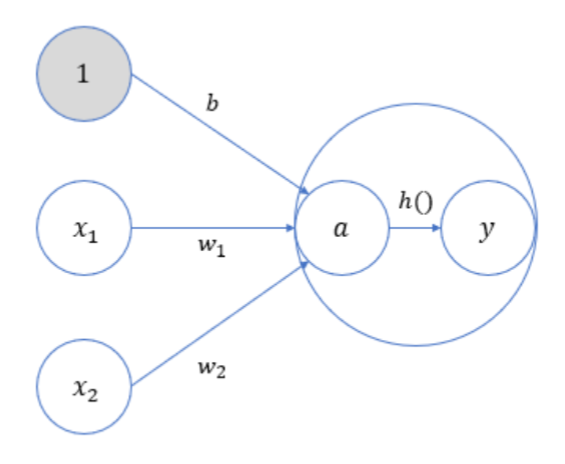
神经元中的信息逐层传递(一般称为 前向传播 forward),上一层神经元的输出作为下一层神经元
的输入,每个连接都会有一个权重。
1.2、激活函数
激活函数必须是非线性函数,也正是激活函数的存在为神经网络引入了非线性,使得神经网络能够
学习和表示复杂的非线性关系。
1.2.1、阶跃函数Binary Step
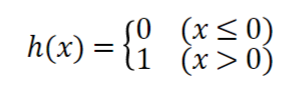
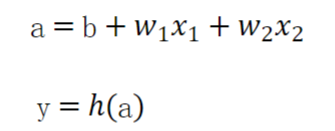
阶跃函数的导数恒为0
# 激活函数

# 阶跃函数
def step_function0(x):
    if x > 0:
        return 1
    else:
        return 0

import numpy as np

def step_function(x):
    return np.array(x > 0 , dtype = int)

if __name__ == '__main__':
    x = np.array([0, 1, 2, 3, 4, 5, -1, -2, -3, -4, -5])
    x1 = np.array([[1,2,3],[-1,-2,-3]])
    print(step_function(x))
    print(step_function(x1))

[0 1 1 1 1 1 0 0 0 0 0]
[[1 1 1]
 [0 0 0]]
1.2.2、Sigmoid函数
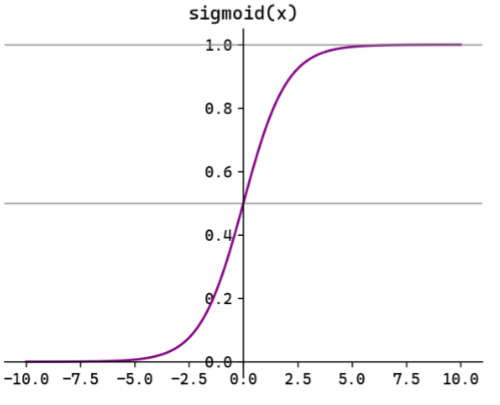
Sigmoid(也叫 Logistic 函数)是平滑的、可微的,能将任意输入映射到区间(0,1)。常用于二分类
的输出层。但因其涉及指数运算,计算量相对较高。
Sigmoid 的输入在[-6,6]之外时,其输出值变化很小,可能导致信息丢失。
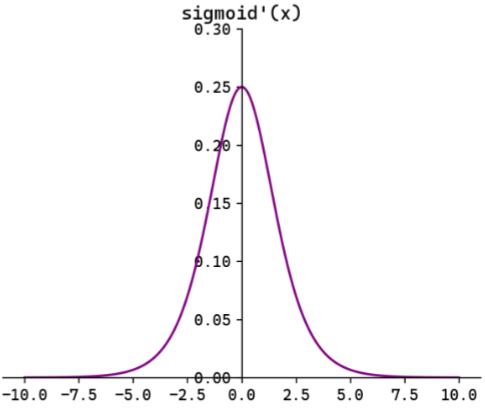
Sigmoid 的导数范围为(0,0.25),梯度较小。当输入在[-6,6]之外时,导数接近0,此时网络参数的
更新将会极其缓慢。使用Sigmoid作为激活函数,可能出现梯度消失,在逐层反向传播时,梯度
会呈指数级衰减。
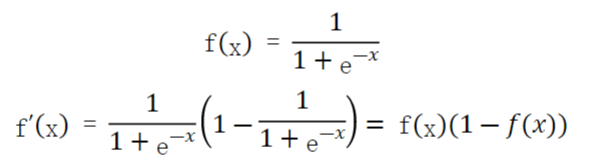
import numpy as np
def sigmoid(x):
    return 1 / (1 + np.exp(-x))
x = np.array([0, 1, 2, 3, 4, 5, -1, -2, -3, -4, -5])
print(sigmoid(x))

[0.5        0.73105858 0.88079708 0.95257413 0.98201379 0.99330715
 0.26894142 0.11920292 0.04742587 0.01798621 0.00669285]
1.2.3、Tanh双曲正切函数
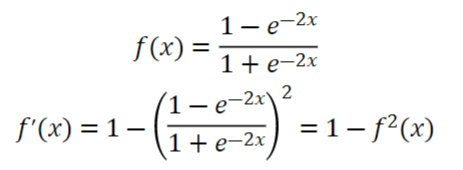
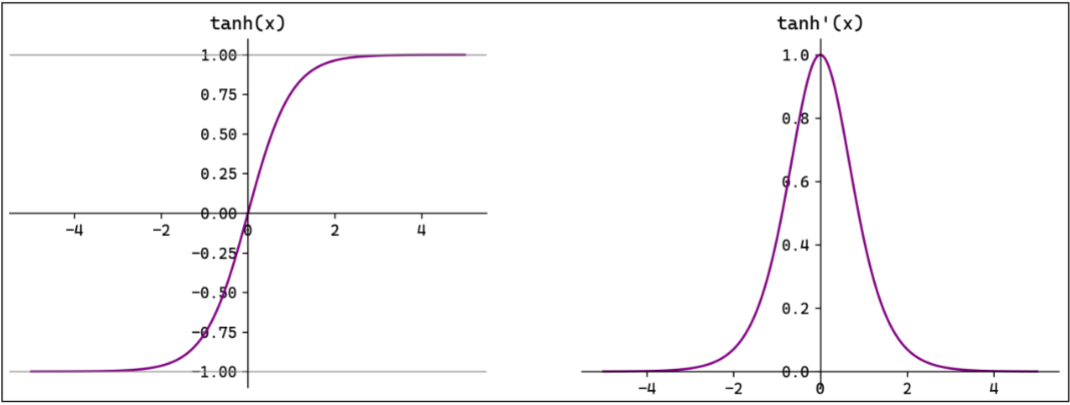
Tanh(双曲正切)将输入映射到区间(-1,1)。其关于原点中心对称。常用在隐藏层。输入在[-3,3]之
外时,Tanh的输出值变化很小,此时其导数接近0。Tanh的输出以0为中心,且其梯度相较于
Sigmoid 更大,收敛速度相对更快。但同样也存在梯度消失现象。
import numpy as np
x = np.array([0, 1, 2, 3, 4, 5, -1, -2, -3, -4, -5])
print(np.tanh(x))

[ 0.          0.76159416  0.96402758  0.99505475  0.9993293   0.9999092
 -0.76159416 -0.96402758 -0.99505475 -0.9993293  -0.9999092 ]
1.2.4、ReLU函数Rectified Linear Unit,修正线性单元
ReLU(Rectified Linear Unit,修正线性单元)会将小于0的输入转换为0,大于等于0的输入保持
不变。ReLU 作为激活函数不存在梯度消失。当输入小于0时,ReLU 的输出为0,这意味着在神
经网络中,ReLU激活的节点只有部分是“活跃”的,这种稀疏性有助于减少计算量提高模型效率。
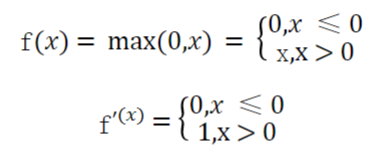
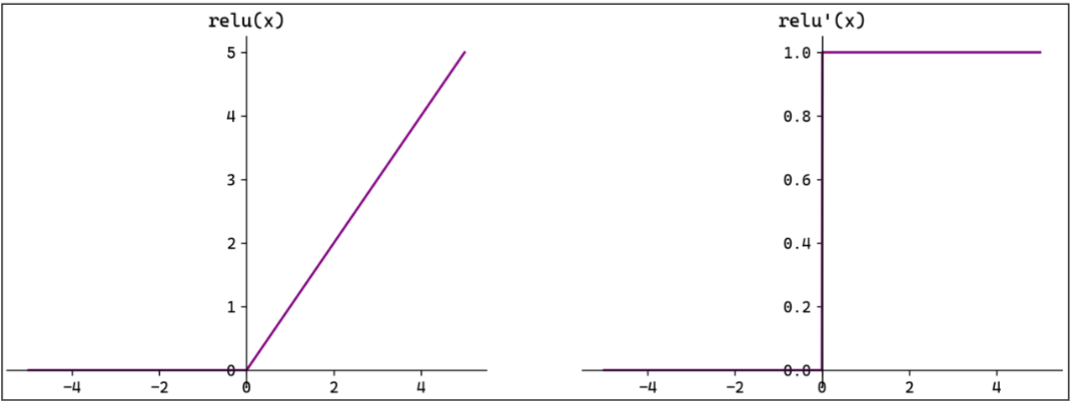
ReLU的输出始终为0。这意味着神经元可能永远不会被激活,从而导致“神经元死亡”问题。这会影
响模型的学习能力,特别是如果大量的神经元都变成了“死神经元”。为解决此问题,可使用Leaky
ReLU来代替ReLU作为激活函数。
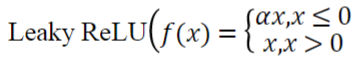
import numpy as np
# relu
def relu(x):
    return np.maximum(0, x)
x = np.array([0, 1, 2, 3, 4, 5, -1, -2, -3, -4, -5])
print(relu(x))

[0 1 2 3 4 5 0 0 0 0 0]
1.2.5、softmax函数
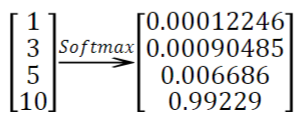
Softmax 的分母是指数之和,是为了保证输出是一个平滑、可微、非负且总和为1的概率分布,同
时放大不同类别之间的差异。
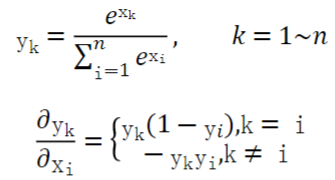
import numpy as np
def softmax(x):
    return np.exp(x) / np.sum(np.exp(x))
x = np.array([0, 1, 2, 3, 4, 5, -1, -2, -3, -4, -5])
print(softmax(x))

[4.25926596e-03 1.15778853e-02 3.14719551e-02 8.55496437e-02
 2.32548042e-01 6.32131116e-01 1.56689638e-03 5.76428965e-04
 2.12056366e-04 7.80111772e-05 2.86987083e-05]
# 数据溢出的对策
def softmax(x):
x = x - np.max(x)
return np.exp(x) / np.sum(np.exp(x))
这个是为了防止数据溢出,如果x里的数据很大,再指数一下很容易就溢出了
# 考虑二维矩阵的输入
def softmax(x):
    if x.ndim == 2:
        x = x.T
        x = x - np.max(x,axis = 0)
        y = np.exp(x) / np.sum(np.exp(x),axis = 0)
        return y.T
    x = x - np.max(x)
    return np.exp(x) / np.sum(np.exp(x))
这个是考虑二维矩阵输入
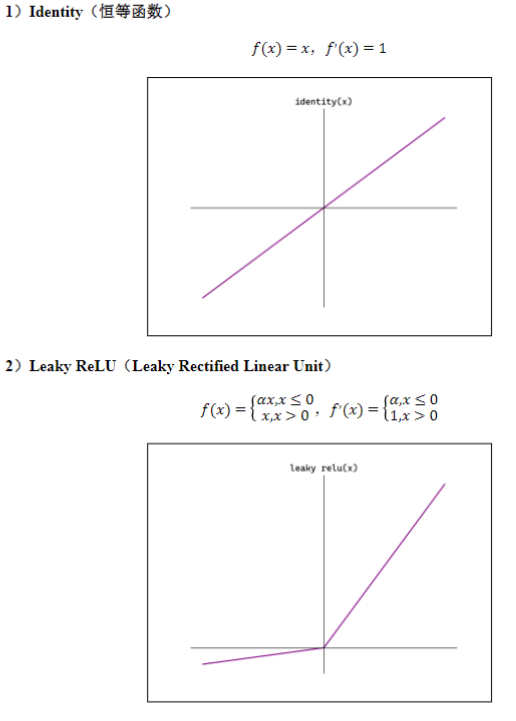
1.2.6、其他常见激活函数
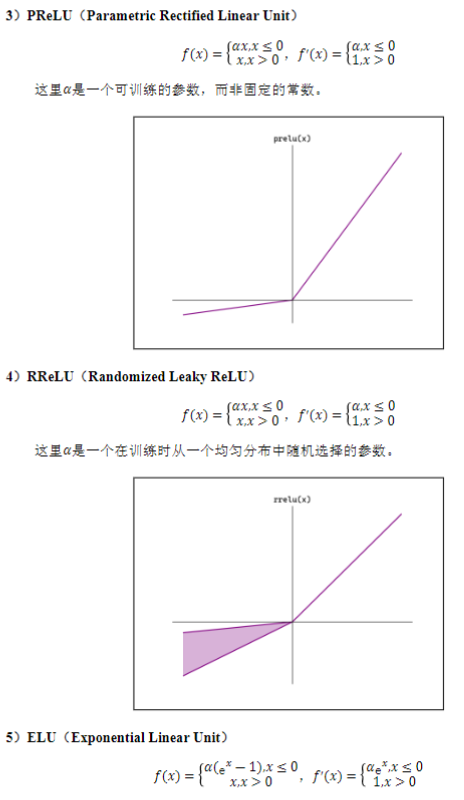
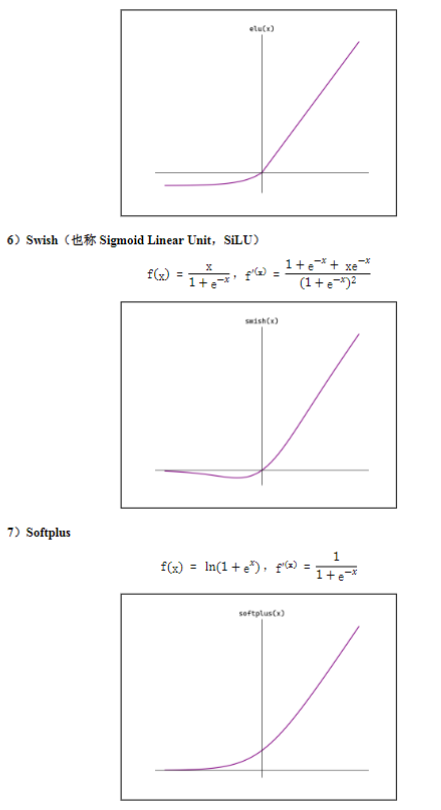
1.2.7 如何选择激活函数
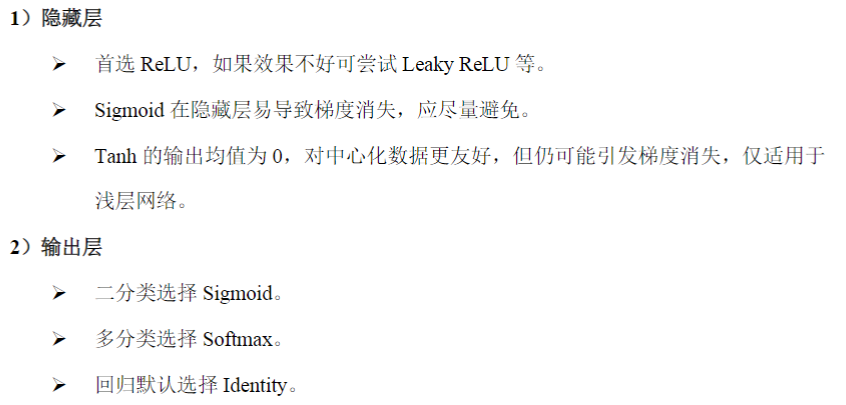
1.3、神经网络的简单实现
深度神经网络由多个层(layer)组成,通常将其称之为 模型(Model)。整个模型接受原始输入
(特征),生成输出(预测),并包含一些参数。而在模型内部,每个单独的层都会接受一些输
入(由前一层提供),生成输出(到下一层的输入),并包含一组参数;层层向下传递,就可以得
到最终的输出值。
神经网络中的参数,就是每一层的权重和偏置。
1.3.1、三层神经网络
我们这里以一个三层神经网络为例,实现从输入到输出的处理计算,这个过程就是前向传播
(forward)
权重矩阵大小应该是输入神经元个数 × 输出神经元个数
偏置向量大小是(输出神经元个数,)
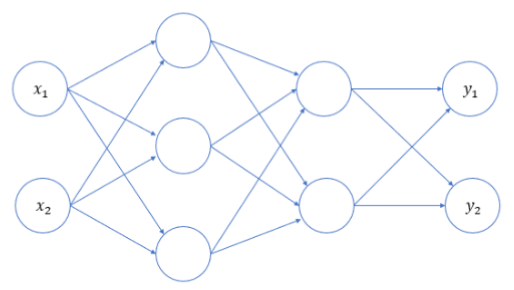
我们可以将神经网络的所有参数(每一层的权重w和偏置b),保存在一个字典network中,并定
义函数:
init_network():对参数进行初始化,每一个权重参数都是一个矩阵(二维),每一个偏置参数则是
一个数组(一维)
forward():前向传播,将输入信号转换为输出信号的处理操作。这里的激活函数,隐藏层用
sigmoid,输出层用 identity(恒等函数)。
import numpy as np
from common.functions import sigmoid,identity

# 初始化网络
def init_network():
    network = {}
    # 第一层参数
    network['W1'] = np.array([[0.1,0.3,0.5],[0.2,0.4,0.6]])
    network['b1'] = np.array([0.1,0.2,0.3])
    # 第二层参数
    network['W2'] = np.array([[0.1,0.4],[0.2,0.5],[0.3,0.6]])
    network['b2'] = np.array([0.1,0.2])
    # 第三层参数
    network['W3'] = np.array([[0.1,0.3],[0.2,0.4]])
    network['b3'] = np.array([0.1,0.2])
    return network
# 前向传播
def forward(network,X):
    w1,w2,w3 = network['W1'],network['W2'],network['W3']
    b1,b2,b3 = network['b1'],network['b2'],network['b3']
    a1 = X @ w1 + b1
    z1 = sigmoid(a1)
    a2 = z1 @ w2 + b2
    z2 = sigmoid(a2)
    a3 = z2 @ w3 + b3
    y = identity(a3)
    return y
# 主流程
x = np.array([1.0,0.5])
network = init_network()
y = forward(network,x)
print(y)

[0.31682708 0.69627909]
1.4、手写数字识别案例
数据集https://www.kaggle.com/competitions/digit-recognizer
这里,我们构建的也是一个三层神经网络,输入层应该有784个神经元,输出层有10个神经元(表
示0~9的分类结果);中间设置2个隐藏层,第一个隐藏层有50个神经元,第二个隐藏层有100个神
经元。这里的参数是需要学习得到的;我们假设已经学习完毕,直接从保存好的文件nn_sample中
进行读取即可。
import numpy as np
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import MinMaxScaler
import joblib
from common.functions import *

def get_data():
    data = pd.read_csv('../data/train.csv')
    X = data.drop(columns = 'label',axis = 1)
    y = data['label']
    x_train, x_test, y_train, y_test = train_test_split(X, y, test_size = 0.3, random_state = 42)
    scaler = MinMaxScaler()
    x_train = scaler.fit_transform(x_train)
    x_test = scaler.transform(x_test)
    return  x_test, y_test

def init_network():
    # 从文件中加载已经训练好的模型
    network = joblib.load('../data/nn_sample')
    return network

def forward(network,X):
    w1,w2,w3 = network['W1'],network['W2'],network['W3']
    b1,b2,b3 = network['b1'],network['b2'],network['b3']
    a1 = X @ w1 + b1
    z1 = sigmoid(a1)
    a2 = z1 @ w2 + b2
    z2 = sigmoid(a2)
    a3 = z2 @ w3 + b3
    y = softmax(a3)
    return y

x_test, y_test = get_data()
network = init_network()
y_proba = forward(network,x_test)
y_pred = np.argmax(y_proba, axis = 1) # 这里因为x是有很多样本,所以y_proba是每个样本自己的预测概率
# 计算准确率
acc_cnt = np.sum(y_pred == y_test)
n = x_test.shape[0]
print(f'Accuracy:',acc_cnt / n)

Accuracy: 0.9362698412698413
这上面X的shape是(12600,784),这样计算量太大,意思就是一直有12600个样本在处理,我们分批量测试,一次处理100个
import numpy as np
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import MinMaxScaler
import joblib
from common.functions import *

def get_data():
    data = pd.read_csv('../data/train.csv')
    X = data.drop(columns = 'label',axis = 1)
    y = data['label']
    x_train, x_test, y_train, y_test = train_test_split(X, y, test_size = 0.3, random_state = 42)
    scaler = MinMaxScaler()
    x_train = scaler.fit_transform(x_train)
    x_test = scaler.transform(x_test)
    return  x_test, y_test

def init_network():
    # 从文件中加载已经训练好的模型
    network = joblib.load('../data/nn_sample')
    return network

def forward(network,X):
    w1,w2,w3 = network['W1'],network['W2'],network['W3']
    b1,b2,b3 = network['b1'],network['b2'],network['b3']
    a1 = X @ w1 + b1
    z1 = sigmoid(a1)
    a2 = z1 @ w2 + b2
    z2 = sigmoid(a2)
    a3 = z2 @ w3 + b3
    y = softmax(a3)
    return y

x_test, y_test = get_data()
network = init_network()

# 定义一些变量
batch_size = 100
n = x_test.shape[0]
acc_cnt = 0
# 循环迭代,分批预测,前向传播
for i in range(0,n,batch_size):
    # 取出当前批次
    x_batch = x_test[i:i+batch_size]
    y_batch = y_test[i:i+batch_size]
    y_proba = forward(network,x_batch)
    y_pred = np.argmax(y_proba, axis = 1)
    # 累计预测正确个数
    acc_cnt += np.sum(y_pred == y_batch)
print(f'Accuracy:', acc_cnt / n)

Accuracy: 0.9362698412698413
1.5、损失函数
神经网络中,需要以某个指标为线索来寻找最优权重参数;这个指标就是损失函数(loss
function)
1.5.1、均方误差MSE
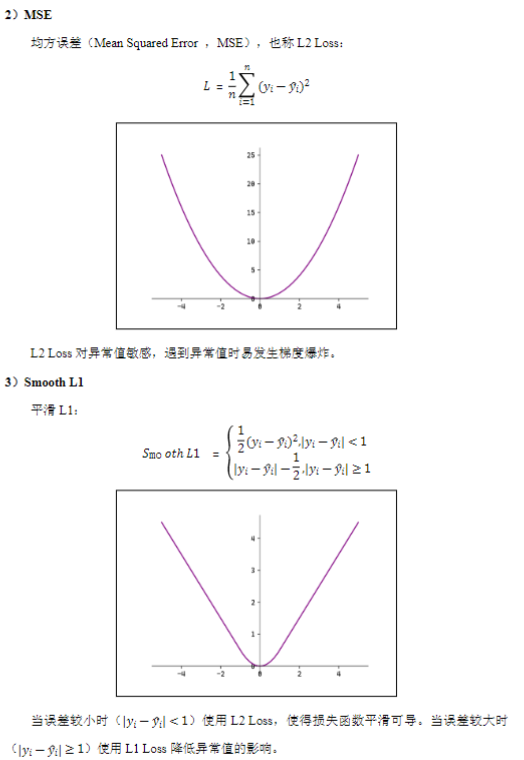
均方误差(Mean Squared Error ,MSE),也称 L2 Loss,L2 Loss 对异常值敏感,遇到异常值时易发生梯度爆炸。
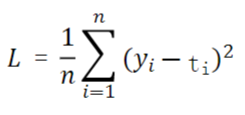
n是数据的“维度”。对于固定维度的网络,前面的系数n不重要,因此公式有时也可以写成这样,因
为求导之后把2约掉,这样会比较简洁
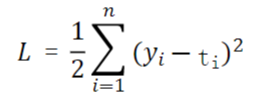
def mean_squared_error(y,t):
    return 0.5 * np.sum((y - t)**2)
1.5.2、交叉熵误差
交叉熵误差(Cross Entropy Error)也经常被用作损失函数
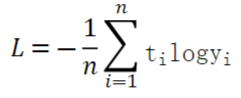
第一个if是转成二维方便后续处理,第二个if是判断是否是独热编码,如果是要转换成索引形式,
argmax是np里一个取最大值索引的方法
# 交叉熵误差
def cross_entropy_error(y,t):
    if y.ndim == 1:
        t = t.reshape(1,-1)
        y = y.reshape(1,-1)
    if t.size == y.size:
        t = np.argmax(t,axis = 1)
    n = y.shape[0]
    return -np.sum(np.log(y[np.arange(n),t] + 1e-7)) / n
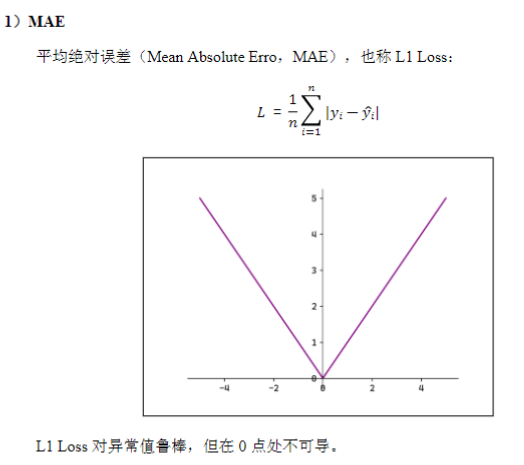
1.5.3、拓展
1.6、数值微分
损失函数的值越小,代表我们选取的参数越适合;想要求得损失函数的最小值,最基本的想法就是
对函数求导,解出导数值为0的点,并判断它是否为极小值/最小值。然而,实际的函数直接求导不
容易得到解析解。这时可以用数值微分的方式来求某点处的导数,这在工程上应用非常广泛。
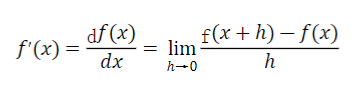 这个是前向差分
以下代码是中心差分,这个更精确,因为它用到了两边的点(x+h 和 x−h),误差项会相互抵消。
# 数值微分
def numerical_diff(f,x):
    h = 1e-4
    return (f(x+h) - f(x-h))/(2 * h)
1.6.1、tangentline案例
import numpy as np
import matplotlib.pyplot as plt
from common.gradient import numerical_diff

def f(x):
    return 0.01 * x ** 2 + 0.1 * x

def tangent_line(f,x0):
    # 利用数值微分计算当前点的导数值
    a = numerical_diff(f, x0)
    b = f(x0) - a * x0
    return lambda x: a * x + b

x0 = 5.0
tf = tangent_line(f, x0)

x = np.arange(0.0,20.0,0.1)
y1 = f(x)
y2 = tf(x)
plt.plot(x,y1)
plt.plot(x,y2)
plt.show()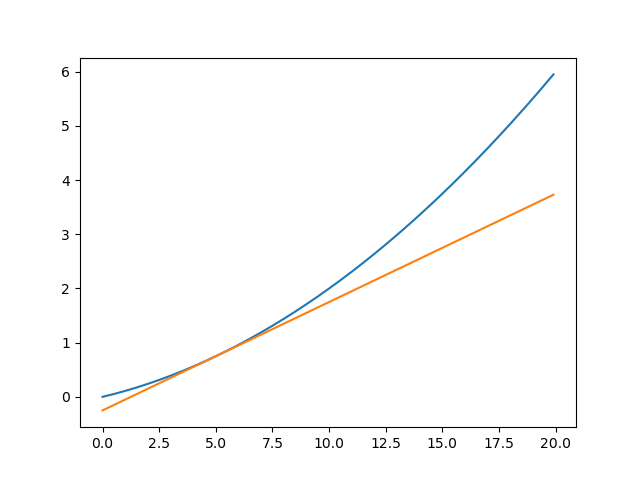
1.6.2、利用中心差分计算梯度
x为向量,i就是在那个索引的位置
下面的enumerate意思是i是索引号,x是向量
# 利用数值微分计算梯度,x为向量
def _numerical_gradient(f,x):
    h = 1e-4
    grad = np.zeros_like(x)
    for i in range(x.size):
        tmp = x[i]
        x[i] = tmp + h
        fxh1 = f(x)
        x[i] = tmp - h
        fxh2 = f(x)
        grad[i] = (fxh1 - fxh2)/(2*h)
        x[i] = tmp
    return grad

def numerical_gradient(f,X):
    if X.ndim == 1:
        return _numerical_gradient(f,X)
    else:
        grad = np.zeros_like(X)
        for i,x in enumerate(X):
            grad[i] = _numerical_gradient(f,x)
        return grad
1.6.3、神经网络的梯度计算
在神经网络的学习中,梯度的计算非常重要。神经网络中的梯度,指的就是损失函数关于权重参数
的梯度。
import numpy as np
from common.functions import *
from common.gradient import numerical_gradient

class SimpleNet:
    def __init__(self):
        self.W = np.random.randn(2,3)
        self.b = np.zeros(3)
    def forward(self,X):
        a = X @ self.W + self.b
        y = softmax(a)
        return y
    def loss(self, x, t):
        y = self.forward(x)
        loss_value = cross_entropy_error(y, t)
        return loss_value

if __name__ == '__main__':
    x = np.array([0.6,0.9])
    t = np.array([0,0,1])
    net = SimpleNet()
    loss_f = lambda w : net.loss(x,t)
    grad_w = numerical_gradient(loss_f,net.W)
    print(grad_w)


[[ 0.04865014  0.28398957 -0.33263971]
 [ 0.07297521  0.42598435 -0.49895956]]
1.7、梯度下降法
沿着目标函数(如损失函数)的负梯度方向逐步调整参数,从而逼近函数的最小值。
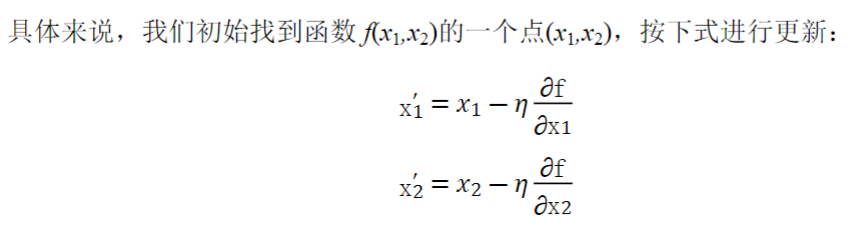
def gradient_descent(f,init_x,lr=0.01,step_num=100):
    x = init_x
    x_history = []
    for i in range(step_num):
        x_history.append(x.copy())
        grad = numerical_gradient(f,x)
        x -= lr * grad
    return x,np.array(x_history)
.copy() 是为了保留每次更新前的真实轨迹。
1.7.1、求最小值案例
目标函数:f(x1,x2) = x1 ** 2 + x2 ** 2
import numpy as np
import matplotlib.pyplot as plt
from common.gradient import  gradient_descent

# 目标函数:f(x1,x2) = x1 ** 2 + x2 ** 2
def f(x):
    return x[0] ** 2 + x[1] ** 2

init_x = np.array([-3.0,4.0])

lr = 0.1
num_iters = 20

x,x_history = gradient_descent(f,init_x,lr,num_iters)
print(x)
print(x_history)

plt.scatter(x_history[:,0],x_history[:,1])
plt.plot([-5,5],[0,0],'--b')
plt.plot([0,0],[-5,5],'--b')
plt.xlabel('x1')
plt.ylabel('x2')
plt.show()

[-0.03458765  0.04611686]
[[-3.          4.        ]
 [-2.4         3.2       ]
 [-1.92        2.56      ]
 [-1.536       2.048     ]
 [-1.2288      1.6384    ]
 [-0.98304     1.31072   ]
 [-0.786432    1.048576  ]
 [-0.6291456   0.8388608 ]
 [-0.50331648  0.67108864]
 [-0.40265318  0.53687091]
 [-0.32212255  0.42949673]
 [-0.25769804  0.34359738]
 [-0.20615843  0.27487791]
 [-0.16492674  0.21990233]
 [-0.1319414   0.17592186]
 [-0.10555312  0.14073749]
 [-0.08444249  0.11258999]
 [-0.06755399  0.09007199]
 [-0.0540432   0.07205759]
 [-0.04323456  0.05764608]]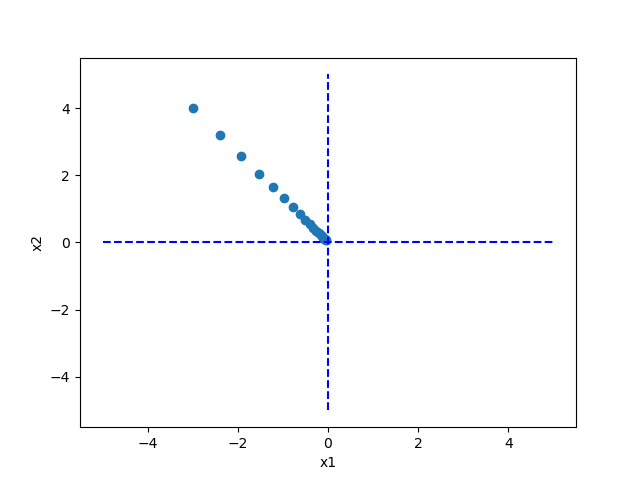
1.8、模型训练相关概念
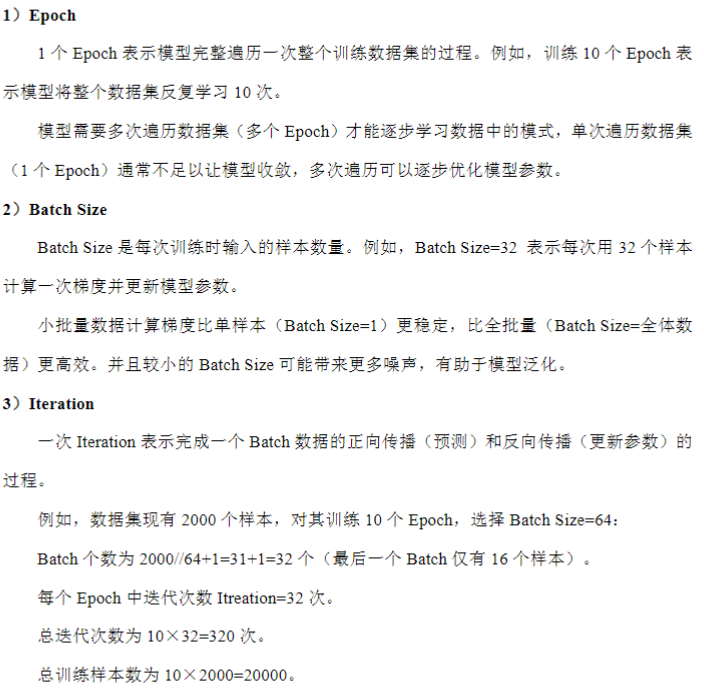
一个epoch是对应整个数据集n,一个iter是对应一个batch
1.9、SDG
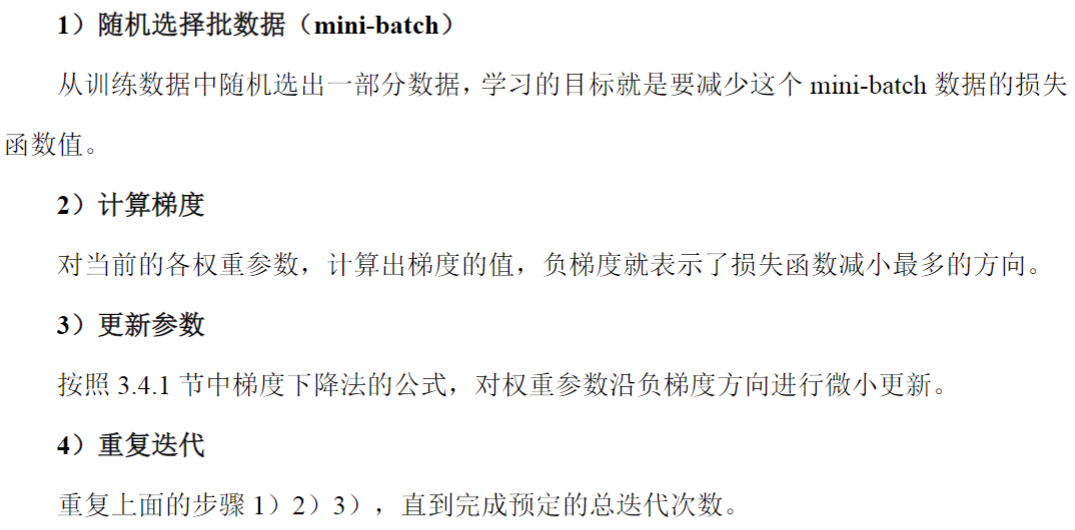
实际操作时,一般会从训练数据中随机选择一个小批量数据(mini-batch),然后用梯度下降法迭
代多个轮次(iteration);这种“对随机选择的数据进行的梯度下降法”,被称作 随机梯度下降法
(stochastic gradient descent,SGD)。
2.0、两层神经网络类
lambda的意思就是给我一个参数 (比如 W1、W2、b1 或 b2),我就把它代入当前网络中计算loss(x,t)
import numpy as np
from common.functions import  *
from common.gradient import numerical_gradient
class TwoLayerNet():
    def __init__(self, input_size, hidden_size, output_size,weight_init_std=0.01):
        self.params = {}
        self.params['W1'] = np.random.randn(input_size, hidden_size) * weight_init_std
        self.params['b1'] = np.zeros(hidden_size)
        self.params['W2'] = np.random.randn(hidden_size, output_size) * weight_init_std
        self.params['b2'] = np.zeros(output_size)
    def forward(self, X):
        W1,W2 = self.params['W1'], self.params['W2']
        b1,b2 = self.params['b1'], self.params['b2']
        a1 = X @ W1 + b1
        z1 = sigmoid(a1)
        a2 = z1 @ W2 + b2
        y = softmax(a2)
        return y
    def loss(self,x,t):
        y = self.forward(x)
        return cross_entropy_error(y,t)
    def accuracy(self,x,t):
        y_proba = self.forward(x)
        y_pred = np.argmax(y_proba, axis=1)
        acc = np.sum(y_pred == t) / x.shape[0]
        return acc
    def numerical_gradient(self, x, t):
        loss_f = lambda _: self.loss(x,t)
        grads = {}
        grads['W1'] = numerical_gradient(loss_f,self.params['W1'])
        grads['b1'] = numerical_gradient(loss_f,self.params['b1'])
        grads['W2'] = numerical_gradient(loss_f,self.params['W2'])
        grads['b2'] = numerical_gradient(loss_f,self.params['b2'])
        return grads
加入数据加载之后的模型训练和验证,完整版,这个代码可以运行,但是运行速度太慢了,主要慢在
grads = network.numerical_gradient(x_batch, t_batch)
这里,每次计算梯度都要调底层的数值计算梯度下降方法
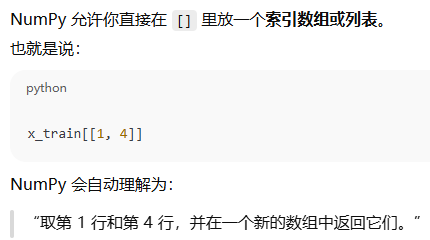
batch_index = np.random.choice(n,batch_size)这句话的意思是从n个里面随机选取一个batch_size
这下面的代码,可以用以下解释
batch_index = np.random.choice(n,batch_size)
x_batch = x_train[batch_index]
t_batch = t_train[batch_index]
import numpy as np
import matplotlib.pyplot as plt
from two_layer_net import TwoLayerNet
from common.load_data import get_data

x_train, t_train, x_test, t_test = get_data()
print(x_train.shape,x_test.shape,t_train.shape,t_test.shape)

network = TwoLayerNet(input_size=784, hidden_size=50, output_size=10)

lr = 0.1
batch_size = 100
num_epochs = 10

n = x_train.shape[0]
iters_per_epoch = np.ceil(n / batch_size) # 每个epoch里的迭代次数
iters_num = int(iters_per_epoch * num_epochs)

train_loss_list = []
train_acc_list = []
test_acc_list = []

for i in range(iters_num):
    batch_index = np.random.choice(n,batch_size)
    x_batch = x_train[batch_index]
    t_batch = t_train[batch_index]
    grads = network.numerical_gradient(x_batch, t_batch)
    for key in network.params.keys():
        network.params[key] -= lr * grads[key]

    this_loss = network.loss(x_batch, t_batch)
    train_loss_list.append(this_loss)
    print('Loss:{}'.format(this_loss))
    if i % iters_per_epoch == 0:
        train_acc = network.accuracy(x_train, t_train)
        test_acc = network.loss(x_test, t_test)
        train_acc_list.append(train_acc)
        test_acc_list.append(test_acc)
        print(f'train_acc:{train_acc}, test_acc:{test_acc}')
更多推荐


 15
 0
- 0


 已为社区贡献9条内容

所有评论(0)