
人工智能通识与实践 - 深度学习概述
深度学习概述
1. 神经网络:模拟大脑的“智能网络”
要理解深度学习,首先得搞懂它的“基础单元” - 神经网络。简单说,神经网络是一种模仿人类大脑工作方式的数学模型,就像把大脑里的神经细胞(神经元)连接起来,形成一个能处理信息的“小网络”。
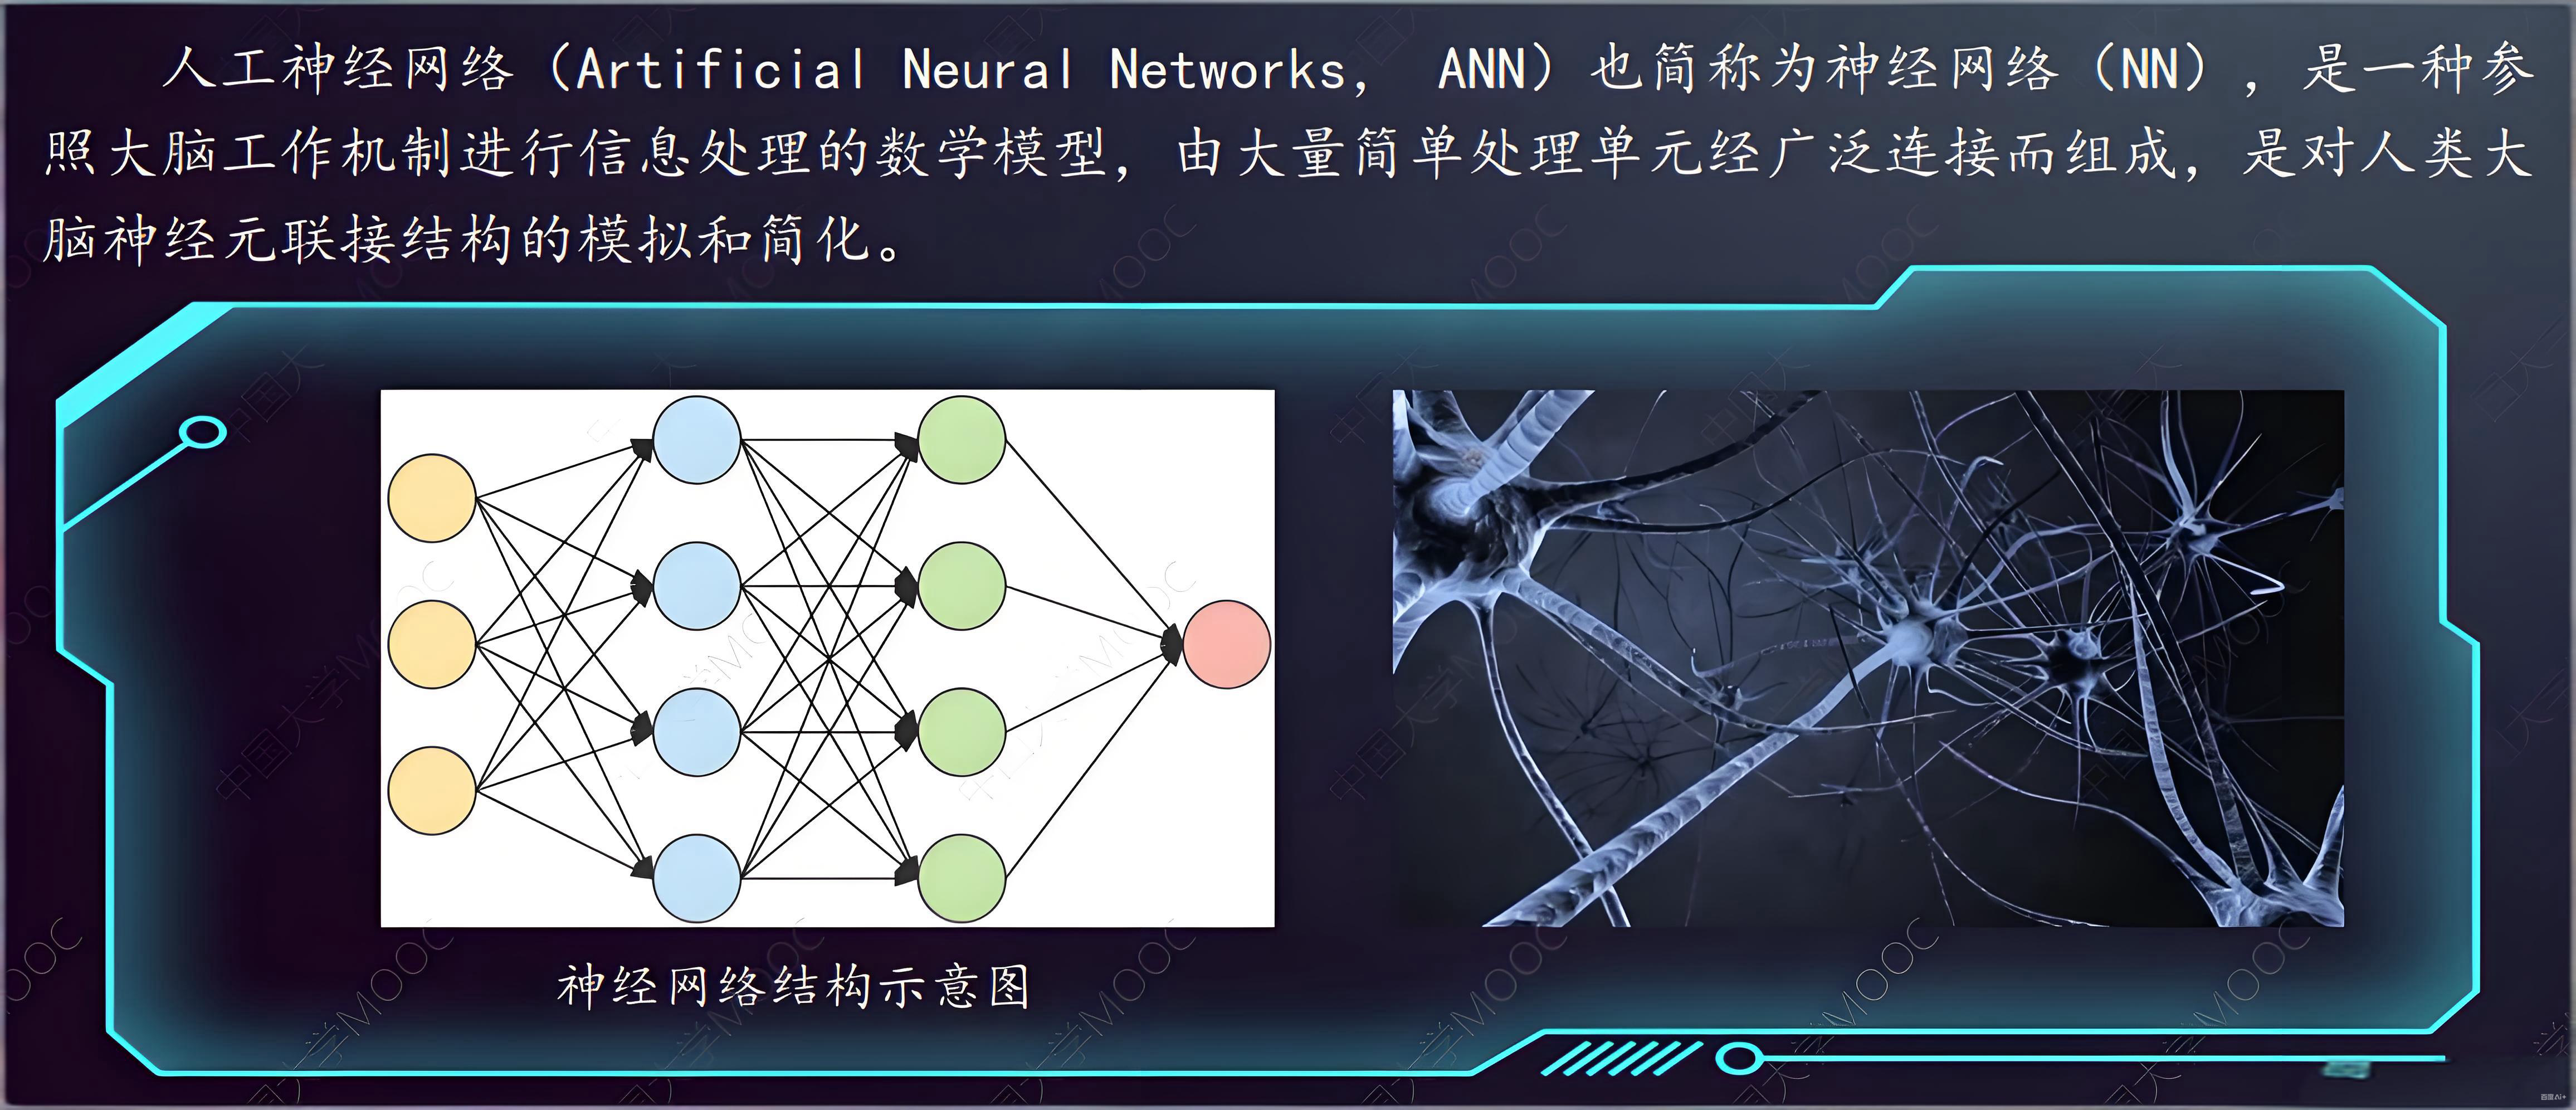
1.1 神经网络的“灵感来源”:大脑神经元
我们先从生物神经元说起。1904年,生物学家发现,人类大脑里的神经元长得很特别,它有三个关键部分:
- 树突:像“接收天线”,负责从外界或其他神经元那里接收信号(比如我们看到的图像、听到的声音,都会变成信号传给树突);
- 轴突:像“信号电线”,把神经元处理后的信号传出去;
- 突触:是两个神经元之间的“连接点”,就像电线的“接口”——一个神经元的轴突通过突触,把信号传给下一个神经元的树突。
后来,科学家就模仿这种结构,造出了“人工神经元”——神经网络的基本单元。
1.2 神经网络的核心:人工神经元怎么工作?
一个人工神经元的工作过程,其实和生物神经元很像,简单分成三步:
- 接收输入:就像树突接收信号,人工神经元会接收多个“原始信息”,比如处理图片时,每个输入可能是图片里一个像素的亮度;
- 加权处理:不是所有输入都一样重要——比如看一张猫的图片,“耳朵形状”的信号比“背景颜色”的信号更关键。所以每个输入会被乘以一个“权重”(可以理解为“重要程度”),重要的输入权重高,不重要的权重低;
- 加偏置、过激活函数:加权后的信号会加一个“偏置”(相当于“调整值”,避免信号太极端),然后传给“激活函数”。激活函数的作用很关键——它会给信号“加一道过滤”,决定这个神经元要不要“激活”(比如信号够强就输出,不够强就“沉默”)。
如果没有激活函数,神经元只能处理简单的“线性关系”(比如“输入越大,输出越大”),根本学不会复杂的任务(比如分辨猫和狗)。有了激活函数,神经网络才能处理复杂的信息,比如图像、语言这些非线性的问题。
1.3 神经网络的“成长史”:从简单到复杂
神经网络不是一下子就变成现在这样的,它的发展经历了多个重要节点:
- 1943年:心理学家麦卡洛克和数学家皮茨,第一次提出了“神经元数学模型”(叫M-P模型),这是神经网络的“雏形”;
- 1982年:约翰·霍普菲尔德提出“霍普菲尔德神经网络”,它能像人脑一样“记住”信息,比如记住一张图片的轮廓;
- 1986年:鲁梅尔哈特等人提出“反向传播算法”(简称BP算法),这个算法解决了神经网络“怎么学”的问题——让网络能从错误中调整自己的“权重”,越学越准;
- 1989年:Yann LeCun(后来的“卷积神经网络之父”)构建了“LeNet”,第一次把神经网络用在“看图片”(计算机视觉)上;
- 1998年:LeCun又完善出“LeNet-5”,这个模型能识别手写数字,比如银行的手写支票识别,就是靠它打下的基础;
- 2012年以后:“AlexNet”“VGGNet”“ResNet”等模型陆续出现,这些模型在图像竞赛中一次次夺冠,让神经网络在“看图”领域彻底站稳了脚跟。
2. 深度学习:让神经网络“更聪明”的技术
很多人会把“神经网络”和“深度学习”搞混,其实深度学习是神经网络的“升级版”——简单说,深度学习就是“更深”的神经网络。
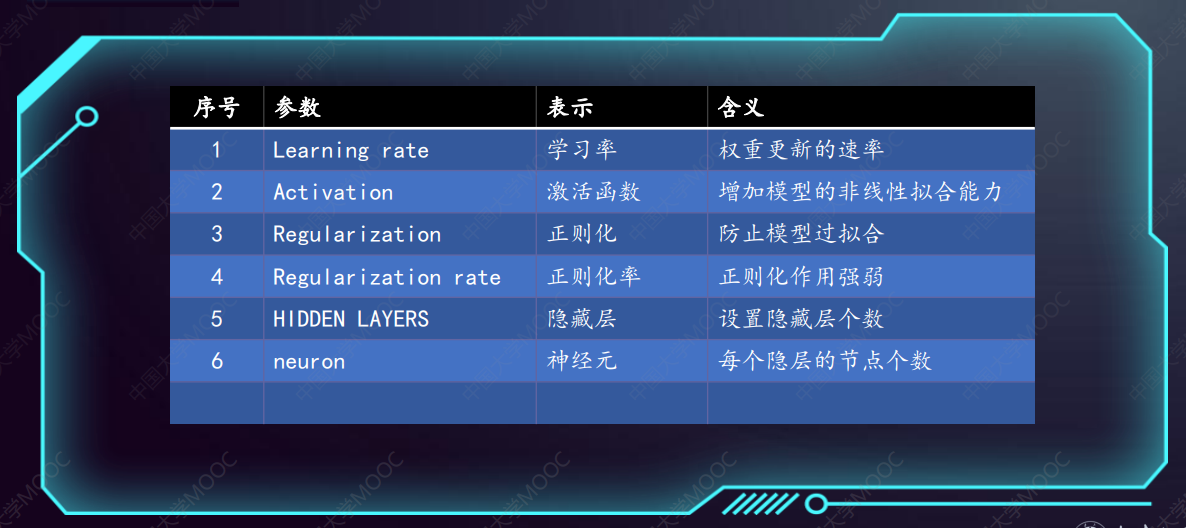
2.1 深度学习的核心:“多一层”的奥秘
普通的神经网络可能只有“输入层”(接收信息)和“输出层”(给出结果)两层,而深度学习至少有三层——在输入层和输出层之间,加了“隐藏层”。
为什么要加隐藏层?举个例子:如果要让AI分辨“猫”和“狗”,输入层接收的是图片的像素点(比如一张图片有几百万个像素),这些原始像素太杂乱,AI看不懂;隐藏层的作用就是“提炼特征”——第一层隐藏层可能先提取“边缘”(比如猫的耳朵边缘、狗的鼻子边缘),第二层隐藏层再把边缘组合成“部件”(比如耳朵、鼻子、爪子),第三层隐藏层再把部件拼成“整体”(比如完整的猫脸、狗脸)。最后输出层根据这些提炼好的特征,判断“这是猫”还是“狗”。
简单说,隐藏层就像AI的“思考步骤”,层数越多,AI能提炼的特征越细致,判断就越准确。
2.2 深度学习的“明星算法”:卷积神经网络(CNN)
在深度学习里,卷积神经网络(简称CNN)是最常用的算法之一,尤其擅长“处理图像”——比如我们手机里的人脸识别、拍照搜物体,背后都有CNN的影子。
CNN的工作过程就像“一步步把图片变清晰(指特征清晰)”,主要分三步:
-
卷积:提取图片的“小特征”
卷积就像用一个“小窗口”(叫“卷积核”)在图片上慢慢滑动,每次滑动都“扫描”一小块区域,提取这个区域的特征——比如扫描图片的左上角,可能提取出“一条竖线”(猫的胡须);扫描中间,可能提取出“一个圆形”(猫的眼睛)。通过多次卷积,图片的所有小特征都会被提取出来。 -
池化:简化特征,减少计算量
卷积后会得到很多“特征图”(记录特征的图),但这些图太大,计算起来很慢。池化就是“缩小特征图”——比如“最大池化”,就是在一个小区域里选“最大的数”(相当于保留最明显的特征,比如在“眼睛”区域,保留最亮的像素点);“均值池化”就是算一个小区域的“平均值”(相当于保留整体特征)。池化后,特征图变小了,但关键特征一点没丢。 -
全连接层:综合特征,给出结果
经过多次卷积和池化后,特征图已经变成了“浓缩的特征”(比如“猫的耳朵+圆眼睛+胡须”)。全连接层会把这些浓缩特征“全部连起来”,综合判断——比如看到“耳朵是尖的、眼睛是圆的、有胡须”,就输出“这是猫”,并给出“99%的概率是猫”这样的结果。
2.3 深度学习的“关键零件”:这些概念要懂
(1)全连接层:“万能连接器”
全连接层是CNN的“最后一步”,它的特点是“每个节点都和上一层的所有节点相连”——比如上一层有25088个节点(相当于25088个特征),下一层有4096个节点(相当于4096个综合特征),那么这两层之间就有“25088×4096”个连接。正因为连接多,全连接层能把所有特征都综合起来,但也导致它的“参数特别多”(参数就是连接的“重要程度”),比如刚才的例子,光这一层就有超过1亿个参数,计算量很大。
(2)激活函数:让AI“会判断”的关键
激活函数是人工神经元的“核心”,它的作用是“决定神经元要不要激活”——比如输入的信号够强,激活函数就“让信号通过”(输出一个值);信号不够强,就“挡住信号”(输出0)。常见的激活函数有三种:
- Sigmoid函数:把输出压在“0到1”之间——比如输出0.9,就代表“这个神经元很确定要激活”,适合用来输出“概率”(比如“90%的概率是猫”);
- Tanh函数:把输出压在“-1到1”之间——比Sigmoid更灵活,能区分“强激活”(接近1)和“强抑制”(接近-1);
- ReLU函数:最简单也最常用——如果输入是正数,就直接输出这个数(激活);如果是负数,就输出0(不激活)。它的优点是“计算快”,还能避免“训练时信号越来越弱”的问题,现在大部分深度学习模型都用它。
3. 生成对抗网络:会“创造”也会“辨别”的AI
除了“识别”,深度学习还能“创造”——生成对抗网络(简称GAN)就是专门用来“创造数据”的模型,比如生成假人脸、假图片,甚至根据文字描述生成图像。
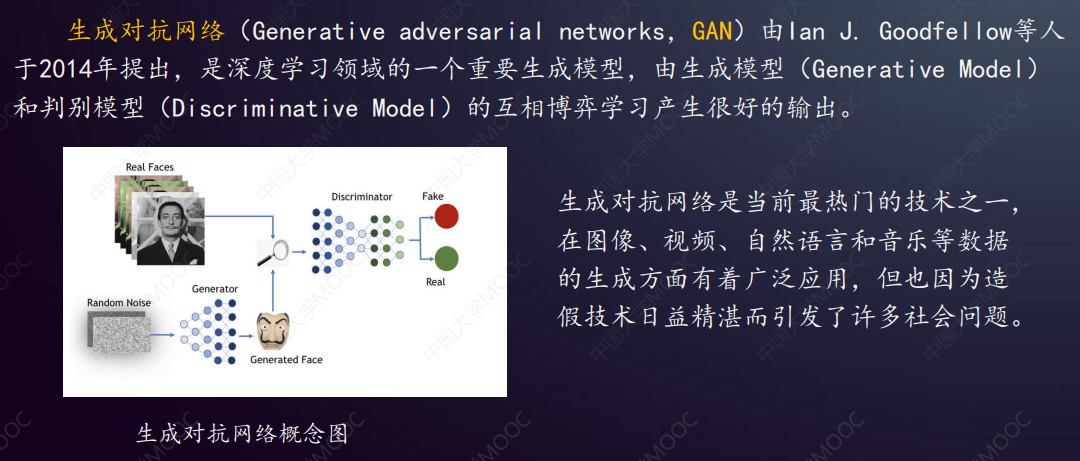
3.1 GAN的核心:“造假者”和“侦探”的博弈
GAN的原理很有意思,它由两个“小网络”组成,就像一对“对手”,互相竞争着进步:
-
生成器(G):“造假者”
生成器的任务是“造假数据”——它从一堆“随机噪声”(比如毫无规律的数字)开始,把这些噪声变成“看起来很真实的数据”,比如一张假的人脸图片。一开始生成的图片可能很模糊(像马赛克),但它会不断调整,越造越像真的。 -
判别器(D):“侦探”
判别器的任务是“分辨真假”——它会同时看“真实数据”(比如真实的人脸照片)和“生成器造的假数据”,判断哪些是真的、哪些是假的。比如看到一张模糊的脸,就判断“这是假的”;看到一张清晰的脸,就判断“这是真的”。
这两个网络就像在“玩游戏”:生成器想让判别器“看走眼”(把假的当成真的),判别器想“火眼金睛”(准确分辨真假)。在一次次的博弈中,生成器越造越真,判别器越辨越准,最后生成器能造出“和真的几乎一样”的数据——比如网上有些“AI生成的虚拟偶像”,就是用GAN造出来的。
3.2 GAN的神奇应用:AI也有“想象力”
GAN的应用非常广泛,很多“AI创造”的场景都离不开它:
-
生成逼真图像
- 生成假人脸:能造出完全不存在的人,但看起来和真人没区别;
- 文本生成图像:比如输入“一只坐在月亮上的兔子”,GAN就能生成一张对应的图片,就像AI“画”出来的一样;
- Deep Dream模型:能把普通图片“改造”得很有创意,比如把一张风景照里的云朵变成“小鸟”,把树木变成“塔楼”。
-
图像“变身”
- “指马为斑马”:GAN能先检测图片里的野马,然后自动给野马加上黑白条纹,让它看起来像斑马;
- 季节转换:比如把“冬天的优胜美地国家公园”(白雪覆盖)变成“夏天的优胜美地”(绿树成荫),反之也能把夏天变冬天;
- 跨物种变换:能把企鹅的图片变成大象,或者把猫的图片变成狗,而且变换后的图片很自然,不会有违和感。
-
模拟人类行为
GAN还能让AI“模仿人类做事”,比如让AI学习“跑步”的动作——生成器会不断尝试生成“跑步的姿态”,判别器判断“这个姿态像不像人在跑步”,最后AI能生成很逼真的跑步动画。
不过,GAN也有“副作用”——因为它能生成太逼真的假数据,可能被用来制作“深度伪造”内容(比如假视频、假照片),引发真假难辨的社会问题。这也是AI发展中需要注意的地方。
更多推荐

 31
 0
- 0


 已为社区贡献6条内容

所有评论(0)