
Docker 搭建 Hadoop 分布式集群 (傻瓜式教程)
文章目录
提示:以下是本篇文章正文内容,Java 系列学习将会持续更新
Docker 搭建 Hadoop 分布式集群
以下是使用 Docker 容器级技术搭建 Hadoop-3.3.4 集群的详细步骤 (以 3 节点集群为例:1 个 NameNode + 2 个 DataNode)。
一、环境准备
-
硬件要求:内存要求至少要 4G,才能负载 3 节点的 Hadoop 集群。
-
主机操作系统:这里采用的是
CentOS-9-Stream,同样的 ubuntu 等 Linux 操作系统都可以。 -
安装 Docker
# 1. yum 包更新到最新 yum update # 2. 安装需要的软件包, yum-util 提供 yum-config-manager 功能,另外两个是 devicemapper 驱动依赖的 yum install -y yum-utils device-mapper-persistent-data lvm2 # 3. 设置yum源 yum-config-manager --add-repo https://download.docker.com/linux/centos/docker-ce.repo # 4. 安装Docker yum install -y docker-ce # 5. 查看docker版本,验证是否验证成功 docker -v # Docker version 23.0.1, build a5ee5b1 -
安装 Docker Compose
# 1. 从 github 官网下载包
curl -L "https://github.com/docker/compose/releases/download/1.27.4/docker-compose-$(uname -s)-$(uname -m)" -o /usr/local/bin/docker-compose

# 2. 设置文件可执行权限
sudo chmod +x /usr/local/bin/docker-compose

# 3. 查看版本信息
docker-compose -version
# docker-compose version 1.27.4, build 40524192
二、构建 Hadoop 镜像
-
创建集群目录结构
mkdir -p hadoop-cluster/{namenode,datanode1,datanode2,conf} cd hadoop-cluster -
编写
Dockerfile文件cat > Dockerfile << EOF FROM ubuntu:18.04 # 安装Java、Shell工具、SSH服务等依赖 RUN apt-get update && apt-get install -y \ openjdk-8-jdk \ bash \ openssh-server \ openssh-client \ vim \ net-tools \ wget && \ rm -rf /var/lib/apt/lists/* # 清理APT缓存,减小镜像体积 # 配置SSH免密登录 RUN mkdir -p /var/run/sshd && \ ssh-keygen -t rsa -f ~/.ssh/id_rsa -N '' && \ cat ~/.ssh/id_rsa.pub >> ~/.ssh/authorized_keys && \ chmod 600 ~/.ssh/authorized_keys # 安装Hadoop(使用3.3.4版本) RUN wget https://archive.apache.org/dist/hadoop/common/hadoop-3.3.4/hadoop-3.3.4.tar.gz && \ tar -zxf hadoop-3.3.4.tar.gz -C /usr/local && \ rm hadoop-3.3.4.tar.gz && \ mv /usr/local/hadoop-3.3.4 /usr/local/hadoop # 配置环境变量 ENV JAVA_HOME=/usr/lib/jvm/java-8-openjdk-amd64 ENV HADOOP_HOME=/usr/local/hadoop ENV PATH=$PATH:$HADOOP_HOME/bin:$HADOOP_HOME/sbin # 暴露Hadoop端口 EXPOSE 9870 9000 8088 9864 9866 # 启动SSH服务 CMD ["/usr/sbin/sshd", "-D"] EOF若下载速度慢或连接超时,则更换国内镜像后的
Dockerfile文件内容为:FROM ubuntu:18.04 # 替换为国内Debian APT源(解决apt-get安装失败问题) RUN sed -i 's/deb.debian.org/mirrors.aliyun.com/g' /etc/apt/sources.list && \ sed -i 's/security.debian.org/mirrors.aliyun.com/g' /etc/apt/sources.list && \ apt-get clean # 清理旧源缓存 # 安装Java、Shell工具、SSH服务等依赖 RUN apt-get update && apt-get install -y \ openjdk-8-jdk \ bash \ openssh-server \ openssh-client \ vim \ net-tools \ wget && \ rm -rf /var/lib/apt/lists/* # 清理APT缓存,减小镜像体积 # 配置SSH免密登录 RUN mkdir -p /var/run/sshd && \ ssh-keygen -t rsa -f ~/.ssh/id_rsa -N '' && \ cat ~/.ssh/id_rsa.pub >> ~/.ssh/authorized_keys && \ chmod 600 ~/.ssh/authorized_keys # 安装Hadoop-3.3.4, 下载地址为华为镜像 RUN wget https://mirrors.huaweicloud.com/apache/hadoop/common/hadoop-3.3.4/hadoop-3.3.4.tar.gz && \ tar -zxf hadoop-3.3.4.tar.gz -C /usr/local && \ rm hadoop-3.3.4.tar.gz && \ mv /usr/local/hadoop-3.3.4 /usr/local/hadoop # 配置环境变量 ENV JAVA_HOME=/usr/lib/jvm/java-8-openjdk-amd64 ENV HADOOP_HOME=/usr/local/hadoop ENV PATH=$PATH:$HADOOP_HOME/bin:$HADOOP_HOME/sbin # 暴露Hadoop端口 EXPOSE 9870 9000 8088 9864 9866 # 启动SSH服务 CMD ["/usr/sbin/sshd", "-D"] -
使用
Dockerfile构建镜像docker build -t hadoop:3.3.4 .如果之前的构建缓存有问题,强制重新下载依赖:
docker build --no-cache -t hadoop:3.3.4 .构建成功后,可以执行
docker images指令查看到该镜像:REPOSITORY TAG IMAGE ID CREATED SIZE hadoop 3.3.4 b9734acd0d8f 20 hours ago 1.94GB
三、配置 Hadoop 集群配置文件
-
进入配置目录
cd conf -
创建
core-site.xmlcat > core-site.xml << EOF <?xml version="1.0" encoding="UTF-8"?> <configuration> <property> <name>fs.defaultFS</name> <value>hdfs://namenode:9000</value> </property> </configuration> EOF -
创建
hdfs-site.xmlcat > hdfs-site.xml << EOF <?xml version="1.0" encoding="UTF-8"?> <configuration> <property> <name>dfs.namenode.name.dir</name> <value>/usr/local/hadoop/data/namenode</value> </property> <property> <name>dfs.datanode.data.dir</name> <value>/usr/local/hadoop/data/datanode</value> </property> <property> <name>dfs.replication</name> <value>2</value> </property> <property> <name>dfs.namenode.http-address</name> <value>0.0.0.0:9870</value> </property> </configuration> EOF -
创建
mapred-site.xmlcat > mapred-site.xml << EOF <?xml version="1.0" encoding="UTF-8"?> <configuration> <property> <name>mapreduce.framework.name</name> <value>yarn</value> </property> <!-- 防止缺少MapReduce ApplicationMaster的配置, 而导致YARN无法找到启动任务所需的主类 --> <property> <name>yarn.app.mapreduce.am.env</name> <value>HADOOP_MAPRED_HOME=/usr/local/hadoop</value> </property> <property> <name>mapreduce.map.env</name> <value>HADOOP_MAPRED_HOME=/usr/local/hadoop</value> </property> <property> <name>mapreduce.reduce.env</name> <value>HADOOP_MAPRED_HOME=/usr/local/hadoop</value> </property> </configuration> EOF -
创建
yarn-site.xmlcat > yarn-site.xml << EOF <?xml version="1.0" encoding="UTF-8"?> <configuration> <!-- 资源管理器主机名(指向NameNode) --> <property> <name>yarn.resourcemanager.hostname</name> <value>namenode</value> </property> <!-- NodeManager提供的辅助服务(必须配置为mapreduce_shuffle,否则MapReduce任务无法运行) --> <property> <name>yarn.nodemanager.aux-services</name> <value>mapreduce_shuffle</value> </property> <!-- 配置NodeManager可用内存(适配宿主机内存且大于默认任务1536MB需求,故设为2GB适合测试环境) --> <property> <name>yarn.nodemanager.resource.memory-mb</name> <value>2024</value> </property> <!-- 单个容器最小分配内存 --> <property> <name>yarn.scheduler.minimum-allocation-mb</name> <value>512</value> </property> <!-- 单个容器最大分配内存(不超过yarn.nodemanager.resource.memory-mb) --> <property> <name>yarn.scheduler.maximum-allocation-mb</name> <value>2024</value> </property> <!-- 虚拟内存与物理内存比例(放宽限制,避免因内存计算严格导致任务失败) --> <property> <name>yarn.nodemanager.vmem-pmem-ratio</name> <value>2.1</value> </property> <!-- 资源管理器通信端口(确保与NodeManager配置一致) --> <property> <name>yarn.resourcemanager.address</name> <value>namenode:8032</value> </property> <!-- 补充ResourceManager注册端口,确保NodeManager能找到注册入口 --> <property> <name>yarn.resourcemanager.resource-tracker.address</name> <value>namenode:8031</value> </property> </configuration> EOF -
创建
workers文件(指定 DataNode 节点)cat > workers << EOF datanode1 datanode2 EOF -
创建
hadoop-env.sh启动脚本cat > hadoop-env.sh << EOF # Set Hadoop-specific environment variables here. # The java implementation to use. By default, this environment # variable is REQUIRED on ALL platforms except OS X! export JAVA_HOME=/usr/lib/jvm/java-8-openjdk-amd64 # Extra Java CLASSPATH elements. Automatically insert capacity-scheduler. for f in \$HADOOP_HOME/contrib/capacity-scheduler/*.jar; do if [ "\$HADOOP_CLASSPATH" ]; then export HADOOP_CLASSPATH=\$HADOOP_CLASSPATH:\$f else export HADOOP_CLASSPATH=\$f fi done # The maximum amount of heap to use (Java -Xmx). Default is 1000m. # export HADOOP_HEAPSIZE= # export HADOOP_NAMENODE_INIT_HEAPSIZE="" # Extra Java runtime options. Empty by default. export HADOOP_OPTS="-Djava.net.preferIPv4Stack=true \$HADOOP_OPTS" # Command specific options appended to HADOOP_OPTS when specified export HADOOP_NAMENODE_OPTS="-Dhadoop.security.logger=\${HADOOP_SECURITY_LOGGER:-INFO,RFAS} -Dhdfs.audit.logger=\${HDFS_AUDIT_LOGGER:-INFO,NullAppender} \$HADOOP_NAMENODE_OPTS" export HADOOP_DATANODE_OPTS="-Dhadoop.security.logger=ERROR,RFAS \$HADOOP_DATANODE_OPTS" export HADOOP_SECONDARYNAMENODE_OPTS="-Dhadoop.security.logger=\${HADOOP_SECURITY_LOGGER:-INFO,RFAS} -Dhdfs.audit.logger=\${HDFS_AUDIT_LOGGER:-INFO,NullAppender} \$HADOOP_SECONDARYNAMENODE_OPTS" # The following applies to multiple commands (fs, dfs, fsck, distcp etc) export HADOOP_CLIENT_OPTS="-Xmx512m \$HADOOP_CLIENT_OPTS" # HADOOP_JAVA_PLATFORM_OPTS is platform specific options. # export HADOOP_JAVA_PLATFORM_OPTS="-XX:-UsePerfData \$HADOOP_JAVA_PLATFORM_OPTS" # On secure datanodes, user to run the datanode as after dropping privileges. # This **MUST** be uncommented to enable secure HDFS if using privileged TC/TB. # export HDFS_DATANODE_SECURE_USER=hdfs # Where log files are stored. \$HADOOP_HOME/logs by default. # export HADOOP_LOG_DIR=\${HADOOP_HOME}/logs # Where process IDs are stored. \$HADOOP_HOME/pids by default. # export HADOOP_PID_DIR=\${HADOOP_HOME}/pids # A string representing this instance of hadoop. \$USER by default. # export HADOOP_IDENT_STRING=\$USER # The scheduling priority for daemon processes. See 'man nice'. # export HADOOP_NICENESS=0 # HDFS 组件用户(使用root,测试环境简化) export HDFS_NAMENODE_USER=root export HDFS_DATANODE_USER=root export HDFS_SECONDARYNAMENODE_USER=root # YARN 组件用户(使用root,测试环境简化) export YARN_RESOURCEMANAGER_USER=root export YARN_NODEMANAGER_USER=root EOF
四、编写 Docker Compose 配置
-
返回上层目录
hadoop-clustercd .. -
创建
docker-compose.ymlcat > docker-compose.yml << EOF version: '3' services: namenode: image: hadoop:3.3.4 container_name: namenode hostname: namenode ports: - "9870:9870" # HDFS WebUI - "8088:8088" # YARN WebUI volumes: - ./conf/core-site.xml:/usr/local/hadoop/etc/hadoop/core-site.xml - ./conf/hdfs-site.xml:/usr/local/hadoop/etc/hadoop/hdfs-site.xml - ./conf/mapred-site.xml:/usr/local/hadoop/etc/hadoop/mapred-site.xml - ./conf/yarn-site.xml:/usr/local/hadoop/etc/hadoop/yarn-site.xml - ./conf/workers:/usr/local/hadoop/etc/hadoop/workers - ./conf/hadoop-env.sh:/usr/local/hadoop/etc/hadoop/hadoop-env.sh - ./namenode:/usr/local/hadoop/data/namenode networks: - hadoop-net datanode1: image: hadoop:3.3.4 container_name: datanode1 hostname: datanode1 volumes: - ./conf/core-site.xml:/usr/local/hadoop/etc/hadoop/core-site.xml - ./conf/hdfs-site.xml:/usr/local/hadoop/etc/hadoop/hdfs-site.xml - ./conf/yarn-site.xml:/usr/local/hadoop/etc/hadoop/yarn-site.xml - ./conf/hadoop-env.sh:/usr/local/hadoop/etc/hadoop/hadoop-env.sh - ./datanode1:/usr/local/hadoop/data/datanode depends_on: - namenode networks: - hadoop-net datanode2: image: hadoop:3.3.4 container_name: datanode2 hostname: datanode2 volumes: - ./conf/core-site.xml:/usr/local/hadoop/etc/hadoop/core-site.xml - ./conf/hdfs-site.xml:/usr/local/hadoop/etc/hadoop/hdfs-site.xml - ./conf/yarn-site.xml:/usr/local/hadoop/etc/hadoop/yarn-site.xml - ./conf/hadoop-env.sh:/usr/local/hadoop/etc/hadoop/hadoop-env.sh - ./datanode2:/usr/local/hadoop/data/datanode depends_on: - namenode networks: - hadoop-net networks: hadoop-net: driver: bridge EOF
五、启动集群并初始化
-
启动容器
docker-compose up -d -
进入 NameNode 容器
docker exec -it namenode bash -
初始化 HDFS (仅首次执行)
hdfs namenode -format该指令是初始化 HDFS 文件系统的命令,用于格式化 NameNode 的元数据存储目录 (如
dfs.namenode.name.dir配置的路径)。执行该命令会清除所有 HDFS 元数据 (但不会删除 DataNode 上的实际数据块,除非手动删除),通常在首次启动 Hadoop 集群前或需要重置 HDFS 时使用。示例成功输出片段:看到类似
has been successfully formatted的提示,说明格式化成功。... 2025-11-10 10:00:00 INFO common.Storage: Storage directory /usr/local/hadoop/data/namenode has been successfully formatted. 2025-11-10 10:00:00 INFO namenode.FSImageFormatProtobuf: Saving image file /usr/local/hadoop/data/namenode/current/fsimage.ckpt_0000000000000000000 using no compression 2025-11-10 10:00:00 INFO namenode.NameNode: SHUTDOWN_MSG: /************************************************************ SHUTDOWN_MSG: Shutting down NameNode at namenode/172.20.0.2 ************************************************************/ -
启动 Hadoop 集群
start-dfs.sh
start-yarn.sh
若执行
start-dfs.sh成功,会显示类似以下输出:Starting namenodes on [namenode] namenode: starting namenode, logging to /usr/local/hadoop/logs/hadoop-root-namenode-namenode.out datanode1: starting datanode, logging to /usr/local/hadoop/logs/hadoop-root-datanode-datanode1.out datanode2: starting datanode, logging to /usr/local/hadoop/logs/hadoop-root-datanode-datanode2.out Starting secondary namenodes [namenode] namenode: starting secondarynamenode, logging to /usr/local/hadoop/logs/hadoop-root-secondarynamenode-namenode.out若执行
start-yarn.sh成功,会显示类似以下输出:Starting resourcemanager Starting nodemanagers
六、验证集群状态
-
确认注册状态(在 NameNode 容器内)关键
yarn node -list若输出包含 2 个 NodeManager 节点,则说明成功注册。
2025-11-11 05:53:02,352 INFO client.DefaultNoHARMFailoverProxyProvider: Connecting to ResourceManager at namenode/172.18.0.2:8032
Total Nodes:2
         Node-Id	     Node-State	Node-Http-Address	Number-of-Running-Containers
 datanode1:33371	        RUNNING	   datanode1:8042	                           0
 datanode2:46737	        RUNNING	   datanode2:8042	                           0
若注册失败,可以去检查 NodeManager 日志,便于定位根本原因。
# 1. 进入任意 DataNode 容器
docker exec -it datanode1 bash
# 2. 查看 NodeManager 日志
cat $HADOOP_HOME/logs/hadoop-root-nodemanager-datanode1.log | grep -i "error\|warn"
常见错误日志及对应原因:
More than physical memory available:宿主机内存无法供应 NodeManager 需要的内存配置。Failed to connect to ResourceManager at namenode:8031:网络不通或端口错误。Connection refused:ResourceManager 未启动或端口被占用。Invalid hostname: namenode:DataNode 无法解析namenode主机名。
-
查看 Java 进程状态(在 NameNode 容器内)
jps
# 预期输出的关键进程
# Jps
# NameNode           # HDFS主节点
# SecondaryNameNode  # HDFS从节点(元数据备份)
# ResourceManager    # YARN资源管理器(若启动了YARN)
查看 Java 进程状态(在 DataNode 容器内)
docker exec -it datanode1 bash jps # 预期输出的关键进程 # Jps # DataNode # HDFS数据节点 # NodeManager # YARN节点管理器(若启动了YARN) -
访问 WebUI 验证 (云服务器的这两个端口必须开放才能访问到!)
- HDFS 管理界面:
http://宿主机IP:9870 - YARN 管理界面:
http://宿主机IP:8088
- HDFS 管理界面:
-
检查 2 个 DataNode 状态(在 NameNode 容器内)
hdfs dfsadmin -report -
重置操作(若挂载的配置文件需要修改,或实在搞不对,则可以用以下两个操作重来)
-
停止集群 (在 NameNode 容器内) —— 重新加载配置文件
stop-yarn.sh stop-dfs.sh -
停止并删除容器 (宿主机执行) —— 重头再来
docker-compose down
-
七、执行 WordCount 代码
-
准备输入数据
# 1. 在NameNode容器内,创建本地输入文件 mkdir -p /root/data echo "Hello Hadoop Hello Docker" > /root/data/input.txt # 2. 在HDFS创建输入目录 hdfs dfs -mkdir -p /user/root/input # 3. 将本地文件上传到HDFS输入目录 hdfs dfs -put /root/data/input.txt /user/root/input/ -
使用 Hadoop 内置的 WordCount 执行 (这一步只是测试,可以从第 3 步开始)
Hadoop 内置的 WordCount 示例位于
$HADOOP_HOME/share/hadoop/mapreduce/hadoop-mapreduce-examples-3.3.4.jar(版本号可能因你的 Hadoop 版本略有不同)。# 1. 确认内置示例 JAR 存在 ls $HADOOP_HOME/share/hadoop/mapreduce/hadoop-mapreduce-examples-*.jar # 2. 执行内置WordCount示例 # 格式:hadoop jar <内置JAR路径> wordcount <输入路径> <输出路径> hadoop jar $HADOOP_HOME/share/hadoop/mapreduce/hadoop-mapreduce-examples-3.3.4.jar wordcount /user/root/input /user/root/output # 3. 查看 HDFS 中的输出结果 hdfs dfs -cat /user/root/output/part-r-00000 -
自定义代码上传到 Hadoop 集群 (上传到 HDFS)
首先需要自己写代码,并将代码打包成
WordCount.jar并上传至宿主机中,代码内容在 九、WordCount.java (补充) 这里。# 1. 宿主机执行: 将jar包上传到NameNode容器的root目录 docker cp /宿主机路径/WordCount.jar namenode:/root/ # 2. 进入NameNode容器 docker exec -it namenode bash # 3. 上传本地代码到HDFS(可选,方便共享) hdfs dfs -put /root/WordCount.jar /user/root/ -
提交 MapReduce 任务
# 1. 执行前清理输出目录 (若存在会报错)
hdfs dfs -rm -r /user/root/output

# 2. 执行命令:hadoop jar <jar包路径> <主类名> <HDFS输入路径> <HDFS输出路径>
hadoop jar /root/WordCount.jar WordCount /user/root/input /user/root/output
执行成功后的输出为:
2025-11-11 11:31:32,742 INFO client.DefaultNoHARMFailoverProxyProvider: Connecting to ResourceManager at namenode/172.18.0.2:8032 2025-11-11 11:31:33,119 INFO mapreduce.JobResourceUploader: Disabling Erasure Coding for path: /tmp/hadoop-yarn/staging/root/.staging/job_1762859578915_0002 2025-11-11 11:31:33,358 INFO input.FileInputFormat: Total input files to process : 1 2025-11-11 11:31:33,429 INFO mapreduce.JobSubmitter: number of splits:1 2025-11-11 11:31:33,547 INFO mapreduce.JobSubmitter: Submitting tokens for job: job_1762859578915_0002 2025-11-11 11:31:33,548 INFO mapreduce.JobSubmitter: Executing with tokens: [] 2025-11-11 11:31:33,718 INFO conf.Configuration: resource-types.xml not found 2025-11-11 11:31:33,719 INFO resource.ResourceUtils: Unable to find 'resource-types.xml'. 2025-11-11 11:31:33,777 INFO impl.YarnClientImpl: Submitted application application_1762859578915_0002 2025-11-11 11:31:33,815 INFO mapreduce.Job: The url to track the job: http://namenode:8088/proxy/application_1762859578915_0002/ 2025-11-11 11:31:33,816 INFO mapreduce.Job: Running job: job_1762859578915_0002 2025-11-11 11:31:39,897 INFO mapreduce.Job: Job job_1762859578915_0002 running in uber mode : false 2025-11-11 11:31:39,898 INFO mapreduce.Job: map 0% reduce 0% 2025-11-11 11:31:43,950 INFO mapreduce.Job: map 100% reduce 0% 2025-11-11 11:31:48,976 INFO mapreduce.Job: map 100% reduce 100% 2025-11-11 11:31:48,983 INFO mapreduce.Job: Job job_1762859578915_0002 completed successfully 2025-11-11 11:31:49,066 INFO mapreduce.Job: Counters: 54 -
查看 HDFS 中的输出结果
hdfs dfs -cat /user/root/output/part-r-00000输出结果:
Docker	1
Hadoop	1
Hello	2
八、查看 Web 管理页面
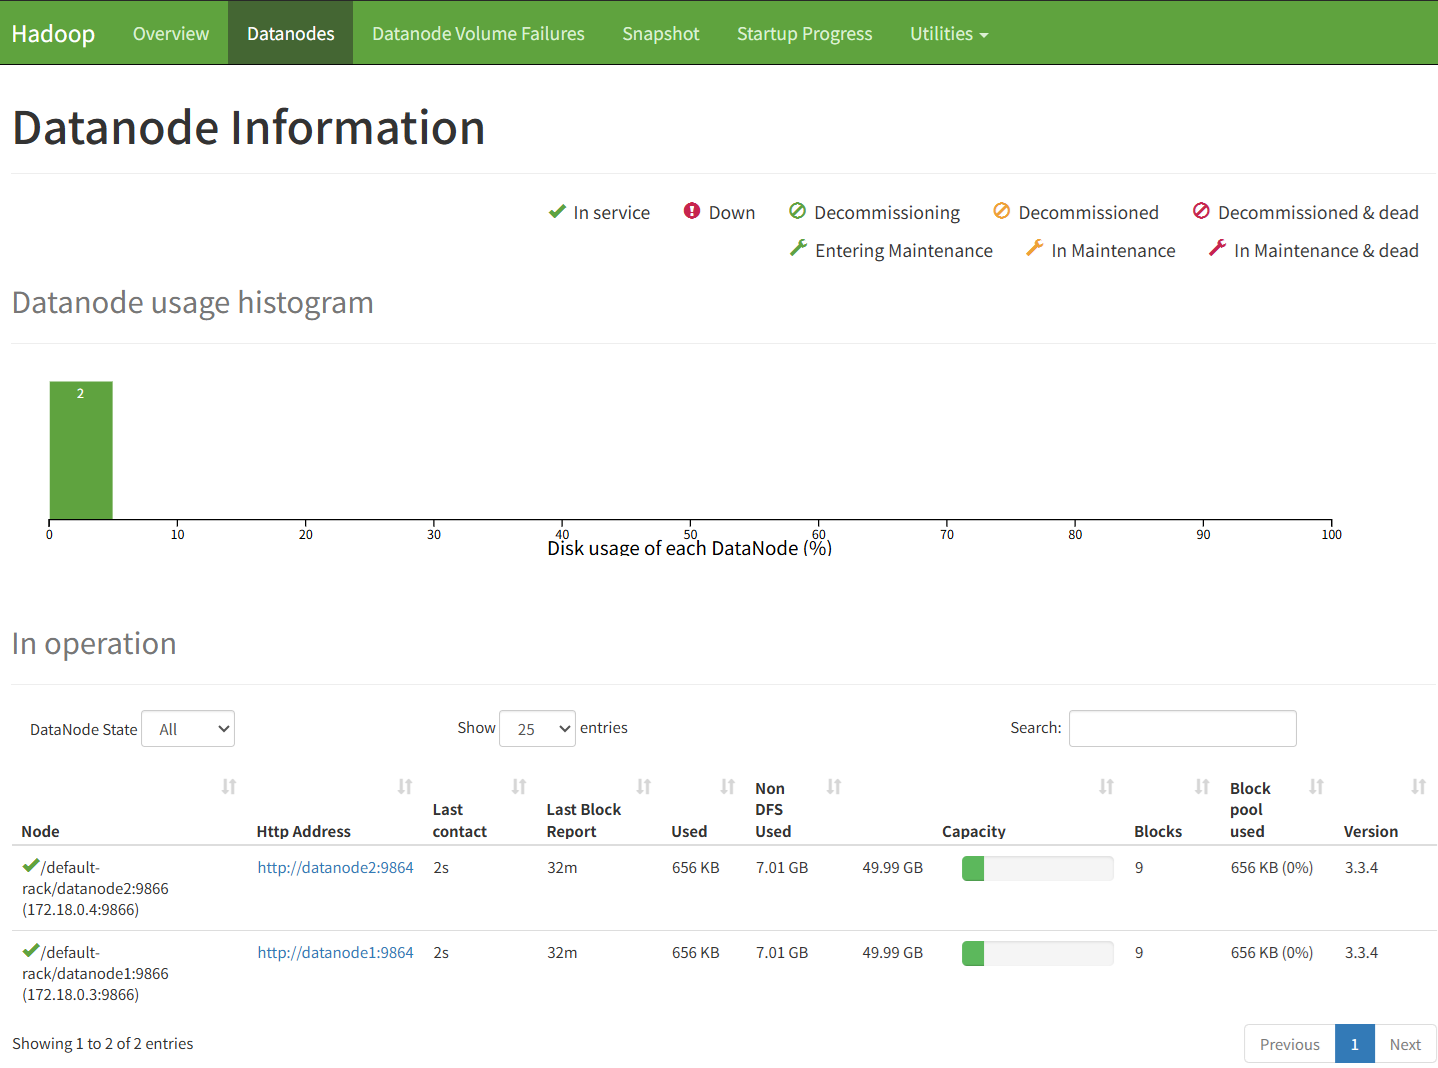
HDFS 管理界面:http://宿主机IP:9870
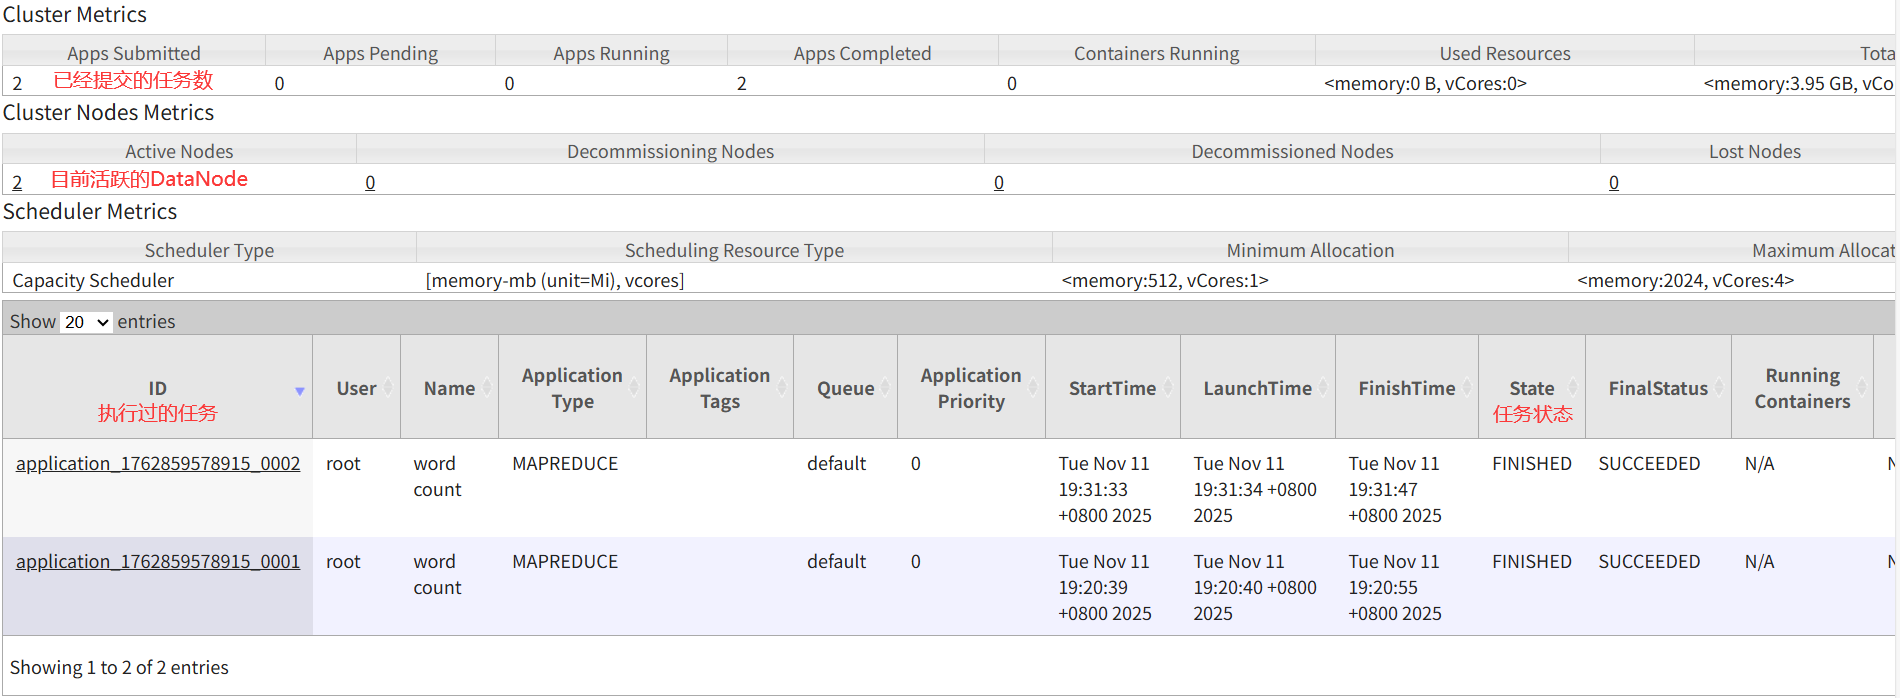
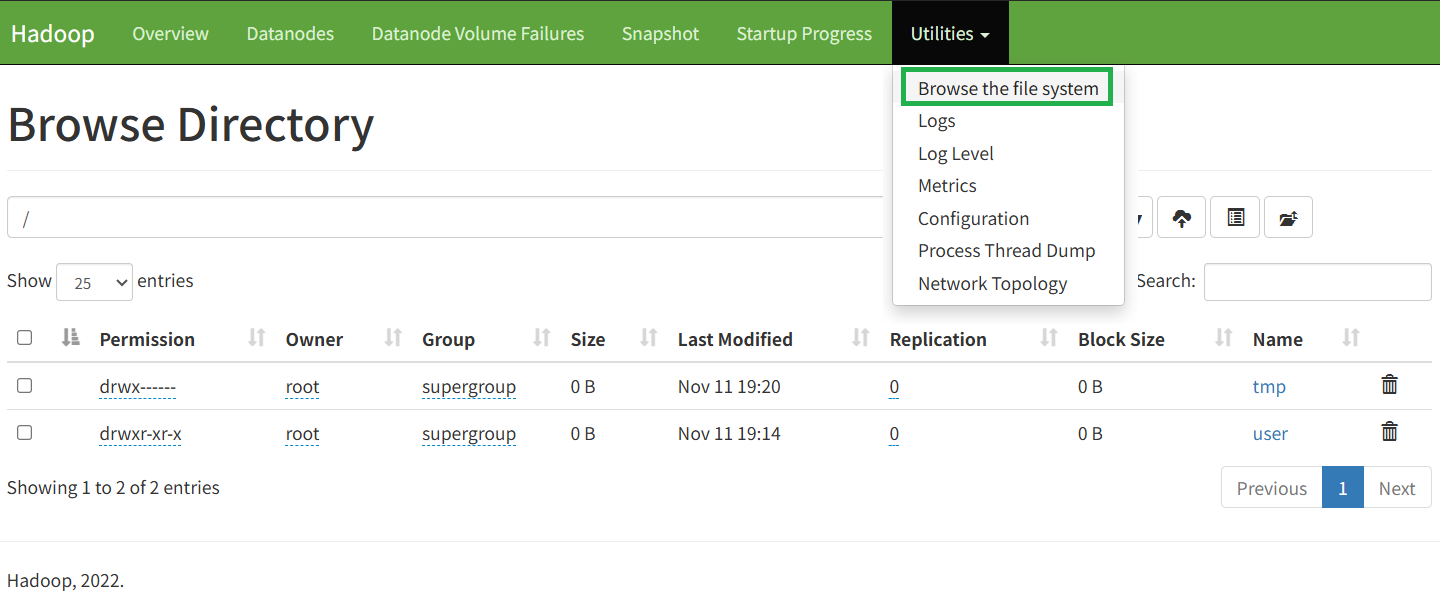
YARN 管理界面:http://宿主机IP:8088
YARN 文件系统:
九、WordCount.java (补充)
-
WordCount.java 主类
import org.apache.hadoop.conf.Configuration; import org.apache.hadoop.fs.Path; import org.apache.hadoop.io.IntWritable; import org.apache.hadoop.io.Text; import org.apache.hadoop.mapreduce.Job; import org.apache.hadoop.mapreduce.Mapper; import org.apache.hadoop.mapreduce.Reducer; import org.apache.hadoop.mapreduce.lib.input.FileInputFormat; import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat; import org.apache.hadoop.util.Tool; import org.apache.hadoop.util.ToolRunner; // 新增:用于处理命令行参数 import java.io.IOException; import java.util.StringTokenizer; // 实现Tool接口,支持参数解析 public class WordCount implements Tool { private Configuration conf; @Override public void setConf(Configuration conf) { this.conf = conf; } @Override public Configuration getConf() { return conf; } // Mapper和Reducer类代码不变(省略,与之前相同) public static class TokenizerMapper extends Mapper<Object, Text, Text, IntWritable> { private final static IntWritable one = new IntWritable(1); private Text word = new Text(); public void map(Object key, Text value, Context context) throws IOException, InterruptedException { StringTokenizer itr = new StringTokenizer(value.toString()); while (itr.hasMoreTokens()) { word.set(itr.nextToken()); context.write(word, one); } } } public static class IntSumReducer extends Reducer<Text, IntWritable, Text, IntWritable> { private IntWritable result = new IntWritable(); public void reduce(Text key, Iterable<IntWritable> values, Context context) throws IOException, InterruptedException { int sum = 0; for (IntWritable val : values) { sum += val.get(); } result.set(sum); context.write(key, result); } } // 主方法通过ToolRunner运行,支持参数解析 public static void main(String[] args) throws Exception { int res = ToolRunner.run(new Configuration(), new WordCount(), args); System.exit(res); } // 实现run方法,配置作业(原main方法的逻辑移到这里) @Override public int run(String[] args) throws Exception { Configuration conf = getConf(); // 获取配置(包含-D参数) Job job = Job.getInstance(conf, "word count"); job.setJarByClass(WordCount.class); job.setMapperClass(TokenizerMapper.class); job.setCombinerClass(IntSumReducer.class); job.setReducerClass(IntSumReducer.class); job.setOutputKeyClass(Text.class); job.setOutputValueClass(IntWritable.class); FileInputFormat.addInputPath(job, new Path(args[0])); FileOutputFormat.setOutputPath(job, new Path(args[1])); return job.waitForCompletion(true) ? 0 : 1; } } -
pom.xml 的依赖配置
<properties>
    <hadoop.version>3.3.4</hadoop.version>
</properties>

<dependencies>
    <!-- Hadoop Common 核心依赖 -->
    <dependency>
        <groupId>org.apache.hadoop</groupId>
        <artifactId>hadoop-common</artifactId>
        <version>${hadoop.version}</version>
        <!-- 排除冲突的日志依赖(可选) -->
        <exclusions>
            <exclusion>
                <groupId>log4j</groupId>
                <artifactId>log4j</artifactId>
            </exclusion>
        </exclusions>
    </dependency>

    <!-- Hadoop MapReduce 核心依赖 -->
    <dependency>
        <groupId>org.apache.hadoop</groupId>
        <artifactId>hadoop-mapreduce-client-core</artifactId>
        <version>${hadoop.version}</version>
    </dependency>

    <!-- Hadoop MapReduce 客户端依赖(提交任务用) -->
    <dependency>
        <groupId>org.apache.hadoop</groupId>
        <artifactId>hadoop-mapreduce-client-jobclient</artifactId>
        <version>${hadoop.version}</version>
        <scope>provided</scope> <!-- 集群环境已存在,打包时不包含 -->
    </dependency>

    <!-- HDFS 依赖(操作 HDFS 时需要) -->
    <dependency>
        <groupId>org.apache.hadoop</groupId>
        <artifactId>hadoop-hdfs-client</artifactId>
        <version>${hadoop.version}</version>
    </dependency>
</dependencies>
通过以上步骤,即可在 Docker 中搭建一个可用的 Hadoop 分布式集群。如需扩展节点,可在 docker-compose.yml 中增加 DataNode 配置并更新 workers 文件。
总结:
提示:这里对文章进行总结:
本文是对 Hadoop 集群搭建的学习,采用 Docker 容器级搭建 Hadoop-3.3.4 分布式集群的详细步骤。之后的学习内容将持续更新!!!
更多推荐

 19
 0
- 0


 已为社区贡献1条内容

所有评论(0)