
深度学习核心2.0之反向传播、梯度消失/爆炸、更新参数优化方法Adam、SGD、AdaDrad、RMSProp
1、反向传播算法
反向传播(Backward Propagation 或 Back Propagation,BP算法)指的是计算神经网络参数梯度
的方法。简言之,该方法根据微积分中的链式法则,按相反的顺序从输出层到输入层遍历网络。该
算法存储了计算某些参数梯度时所需的任何中间变量。
反向传播目前来说就是一个更高效计算grad的方式,并不是一个更新参数的方法
1.1、链式法则
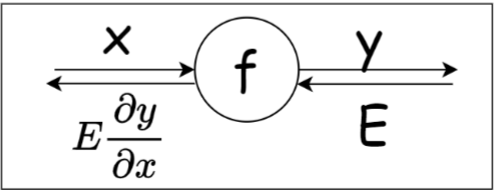
反向传播将局部导数向反方向传递,传递的原理基于链式法则。反向传播时将信号乘以节点的局部
导数然后传递给下一个节点。
1.2、加法和乘法节点
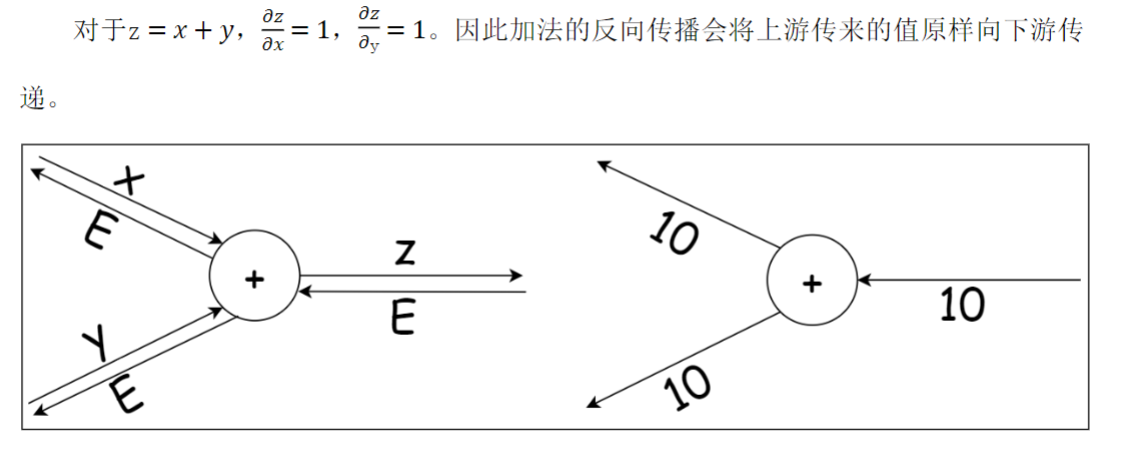
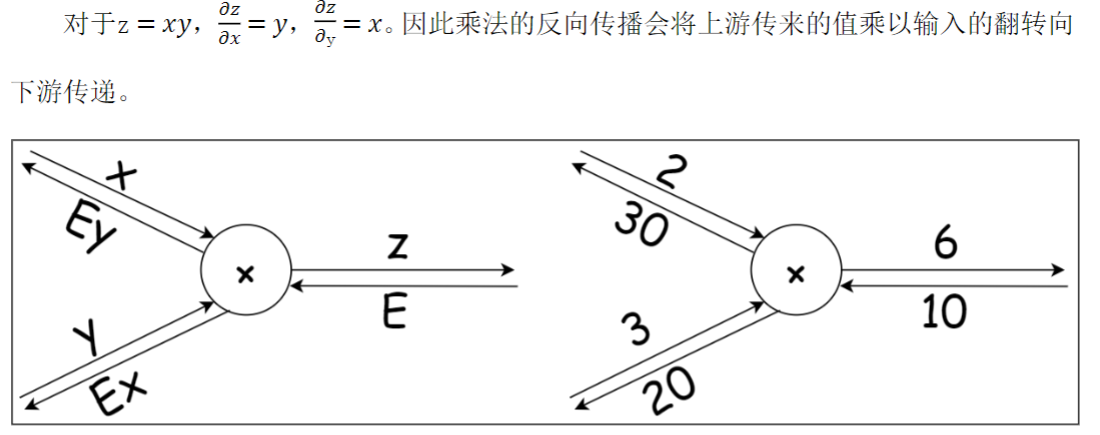
2、反向传播——激活层
这里理清一下思路,我们这里定义的反向传播的函数,里面有一个dy需要输入,其实这个时候我们
只是包装了一个函数而已,我们并没有在管这个dy到底是多少,这个需要用到的时候你自己再传进
来,然后输入dx其实就是当前这一层的导数,如果下面还要再继续往前传递的话,这个dx也有可能
成为前一层的dy也就是输入,下面的公式很重要,为什么是上一层乘下一层就是这个原理。
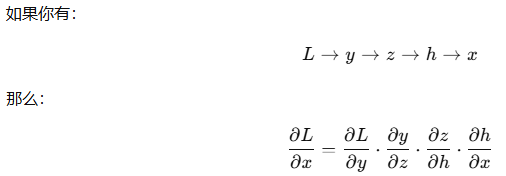
2.1、Relu
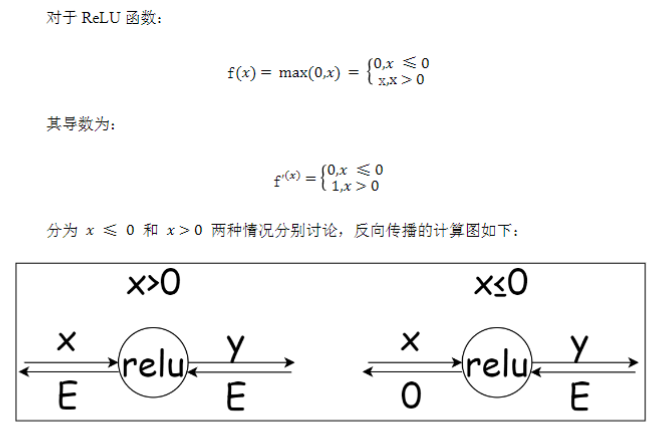
class Relu:
    def __init__(self):
        self.mask = None
    def forward(self, x):
        self.mask = ( x<=0 )
        y = x.copy()
        y[self.mask] = 0
        return y
    # 反向传播输入后面层传来的局部导数dy,输出dx
    def backward(self, dy):
        dx = dy.copy()
        dx[self.mask] = 0
        return dx
2.2、Sigmoid
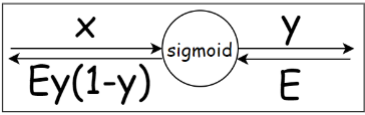
from common.functions import *
class Sigmoid:
    def __init__(self):
        self.y = None
    def forward(self, x):
        y = sigmoid(x)
        self.y = y
        return y
    def backward(self, dy):
        dx = dy * self.y * (1.0 - self.y)
        return dx
2.3、Affine仿射变换
这里具体是左乘还是右乘就是看形状
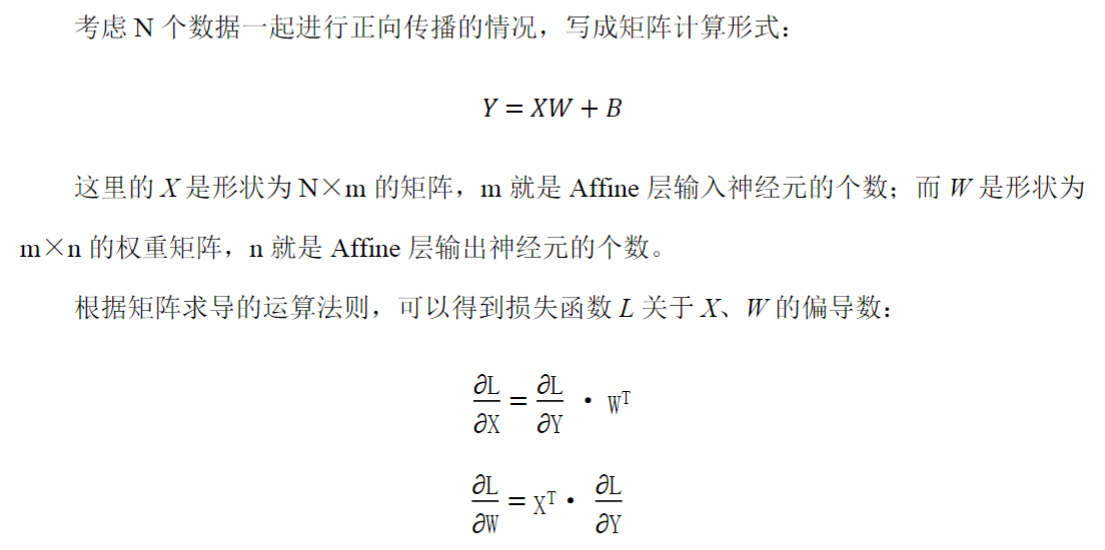
这个代码还没有实现梯度下降的功能,暂时只是求梯度,然后返回一个可以往前传递的导数值而
已,这个return的dx相当于上一层的dy
class Affine:
    def __init__(self,W,b):
        self.W = W
        self.b = b
        self.X = None
        self.original_x_shape = None
        self.dw = None
        self.db = None
    def forward(self, X):
        self.original_x_shape = X.shape
        self.X = X.reshape(X.shape[0], -1)
        Y = self.X @ self.W + self.b
        return Y
    def backward(self, dY):
        dx = dY @ self.W.T
        self.dw = self.X.T @ dY
        self.db = np.sum(dY, axis=0)
        dx = dx.reshape(self.original_x_shape)
        return dx
3、反向传播——输出层
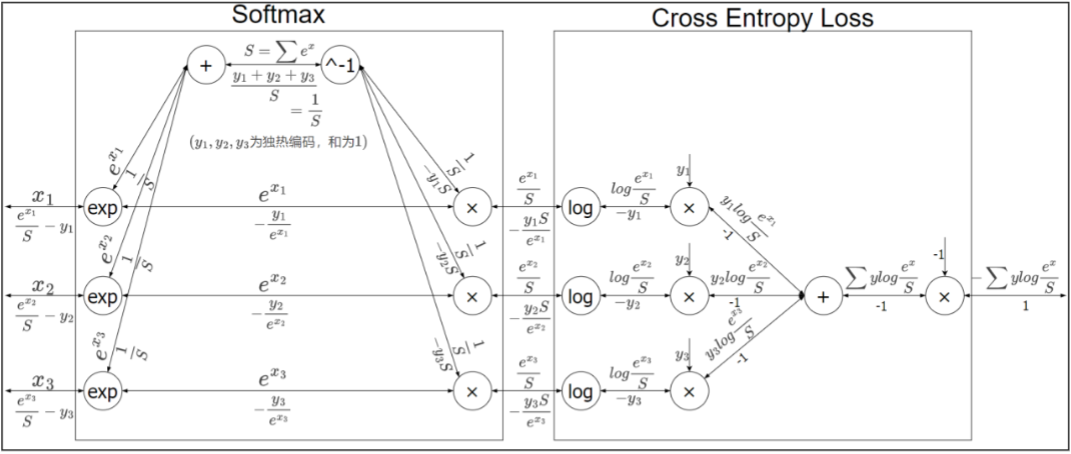
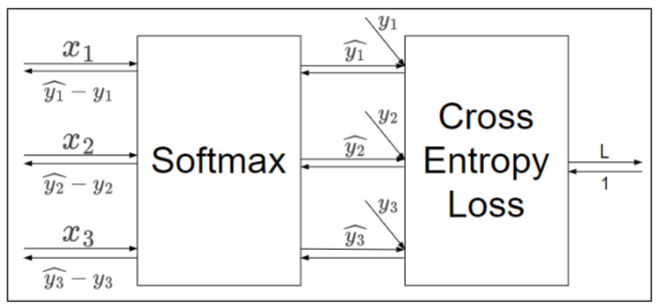
class SoftmaxWithLoss:
    def __init__(self):
        self.loss = None
        self.y = None
        self.t = None
    def forward(self, x, t):
        self.t = t
        self.y = softmax(x)
        self.loss = cross_entropy_error(self.y, self.t)
        return self.loss
    def backward(self, dy=1):
        n = self.t.shape[0]
        if self.t.size == self.y.size:
            dx = self.y - self.t
        else:
            dx = self.y.copy()
            dx[np.arange(n),self.t] -= 1
        return dx * dy / n
4、改进之后的案例
gradient下面的这一步是先做一遍前向传播,保存反向传播要用到的数值
self.loss(x,t)
import numpy as np
from common.functions import  *
from common.gradient import numerical_gradient
from common.layers import *
from collections import OrderedDict

class TwoLayerNet():
    def __init__(self, input_size, hidden_size, output_size,weight_init_std=0.01):
        self.params = {}
        self.params['W1'] = np.random.randn(input_size, hidden_size) * weight_init_std
        self.params['b1'] = np.zeros(hidden_size)
        self.params['W2'] = np.random.randn(hidden_size, output_size) * weight_init_std
        self.params['b2'] = np.zeros(output_size)

        self.layers = OrderedDict()
        self.layers['Affine1'] = Affine(self.params['W1'], self.params['b1'])
        self.layers['Relu1'] = Relu()
        self.layers['Affine2'] = Affine(self.params['W2'], self.params['b2'])
        self.lastLayer = SoftmaxWithLoss()


    def forward(self, x):
        for layer in self.layers.values():
            x = layer.forward(x)
        return x
    def loss(self,x,t):
        y = self.forward(x)
        return self.lastLayer.forward(y,t)
    def accuracy(self,x,t):
        y = self.forward(x)
        y_pred = np.argmax(y, axis=1)
        acc = np.sum(y_pred == t) / x.shape[0]
        return acc
    def numerical_gradient(self, x, t):
        loss_f = lambda _ : self.loss(x,t)
        grads = {}
        grads['W1'] = numerical_gradient(loss_f,self.params['W1'])
        grads['b1'] = numerical_gradient(loss_f,self.params['b1'])
        grads['W2'] = numerical_gradient(loss_f,self.params['W2'])
        grads['b2'] = numerical_gradient(loss_f,self.params['b2'])
        return grads
    def gradient(self, x, t):
        self.loss(x,t)
        layers = list(self.layers.values())
        layers.reverse()
        dy = self.lastLayer.backward()
        for layer in layers:
            dy = layer.forward(dy)
        grads = {}
        grads['W1'],grads['b1'] = self.layers['Affine1'].dW,self.layers['Affine1'].db
        grads['W2'],grads['b2'] = self.layers['Affine2'].dW,self.layers['Affine2'].db
        return grads
5、深度学习学习技巧之梯度消失和梯度爆炸
梯度消失:在反向传播的时候,一开始梯度比较有效,越往前传播,梯度越来越小直至趋向于0,
这样意味着参数更新太慢,这种现象被称为“梯度消失”。
与之对应,如果我们进行一些特殊的调整(比如初始权重很大),可以让梯度反向传播时不会明显
减小,从而解决梯度消失的问题;然而这样一来,前面层的梯度又会变得非常大,引起网络不定,
无法再从训练数据中学习,这种现象被称为“梯度爆炸”。
怎么做:
改变神经网络结构(换激活函数,优化损失函数,ResNet,LSTM),增加限制(正则化,参数初始化,梯度裁剪设置阈值),优化学习算法(更新参数方法)
6、更新参数方法的优化
6.1、SGD的缺点
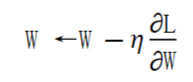
局部最优解:陷入局部最优,尤其在非凸函数中,难以找到全局最优解。
鞍点:陷入鞍点,梯度为 0,导致训练停滞(x ** 3的0点)。
收敛速度慢:高维或非凸函数中,收敛速度较慢。
学习率选择:学习率过大导致震荡或不收敛,过小则收敛速度慢。
#SGD
class SGD:
    def __init__(self,lr=0.01):
        self.lr = lr
    def update(self,params,grads):
        for key in params.keys():
            params[key] -= self.lr * grads[key]
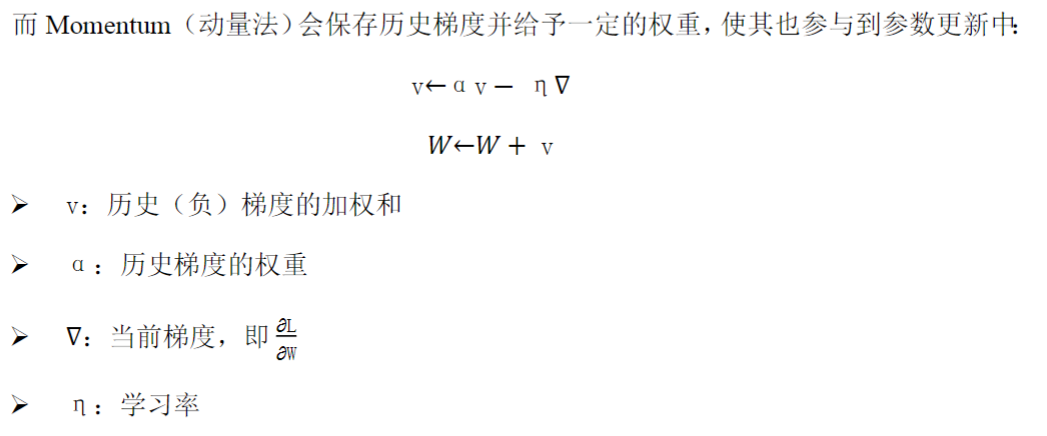
6.2、动量法Momentum
动量法有时能够减缓优化过程中的震荡,加快优化的速度。因为其会累计历史梯度,也可以有效避
免鞍点问题。
import numpy as np
#Momentum
class Momentum:
    def __init__(self,lr=0.01,momentum=0.9):
        self.lr = lr
        self.momentum = momentum
        self.v = None
    def update(self,params,grads):
        # 首先判断是否是第一次迭代,如果是,则对v做全0初始化
        if self.v is None:
            self.v = {}
            for key,val in params.items():
                self.v[key] = np.zeros_like(val)
        for key in params.keys():
            self.v[key] = self.momentum * self.v[key] - self.lr * grads[key]
            params[key] += self.v[key]
6.3、学习率衰减
学习率衰减是一种平衡策略,初期使用较大学习率快速接近最优解,后期逐渐减小学习率,使参数
更稳定地收敛到最优解。
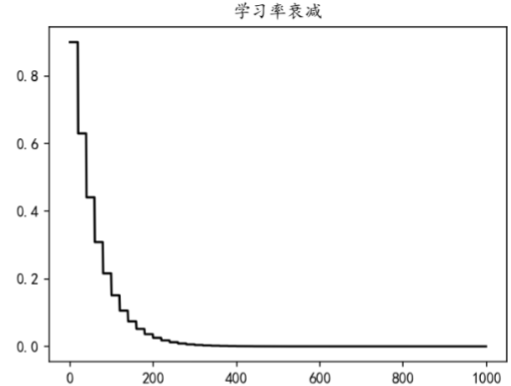
6.3.1、等间隔衰减
每隔固定的训练周期(epoch),学习率按一定的比例下降,也称为“步长衰减”。例如,使学习率
每隔20个epoch衰减为之前的0.7:
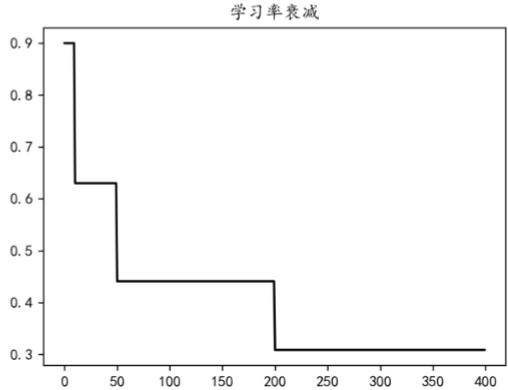
6.3.2、指定间隔衰减
在指定的epoch,让学习率按照一定的系数衰减。例如,使学习率在epoch达到[10,50,200]时衰
减为之前的0.7:
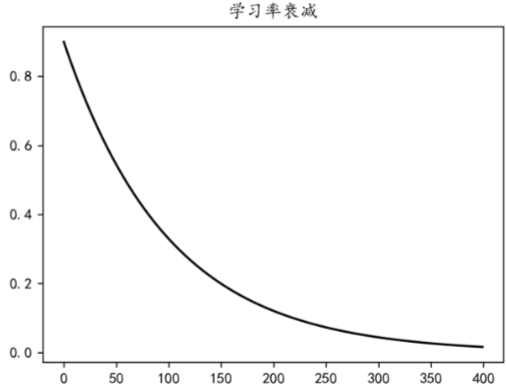
6.3.3、指数衰减
学习率按照指数函数 f(𝑥) = ax , 𝑎 < 1 进行衰减。例如,使学习率以 0.99 为底数,epoch为指数衰
减:
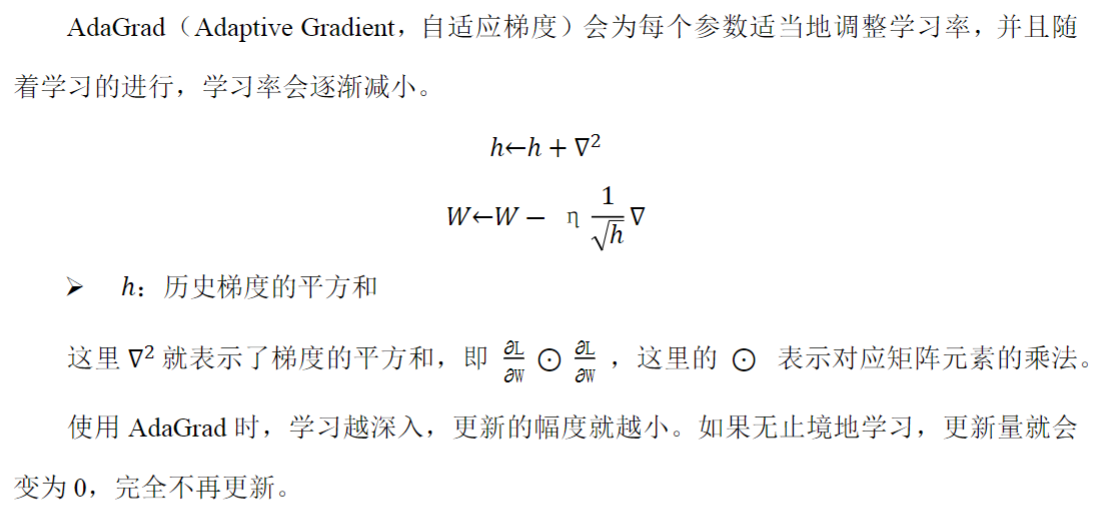
6.4、AdaGrad自适应梯度
Momentum是利用历史梯度直接影响梯度更新,AdaGrad是利用历史梯度影响学习率,从而影响梯
度更新。
#AdaGrad
class AdaGrad:
    def __init__(self,lr=0.01):
        self.lr = lr
        self.h = None
    def update(self,params,grads):
        if self.h is None:
            self.h = {}
            for key,val in params.items():
                self.h[key] = np.zeros_like(val)
        for key in params.keys():
            self.h[key] += grads[key] * grads[key]
            params[key] -= self.lr * grads[key] / (np.sqrt(self.h[key]) + 1e-8)
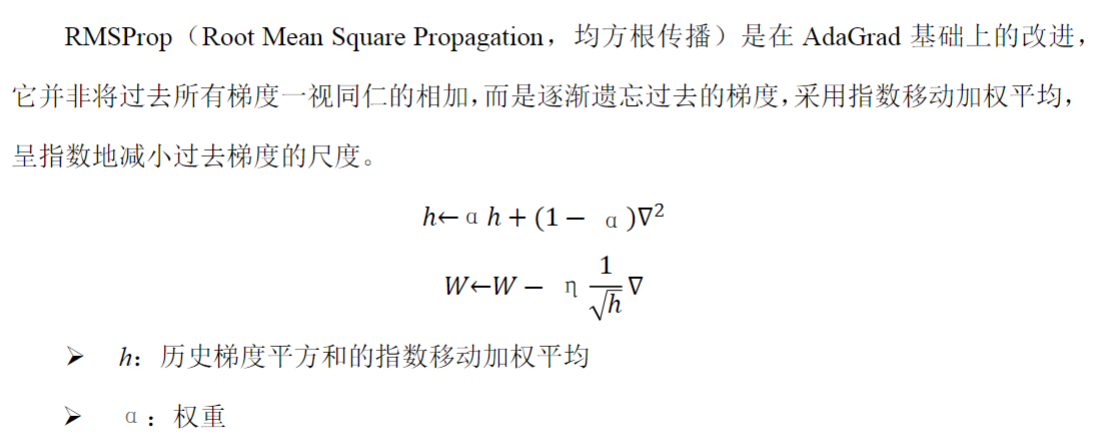
6.5、RMSProp均方根传播
#RMSProp
class RMSProp:
    def __init__(self,lr=0.01,decay=0.9):
        self.lr = lr
        self.decay = decay
        self.h = None
    def update(self,params,grads):
        if self.h is None:
            self.h = {}
            for key,val in params.items():
                self.h[key] = np.zeros_like(val)
        for key in params.keys():
            # self.h[key] = self.decay * self.h[key] + (1 - self.decay) * grads[key] * grads[key]
            # 也可以分两步走
            self.h[key] *= self.decay
            self.h[key] += (1 - self.decay) * grads[key] * grads[key]
            params[key] -= self.lr * grads[key] / (np.sqrt(self.h[key]) + 1e-8)
6.6、Adam自适应矩估计
Adam(Adaptive Moment Estimation,自适应矩估计)在工程应用中用的最多,融合了
Momentum 和 AdaGrad 的方法。
v是一阶矩,h是二阶矩。
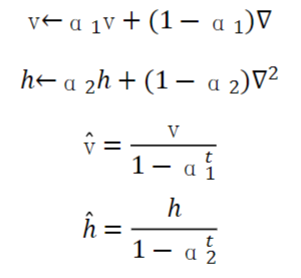
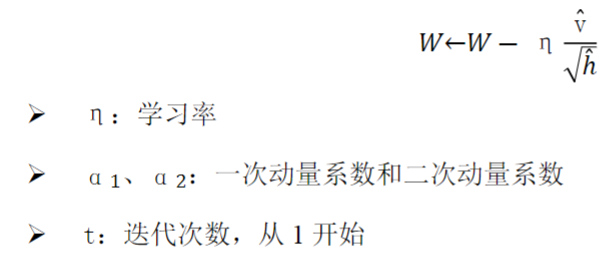
阿尔法1 = 0.9、阿尔法2 = 0.999
class Adam:
    def __init__(self,lr=0.01,beta1=0.9,beta2=0.999):
        self.lr = lr
        self.beta1 = beta1
        self.beta2 = beta2
        self.t = 0
        self.v = None
        self.h = None
    def update(self,params,grads):
        if self.v is None:
            self.v ,self.h = {},{}
            for key,val in params.items():
                self.v[key] = np.zeros_like(val)
                self.h[key] = np.zeros_like(val)
        self.t += 1
        # 将t对公式的修正影响,直接添加到学习率上
        lr_t = self.lr * np.sqrt(1 - self.beta2 ** self.t) / (1 - self.beta1 ** self.t)
        for key in params.keys():
            # self.v[key] = self.beta1 * (self.v[key]) + (1 - self.beta1) * grads[key]
            # self.h[key] = self.beta2 * (self.h[key]) + (1 - self.beta2) * (grads[key] ** 2)
            # 化简版本
            self.v[key] += (1 - self.beta1) * (grads[key] - self.v[key])
            self.h[key] += (1 - self.beta2) * (grads[key] ** 2 - self.h[key])
            params[key] -= lr_t * self.v[key] / (np.sqrt(self.h[key]) + 1e-8)
6.7、各种方法对比——代码实现
import numpy as np
import matplotlib.pyplot as plt
from common.optimizer import *
from collections import OrderedDict # 使用有序字典保存不同的优化器

def f(x,y):
    return x ** 2 / 20 + y ** 2

def f_grad(x,y):
    return x / 10, 2 * y

init_pos = (-7.0,2.0)
params,grads = {},{}

optimizers = OrderedDict()
optimizers['SGD'] = SGD(lr = 0.9)
optimizers['Momentum'] = Momentum(lr = 0.11,momentum = 0.85)
optimizers['AdaGrad'] = AdaGrad(lr = 1.5)
optimizers['Adam'] = Adam(lr = 0.5,beta1 = 0.5, beta2 = 0.999)

# 定义子图序号
idx = 1

for key in optimizers: # 遍历字典是默认遍历key,所以这里写什么单词都可以,只要上下文能对应就可以
    optimizer = optimizers[key]
    params['x'],params['y'] = init_pos[0], init_pos[1]
    # 用列表保存参数变化轨迹
    x_history,y_history = [],[]

    for epoch in range(30):
        x_history.append(params['x'])
        y_history.append(params['y'])
        grads['x'],grads['y'] = f_grad(params['x'],params['y'])
        optimizer.update(params,grads)

    # 确定子图
    plt.subplot(2,2,idx)
    idx += 1
    # 绘制等高线
    x = np.arange(-10,10,0.01)
    y = np.arange(-5,5,0.01)
    X,Y = np.meshgrid(x,y)
    Z = f(X,Y)
    Z[Z > 7] = 0
    plt.contour(X,Y,Z)
    # 单独画出最低点
    plt.plot(0,0,'+')
    plt.plot(x_history,y_history,'o-',color='red',markersize=2,label = key)
    plt.legend(loc='best')
plt.show()
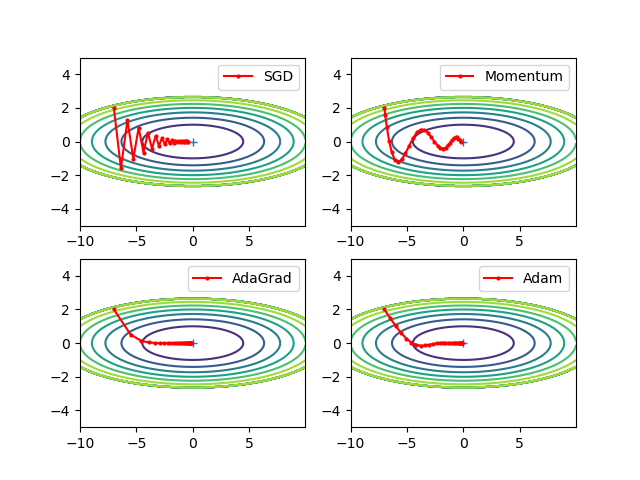
这里超参数要调节,是一个交叉验证的过程,beta1是往前冲一下的向量,是继承momentum的
7、参数初始化
我们选择哪个激活函数以及如何初始化参数,可以决定优化算法收敛的速度有多快;糟糕选择可能
会导致我们在训练时遇到梯度爆炸或梯度消失。
7.1、常数初始化
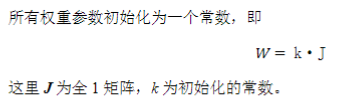
注意:将权重初始值设为 0 将无法正确进行学习。严格地说,不能将权重初始值设成一样的值。因
为这意味着反向传播时权重全部都会进行相同的更新,被更新为相同的值(对称的值)。这使得神
经网络拥有许多不同的权重的意义丧失了。为了防止“权重均一化”(瓦解权重的对称结构),必须
随机生成初始值。
7.2、秩初始化
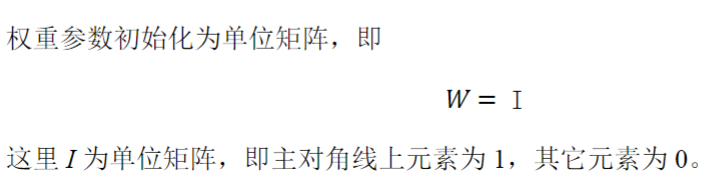
7.3、正态分布初始化
权重参数按指定均值μ与标准差 σ 正态分布初始化。因为不能直接将权重初始化为相同的常数,所
以需要对参数进行随机初始化。最常见的随机分布就是正态分布(也叫高斯分布),记作X ~ N(μ,
σ2)。
7.4、均匀分布初始化
权重参数在指定区间内均匀分布初始化。均匀分布一般记作X ~ U(a, b)。
7.5、Xavier初始化(Glorot初始化)
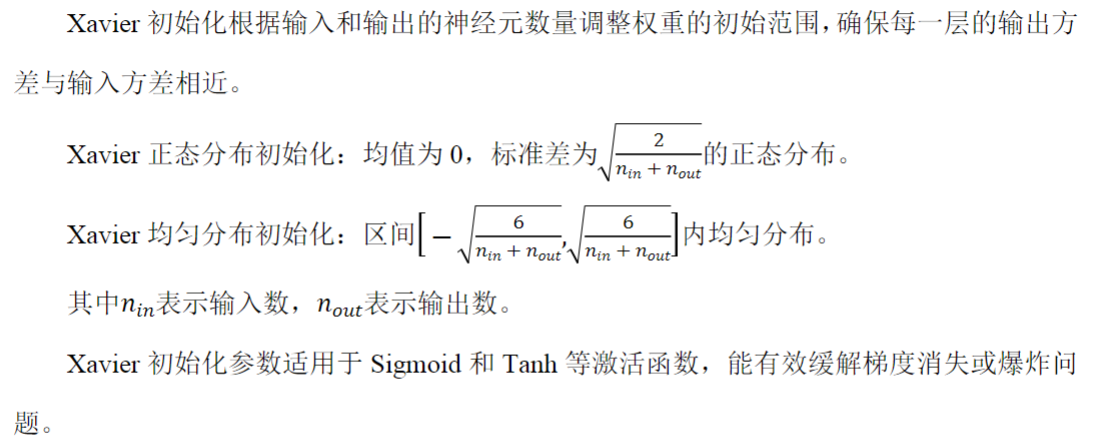
7.6、He初始化(Kaiming初始化)
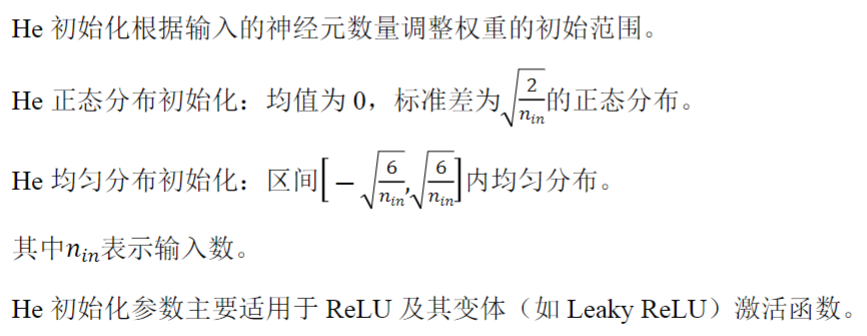
8、正则化
机器学习的问题中,过拟合 是一个很常见的问题。
过拟合指的是能较好拟合训练数据,但不能很好地拟合不包含在训练数据中的其他数据。机器学习
的目标是提高泛化能力,希望即便是不包含在训练数据里的未观测数据,模型也可以进行正确的预
测。因此可以通过 正则化 方法来抑制过拟合。
常用的正则化方法有 Batch Normalization、权值衰减、Dropout、早停法等。
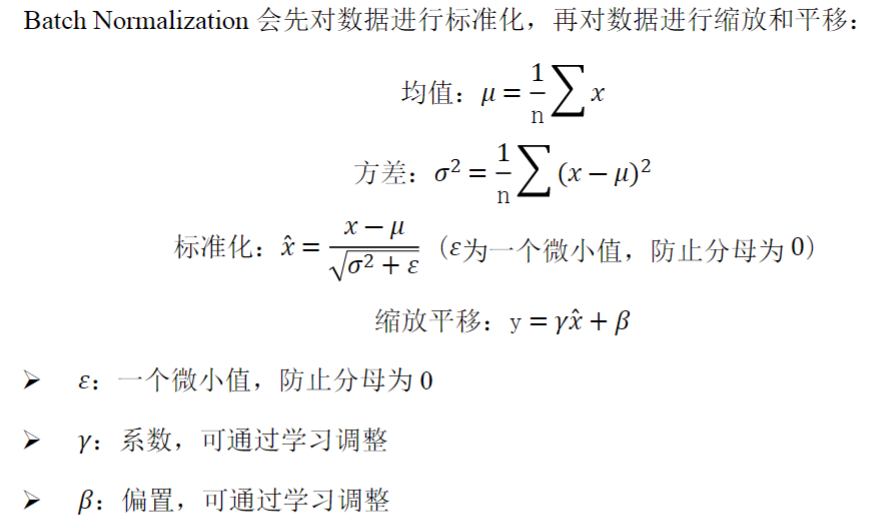
8.1、Batch Normalization批量标准化
Batch Normalization 最重要的目的,其实是调整各层的激活值分布使其拥有适当的广度,BN 层通
常放在线性层(全连接层/卷积层)之后,激活函数之前。它有着以下优点:
可以使学习快速进行(允许更高的学习率)
不那么依赖初始值(对于初始值不用那么神经质)
抑制过拟合(降低 Dropout 等的必要性)
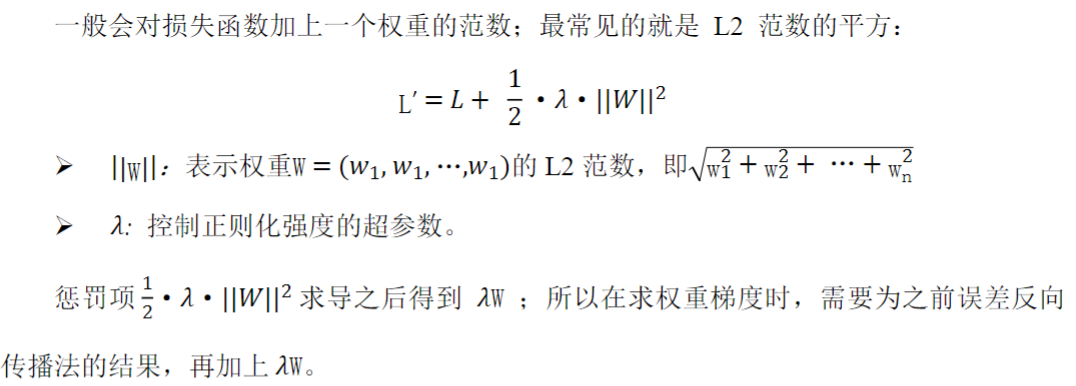
8.2、权值衰减
通过在学习的过程中对大的权重进行“惩罚”,可以有效地抑制过拟合,这种方法被称为权值衰减。
因为很多过拟合产生的原因,就是权重参数取值过大。
8.3、Dropout随机失活
训练时拟定一个超参数p,这个p是一个概率,以这个概率随机关闭一部分神经元,让我们的神经网
络节点变少,同时未被关闭的神经元的输出值以 1/(1 - p) 的比例进行缩放,以保持期望值不变;而
测试时通常不使用Dropout,即所有神经元保持激活状态并且不进行缩放。
Dropout 在全连接层和卷积层均适用,尤其对大规模网络效果显著。Dropout 通常放在激活函数之
后,线性层(全连接层/卷积层)之前,也就是说:Dropout 在“激活之后、下一层之前”
更多推荐


 2
 0
- 0


 已为社区贡献9条内容

所有评论(0)