
Pycharm连接Spark
·
本教程使用所有软件版本:pycharm 25.2 ,spark 3.4.2 ,hadoop 3.3.3
一 确认虚拟环境中已安装 pyspark
source /home/hadoop/.virtualenvs/PythonProject1/bin/activate
 pip show pyspark
运行结果如图:

如果没有安装,则安装百度进行完整安装,安装完成则到下一步。
二 使用Pycharm进行连接
2.1打开pycharm进行新建项目
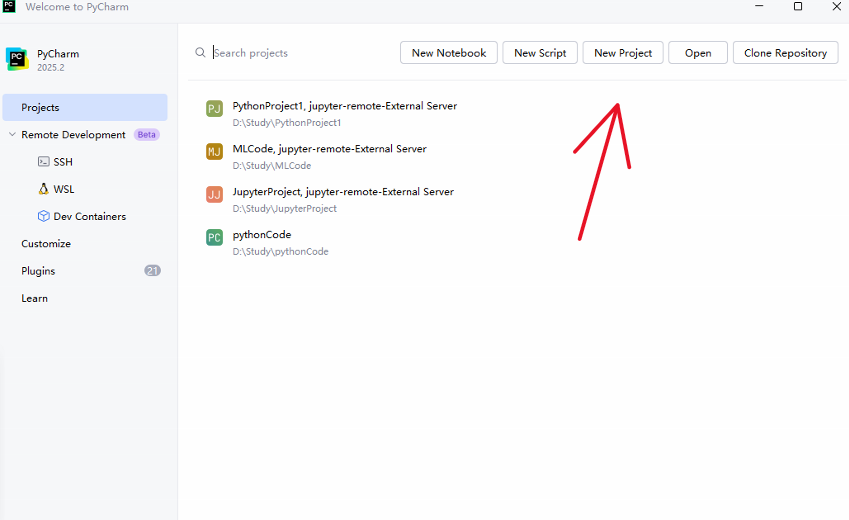
2.2 自行选一个python环境先将py项目建立起来,之后再做修改
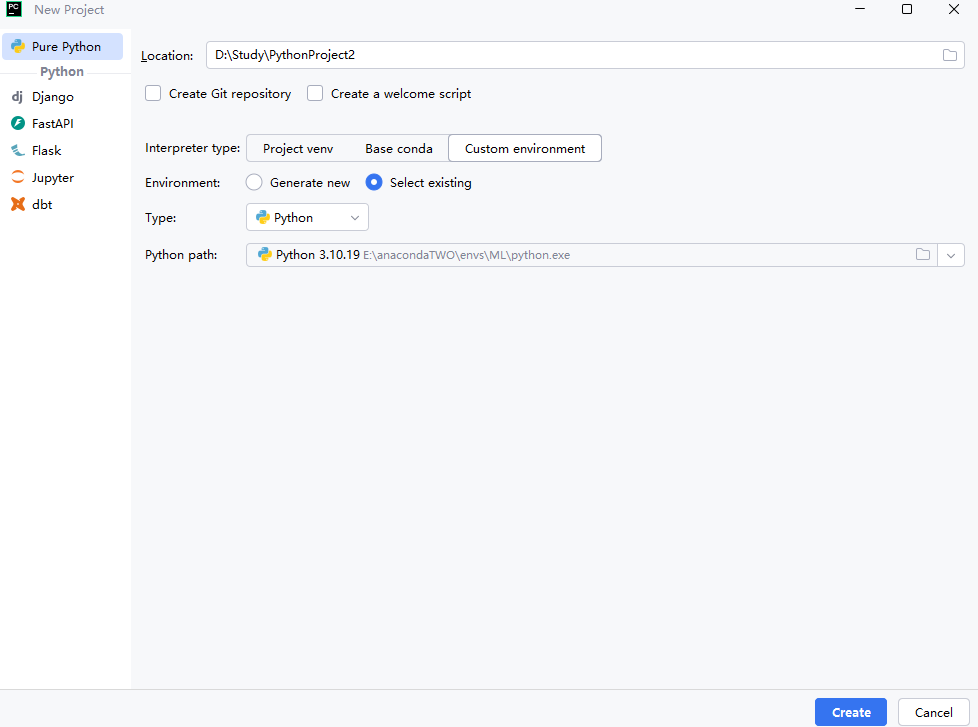
2.3 打开设置并且配置解释器
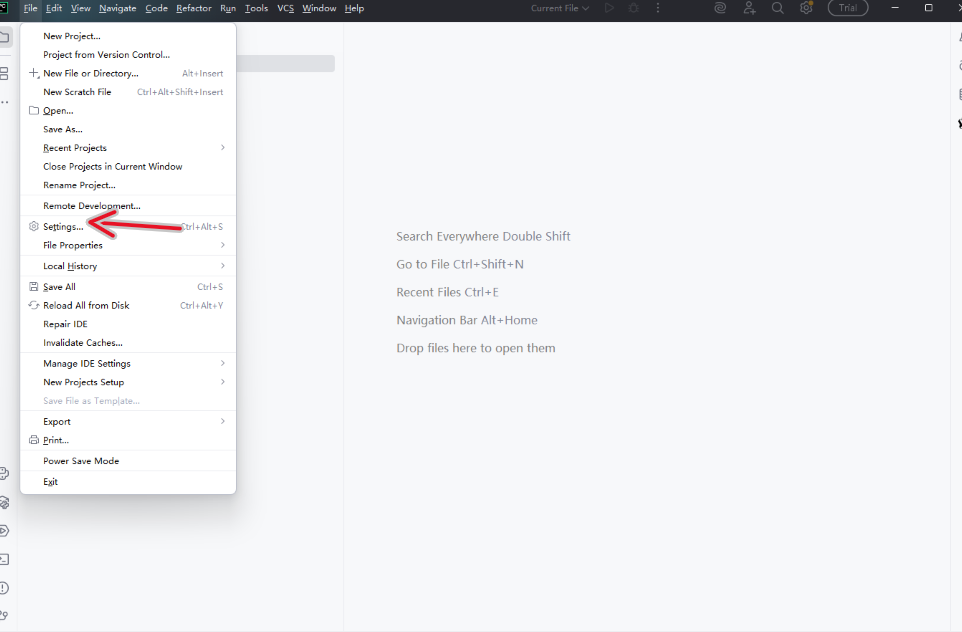
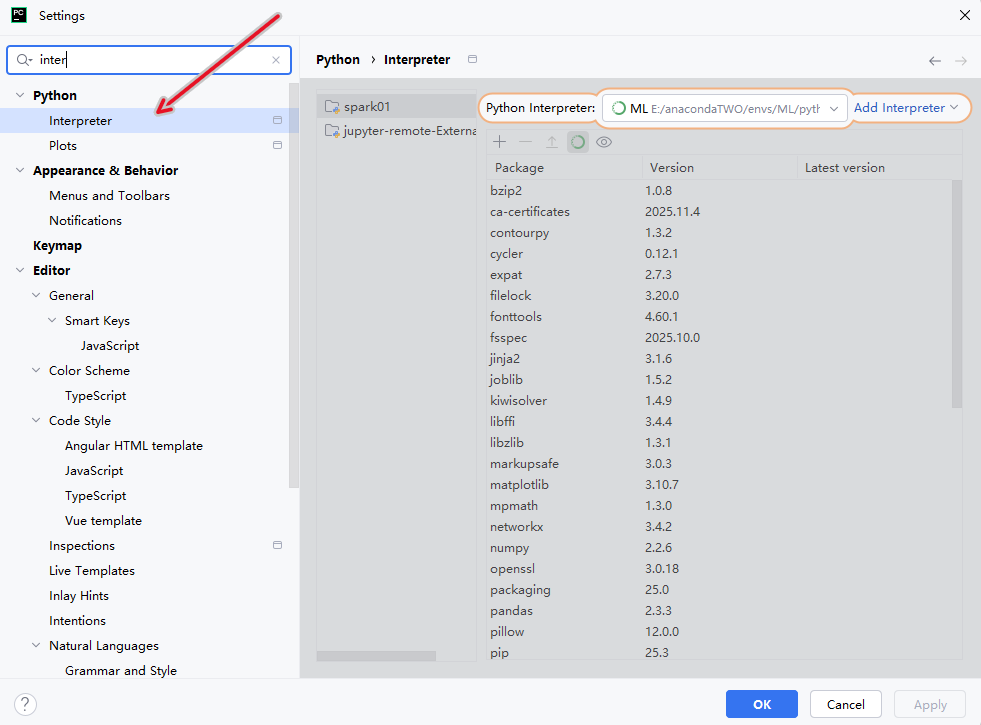
2.4 选择ssh进行远程连接
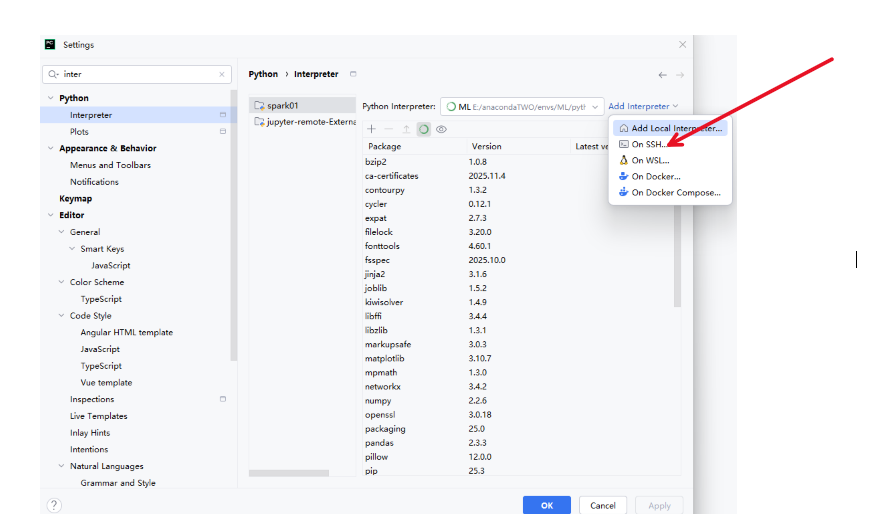
2.5 输入自己的虚拟机主机名以及密码,ip地址然后一路next
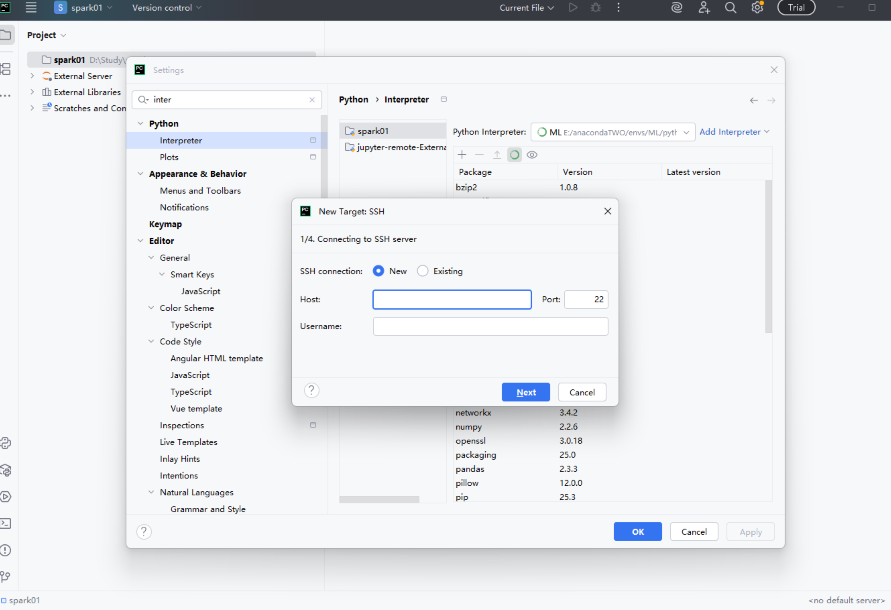
如果不知道主机名可以采用如下命令进行查看
ip addr show
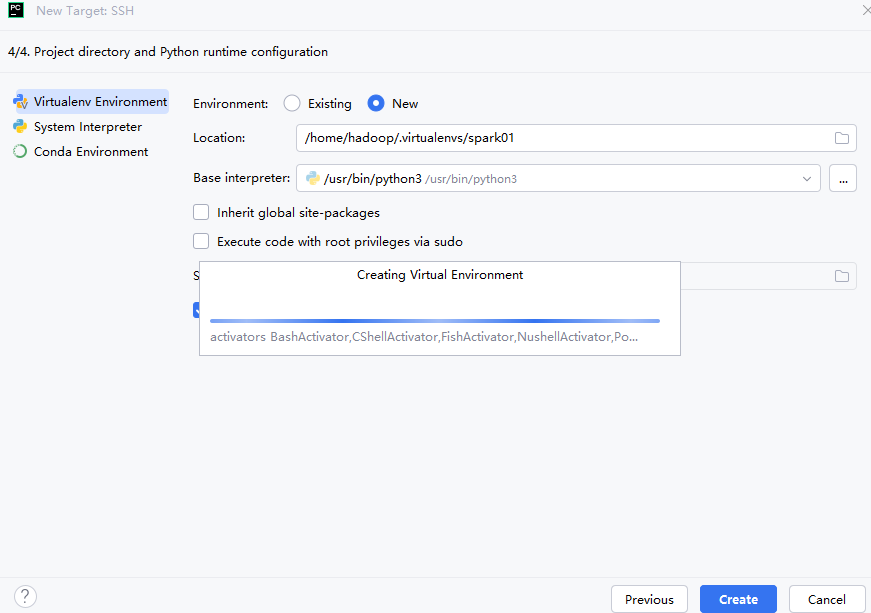
点击create创建
注意:若是连接不上,卡在第三步的service,首先检查主机名,密码是否输入正确,若还是不行,确保虚拟机允许ssh连接:
sudo apt install openssh-server -y
sudo systemctl start ssh
sudo systemctl enable ssh
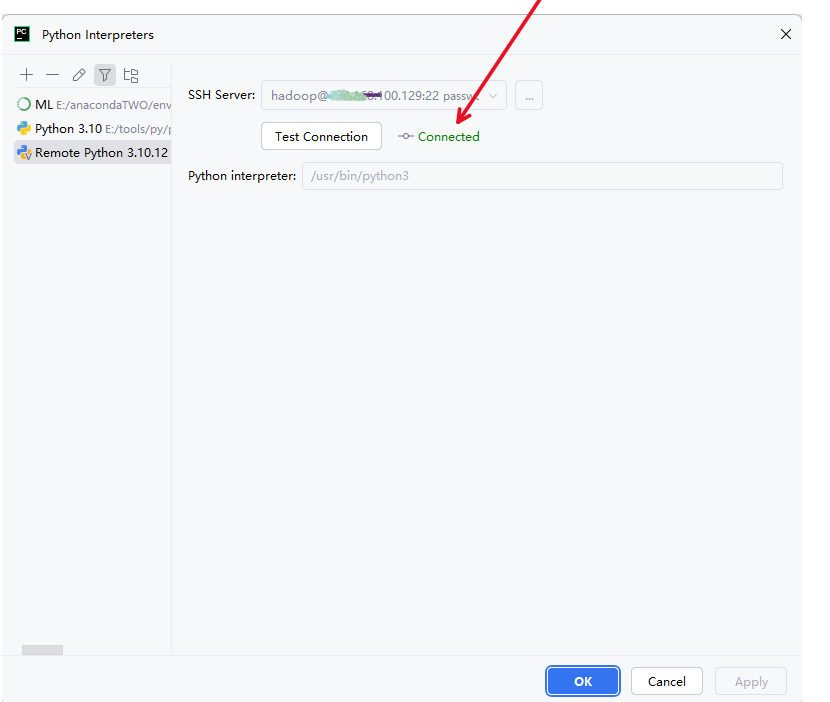
2.6 再次点击解释器查看是否连接成功(2.3)
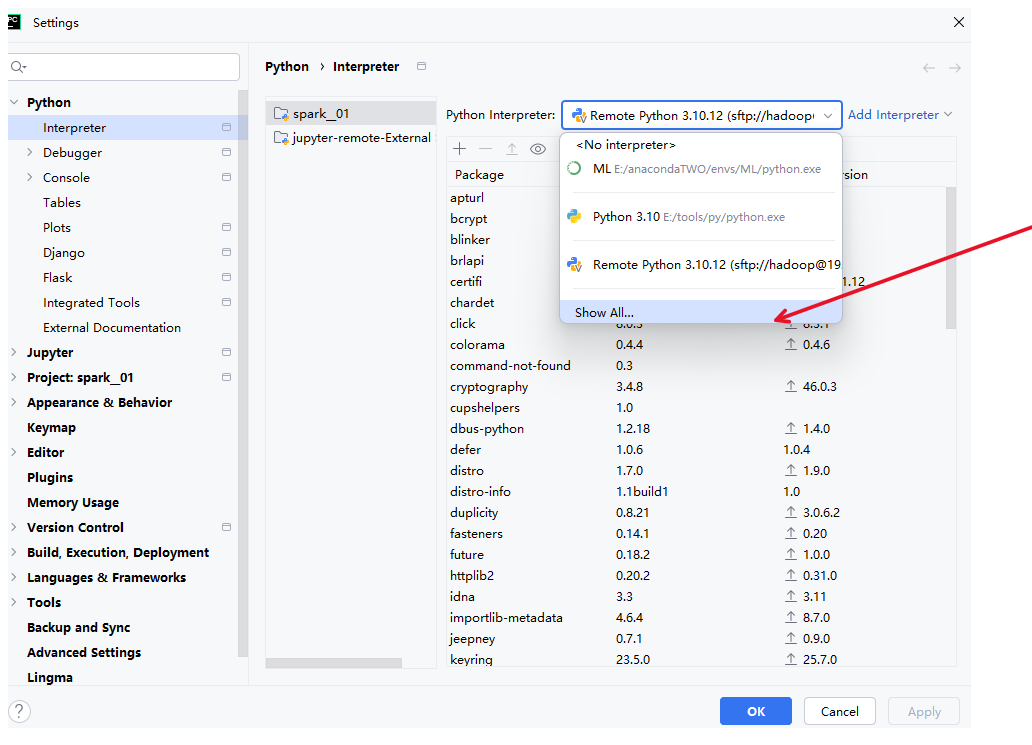
如下图连接成功
三 检验是否连接成功
- 打开 PyCharm。
- 点击底部工具栏 → Python Console(如果没有,可通过
View → Tool Windows → Python Console打开)。 - 在 Console 中逐行输入以下代码:
from pyspark.sql import SparkSession

spark = SparkSession.builder \
    .appName("ConsoleTest") \
    .master("local[*]") \
    .getOrCreate()

print("Spark version:", spark.version)
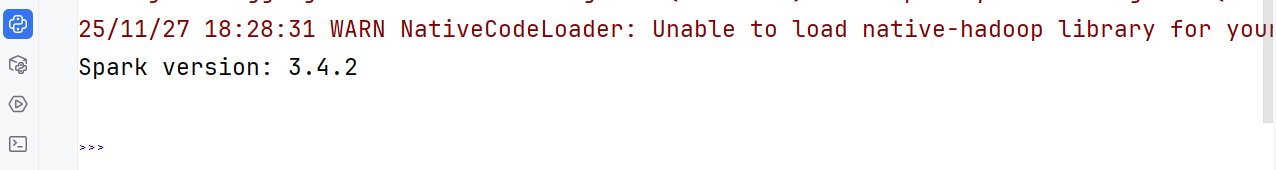
3.1若出现版本号,则连接成功,如图:
3.2 (没错直接跳到3.3.)若是显示缺少spark模块,可能是在使用虚拟机安装spark时使用了pip命令,没有下载完整的包,建议重新下载spark完整包,并解压在指定目录下,以下是我解决方案(也可以按照书上来):
使用华为云镜像:
wget https://mirrors.huaweicloud.com/apache/spark/spark-3.4.2/spark-3.4.2-bin-hadoop3.tgz
解压到 /opt
sudo tar -xzf spark-3.4.2-bin-hadoop3.tgz -C /opt/
配置环境变量
nano ~/.bashrc
在文件末尾添加:
# Spark 完整安装
export SPARK_HOME=/opt/spark
export PATH=$SPARK_HOME/bin:$PATH
export PYTHONPATH=$SPARK_HOME/python:$SPARK_HOME/python/lib/py4j-0.10.9.7-src.zip:$PYTHONPATH
✅ 第五步:生效配置 & 验证
source ~/.bashrc
spark-submit --version
你应该看到:
Welcome to
      ____              __
     / __/__  ___ _____/ /__
    _\ \/ _ \/ _ `/ __/  '_/
   /___/ .__/\_,_/_/ /_/\_\   version 3.4.2
      /_/

Using Scala version 2.12.18, OpenJDK 64-Bit Server VM, 11.0.xx
3.3若是前面都没错,则创建一个test项目跑一下如下代码,右键点击run:
# test_spark_console.py 或直接在 PyCharm Console 中运行

from pyspark.sql import SparkSession

# 创建 SparkSession(本地模式)
spark = SparkSession.builder \
    .appName("PyCharm-Spark-Test") \
    .master("local[*]") \
    .getOrCreate()

# 打印基本信息
print("🟢 Spark 连接成功!")
print(f"✅ Spark 版本: {spark.version}")
print(f"📍 运行模式: {spark.sparkContext.master}")

# 创建一个简单 DataFrame
data = [("Alice", 25), ("Bob", 30), ("Cathy", 35)]
columns = ["Name", "Age"]
df = spark.createDataFrame(data, columns)

# 显示数据
print("\n📊 示例 DataFrame:")
df.show()

# 执行一个简单计算
avg_age = df.selectExpr("avg(Age) as AverageAge").collect()[0]["AverageAge"]
print(f"\n📈 平均年龄: {avg_age:.2f}")

# 停止 Spark(如果是在脚本中运行;Console 中可不加)
# spark.stop()
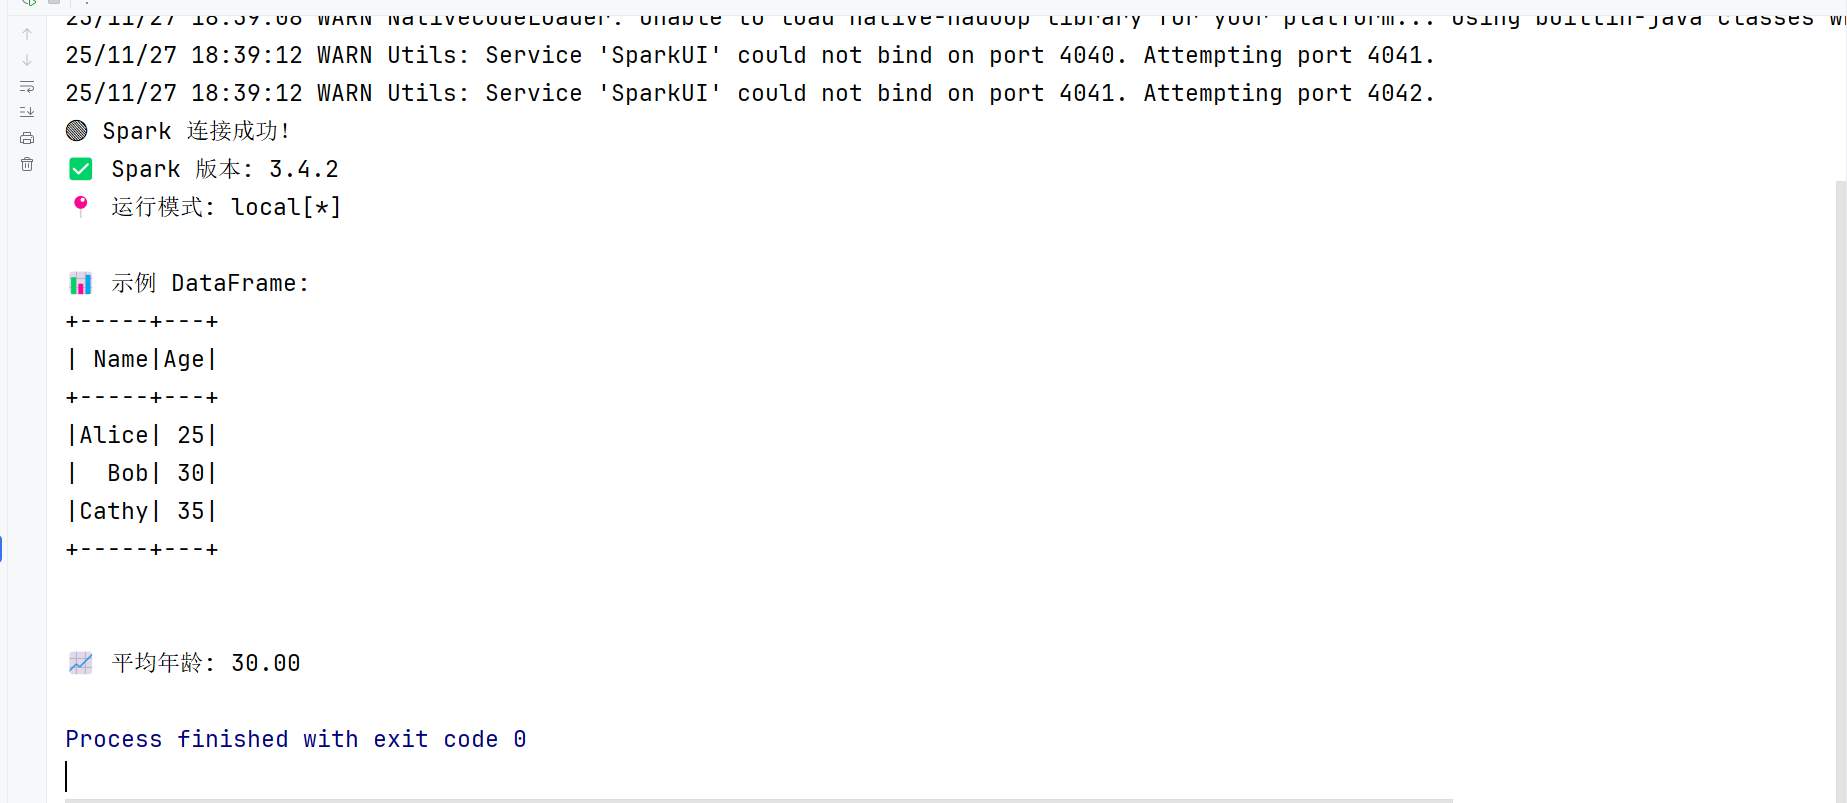
执行结果如下:
到这一步,🎉 恭喜你!现在你可以开始用 PyCharm + Spark 做数据分析、机器学习等任务了!
更多推荐


 5
 0
- 0


 已为社区贡献3条内容

所有评论(0)