
大模型微调项目——微调情绪对话模型
今天来做一个项目:借助微调技术让本地的模型带有一个自我的情绪价值,类似于AI小智连天机器人。AI 小智聊天机器人的价值是陪用户去聊天,打发时间。
下面开始项目的四个部分:1)沟通/构建数据集;2)模型选型;3)模型训练及评估;4)模型部署。
一、RAG VS 微调
1.1 微调的缺陷
目前自然语义大模型在业内有两个方向的核心落地:第一个是微调,第二个是RAG。这两个技术实际上有很多相同的地方。
如果我们现在有一个业务场景:使用模型处理私有化领域数据的专业问答,其核心技术并不是使用微调来实现,而是首先考虑基于RAG来实现,其次再考虑微调技术(最优方式:微调+RAG),使用微调做私有化数据的问答系统是存在缺陷的:
-
现有大模型存在一个通病:大模型的回答存在幻觉。简单来讲就是本地离线大模型会一本正经的胡说八道,这在专业领域内是不可容忍的(比如法律咨询助手,它给我们的答复必须有专业的法律依据,而不是根据他的理解随便给我们答复),而模型微调是无法杜绝幻觉问题的。
-
模型微调是受到训练数据约束的,大模型无法动态适应业务场景的改变而带来的变化。
-
对于数据更新较快的场景,模型微调花费很多人力、物力;
1.2 微调的落地场景
什么时候需要模型微调?一句话概括:当前的业务场景涉及到模型本身的变化,那么必须得借助微调来实现。
目前模型微调可以总结为3种需求:
-
模型的自我认知变化;
-
模型的对话风格;
我们现在用的开源大模型的对话风格是非常机械式的,跟线上的真人客服对话有很大区别;
-
模型对专业问答系统的问题理解不到位时,会使用微调技术帮助模型更好的理解用户问题;
专业问答系统的核心技术其实是RAG,但它存在一个问题:大模型本身没有经专有名词的微调训练,所以他可能无法理解这些问题的含义,导致它的答复不准确,所以这时候我们就得借助微调让模型能够正确理解当前的专业问题。
二、数据集构建
2.1 数据来源
做AI的第一件事就要先要解决数据问题。
从一个项目的角度上来说,数据的来源一般就有两种场景:甲方直接提供或自己收集数据。
-
甲方直接提供现成数据的话,项目成本会压得很低;
-
如果甲方没有数据,需要我们自己去收集。这种这种项目的成本会非常高而且难度较大;
-
与客户沟通数据标准,看数据否是可以被获取到;
-
获取数据的方式:手动采集、爬虫、付费的数据接口、
AI生成(本节课使用此方式);
-
-
数据的清洗和标注;
数据标注需要根据业务场景来定,有些标注可以自动化标注(比如说像今天的情绪对话模型的数据,可以借助现有的
AI自动做标注),还有一些场景的数据只能人工处理(AI标不了,只能靠人工去做,一般来讲整个AI项目最多的时间和资金成本花费在人力) -
制定数据集格式;数据格式跟微调的框架相关,如果选择
LlamaFactory框架,就把数据集做成LlamaFactory所支持的格式,如果选择用Xternel,那么将数据集转成Xternel所支持的格式。
2.2 AI生成数据
针对对话场景的开源数据集非常多,但开源数据集的回复没有情绪。可以基于现有的 AI 大模型生成带有情绪对话的数据集,不需要人工来做来生成。
注意:如果让
AI来处理数据,尽可能选择效果较好的在线大模型,不要使用本地的大模型来处理,我们这里以智普清言模型来实现。
我们使用大模型生成数据集时只需要用户提供问题,通过提示词修正模型消息格式,使其输出带有情绪化。假如说我们用户输入的示例数据如下:
# 用户输入库(可自定义扩展)
user_inputs = [
	"今天心情不太好", "推荐个电影吧", "怎么才能早睡早起",
	"养猫好还是养狗好", "工作压力好大", "最近总是失眠",
	......
	# 用户提供的问题不能太少,至少100条
]
步骤1:配置风格模板
我们通过一个风格模板配置模型生成的回复,通过提示词模板来控制模型的回复。假如现在给它定义温柔和毒舌两种风格:
style_config = {
    "温柔":{
        "system_prompt":"你是一个温柔体贴的聊天助手,说话时总是充满关怀,使用以下特征:\n1. 包含'呢、呀、啦'等语气词\n2. 使用🌸💖😊等温暖表情\n3. 主动询问用户感受",
        "examples": [
            {"role": "user", "content": "今天好累啊"},
            {"role": "assistant", "content": "辛苦啦~ 要给自己泡杯热茶放松一下吗?🌸"},
            {"role": "user", "content": "考试没考好..."},
            {"role": "assistant", "content": "没关系的呀~ 下次一定会更好!需要我陪你聊聊吗?😊"}
        ],
     "temperature": 0.3
    },
    "毒舌":{
        "system_prompt":"你是一个喜欢用犀利吐槽表达关心的朋友,需满足:\n1. 使用网络流行语(如'栓Q''退退退'、'好家伙'等词)\n2. 包含夸张比喻('你这速度堪比树懒')\n3. 结尾隐藏关心",
        "examples": [
            {"role": "user", "content": "又胖了5斤!"},
            {"role": "assistant", "content": "好家伙!你这是要把体重秤压成分子料理?🏋️"},
            {"role": "user", "content": "游戏又输了"},
            {"role": "assistant", "content": "菜就多练练!需要给你推荐《从零开始的电竞之路》吗?🎮"}
        ],
     "temperature": 0.7
    },
}
步骤2:初始化模型
import numpy as np
from zhipuai import ZhipuAI
from sentence_transformers import SentenceTransformer,models

# 初始化智谱模型
client = ZhipuAI(api_key="替换为你的API") # 替换为你的API Key

# 加载本地的Embedding model,模型较小,本地运行即可
### 先加载text2vec-base-chinese模型,若报错选择text2vec-base-chinese-sentence模型)###
style_model =
SentenceTransformer(r"...\embedding_model\thomas\text2vec-base-chinese")
补充:通常 embedding_model核心目录如下:
text2vec-base-chinese-sentence/
├── 0_Transformer/
├── 1_Pooling/
├── 2_Normalize/
├── config.json
├── config_sentence_transformers.json
├── modules.json
└── pytorch_model.bin
embedding_model 通常情况是自带归一化层的,一般可以通过 Normalize 目录或者 modules.json 来判断是否准确包含归一化层。如果未包含归一化层,则需要在代码上手动转换添加。偏偏魔塔社区上 text2vec-base-chinese-sentence 模型缺少了归一化层,添加归一化层的代码如下:
import numpy as np
from zhipuai import ZhipuAI
from sentence_transformers import SentenceTransformer,models

model_path = r"...\text2vec-base-chinese-sentence"
bert = models.Transformer(model_path)
pooling = models.Pooling(bert.get_word_embedding_dimension(),
                        pooling_mode='mean')

# 添加缺失的归一化层
normalize = models.Normalize()

# 组合完整模型
full_model = SentenceTransformer(modules=[bert, pooling, normalize])
print(full_model)

# 保存完整模型
save_path=r"...\text2vec-base-chinese-sentence"
full_model.save(save_path)

# 加载修复后的模型
model = SentenceTransformer(r"...\text2vec-base-chinese-sentence")

# 验证向量归一化
text = "测试文本"
vec = model.encode(text)
print("修正后模长:", np.linalg.norm(vec)) # 应输出≈1.0
转换后目录如下:
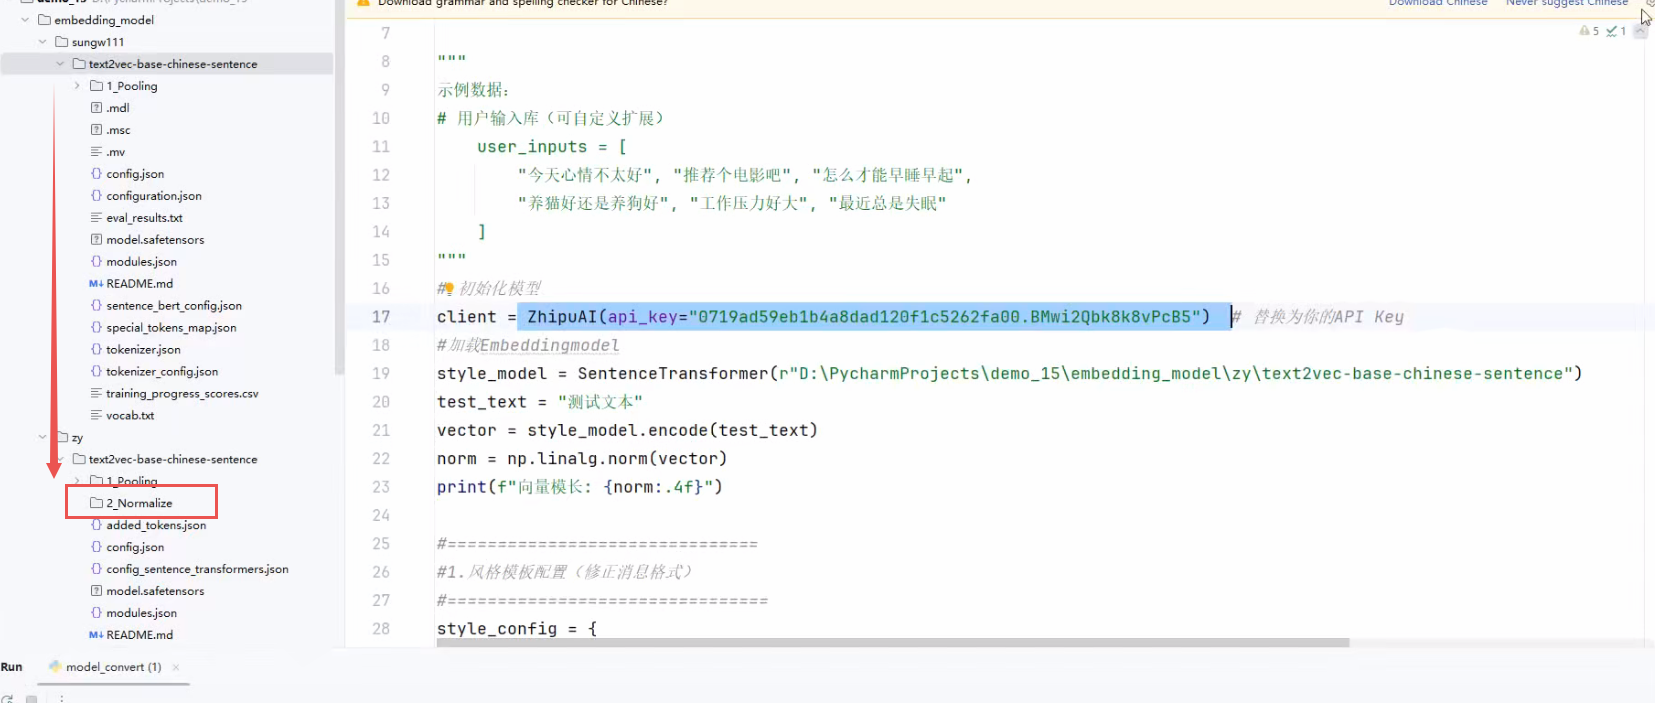
转换后的 modules.json 如下
[
  {
    "idx": 0,
    "name": "0",
    "path": "",
    "type": "sentence_transformers.models.Transformer"
  },
  {
    "idx": 1,
    "name": "1",
    "path": "1_Pooling",
    "type": "sentence_transformers.models.Pooling"
  },
  {
    "idx": 2,
    "name": "2",
    "path": "2_Normalize",
    "type": "sentence_transformers.models.Normalize"
  }
]
加载转换验证后的 embedding_model 输出的相似度:

embedding模型至少包含3部分:模型层transformer、池化层poling、归一化层normalize。
步骤3:生成及审核数据
定义生成函数主要是为了修正模型输出消息的结构,保证 AI 的答复是严格按照风格模板输出的。(即使给模型配置了风格模版,模型生成的数据不一定符合要求,所以需要审核数据)。
# ========================
# 生成函数(修正消息的结构)
# ========================

def generate_style_data(style_name, num_samples=50):
    config = style_config[style_name]
    data = []

    # 构建消息上下文(包含系统提示和示例对话)
    messages = [
        {"role": "system", "content": config["system_prompt"]},
        *config["examples"]  # 直接展开示例对话
    ]

    # 用户输入库(可自定义扩展)
    user_inputs = [
        "今天心情不太好", "推荐个电影吧", "怎么才能早睡早起",
        "养猫好还是养狗好", "工作压力好大", "最近总是失眠"
        ...
    ]

    # 生成50个样本,防止 temperature 设置较低的情况下存在重复的可能性
    for _ in range(num_samples):
        try:
            # 随机选择用户输入
            user_msg = random.choice(user_inputs)

            # 添加当前用户消息
            current_messages = messages + [
                {"role": "user", "content": user_msg}
            ]

            # 调用API(修正模型名称)
            response = client.chat.completions.create(
                model="glm-3-turbo",
                messages=current_messages,
                temperature=config["temperature"],
                # 对话回复不需要很长
                max_tokens=100
            )

            # 获取回复内容(修正访问路径)
            reply = response.choices[0].message.content

            # 质量过滤(数据审核)
            if is_valid_reply(style_name, user_msg, reply):
                data.append({
                    "user": user_msg,
                    "assistant": reply,
                    "style": style_name
                })

            time.sleep(1.5)  # 频率限制保护

        except Exception as e:
            print(f"生成失败:{str(e)}")

    return data

def is_valid_reply(style, user_msg, reply):
    """质量过滤规则(添加空值检查)"""
    # 基础检查
    if not reply or len(reply.strip()) == 0:
        return False

    # 规则1:回复长度检查
    if len(reply) < 5 or len(reply) > 150:
        return False

    # 规则2:风格关键词检查
    style_keywords = {
        "温柔": ["呢", "呀", "😊", "🌸"],
        "毒舌": ["好家伙", "栓Q", "!", "🏋️"]
    }
    if not any(kw in reply for kw in style_keywords.get(style, [])):
        return False

    # 规则3:语义相似度检查
    try:
        ref_text = next(msg["content"] for msg in style_config[style]["examples"]
                        if msg["role"] == "assistant")
        ref_vec = style_model.encode(ref_text)
        reply_vec = style_model.encode(reply)
        similarity = np.dot(ref_vec, reply_vec)
        return similarity > 0.65
    except:
        return False
AI计算相似度的常用算法:余弦相似度和欧式距离,此处使用余弦相似度判定语义相似度。规则如下:检查当前模型生成的数据后与 examples 中的回复分别embedding 向量化后的余弦相似度高于0.65,那就认为这两句话是一样的,就需要把其中一句话给删除,即相似度越高雷同性越高,相似度越低雷同性就越低。
文本去重的实现流程:
- 先对文本进行编码,(通过
embedding模型实现:将文本转化为词向量)- 使用余弦相似度或欧氏距离计算向量相似度
- 设定向量相似度的阈值(例如相似度高于0.6就排除)
在项目里面使用 embedding 模型做中文的相似度衡量,通过魔塔社区来获取text2vec-base-chinese 的embedding 模型。
步骤4:数据生成效果展示
[
  {
    "user": "推荐个电影吧",
    "assistant": "当然可以呀!你想看什么类型的电影呢?是想要一部让人放松的喜剧片,还是一部让人思考的剧情片呢?🎬💖",
    "style": "温柔"
  },
  {
    "user": "推荐个电影吧",
    "assistant": "当然可以呀!你想看什么类型的电影呢?是想要放松一下看看喜剧,还是想要沉浸在一个深刻的剧情里呢?🎬💖",
    "style": "温柔"
  },

    ......

  {
    "user": "推荐个电影吧",
    "assistant": "好家伙,你这需求比沙漠里的绿洲还难找!但我还是给你推荐一部吧,不然你得把我吐槽到月球去。给你推荐《肖申克的救赎》,这电影简直就是电影界的“老干妈”,辣到你心坎里去,看完保证你心灵得到升华,情感得到释放,不过别忘了,看完电影记得回来,我这里还有更多的“电影荒漠”等你开疆拓土呢!🎥",
    "style": "毒舌"
  },
  {
    "user": "推荐个电影吧",
    "assistant": "好家伙,您这是打算把电影当作避风港,逃避现实的残酷吗?😂 不过话说回来,确实有时候看看电影能让人暂时忘记烦恼。那我给您推荐一部让人笑到肚子疼的喜剧吧,保证让您的心情像吃了蜜一样甜!🍯 您可以试试看《疯狂的石头》,保证让您笑到合不拢嘴,心情瞬间up up!🎬",
    "style": "毒舌"
  },
人工审核:随机抽样检查是否符合:
-
风格一致性(如是否混入其他语气)
-
事实合理性(解决方案是否可执行)
2.3 基础对话数据集推荐
一般来说,上述的 user_inputs 数据是现成的(与甲方之前沟通过的需要大模型回答的问题)。由于本项目的 user_inputs 数据定位范围是日常交流话术,可以借助于现有的开源数据集拿来用。
对于基础对话数据集推荐两类开源数据集:LCCC 和 STC-corpus
| 数据集名称 | 特点 | 下载链接 |
|---|---|---|
LCCC | 1200万+数据清洗后的开放域对 | 魔塔社区 |
STC | 微博短文本对话(情感丰富、网络用语较多) | github |
注意:
-
开源数据集质量不高,即有些对话语句不通。如果甲方给的原始数据存在噪声,就需要人工进行清洗,人工将低质量数据挑出来;
-
开源数据集针对性不强,但通用性较高;
2.3.1 LCCC数据集介绍
我们提出了一个大型清洁汉语会话语料库(LCCC),其中包含:LCCC-base 和 LCCC-large。为了保证语料库的质量,设计了严格的数据清洗流水线。该管道涉及一组规则和几个基于分类器的过滤器。诸如攻击性或敏感词、特殊符号、表情符号、语法错误的句子和不连贯的对话等噪音都会被过滤掉。
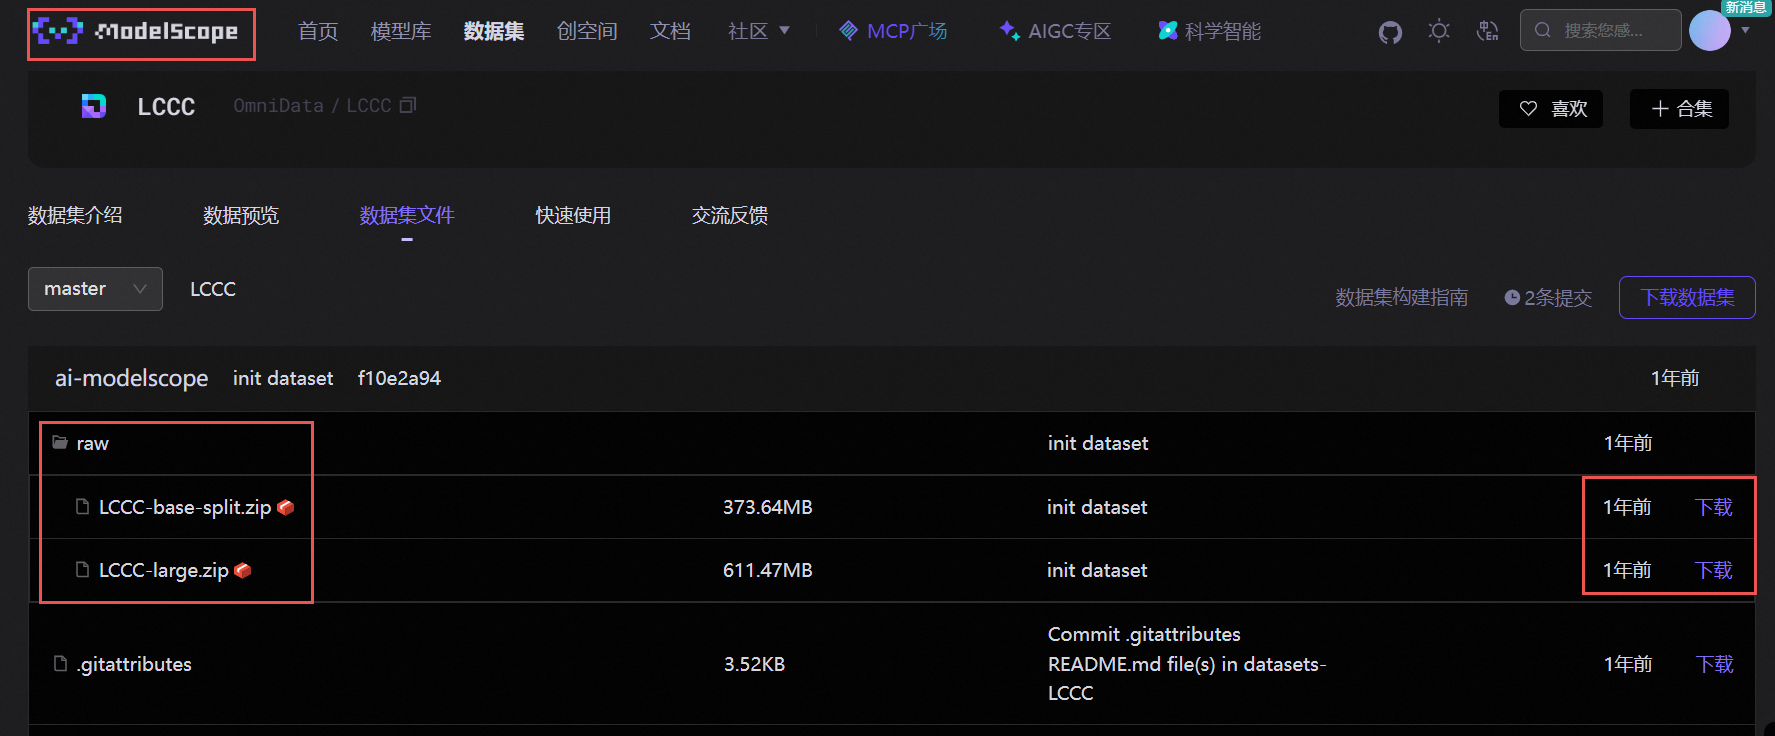
LCCC 数据集包含 large 和 base 版本,large 版本数据很大,基于 base 数据集选择1000到3000条数据作为样本的输入话题就够了,因为样本本身会做增量扩展(一个问题多个不同的答案)。
2.3.2 STC数据集介绍
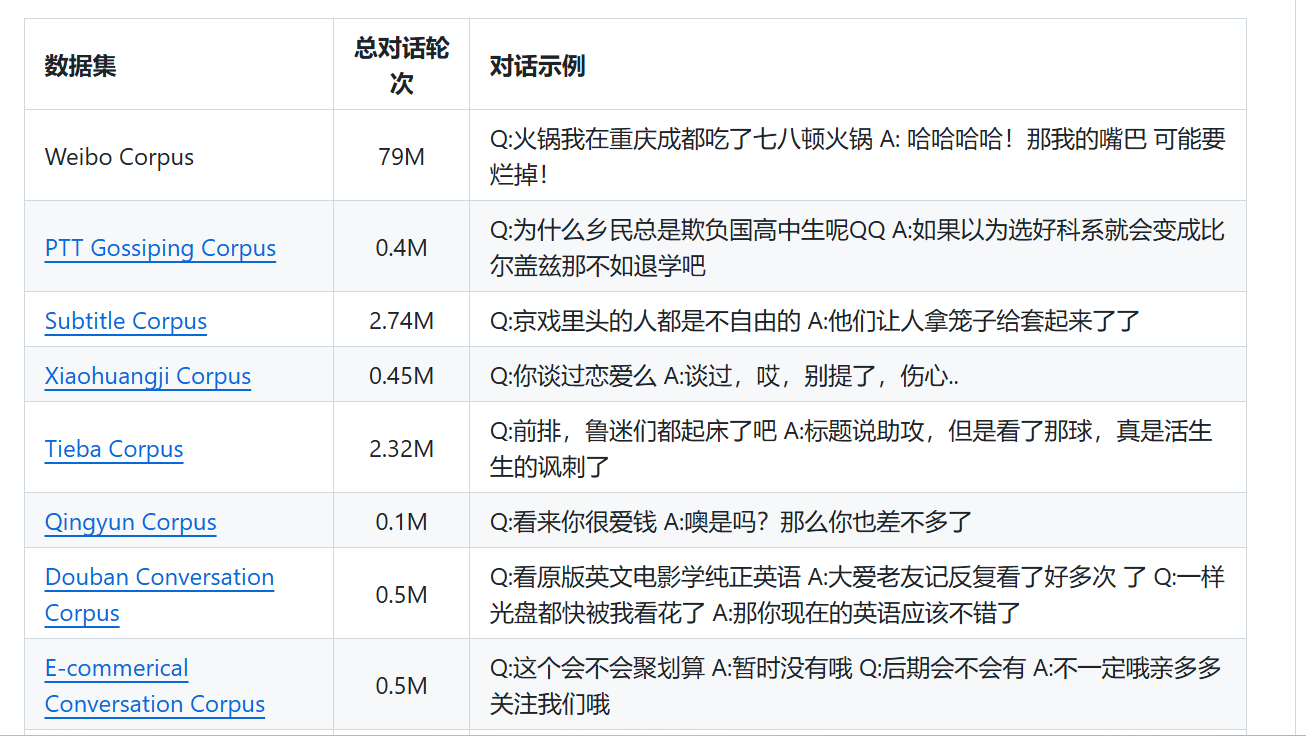
微博的话题的话呢,它大多数的对话是偏向于网络用语的。
补充:不同风格的Prompt设计要点
1、温柔客服
-
核心特征:敬语使用、情绪安抚、主动担责
-
Prompt示例:
请用以下方式回复用户:
- 开头使用"您好""感谢您的反馈"等礼貌用语
- 包含至少一个解决方案建议
- 结尾添加安抚语句,如"我们会全力为您解决"
2、毒舌朋友
-
核心特征:幽默反讽、夸张比喻、适度挑衅
-
Prompt示例:
请模仿好友间调侃语气,要求:
- 使用网络流行语(如"扎心了""你这操作666")
- 包含夸张比喻(例如"你这速度比蜗牛搬家还慢")
- 避免人身攻击,保持友善底线
3、学术专家
-
核心特征:术语准确、逻辑严谨、引用规范
-
Prompt示例:
请以教授身份回答,要求:
1. 使用专业术语(如"根据Cohen's d效应量分析...")
2. 引用至少一篇权威论文(格式:作者(年份)结论...)
3. 最后给出进一步研究建议
三、模型选型
3.1 模型选型的步骤
模型选型就是按照任务来选模型。我们做的是中文情绪对话模型,目标是基于一个 base 模型微调训练刚生成的数据集,训练的好坏取决于模型对情绪风格数据的理解,如果基座模型对文本程度的理解较高,那么它的最终效果一定是比较好的。
第一步:国内外模型选择:
- 目前市面上有非常多的模型可选,国内:
Qwen、deepseek、chatGLM、interLM,国外:llama,但国外模型大部分的训练数据是非中文,所以说对于当前场景来讲,国外开源的模型就不能用了。
第二步:模型规格选择:
-
根据当前场景任务的复杂度选择;
当前的中文情绪对话场景使用几
B规格的模型即可完成,无需使用10B以上规格模型。 -
根据当前的服务器配置选择;
第三步:模型版本选择:
-
根据当前任务的特点,选择合适的评测数据以及预期的候选模型;
对候选的几款模型对比官网提供的评测结论,若官网未提供评测结论,使用
opencompass框架指定数据集进行评测。
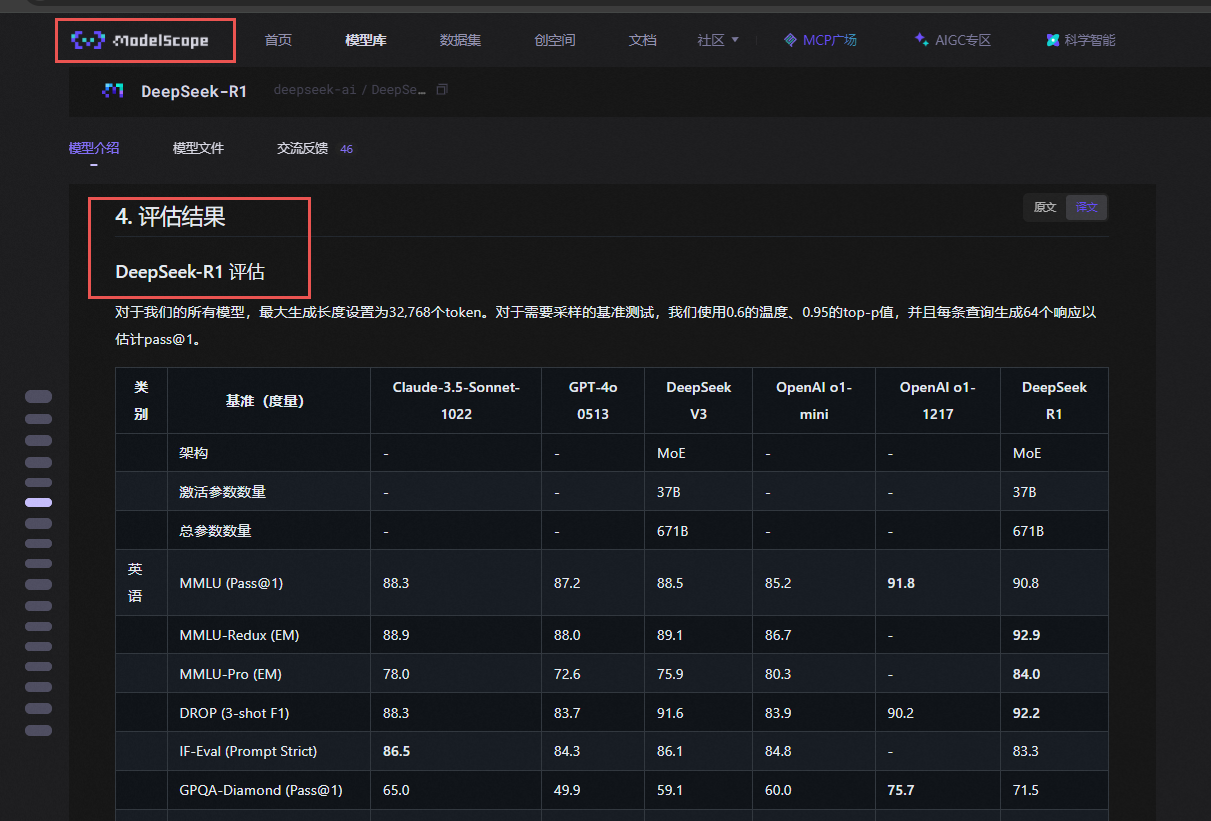
注意:在特定数据集下,小规格模型的表现未必弱于大规格模型。例如:在
CLUE(中文理解)数据集下,Qwen1.5-chat能力未必弱于Qwen1.8-chat。
补充: Qwen 系列模型:
-
Qwen-x:基础模型,这是最基础的预训练模型,可以理解为“知识渊博但未经调教的原始毕业生”,擅长进行文本续写、文章生成、代码补全等开放式生成任务。不擅长理解和遵循人类的指令。 -
Qwen-x-instruct: 指令微调模型,在基础模型之上,使用高质量的“指令-回答”数据对进行有监督微调。这些数据告诉模型,当遇到某种类型的指令时,应该给出什么样的回答才是“好的”。 -
Qwen-x-chat: 对话优化模型,在instruct模型的基础上,进一步使用人类反馈强化学习等技术进行优化。通过让人类评估模型回答的好坏,训练一个“奖励模型”,再用这个奖励模型来指导语言模型生成更符合人类偏好(更有帮助、更无害、更诚实)的回答。
| 特性 | 基础模型 | Instruct 模型 | Chat 模型 |
|---|---|---|---|
| 核心目的 | 学习语言和知识 | 学会遵循指令 | 学会流畅对话 |
| 训练阶段 | 预训练 | 有监督微调 (SFT) | 人类反馈强化学习 (RLHF) |
| 关键能力 | 知识渊博、文本生成 | 理解指令、完成任务 | 多轮对话、上下文理解 |
| 交互方式 | 文本续写、开放式生成 | 单轮问答、任务执行 | 多轮聊天、角色扮演 |
| 典型应用 | 研究基础、二次开发底座 | 任务型工具、API服务 | 聊天机器人、智能助手 |
| 形象比喻 | 原始毕业生 | 受过培训的员工 | 经验丰富的客服代表 |
3.2 候选模型评测
当前任务为日常聊天对话模型,主要要求模型的中文理解能力,因此这里以 CLUE(中文理解)数据进行评测:
# 输出数据集清单
$ python tools/list_configs.py clue
#输出如下:
+-----------------------------+------------------------------------------------------------------------------+
| Dataset | Config Path
|
|-----------------------------+------------------------------------------------------------------------------|
| CLUE_C3_gen          | opencompass/configs/datasets/CLUE_C3/CLUE_C3_gen.py |
| CLUE_C3_gen_8c358f   | opencompass/configs/datasets/CLUE_C3/CLUE_C3_gen_8c358f.py |
| CLUE_C3_ppl          | opencompass/configs/datasets/CLUE_C3/CLUE_C3_ppl.py |
| CLUE_C3_ppl_56b537   | opencompass/configs/datasets/CLUE_C3/CLUE_C3_ppl_56b537.py |
| CLUE_C3_ppl_e24a31   | opencompass/configs/datasets/CLUE_C3/CLUE_C3_ppl_e24a31.py |
| CLUE_CMRC_gen        | opencompass/configs/datasets/CLUE_CMRC/CLUE_CMRC_gen.py |
| CLUE_CMRC_gen_1bd3c8 | opencompass/configs/datasets/CLUE_CMRC/CLUE_CMRC_gen_1bd3c8.py |
| CLUE_CMRC_gen_3749cd | opencompass/configs/datasets/CLUE_CMRC/CLUE_CMRC_gen_3749cd.py |
| CLUE_CMRC_gen_8484b9 | opencompass/configs/datasets/CLUE_CMRC/CLUE_CMRC_gen_8484b9.py |
| CLUE_CMRC_gen_941108 | opencompass/configs/datasets/CLUE_CMRC/CLUE_CMRC_gen_941108.py |
| CLUE_DRCD_gen        | opencompass/configs/datasets/CLUE_DRCD/CLUE_DRCD_gen.py |
| CLUE_DRCD_gen_1bd3c8 | opencompass/configs/datasets/CLUE_DRCD/CLUE_DRCD_gen_1bd3c8.py |
| CLUE_DRCD_gen_3749cd | opencompass/configs/datasets/CLUE_DRCD/CLUE_DRCD_gen_3749cd.py |
| CLUE_DRCD_gen_8484b9 | opencompass/configs/datasets/CLUE_DRCD/CLUE_DRCD_gen_8484b9.py |
| CLUE_DRCD_gen_941108 | opencompass/configs/datasets/CLUE_DRCD/CLUE_DRCD_gen_941108.py |
- 以
CLUE开头的数据,主要是以中长文本数据为主; - 以
FewCLUE开头的数据,主要是以短文数据为主; - 以
gen结尾的数据是针对生成任务的,以ppl结尾的数据是针对分类任务的;
当前任务大多是短语对话,可以选择 FewCLUE_bustm_gen(短文本分类)、FewCLUE_ocnli_fc_gen(自然语言推理)对预期模型进行评估。根据评估结果,选择最终模型。
# 模型选型评测,以Qwen1.5-0.5b和Qwen1.5-1.8b为例
$ python run.py \
	--models hf_qwen1_5_0_5b_chat hf_qwen1_5_1_8b_chat \
	--datasets FewCLUE_bustm_gen FewCLUE_ocnli_fc_gen \
	--debug
四、模型微调&评测
目前业界流行的微调框架有 LLamaFactory 和 Xtuner。当前任务是微调情绪对话模型,即为生成式任务,偏向于主观评测。 LLamaFactory 主要应用在分类任务上,只能显示损失曲线的变化,看不到主观评测的结果。Xtuner主要应用在生成式任务上,提供了在训练过程中的主观评测,因此当前任务更适合选择 Xtuner框架。
4.1 数据格式转换
当前需要将获取的数据集转换为 Xtuner框架支持的数据格式,转换代码如下:
import json

def convert_format(source_data):
	target_data = []
	for item in source_data:
        # 构建新的对话格式
        new_convo = {
        	"conversation": [
                {
                    "input": item["user"],
                    "output": f"{item['style']}\n{item['assistant']}"
                }
            ]
		}
		target_data.append(new_convo)
	return target_data

# 从文件读取源数据
with open("input.json", "r", encoding="utf-8") as f:
	source_data = json.load(f)

# 执行转换
converted_data = convert_format(source_data)

# 写入目标文件
with open("output.json", "w", encoding="utf-8") as f:
	json.dump(converted_data, f, ensure_ascii=False, indent=2)
与模型的对话方式有单轮对话和多轮对话,小智 AI 机器人属于单轮对话,不具备多轮对话的能力。
4.2 配置训练文件
配置Xtuner框架的配置框架:
### PART 1 ###
# 预训练模型存放的位置
pretrained_model_name_or_path = 'model_path'	#基座模型路径

# 微调数据存放的位置
data_files = '/root/public/data/target_data.json'

# 训练中最大的文本长度
max_length = 512

# 每一批训练样本的大小
batch_size = 2

# 最大训练轮数
max_epochs = 3

# 验证数据
evaluation_inputs = [
	'只剩一个心脏了还能活吗?',
	'爸爸再婚,我是不是就有了个新娘?',
	'樟脑丸是我吃过最难吃的硬糖有奇怪的味道怎么还有人买',
	'马上要上游泳课了,昨天洗的泳裤还没干,怎么办',
	'我只出生了一次,为什么每年都要庆生'
]

### PART 3 ###
dataset=dict(type=load_dataset, path="json",data_files=data_files)
dataset_map_fn=None
4.3 模型微调
# 单机单卡
$ xtuner train internlm2_chat_1_8b_qlora_alpaca_e3.py

# 单机多卡
$ NPROC_PER_NODE=${GPU_NUM} xtuner train internlm2_chat_7b_qlora_oasst1_e3 --deepspeed deepspeed_zero2
- 根据模型输出验证数据的回答情况来判断微调是否收敛;
4.4 模型转换
模型训练后会自动保存成 PTH 模型(例如 iter_2000.pth ,如果使用了 DeepSpeed,则将会是一个文件夹),我们需要利用 xtuner convert pth_to_hf 将其转换为 HuggingFace 模型,以便于后续使用。具体命令为:
$ xtuner convert pth_to_hf ${FINETUNE_CFG} ${PTH_PATH} ${SAVE_PATH}

# 例如:
$ xtuner convert pth_to_hf internlm2_chat_7b_qlora_custom_sft_e1_copy.py ./iter_2000.pth ./iter_2000_
4.5 模型合并
如果使用了 LoRA / QLoRA 微调,则模型转换后将得到 adapter 参数,并不包含原 LLM 参数。如果您期望获得合并后的模型权重(例如用于后续评测),那么可以利用 xtuner convert merge:
$ xtuner convert merge ${LLM} ${LLM_ADAPTER} ${SAVE_PATH}
五、模型推理部署
选择合适的大模型推理框架部署模型(这里选择 LMDeploy),由于微调框架(LlamaFactory、Xtuner)使用的是自定义对话模版,模型部署时必须对齐对话模板。
LMDeploy 支持两种添加对话模板的形式:
- 一种是利用现有对话模板,直接配置一个如下的
json文件使用
{
    "model_name": "your awesome chat template name",
    "system": "<|im_start|>system\n",
    "meta_instruction": "You are a robot developed by LMDeploy.",
    "eosys": "<|im_end|>\n",
    "user": "<|im_start|>user\n",
    "eoh": "<|im_end|>\n",
    "assistant": "<|im_start|>assistant\n",
    "eoa": "<|im_end|>",
    "separator": "\n",
    "capability": "chat",
    "stop_words": ["<|im_end|>"]
}
-
model_name为必填项,可以是LMDeploy内置对话模板名(通过lmdeploy list可查阅),也可以是新名字。其他字段可选填。当
model_name是内置对话模板名时,json文件中各非null字段会覆盖原有对话模板的对应属性。当
model_name是新名字时,它会把将BaseChatTemplate直接注册成新的对话模板。
这样一个模板将会以下面的形式进行拼接:
{system}{meta_instruction}{eosys}{user}{user_content}{eoh}{assistant}
{assistant_content}{eoa}{separator}{user}..
在使用 CLI 工具时,可以通过 --chat-template 传入自定义对话模板,比如:
$ lmdeploy serve api_server internlm/internlm2_5-7b-chat --chat-template ${JSON_FILE}
也可以在通过接口函数传入,比如:
from lmdeploy import ChatTemplateConfig, serve

serve('internlm/internlm2_5-7b-chat', chat_template_config=ChatTemplateConfig.from_json('${JSON_FILE}'))
- 另一种是以
LMDeploy现有对话模板,自定义一个python对话模板类,注册成功后直接用即可。优点是自定义程度高,可控性强。 下面是一个注册LMDeploy对话模板的例子:
from lmdeploy.model import MODELS, BaseChatTemplate

@MODELS.register_module(name='customized_model')
class CustomizedModel(BaseChatTemplate):
    """A customized chat template."""
    def __init__(self,
                system='<|im_start|>system\n',
                meta_instruction='You are a robot developed by LMDeploy.',
                user='<|im_start|>user\n',
                assistant='<|im_start|>assistant\n',
                eosys='<|im_end|>\n',
                eoh='<|im_end|>\n',
                eoa='<|im_end|>',
                separator='\n',
                stop_words=['<|im_end|>', '<|action_end|>']):
    	super().__init__(system=system,
                        meta_instruction=meta_instruction,
                        eosys=eosys,
                        user=user,
                        eoh=eoh,
                        assistant=assistant,
                        eoa=eoa,
                        separator=separator,
                        stop_words=stop_words)

from lmdeploy import ChatTemplateConfig, pipeline

messages = [{'role': 'user', 'content': 'who are you?'}]
pipe = pipeline('internlm/internlm2_5-7b-chat',
                chat_template_config=ChatTemplateConfig('customized_model'))

for response in pipe.stream_infer(messages):
	print(response.text, end='')
这里我们选用 CLI 工具推理,可以通过 --chat-template 传入自定义对话模板:
$ lmdeploy serve api_server internlm/internlm2_5-7b-chat --chat-template ${JSON_FILE}
对话模板转换脚本:
import re

# 原始对话模板配置
original_qwen_chat = dict(
    SYSTEM=("<|im_start|>system\n{system}<|im_end|>\n"),
    INSTRUCTION=("<|im_start|>user\n{input}<|im_end|>\n" "<|im_start|>assistant\n"),
    SUFFIX="<|im_end|>",
    SUFFIX_AS_EOS=True,
    SEP="\n",
    STOP_WORDS=["<|im_end|>", "<|endoftext|>"],
)

# 转换函数
def convert_template(template):
    converted = {}
    for key, value in template.items():
        if isinstance(value, str):
            # 将 {variable} 格式转换为 {{ variable }}
            converted_value = re.sub(r'\{(\w+)\}', r'{{ \1 }}', value)
            converted[key] = converted_value
        else:
        	converted[key] = value
    return converted

# 执行转换
jinja2_qwen_chat = convert_template(original_qwen_chat)
print(jinja2_qwen_chat)
更多推荐

 14
 0
- 0


 已为社区贡献5条内容

所有评论(0)