
机器学习基础入门3——回归与聚类算法
目录
4.6.5 案例:K-means对Instacart Market用户聚类
4.1 线性回归
4.1.1 线性回归原理
回归问题:
目标值——连续型的数据
应用场景:房价预测、销售额度预测、金融(贷款额度预测)
4.1.2 什么是线性回归
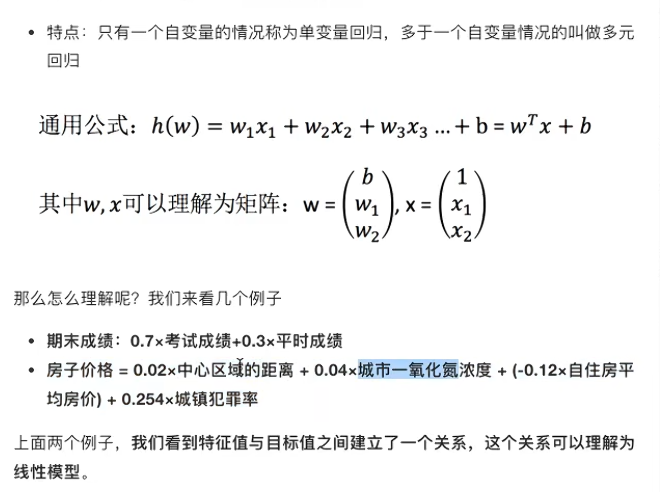
定义:线性回归是利用回归方程(函数)对一个或多个自变量(特征值)和因变量(目标值)之间关系进行建模的一种分析方式。
注:简单来说,一种是统计的说法,一种是机器学习中的说法,两者无非就是
函数关系 特征值和目标值
线性模型
数据挖掘基础
y = 0.7x1 + 0.3x2
期末成绩 :0.7x考试成绩 + 0.3x平时成绩
广义线性模型
~ 非线性关系
线性模型:
自变量一次
y = w1x1 + w2x2 + w3x3 + ......+ wnxn + b
参数一次
y = w1x1 + w2x1^2 + w3x1^3 + w4x2^3 +......+ b
注:线性关系一定是线性模型,线性模型不一定是线性关系。
4.1.2 线性回归的损失和优化原理(理解记忆)
目标:求模型参数
模型参数能够使得预测准确
真实关系
随意假定
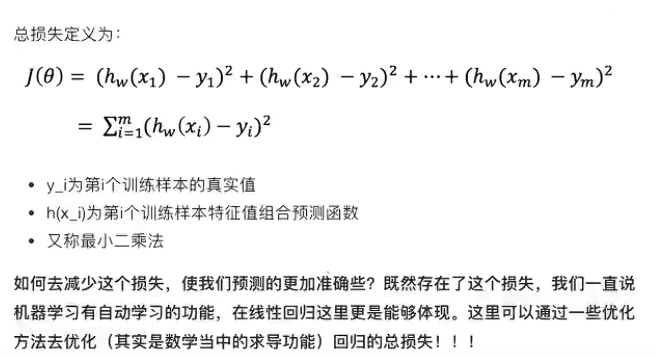
损失函数/cost/成本函数/目标函数:
最小二乘法
优化损失
1、损失函数
优化方法
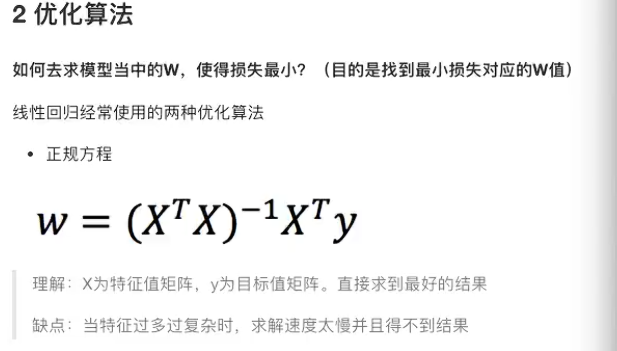
正规方程 ~ 天才 —— 直接求解w
拓展:
1) 求函数最小值
y = ax^2 + bx + c
y' = 2ax + b 令y' = 0
2) 矩阵求幂
a * b = 1 (a,b均不为0)
b = 1/a = a^-1
A * B = E (矩阵A乘以矩阵B等于单位矩阵E)
[[1 , 0 , 0]
[0 , 1 , 0 ]
[0 , 0 , 1]]
B = A ^ -1
梯度下降 ~ 勤奋努力的普通人 —— 试错、改进
2、优化算法
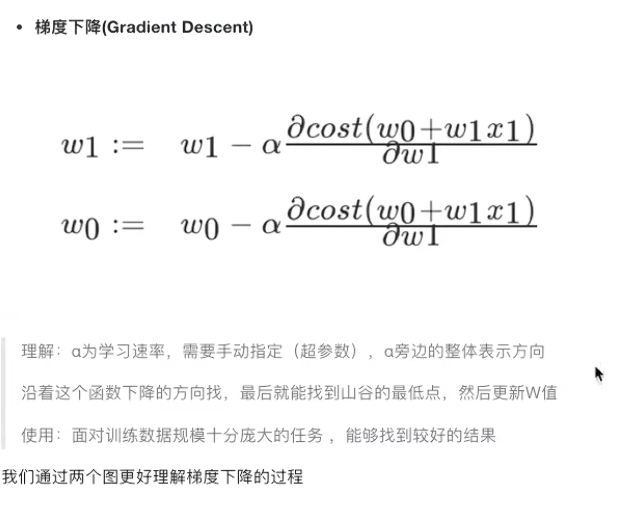
迭代法每次减一下,理解为学习率,每次沿着坡度最陡的方向每次下降的步长,
后面的理解为每次沿着坡度最陡的方向每次下降的方向。
注:机器学习的学习过程就是梯度下降、不断迭代试错的过程,根据上一步的错误不断试错改进。
4.1.3 线性回归API
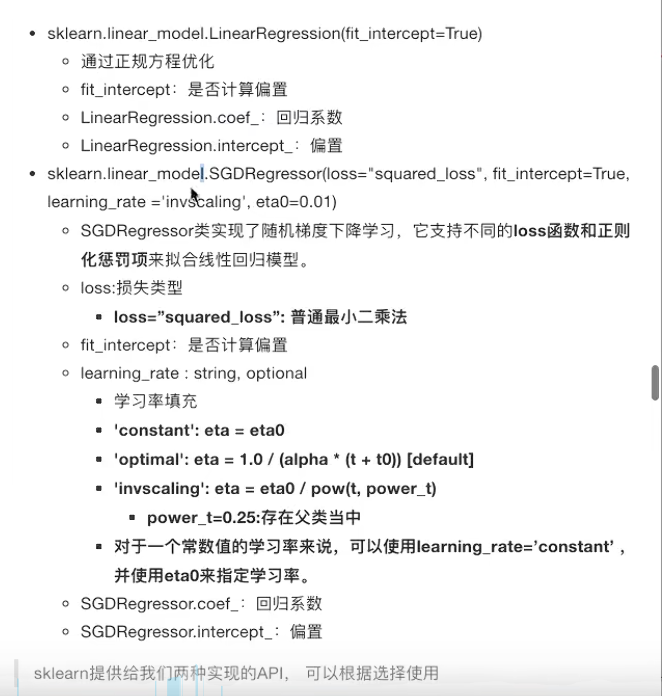
4.1.4 波士顿房价预测
流程:
1)获取数据集
2)划分特征工程
3)特征工程:
无量纲化 ——标准化
4)预估器流程
fit() -- > 模型
coef_intercept_
5)模型评估
回归的模型性能评估:
均方误差
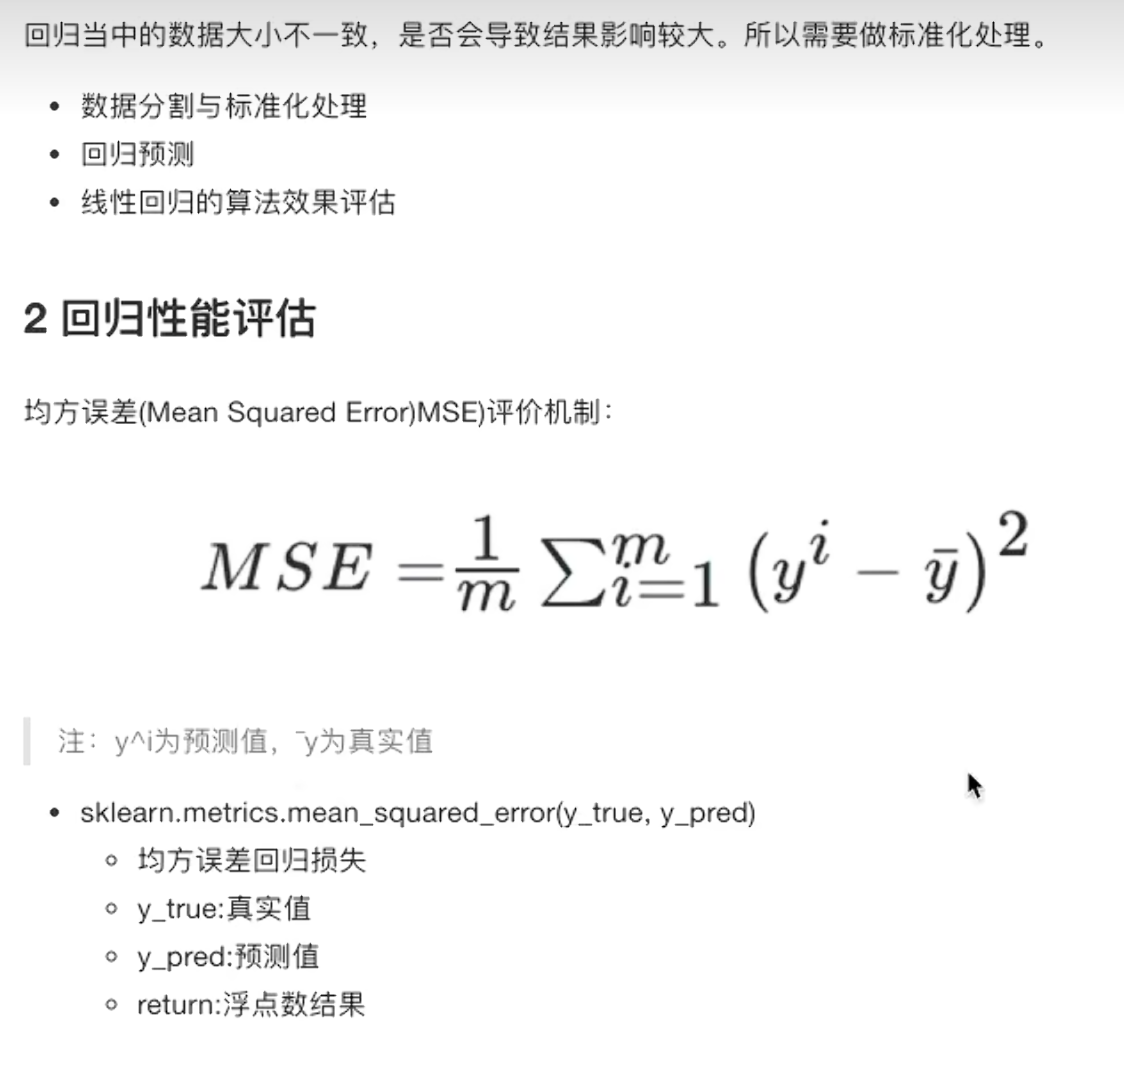
正规方程与梯度下降对比
4.1.5 拓展 ——关于优化方法GD、SGD、SAG
1、GD
梯度下降(Gradient Descent),原始的梯度下降法需要计算机所有样本的值才能够得到梯度,计算量大,所以后面才有会一系列的改进。
2、SGD
随机梯度下降(Stochastic gradient descent)是一个优化方法,它在一次迭代时只考虑一个训练样本。
· SGD的优点:
~高效
~易于实现
· SGD的缺点:
SGD需要许多超参数:比如正则项参数、迭代数。
SGD对于特征标准化是敏感的。
3、SAG
随机平均梯度法(Stochastic Average Gradient),由于收敛的速度太慢,有人提出SAG等基于梯度下降的算法
Scikit-learn : 岭回归、逻辑回归等当中都会有SAG优化
4.1.6 总结
· 线性回归的损失函数——均方误差
· 线性回归的优化方法
正规方程
梯度下降
· 线性回归的性能衡量方法——均方误差
· sklearn的SGDRegressor API 参数
4.2 欠拟合与过拟合
4.2.1 什么是过拟合与欠拟合
训练集上表现得好,测试集上不好——过拟合
训练集和测试集上表现都不好——欠拟合
定义:
· 过拟合:一个假设在训练数据上能够获得比其他假设更好的拟合,但是在测试数据集上却不能很好地拟合数据,此时认为这个假设出现了过拟合的现象。(模拟过于复杂)
· 欠拟合:一个假设在训练数据上不能获得更好的拟合,并且在测试数据集上也不能更好地拟合,此时认为这个假设出现了欠拟合的现象。(模型过于简单)
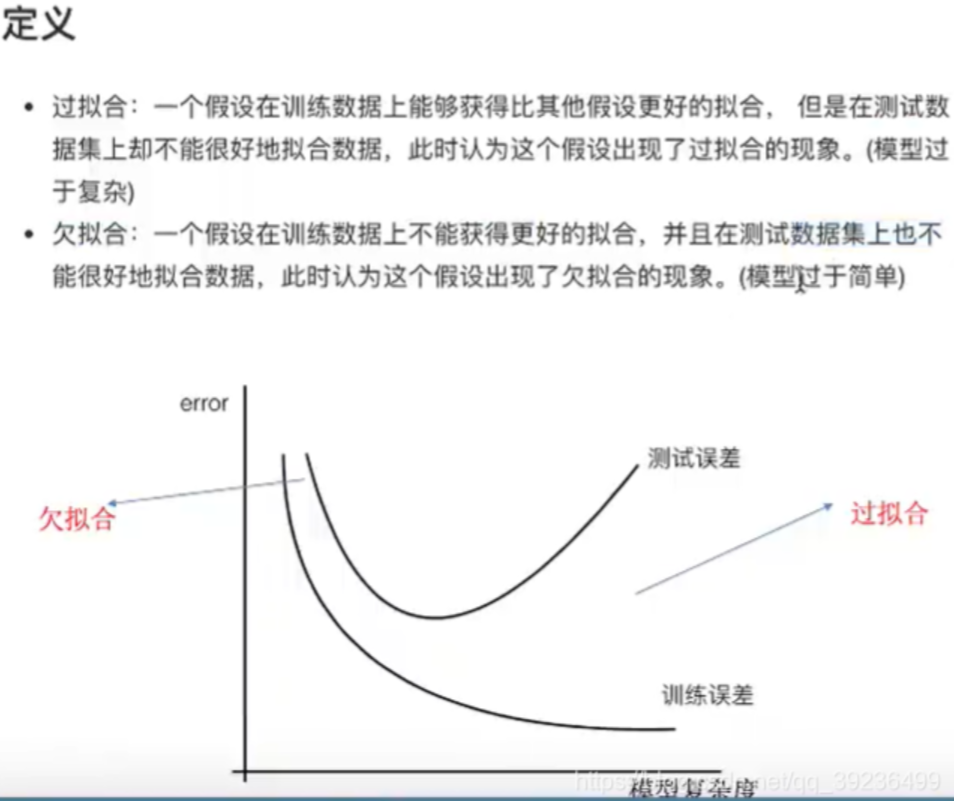
4.2.2 原因以及解决办法
· 欠拟合原因及解决办法
原因:学习到数据的特征过少
解决办法:增加数据的特征数量
· 过拟合原因及解决办法
原因:原始特征过多,存在一些嘈杂特征,模型过于复杂是因为模型尝试去兼顾各个测试数据点
· 解决办法:正则化
1、正则化类别
1)L2正则化(更常用)
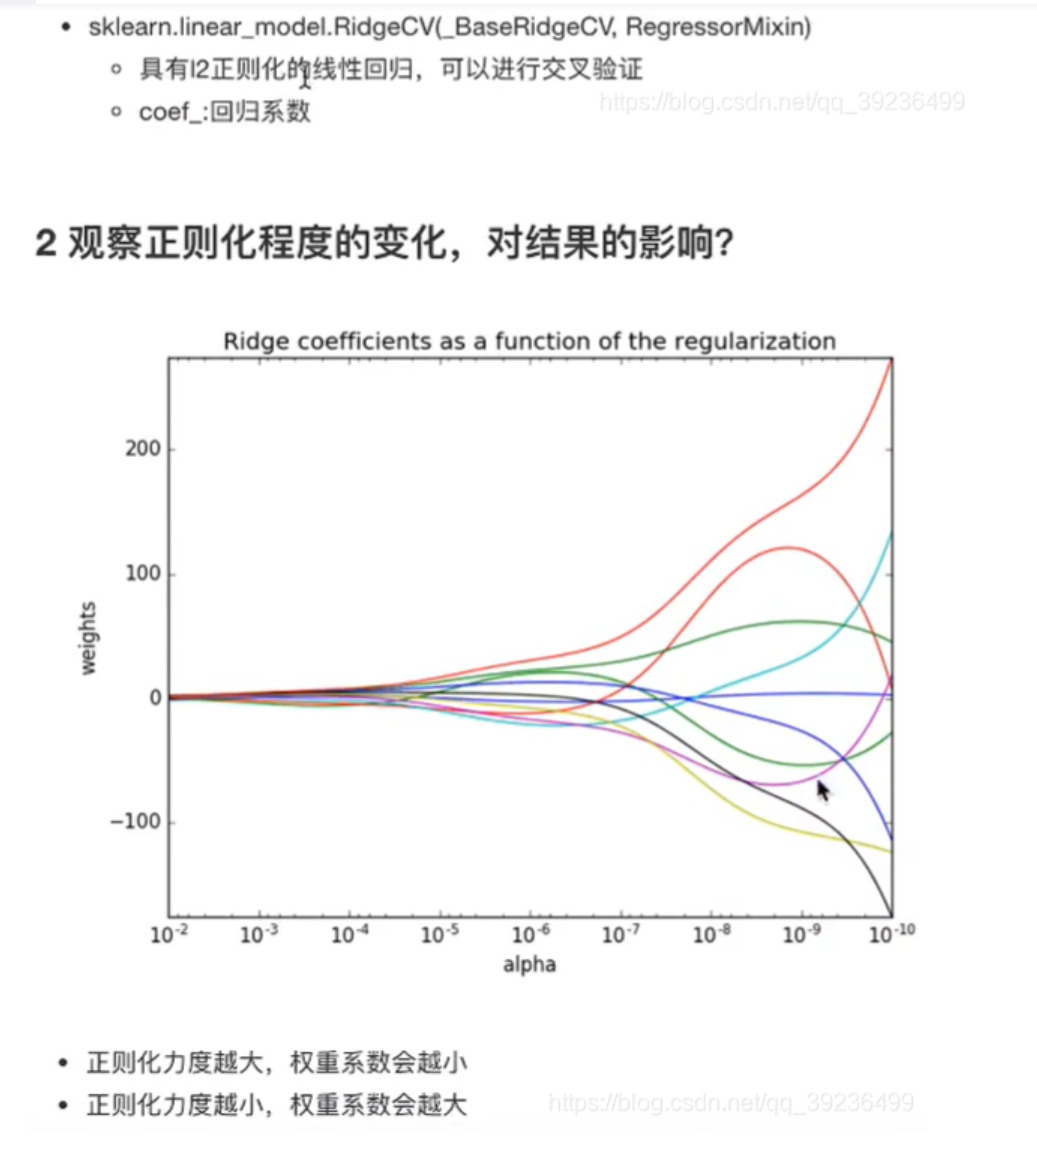
作用:可以使得其中一些w的都很小,都接近于0,削弱某个特征的影响
优点:越小的参数说明模型越简单,越简单的模型则越不容易产生过拟合现象
- Ridge回归 —— 岭回归
- 加入L2正则化后的损失函数:
- 损失函数 +
惩罚项
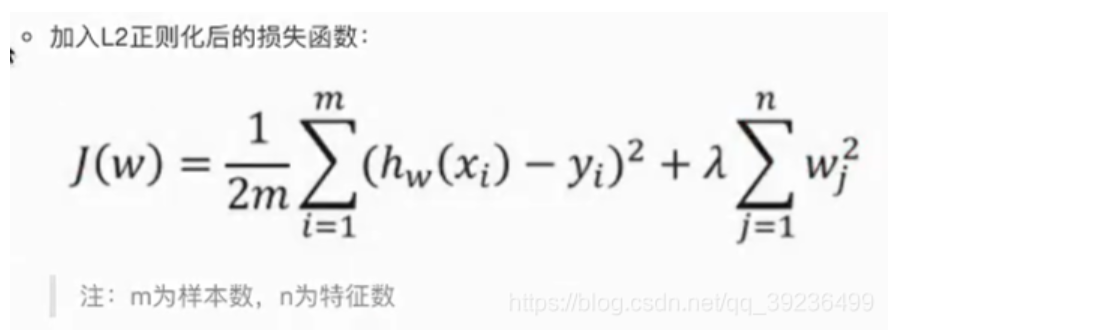
2)L1正则化
损失函数 + 惩罚项
作用:可以使其中一些w的值直接为0,删除这个特征的影响
LASSO回归
4.3 线性回归的改进——岭回归
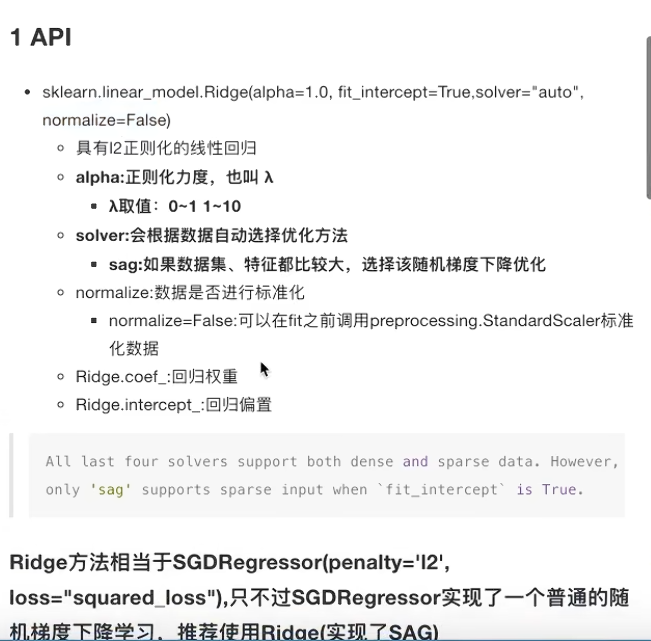
岭回归,其实也是一种线性回归,只不过在算法建立回归方程的时候,加上正则化的限制,从而达到解决过拟合的效果
4.3.1 带有L2正则化的线性回归——岭回归
alpha 正则化力度=惩罚项系数
波士顿房价预测
from sklearn.datasets import load_boston
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LinearRegression, SGDRegressor, Ridge
from sklearn.metrics import mean_squared_error


def linear1():
    """
    正规方程的优化方法对波士顿房价进行预测
    :return:
    """
    # 1) 获取数据
    boston = load_boston()
    print("特征数量:\n",boston.data.shape)

    # 2) 划分数据集
    x_train,x_test,y_train,y_test = train_test_split(boston.data, boston.target,random_state=22)

    # 3) 标准化
    transfer = StandardScaler()
    x_train = transfer.fit_transform(x_train)
    x_test = transfer.transform(x_test)

    # 4) 预估器
    estimator = LinearRegression()
    estimator.fit(x_train,y_train)


    # 5) 得出模型
    print("正规方程-权重系数为:\n",estimator.coef_)
    print("正规方程-偏置为:\n",estimator.intercept_)

    # 6) 模型评估
    y_predict = estimator.predict(x_test)
    print("预测房价:\n",y_predict)
    error = mean_squared_error(y_test,y_predict)
    print("正规方程-均方误差为:\n",error)

    return None

def linear2():
    """
    梯度下降的优化方法对波士顿房价进行预测
    :return:
    """
    # 1) 获取数据
    boston = load_boston()
    print("特征数量:\n", boston.data.shape)

    # 2) 划分数据集
    x_train, x_test, y_train, y_test = train_test_split(boston.data, boston.target, random_state=22)

    # 3) 标准化
    transfer = StandardScaler()
    x_train = transfer.fit_transform(x_train)
    x_test = transfer.transform(x_test)

    # 4) 预估器
    estimator = SGDRegressor(learning_rate="constant",eta0=0.01,max_iter=10000,penalty="l1")
    estimator.fit(x_train, y_train)

    # 5) 得出模型
    print("梯度下降-权重系数为:\n", estimator.coef_)
    print("梯度下降 -偏置为:\n", estimator.intercept_)

    # 6) 模型评估
    y_predict = estimator.predict(x_test)
    print("预测房价:\n", y_predict)
    error = mean_squared_error(y_test, y_predict)
    print("梯度下降-均方误差为:\n", error)

    return None

def linear3():
    """
    岭回归对波士顿房价进行预测
    :return:
    """
    # 1) 获取数据
    boston = load_boston()
    print("特征数量:\n", boston.data.shape)

    # 2) 划分数据集
    x_train, x_test, y_train, y_test = train_test_split(boston.data, boston.target, random_state=22)

    # 3) 标准化
    transfer = StandardScaler()
    x_train = transfer.fit_transform(x_train)
    x_test = transfer.transform(x_test)

    # 4) 预估器
    estimator = Ridge(alpha=0.5,max_iter=10000)
    estimator.fit(x_train, y_train)

    # 5) 得出模型
    print("岭回归-权重系数为:\n", estimator.coef_)
    print("岭回归-偏置为:\n", estimator.intercept_)

    # 6) 模型评估
    y_predict = estimator.predict(x_test)
    print("预测房价:\n", y_predict)
    error = mean_squared_error(y_test, y_predict)
    print("岭回归-均方误差为:\n", error)

    return None


if __name__ == '__main__':
    # 代码1:正规方程的优化方法对波士顿房价进行预测
    linear1()
    # 代码2:梯度下降的优化方法对波士顿房价进行预测
    linear2()
    # 代码3:岭回归对波士顿房价进行预测
    linear3()
4.4 分类算法——逻辑回归与二分法
4.4.1 逻辑回归的应用场景
· 广告点击率 是否会被点击
· 是否为垃圾邮件
· 是否患病
· 是否为金融诈骗
· 是否为虚假账号
正例 /反例
4.4.2 逻辑回归的原理
1、输入
线性回归的输出就是逻辑回归的输入。
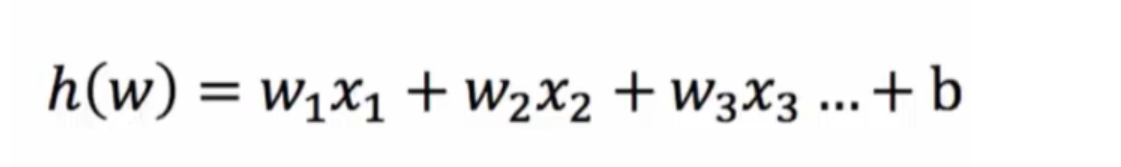
2、激活函数
· sigmoid函数 [0, 1]
1/(1 + e^(-x))
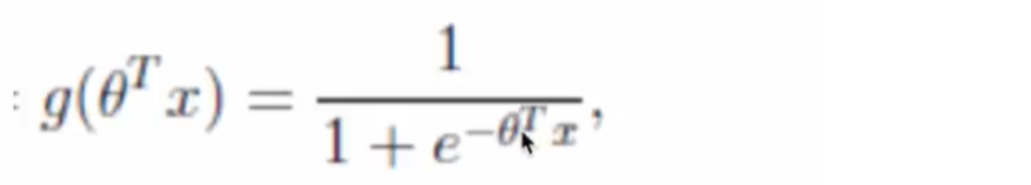
假设函数 / 线性模型
1/(1 + e^(-(w1x1 + w2x2 + w3x3 + ...... + wnxn + b)))
构建损失函数
(y_predict - y_true)平方和/总数
逻辑回归的真实值/预测值 是否属于某个类别
3、损失以及优化
1)损失
逻辑回归的损失,称之为对数似然损失,公式如下:
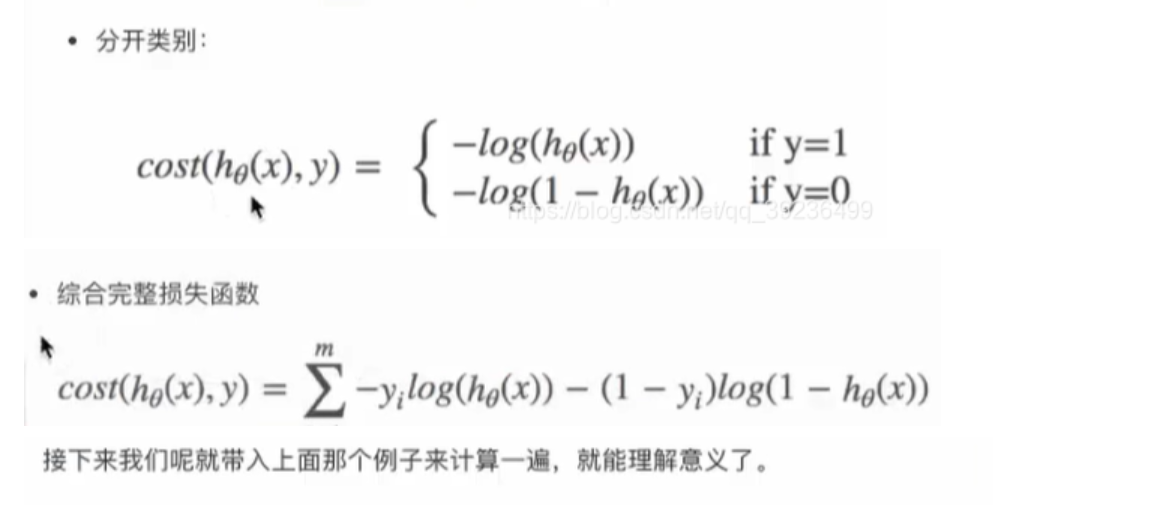
当真实值yi等于1,则后面式子没有了
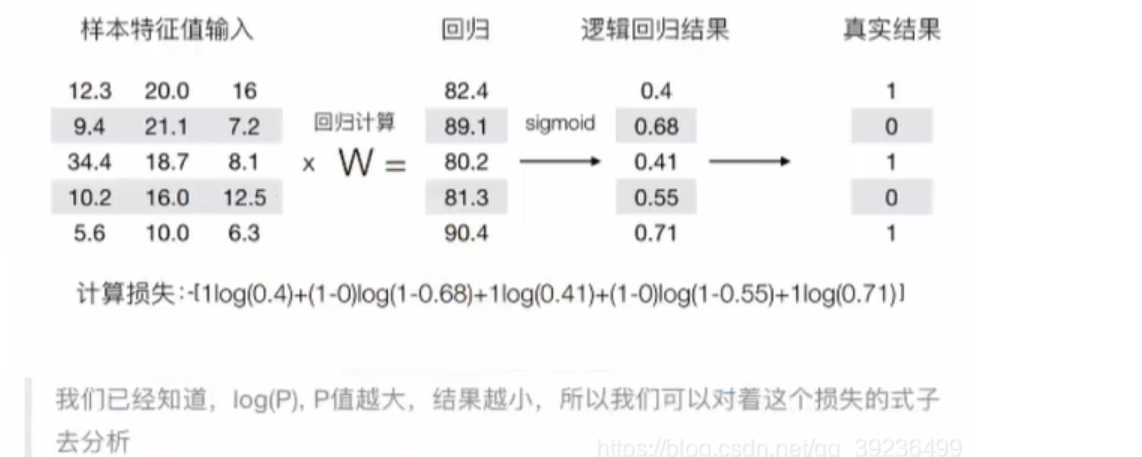
优化损失
梯度优化
4.4.3 逻辑回归API
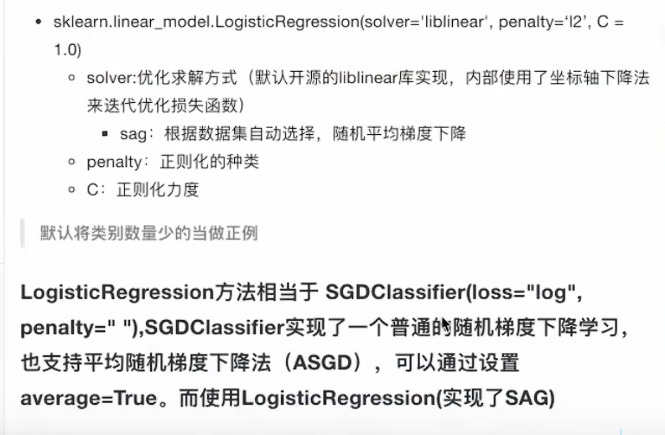
4.4.4 案例:癌症分类预测-良/恶性乳腺癌肿瘤预测
恶性 - 正例
流程分析:
1)获取数据
读取的时候加上names
2) 数据处理
处理缺失值
3)数据集划分
4)特征工程:
无量纲化处理——标准化
5)逻辑回归预估器
6)模型评估
真的患癌症的,能够被检查出来的概率 ——召回率
4.4.5 分类的评估方法
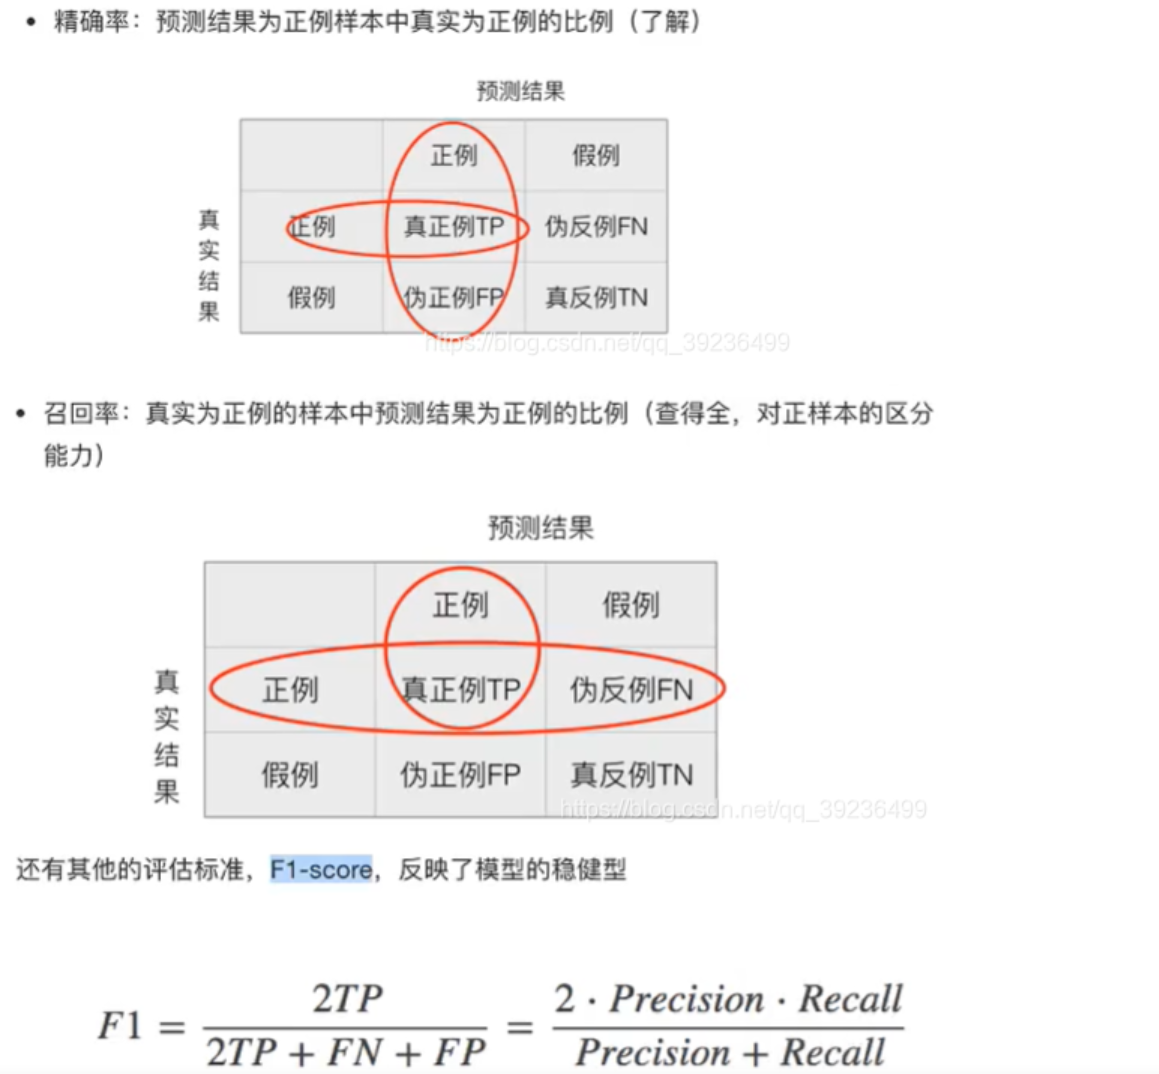
1、精确率与召回率
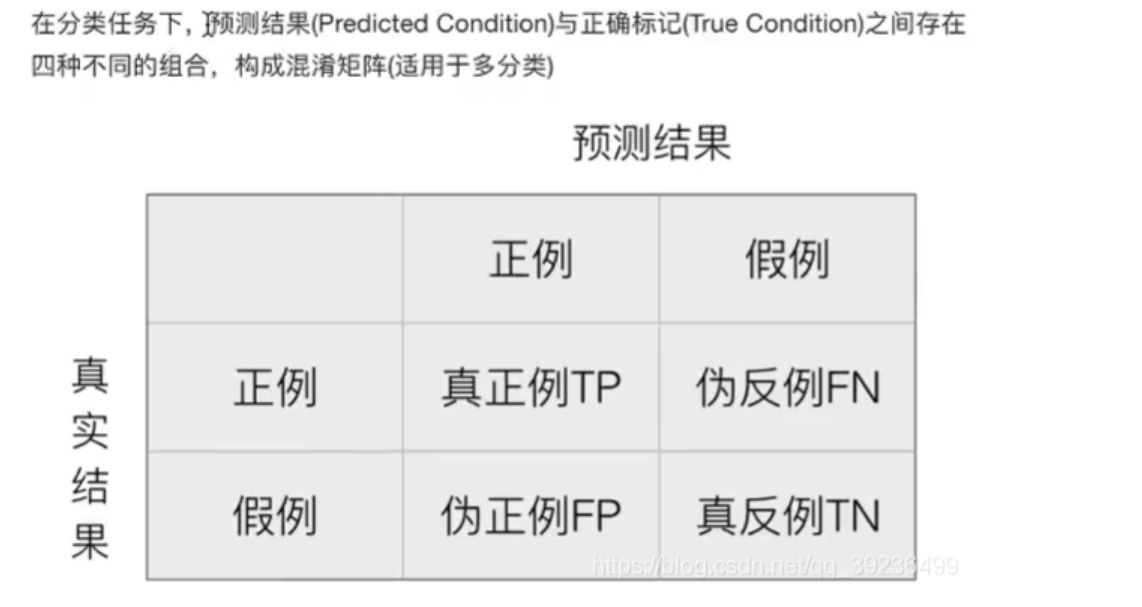
1混淆矩阵
TP = True Possitive
FN = False Negative
2 精确率(Precision)与召回率(Recall)
精确率
召回率 查的全不全
工厂 质量检测 次品 召回率
3 F1-score 模型的稳健型
总共有100个人,如果99个样本癌症,1个样本非癌症
不管怎样我全都预测正例(默认癌症为正例)—— 不负责任的模型
准确率:99%
召回率:99/99 = 100%
精选率:99%
F1-score:2*99%/ 199% = 99.497%
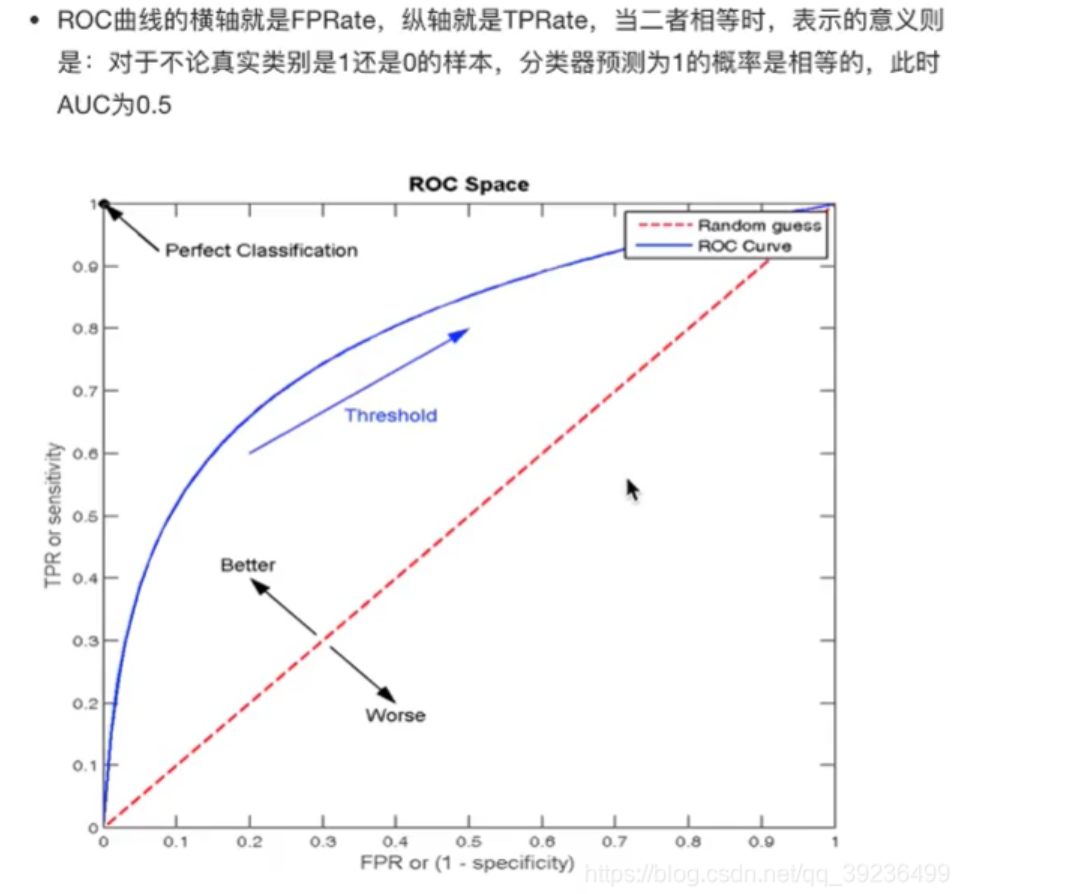
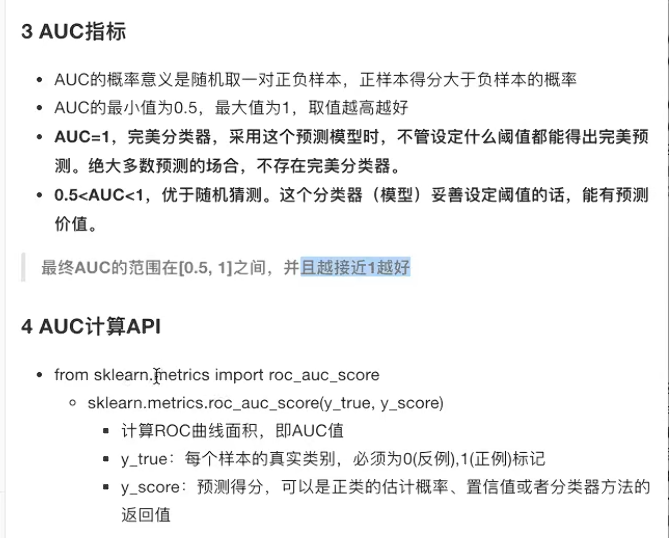
AUC:0.5
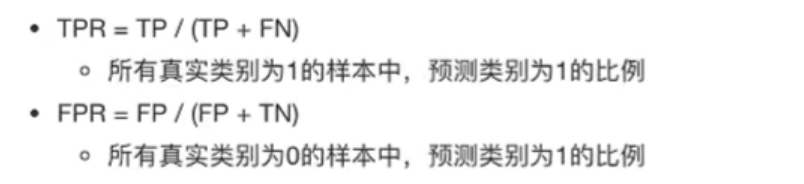
TPR = 100%
FPR = 1 / 1 = 100%
3、 分类评估报告API
· sklearn.metrics.classification_report(y_true, y_pred, labels=[], target_names=None)
- y_true:真实目标值
- y_pred:估计器预测目标值
- labels:指定类别对应的数字
- target_names:目标类别名称
- return:每个类别精确率与召回率
问题:如何衡量样本不均衡下的评估?
衡量样本不均衡下的评估:
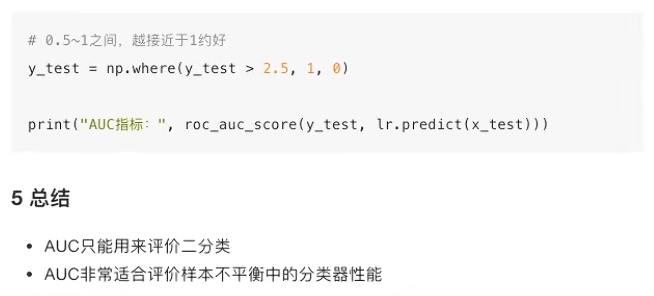
2 ROC曲线与AUC指标
TPR就是召回率
4.5 模型保存和加载
4.5.1 sklearn模型的保存和加载API
· from sklearn.externals import joblib
在较新的scikit - learn版本中,joblib已经成为独立的库,正确的导入方式应该是直接import joblib,
不需要再从sklearn.externals里面导入啦。
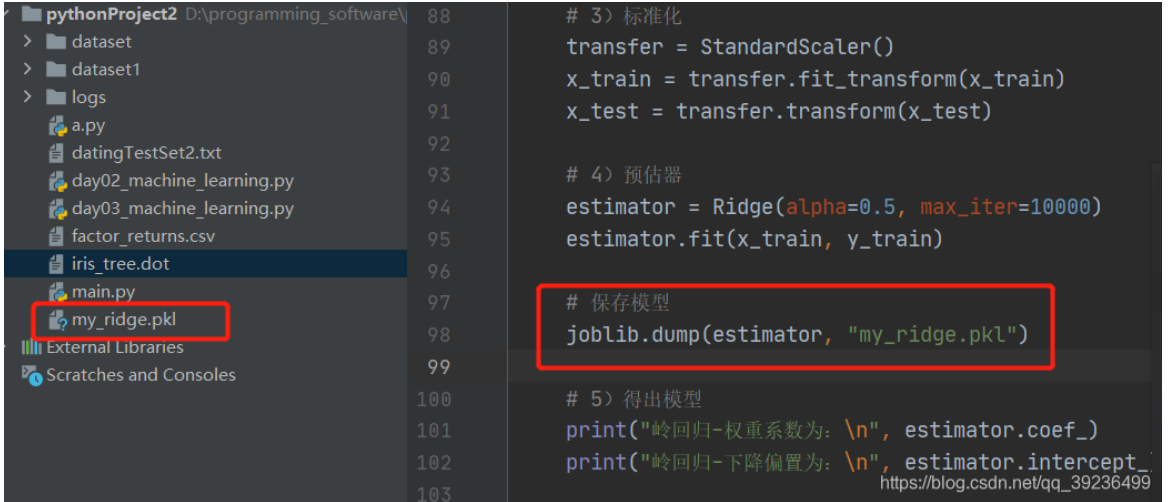
- 保存:joblib.dump(rf, ‘test.pkl’)
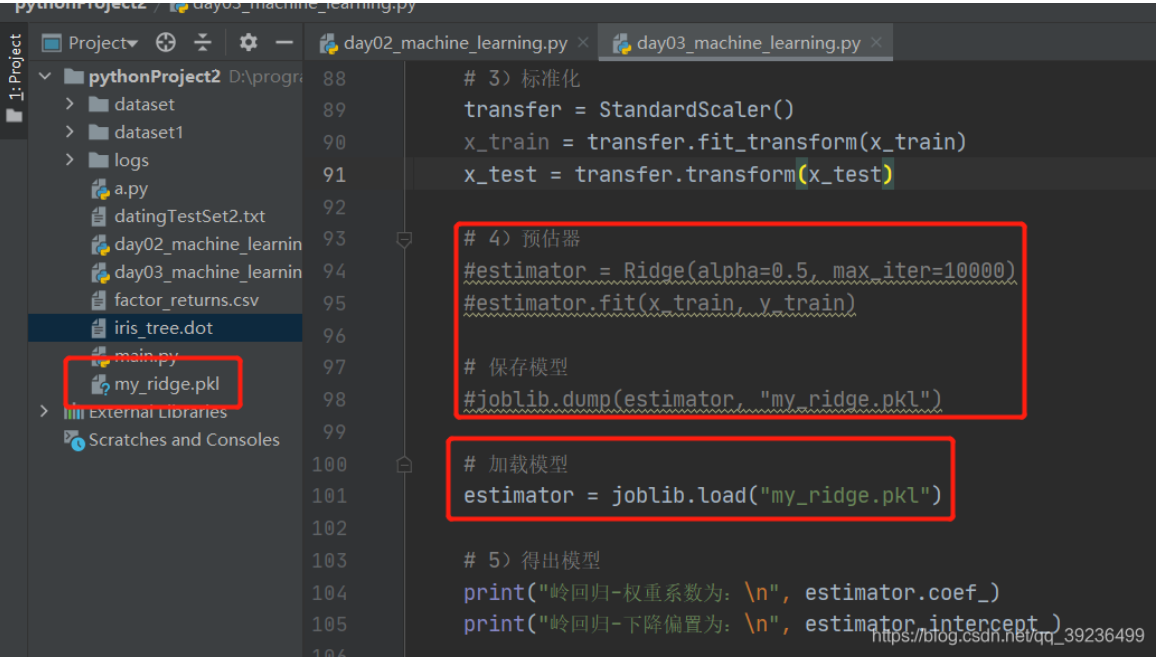
- 加载:estimator = joblib.load(‘test.pkl’)
4.5.2 线性回归的模型保存加载案例
1、保存模式
2、加载模式
4.6 无监督学习——K-means算法
4.6.1 什么是无监督学习
没有目标值(无标签)—无监督学习
4.6.2 无监督学习包含算法
· 聚类
K-means(K均值聚类)
· 降维
PCA
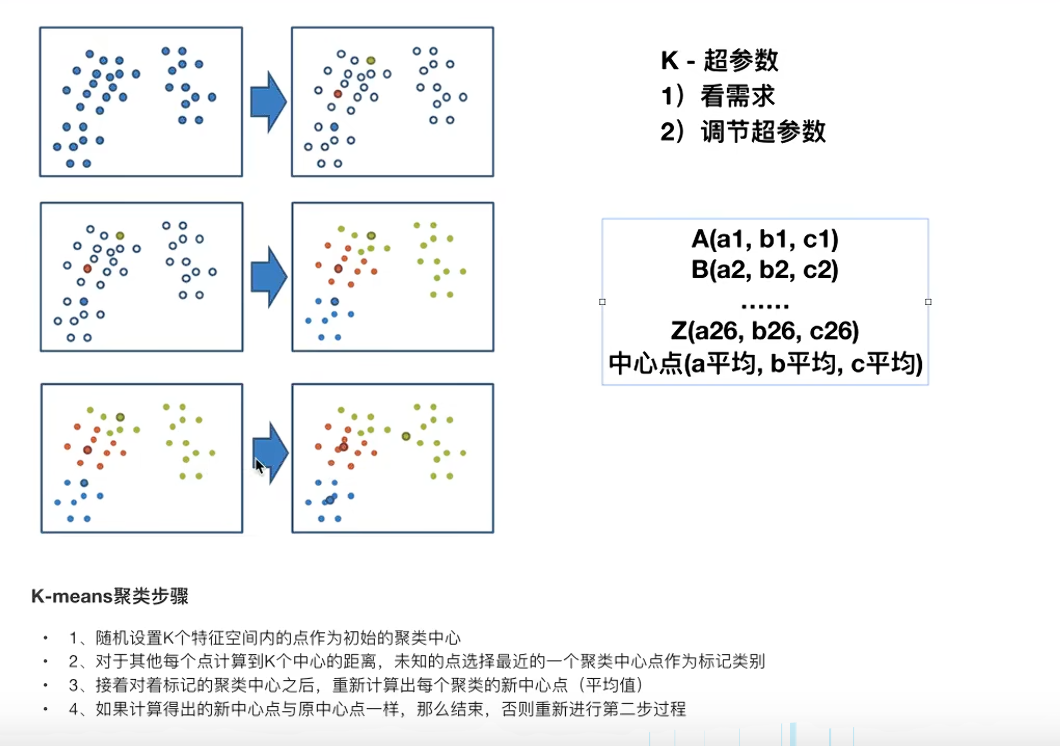
4.6.3 K-means原理
4.6.4 K-meansAPI
· sklearn.cluster.KMeans(n_cluster=8, init='k-means++')
- k-means聚类
- n_clusters:开始聚类中心数量
- init:初始化方法,默认为‘k-means++’
- labels_:默认标记的类型,可以和真实值比较(不是值比较)
4.6.5 案例:K-means对Instacart Market用户聚类
k = 3
流程分析:
降维之后的数据
1)预估器流程
2)看结果
3)模型评估
4.6.6 Kmeans性能评估指标
1、轮廓系数
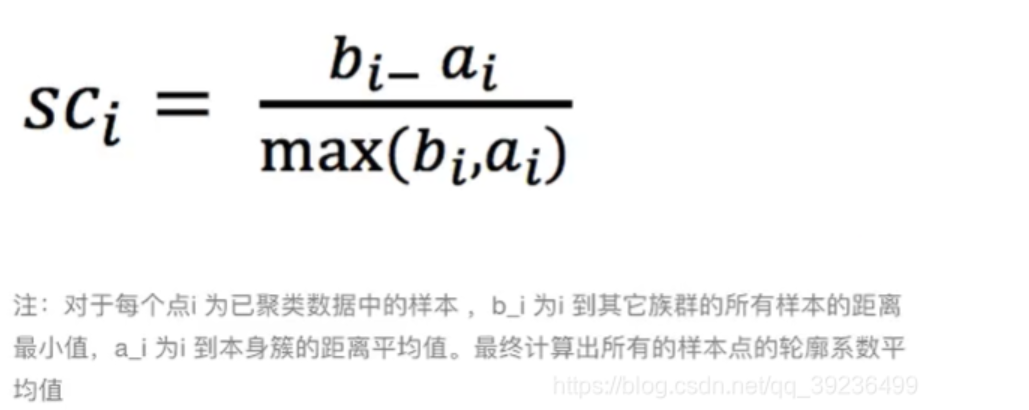
2、轮廓系数值分析
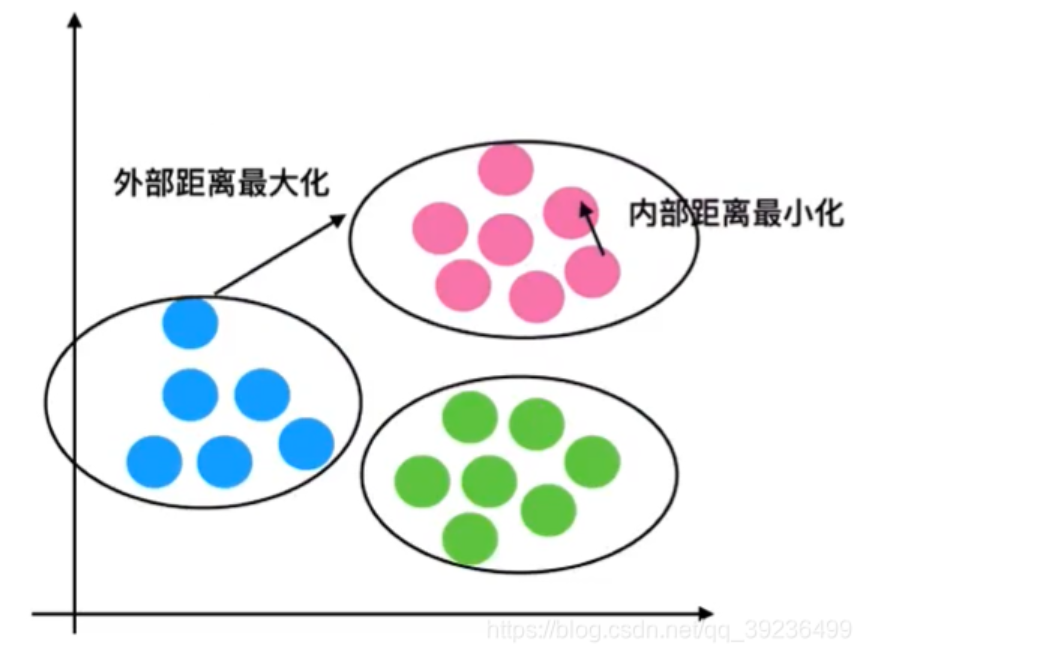
b_i >> a_i 说明外部距离很大,内部距离很小
Sc b_i / b_i = 1
b_i << a_i
Sc -a_i / a_i = -1
3、结论
如果b_i >> a_i:趋近于1效果越好,
b_i << a_i:趋近于-1,效果不好。
轮廓系数的值是介于 [-1,1],
越趋近于1代表内聚度和分离度都相对较优。
4、轮廓系数API
· sklearn.metrics.silhouette_score(X, labels)
- 计算所有样本的平均轮廓系数
- X:特征值
- labels:被聚类标记的目标值
5、用户聚类结果评估
4.6.7 K-means总结
应用场景:
没有目标值
分类
· 特点分析:采用迭代式算法,直观易懂并且非常实用
· 缺点:容易收敛到局部最优解(多次聚类)
注意:聚类一般坐在分类之前
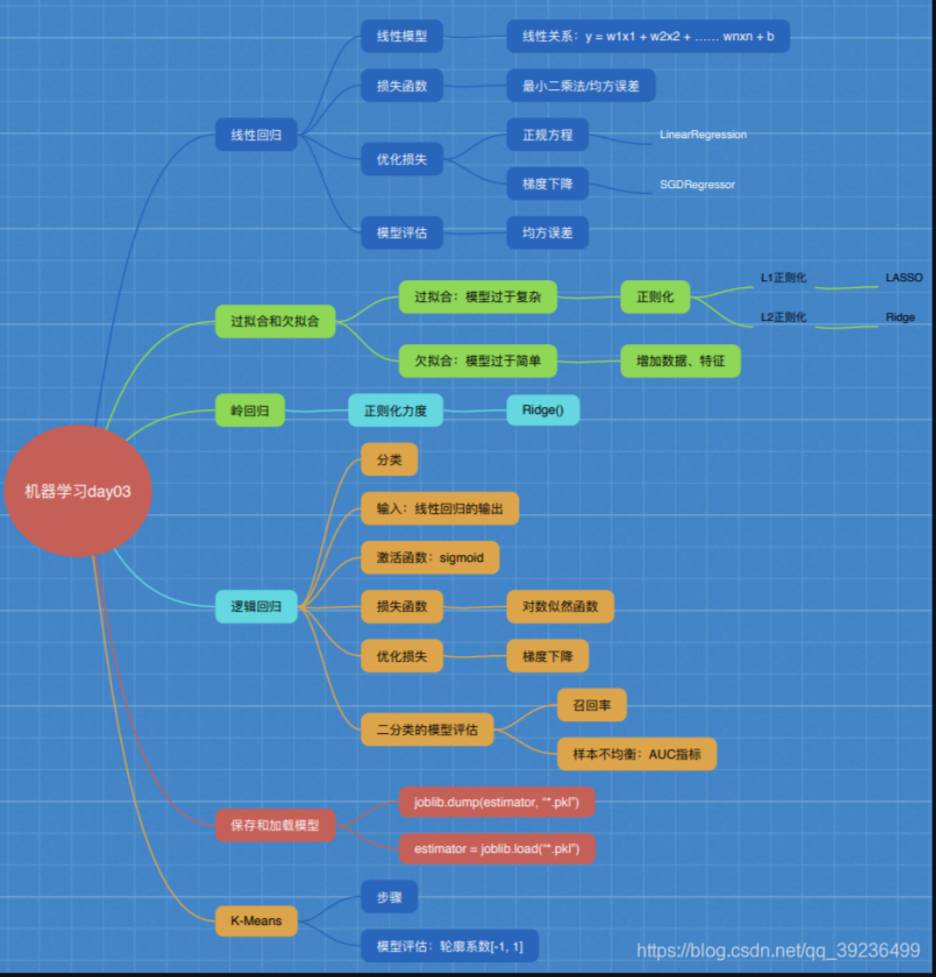
# 学了快9天,机器学习感觉学的不怎么样,准备二刷多加复习,争取早日开深度学习。
更多推荐


 45
 0
- 0


 已为社区贡献5条内容

所有评论(0)