
大模型平台中模型蒸馏功能介绍
大模型开发平台TLM介绍
天纪大模型开发平台整合最新 AI 技术,提供模型广场、数据广场,模型微调、模型部署和模型评测等大模型开发的完整解决方案,为用户提供全套 LLMOPS 工程能力,助力业务快速基于通用模型开发出行业模型并部署服务。
模型蒸馏简介
大模型蒸馏(Knowledge Distillation, KD)的核心原理是将大型、高性能的“教师模型”(Teacher Model)所学到的知识迁移至结构更简单、计算成本更低的“学生模型”(Student Model)。其基本思想不仅限于学习真实标签(hard labels),而是利用教师模型在训练数据上输出的类别概率分布——即“软标签”(soft labels),这些软标签包含类别间的相对关系和不确定性信息,蕴含了更丰富的知识。
蒸馏过程中,学生模型通过最小化其输出与教师模型输出之间的差异(通常使用KL散度等损失函数)进行训练。常引入温度参数(Temperature)来软化概率分布,使小模型更容易学习到类别间的隐含关系。此外,总损失通常由蒸馏损失和传统交叉熵损失(针对真实标签)加权组成。
通过这种方式,学生模型能在推理效率更高的前提下,逼近甚至接近教师模型的性能,实现模型压缩与加速,广泛应用于大模型部署优化中。
模型蒸馏数学原理
大模型蒸馏的数学原理主要基于软标签的知识迁移,其核心是通过优化学生模型(Student)使其输出逼近教师模型(Teacher)的平滑概率分布。设输入为 x,类别数为 K。
1. Softmax with Temperature
教师模型通常使用一个高于1的温度 T 来生成更平滑的概率分布:
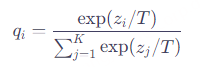
其中 zi 是第 i 类的logit输出。高温 T 使概率分布更“软”,保留类别间关系信息。
学生模型也用相同温度 T 计算其软化概率 pi。
2. 蒸馏损失函数(Distillation Loss)
使用KL散度衡量学生与教师软标签之间的差异:
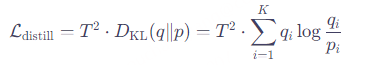
乘以 T平方 是为了在梯度传播时保持损失量级稳定。
3. 总损失
通常结合真实标签的交叉熵损失(使用 T=1):
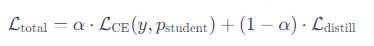
其中 y 是真实标签,α 是平衡权重。
通过该联合优化,学生模型既学习真实标注,又模仿教师的泛化能力,实现高效知识迁移。
模型蒸馏实践
在TLM平台的模型蒸馏模块可创建模型蒸馏任务。用户只需要选择教师模型和学生模型、数据集、参数设置(平台已内置)即可创建蒸馏任务。
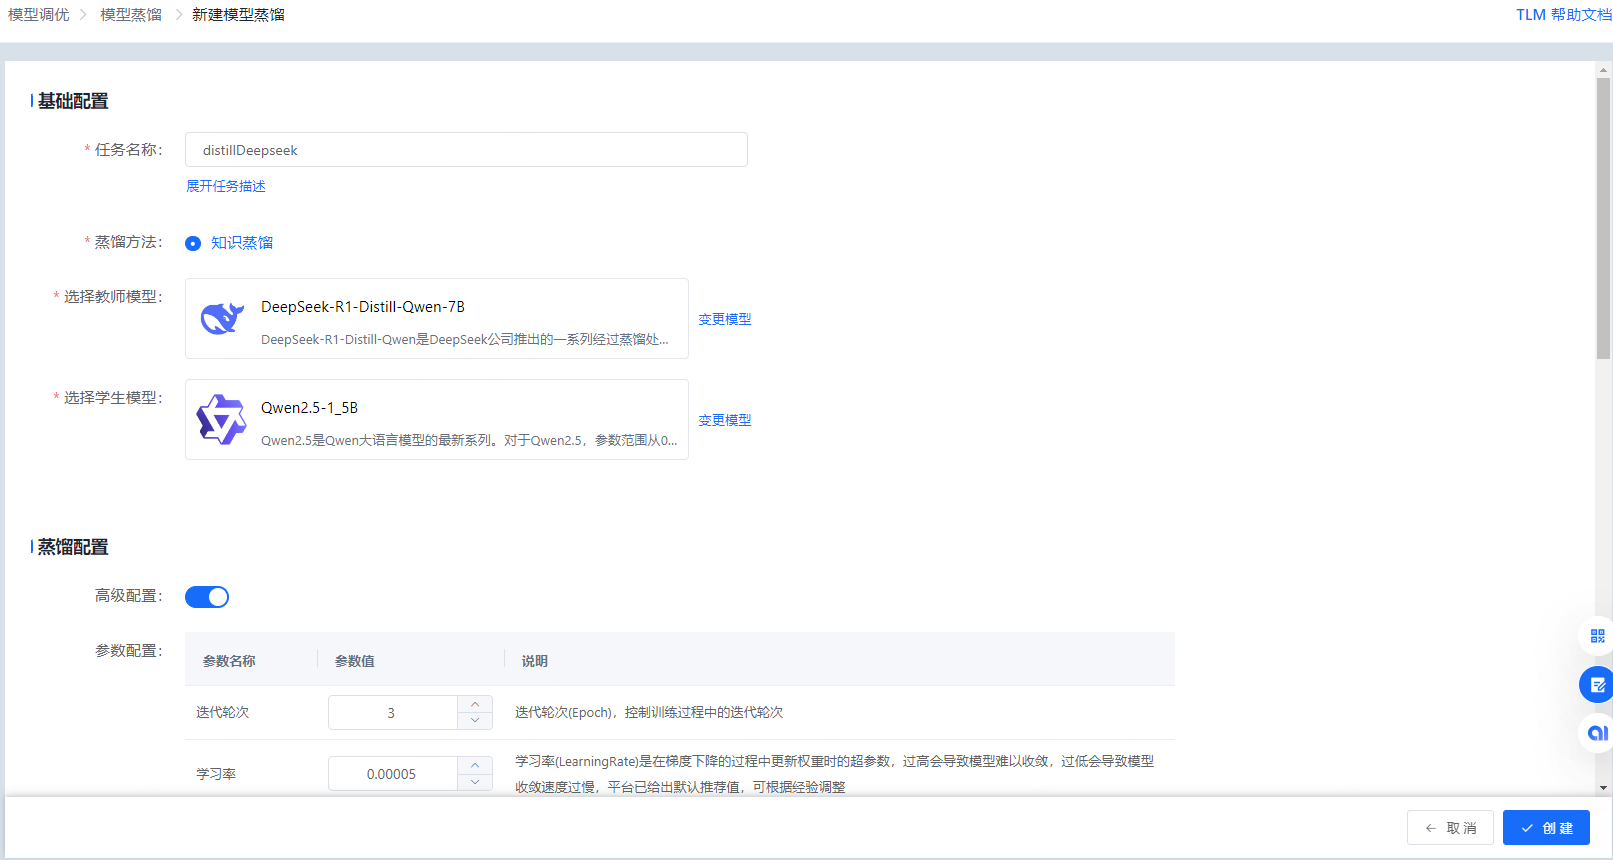
平台提供蒸馏前后模型的评测报告,可以直观的评估教师模型和学生模型之间的能力差异。
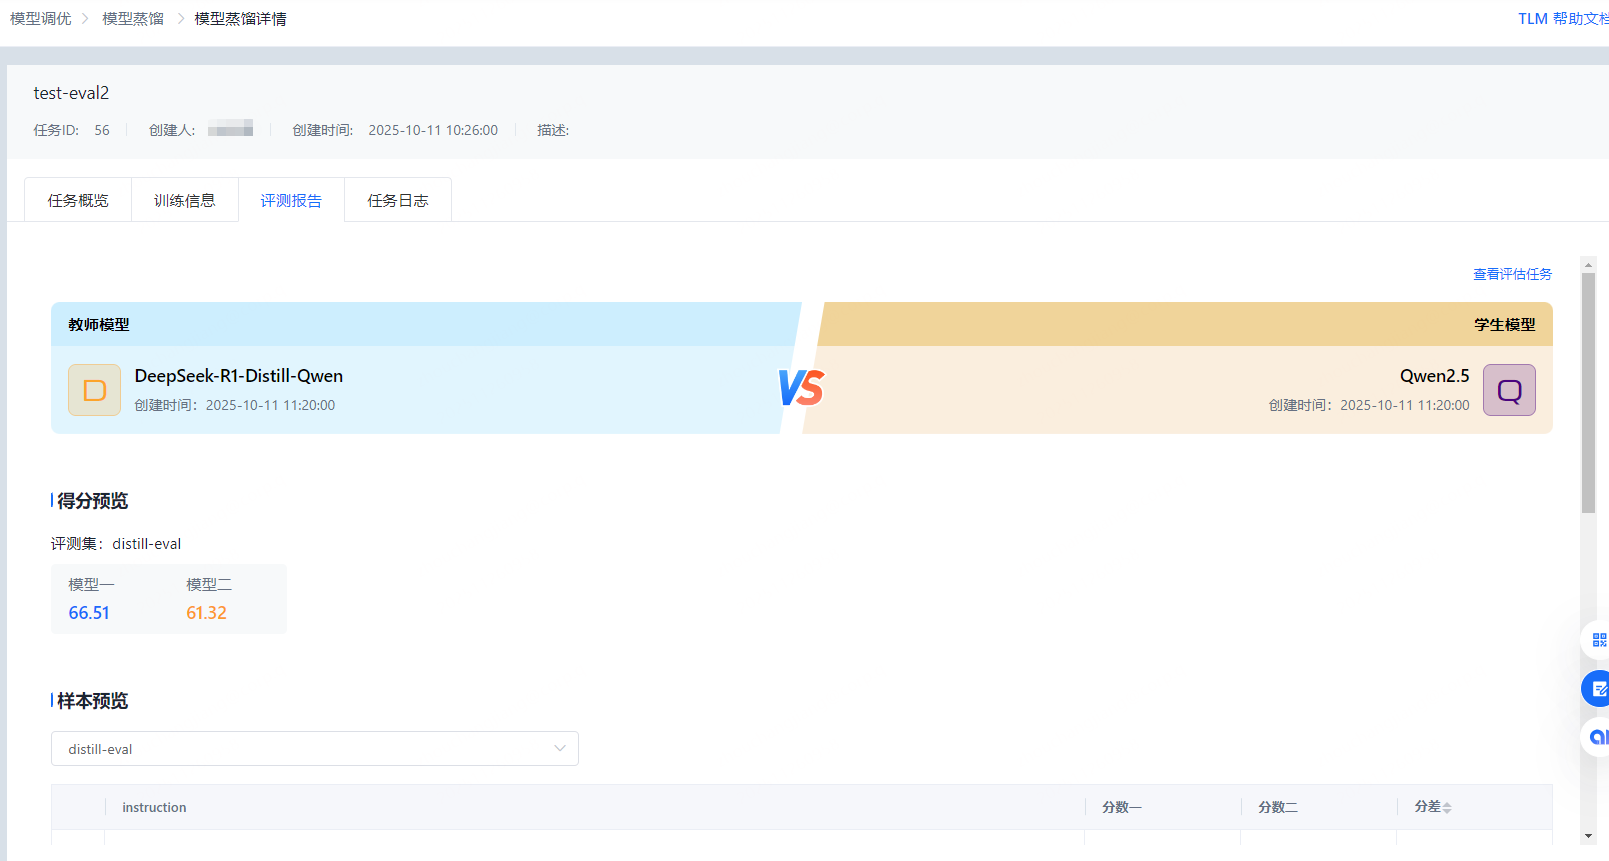
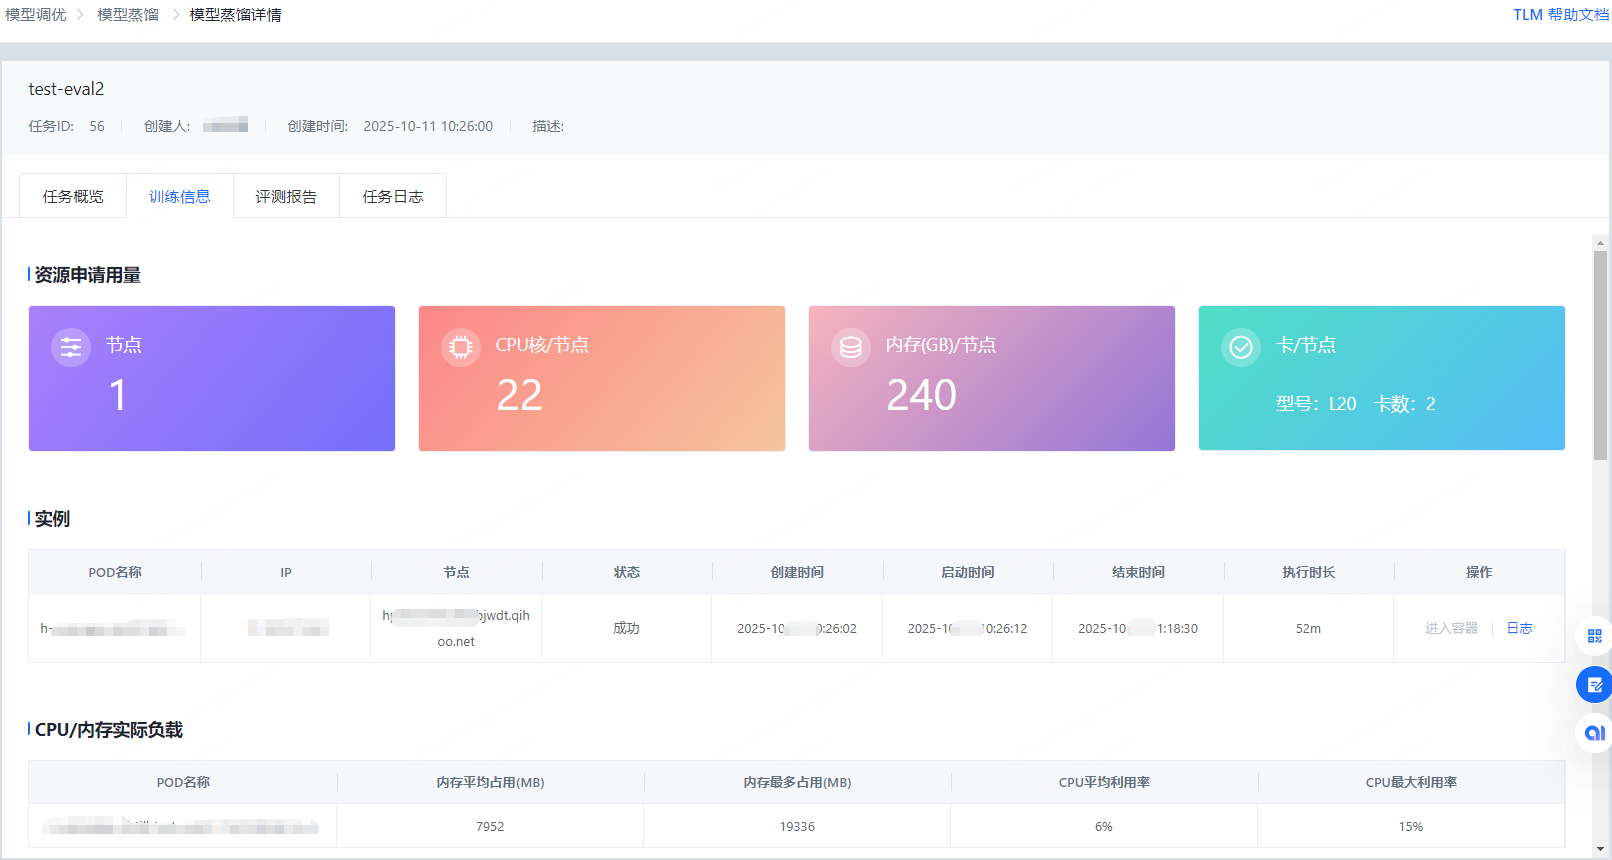
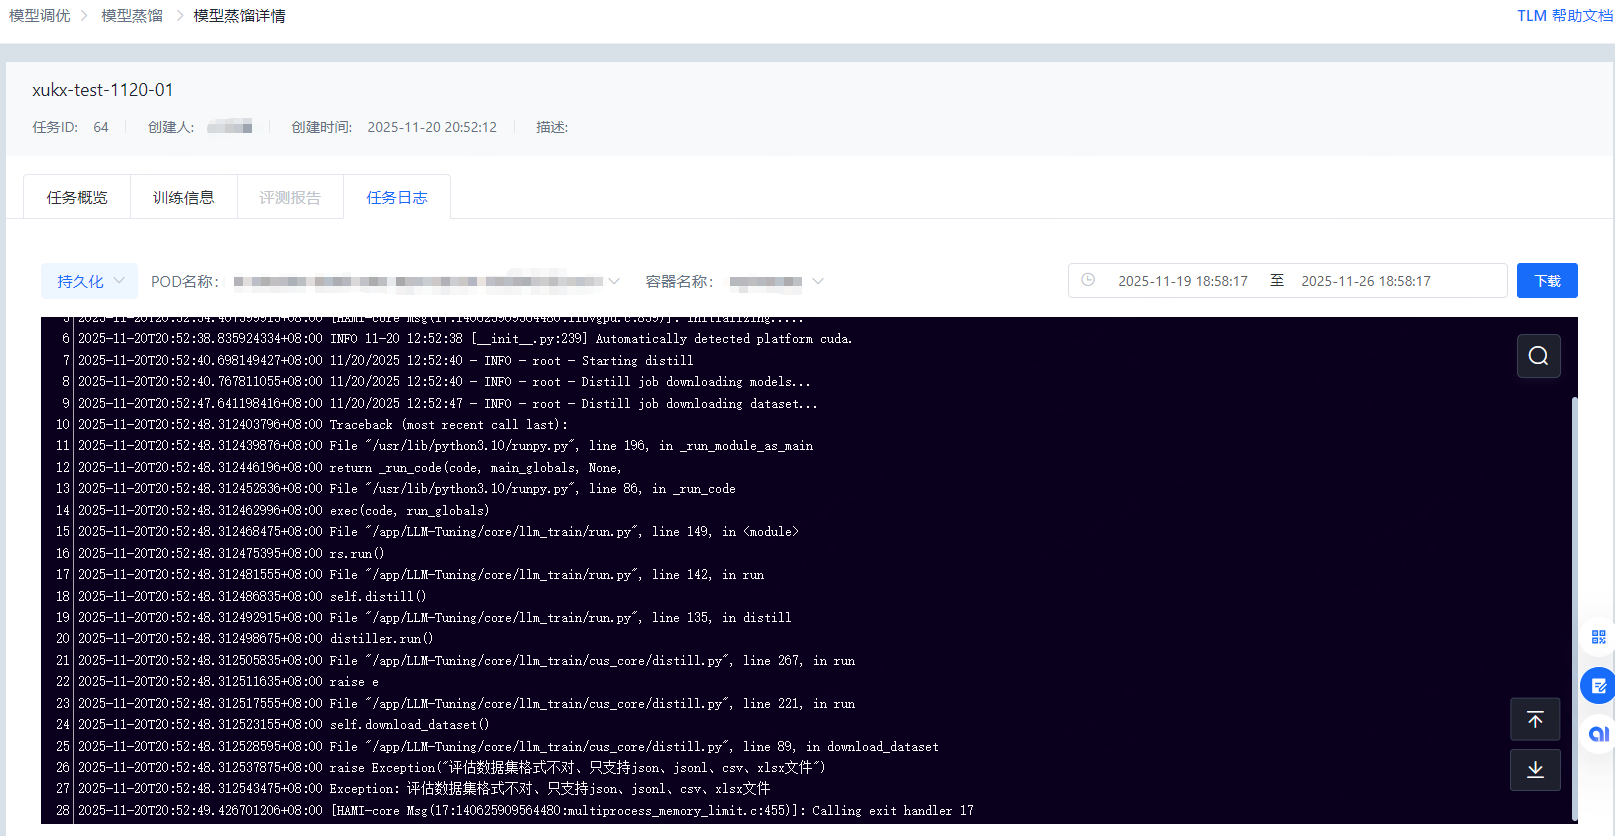
模型蒸馏过程中可以查看所使用的GPU、CPU、容器的监控信息,同事可查看运行日志。
更多推荐

 5
 0
- 0


 已为社区贡献11条内容

所有评论(0)