
突破MRS代谢物量化瓶颈!QNet:深度学习+线性最小二乘的智能解决方案
突破MRS代谢物量化瓶颈!QNet:深度学习+线性最小二乘的智能解决方案
磁共振波谱(Magnetic Resonance Spectroscopy, MRS)作为无创检测活体组织生化代谢物的“分子探针”,在脑肿瘤、神经退行性疾病(如阿尔茨海默病)、肝脏代谢异常等疾病的诊断与疗效随访中具有不可替代的临床价值。然而,质子MRS(¹H-MRS)的代谢物量化却长期受三大难题困扰:代谢物信号严重重叠(临床3T扫描仪磁场强度有限,谱峰拥挤)、采集缺陷干扰(相位偏移、频率偏移、线宽偏差、生理运动等非理想条件)、大分子背景信号干扰(占背景信号主要成分,掩盖弱代谢物信号)。
传统主流量化方法如LCModel,虽通过设计基组、缺陷因子等经验先验,采用非线性最小二乘求解,但在低信噪比(SNR)下误差显著增大;近年兴起的端到端深度学习方法,虽能处理低SNR数据,却因完全依赖训练数据,对训练外的代谢物浓度泛化性差。针对这些痛点,厦门大学屈小波教授团队提出了创新的MRS量化网络QNet,将深度学习的非线性学习能力与线性最小二乘(LLS)的解析求解优势结合,实现更精准、稳定且泛化性强的代谢物量化。相关成果发表于《IEEE Transactions on Biomedical Engineering》(2024年6月,Vol.71, No.6)。
一、QNet:核心设计理念与整体框架
QNet的核心创新在于“拆分难题+协同优化”:先用深度学习模块分别预测采集缺陷因子(Imperfection Factors, IFs)和大分子(Macromolecules, MMs)背景信号,将复杂的非线性量化问题简化为线性问题;再通过LLS解析求解代谢物浓度,且LLS全程参与网络反向传播,将量化误差反馈至代谢物波谱估计,大幅提升泛化性。
QNet的完整流程可通过图1理解(覆盖从数据合成到浓度估计的全链路),具体拆解如下:
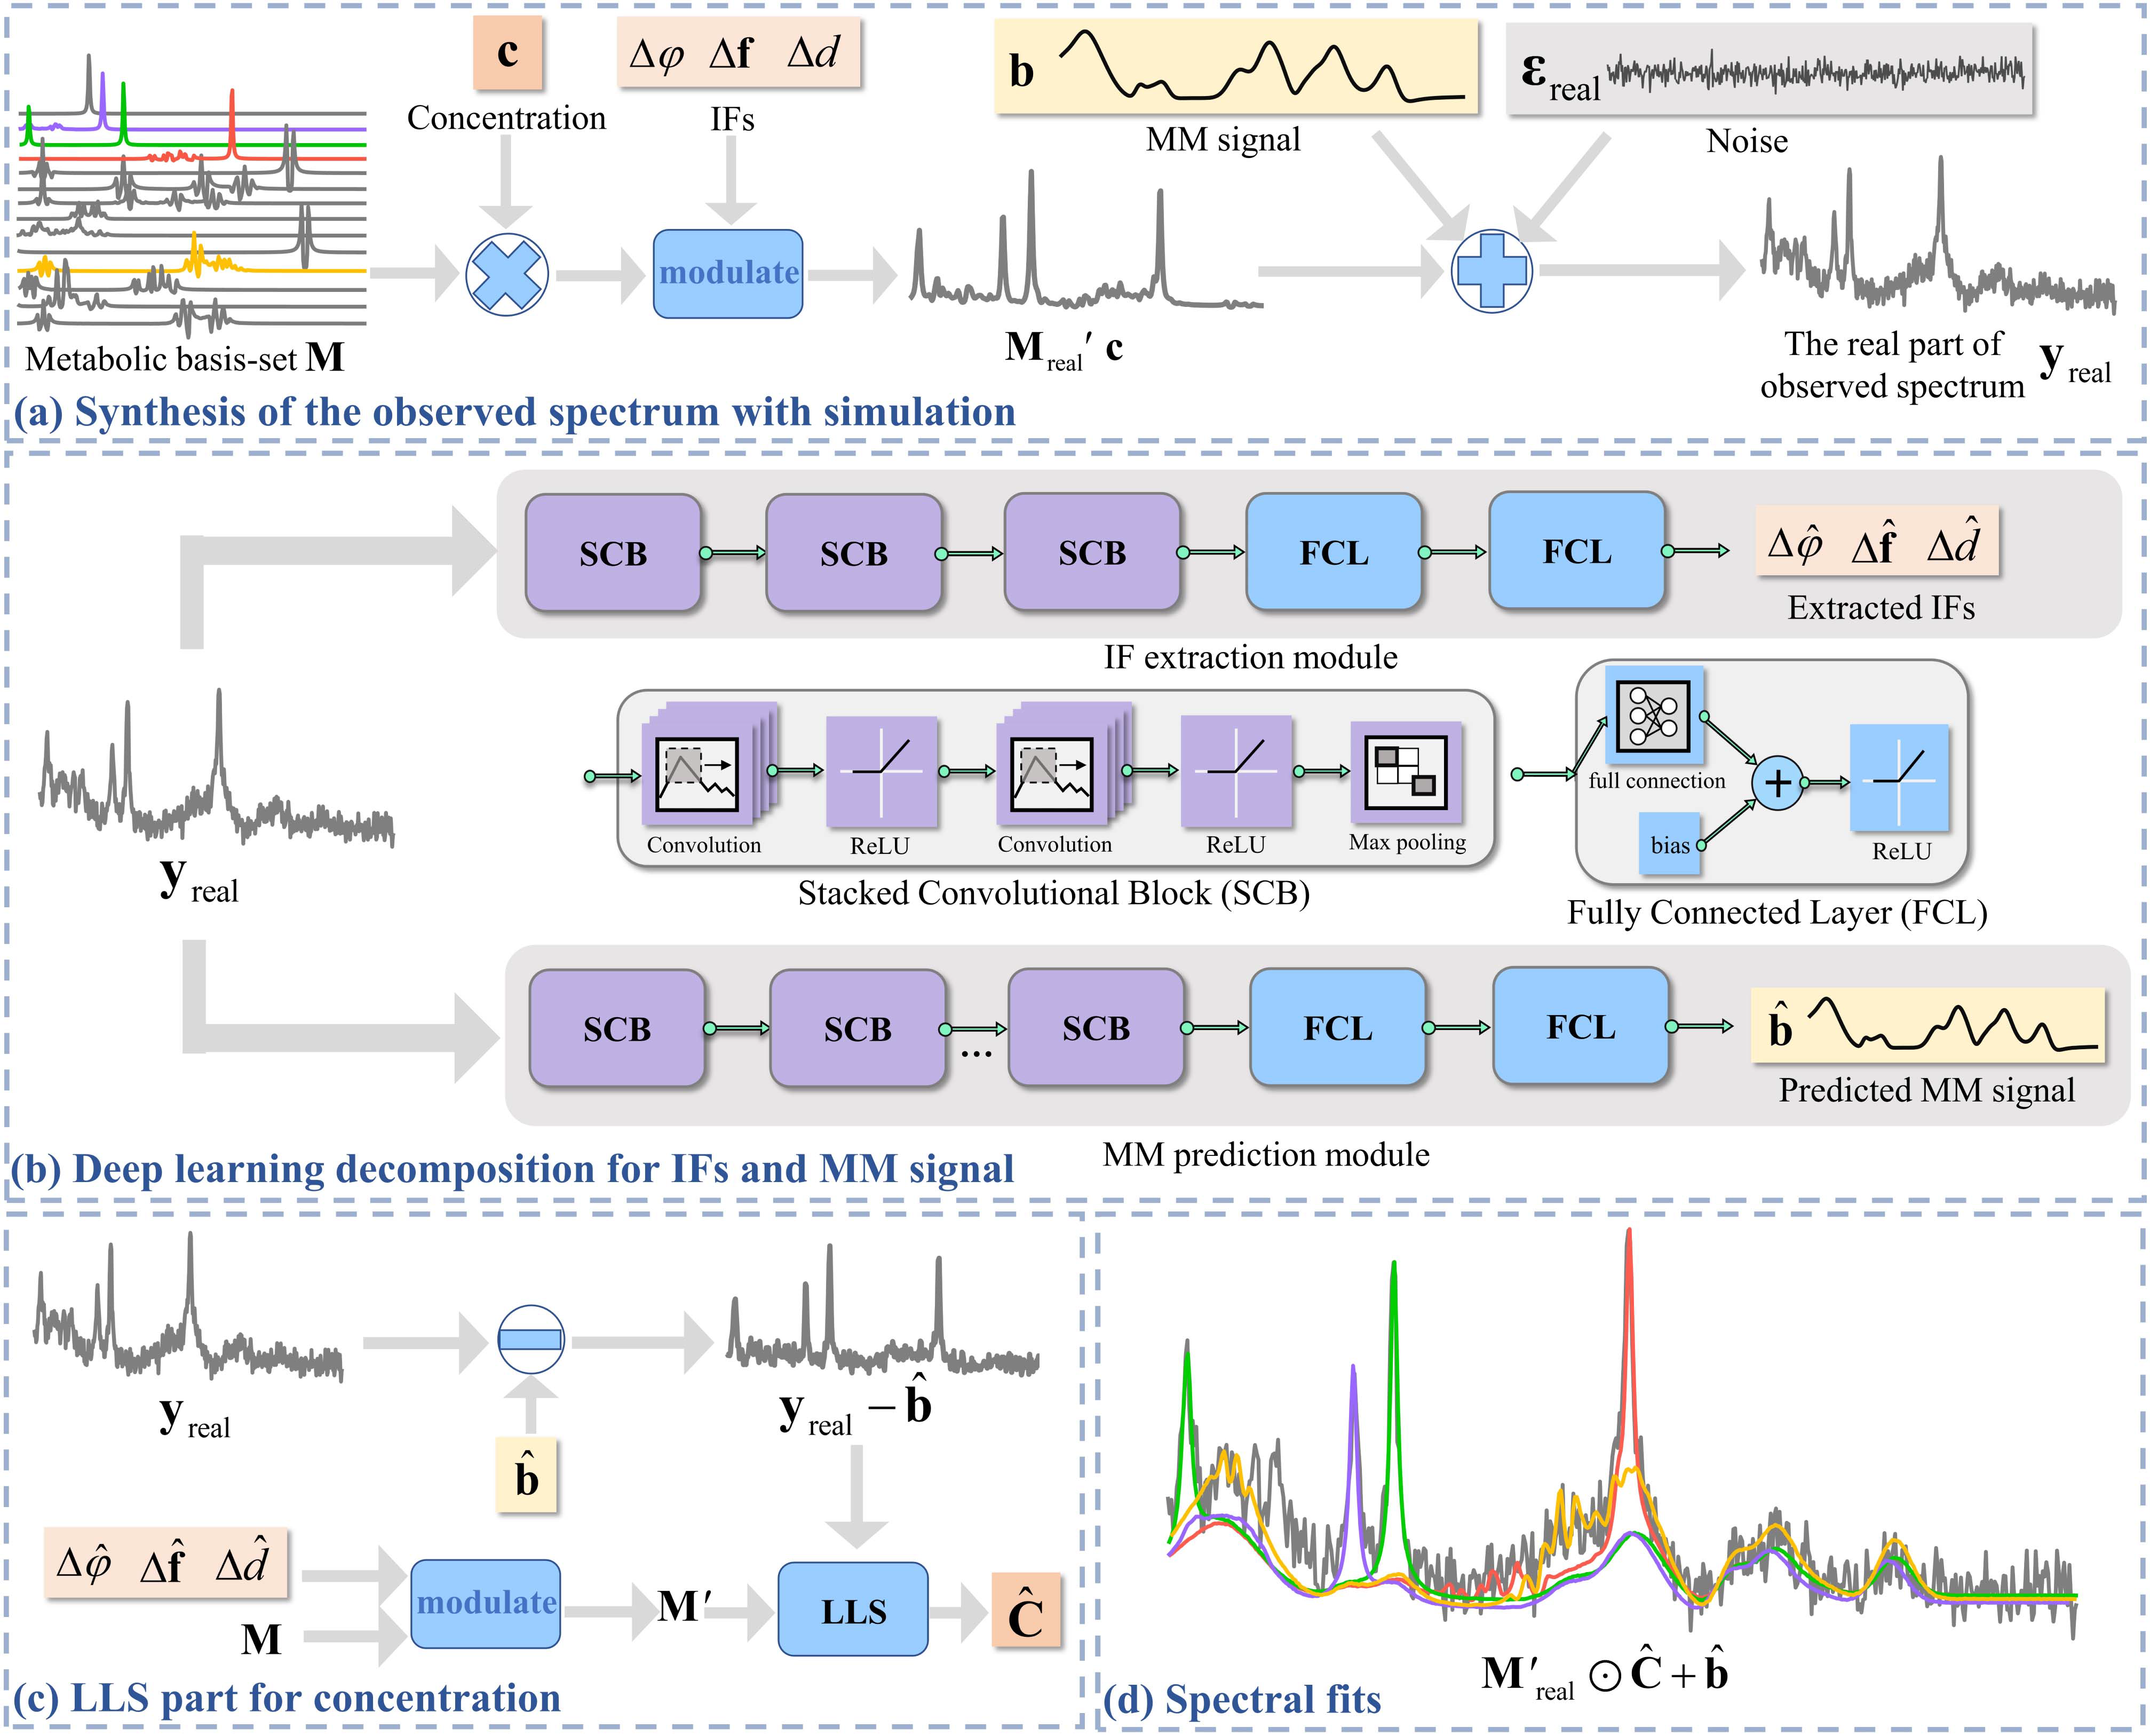
1. 光谱合成:物理驱动的训练数据生成(图1(a))
基于量子力学指数模型(QMEM)生成符合真实物理规律的模拟MRS信号,公式为:
y
^
(
n
Δ
t
)
=
∑
k
=
1
K
c
k
h
k
(
m
k
(
n
Δ
t
)
∣
θ
k
)
+
b
(
n
Δ
t
)
+
ε
(
n
Δ
t
)
\hat{y}(n\Delta t) = \sum_{k=1}^{K} c_{k} h_{k}(m_{k}(n\Delta t)|\theta_{k}) + b(n\Delta t) + \varepsilon(n\Delta t)
y^(nΔt)=∑k=1Kckhk(mk(nΔt)∣θk)+b(nΔt)+ε(nΔt)
其中:
- c k c_k ck :第k种代谢物浓度;
- h k h_k hk :经缺陷因子 θ k \theta_k θk (含相位偏移 Δ φ \Delta\varphi Δφ 、频率偏移 Δ f k \Delta f_k Δfk 、线宽偏差 Δ d \Delta d Δd )调制后的代谢物信号;
- b b b :大分子背景信号;
-
ε
\varepsilon
ε :复高斯噪声(模拟临床扫描噪声)。
这一步是为了生成大规模、高保真的训练数据,解决真实MRS数据“难以获取代谢物真实浓度标签”的问题。
2. 深度学习双模块:拆解核心干扰(图1(b))
输入为检测波谱的实部 y r e a l y_{real} yreal ,两个并行模块分别处理“采集缺陷”和“大分子干扰”:
(1)缺陷因子提取模块
- 结构:3个堆叠卷积块(SCB)+ 2个全连接层(FCL)。每个SCB含2个卷积层,滤波器数量依次为16、32、64(核大小3×1,确保光谱时序特征提取),卷积后经ReLU激活函数(引入非线性)和最大池化(降维并保留关键特征);最终输出3个缺陷因子:
Δ
φ
^
,
Δ
f
^
,
Δ
d
^
{\Delta\hat{\varphi}, \Delta\hat{f}, \Delta\hat{d}}
Δφ^,Δf^,Δd^ ,公式为:
N e x t r a c t i o n ( y r e a l ∣ Θ e x t r a c t i o n ) = { Δ φ ^ , Δ f ^ , Δ d ^ } \mathcal{N}_{extraction}\left(y_{real} | \Theta_{extraction}\right)=\{\Delta \hat{\varphi}, \Delta \hat{f}, \Delta \hat{d}\} Nextraction(yreal∣Θextraction)={Δφ^,Δf^,Δd^}
其中 Θ e x t r a c t i o n \Theta_{extraction} Θextraction 为模块可训练参数。
(2)大分子信号预测模块
- 结构:6个SCB + 2个FCL。SCB滤波器数量依次为16、32、64、128、256(核大小3×1,适配大分子信号的宽谱特征),同样经ReLU激活和最大池化;最终输出与输入光谱长度一致的大分子信号
b
^
\hat{b}
b^ (512×1向量),公式为:
N p r e d i c t i o n ( y r e a l ∣ Θ p r e d i c t i o n ) = b ^ \mathcal{N}_{prediction}\left(y_{real} | \Theta_{prediction}\right)=\hat{b} Nprediction(yreal∣Θprediction)=b^
其中 Θ p r e d i c t i o n \Theta_{prediction} Θprediction 为模块可训练参数。
3. LLS浓度估计:解析求解+误差反馈(图1©)
这是QNet与传统端到端深度学习的核心差异——LLS并非独立工具,而是深度网络的“优化闭环组件”,具体步骤:
- 基组修正:用预测的缺陷因子调制代谢物基组 M M M ,得到修正基组 M ′ = h ( M , Δ φ ^ , Δ f ^ , Δ d ^ ) M' = h(M, \Delta\hat{\varphi}, \Delta\hat{f}, \Delta\hat{d}) M′=h(M,Δφ^,Δf^,Δd^) (消除采集缺陷对基组的影响);
- 背景扣除:从检测光谱中减去预测的大分子信号,得到“纯净代谢物信号”: y r e a l − b ^ y_{real} - \hat{b} yreal−b^ ;
- 解析求解浓度:通过LLS求解代谢物浓度 c ^ \hat{c} c^
- 误差反馈:LLS计算的浓度误差会通过反向传播更新深度学习双模块的参数,实现“量化误差→光谱估计优化”的闭环,大幅提升泛化性。
4. 光谱拟合与损失函数(图1(d))
最终输出调制后的基组 M ^ = M ′ ⊙ C ^ \hat{M} = M' \odot \hat{C} M^=M′⊙C^ ( ⊙ \odot ⊙ 为哈达玛积, C ^ \hat{C} C^ 为浓度矩阵),与检测光谱对比实现拟合。损失函数平衡“光谱拟合误差”与“大分子信号预测误差”:
L
o
s
s
(
Θ
)
=
1
K
∥
M
^
−
M
l
a
b
e
l
∥
F
2
+
α
∥
b
^
−
b
l
a
b
e
l
∥
F
2
Loss(\Theta) = \frac{1}{K}\|\hat{M} - M^{label}\|_F^2 + \alpha\|\hat{b} - b^{label}\|_F^2
Loss(Θ)=K1∥M^−Mlabel∥F2+α∥b^−blabel∥F2
其中
∣
⋅
∣
F
|\cdot|_F
∣⋅∣F 为弗罗贝尼乌斯范数(衡量矩阵差异),
α
\alpha
α 为平衡系数,
Θ
=
Θ
e
x
t
r
a
c
t
i
o
n
,
Θ
p
r
e
d
i
c
t
i
o
n
\Theta = {\Theta_{extraction}, \Theta_{prediction}}
Θ=Θextraction,Θprediction 为全局网络参数。
二、数据准备:从物理模拟到临床验证
为确保QNet的泛化性与临床适用性,研究设计“模拟数据训练+在体数据验证”的方案,具体参数如下:
1. 模拟数据:大规模物理驱动训练集
模拟数据需覆盖临床常见的代谢物浓度、缺陷因子与噪声水平,确保训练充分:
- 代谢物设置:17种常见脑代谢物,浓度范围参考临床文献(如NAA 7.5-17 mM、Glu 6.0-12.5 mM、Cr 4.5-10.5 mM、GSH 1.5-3.0 mM等);
- 大分子信号:17个高斯函数合成(模拟真实大分子宽谱特征),每个高斯函数的化学位移、振幅、线宽参考文献,振幅/线宽分别随机波动±10%/±20%,大分子与代谢物信号强度比为0.15:1(波动±25%);
- 缺陷因子范围:相位偏移[-5.00,5.00]°、频率偏移[-0.08,0.08]ppm、线宽偏差[0.04,0.12]ppm(覆盖临床3T扫描仪的典型误差);
- SNR范围:[3,80](对应临床8-128次信号平均的SNR水平),SNR定义为NAA甲基峰(~2.0ppm)振幅与8.0-10.0ppm噪声标准差的比值;
- 数据量与预处理:60000组训练数据、700组测试数据,均进行振幅归一化并裁剪为0.2-4.0ppm范围内的512个数据点(聚焦代谢物集中的谱段)。
2. 在体数据:临床场景真实性验证
在体数据用于验证QNet的临床实用性,扫描方案严格遵循临床标准:
- 设备与序列:Philips 3T磁共振扫描仪,32通道头线圈;快速自旋回波序列获取T1加权像(用于体素定位),点分辨波谱序列(PRESS)采集MRS数据(含水抑制模块,避免水信号掩盖代谢物);
- 关键参数:TR=2000ms、TE=35ms(短TE减少代谢物信号衰减),体素大小20×20×20mm³(平衡空间分辨率与信噪比),数据点2048,光谱带宽2000Hz,信号平均次数(NSA)=128;
- 研究对象:20名健康志愿者,脑区覆盖前额叶(15例)、顶叶(1例)、枕叶(1例)、扣带回(3例)(覆盖常见临床感兴趣区);
- 伦理审批:经厦门大学伦理委员会批准(审批号XDYX202206K11),符合医学研究伦理规范。
三、核心结果:QNet vs 传统方法,优势何在?
研究从“准确性”“稳定性”“泛化性”三个维度,将QNet与主流方法(LCModel、端到端深度学习)对比,结果均显示QNet的显著优势。
1. 模拟数据:低SNR下仍保持高准确性
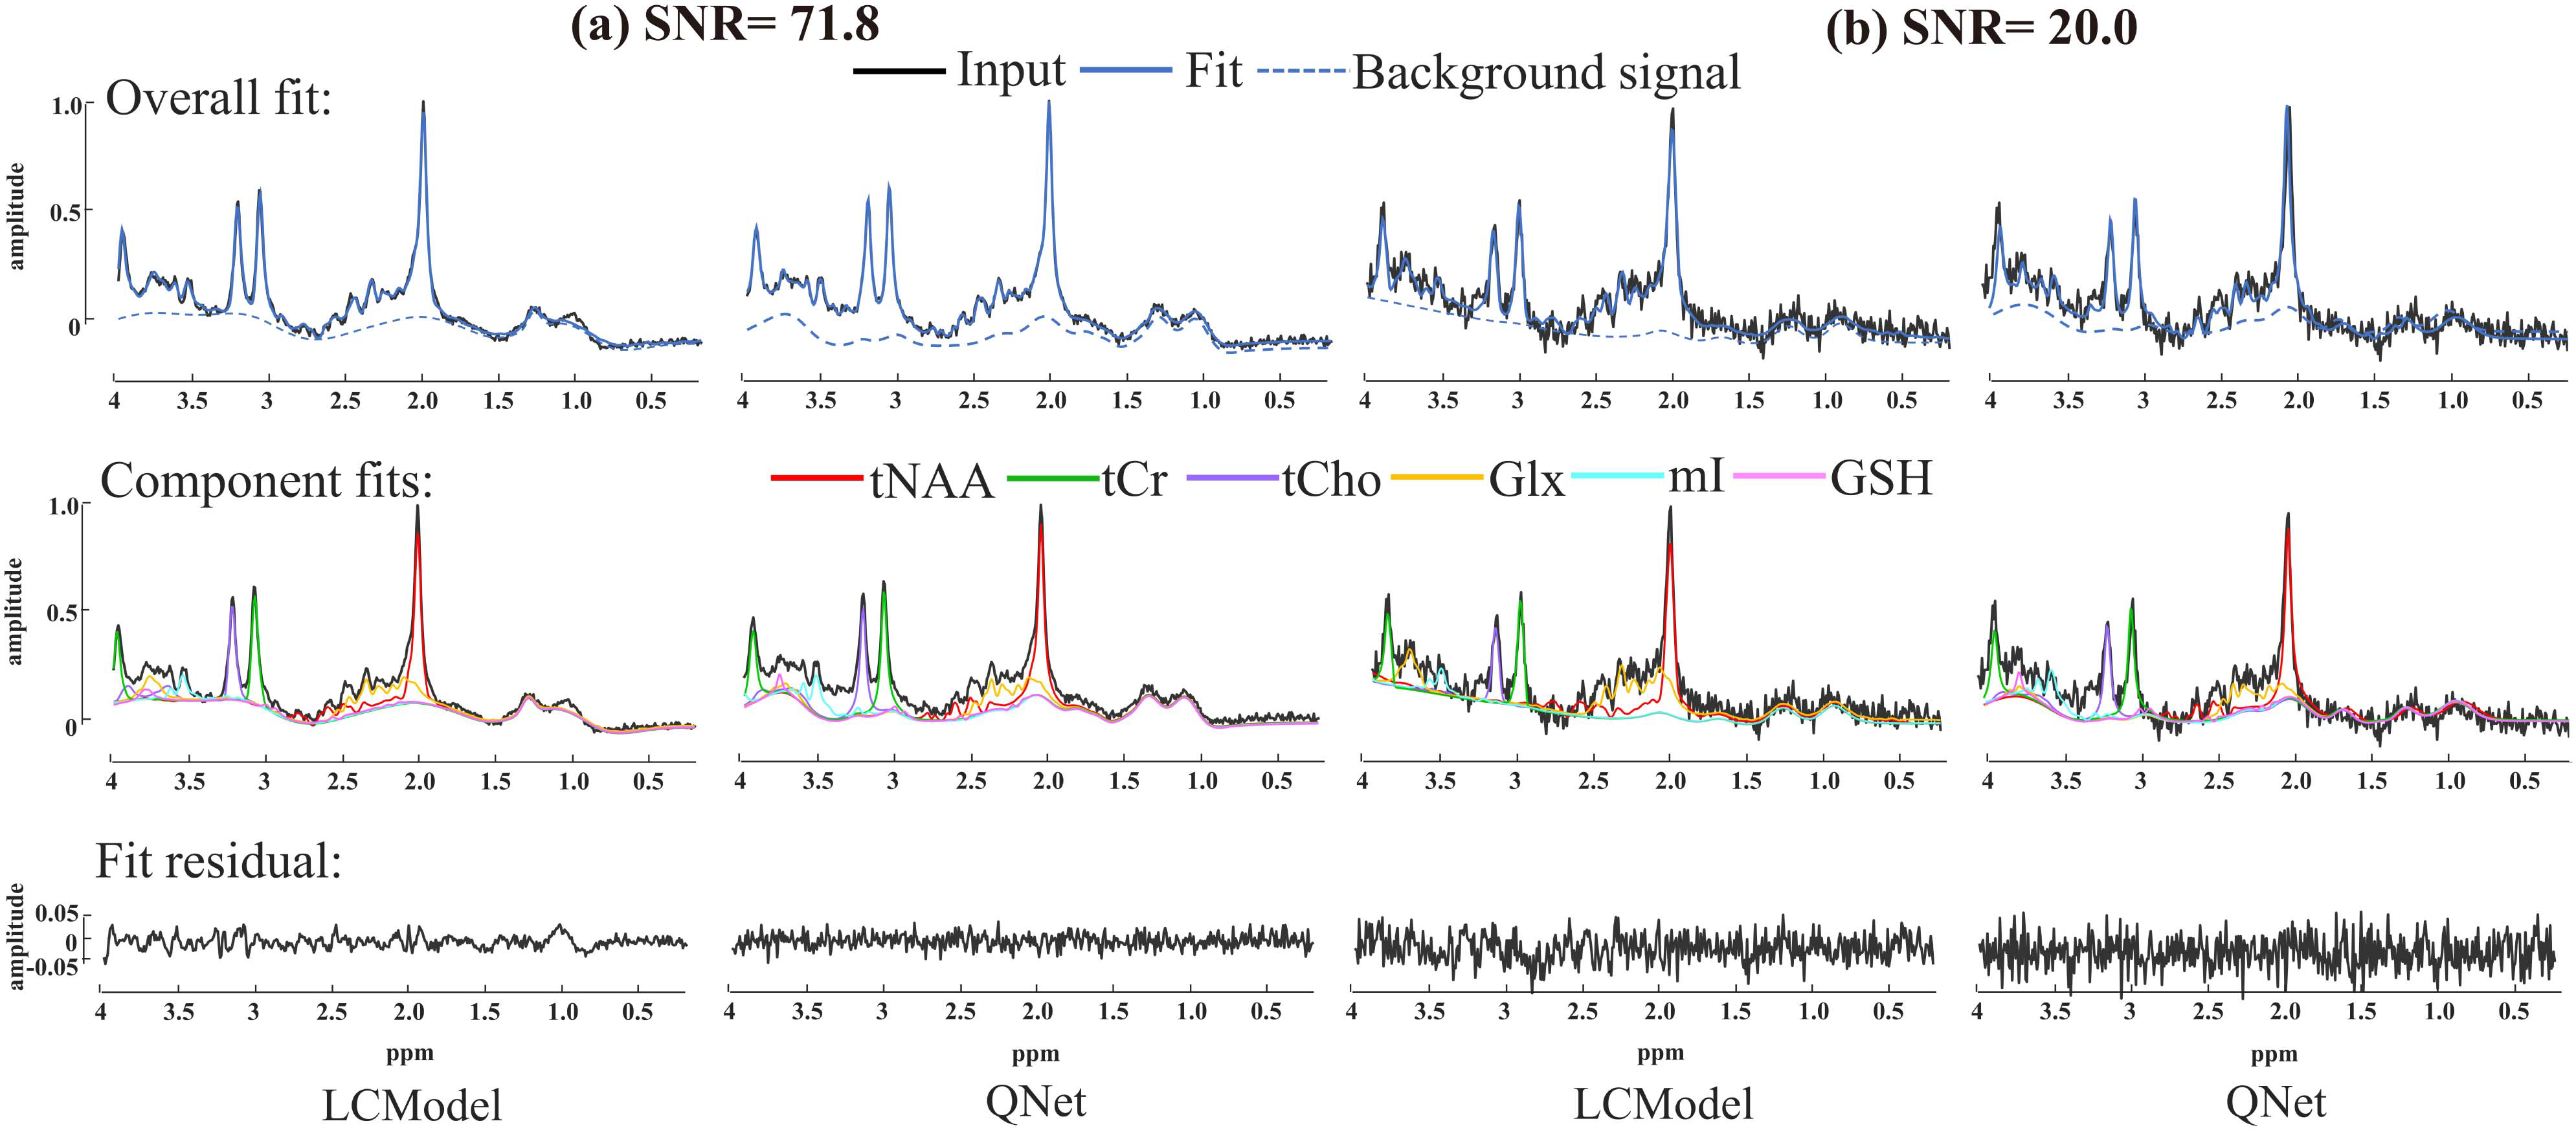
(1)视觉拟合对比(图2)
- 高SNR(71.8):QNet与LCModel均实现精准拟合,残差小;但QNet的残差更接近纯噪声水平(波动范围±0.1),而LCModel残差在弱信号区域(如GSH对应谱段)有明显偏差;
- 低SNR(20.0):两者残差均增大,但QNet仍能捕捉tNAA、tCr、tCho等主要代谢物的信号峰形,而LCModel对GSH、Glx等弱信号代谢物的拟合已严重偏离真实谱形。
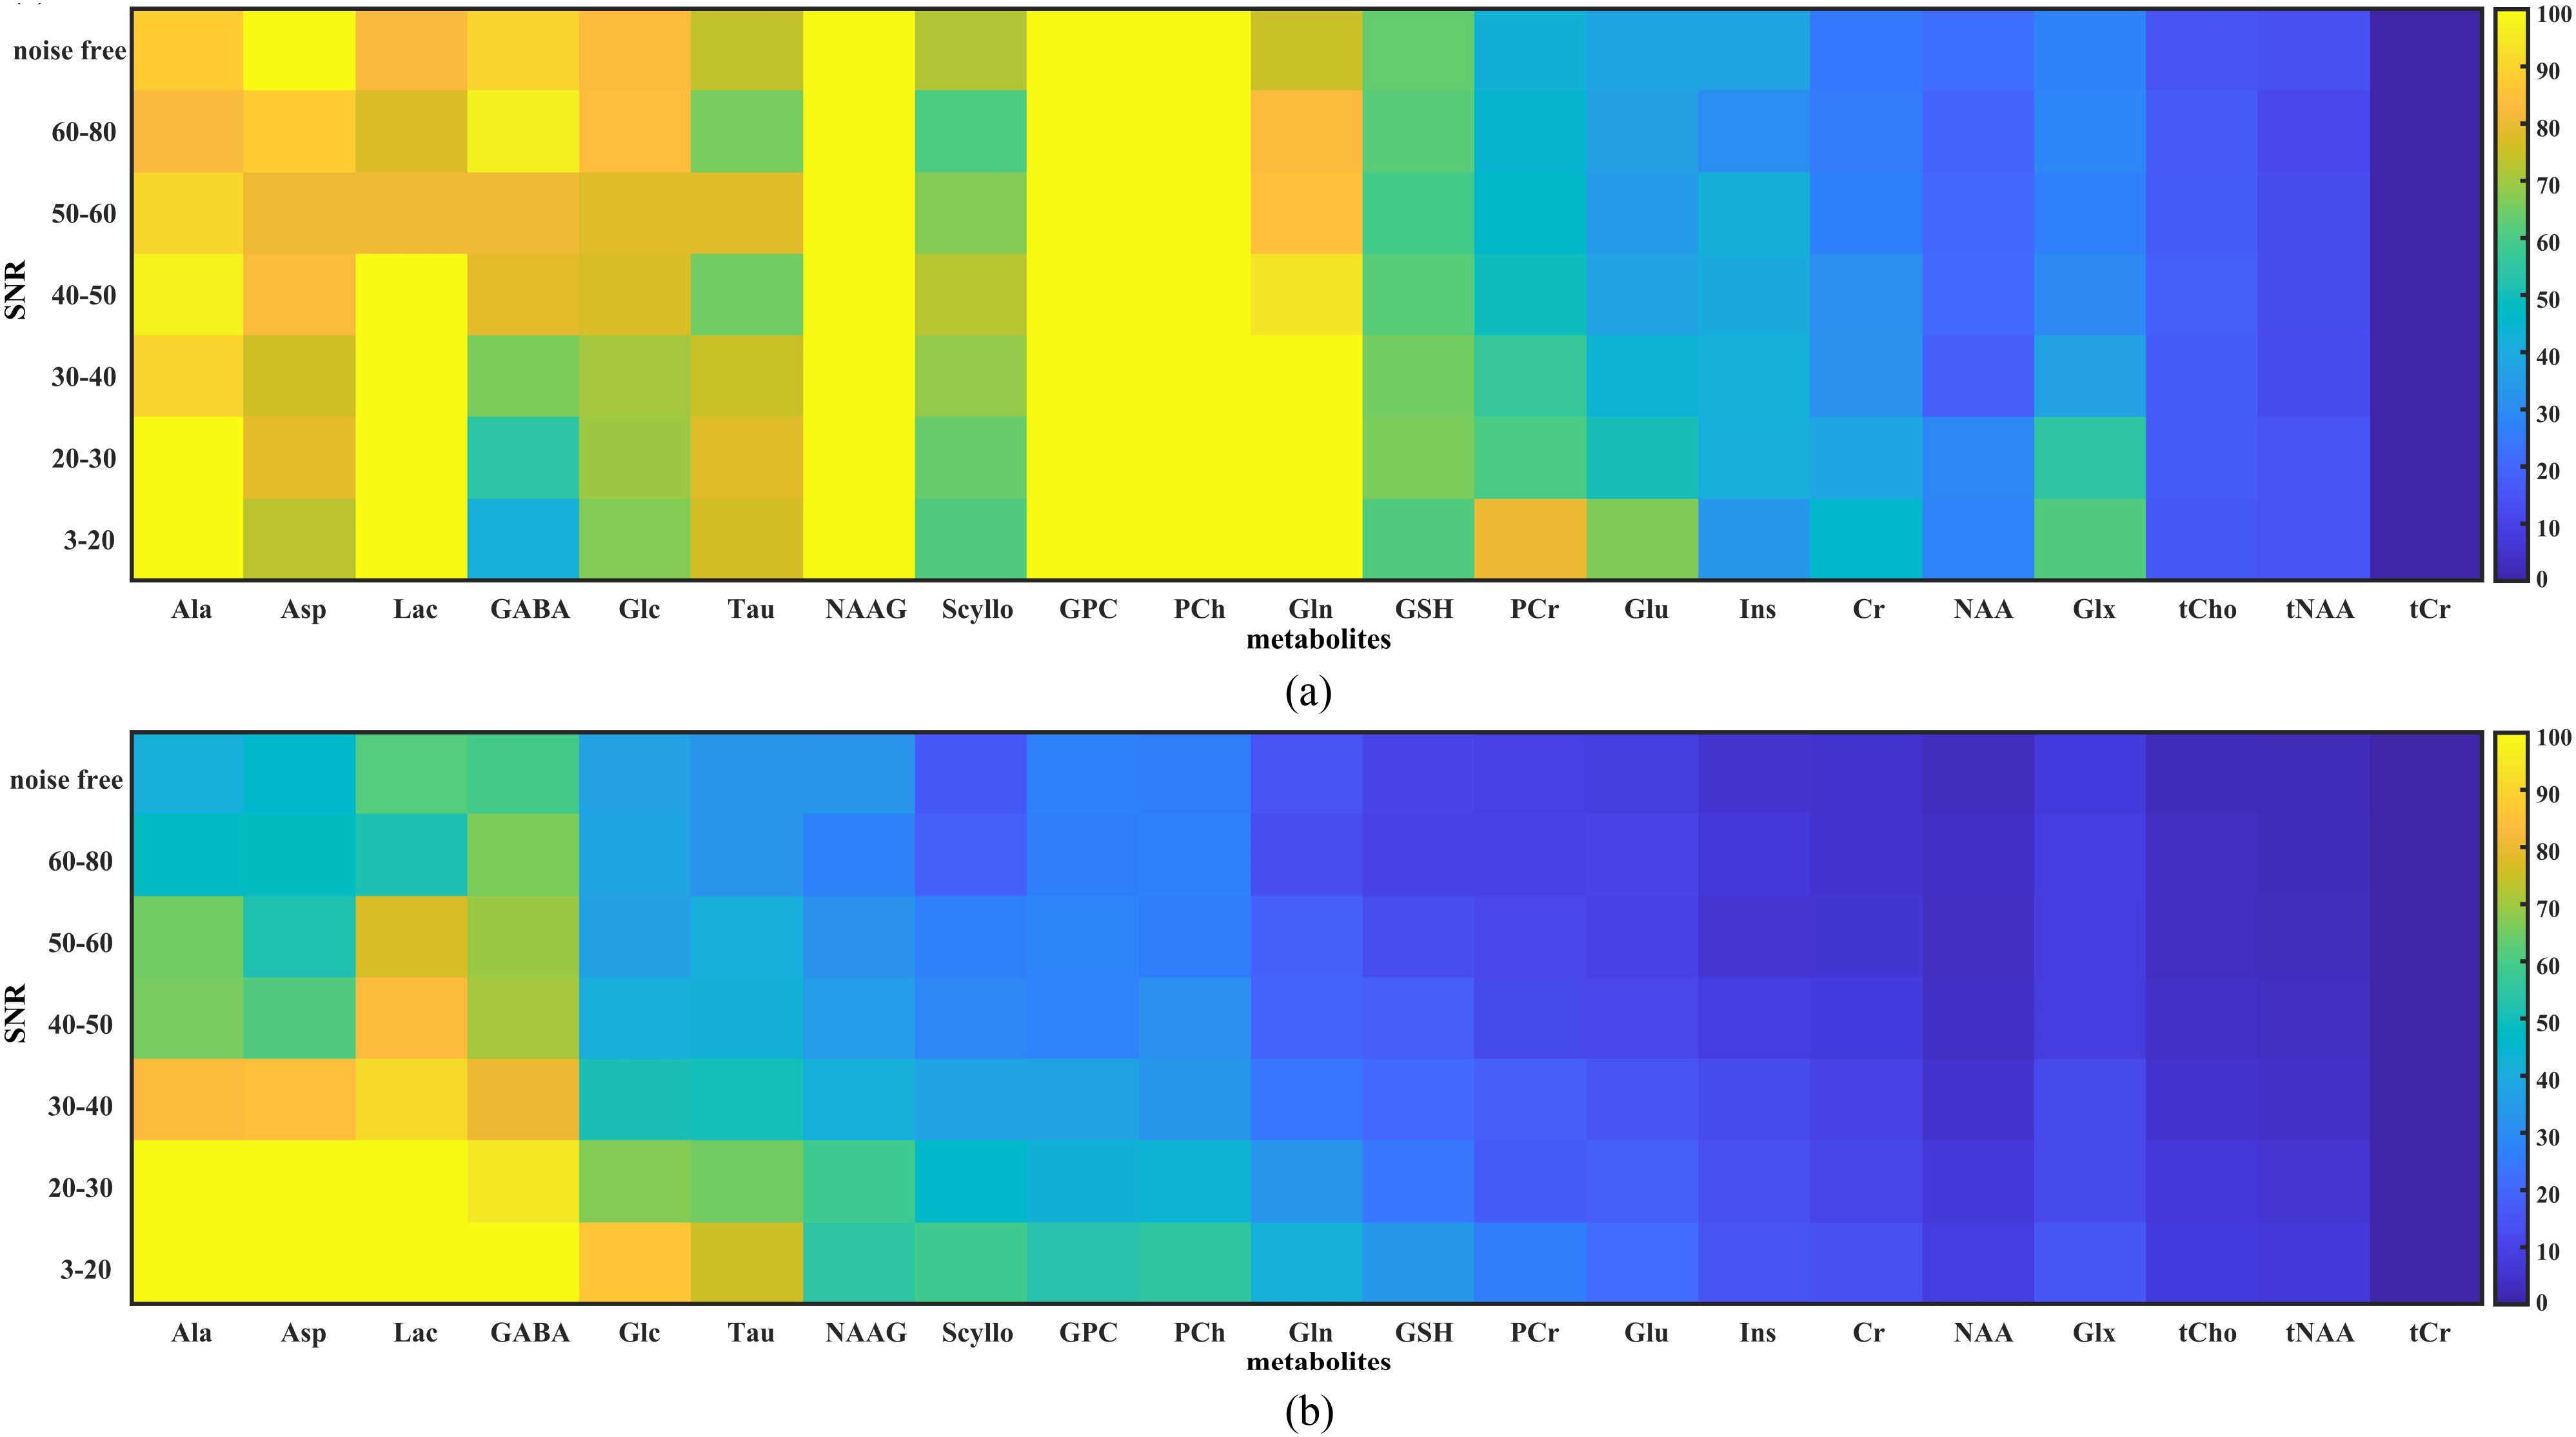
(2)定量误差对比(图3、MAPE指标)
MAPE(平均绝对百分比误差)越低,量化越准确。结果显示:
- 对多数代谢物(除Ala、Asp、Lac、GABA等极低浓度者),QNet的MAPE显著低于LCModel;
- 对LCModel误差极大的代谢物(如NAAG、GPC、PCh),QNet的MAPE从近100%降至30%以下,解决传统方法“弱信号难量化”的痛点;
- 随SNR降低(从80降至3),LCModel的MAPE增幅(如tNAA从5%升至40%)远大于QNet(tNAA从3%升至15%),证明QNet对噪声的鲁棒性更强。
2. 在体数据:与LCModel高度一致,且更稳定
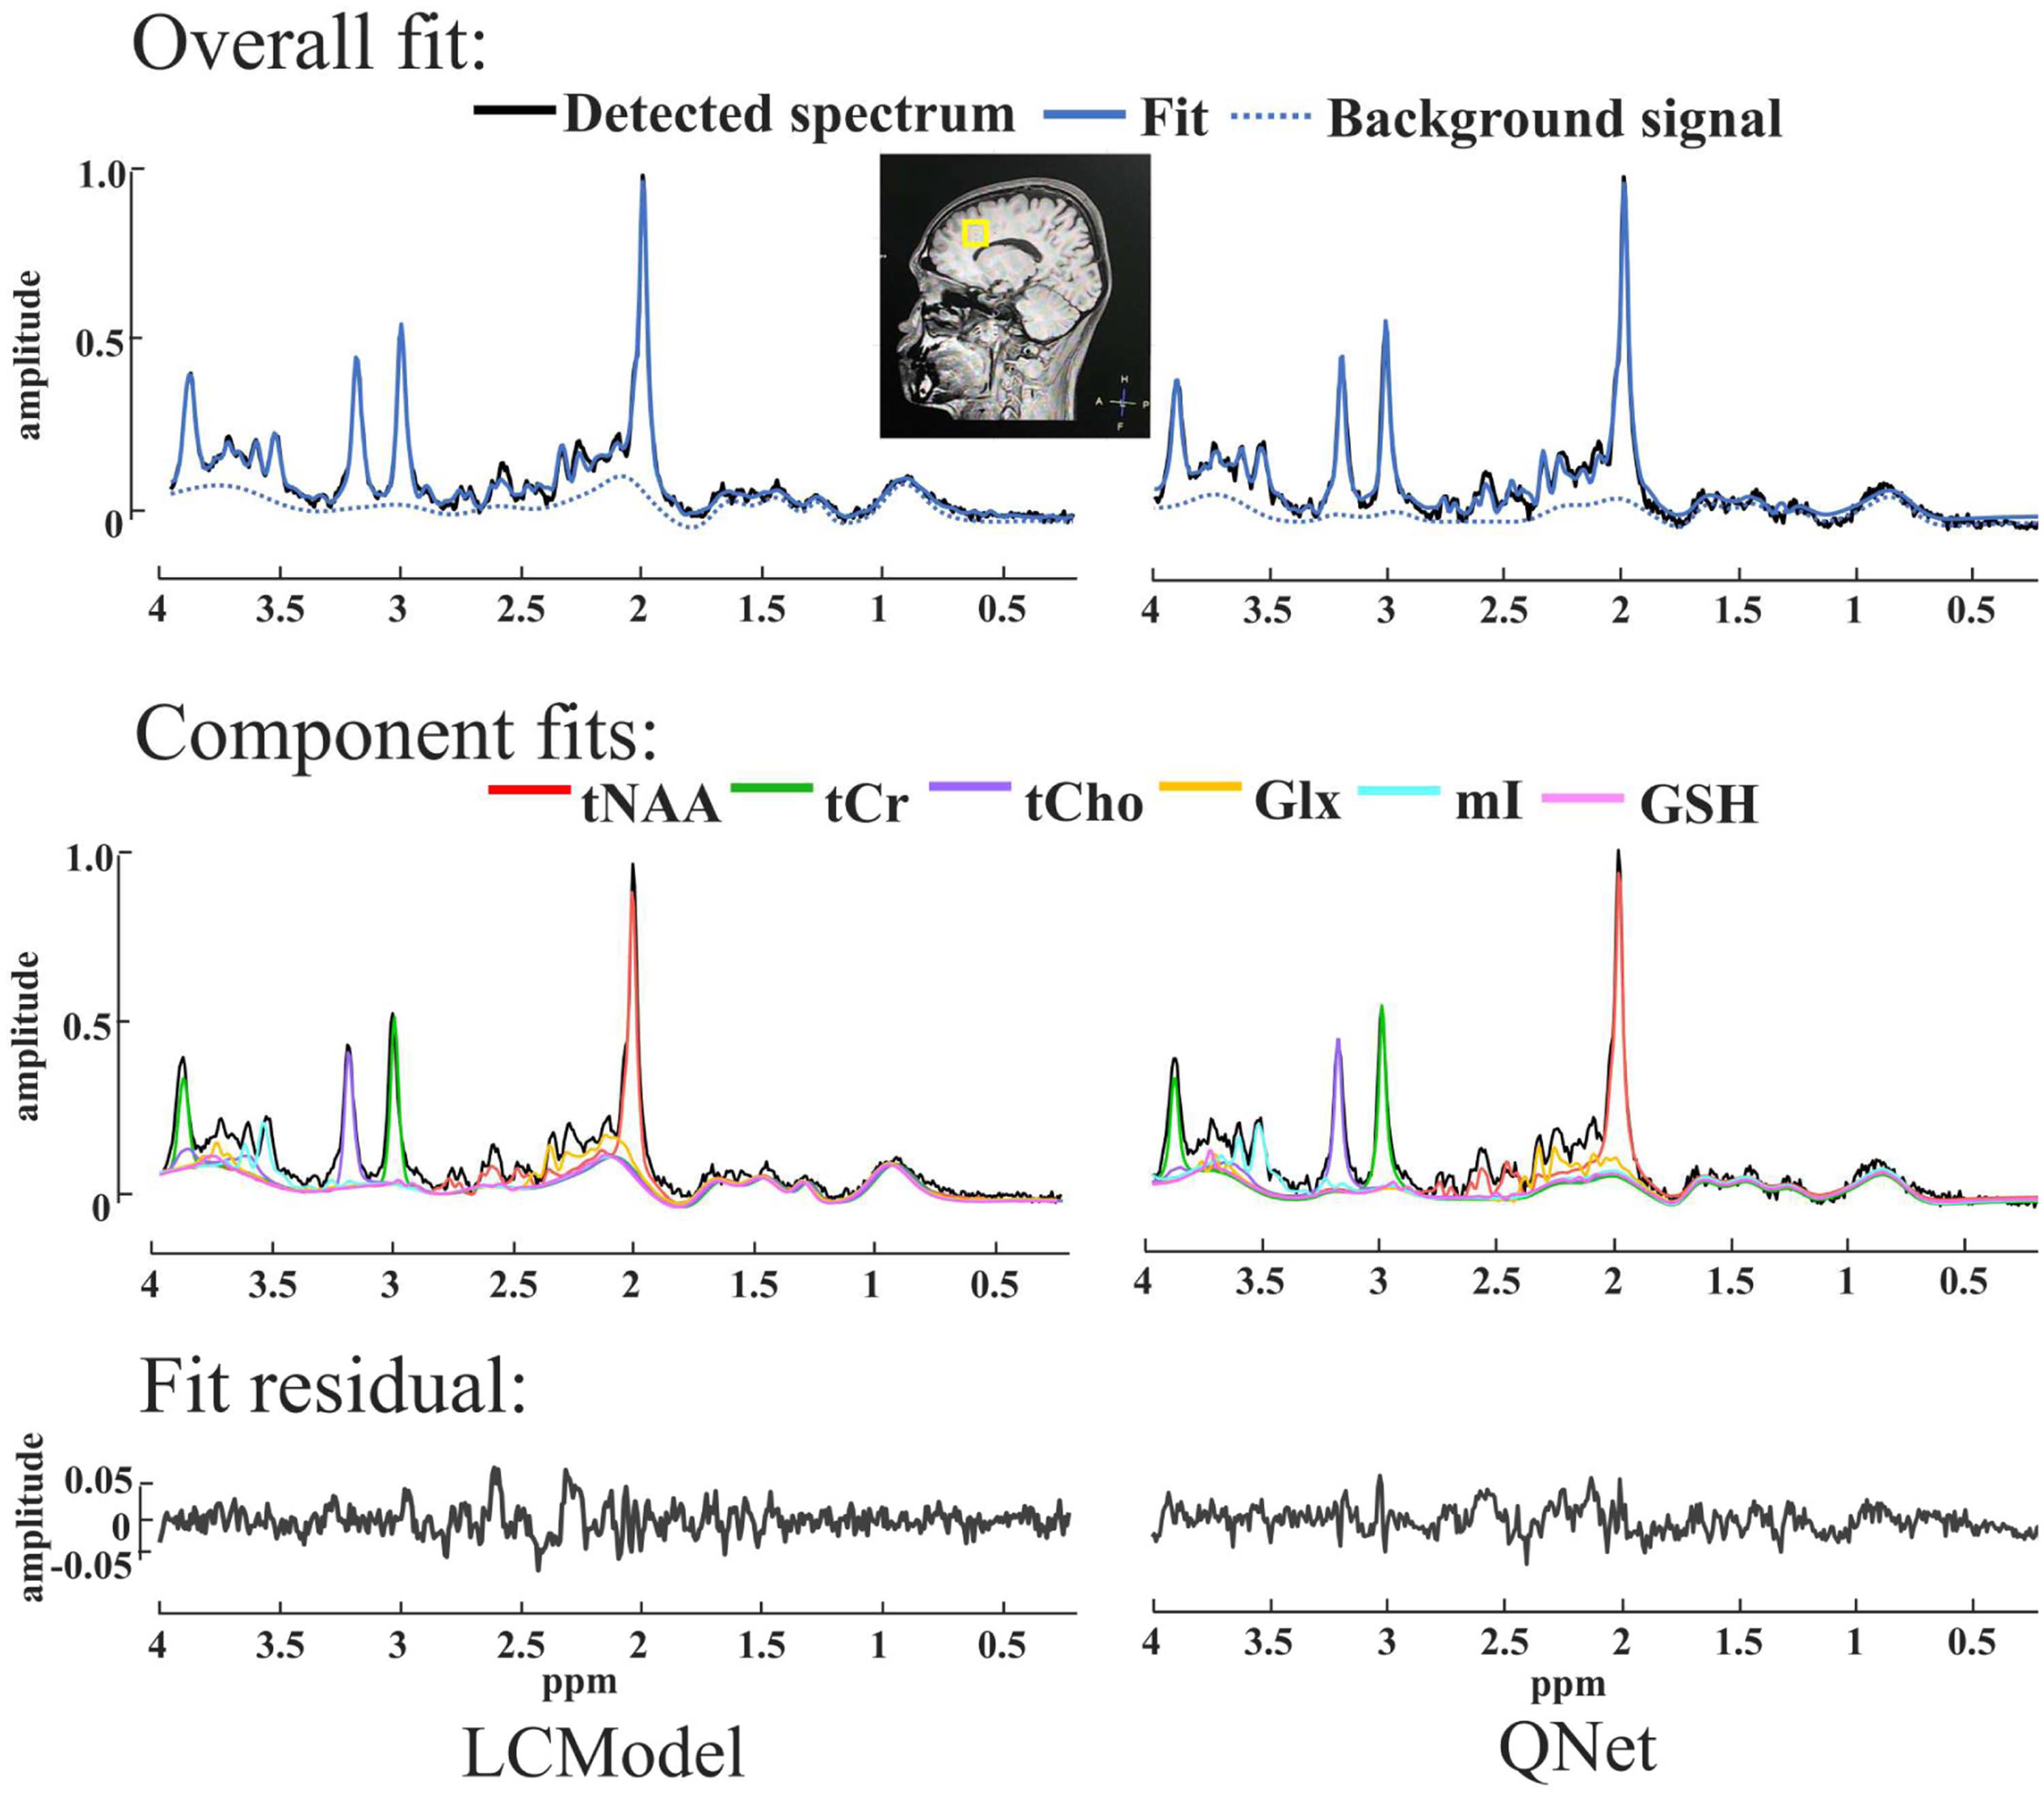
(1)高SNR下的一致性(图4)
- 视觉拟合:前额叶高SNR(NSA=128)数据中,QNet与LCModel的整体拟合曲线、各代谢物组分(tNAA、tCr、tCho、Glx、mI、GSH)拟合结果视觉高度一致,残差均小于0.1;
- Bland-Altman分析:20例在体数据中,95%(tNAA、tCho)或90%(mI、GSH)的数据点落在95%一致性界限内(均值±1.96SD),且tNAA、tCho的Pearson相关系数分别为0.90、0.95(强线性一致性);Glx相关系数较低(0.18),推测因Glx信号与其他代谢物重叠更严重,QNet的分离策略与LCModel存在差异。
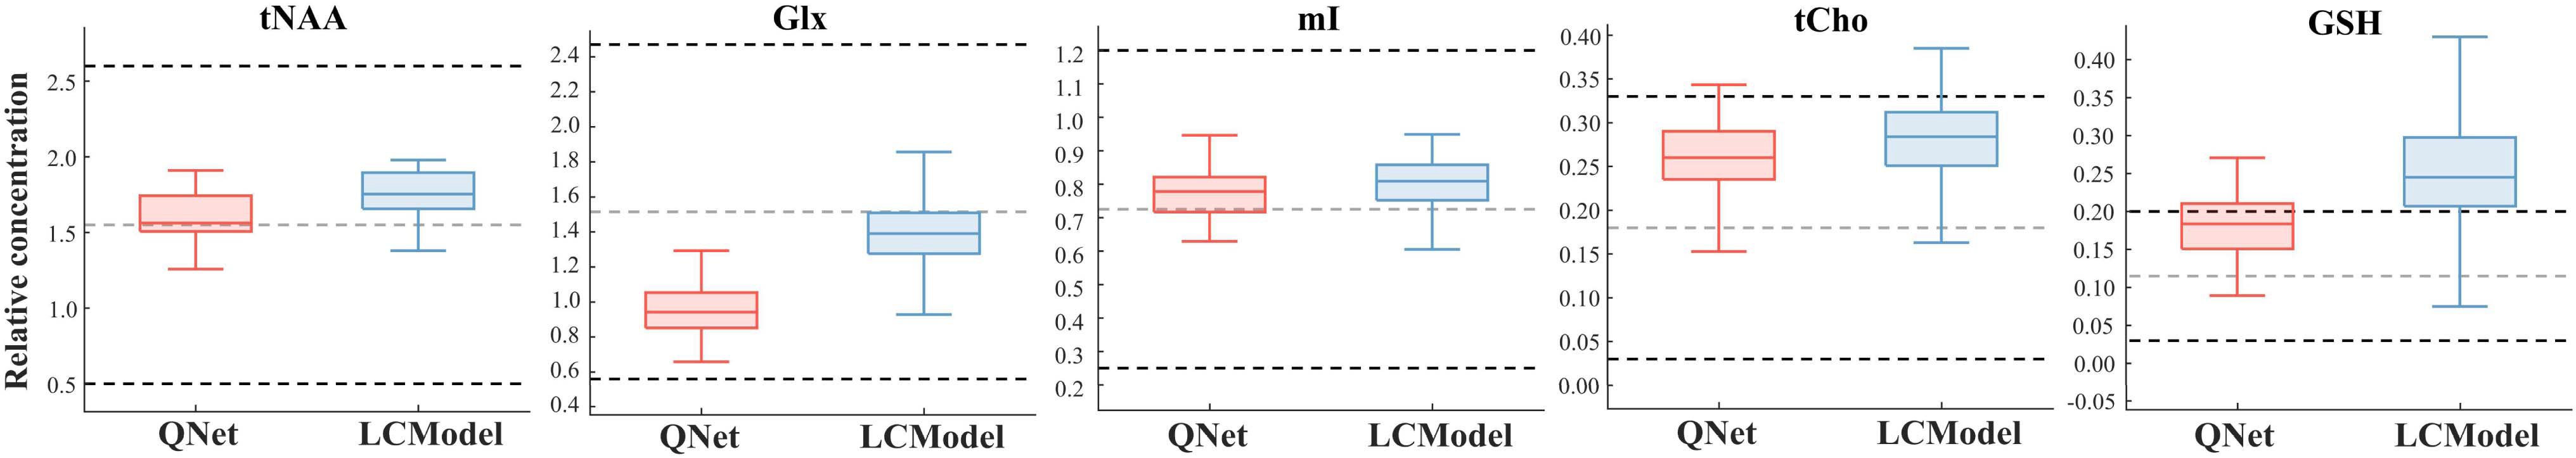
(2)浓度分布合理性(图5)
对比临床正常脑代谢物浓度范围:
- tNAA、mI、Glx:两者均在正常范围内,无显著偏差;
- tCho:少数数据超出上限(QNet 3例,LCModel 4例),表现相近;
- GSH:LCModel 15例结果超出正常上限,而QNet仅4例,证明QNet对“易受大分子背景干扰的代谢物”量化更准确。
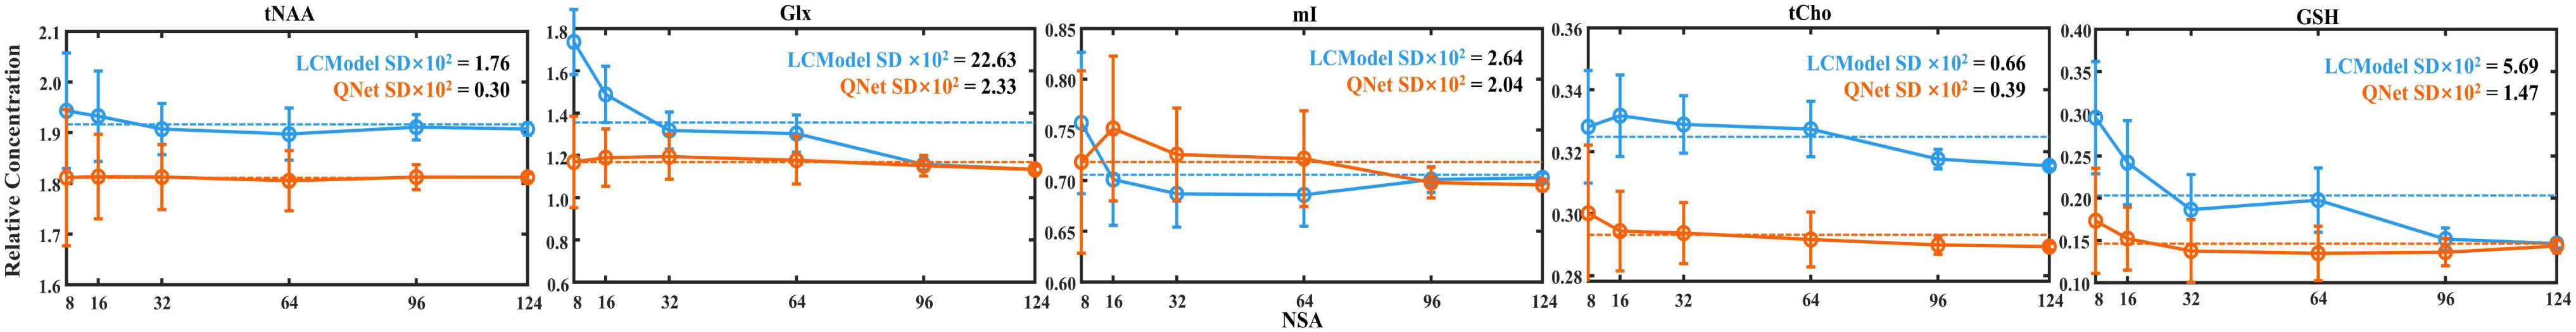
(3)不同SNR下的稳定性(图6)
NSA(信号平均次数)越少,SNR越低,通过SD(标准差)评估稳定性(SD越小越稳定):
- 对所有5种主要代谢物(tNAA、mI、Glx、tCho、GSH),QNet的SD均小于LCModel;
- 差异最显著的是Glx:QNet的SD=2.33,而LCModel的SD=22.63(相差近10倍);GSH的SD差异达3-5倍;
- 20例在体数据中,QNet在tNAA、mI、Glx、tCho、GSH上分别有16/20、17/20、20/20、19/20、17/20的案例SD更小,证明稳定性具有普适性。
3. 与其他深度学习方法对比:泛化性更优
(1)vs 端到端深度学习
端到端方法的核心问题是“训练外浓度泛化差”。研究模拟肿瘤脑的异常代谢物浓度(tNAA降至0.5-2.0mM、tCho升至5.0-12.0mM、tCr降至0.5-3.0mM):
- 端到端QNet的MAPE极显著升高(tNAA>516.6、tCr>544.1),完全无法准确量化;
- QNet的MAPE虽高于正常浓度场景,但仍保持在合理范围(tNAA 68.3±40.6、tCr 54.1±38.4、tCho 25.4±14.2),证明LLS的引入大幅提升对“未见浓度”的泛化性。
(2)vs 现有深度学习方法
- 对比[31]的方法:QNet对9种代谢物的SMAPE(对称平均绝对百分比误差)均更低(如NAA 1.98 vs 18.95、Cr 2.98 vs 19.64);
- 对比[18]的方法:QNet在tCho、Glx、tCr、mI上的MAPE更小(如tCr 2.41%±1.43% vs 3.66%±3.05%),仅tNAA略高(4.35%±2.76% vs 4.00%±3.38%),整体性能更优。
四、讨论:QNet的优势与待突破方向
1. QNet的关键优势
- 模块必要性:消融实验显示,去掉缺陷因子提取模块(QNet-woIF)或大分子预测模块(QNet-woMM),量化误差均超过100%,证明两个模块缺一不可;
- 线型选择:QNet采用全局洛伦兹线型(Lorentzian),而非Voigt线型(洛伦兹+高斯),因Voigt需估计的非线性参数从19个增至52个,导致稳定性下降;
- 相位容忍性:QNet可容忍[-30,30]°的相位偏移(MAPE<20),超出此范围需预处理,满足临床多数场景需求;
- 输入灵活性:输入复数光谱或仅实部,量化误差无显著差异,因深度学习模块为“任务导向的非线性映射”,对虚部不敏感。
2. 待突破的局限性
- 合成数据假设偏差:若测试数据的噪声水平、代谢物浓度范围、缺陷因子范围超出训练设定,QNet性能会下降(如强噪声下弱信号代谢物误差增大);
- 部分代谢物量化精度不足:Ala、Asp、Lac、GABA等弱信号代谢物,或NAAG/NAA、Cr/PCr等结构相似代谢物,仍难以精准区分,需结合特异性序列(如MEGA-PRESS用于GABA检测)优化训练;
- 训练数据多样性不足:当前模拟数据基于健康人参数,需增加肿瘤、神经退行性疾病等病变数据,或通过迁移学习拓展至病理场景;
- 仅相对浓度量化:当前结果为代谢物与tCr的浓度比,依赖tCr的稳定性;临床更需绝对浓度量化,未来需结合水信号校正等方法实现。
五、结论与临床价值
QNet创新性地将深度学习的“非线性学习能力”与LLS的“解析求解优势”结合,通过双模块预测采集缺陷因子和大分子信号,简化量化问题的同时,利用LLS的反向传播反馈提升泛化性。实验证明:
- 模拟数据中,QNet对80%代谢物的量化误差低于LCModel,尤其在低SNR下优势显著;
- 在体数据中,QNet与LCModel在主要代谢物上高度一致,且随SNR降低更稳定;
- 相比端到端深度学习,QNet对训练外的异常代谢物浓度泛化性更强。
参考文献
[1] Chen D, Lin M, Liu H, et al. Magnetic Resonance Spectroscopy Quantification Aided by Deep Estimations of Imperfection Factors and Macromolecular Signal[J]. IEEE Transactions on Biomedical Engineering, 2024, 71(6): 1841-1852. https://doi.org/10.1109/TBME.2024.3354123
课题组网页
https://csrc.xmu.edu.cn/xiaobo/index_cn.html
欢迎关注
微信:Chushanzhishi2022
微信公众号:NMR凯米小屋
作者B站:楚山之石
更多推荐



 18
 0
- 0


 已为社区贡献1条内容

所有评论(0)